
Dieses Video führt Sie durch die Verwendung von Fivetran + AWS Lambda, um Daten aus „ Tulip table “ nach einem festgelegten Zeitplan abzurufen und verschiedene Zielsysteme wie Data Warehouses, Datenbanken, Data Lakes und mehr zu aktualisieren
Optimieren Sie das Tulip-Data-Engineering mit der Fivetran-Integration
Zweck
Die Optimierung von Data-Engineering-Pipelines mit Tulip ermöglicht die unternehmensweite Nutzung von Daten aus Tulip-Tabellen
Einrichtung
Für die Einrichtung sind folgende Voraussetzungen erforderlich:* Fivetran-Konto (kostenlose Version verfügbar)* AWS (oder ein anderes Cloud-Konto)* Datenbank oder Data Warehouse zum Empfang von Daten aus Tulip-Tabellen* Fundierte Kenntnisse in Python
So funktioniert es
Die Einrichtung dieser Fivetran-Automatisierung erfolgt in folgenden Schritten:
- Fivetran-Konto einrichten
- Ziel erstellen (z. B. Snowflake)
- Erstellen Sie eine Connector-Funktion mit einer AWS-Lambda-Funktion
- Erstellen Sie eine AWS-Lambda-Funktion
- Connector-Funktion fertigstellen
- Fivetran-Konnektor testen und Aktualisierungshäufigkeit anpassen
Fivetran nutzt die Lambda-Funktion, um Daten aus Tulip-Tabellen automatisch nach einem festgelegten Zeitplan abzurufen und die Zieldatenbanken oder Data Warehouses zu aktualisieren. Das beigefügte Beispiel ist eine einfache Funktion, die die Tabelle mit neuen, aktualisierten Daten überschreibt. Für verbesserte ereignisbasierte Trigger können zusätzliche Funktionen hinzugefügt werden.
Einrichtungsanleitung
Fivetran-Konto einrichten
Zunächst müssen Sie ein Fivetran-Konto einrichten. Es wird eine kostenlose Version mit einer begrenzten Anzahl von Aktualisierungen pro Monat angeboten
Ziel einrichten
Klicken Sie anschließend auf „Ziele“ und erstellen Sie Ihr erstes Ziel. Dabei handelt es sich im Wesentlichen um die Datenbank oder das Data Warehouse, das die Daten aus den Tulip-Tabellen empfangen soll.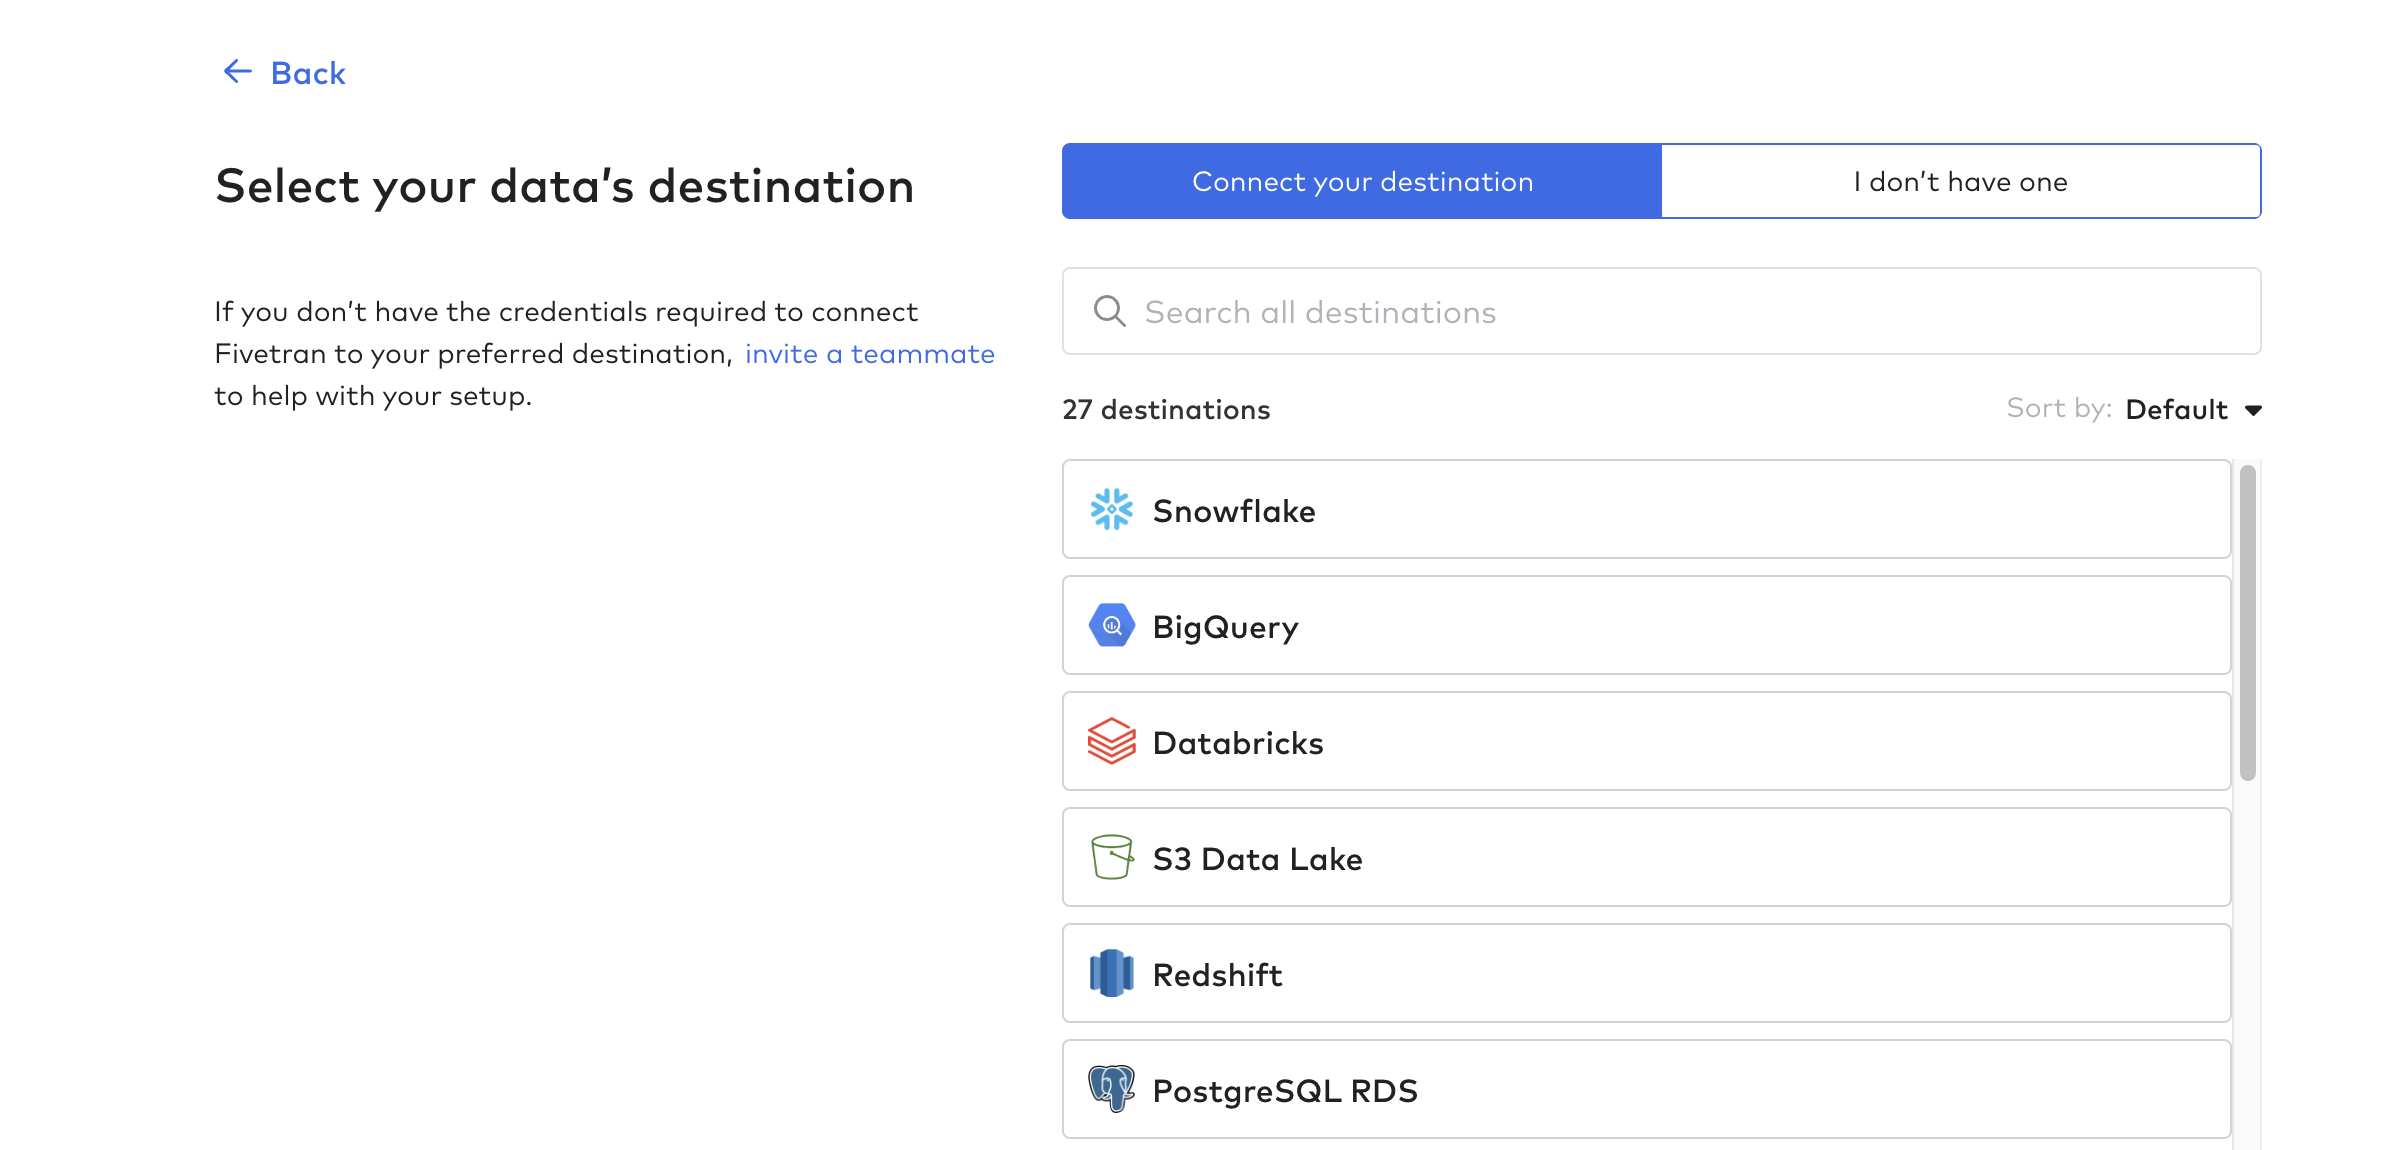
Connector-Funktion erstellen
Erstellen Sie anschließend die Connector-Funktion; dies ist der Prozess zur Automatisierung der Datenpipeline aus Tulip. Sie können jede beliebige Cloud-Funktion verwenden, wie z. B. AWS Lambda, Azure Functions oder GCP Cloud Functions. In diesem Beispiel verwenden wir AWS Lambda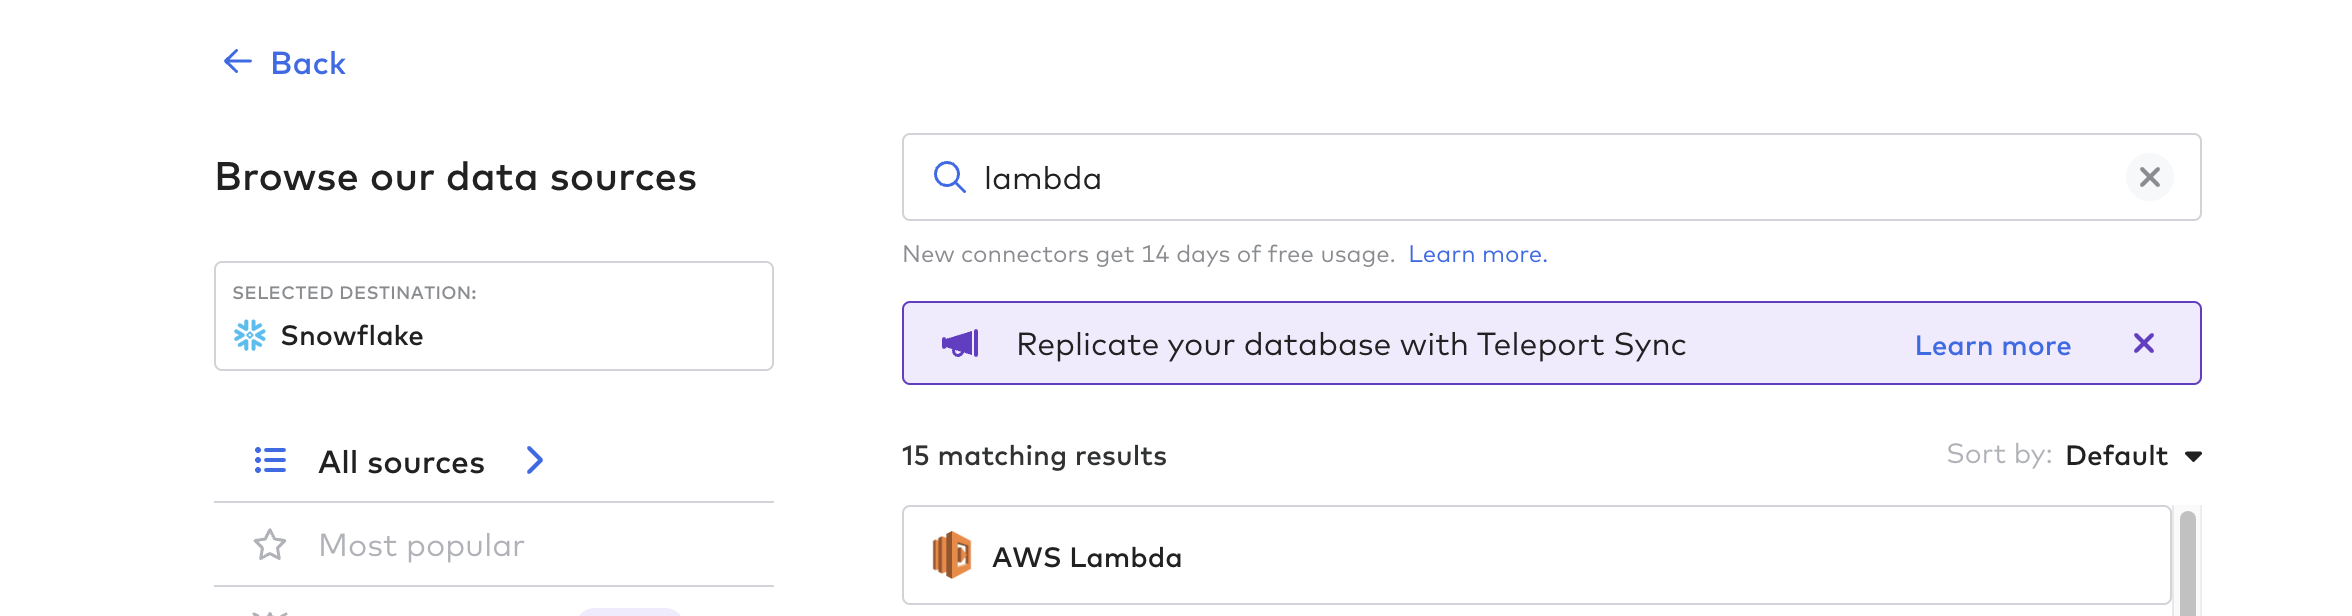
Befolgen Sie die Anweisungen in Fivetran zum Erstellen einer Lambda-Funktion auf AWS mit den entsprechenden Rollen undBerechtigungen. Unter dem folgenden Link finden Sie eine Lambda-Funktionsvorlage als Ausgangspunkt. Nachfolgendfinden Sie einige hilfreiche Tipps:
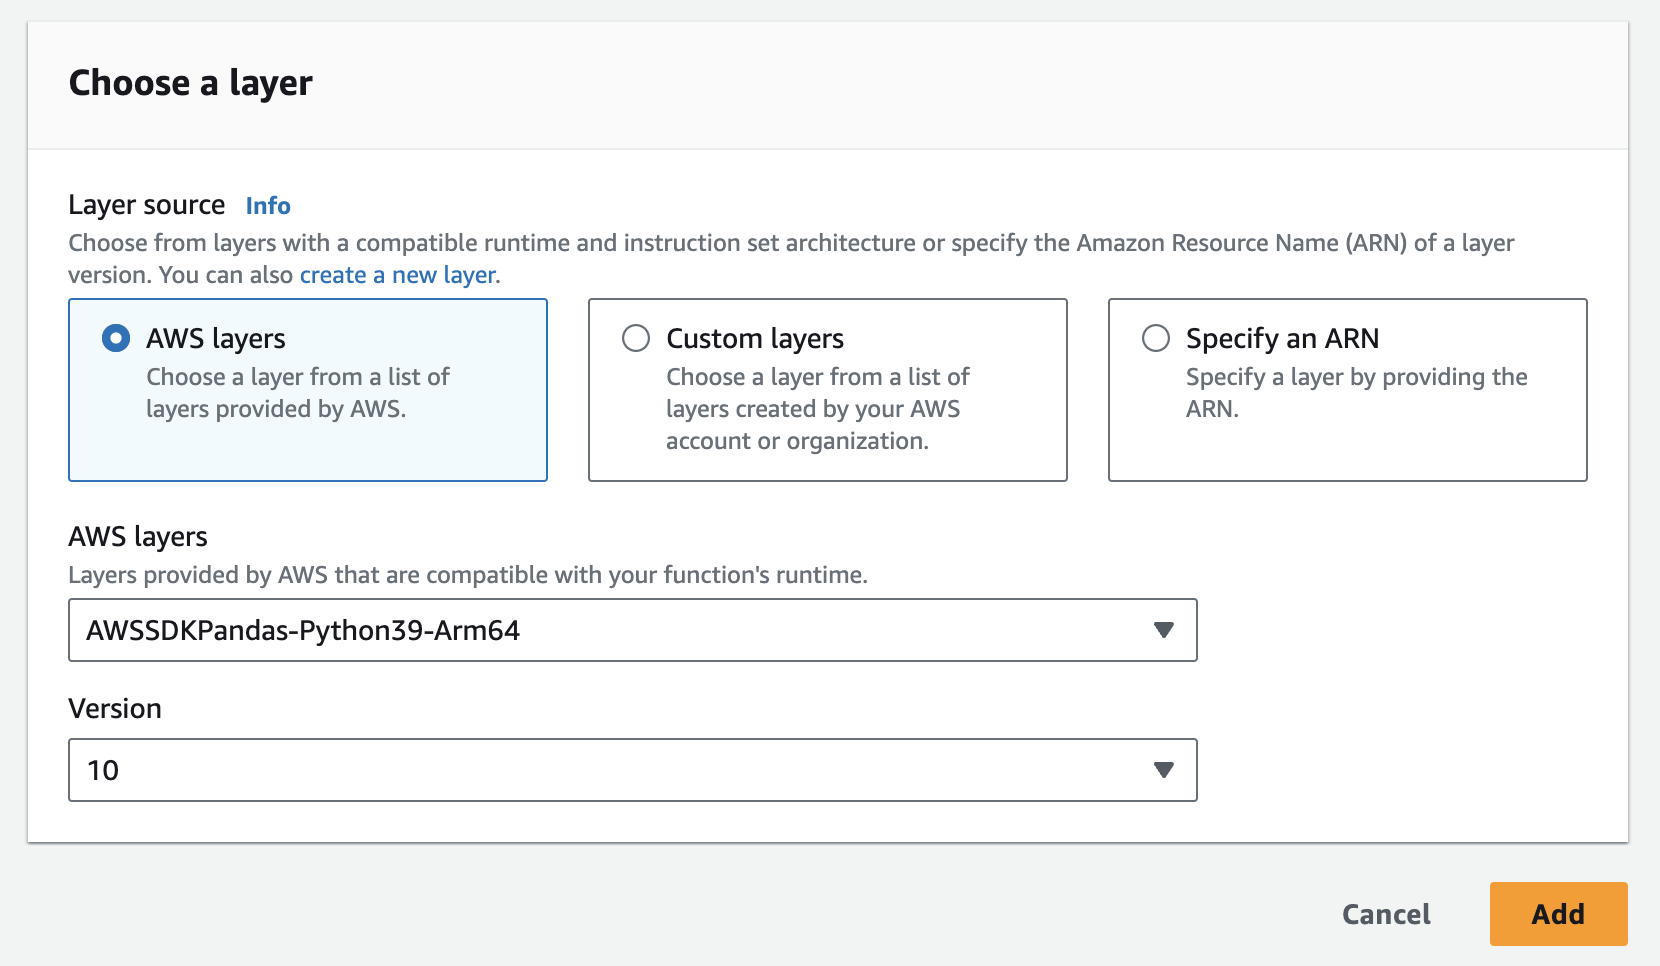
- Sie müssen zwei Ebenen erstellen: eine für die Tulip-Bibliothek und eine für die Pandas-Bibliothek
- Die Tulip-Community-API können Sie hier einsehen
- Alternativ kannst du die ZIP-Datei hier herunterladen (diese wurde bereits für das Hinzufügen zu einer Ebene vorbereitet)
- Sie können die Pandas-Layer ganz einfach in AWS unter folgendem Link hinzufügen:
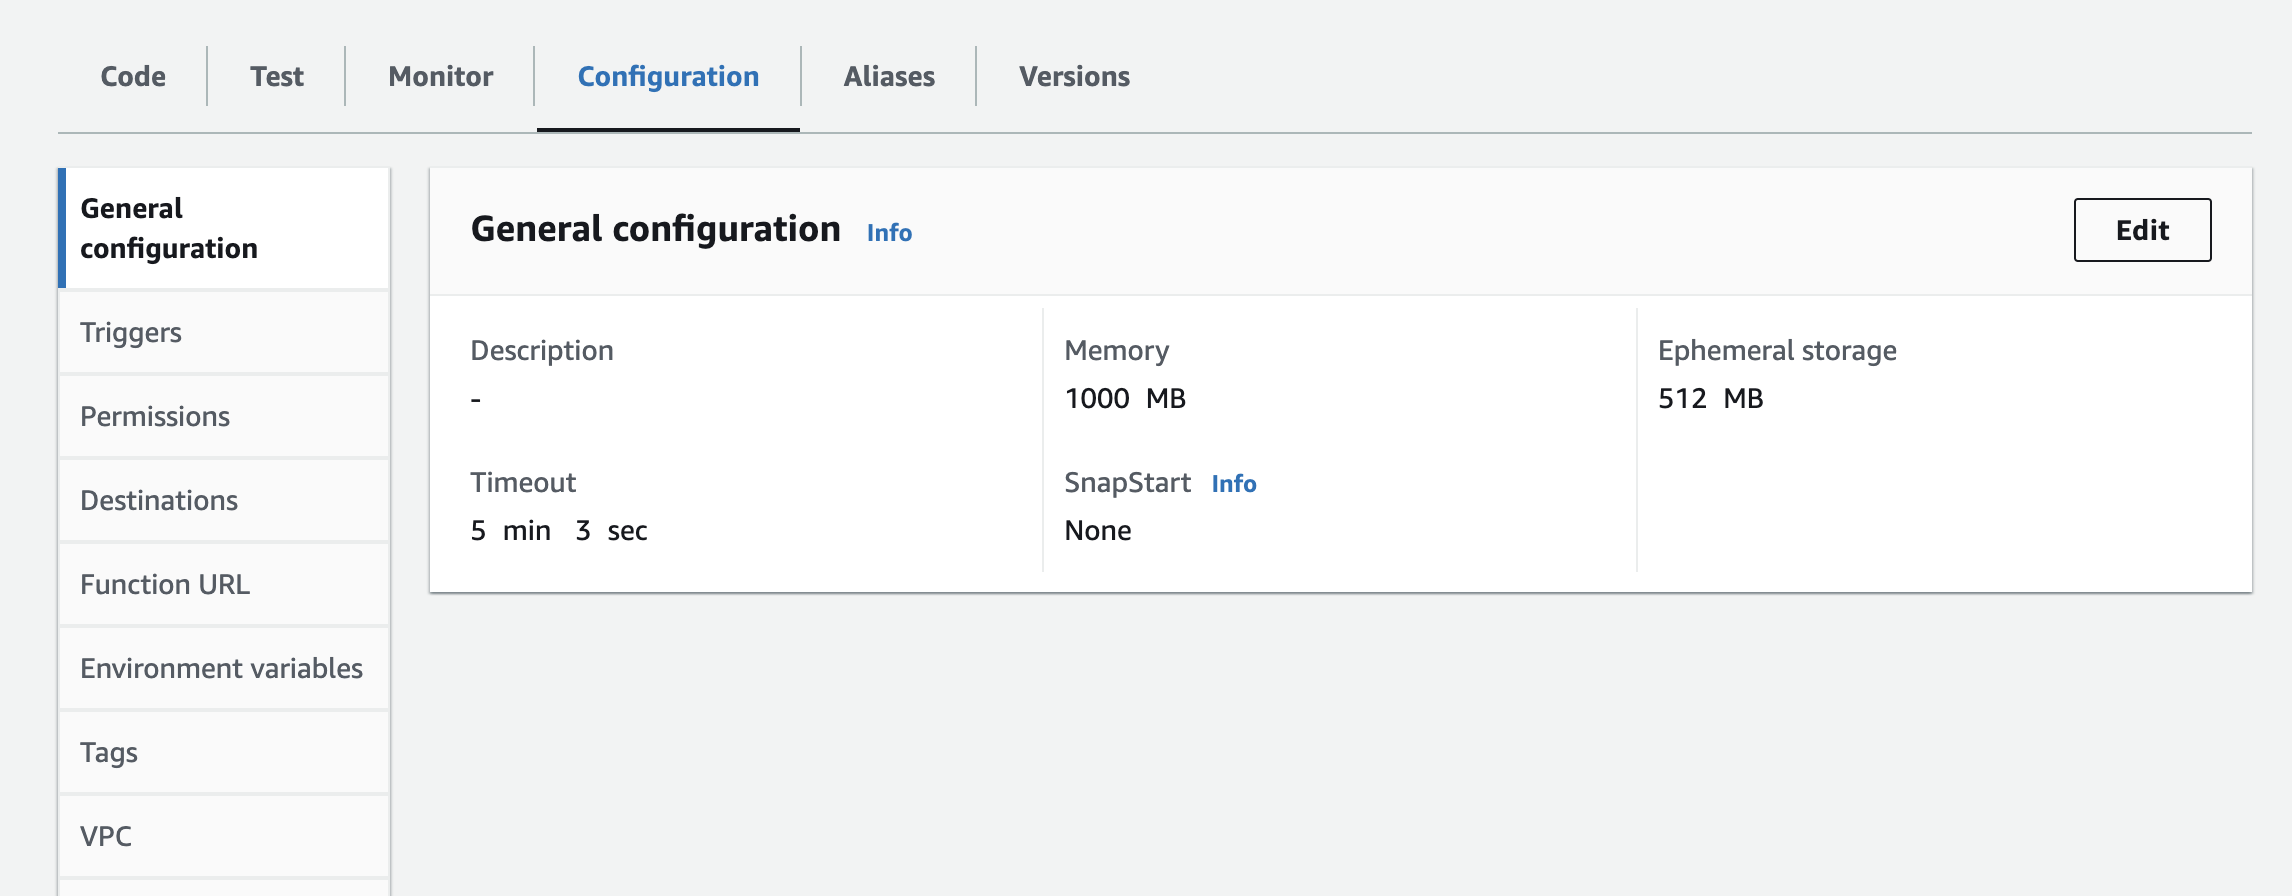
- Sie müssen die Instanz, den API-Schlüssel und das API-Geheimnis als Umgebungsvariablen zur Lambda-Funktion hinzufügen. Möglicherweise müssen Sie die Laufzeiteinstellungen anpassen, um die Zeitüberschreitung und den Speicherbedarf zu erhöhen. Screenshot zur Aktualisierung der Konfiguration unten:
Nächste Schritte
Sobald die Connector-Funktion funktioniert, können Sie die Aktualisierungshäufigkeit anpassen, Informationen zu Tulip-Tabellen in der Zieldatenbank oder im Data Warehouse einsehen und weitere Funktionen nutzen
Einige konkrete Anwendungsfälle für diese Datenpipeline:* Analysen und Datenverarbeitung von Tulip-Daten auf Unternehmensebene* Batch-Automatisierungen mit Unternehmenssystemen* Kontextualisierung mit Data Warehouses und Data Lakes
Weitere Ressourcen
Wenden Sie sich hier an Fivetran, um weitere Unterstützung zu erhalten.Wenden Sie sichhieran Fivetran, um weitere Unterstützung zu erhalten. * Darüber hinaus steht ein Formular zur Verfügung, über das Sie Anpassungen vornehmen und Anfragen zur vereinfachten Integration von Tulip-Tabellen stellen können. Geben Sie hier Feedback und stellen Sie Anfragen.