
Wer kann diese Funktion nutzen?
Benutzer mit Enterprise-Tarifen und höher.
Diagramm zum Export und Import
Nachfolgend ist der gesamte Übertragungsablauf für Tulip-Tabellen, Abfragen und Aggregationen dargestellt. Dieses Dokument enthält eine detaillierte Erläuterung dieses Ablaufs.
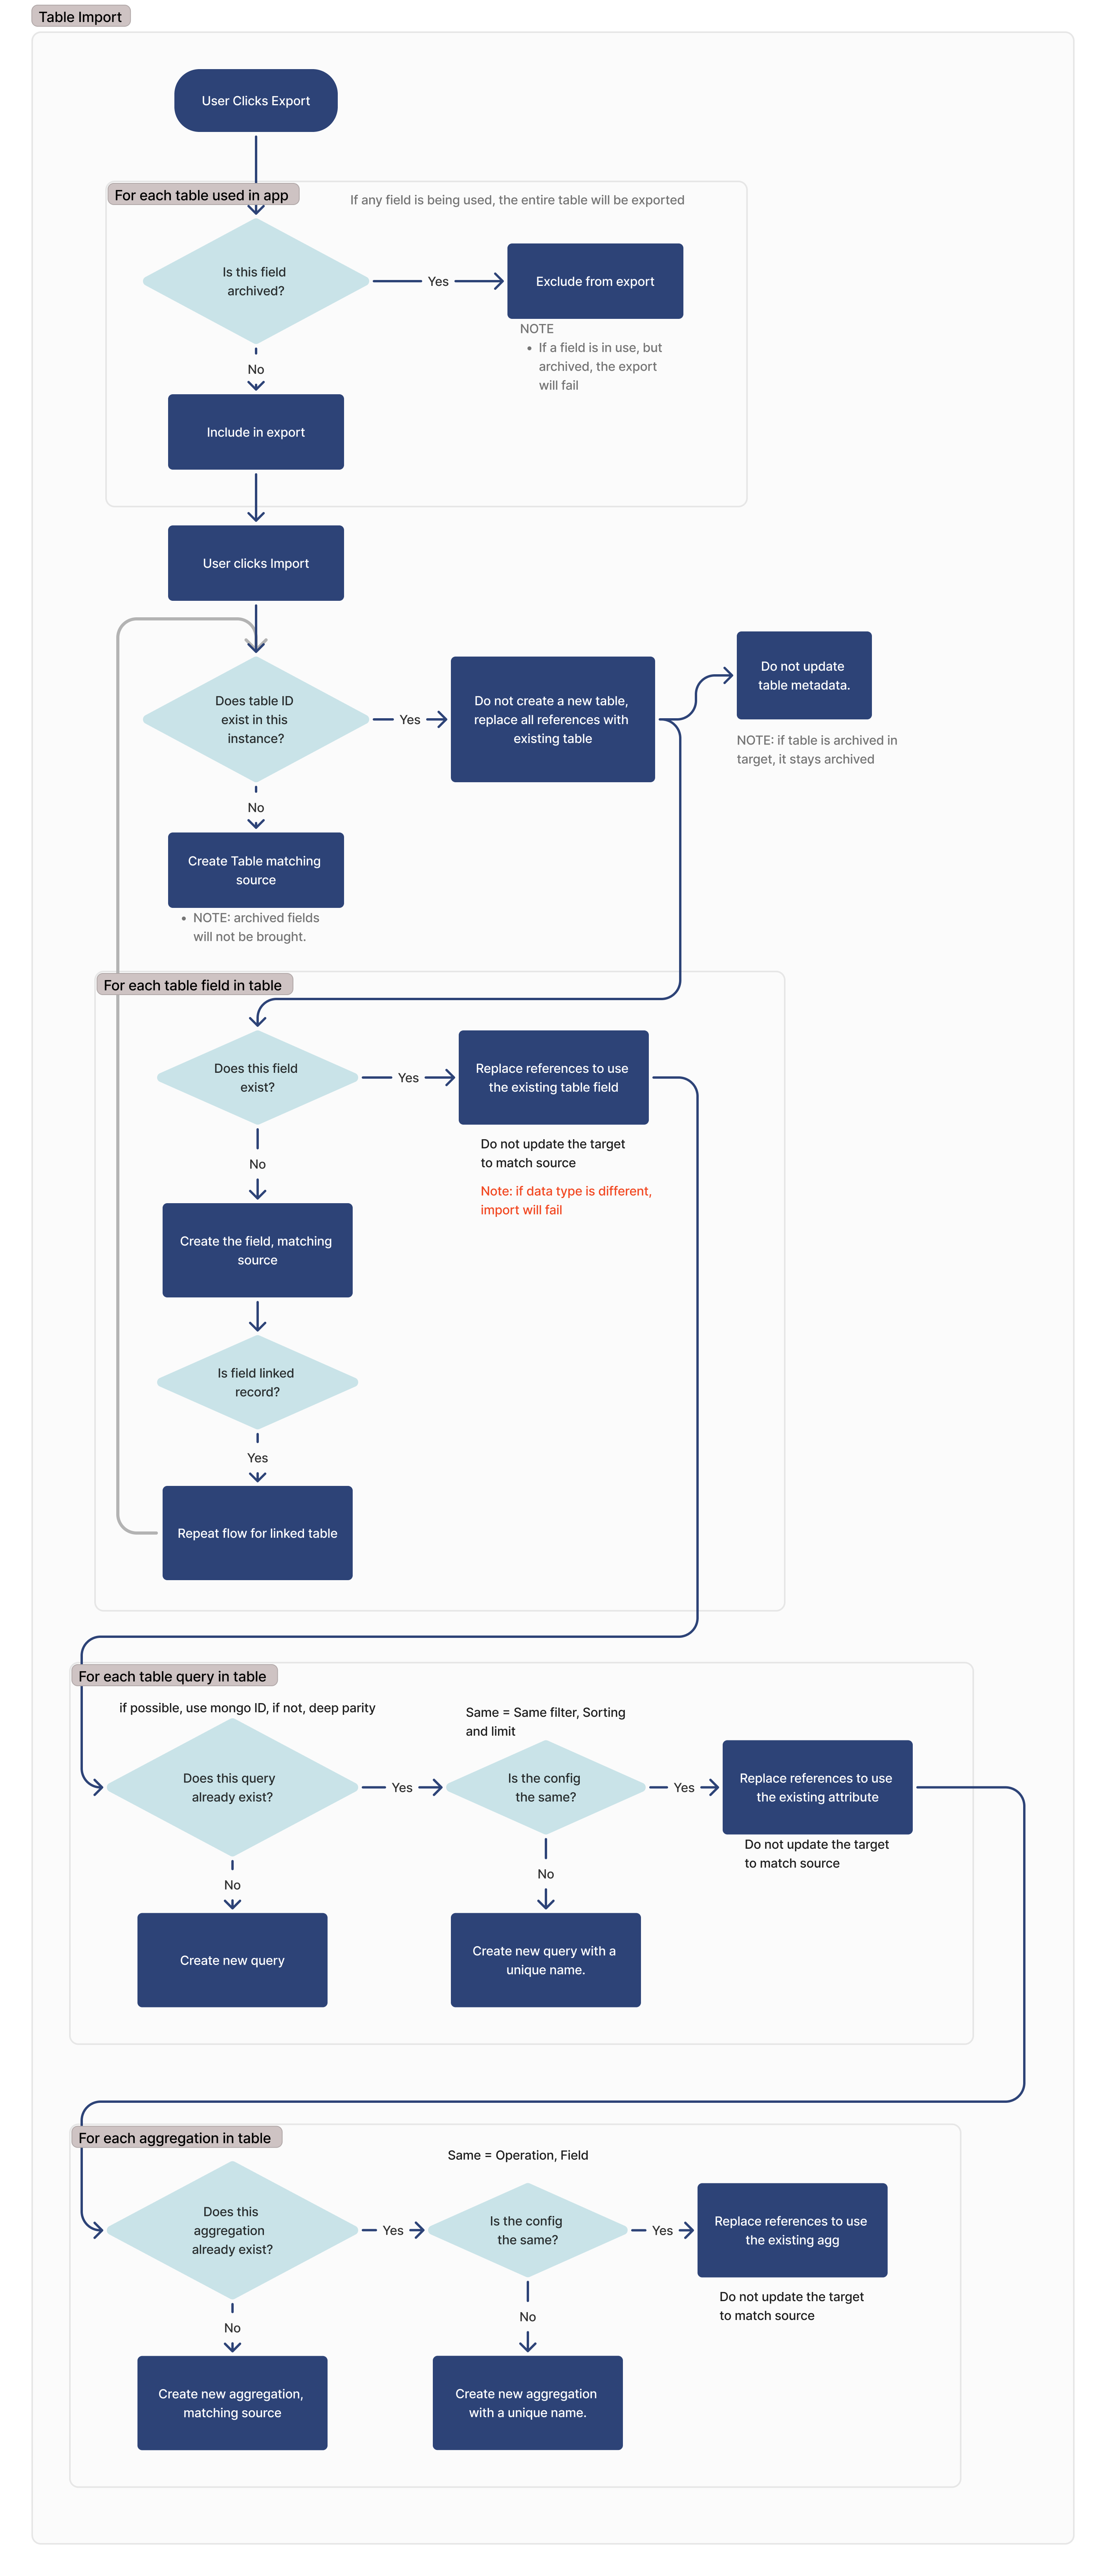
Benutzerdefinierte Benutzerfelder und Tabellen zur Maschinenaktivität
Der unten beschriebene Ablauf gilt auch für den Export und Import von Tabellen mit benutzerdefinierten Feldern und Tabellen mit Maschinenaktivitätsfeldern.
Export
Während des Exportvorgangs umfasst die exportierte Anwendung oder Automatisierung jede Tabelle, die innerhalb dieser Anwendung verwendet wird. Eine Tabelle gilt als verwendet, wenn eine der folgenden Bedingungen erfüllt ist:
- Sie wird in einem „Tabelleneintrag“-Widget angezeigt
- Wird in einem Eingabe-Widget verwendet
- Wird in einer interaktiven Tabelle angezeigt
- Wird in einem Trigger verwendet
- Wird in einer Automatisierungsaktion verwendet
- Verwendet in einem Automatisierungs-Ereignisblock
- Verwendung in einem Filter für eine Tabellenabfrage, eine interaktive Tabelle oder ein Analyse-Widget
- Wird als Eingabe oder Ausgabe für ein benutzerdefiniertes Widget verwendet
Wenn ein Feld archiviert ist, wird es nicht exportiert. Wenn ein Feld archiviert ist, aber verwendet wird, schlägt der Export fehl.
Import
Gleiche Tabelle suchen
Um beim Import übereinstimmende Tabellen zu identifizieren, suchen wir nach übereinstimmenden IDs. Wird eine Tabelle mit derselben ID gefunden, erstellen wir keine neue Tabelle, sondern greifen auf die vorhandene zurück.
Wenn eine Tabelle in der Quelle archiviert ist und in der Zielinstanz nicht existiert, wird die Tabelle in der Zielinstanz angelegt und anschließend archiviert.
Ist die Tabelle in der Quellinstanz archiviert, bleibt sie archiviert. Eine archivierte Tabelle bleibt archiviert; eine nicht archivierte Tabelle bleibt nicht archiviert.
Für jedes Tabellenfeld
Für jedes Tabellenfeld suchen wir anhand der Spalten-ID des jeweiligen Feldes nach einem übereinstimmenden Feld.
Wenn der Datentyp des passenden Feldes abweicht, schlägt der Import fehl.
Wenn es sich bei dem Feld um ein Feld mit verknüpftem Datensatz handelt, wird die verknüpfte Tabelle zur Liste der Abhängigkeiten für den Import hinzugefügt, und dieser Ablauf wird für diese Tabelle wiederholt.
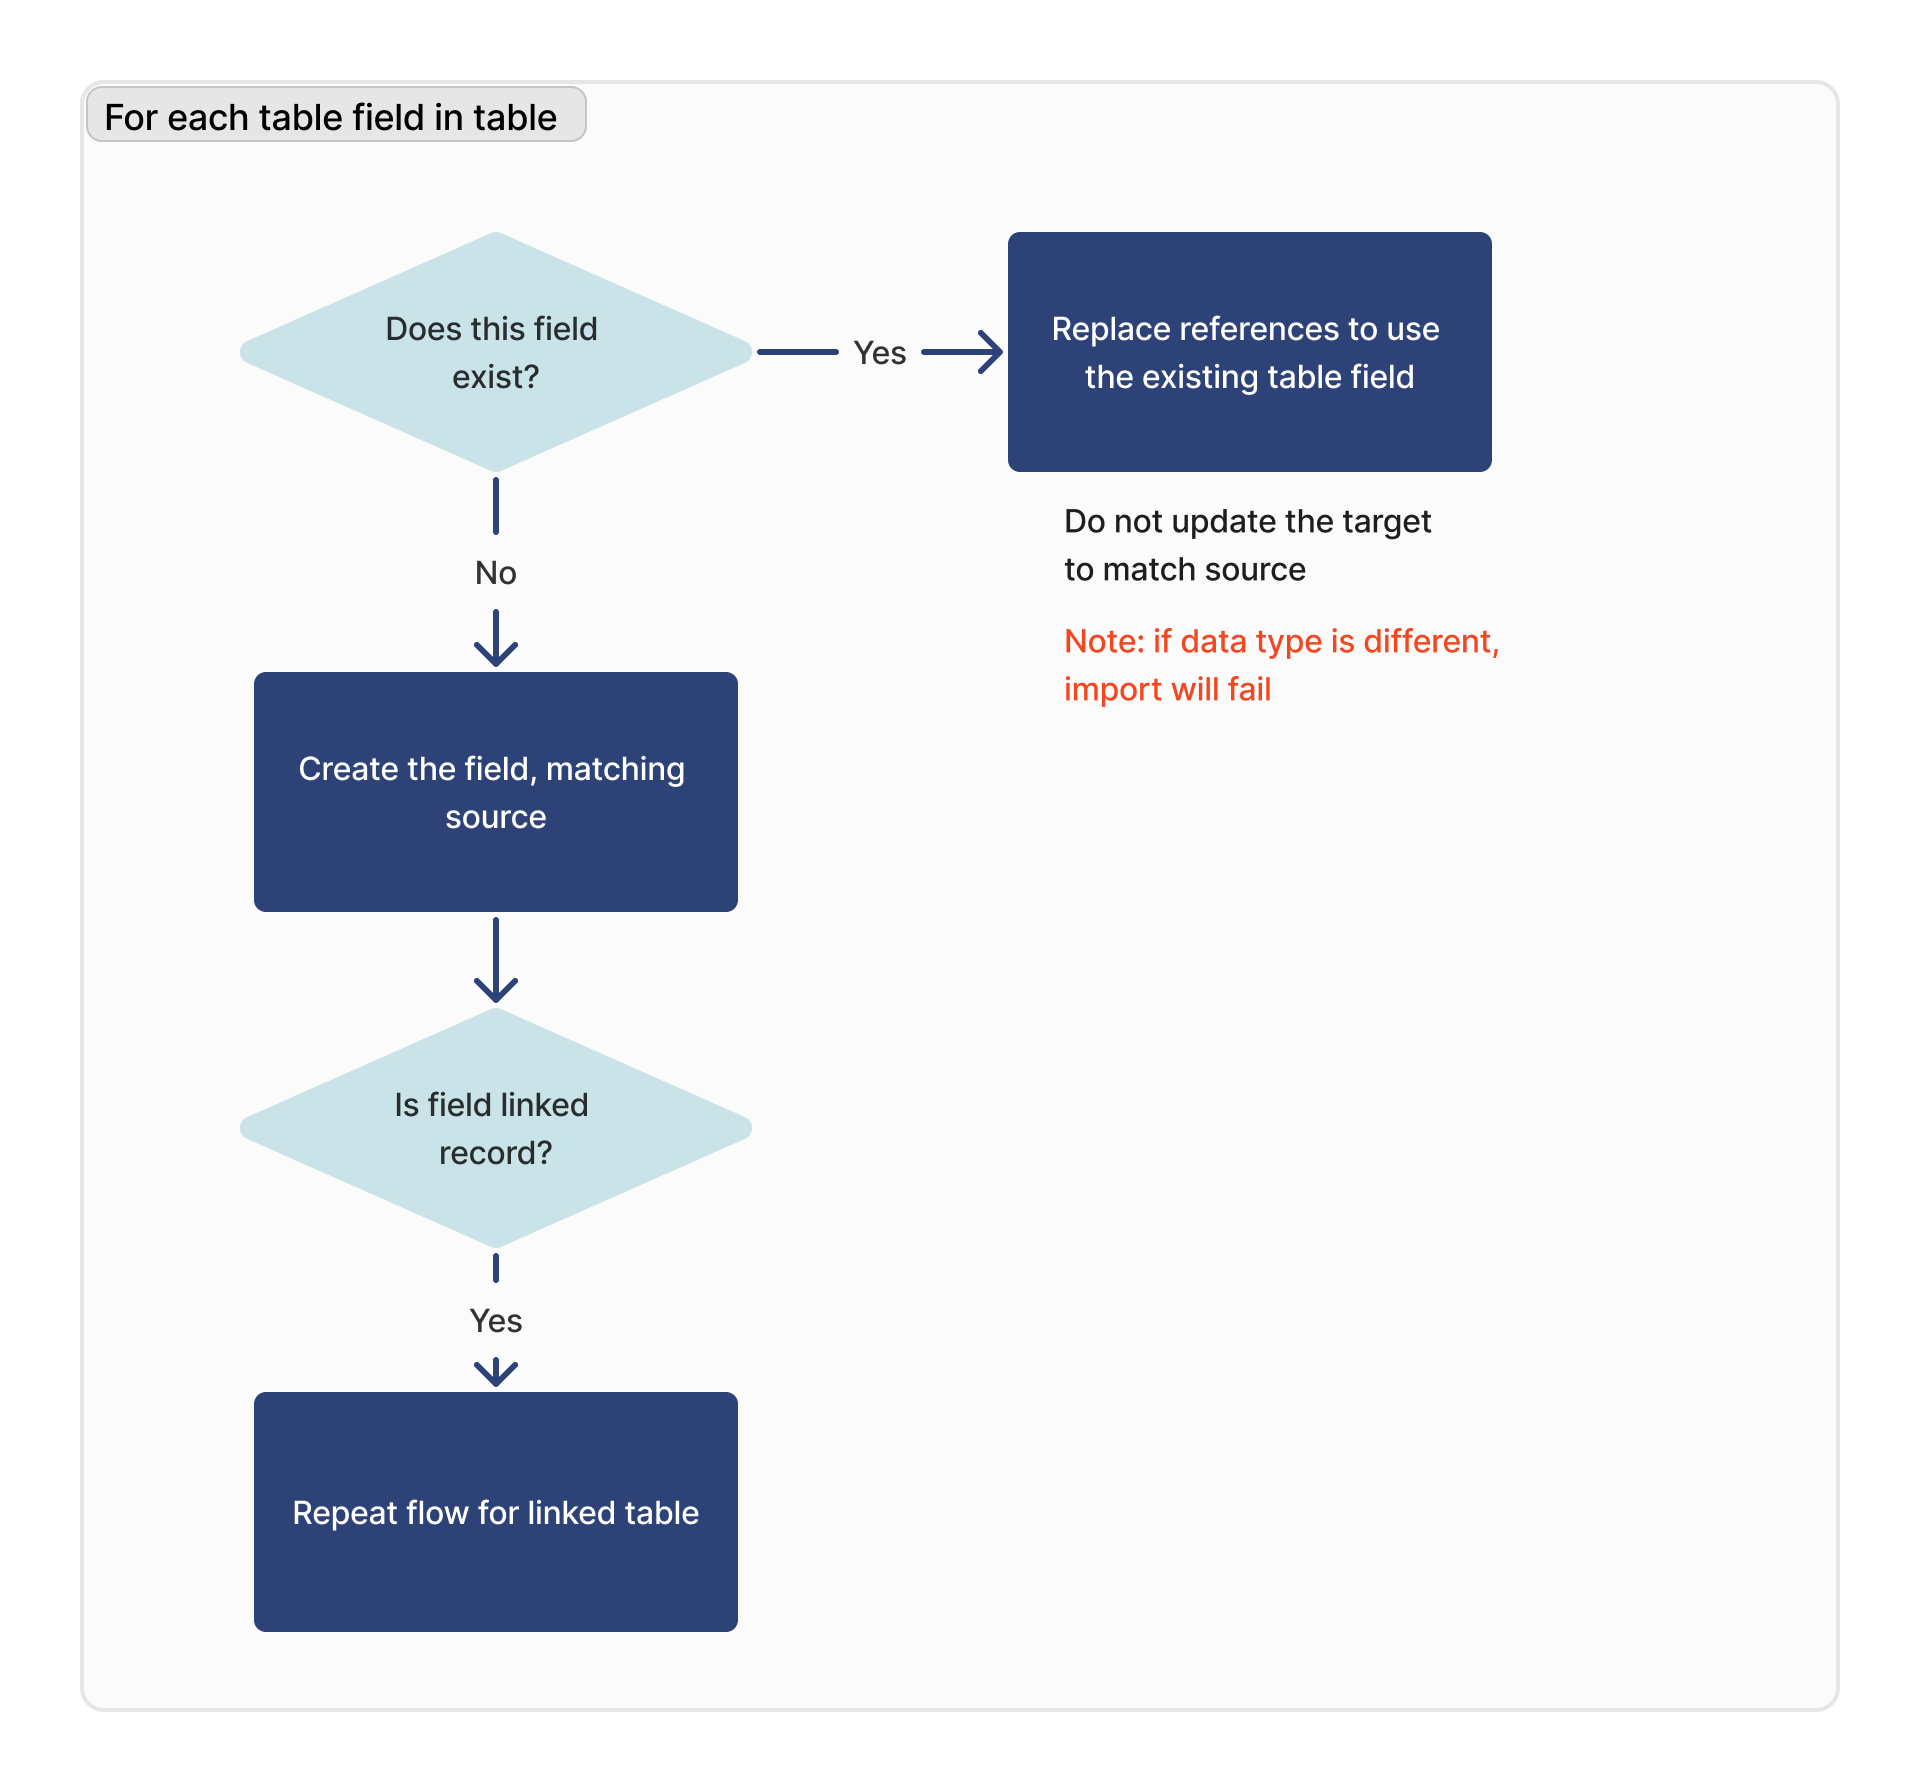
Wenn ein Feld in der Quelle archiviert ist und im Ziel nicht vorhanden ist, wird es im Ziel als nicht archiviert angelegt (Hinweis: Dies unterscheidet sich vom Verhalten der Tabelle).
Wenn ein Feld auf der Zielseite bereits vorhanden ist, wird sein Archivierungsstatus durch den Import niemals aktualisiert. Ein archiviertes Feld bleibt archiviert; ein nicht archiviertes Feld bleibt nicht archiviert.
When exporting a table directly, archived fields are not included. However, if an archived field is referenced by an app, it will be included in the export (with the above import rules applying).
Für jede Abfrage
Für jede Abfrage in der importierten Tabelle prüfen wir, ob diese Abfrage vorhanden ist. Wird eine übereinstimmende ID gefunden, überprüfen wir, ob die Konfiguration (Begrenzung, Sortierung und Filterung) zwischen Ziel und Quelle identisch ist.
Wenn keine übereinstimmende Abfrage gefunden werden kann, wird eine neue Abfrage erstellt. Wenn eine übereinstimmende Abfrage gefunden wird, diese aber nicht mit der Zielinstanz identisch ist, wird eine neue Abfrage mit einem neuen Namen erstellt.
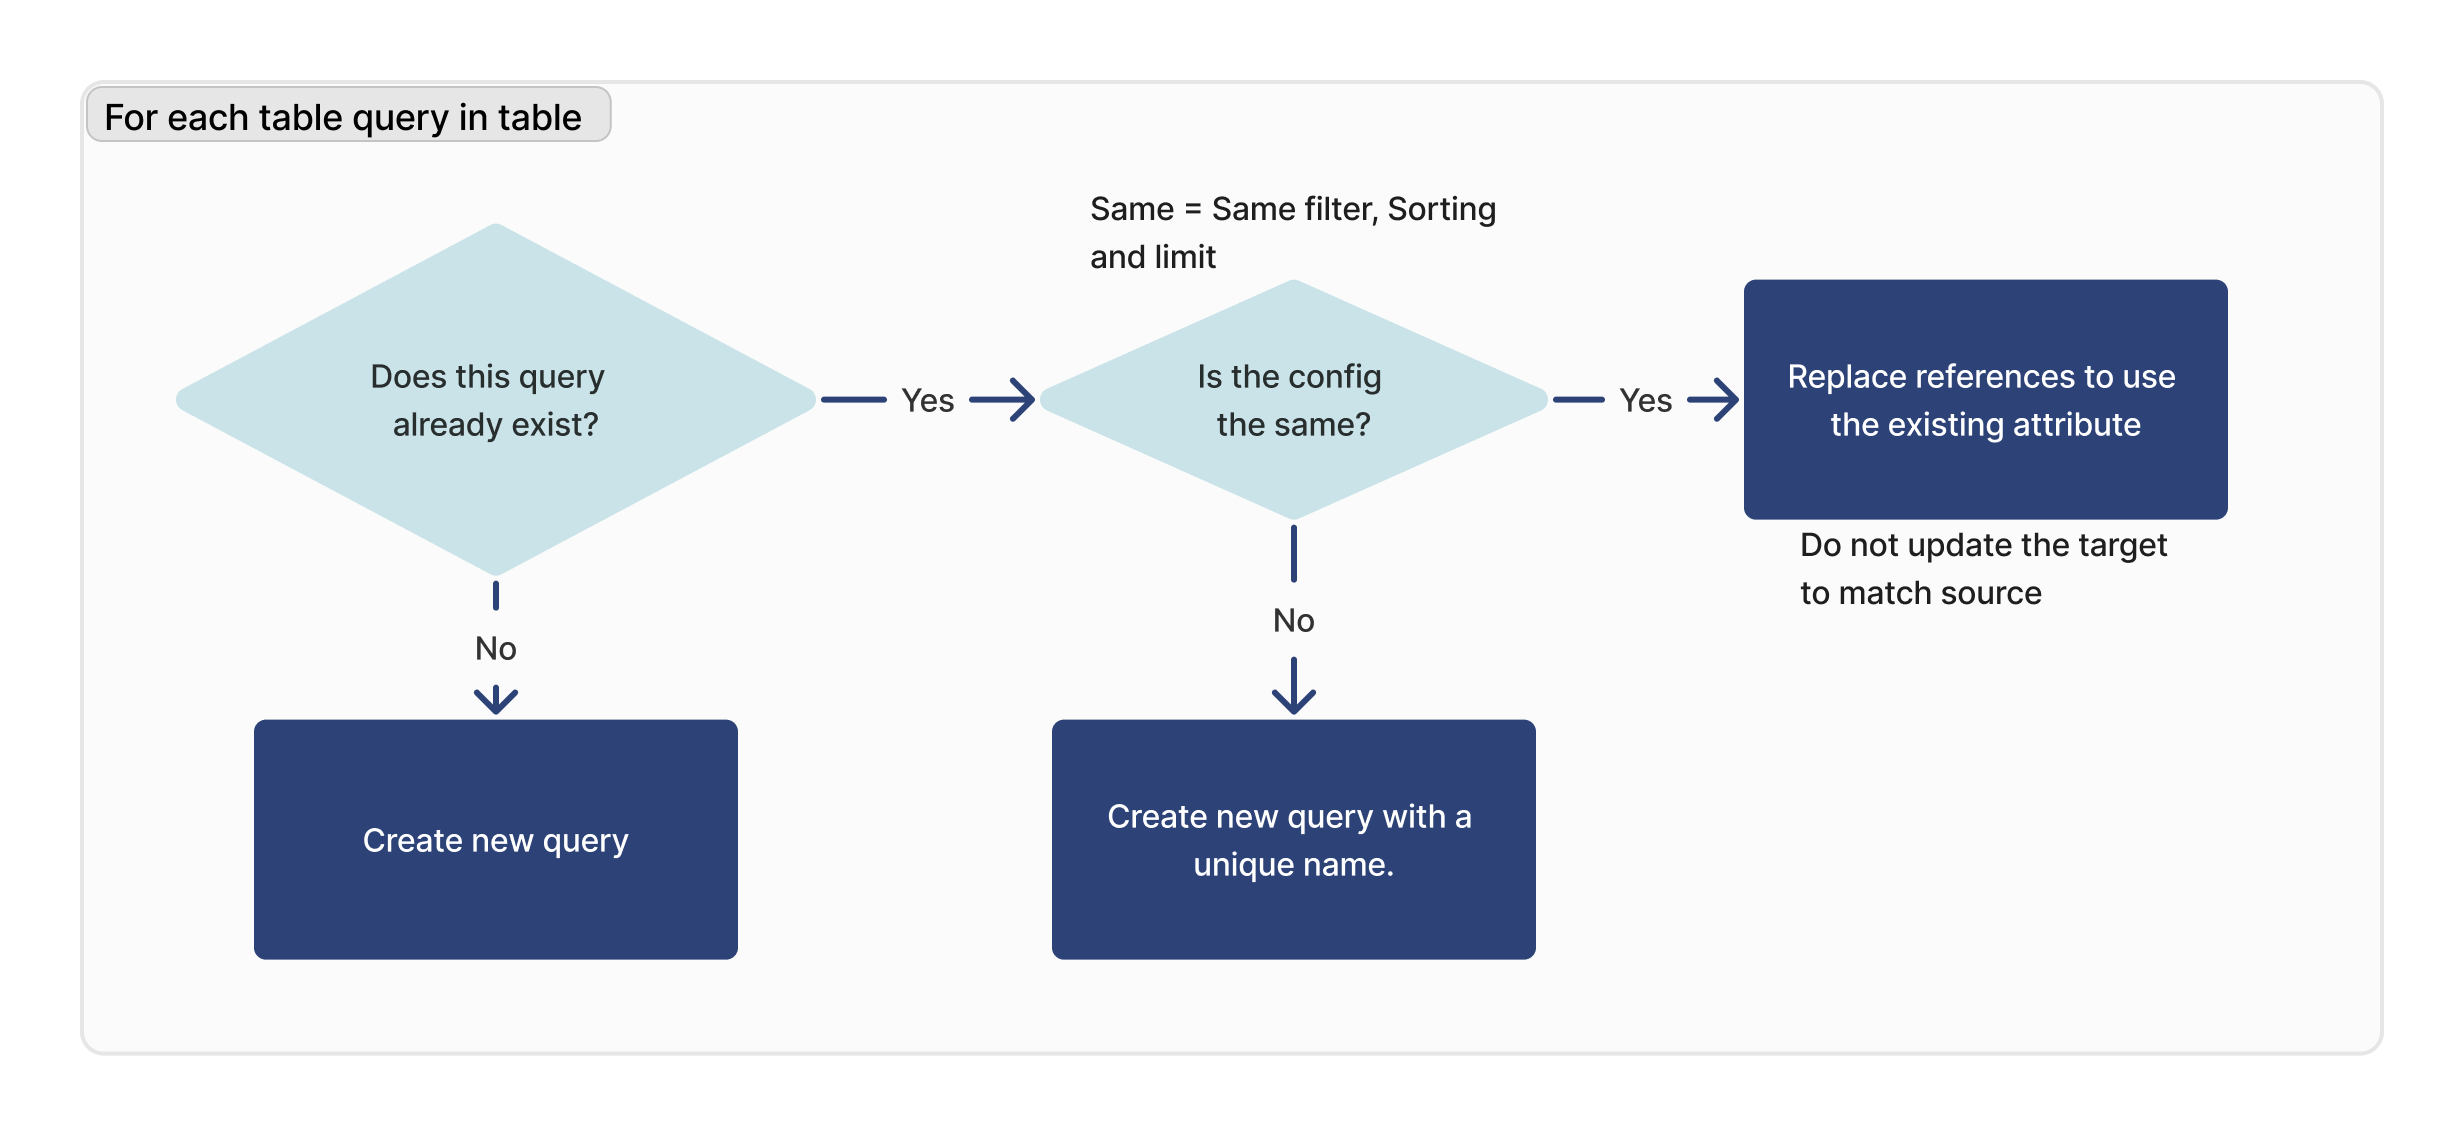
Hinweis: Dies gilt nicht für benutzerdefinierte Felder oder Tabellen zur Maschinenaktivität.
Aktualisierungen des Import-/Exportverhaltens reduzieren Duplikate. Tabellenabfragen werden nun als „ development version “ importiert. Die Tabellenabfrage wird nur dann als Snapshot importiert, wenn dieselbe Abfrage bereits existiert und eine andere Konfiguration aufweist.
Das bisherige Verhalten (das in den Instanzen r329/LTS14 und früheren Versionen weiterhin besteht) importierte Snapshots als „Snapshots“ und „ development versions “ als „ development versions “.
Für jede Aggregation
Für jede Aggregation in der importierten Tabelle prüfen wir, ob diese Abfrage existiert. Wird eine übereinstimmende ID gefunden, überprüfen wir, ob die Konfiguration (Operation, Feld) zwischen Ziel und Quelle identisch ist.
Wenn keine passende Aggregation gefunden werden kann, wird eine neue Aggregation erstellt. Wenn eine passende Aggregation gefunden wird, diese aber nicht mit der Zielinstanz identisch ist, wird eine neue Aggregation mit einem neuen Namen erstellt.
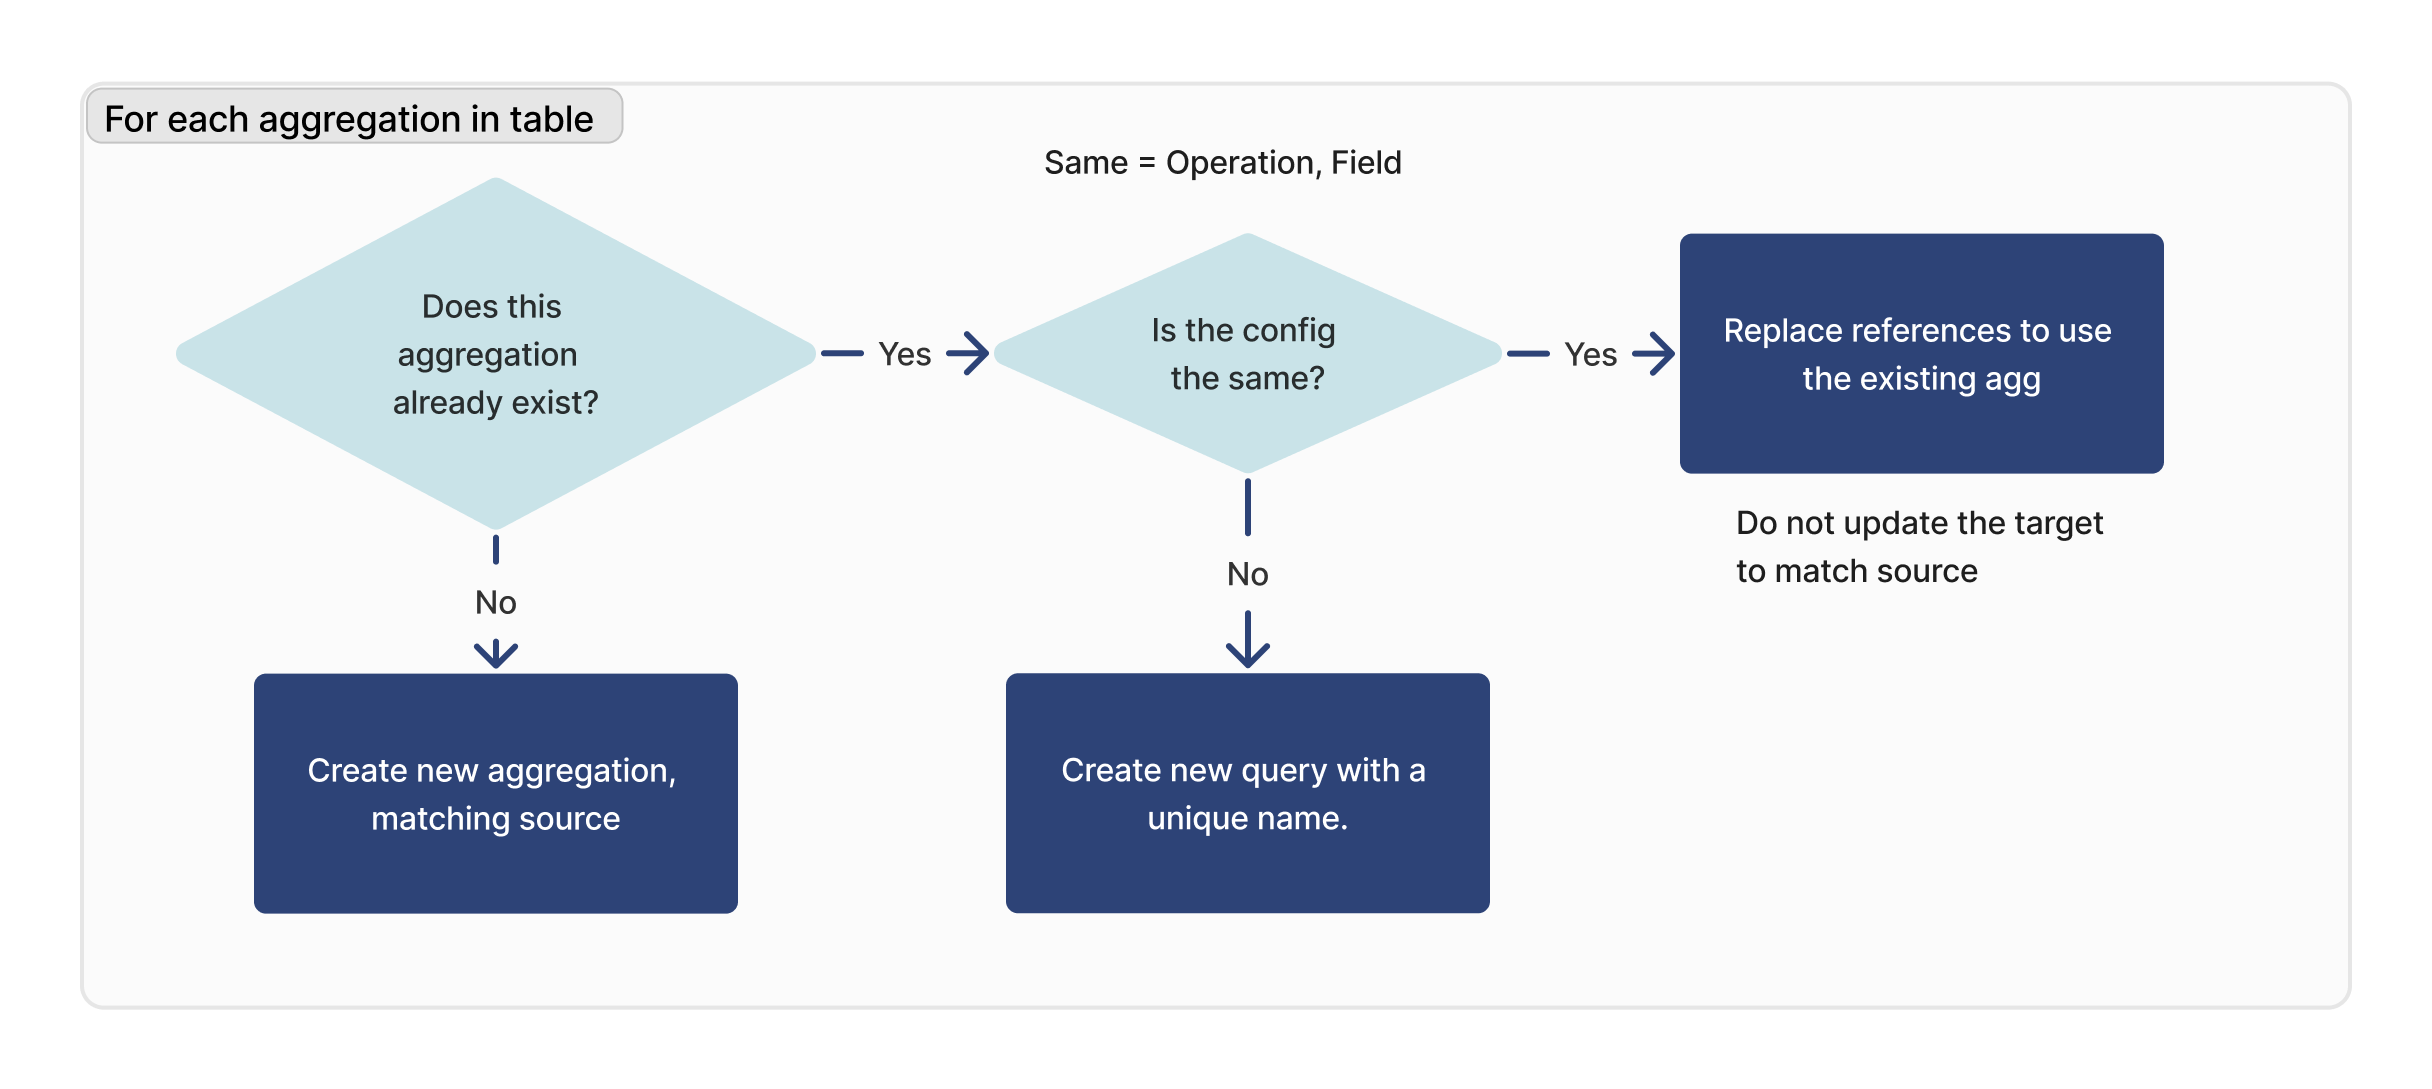
Hinweis: Dies gilt nicht für benutzerdefinierte Felder oder Tabellen zur Maschinenaktivität.
Aktualisierungen des Import-/Exportverhaltens reduzieren Duplikate. Tabellenaggregationen werden nun als „ development version “ importiert. Die Tabellenaggregation wird nur dann als Snapshot importiert, wenn dieselbe Aggregation bereits existiert und eine andere Konfiguration aufweist.
Beim bisherigen Verhalten (das in den Instanzen r329/LTS14 und früheren Versionen weiterhin besteht) wurden Snapshots als „snapshots“ und „ development versions “ als „ development versions “ importiert.
{{snippet.Haben Sie gefunden, wonach Sie gesucht haben?}}