
Questo video illustra le istruzioni per l’utilizzo di Fivetran + AWS Lambda per recuperare i dati dell’ Tulip table e a intervalli prestabiliti e aggiornare una varietà di destinazioni quali data warehouse, database, data lake e altro ancora
Ottimizza il data engineering di Tulip con l’integrazione di Fivetran
Scopo
L’ottimizzazione delle pipeline di ingegneria dei dati con Tulip consente di utilizzare i dati delle tabelle Tulip in tutta l’azienda
Configurazione
Per la configurazione sono necessari i seguenti elementi:* Account Fivetran (è disponibile una versione gratuita)* AWS (o altro account cloud)* Database o data warehouse per ricevere i dati delle tabelle Tulip* Conoscenza avanzata di Python
Come funziona
La configurazione di questa automazione Fivetran prevede i seguenti passaggi:
- Configurare l’account Fivetran
- Creare una destinazione (ad es. Snowflake)
- Creare una funzione di connessione con AWS Lambda
- Creazione della funzione AWS Lambda
- Finalizza la funzione del connettore
- Testare il connettore Fivetran e regolare la frequenza di aggiornamento
Fivetran utilizza la funzione Lambda per recuperare automaticamente i dati delle tabelle Tulip a intervalli prestabiliti e aggiornare i database o i data warehouse di destinazione. L'esempio riportato è una funzione semplice che riscrive la tabella con i nuovi dati aggiornati. È possibile aggiungere ulteriori funzionalità per migliorare i trigger basati sugli eventi.
Istruzioni per la configurazione
Configurazione dell’account Fivetran
Per prima cosa è necessario creare un account Fivetran. È disponibile una versione gratuita con un numero limitato di aggiornamenti al mese
Configurazione della destinazione
Quindi, clicca su “Destinazioni” e crea la tua prima destinazione. Si tratta essenzialmente del database o del data warehouse che riceverà i dati delle tabelle Tulip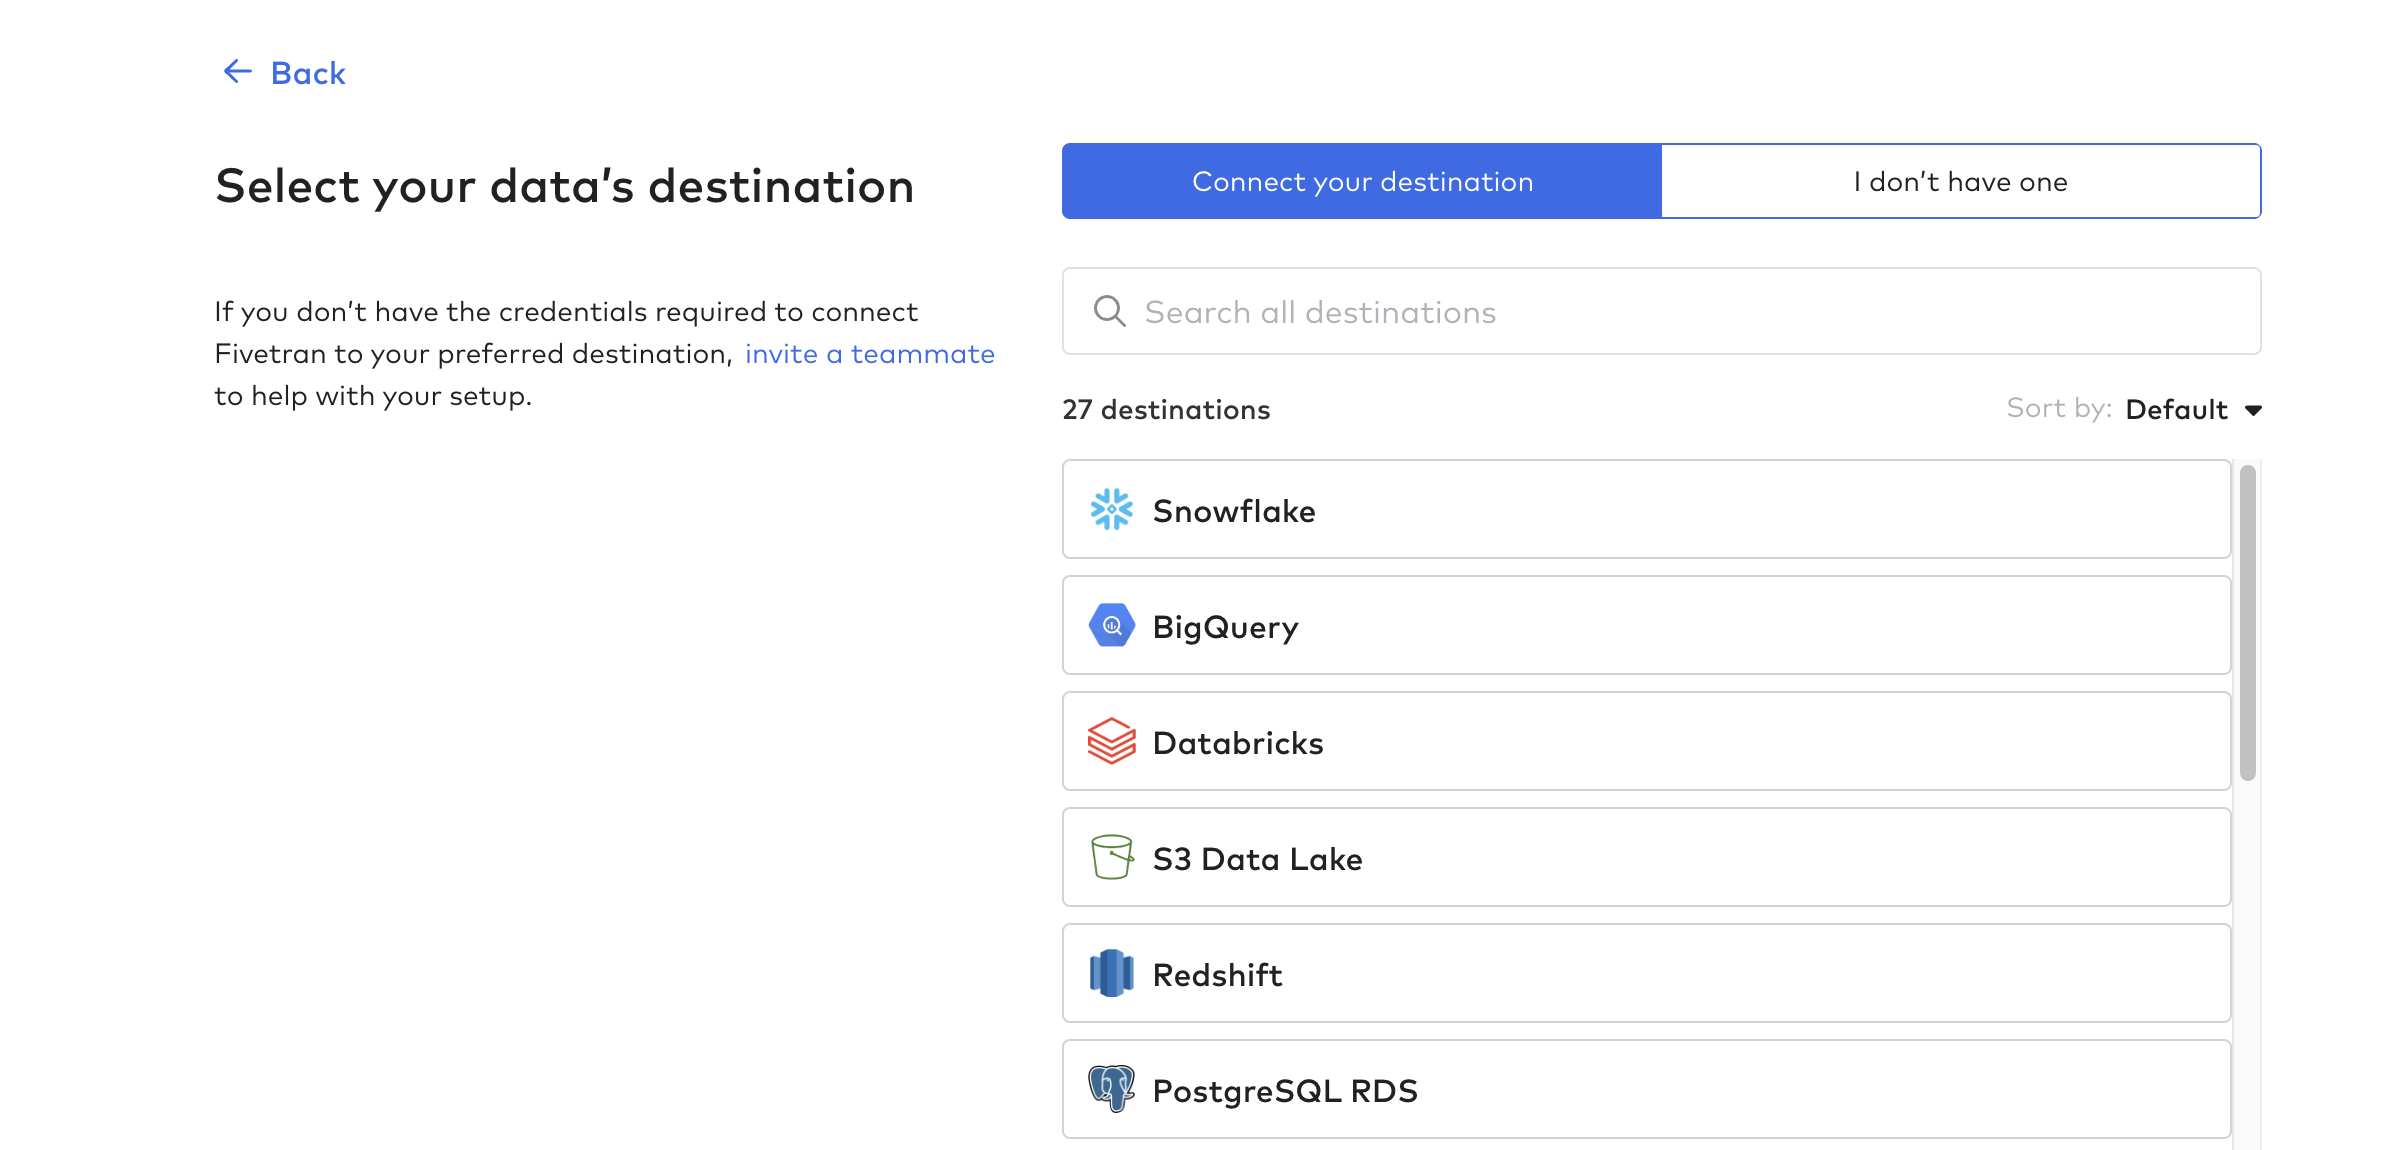
Creazione della funzione di connessione
Crea quindi la funzione di connessione; si tratta del processo per automatizzare la pipeline di dati da Tulip. Puoi utilizzare qualsiasi funzione cloud come AWS Lambda, Azure Functions o GCP Cloud Functions. Per questo esempio, useremo AWS Lambda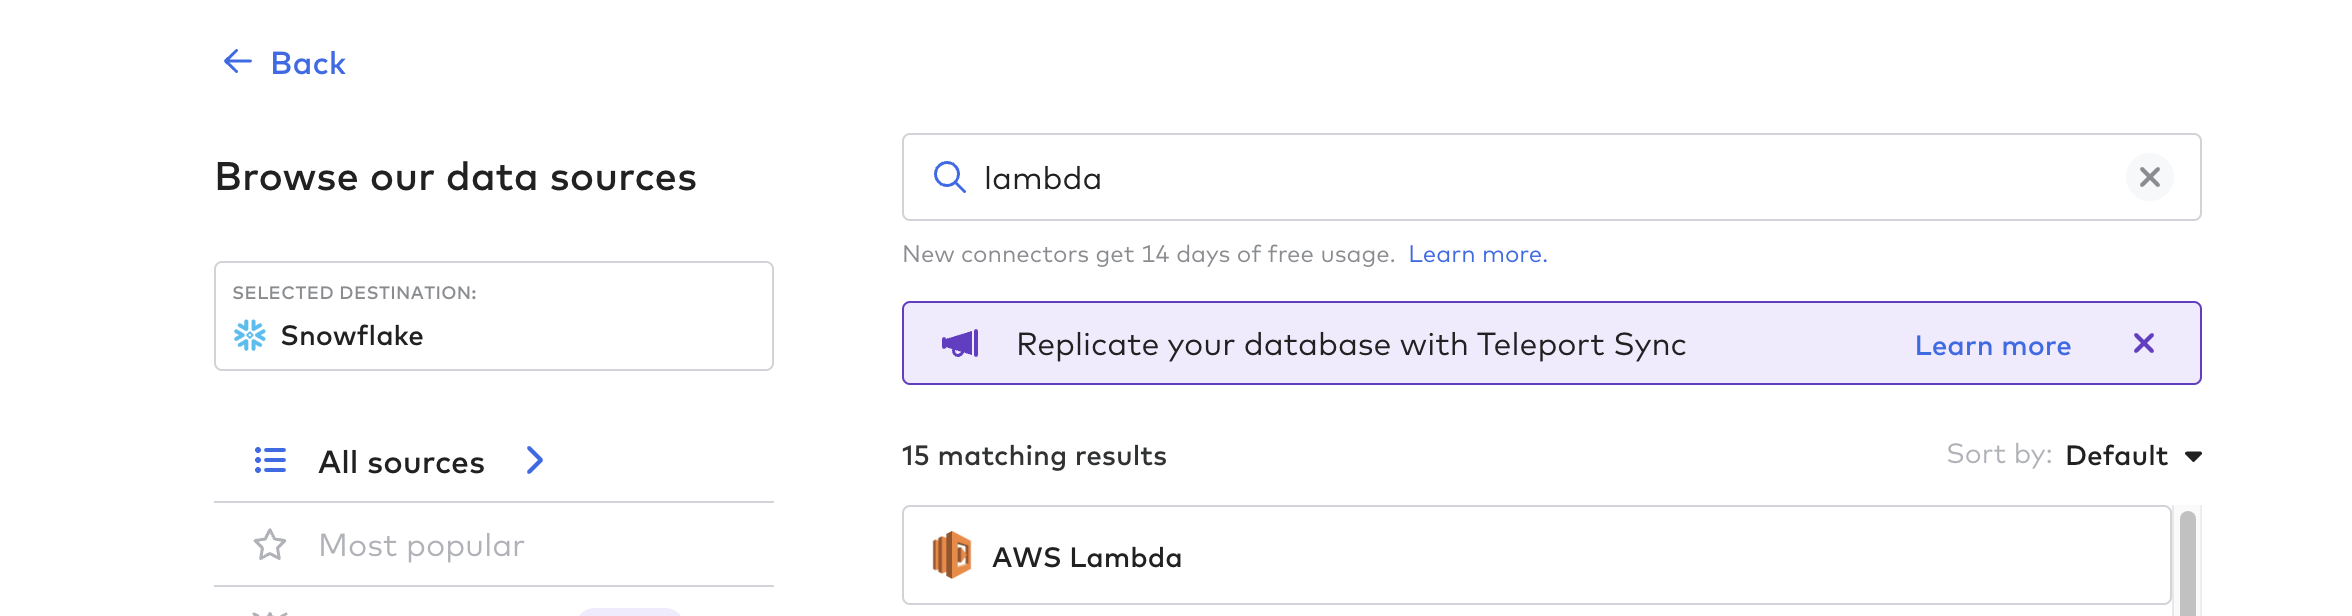
Seguire le istruzioni fornite da Fivetran per la creazione di una funzione Lambda su AWS con i ruoli ele autorizzazioniappropriati. Vedere il link per il modello di funzione Lambda come punto di partenza. Di seguitosono riportati alcuni suggerimenti utili:
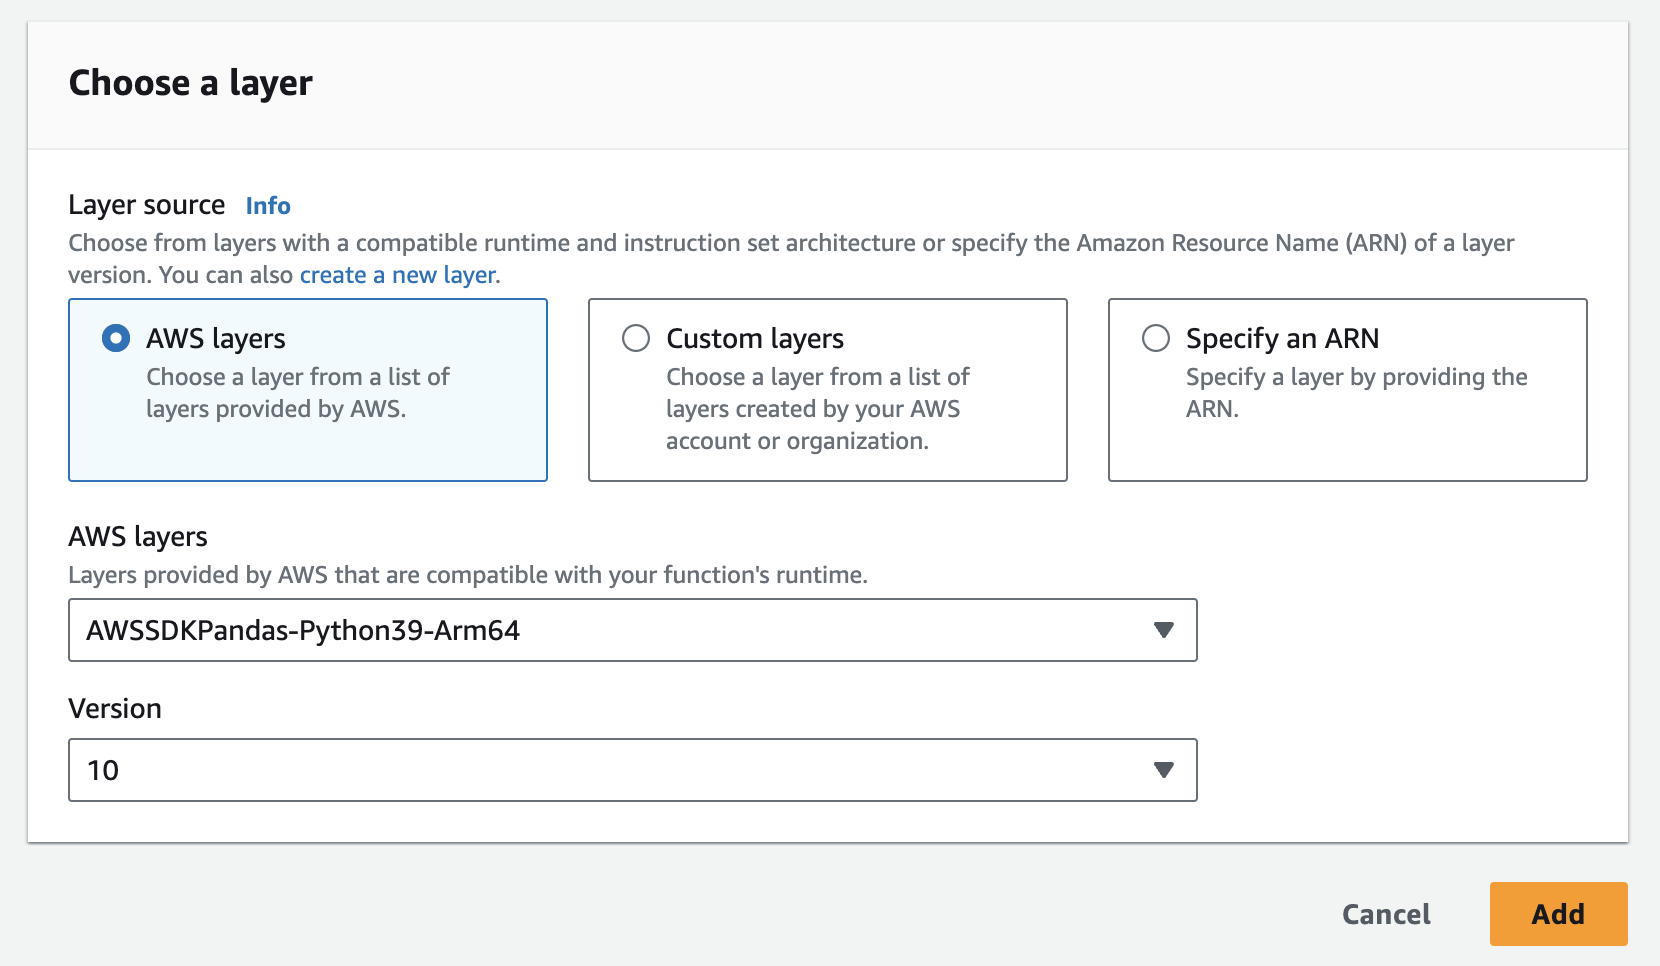
- Dovrai creare due livelli: uno per la libreria Tulip e l’altro per la libreria pandas
- Puoi consultare l’API della comunità Tulip qui
- In alternativa, puoi scaricare il file zip qui (è già stato preparato per essere aggiunto a un livello)
- Puoi aggiungere facilmente il livello pandas in AWS qui sotto
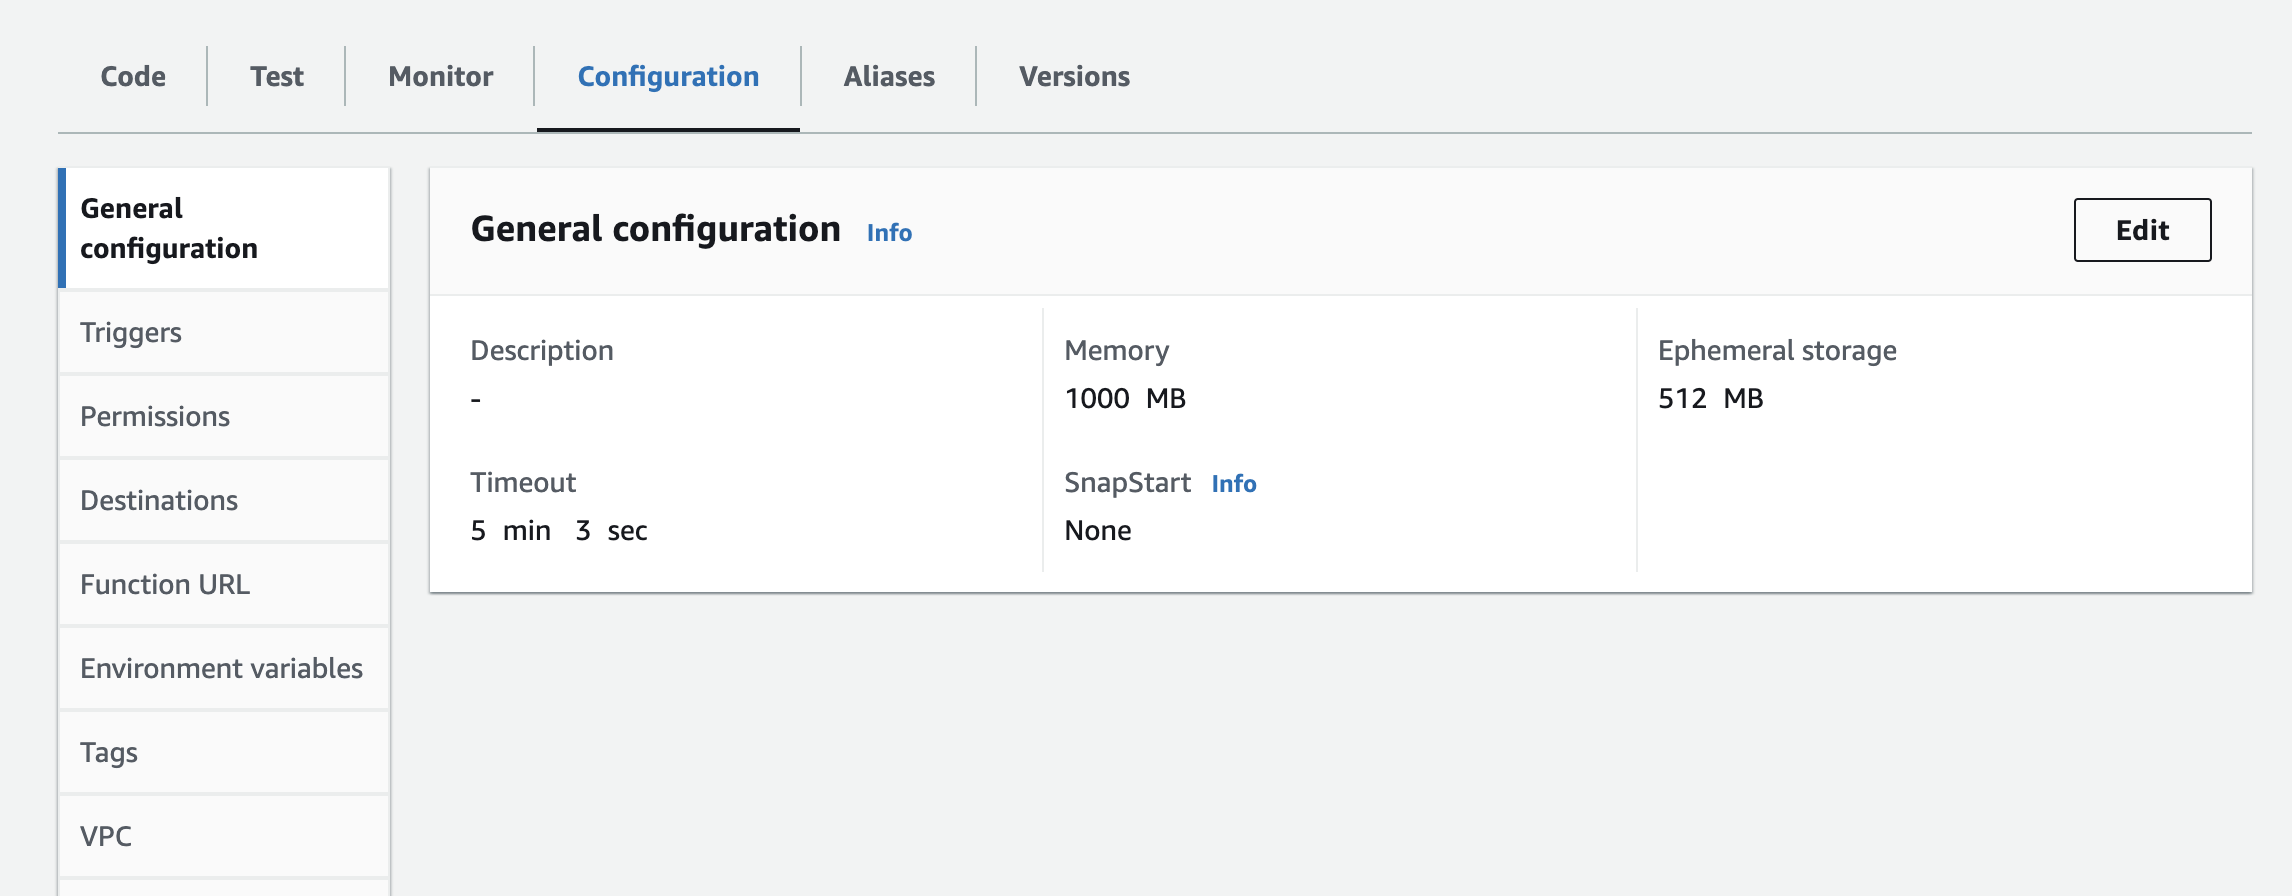
- Dovrete aggiungere l’istanza, la chiave API e il segreto API come variabili d’ambiente alla funzione Lambda. Potrebbe essere necessario aggiornare le impostazioni di runtime per aumentare il tempo di timeout e la memoria utilizzata. Di seguito è riportato uno screenshot per l’aggiornamento della configurazione
Prossimi passi
Una volta che la funzione del connettore è operativa, è possibile regolare la frequenza di aggiornamento, visualizzare le informazioni delle tabelle Tulip nel database di destinazione o nel data warehouse e accedere a ulteriori funzionalità
Alcuni casi d’uso specifici per questa pipeline di dati:* Analisi e elaborazione dei dati Tulip a livello aziendale* Automazioni batch con sistemi aziendali* Contestualizzazione con data warehouse e data lake
Risorse aggiuntive
Contatta Fivetran per ulteriore assistenza quiContattaFivetran per ulteriore assistenza qui*Inoltre, è disponibile un modulo per inviare richieste e suggerimenti per semplificare l’integrazione delle tabelle Tulip. Invia feedback e richieste qui