
:::(Информация) (Демонстрация библиотеки Tulip)
В этом видео представлена пошаговая инструкция по использованию Fivetran + AWS Lambda для регулярного извлечения данных из Tulip table и обновления различных целевых систем, таких как хранилища данных, базы данных, озера данных и т. д.
Оптимизируйте обработку данных в Tulip с помощью интеграции с Fivetran
Цель
Оптимизация конвейеров обработки данных с помощью Tulip позволяет использовать данные из таблиц Tulip в масштабах всего предприятия
Настройка
Для настройки требуется следующее:* Учетная запись Fivetran (доступна бесплатная версия)* AWS (или другая учетная запись в облаке)* База данных или хранилище данных для приема данных из таблиц Tulip* Общие знания языка Python
Как это работает
Настройка этой автоматизации в Fivetran включает следующие шаги:
- Настройте учетную запись Fivetran
- Создание места назначения (например, Snowflake)
- Создание функции-коннектора с помощью AWS Lambda
- Создание функции AWS Lambda
- Завершение настройки функции коннектора
- Протестируйте коннектор Fivetran и настройте частоту обновления
Fivetran использует функцию Lambda для автоматического извлечения данных из таблиц Tulip по расписанию и обновления целевых баз данных или хранилищ данных. Приведенный пример представляет собой простую функцию, которая перезаписывает таблицу новыми, обновленными данными. Для улучшения триггеров, основанных на событиях, можно добавить дополнительные функции.
Инструкции по настройке
Настройка учетной записи Fivetran
Сначала вам необходимо создать учетную запись Fivetran. Сервис предлагает бесплатную версию с ограниченным количеством обновлений в месяц
Настройка места назначения
Затем нажмите «Destinations» (Места назначения) и создайте свое первое место назначения. По сути, это база данных или хранилище данных, которое будет получать данные из таблиц Tulip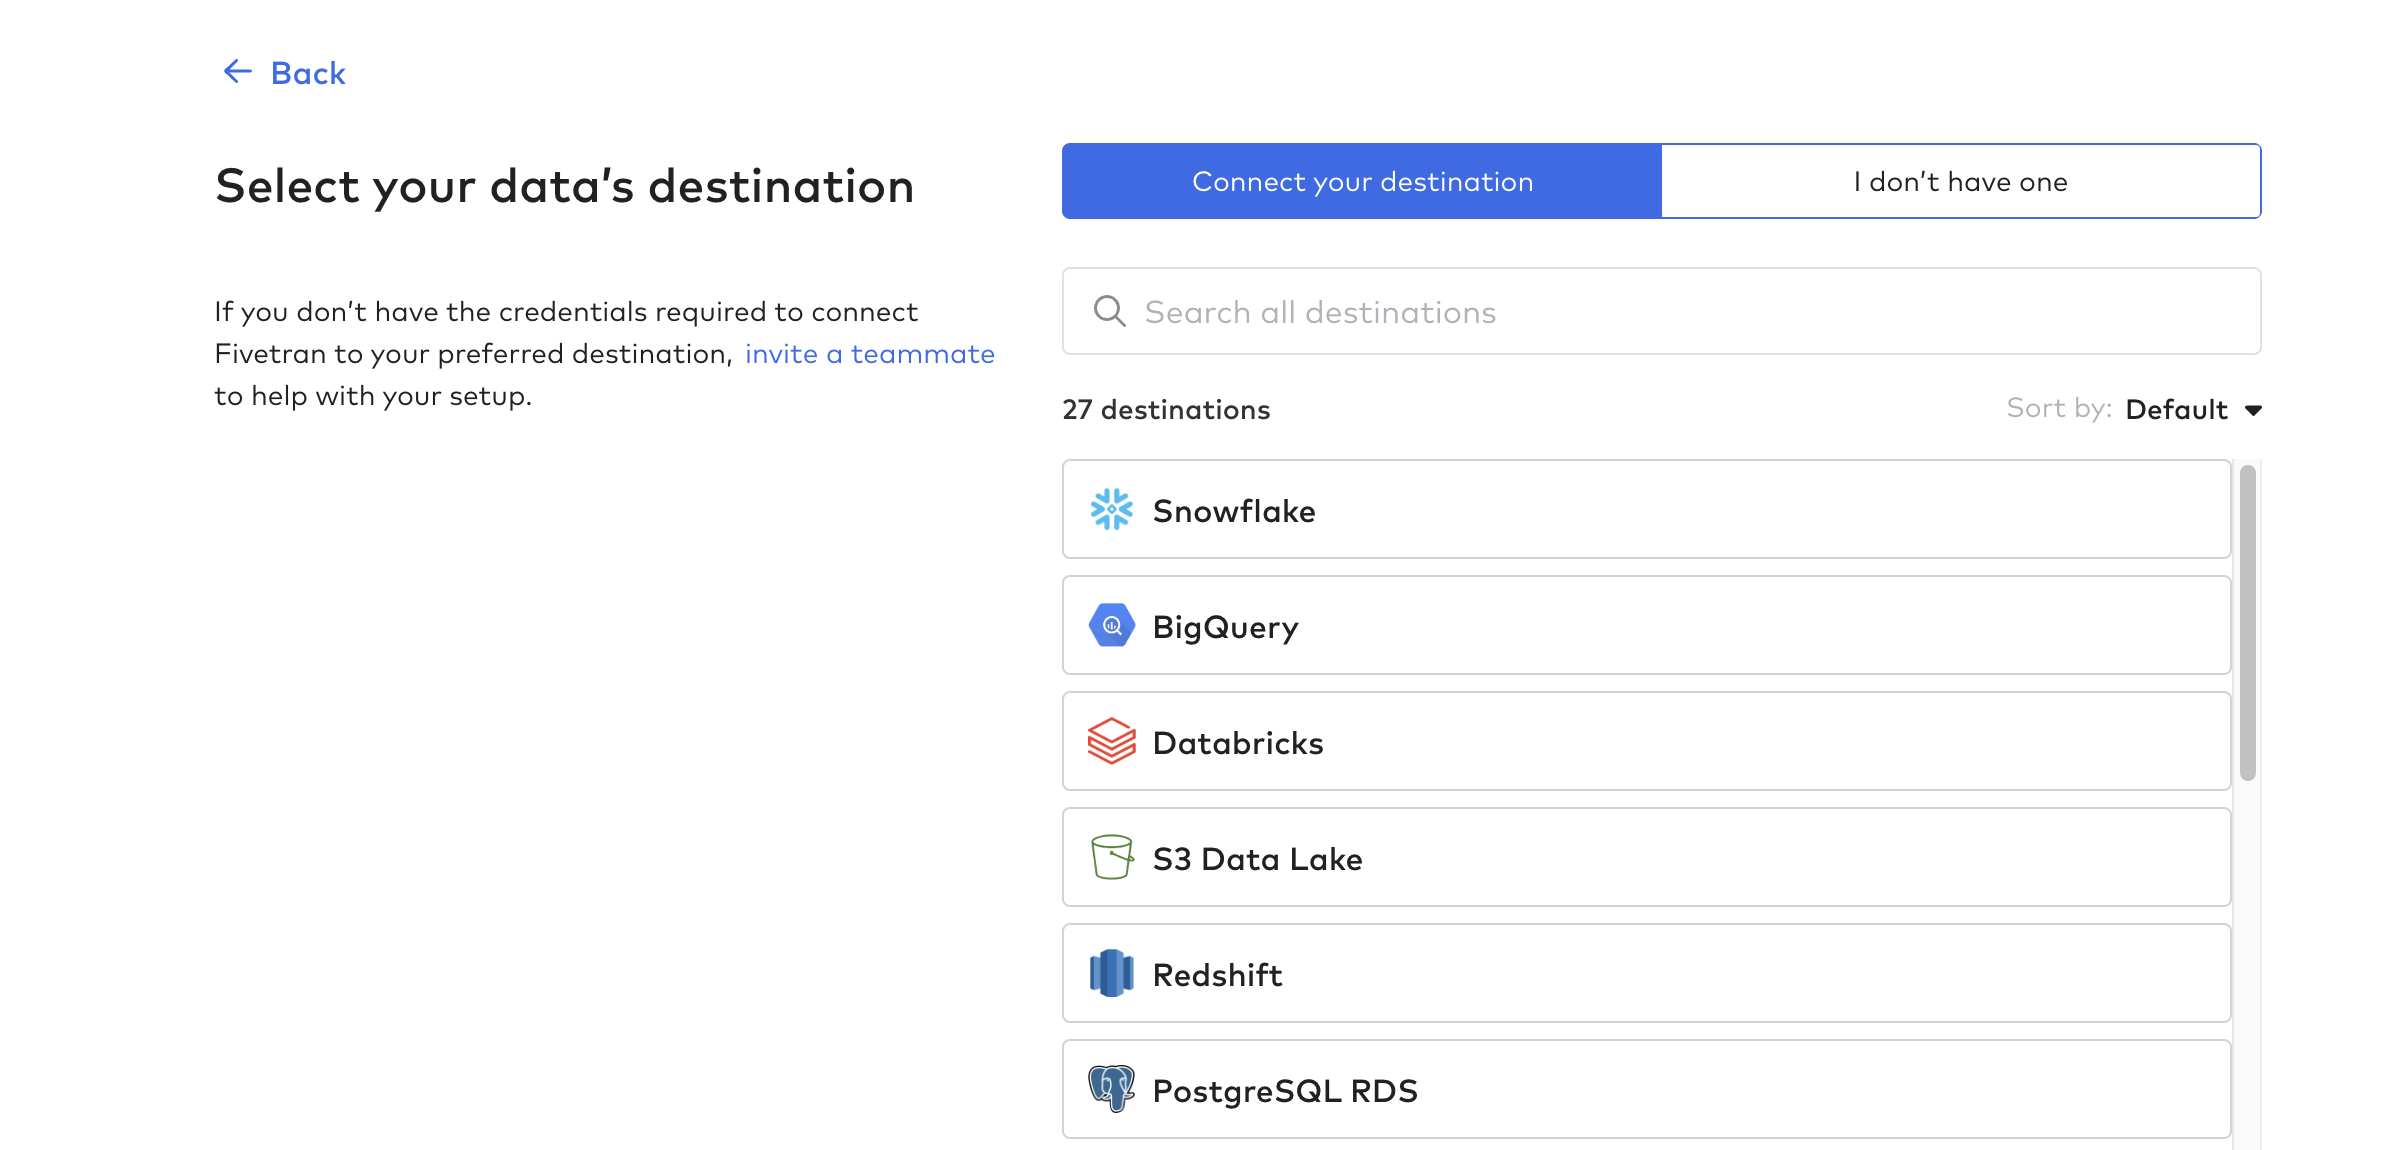
Создание функции коннектора
Затем создайте функцию коннектора; это процесс автоматизации конвейера данных из Tulip. Вы можете использовать любую облачную функцию, такую как AWS Lambda, Azure Functions или GCP Cloud Functions. В этом примере мы будем использовать AWS Lambda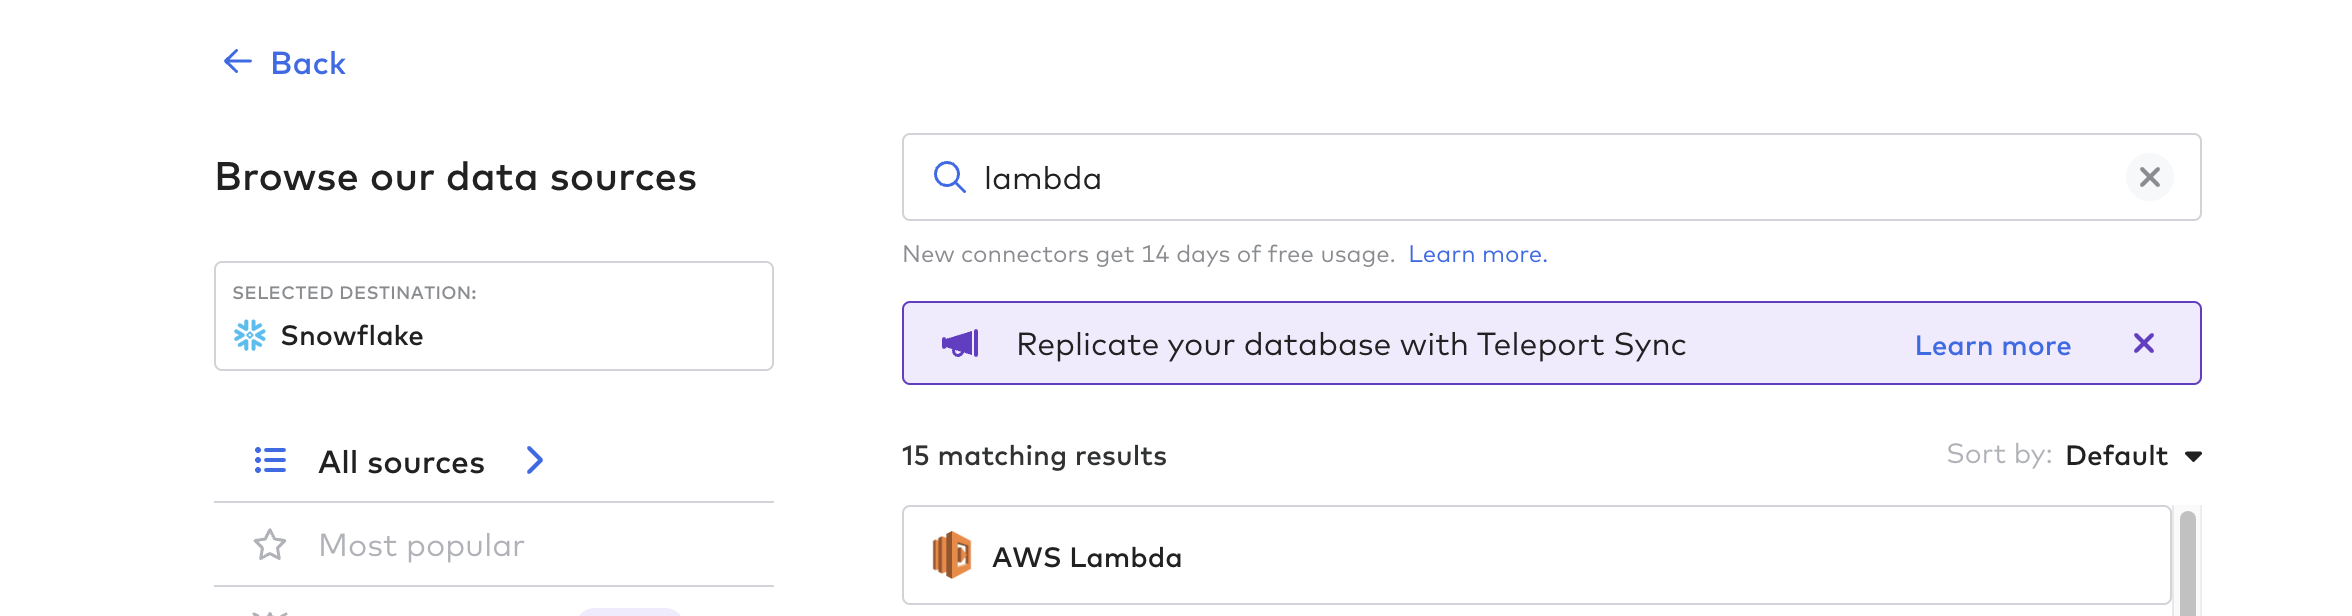
Следуйте инструкциям в Fivetran по созданию функции Lambda в AWS с соответствующими ролями иразрешениями. См. ссылку на шаблон функции Lambda в качестве отправной точки. Нижеприведены несколько полезных советов:
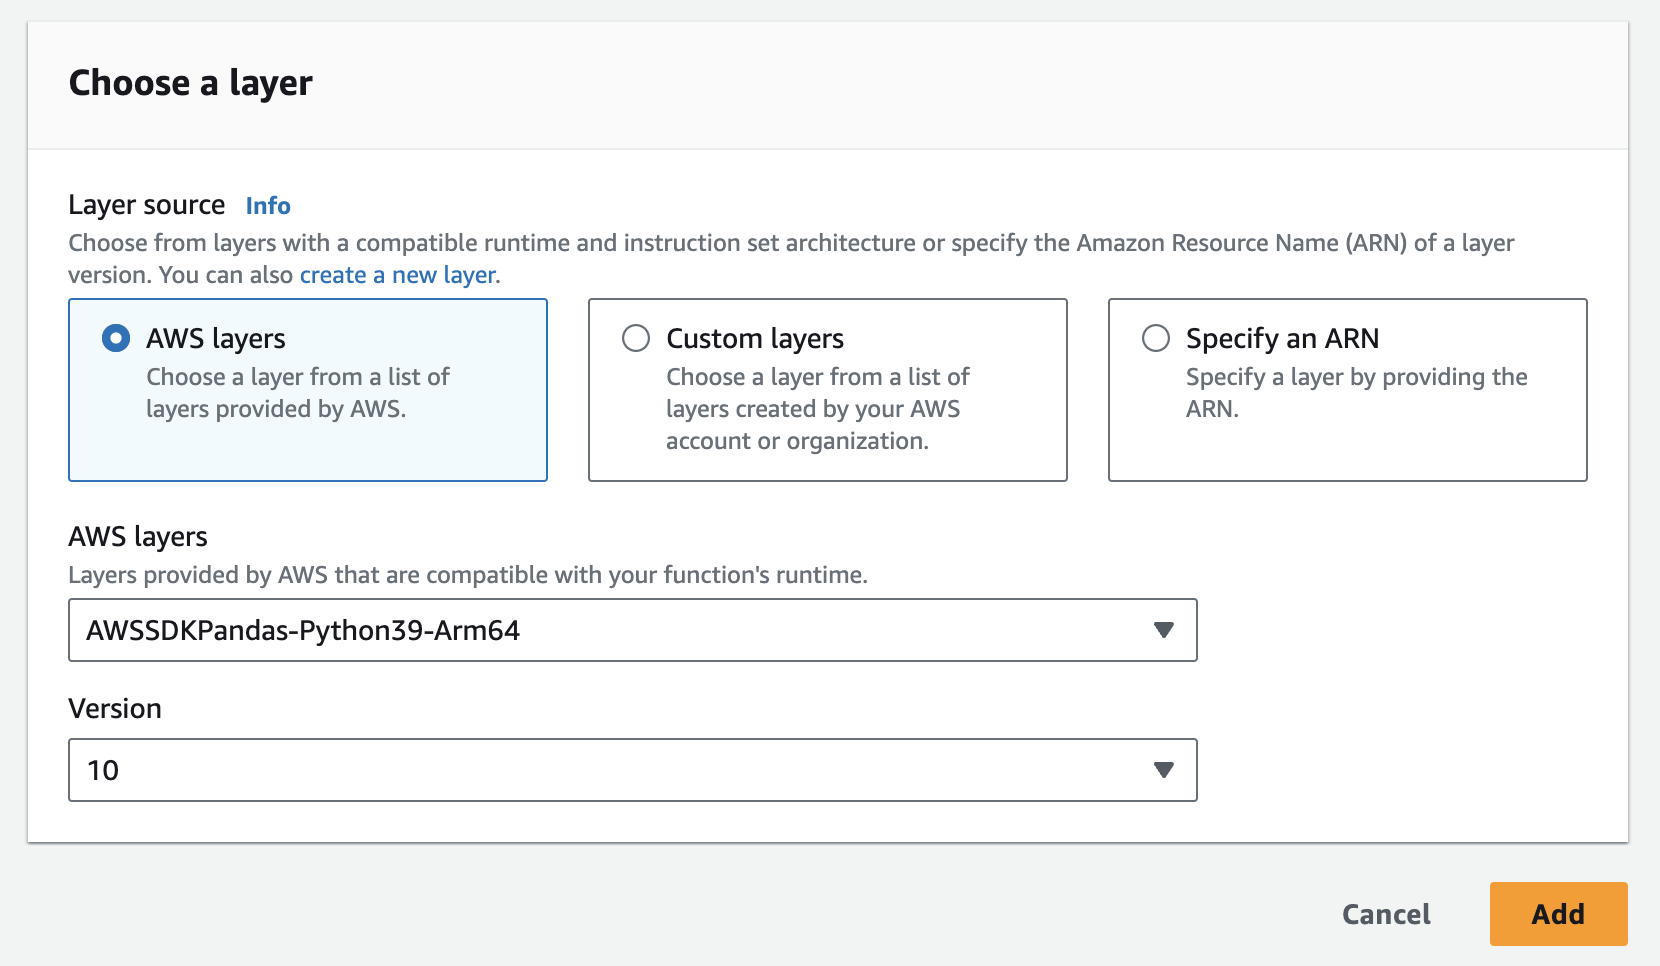
- Вам нужно будет создать два уровня: один — для библиотеки Tulip, другой — для библиотеки pandas
- Вы можете ознакомиться с API сообщества Tulip здесь
- В качестве альтернативы вы можете скачать ZIP-файл здесь (он уже подготовлен для добавления в слой)
- Вы можете легко добавить слой pandas в AWS по ссылке ниже:
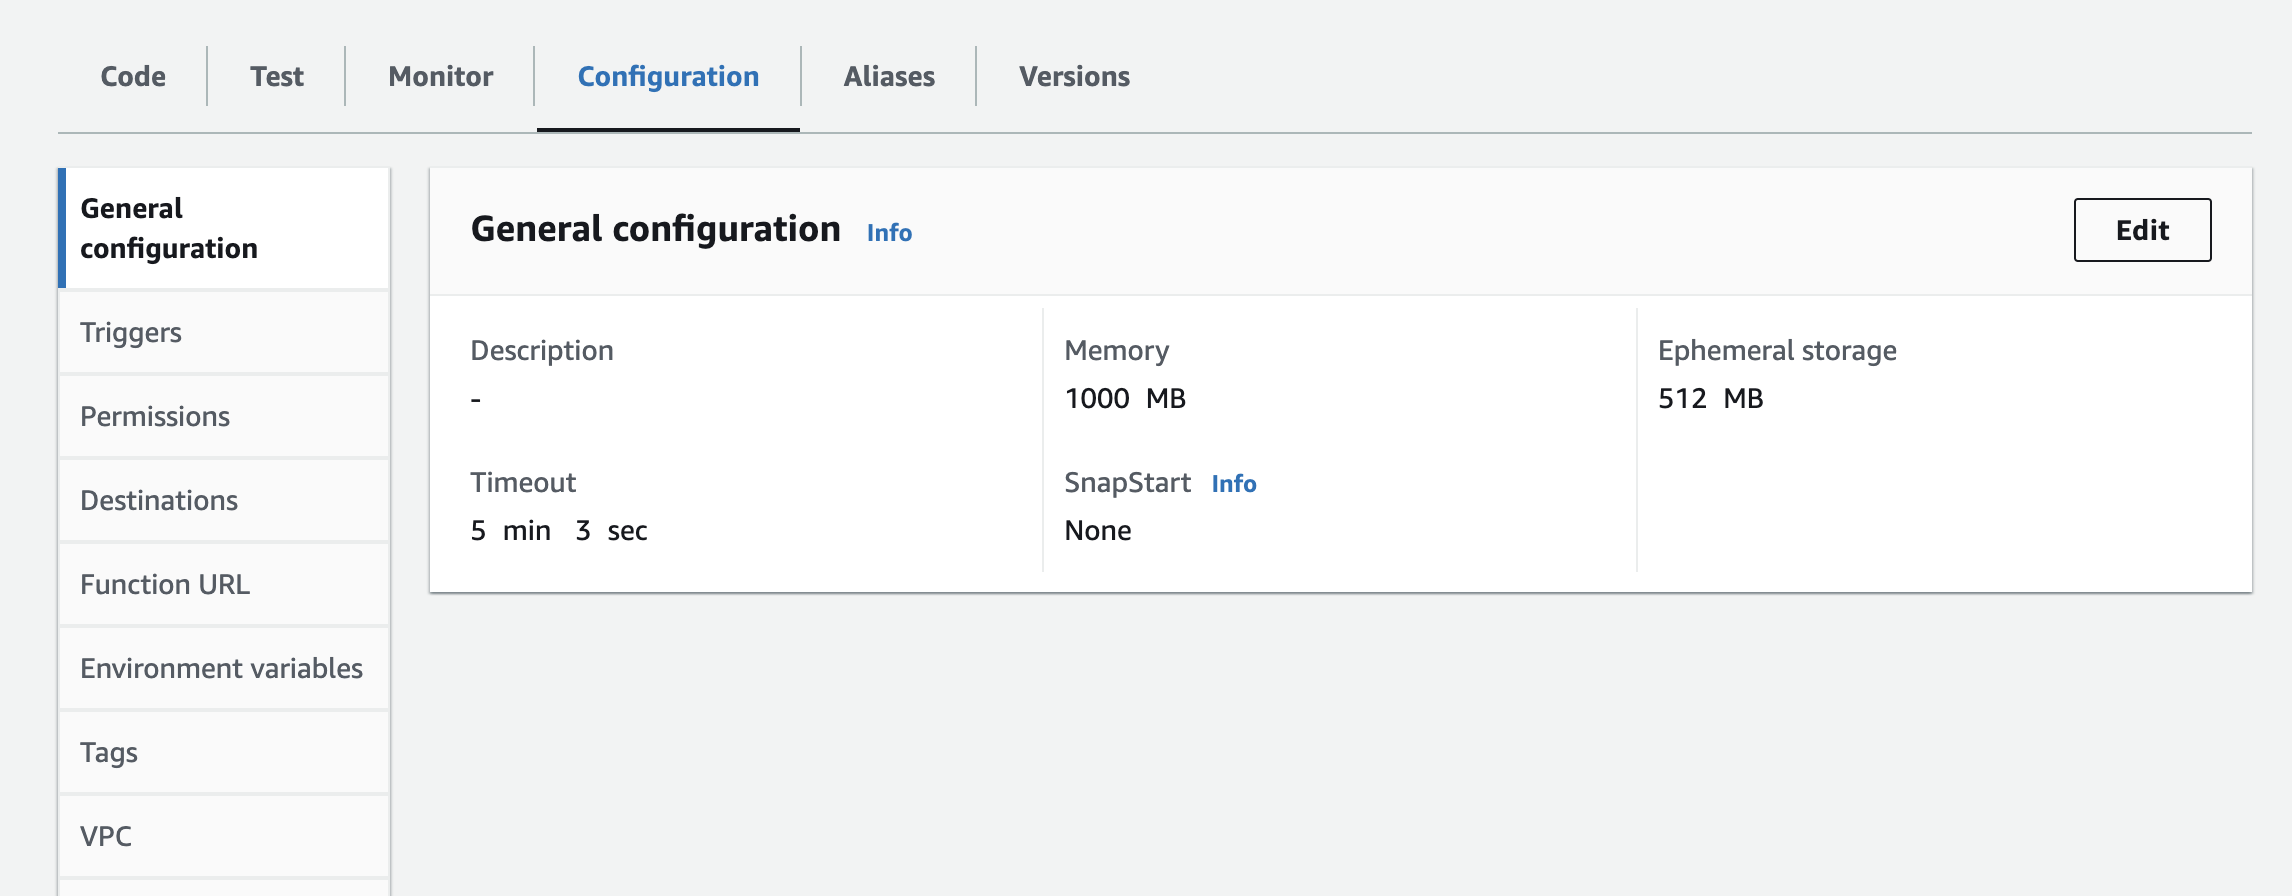
- Вам нужно будет добавить экземпляр, ключ API и секретный ключ API в качестве переменных среды для функции Lambda. Возможно, вам придется обновить настройки среды выполнения, чтобы увеличить время ожидания и объем используемой памяти. Снимок экрана с обновлением конфигурации приведен ниже:
Следующие шаги
Как только функция коннектора заработает, вы сможете настроить частоту обновления, просматривать информацию о таблицах Tulip в целевой базе данных или хранилище данных, а также использовать дополнительные функции
Некоторые конкретные сценарии использования этого конвейера данных:* Аналитика и обработка данных Tulip на корпоративном уровне* Автоматизация пакетной обработки с корпоративными системами* Контекстуализация с использованием хранилищ данных и озер данных
Дополнительные ресурсы
Обратитесь в Fivetran за дополнительной поддержкой здесь.Обратитесь в Fivetran за дополнительной поддержкой здесь. *Кроме того, они предоставили форму для внесения изменений и отправки запросов по упрощённой интеграции таблиц Tulip. Оставьте отзыв и отправьте запрос здесь