
:::(信息) (Tulip Library 演示)
本视频详细演示了如何使用 Fivetran + AWS Lambda 按计划从Tulip table 获取数据,并更新数据仓库、数据库、数据湖等多种目标系统
Fivetran 集成
:::
通过 Fivetran 集成优化 Tulip 数据工程
目的
通过 Tulip 优化数据工程管道,可在整个企业范围内利用 Tulip 表中的数据
设置
配置需要以下条件:* Fivetran 账户(提供免费版本)* AWS(或其他云服务账户)* 用于接收 Tulip 表数据的数据库或数据仓库* 具备 Python 的基础知识
工作原理
此 Fivetran 自动化配置的设置流程如下:
- 创建 Fivetran 账户
- 创建目标(例如 Snowflake)
- 使用 AWS Lambda 函数创建连接器函数
- 创建 AWS Lambda 函数
- 完成连接器函数配置
- 测试 Fivetran 连接器并调整刷新频率
Fivetran 利用 Lambda 函数按计划自动获取 Tulip 表中的数据,并更新目标数据库或数据仓库。此处提供的示例是一个简单的函数,它会使用新的、已刷新数据重写该表。还可以添加额外功能,以改进基于事件的触发机制。
设置说明
设置 Fivetran 账户
首先,您需要创建一个 Fivetran 账户。该平台提供免费版本,但每月刷新次数有限
设置目标
然后,点击“目标”并创建您的第一个目标。这实际上就是将接收 Tulip 表数据的数据库或数据仓库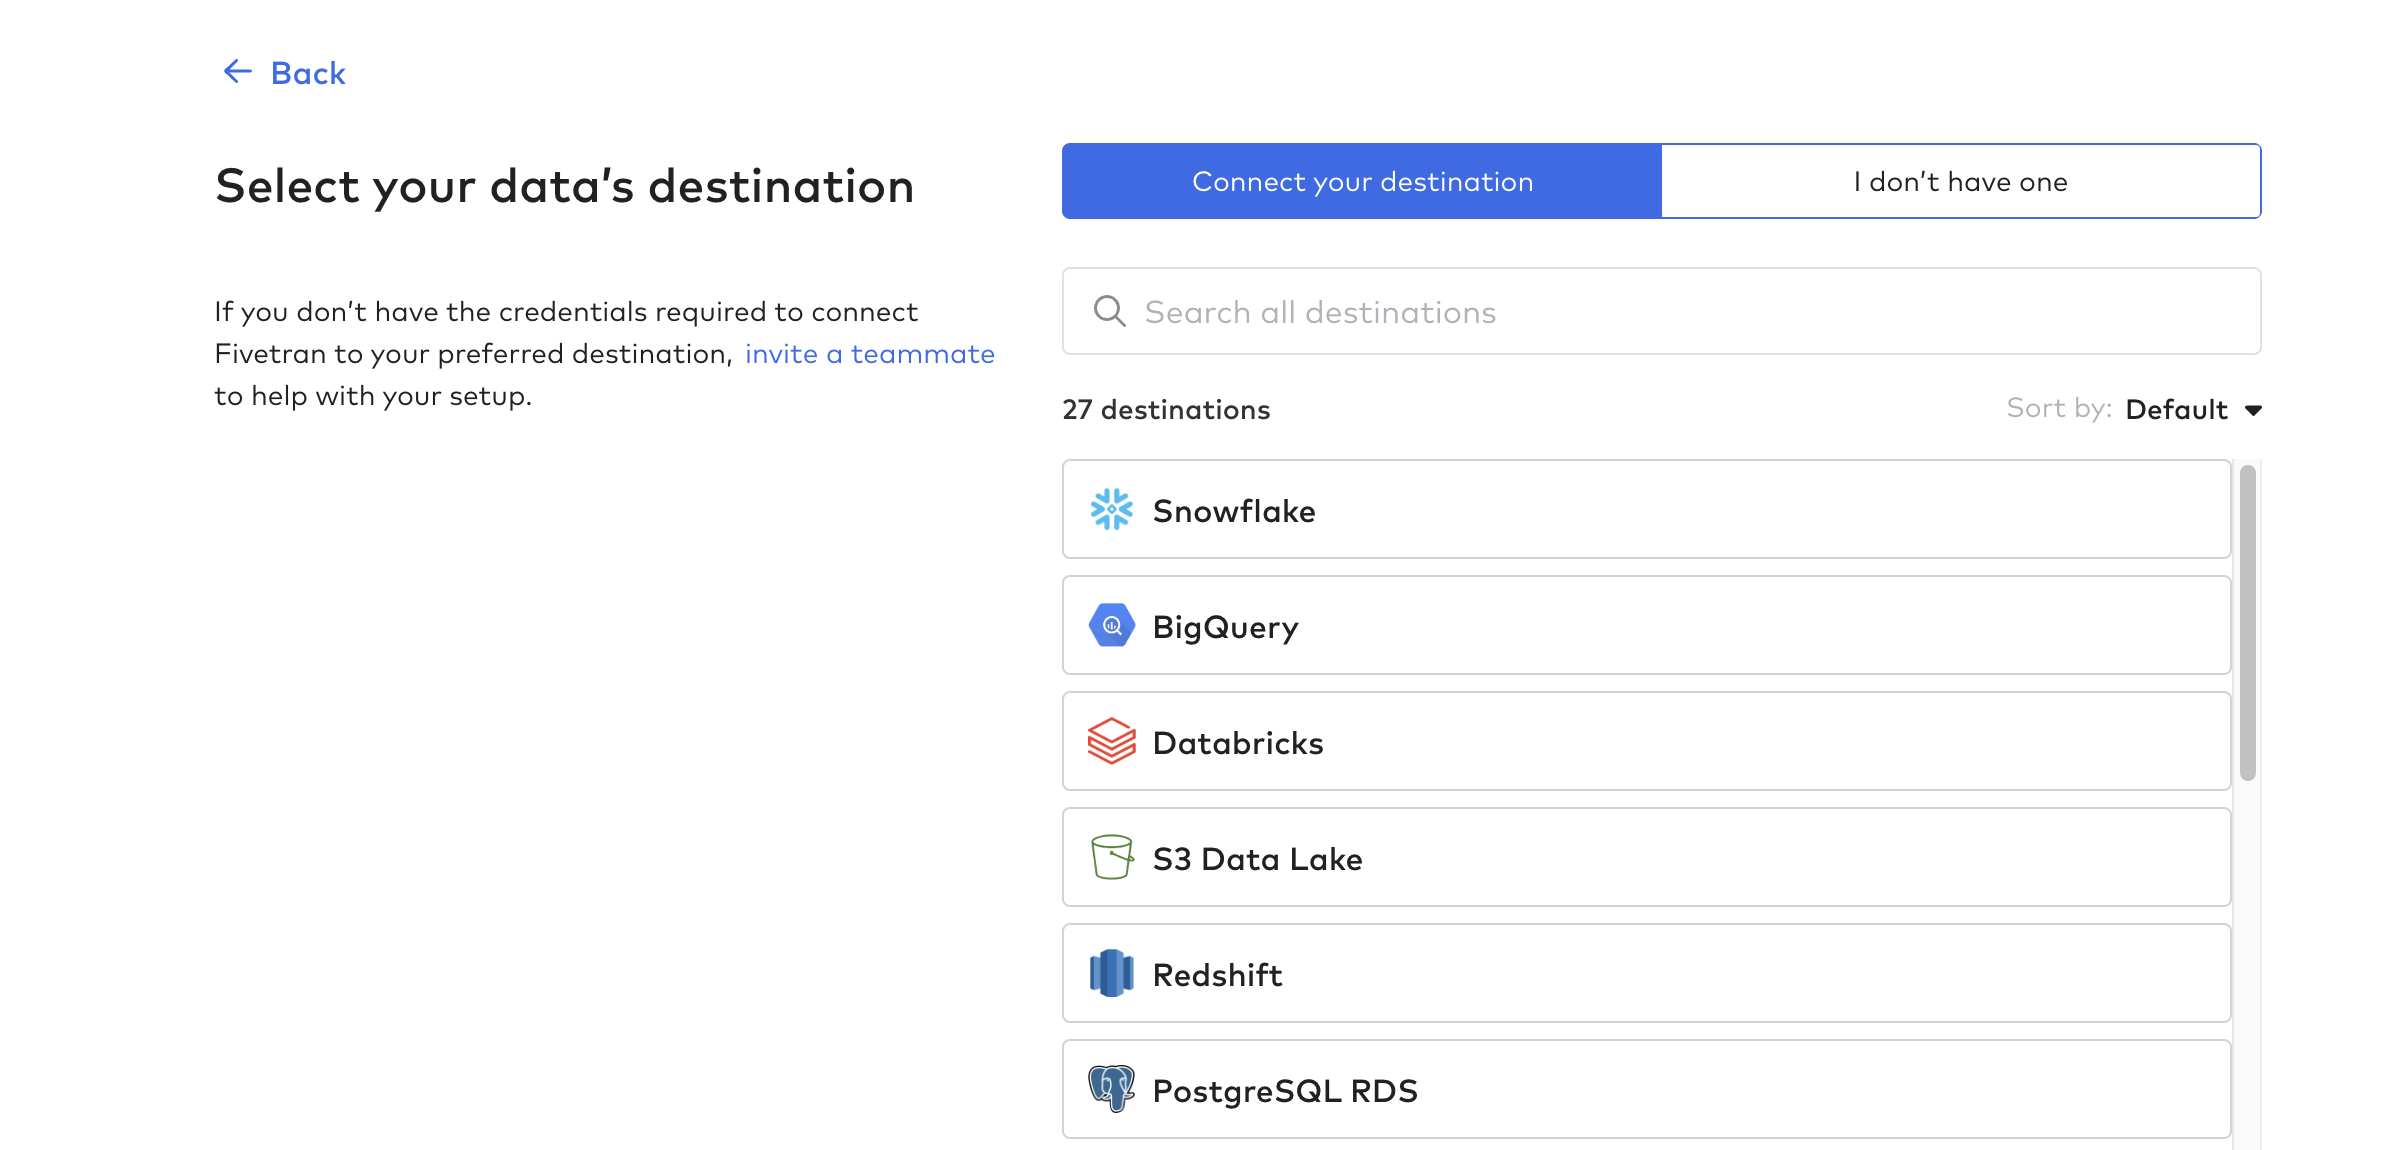
创建连接器函数
接着,创建连接器函数;这是实现从 Tulip 自动化数据管道的过程。您可以使用任何云函数,例如 AWS Lambda、Azure Functions 或 GCP Cloud Functions。在本示例中,我们将使用 AWS Lambda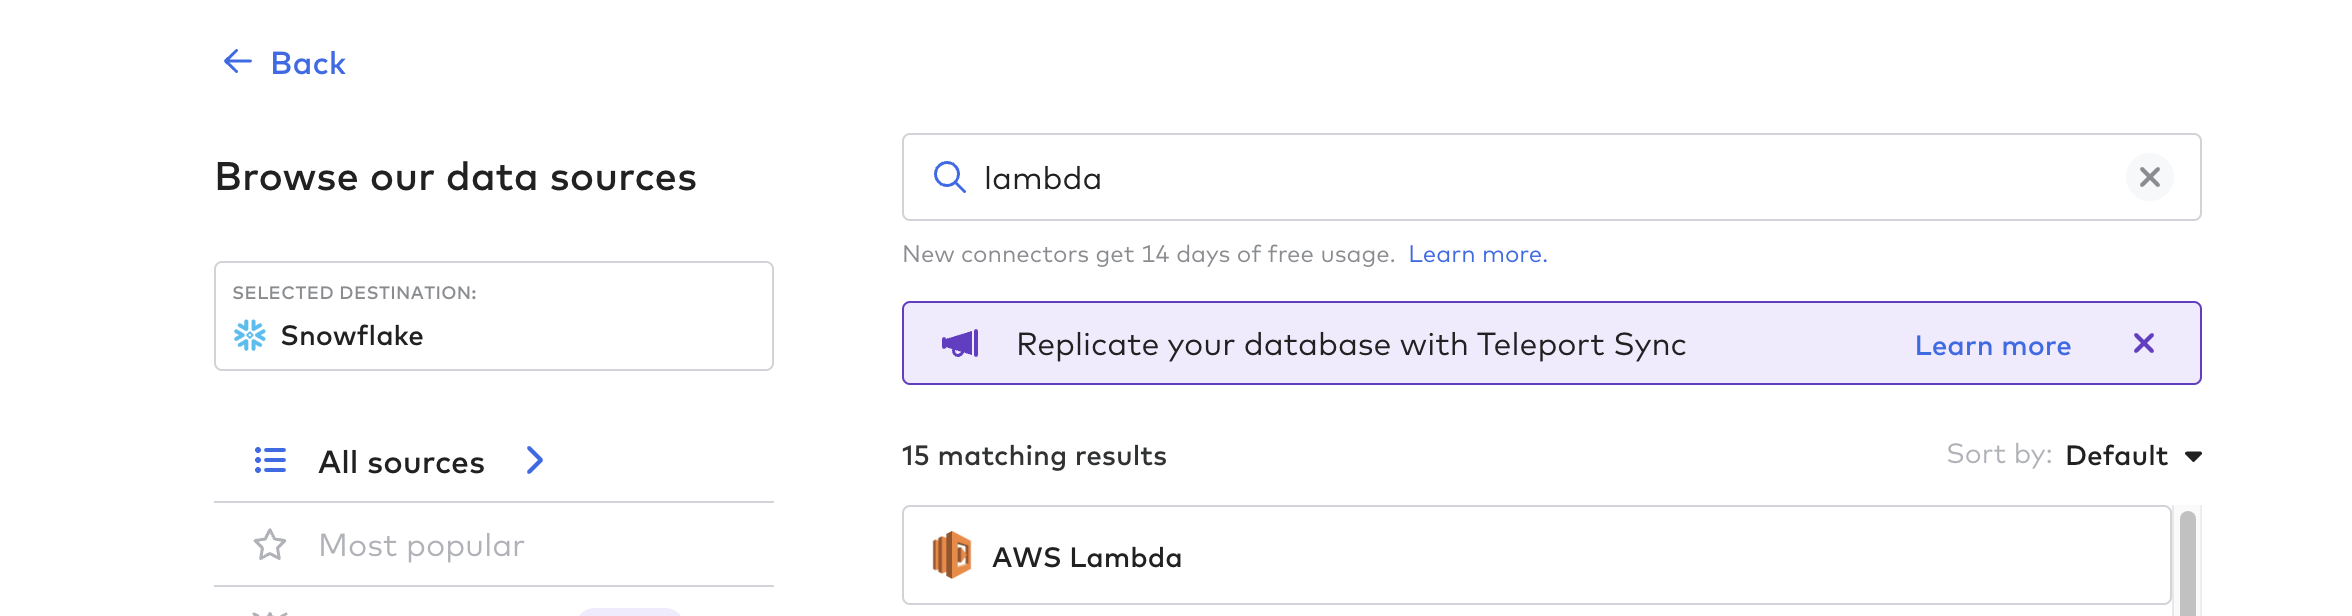
请按照 Fivetran 中的说明,在 AWS 上创建 Lambda 函数并配置相应的角色和权限。请参阅链接中的 Lambda 函数模板作为起点。以下是一些有用的提示:
- 您需要创建两个层:一个用于 tulip 库,另一个用于 pandas 库
- 您可以在此处查看Tulip 社区 API
- 您也可以在此处下载ZIP 文件(该文件已预先处理,可直接添加到层中)
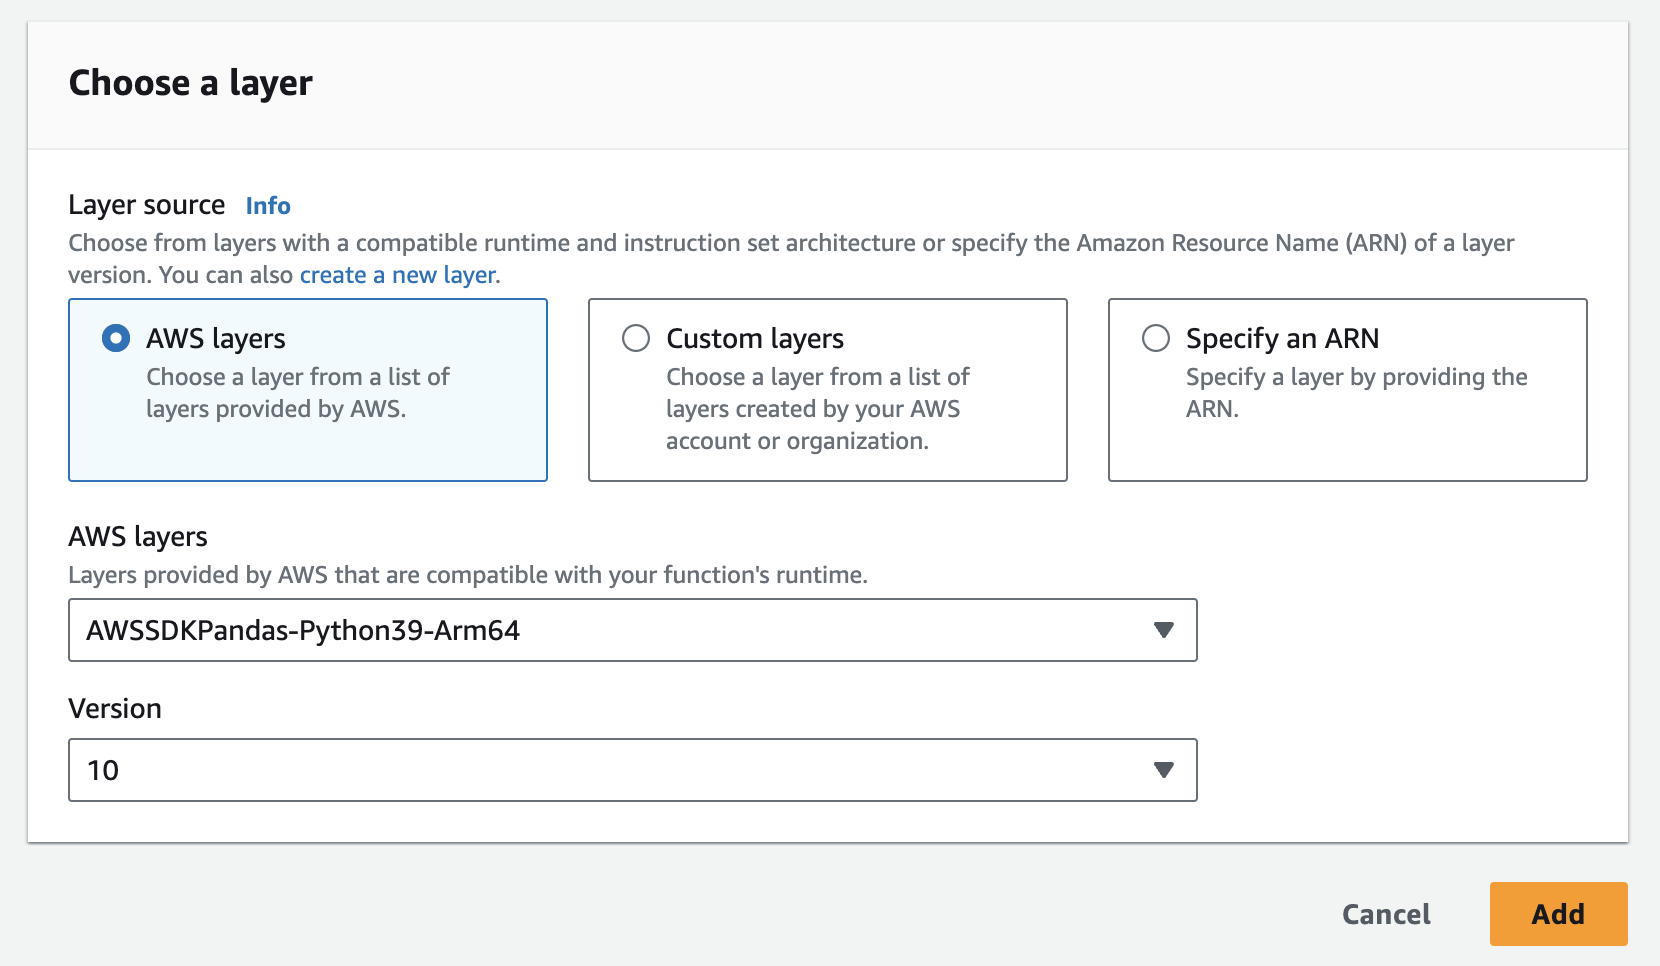
- 您可以在 AWS 中轻松添加 pandas 层,如下所示:
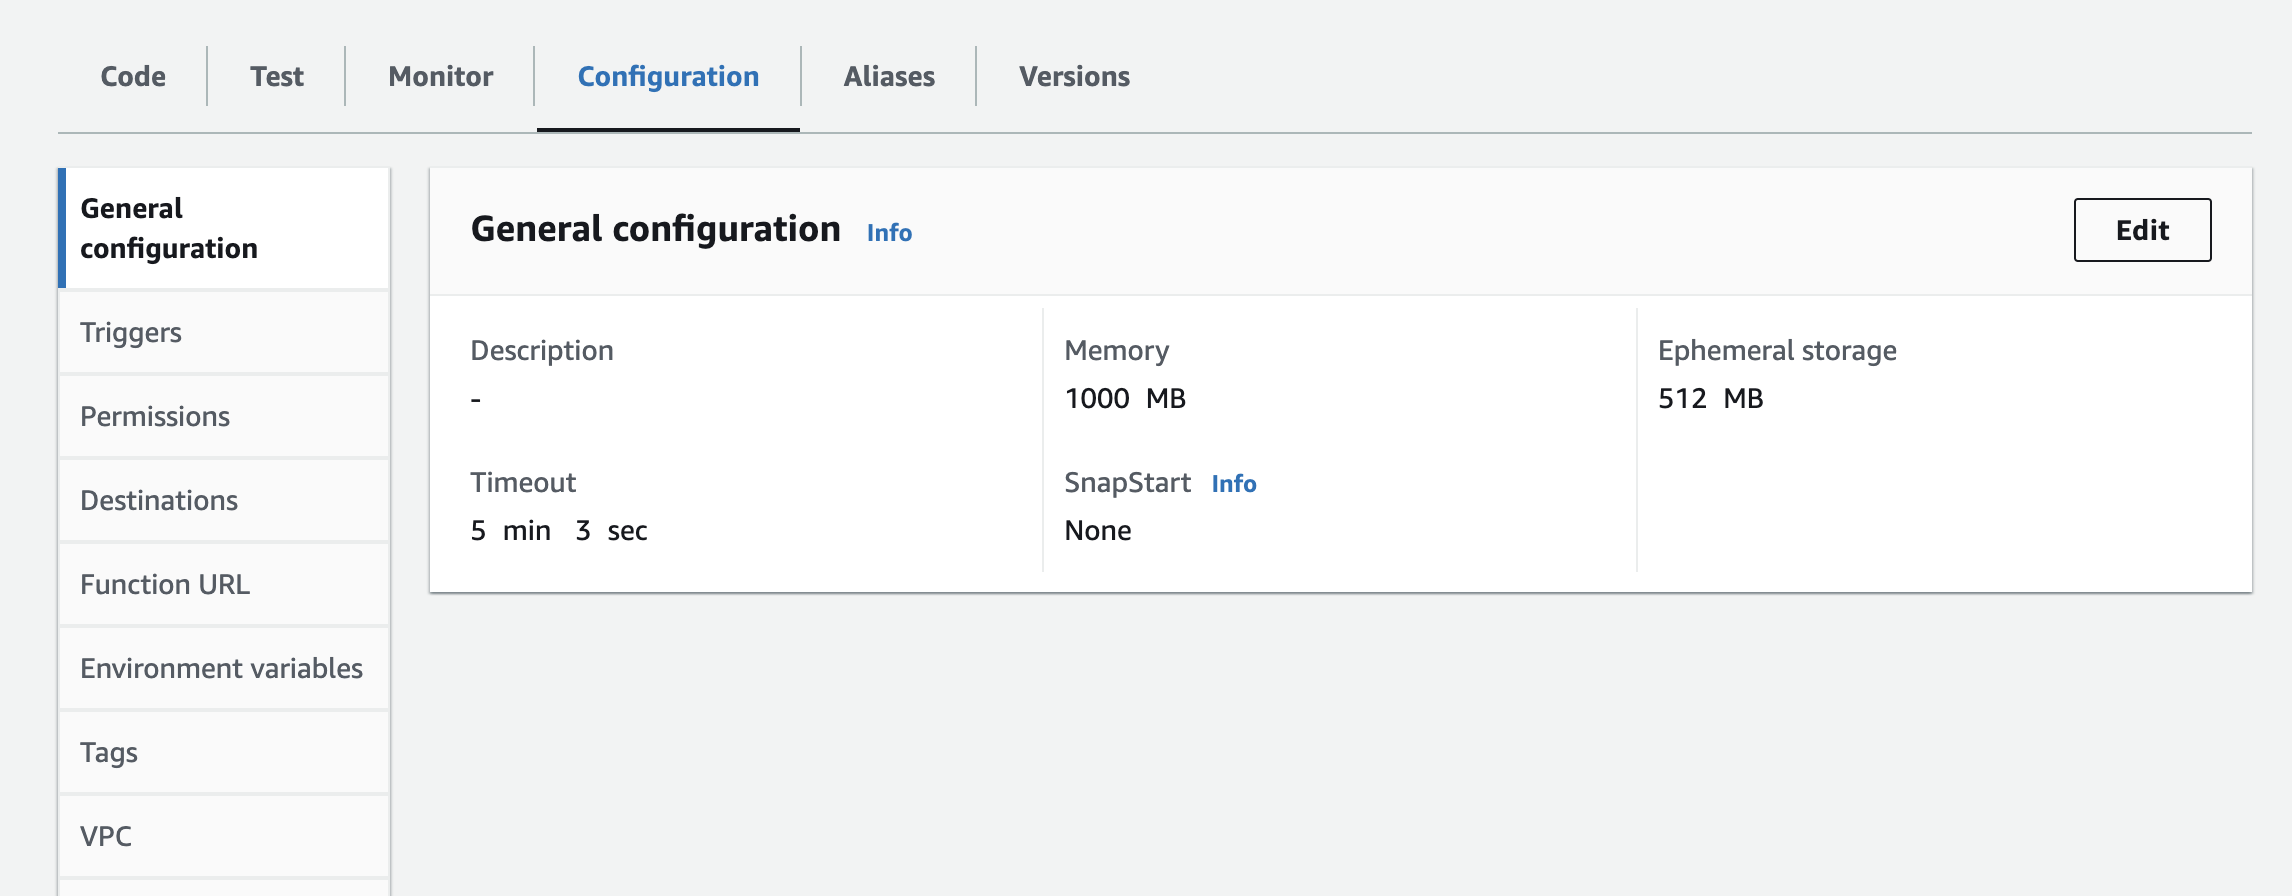
- 您需要将实例、API 密钥和 API 密钥密文作为环境变量添加到 Lambda 函数中。您可能需要更新运行时设置以延长超时时间并增加内存使用量。下图展示了更新配置的截图:
后续步骤
一旦连接器函数正常运行,您就可以调整刷新频率、查看目标数据库或数据仓库中的 Tulip 表信息,并使用更多功能
此数据管道的一些具体用例:* Tulip 数据的企业级分析和数据处理* 与企业系统的批处理自动化* 与数据仓库和数据湖的上下文关联
其他资源
点击此处联系 Fivetran 获取更多支持点击此处联系Fivetran 获取更多支持*此外,他们还提供了一份表单,用于针对简化的 Tulip 表集成进行调整和提交请求。请在此处提供反馈并提交请求