

Die Trigger-Aktion „Text aus Bild extrahieren“ extrahiert Text aus einem Bild auf der Grundlage einer Abfrage. Man könnte dies auch als „abfragebasierte OCR (optische Zeichenerkennung)“ oder „Text aus einem Bild extrahieren, indem man danach fragt“ beschreiben.
Der Trigger gibt stets nur Text zurück, der tatsächlich im Bild vorhanden ist. Er fügt keine zusätzlichen Informationen oder Interpretationen hinzu. Dies macht ihn zu einem sehr leistungsstarken Werkzeug für die Übertragung von Daten aus der physischen in die digitale Welt.
Beispiel-Anwendungsfälle:
- Daten aus einem Bestellformular eines externen Anbieters erfassen. Vergessen Sie die manuelle Übertragung dieser 14-stelligen Bestellnummer aus einer Lieferantenrechnung in Ihr WMS – kombinieren Sie eine einfache App mit „Text aus Bild extrahieren“, um diese Daten in Sekundenschnelle zu übernehmen.
- Digitalisieren Sie Papierformulare. Die Daten auf bestehenden Papierbelegen sind noch wertvoller, wenn sie innerhalb von Tulip-Apps abgerufen werden können. „Text aus Bild extrahieren“-Aktionen sind ein hervorragendes Mittel, um eine Brücke zwischen der physischen und der digitalen Welt zu schlagen.
- Arbeiten Sie zuverlässig mit Texten in Sprachen, die Ihren Mitarbeitern fremd sind. Die Fertigungswelt ist global – geben Sie Ihren Mitarbeitern Superkräfte, indem Sie die Trigger-Aktionen „Text aus Bild extrahieren“ und „Übersetzen“ kombinieren, um papierbasierte Informationen in etwas umzuwandeln, auf das Ihre Mitarbeiter reagieren können.
Beispiel für einen Trigger
Nutzen Sie eine mobile App, um ein Foto eines Etiketts auf einem Produkt aufzunehmen und so die Chargennummer zu ermitteln.
| Bild | Trigger | Ergebnis |
|---|---|---|
| image.png{height="" width="400"} | image.png{height="" width="400"} | 11EP8F4WA58CCX |
Wert aus Bild extrahieren
Ein- und Ausgänge
Die Trigger-Aktion verfügt über zwei Eingaben, „Eingabebild“ und „Abfrage“, sowie eine Ausgabe, den extrahierten Text.
Eingabe: Eingabebild
Dies ist das Bild, aus dem der Text extrahiert werden soll. Es kann vom Kamera-Eingabe-Widget, von Tulip Vision oder von externen Systemen stammen.
| Unterstützter Datentyp | |
|---|---|
| Eingabe | Bild-URL |
Eingabe: Abfrage
Dies ist die Suchanfrage, die zum Extrahieren des Textes aus dem Bild oder Dokument verwendet wird.
Bewährte Vorgehensweisen für Abfragen:* Verwenden Sie nach Möglichkeit Wörter aus dem Dokument. Dies ist besonders hilfreich bei Akronymen und Abkürzungen (z. B. SN, ID, SSN, Lot-Nr. usw.). Die Trigger-Aktionen zum Extrahieren von Text unterstützen weniger komplexe Abfragen als die Trigger-Aktionen „Frage aus Daten/Dokument beantworten“. * Beispiel für eine gute Eingabe: „Wer ist der Lieferant?“ * Beispiel für eine schlechte Eingabe: „Was glaubst du, wer uns das geschickt haben könnte?“* Die Angabe des Ortes, an dem sich die Informationen befinden, kann ebenfalls hilfreich sein (z. B. „Wie lautet die Referenznummer unten?“)
| Unterstützte Datentypen | |
|---|---|
| Eingabe | Text |
Ausgabe: extrahierter Text
Dies ist der Text, der basierend auf der Abfrage aus dem Bild extrahiert wurde.
| Unterstützter Datentyp | |
|---|---|
| Ausgabe | Text |
Werte aus Bild/Dokument extrahieren
Extracting values from documents is a relatively slow operation. We limit documents to 10 pages to limit execution time.
„Werte aus Bild/Dokument extrahieren“ funktioniert genau wie „Wert aus Bild extrahieren“, unterstützt jedoch eine Reihe von Fragen. Dies ist deutlich leistungsfähiger als die Ausführung der Trigger-Aktion „Wert aus Bild extrahieren“.
Eingabe: Eingabebild/-dokument
Dies ist das Bild, aus dem der Text extrahiert werden soll. Es kann aus dem Kamera-Eingabe-Widget, von Tulip Vision oder aus externen Systemen stammen. Bei Dateien kann dies statisch festgelegt, über das Datei-Eingabe-Widget eingegeben oder auf in Tabellen gespeicherte Dateien verwiesen werden.
| Unterstützte Datentypen | |
|---|---|
| Eingabe | Bild-URL |
Eingabe: Abfrage
Dies ist die Abfrage, die zum Extrahieren des Textes aus dem Bild verwendet wird. Dabei sollte es sich um ein Array bzw. eine Liste von Textwerten handeln.
| Unterstützter Datentyp | |
|---|---|
| Eingabe | Textliste |
Ausgabe: extrahierter Text
Dies ist der Text, der anhand der Abfrage aus dem Bild extrahiert wurde.
| Unterstützter Datentyp | |
|---|---|
| Ausgabe | Objekt-Array. Jedes Element verfügt über die Attribute „Frage“ und „Antwort“. |
Den gesamten Text aus einem Bild/Dokument extrahieren
In manchen Fällen ist das Schlüssel-Wert-Paradigma der Trigger-Aktionen zum Extrahieren von Werten für Ihren Anwendungsfall nicht sinnvoll. Das Auslesen aller Daten aus einem Bild bietet nahezu unbegrenzte Flexibilität hinsichtlich der Probleme, die von Copilot gelöst werden können. Die Trigger-Aktionen „Gesamten Text extrahieren“ bieten Ihnen diese Flexibilität.
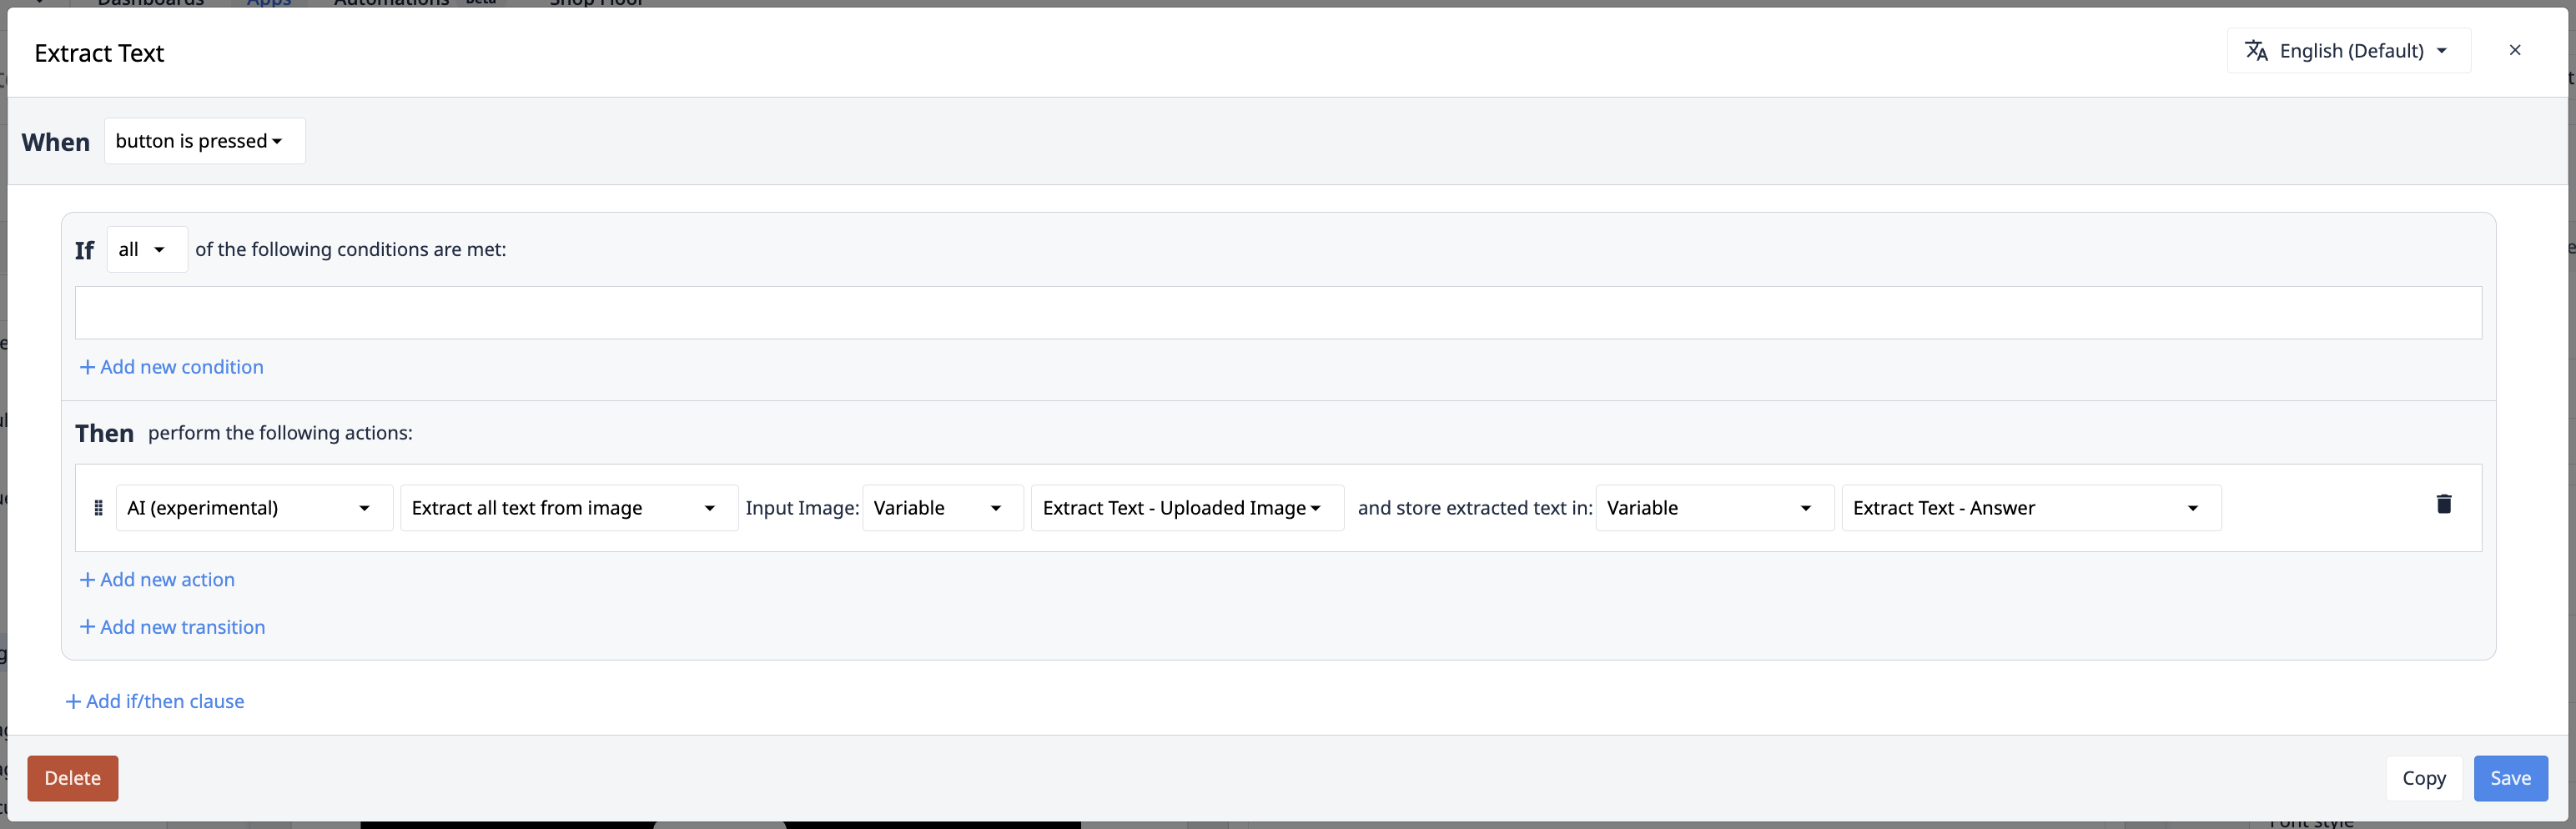
Eingabe: Eingabebild/-dokument
Dies ist das Bild, aus dem der Text extrahiert werden soll. Es kann aus dem Kamera-Eingabe-Widget, von Tulip Vision oder aus externen Systemen stammen. Bei Dateien kann dies statisch festgelegt, über das Datei-Eingabe-Widget eingegeben oder auf in Tabellen gespeicherte Dateien verwiesen werden.
| Unterstützter Datentyp | |
|---|---|
| Eingabe | Bild-URL oder Datei-URL |
Ausgabe: extrahierter Text
Dies ist der gesamte Text, der auf dem jeweiligen Bild oder Dokument zu finden ist. Bei Dokumenten wird ein Datenarray zurückgegeben, wobei jedes Element den Text einer Seite des bereitgestellten Dokuments darstellt.
| Unterstützter Datentyp | |
|---|---|
| Ausgabe | (für Bilder) Text. (für Dokumente) Textliste |
Sonderfälle
Kein Eingabebild und/oder keine Abfrage angegeben
Wenn der Trigger-Aktion kein Eingabebild oder keine Suchanfrage bereitgestellt wird, zeigt die App den folgenden Systemfehler an:Ihre Eingabe oder Suchanfrage ist leer
Dies tritt in allen folgenden Fällen auf:* Dem Eingabebild und/oder der Suchanfrage ist kein Wert zugewiesen. Dies entspricht „null“.* Der Suchanfrage ist eine leere Zeichenkette zugewiesen.
Kein Ergebnis für die Suchanfrage
Wenn für die Suchanfrage kein Ergebnis gefunden werden konnte, gibt die Trigger-Aktion einen leeren Text zurück.
Beschränkungen
The following languages are the only ones supported for documents where values are being extracted: English, Spanish, Italian, Portuguese, French, German.
Diese Limits werden auf der Ebene „ Instance “ erfasst. Wenn diese Limits überschritten werden, schlägt die Trigger-Aktion „Text aus Bild extrahieren“ fehl.
Für Trigger des Typs „Text aus Bild extrahieren“ gelten folgende Beschränkungen:
| Beschränkung | |
|---|---|
| Bildgröße | 5 MB |
| Monatliches Limit | 10.000 Anfragen pro Monat |
| Ratenbegrenzung | 10 Anfragen pro Minute |
| Anzahl der extrahierten Werte | 15 extrahierte Werte pro Aktion |
Weitere Beschränkungen, einschließlich der Kontonutzung, finden Sie unter „Nutzung und Preise von Tulip AI“.
{{snippet.Haben Sie gefunden, wonach Sie gesucht haben?}}