
:::(정보) (Tulip 라이브러리 데모)
이 동영상은 Fivetran과 AWS Lambda를 사용하여 Tulip table 데이터를 정기적으로 가져오고, 데이터 웨어하우스, 데이터베이스, 데이터 레이크 등 다양한 대상에 데이터를 업데이트하는 방법을 단계별로 안내합니다.
Fivetran 통합
:::
Fivetran 연동을 통한 Tulip 데이터 엔지니어링 간소화
목적
Tulip을 통해 데이터 엔지니어링 파이프라인을 간소화하면 전사적으로 Tulip 테이블 데이터를 활용할 수 있습니다.
설정
설정을 위해서는 다음이 필요합니다:* Fivetran 계정 (무료 버전 이용 가능)* AWS (또는 기타 클라우드 계정)* Tulip 테이블 데이터를 수신할 데이터베이스 또는 데이터 웨어하우스* Python에 대한 기초 지식
작동 방식
이 Fivetran 자동화 설정은 다음 단계로 진행됩니다:
- Fivetran 계정 설정
- 대상(예: Snowflake) 생성
- AWS Lambda 함수를 사용하여 커넥터 함수 생성
- AWS Lambda 함수 생성
- 커넥터 함수 마무리
- Fivetran 커넥터 테스트 및 갱신 주기 조정
Fivetran은 Lambda 함수를 사용하여 예약된 일정에 따라 Tulip 테이블 데이터를 자동으로 가져와 대상 데이터베이스 또는 데이터 웨어하우스를 업데이트합니다. 포함된 예제는 새로 갱신된 데이터로 테이블을 다시 작성하는 간단한 함수입니다. 향상된 이벤트 기반 트리거를 위해 추가 기능을 구현할 수 있습니다.
설정 안내
Fivetran 계정 설정
먼저 Fivetran 계정을 설정해야 합니다. Fivetran은 월간 갱신 횟수가 제한된 무료 버전을 제공합니다.
대상 설정
그런 다음, ‘Destinations’를 클릭하고 첫 번째 대상 데이터베이스를 생성합니다. 이는 기본적으로 Tulip 테이블 데이터를 수신할 데이터베이스 또는 데이터 웨어하우스입니다.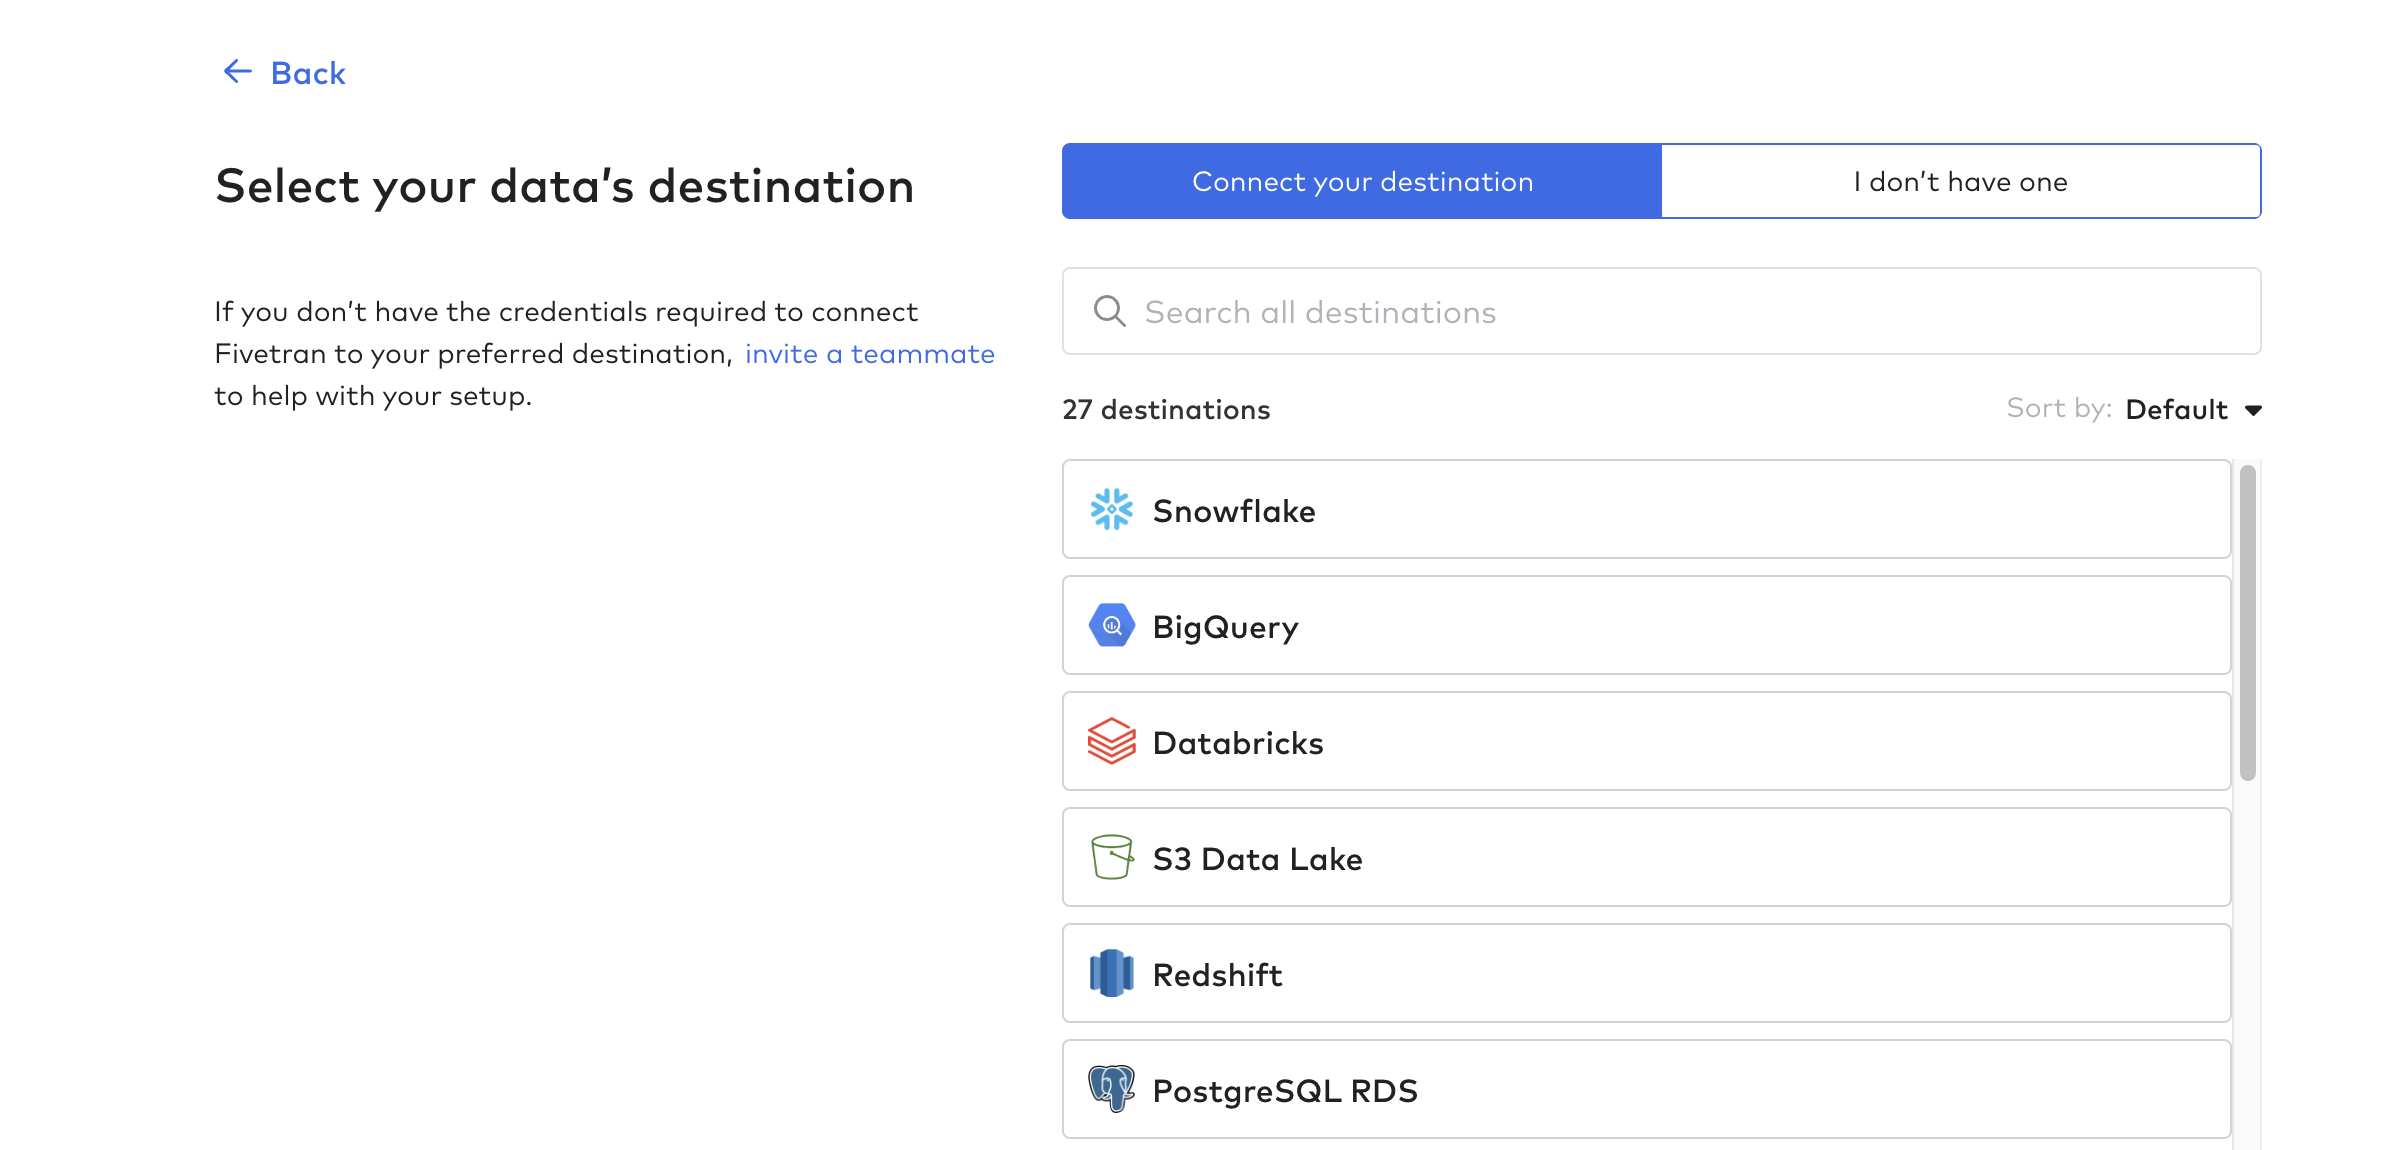
커넥터 함수 생성
다음으로 커넥터 함수를 생성합니다. 이는 Tulip에서 데이터 파이프라인을 자동화하는 프로세스입니다. AWS Lambda, Azure Functions, GCP Cloud Functions 등 어떤 클라우드 함수든 사용할 수 있습니다. 이 예제에서는 AWS Lambda를 사용하겠습니다.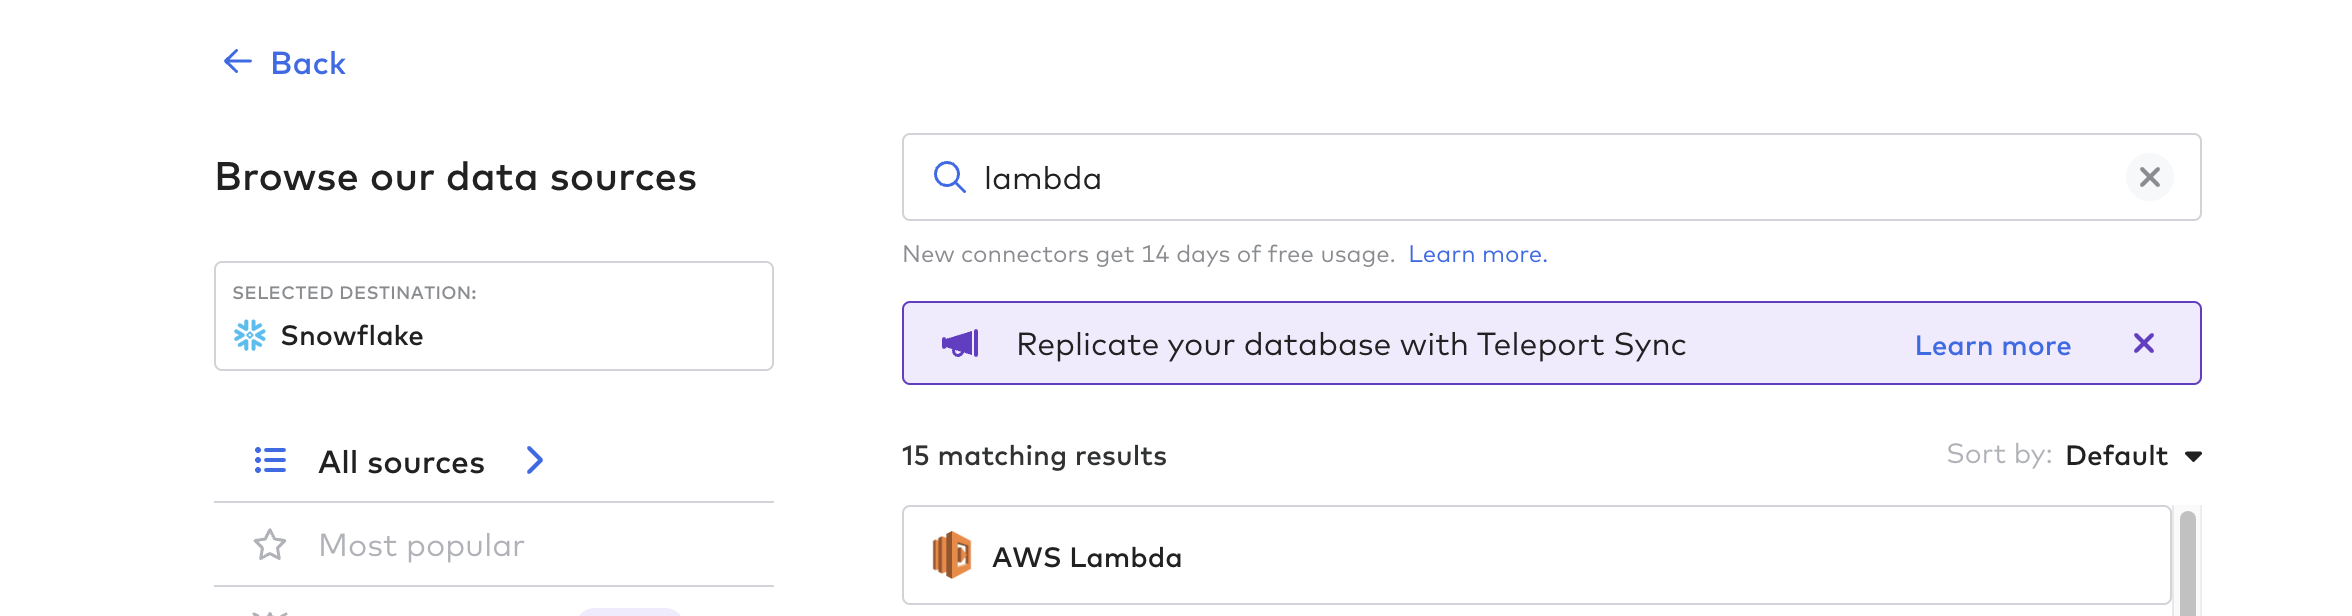
Fivetran 내 지침에 따라 적절한 역할과권한을설정하여 AWS에서 Lambda 함수를 생성하세요.시작점으로 사용할 Lambda 함수 템플릿은 링크를 참조하세요. 다음은 유용한 팁입니다:
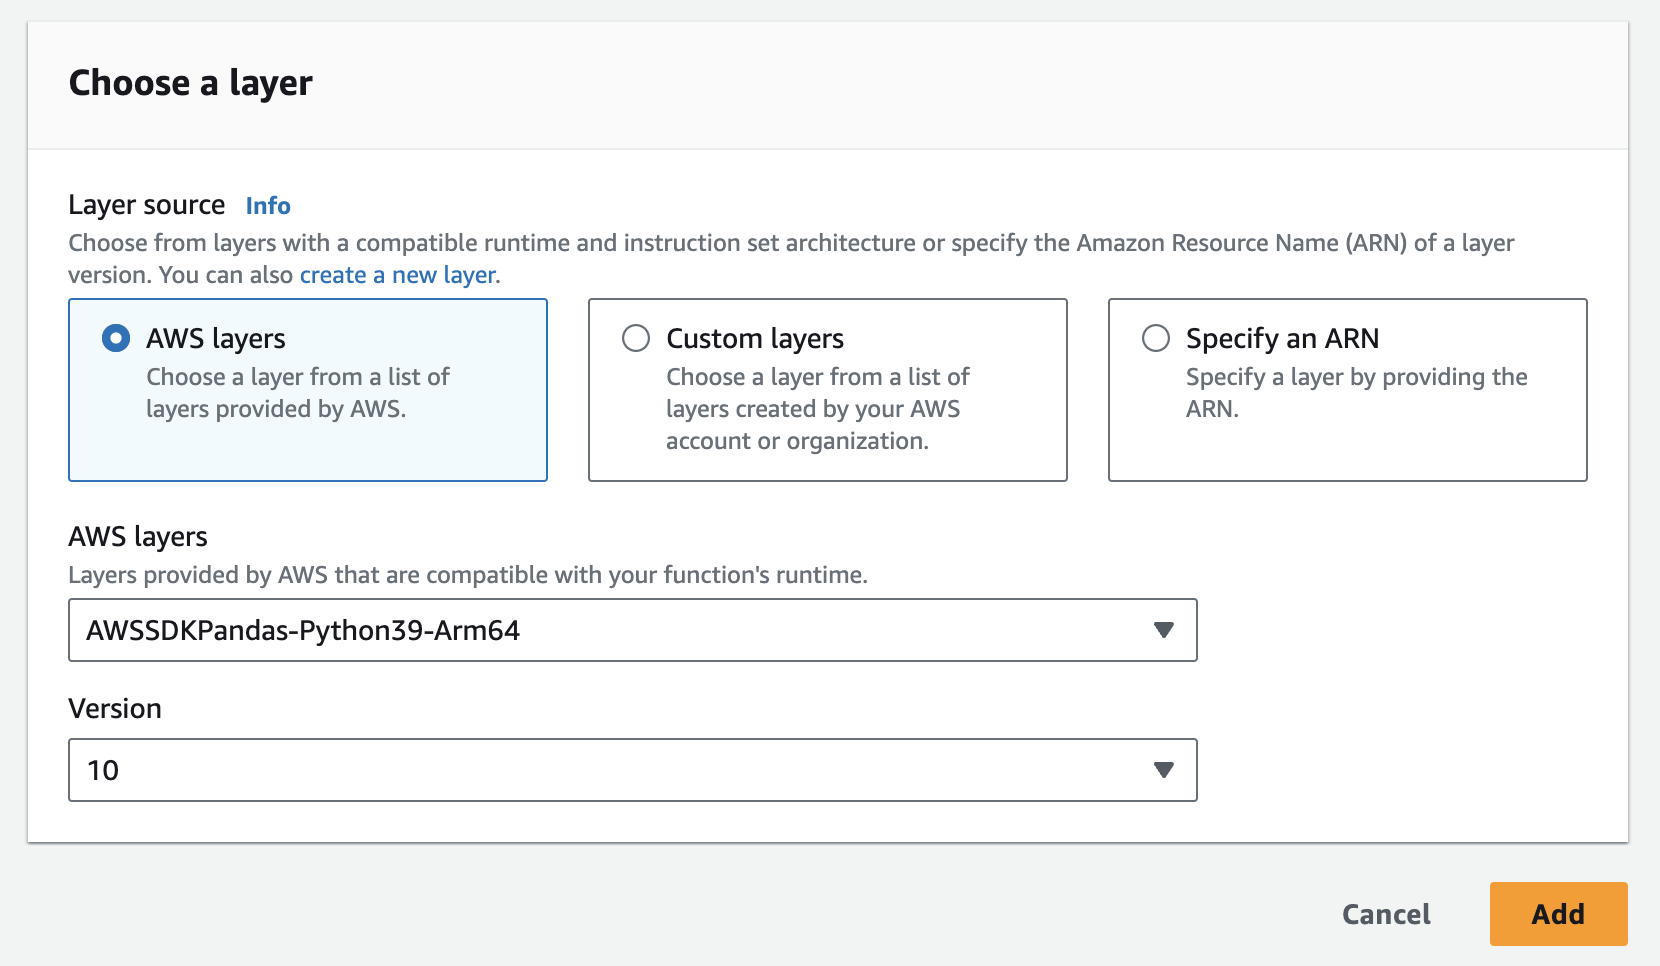
- 두 개의 레이어를 생성해야 합니다. 하나는 Tulip 라이브러리용이고, 다른 하나는 pandas 라이브러리용입니다.
- Tulip 커뮤니티 API는 여기에서 확인할 수 있습니다
- 또는 여기에서 zip 파일을 다운로드할 수 있습니다(이 파일은 레이어에 추가할 수 있도록 미리 준비되어 있습니다).
- 아래에서 AWS에 pandas 레이어를 쉽게 추가할 수 있습니다.
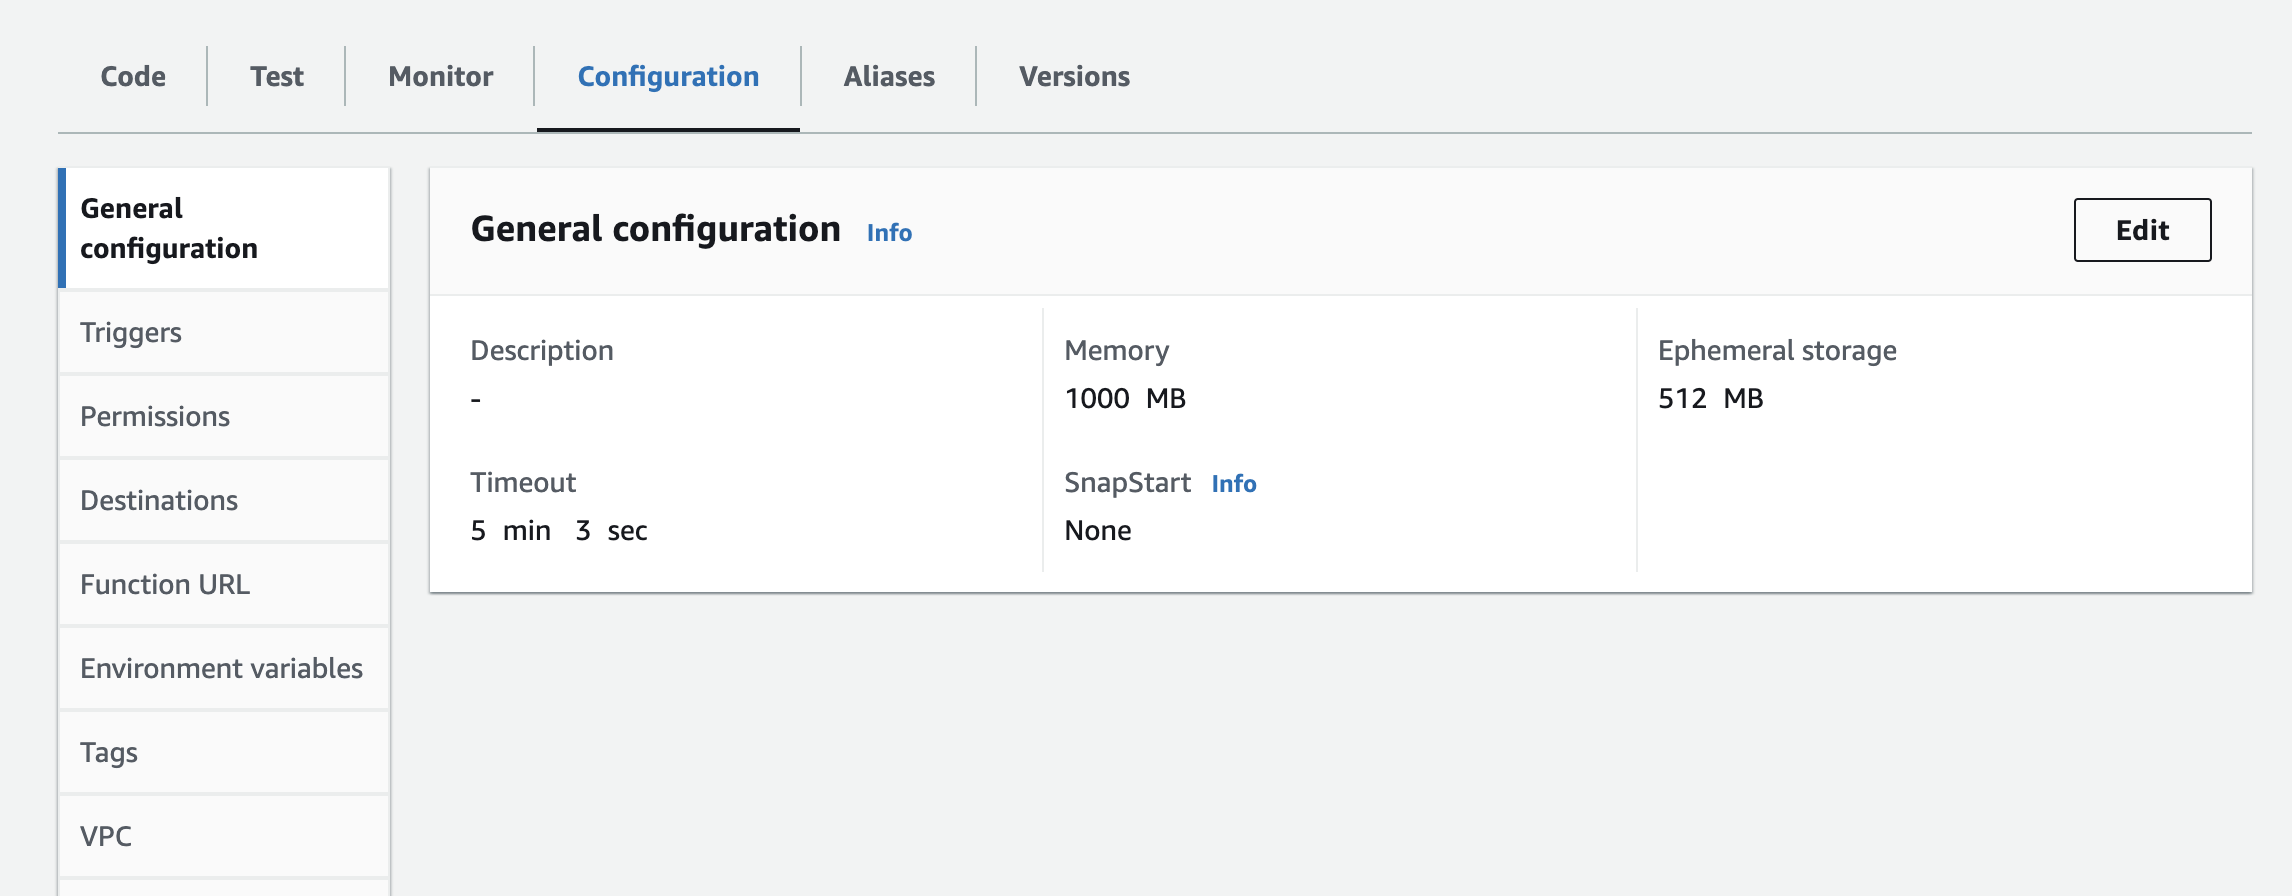
- Lambda 함수에 인스턴스, API 키, API 시크릿을 환경 변수로 추가해야 합니다. 타임아웃 시간과 사용 메모리를 늘리기 위해 런타임 설정을 업데이트해야 할 수도 있습니다. 구성 업데이트 방법은 아래 스크린샷을 참조하세요.
다음 단계
커넥터 함수가 정상적으로 작동하면, 새로고침 빈도를 조정하고, 대상 데이터베이스 또는 데이터 웨어하우스에서 Tulip 테이블 정보를 확인하는 등 다양한 기능을 활용할 수 있습니다.
이 데이터 파이프라인의 구체적인 사용 사례: * Tulip 데이터에 대한 엔터프라이즈급 분석 및 데이터 처리 * 엔터프라이즈 시스템과의 배치 자동화 * 데이터 웨어하우스 및 데이터 레이크를 활용한 맥락화
추가 리소스
추가 지원이 필요하시면 여기에서 Fivetran에 문의하세요. 추가 지원이 필요하시면여기에서Fivetran에 문의하세요. *또한, Tulip 테이블 통합을 간소화하기 위한 조정 및 요청을 할 수 있는 양식을 제공하고 있습니다. 여기에서 피드백을 제공하고 요청하세요.