
:::(Informacje) (Prezentacja biblioteki Tulip)
Ten film przedstawia instrukcje korzystania z Fivetran + AWS Lambda w celu pobierania danych z serwisu Tulip table zgodnie z harmonogramem oraz aktualizowania różnych miejsc docelowych, takich jak hurtownie danych, bazy danych, jeziora danych i inne
Usprawnij inżynierię danych w Tulip dzięki integracji z Fivetran
Cel
Usprawnienie potoków inżynierii danych za pomocą Tulip umożliwia wykorzystanie danych z tabel Tulip w całym przedsiębiorstwie
Konfiguracja
Konfiguracja wymaga:* konta Fivetran (dostępna jest wersja bezpłatna)* konta AWS (lub innego dostawcy usług w chmurze)* bazy danych lub hurtowni danych do przechowywania danych z tabel Tulip* podstawowej znajomości języka Python
Jak to działa
Konfiguracja automatyzacji w Fivetran obejmuje następujące kroki:
- Skonfiguruj konto Fivetran
- Utwórz miejsce docelowe (np. Snowflake)
- Utwórz funkcję łącznika przy użyciu funkcji AWS Lambda
- Utwórz funkcję AWS Lambda
- Sfinalizuj funkcję łącznika
- Przetestuj łącznik Fivetran i dostosuj częstotliwość odświeżania
Fivetran wykorzystuje funkcję Lambda do automatycznego pobierania danych z tabel Tulip zgodnie z harmonogramem oraz aktualizowania docelowych baz danych lub hurtowni danych. Przedstawiony przykład to prosta funkcja, która przepisuje tabelę nowymi, zaktualizowanymi danymi. Można dodać dodatkowe funkcje w celu ulepszenia wyzwalaczy opartych na zdarzeniach.
Instrukcje konfiguracji
Skonfiguruj konto Fivetran
Najpierw należy założyć konto w Fivetran. Serwis oferuje bezpłatną wersję z ograniczoną liczbą odświeżeń miesięcznie
Skonfiguruj miejsce docelowe
Następnie kliknij opcję „Miejsca docelowe” i utwórz swoje pierwsze miejsce docelowe. Jest to zasadniczo baza danych lub hurtownia danych, do której będą trafiać dane z tabel Tulip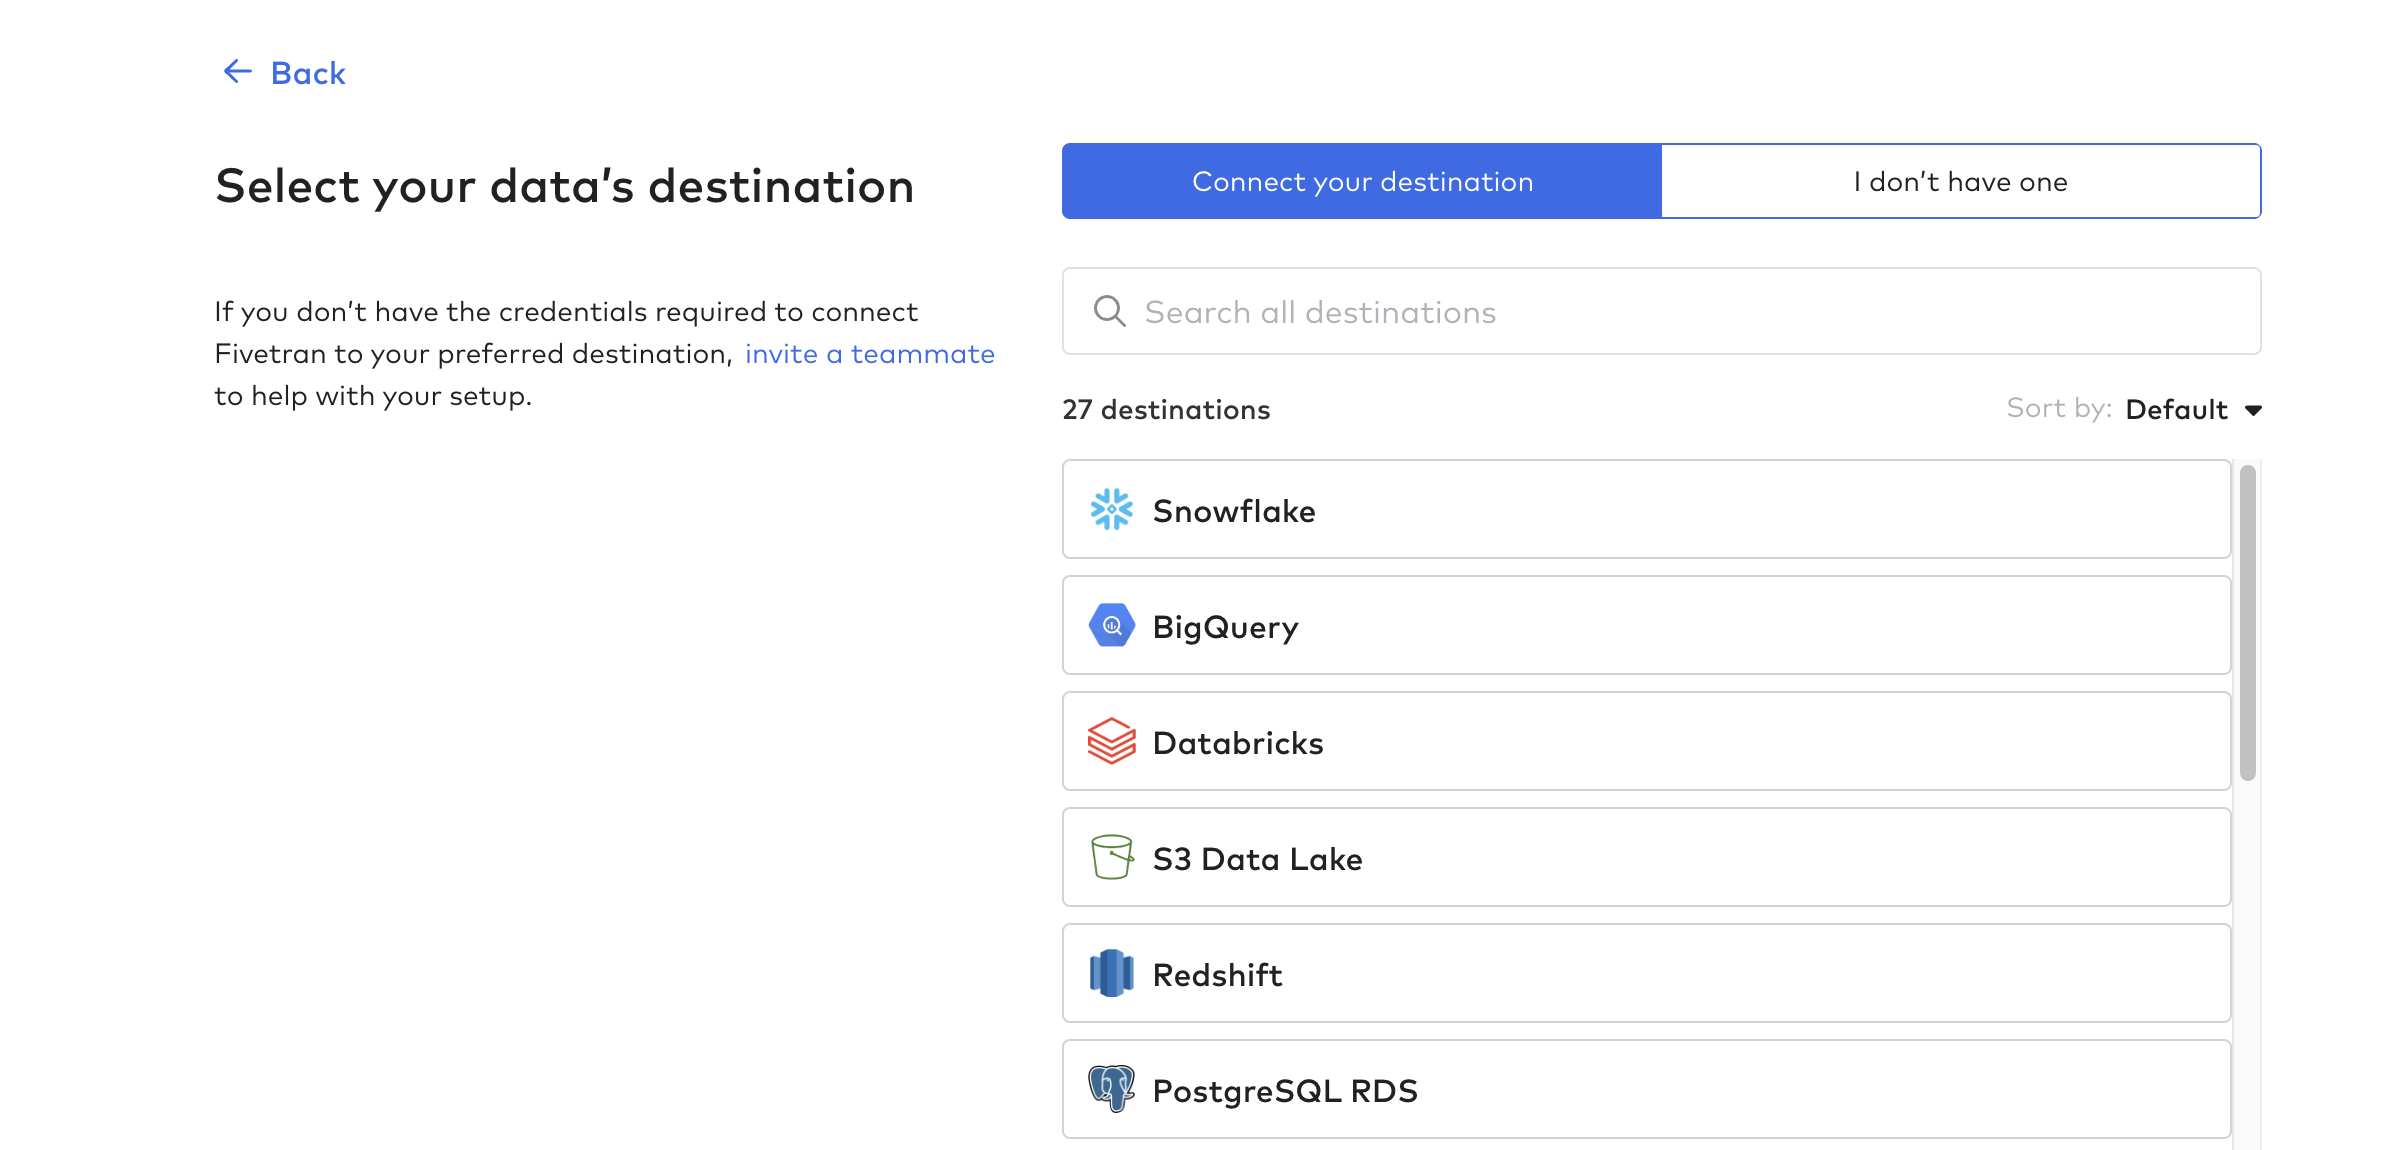
Utwórz funkcję łącznika
Następnie utwórz funkcję łącznika; jest to proces automatyzacji potoku danych z Tulip. Możesz użyć dowolnej funkcji chmurowej, takiej jak AWS Lambda, Azure Functions lub GCP Cloud Functions. W tym przykładzie użyjemy AWS Lambda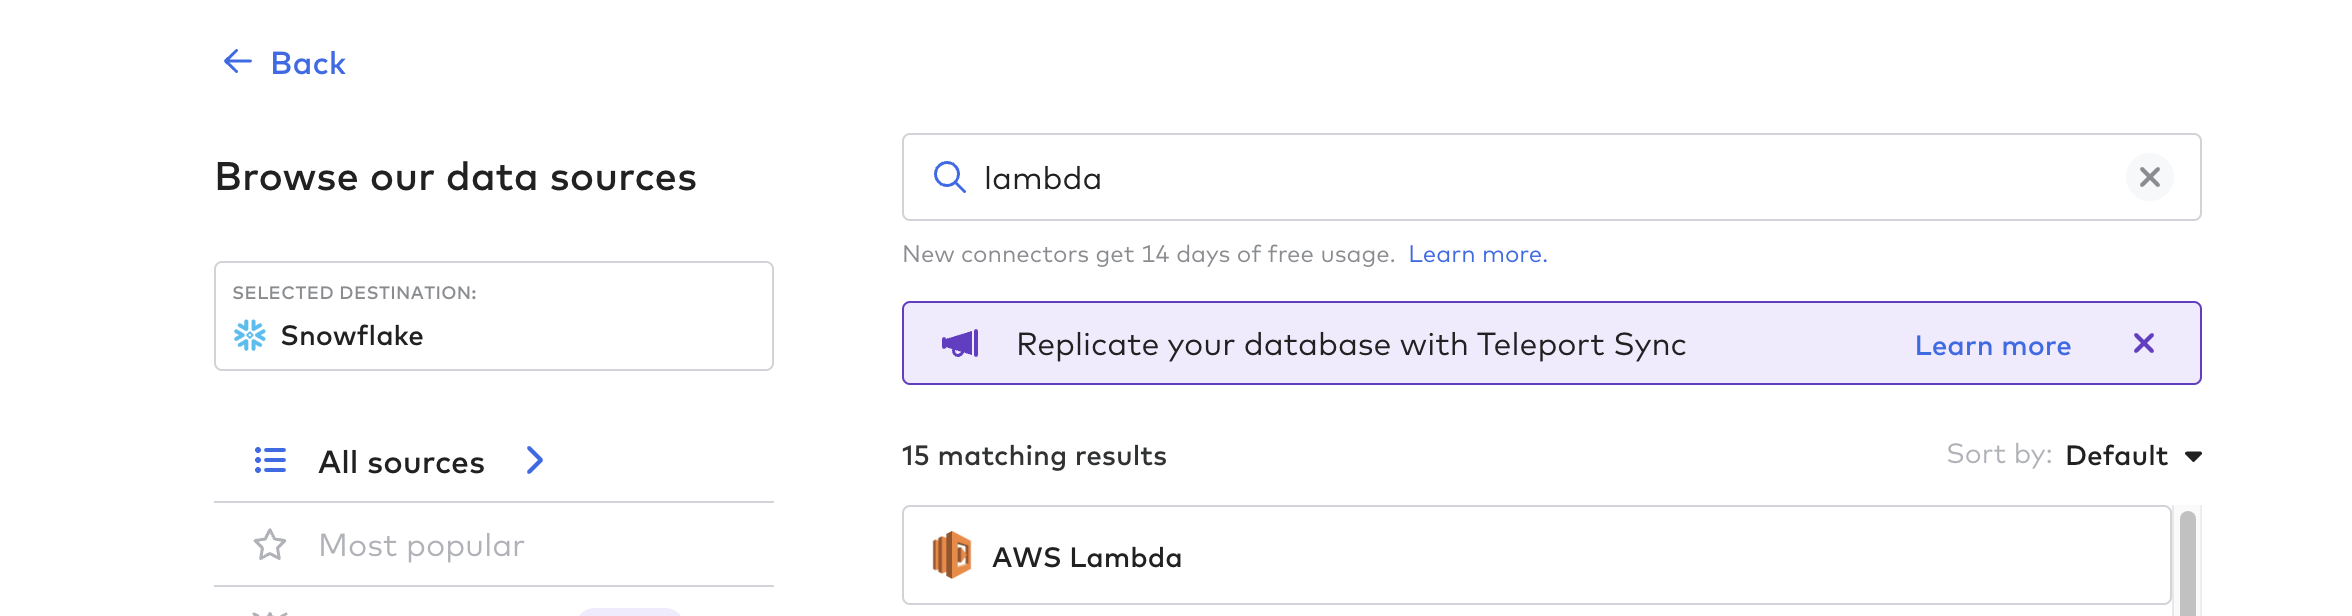
Postępuj zgodnie z instrukcjami w Fivetran dotyczącymi tworzenia funkcji Lambda w AWS z odpowiednimi rolami iuprawnieniami. Zobacz link do szablonu funkcji Lambda jako punktu wyjścia. Poniżejznajduje się kilka pomocnych wskazówek:
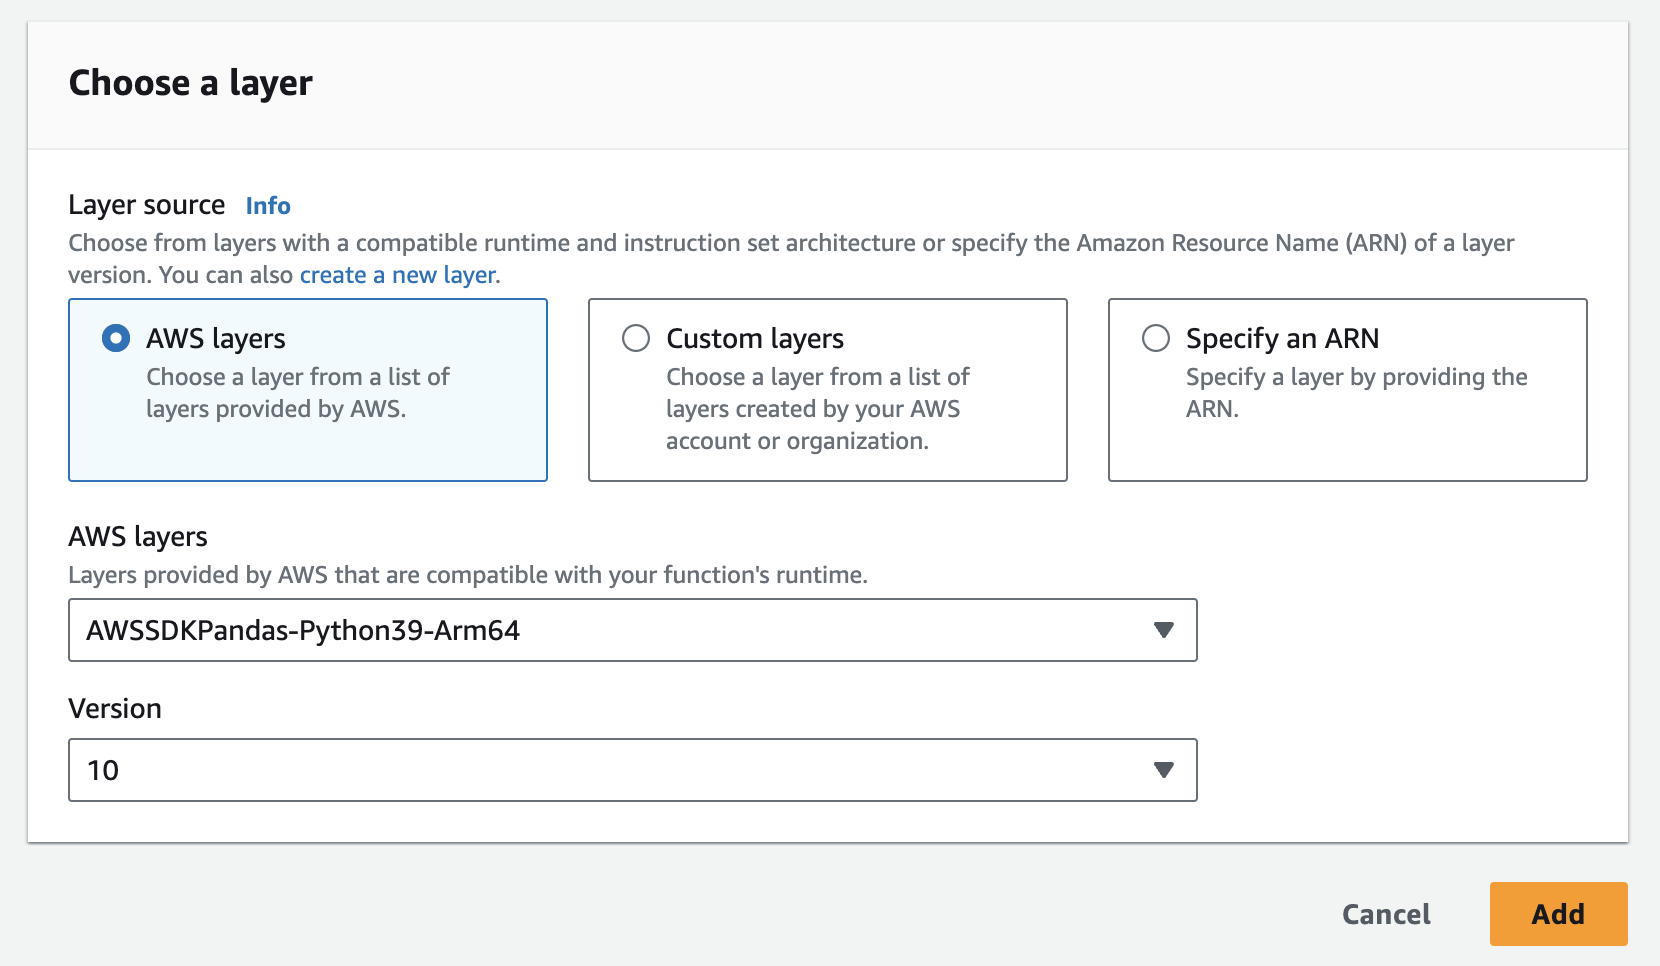
- Będziesz musiał utworzyć dwie warstwy: jedną dla biblioteki Tulip, a drugą dla biblioteki pandas
- API społeczności Tulip można obejrzeć tutaj
- Alternatywnie możesz pobrać plik zip tutaj (został on przygotowany do dodania do warstwy)
- Warstwę pandas można łatwo dodać w AWS poniżej
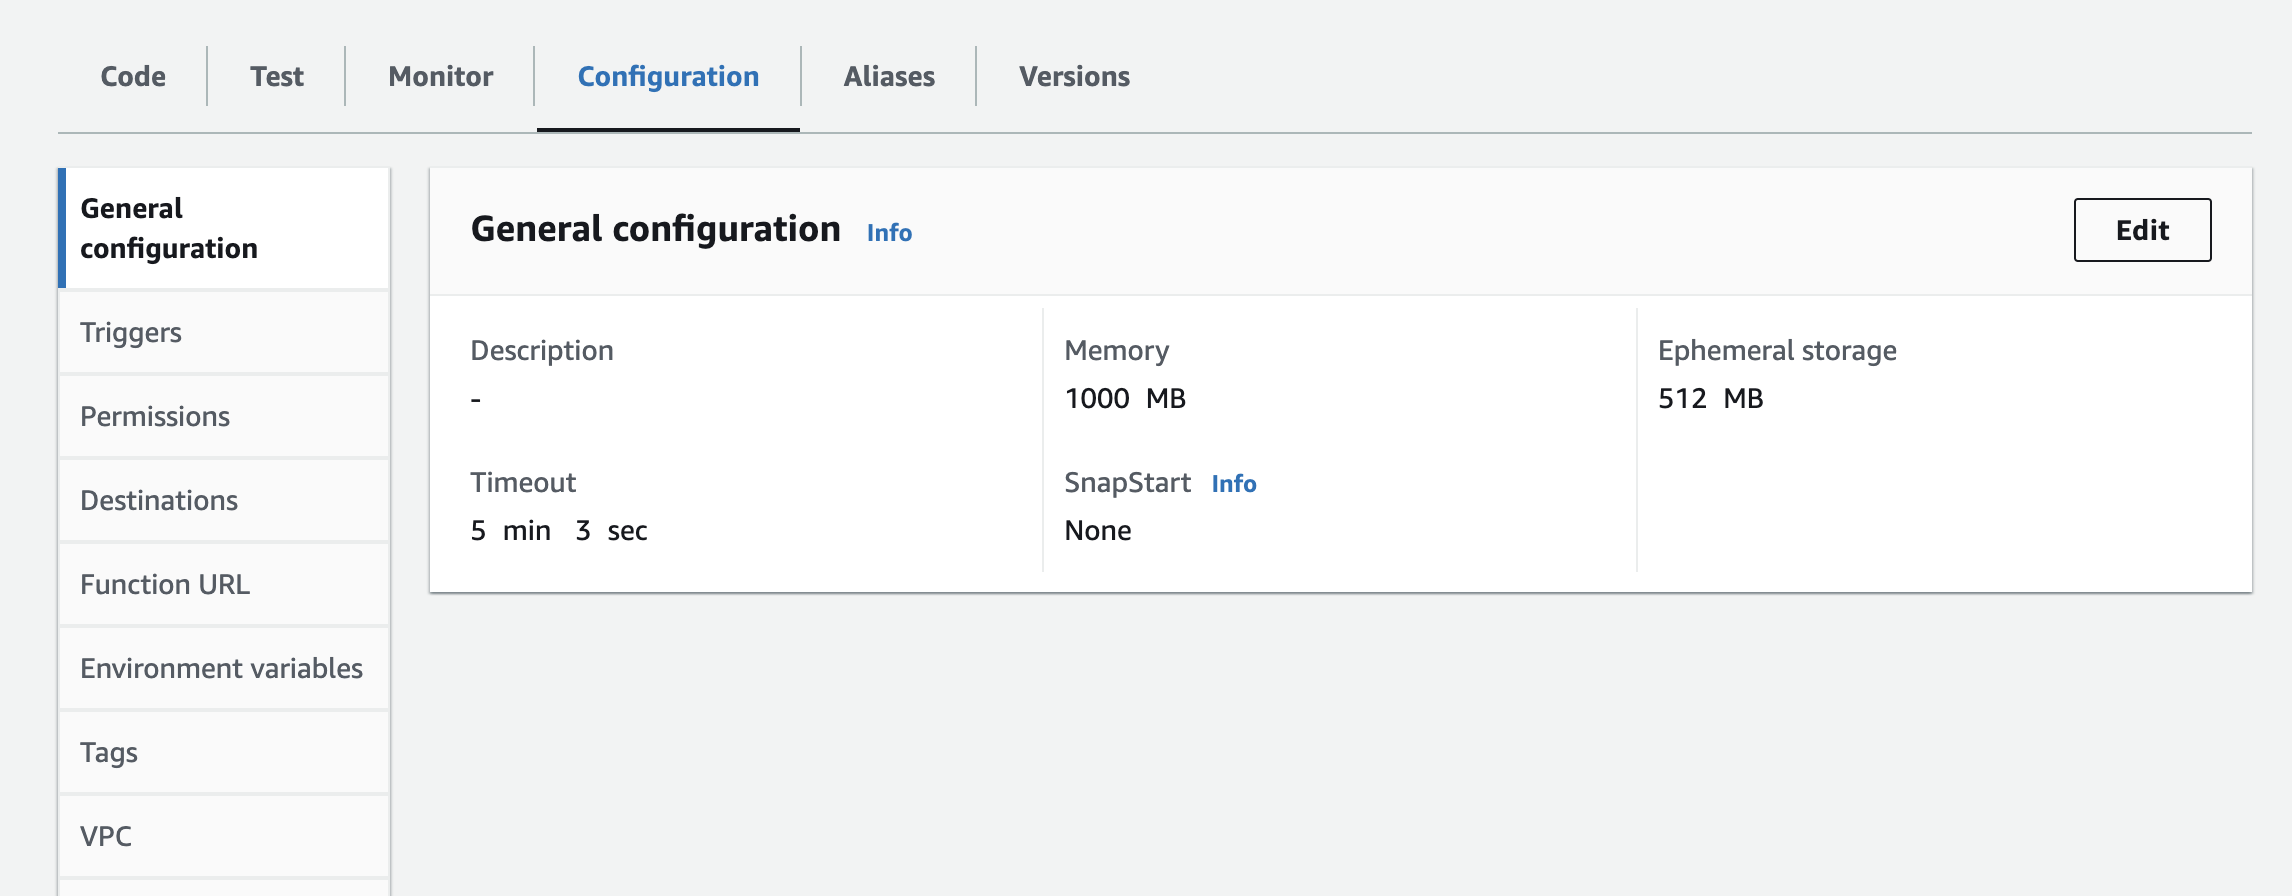
- Będziesz musiał dodać instancję, klucz API i sekret API jako zmienne środowiskowe do funkcji Lambda. Być może będziesz musiał zaktualizować ustawienia środowiska uruchomieniowego, aby zwiększyć limit czasu i ilość używanej pamięci. Poniżej znajduje się zrzut ekranu przedstawiający aktualizację konfiguracji
Kolejne kroki
Gdy funkcja łącznika już działa, można dostosować częstotliwość odświeżania, przeglądać informacje o tabelach Tulip w docelowej bazie danych lub hurtowni danych oraz korzystać z dodatkowych funkcji
Niektóre konkretne przypadki użycia tego potoku danych:* Analizy na poziomie przedsiębiorstwa i przetwarzanie danych z Tulip* Automatyzacja przetwarzania wsadowego z systemami korporacyjnymi* Kontekstualizacja z wykorzystaniem hurtowni danych i jezior danych
Dodatkowe zasoby
Skontaktuj się z Fivetran w celu uzyskania dodatkowego wsparcia tutajSkontaktujsię z Fivetran w celu uzyskania dodatkowego wsparcia tutaj*Ponadto udostępniono formularz umożliwiający wprowadzanie zmian i zgłaszanie wniosków dotyczących uproszczonej integracji tabel Tulip. Prześlij opinię i zgłoś prośbę tutaj