
Ez a videó bemutatja, hogyan lehet a Fivetran és az AWS Lambda segítségével ütemezett alapon lekérni az Tulip table adatait, és frissíteni azokat különböző célhelyeken, például adattárházakban, adatbázisokban, adattavakban és egyebekben
A Tulip adatfeldolgozásának egyszerűsítése a Fivetran-integrációval
Cél
Az adatfeldolgozási folyamatok egyszerűsítése a Tulip segítségével lehetővé teszi a Tulip-táblák adatainak vállalati szintű felhasználását
Beállítás
A beállításhoz a következőkre van szükség:* Fivetran-fiók (ingyenes verzió is elérhető)* AWS (vagy más felhőalapú fiók)* Adatbázis vagy adattárház a Tulip-táblák adatainak fogadásához* Magas szintű Python-ismeretek
Hogyan működik
A Fivetran automatizálás beállítása a következő lépésekből áll:
- Fivetran-fiók beállítása
- Cél létrehozása (pl. Snowflake)
- Csatlakozó funkció létrehozása AWS Lambda funkcióval
- AWS Lambda-függvény létrehozása
- A csatlakozó funkció véglegesítése
- A Fivetran csatlakozó tesztelése és a frissítési gyakoriság beállítása
A Fivetran a Lambda-függvényt használja a tulip táblák adatainak ütemezett automatikus lekérésére, valamint a céladatbázisok vagy adattárházak frissítésére. A mellékelt példa egy egyszerű függvény, amely új, frissített adatokkal írja át a táblát. További funkciók hozzáadhatók az eseményalapú kiváltók javítása érdekében.
Beállítási útmutató
Fivetran-fiók beállítása
Először létre kell hoznia egy Fivetran-fiókot. A szolgáltatás ingyenes verziója havi szinten korlátozott számú frissítést kínál
Célhely beállítása
Ezután kattintson a „Destinations” (Célhelyek) gombra, és hozza létre az első célhelyét. Ez lényegében az az adatbázis vagy adattárház, amely a Tulip táblák adatait fogja fogadni.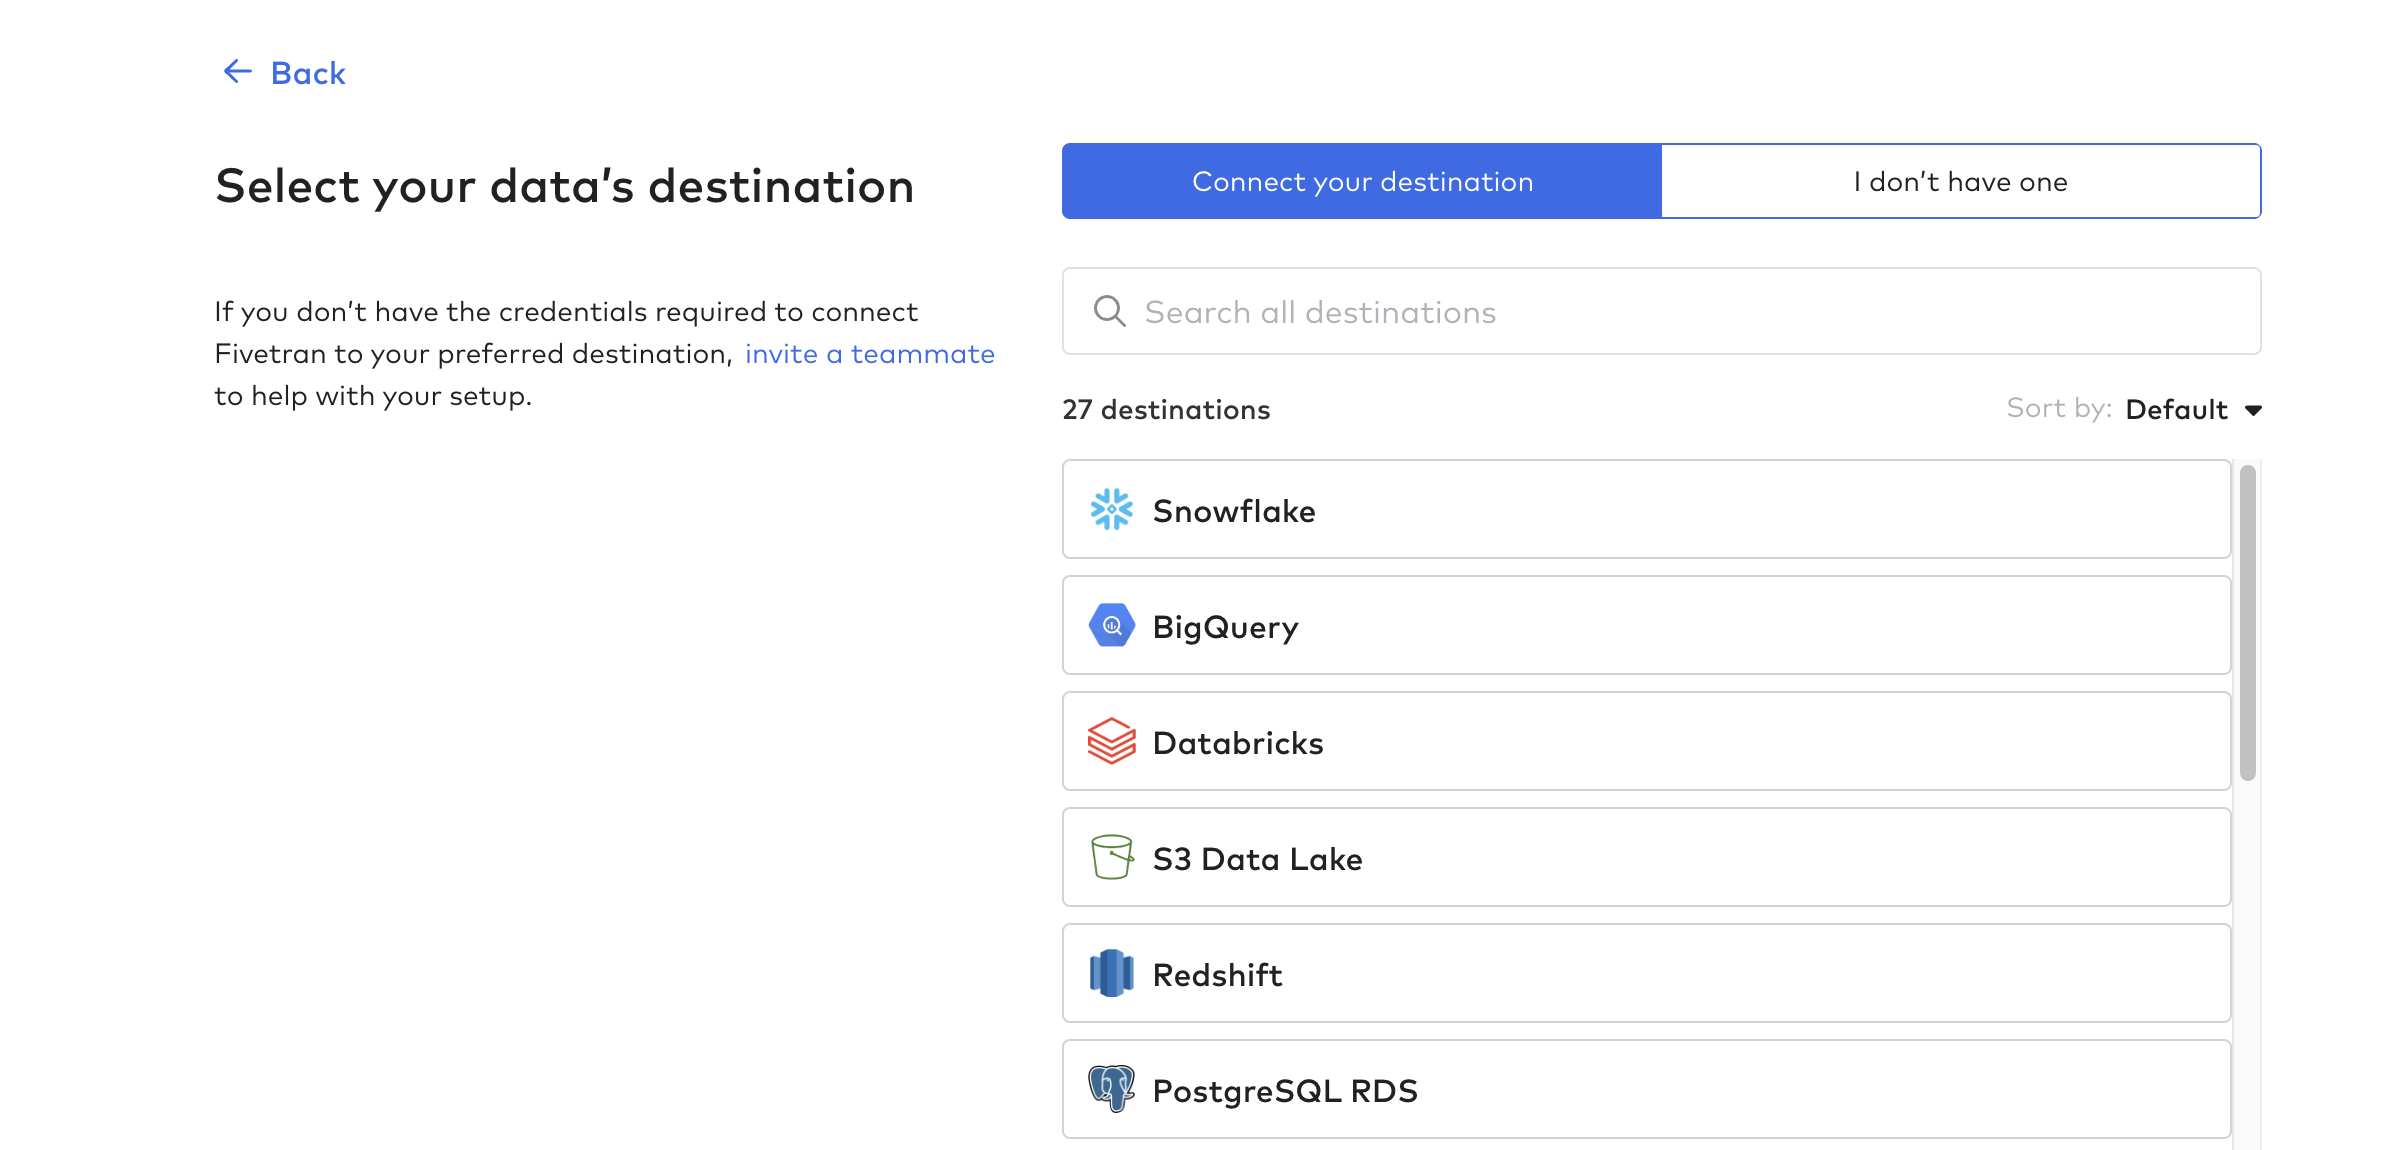
Csatlakozó funkció létrehozása
Ezután hozza létre a csatlakozó funkciót; ez a folyamat automatizálja az adatcsatornát a Tulipból. Bármilyen felhőalapú funkciót használhat, például az AWS Lambda-t, az Azure Functions-t vagy a GCP Cloud Functions-t. Ebben a példában az AWS Lambda-t fogjuk használni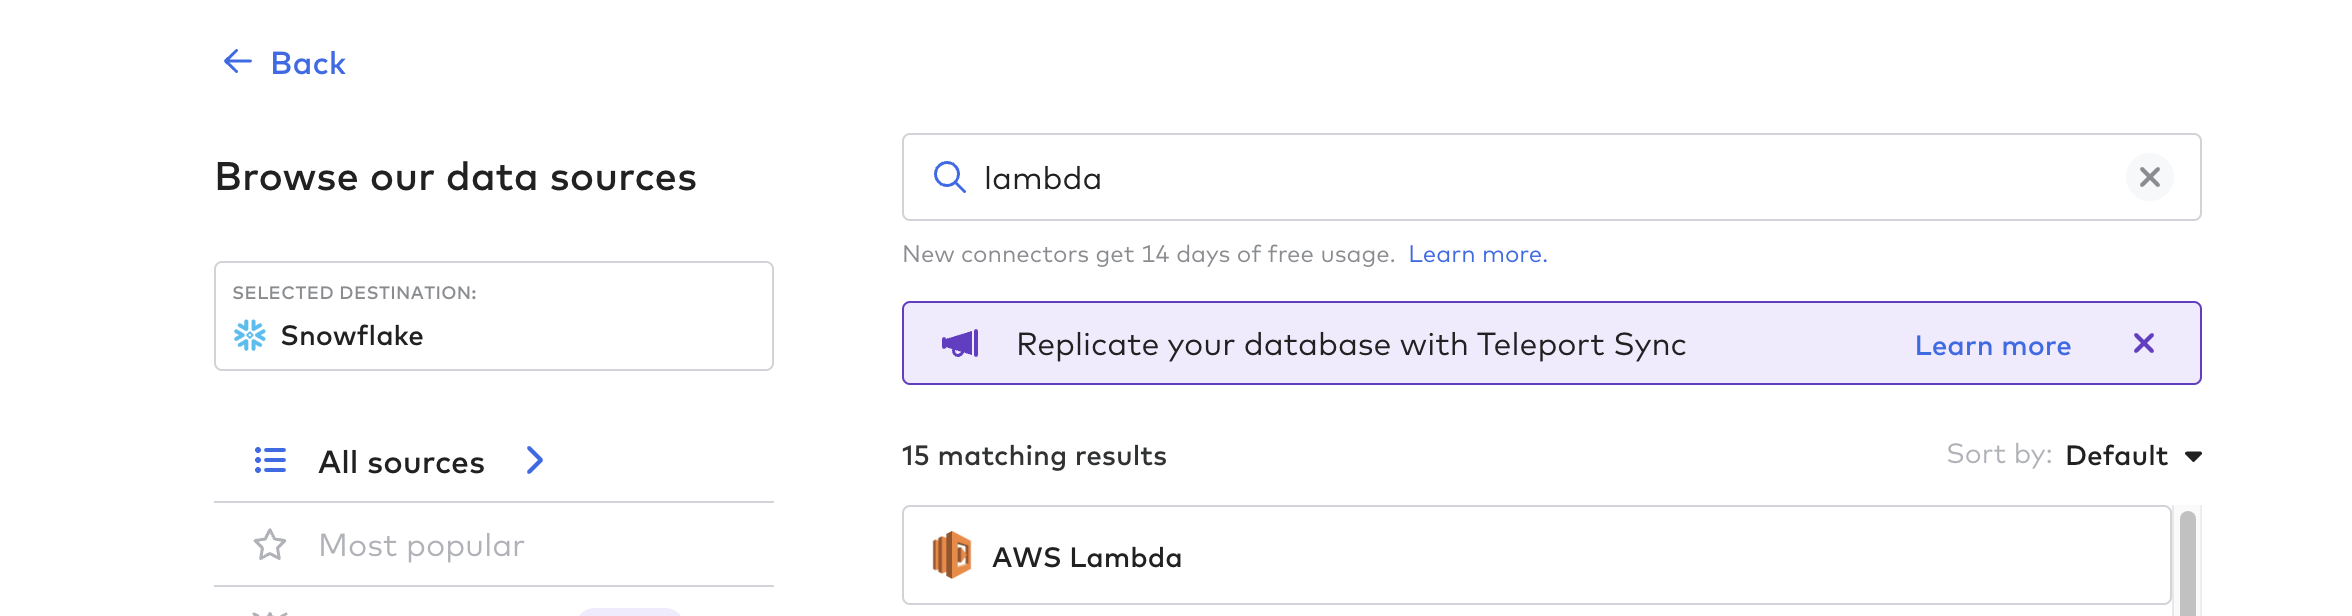
Kövesse a Fivetranon található utasításokat az AWS-en történő Lambda-függvény létrehozásához a megfelelő szerepkörökkel ésjogosultságokkal. A kiindulási pontként szolgáló Lambda-függvény-sablont a link alatt találja. Az alábbiakbannéhány hasznos tipp található:
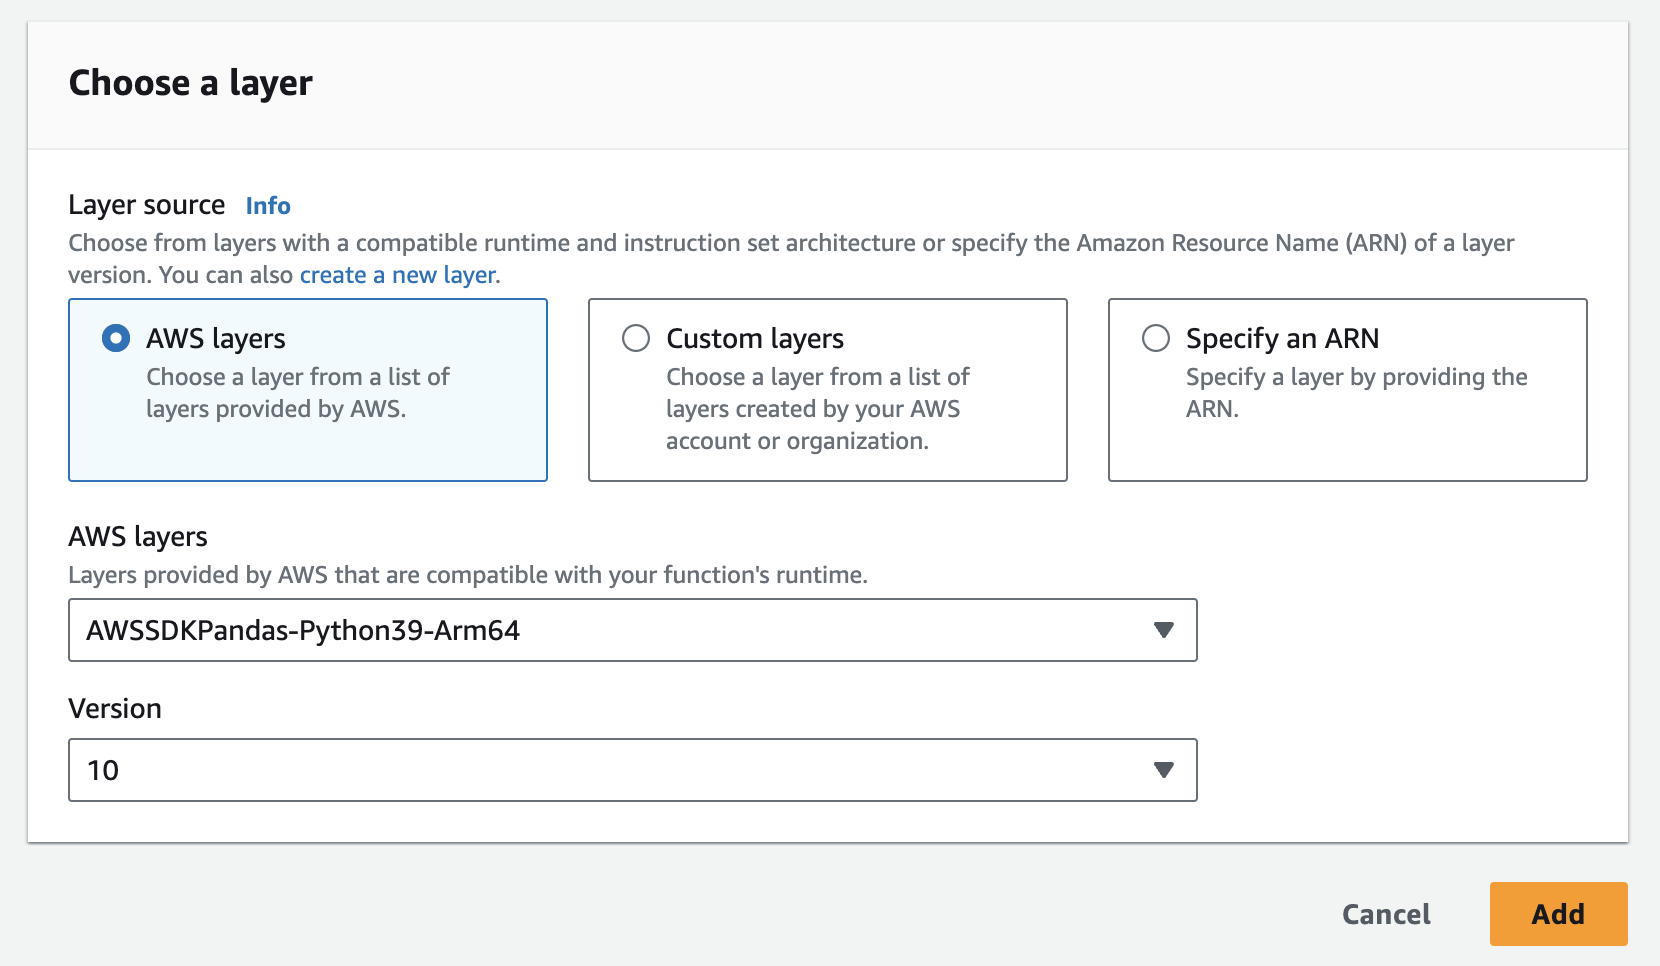
- Két réteget kell létrehoznia: az egyiket a Tulip könyvtárhoz, a másikat pedig a pandas könyvtárhoz
- A Tulip közösségi API-t itt tekintheti meg
- Alternatívaként itt töltheti le a zip fájlt (ez már elő van készítve réteghez való hozzáadásra)
- A pandas réteget könnyedén hozzáadhatja az AWS-ben az alábbi linken:
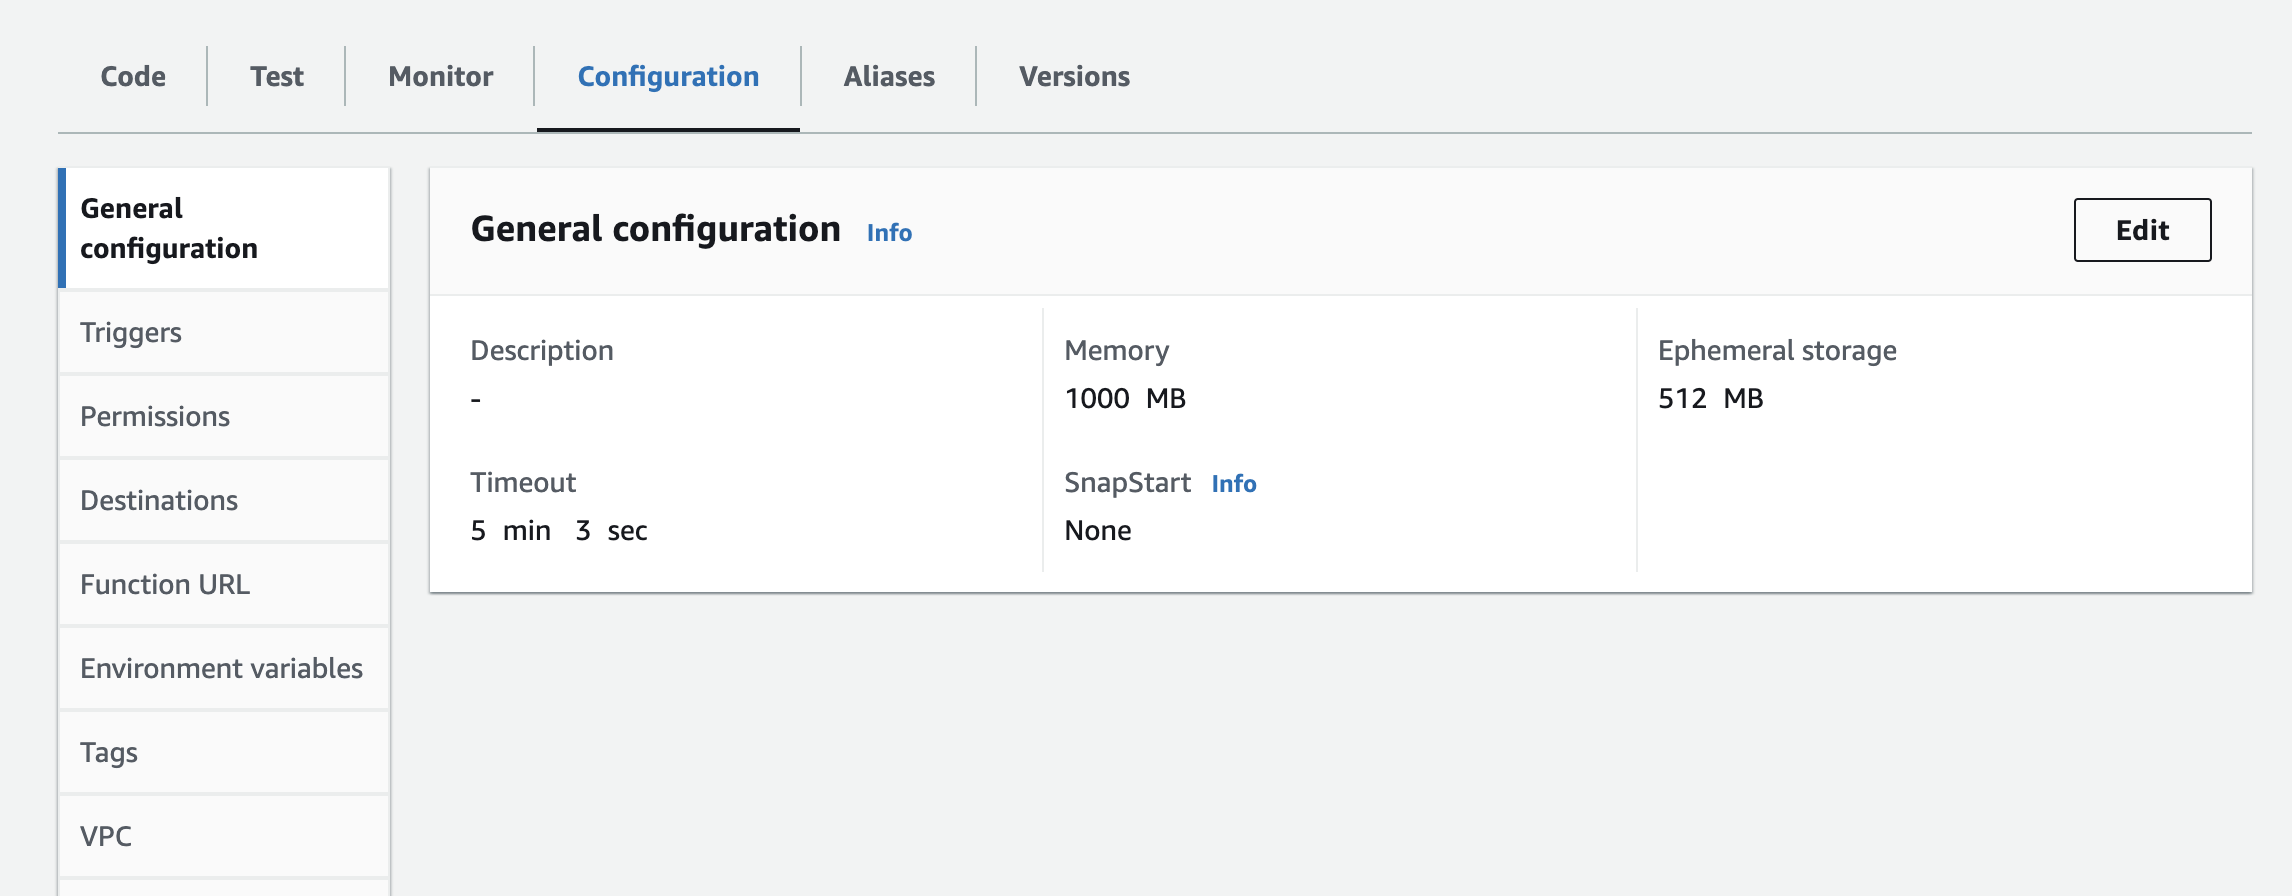
- Az instanciát, az API-kulcsot és az API-titkot környezeti változóként kell hozzáadnia a Lambda-függvényhez. Előfordulhat, hogy frissítenie kell a futási beállításokat az időkorlát és a felhasznált memória növelése érdekében. Az alábbi képernyőképen látható a konfiguráció frissítése:
Következő lépések
Miután a csatlakozó funkció működik, beállíthatja a frissítési gyakoriságot, megtekintheti a Tulip-táblák adatait a céladatbázisban vagy az adattárházban, valamint további funkciókat is igénybe vehet
Néhány konkrét felhasználási eset ehhez az adatcsatornához:* Tulip-adatok vállalati szintű elemzése és feldolgozása* Tömeges automatizálás vállalati rendszerekkel* Kontextusba helyezés adattárházakkal és adattavakkal
További források
További támogatásért forduljon a Fivetranhoz itt.További támogatásért forduljon a Fivetranhozitt. * Ezen felül rendelkezésre áll egy űrlap is, amelyen keresztül módosításokat és kéréseket nyújthat be a Tulip-táblák egyszerűsített integrációja érdekében. Itt adhat visszajelzést és nyújthat be kérelmet.