
Cette vidéo explique comment utiliser Fivetran + AWS Lambda pour récupérer des données d’ Tulip table s à intervalles réguliers et mettre à jour diverses destinations telles que des entrepôts de données, des bases de données, des lacs de données, etc.
Optimisez l’ingénierie des données Tulip grâce à l’intégration Fivetran
Objectif
La rationalisation des pipelines d’ingénierie des données avec Tulip permet d’exploiter les données des tables Tulip à l’échelle de l’entreprise
Configuration
La configuration nécessite les éléments suivants :* Compte Fivetran (version gratuite disponible)* Compte AWS (ou autre compte cloud)* Base de données ou entrepôt de données pour recevoir les données des tables Tulip* Connaissances avancées en Python
Fonctionnement
La configuration de cette automatisation Fivetran s'effectue selon les étapes suivantes :
- Configurer un compte Fivetran
- Créer une destination (par exemple, Snowflake)
- Créer une fonction de connexion à l'aide d'une fonction AWS Lambda
- Créer une fonction AWS Lambda
- Finaliser la fonction de connecteur
- Tester le connecteur Fivetran et ajuster la fréquence de rafraîchissement
Fivetran utilise la fonction Lambda pour récupérer automatiquement les données des tables Tulip selon une fréquence planifiée et mettre à jour les bases de données ou les entrepôts de données de destination. L’exemple fourni est une fonction simple qui réécrit la table avec les nouvelles données actualisées. Des fonctionnalités supplémentaires peuvent être ajoutées pour améliorer les déclencheurs basés sur les événements.
Instructions de configuration
Créer un compte Fivetran
Vous devez tout d’abord créer un compte Fivetran. La plateforme propose une version gratuite avec un nombre limité d’actualisations par mois
Configurer la destination
Cliquez ensuite sur « Destinations » et créez votre première destination. Il s’agit essentiellement de la base de données ou de l’entrepôt de données qui recevra les données des tables Tulip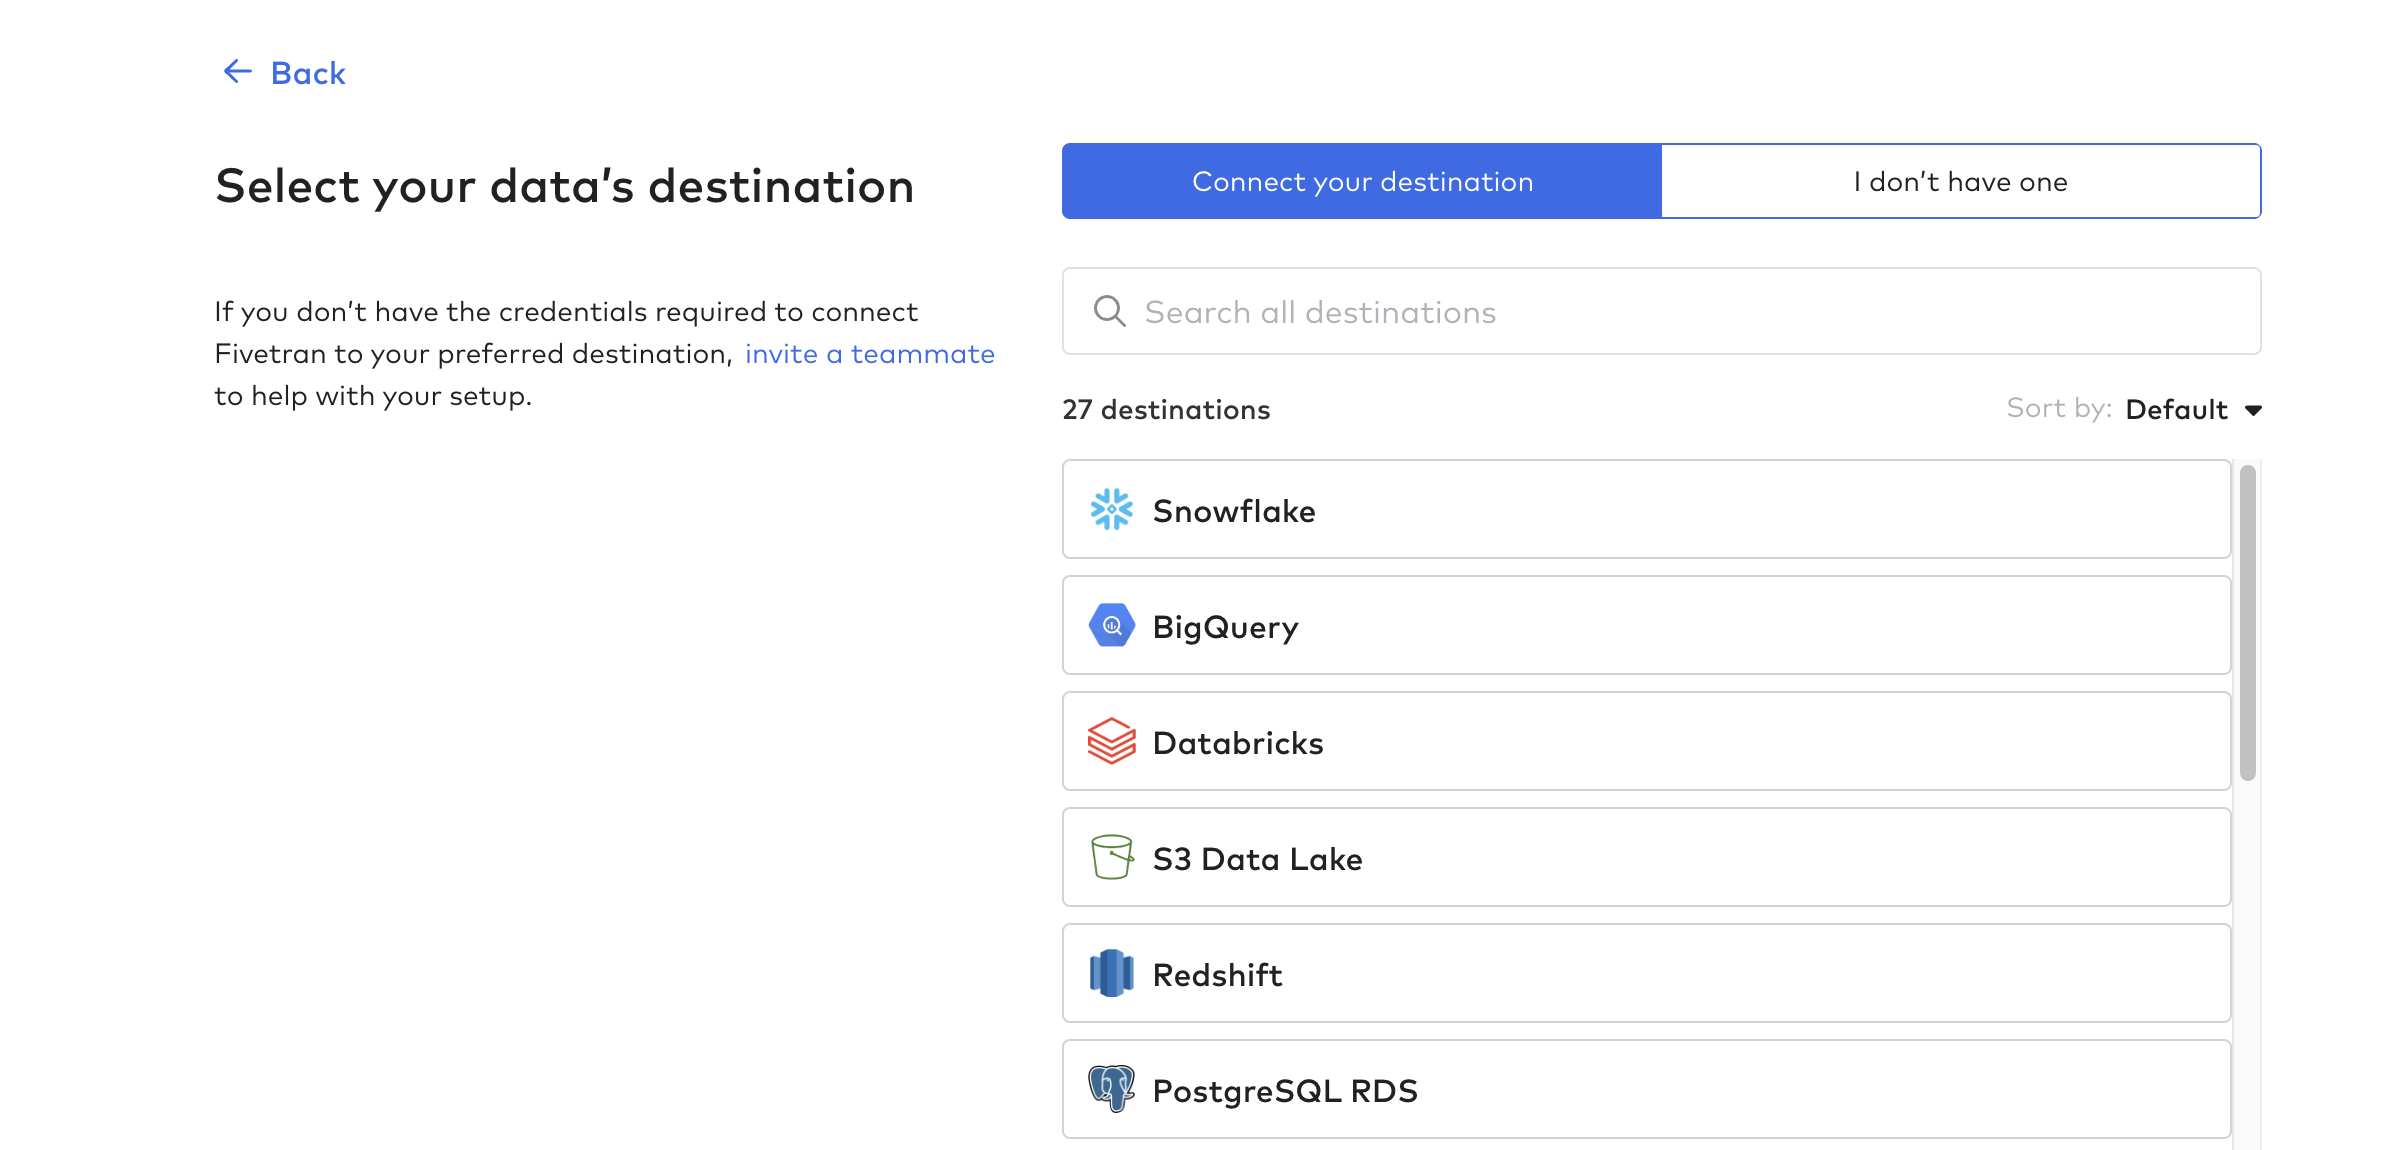
Créer une fonction de connecteur
Créez ensuite la fonction de connexion ; il s’agit du processus permettant d’automatiser le pipeline de données depuis Tulip. Vous pouvez utiliser n’importe quelle fonction cloud, telle qu’AWS Lambda, Azure Functions ou GCP Cloud Functions. Dans cet exemple, nous utiliserons AWS Lambda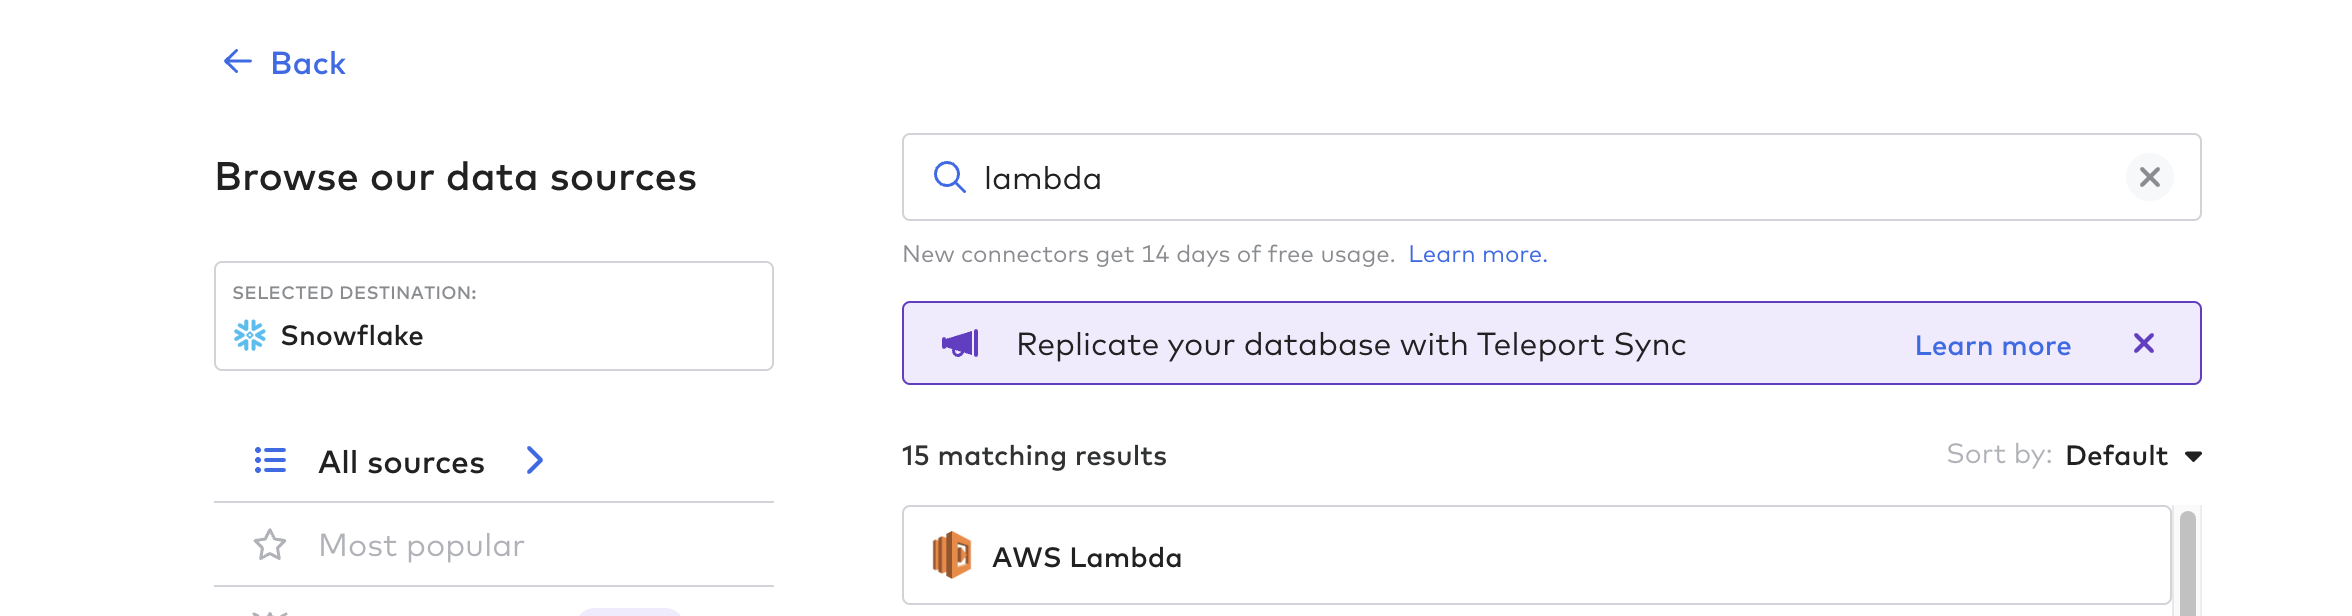
Suivez les instructions fournies dans Fivetran pour créer une fonction Lambda sur AWS avec les rôles etautorisationsappropriés. Consultez le lien pour obtenir un modèle de fonction Lambda comme point de départ. Voici quelques conseils utiles :
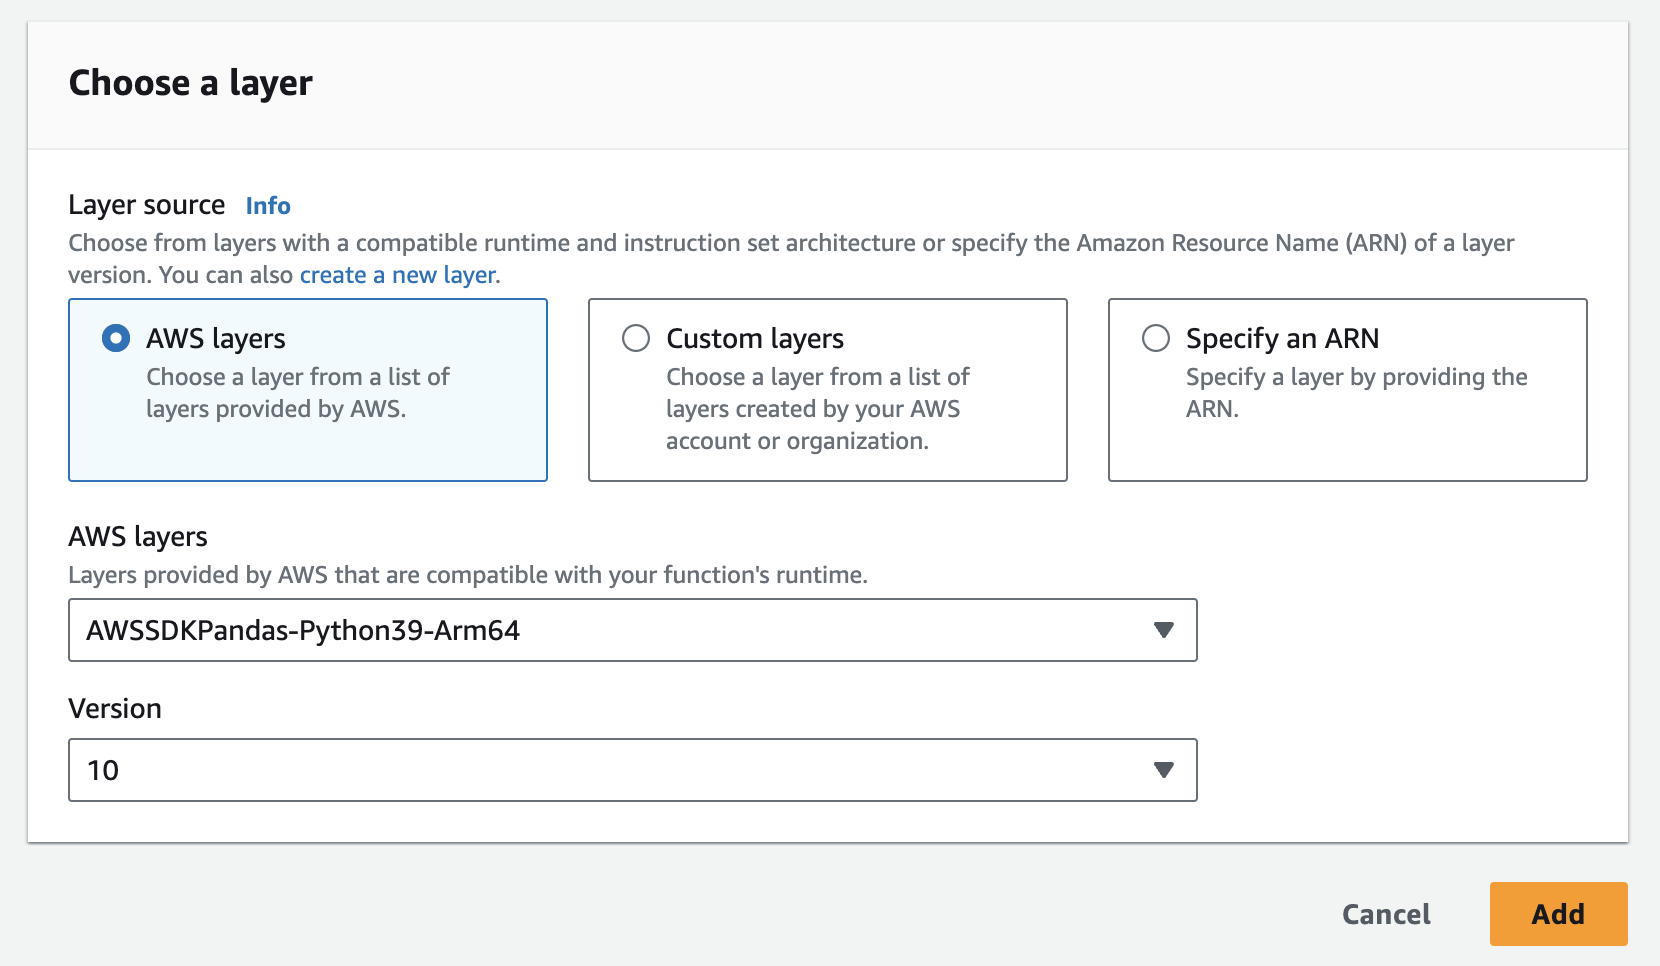
- Vous devrez créer deux couches : l’une pour la bibliothèque Tulip, l’autre pour la bibliothèque pandas
- Vous pouvez consulter l’API de la communauté Tulip ici
- Vous pouvez également télécharger le fichier zip ici (celui-ci a été préparé pour être ajouté à une couche)
- Vous pouvez facilement ajouter la couche pandas dans AWS ci-dessous :
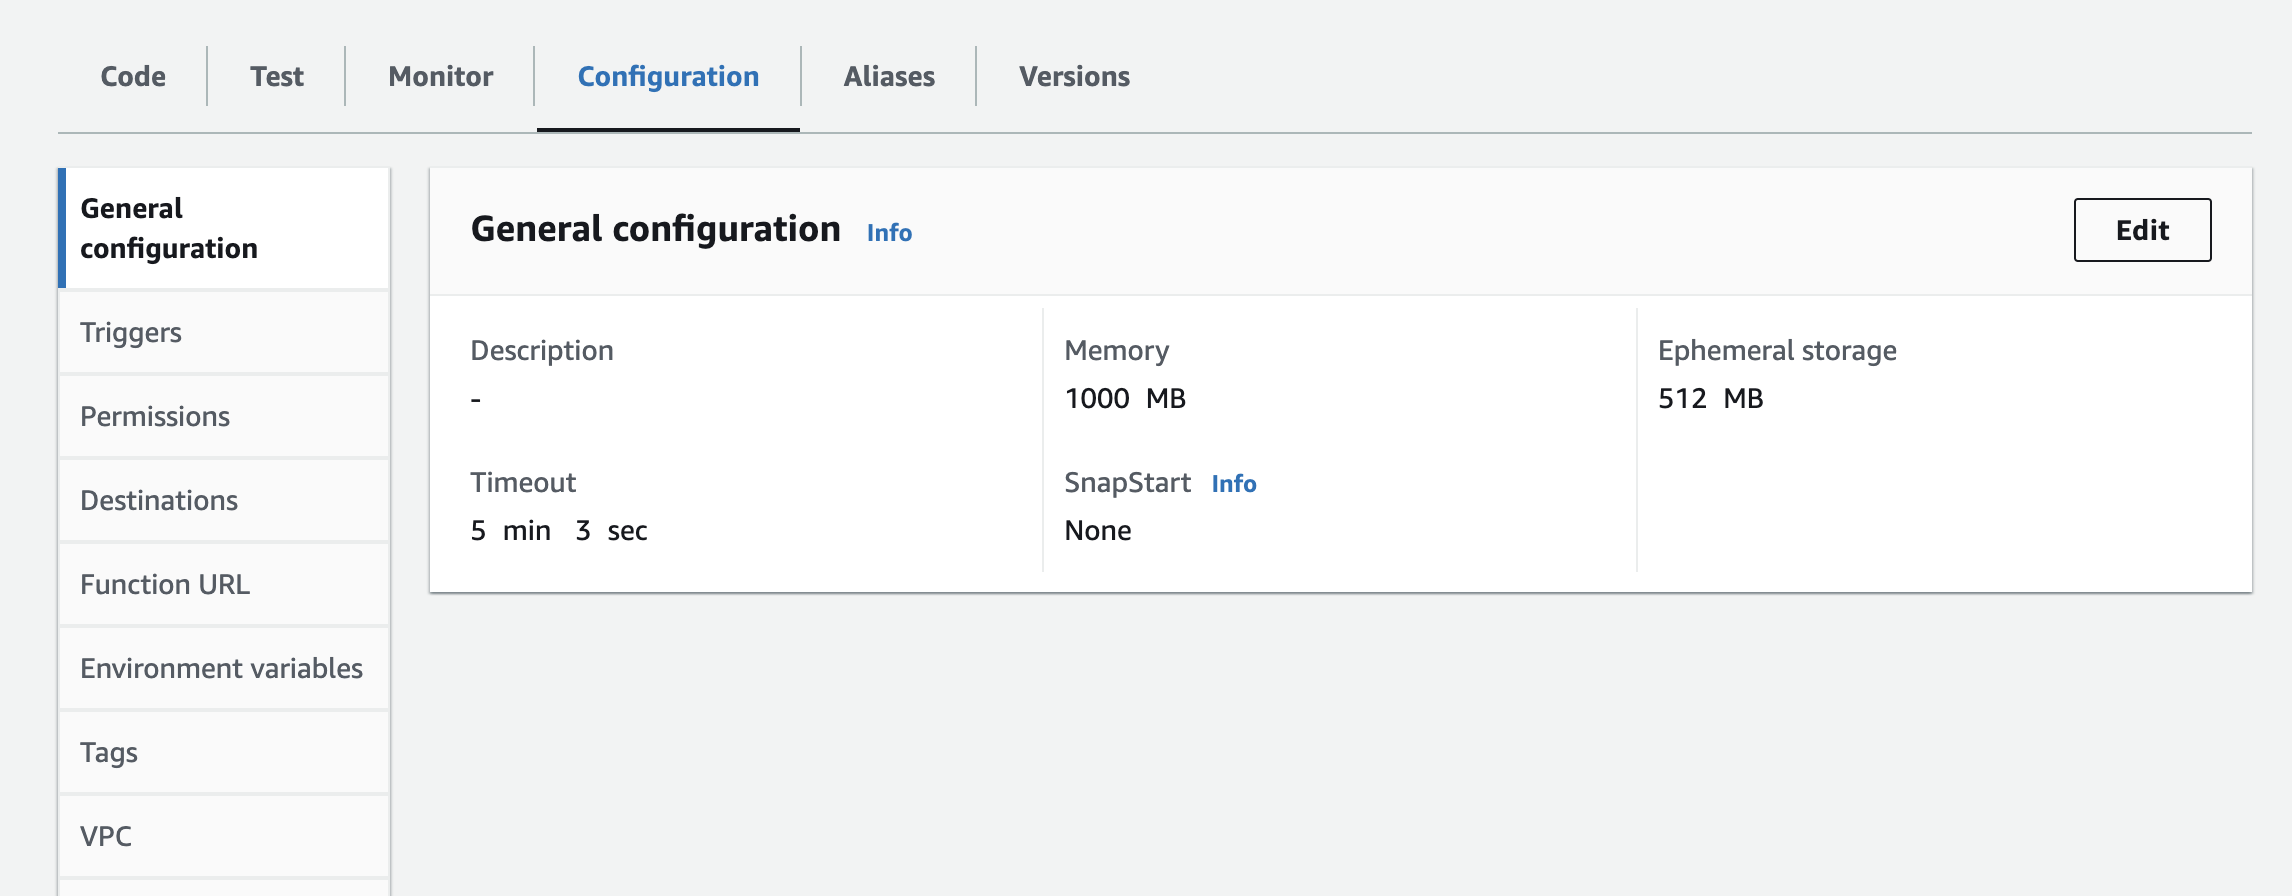
- Vous devrez ajouter l’instance, la clé API et le secret API en tant que variables d’environnement à la fonction Lambda. Vous devrez peut-être mettre à jour les paramètres d’exécution pour augmenter le délai d’expiration et la mémoire utilisée. Capture d’écran ci-dessous pour la mise à jour de la configuration
Étapes suivantes
Une fois que la fonction de connexion fonctionne, vous pouvez ajuster la fréquence de rafraîchissement, consulter les informations des tables Tulip dans la base de données ou l’entrepôt de données de destination, et bénéficier de fonctionnalités supplémentaires
Quelques cas d’utilisation spécifiques de ce pipeline de données :* Analyse et traitement des données Tulip à l’échelle de l’entreprise* Automatisations par lots avec des systèmes d’entreprise* Contextualisation à l’aide d’entrepôts de données et de lacs de données
Ressources supplémentaires
Contactez Fivetran pour obtenir une assistance supplémentaire ici.Contactez Fivetran pour obtenir une assistance supplémentaire ici. * De plus, Fivetran met à disposition un formulaire permettant d’effectuer des ajustements et de soumettre des demandes pour une intégration simplifiée des tables Tulip. Envoyez vos commentaires et vos demandes ici