

**「画像からテキストを抽出」**トリガーアクションは、クエリに基づいて画像からテキストを抽出します。これは「クエリベースのOCR(光学式文字認識)」、あるいは「クエリを指定して画像からテキストを抽出する」とも表現できます。
このトリガーは、常に画像内に実際に存在するテキストのみを返します。追加の情報や解釈を加えることはありません。このため、物理的な世界からデジタル世界へデータを転送する際に非常に強力な機能となります。
使用例:
- **外部ベンダーからの注文書データを取り込む。サプライヤーの請求書にある14文字のPO番号をWMSに手動で転記する手間は不要です。**シンプルなアプリと「画像からテキストを抽出」を組み合わせれば、このデータを数秒で取り込むことができます。
- **紙のフォームをデジタル化します。**既存の紙の伝票に含まれるデータは、Tulipアプリ内でアクセスできるようになれば、さらに価値が高まります。「画像からテキストを抽出」アクションは、物理世界とデジタル世界をつなぐ優れた仕組みです。
- **オペレーターにとって不慣れな言語のテキストを、確実に処理します。**製造業界はグローバル化が進んでいます。「画像からテキストを抽出」と「翻訳」のトリガーアクションを組み合わせることで、紙ベースの情報をオペレーターが実際に活用できる形に変換し、オペレーターに「超能力」を与えましょう。
トリガーの例
モバイルアプリを使って製品のラベルを撮影し、ロット番号を取得します。
| 画像 | トリガー | 結果 |
|---|---|---|
| image.png{height="" width="400"} | image.png{height="" width="400"} | 11EP8F4WA58CCX |
画像から値を抽出
入力と出力
このトリガーアクションには、「入力画像」と「クエリ」の 2 つの入力と、抽出されたテキストという 1 つの出力があります。
入力:入力画像
これは、テキストを抽出する対象となる画像です。この画像は、カメラ入力ウィジェット、Tulip Vision、または外部システムから取得できます。
| サポートされているデータ型 | |
|---|---|
| 入力 | 画像URL |
入力:クエリ
これは、画像や文書からテキストを抽出するために使用されるクエリです。
クエリのベストプラクティス:* 可能な限り、文書内の単語を使用してください。これは特に頭字語や略語(例:SN、ID、SSN、ロット番号など)の場合に役立ちます。「テキスト抽出」トリガーアクションは、「データ/文書からの質問への回答」トリガーアクションに比べて、より単純なクエリに対応しています。 * 例:適切な入力:「サプライヤーは誰ですか?」 * 例:不適切な入力:「誰がこれを送ってきたと思いますか?」* 情報の位置を指定することも有効です(例:「下部に記載されている参照番号は何ですか?」)
| サポートされるデータ型 | |
|---|---|
| 入力 | テキスト |
出力:抽出されたテキスト
これは、クエリに基づいて画像から抽出されたテキストです。
| サポートされているデータ型 | |
|---|---|
| 出力 | テキスト |
画像/文書から値を抽出
Extracting values from documents is a relatively slow operation. We limit documents to 10 pages to limit execution time.
「画像/文書から値を抽出」は、「画像から値を抽出」と同様に機能しますが、一連の質問に対応しています。これにより、「画像から値を抽出」トリガーアクションを実行する場合よりも、パフォーマンスが大幅に向上します。
入力:入力画像/文書
テキストを抽出する対象となる画像です。これは、カメラ入力ウィジェット、Tulip Vision、または外部システムから取得できます。ファイルの場合は、静的に設定するか、ファイル入力ウィジェットから入力するか、Tablesに保存されたファイルを参照することができます。
| サポートされるデータ型 | |
|---|---|
| 入力 | 画像URL |
入力:クエリ
これは、画像からテキストを抽出するために使用されるクエリです。テキスト値の配列またはリストである必要があります。
| サポートされているデータ型 | |
|---|---|
| 入力 | テキストリスト |
出力: 抽出されたテキスト
これは、クエリに基づいて画像から抽出されたテキストです。
| サポートされているデータ型 | |
|---|---|
| 出力 | オブジェクトの配列。各要素には「Question」および「Answer」属性が含まれます。 |
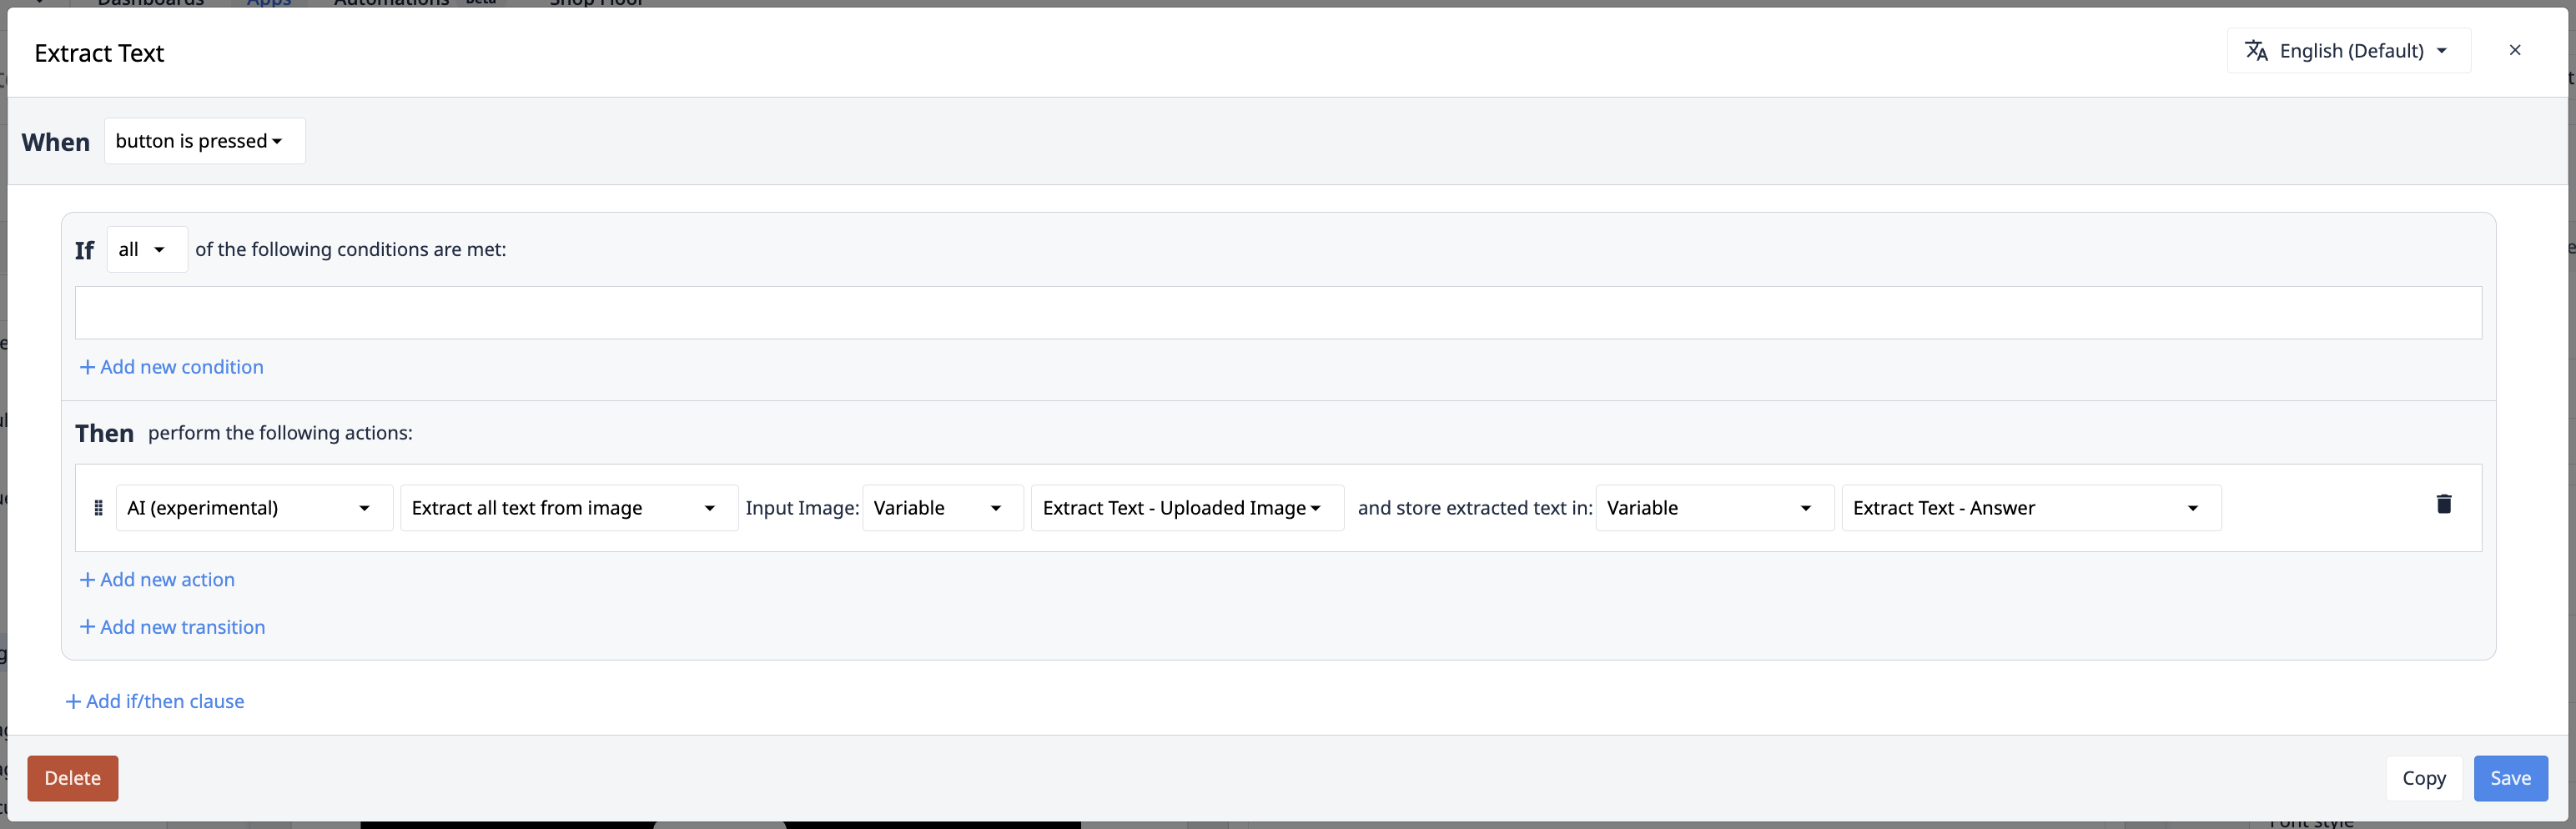
画像/文書からすべてのテキストを抽出
場合によっては、値抽出トリガーアクションの「キー:値」というパラダイムが、ご利用のユースケースには適さないことがあります。画像からすべてのデータを読み取ることで、Copilotで対処できる問題の幅がほぼ無限に広がります。「すべてのテキストを抽出」トリガーアクションは、この柔軟性を提供します。
入力:入力画像/文書
これは、テキストを抽出する対象となる画像です。カメラ入力ウィジェット、Tulip Vision、または外部システムから取得できます。ファイルの場合は、静的に設定したり、ファイル入力ウィジェットで入力したり、Tablesに保存されたファイルを参照したりできます。
| サポートされるデータ型 | |
|---|---|
| 入力 | 画像URLまたはファイルURL |
出力:抽出されたテキスト
これは、対象の画像または文書に含まれるすべてのテキストです。文書の場合、データの配列が返され、各要素は提供された文書の1ページ分のテキストを表します。
| サポートされているデータ型 | |
|---|---|
| 出力 | (画像の場合)テキスト。(ドキュメントの場合)テキストのリスト |
例外ケース
入力画像がない、および/またはクエリが指定されていない場合
トリガーアクションに入力画像またはクエリが指定されていない場合、アプリは次のシステムエラーを表示します:「入力またはクエリが空です」
これは、以下のすべてのケースで発生します:* 入力画像および/またはクエリ入力に値が割り当てられていない場合。これは「null」に相当します。* クエリに空の文字列が割り当てられている場合。
クエリに対する結果がない場合
クエリに対する結果が見つからない場合、トリガーアクションは空のテキストを返します。
制限
The following languages are the only ones supported for documents where values are being extracted: English, Spanish, Italian, Portuguese, French, German.
これらの制限は、Instance レベルで追跡されます。これらの制限を超えた場合、「画像からテキストを抽出」トリガーアクションは失敗します。
「画像からテキストを抽出」トリガーには、以下の制限があります:
| 制限 | |
|---|---|
| 画像サイズ | 5MB |
| 月間制限 | 月間10,000リクエスト |
| レート制限 | 1分あたり10リクエスト |
| 抽出される値の数 | アクションごとに15個の値を抽出 |
アカウントの利用状況を含むその他の制限については、「Tulip AIの利用と料金」をご覧ください。