

Akcja wyzwalająca „Wyodrębnij tekst z obrazu ” wyodrębnia tekst z obrazu na podstawie zapytania. Innym sposobem opisania tego jest „OCR (optyczne rozpoznawanie znaków) oparte na zapytaniu” lub „Wyodrębnij tekst z obrazu, prosząc o to”.
Akcja ta zawsze zwraca wyłącznie tekst faktycznie obecny na obrazie. Nie dodaje do niego żadnych dodatkowych informacji ani interpretacji. Dzięki temu jest to bardzo skuteczne narzędzie do przenoszenia danych ze świata fizycznego do świata cyfrowego.
Przykładowe zastosowania:
- Pobieranie danych z formularza zamówienia od zewnętrznego dostawcy. Nie musisz już ręcznie przenosić 14-znakowego numeru zamówienia z faktury dostawcy do systemu WMS – połącz prostą aplikację z akcją „Wyodrębnij tekst z obrazu”, aby pobrać te dane w ciągu kilku sekund.
- Digitalizacja formularzy papierowych. Dane zawarte w istniejących dokumentach papierowych stają się jeszcze cenniejsze, gdy można uzyskać do nich dostęp w aplikacjach Tulip. Akcje „Wyodrębnij tekst z obrazu” to świetny mechanizm łączący świat fizyczny ze światem cyfrowym.
- Niezawodna praca z tekstem w językach obcych dla operatorów. Świat produkcji jest globalny – zapewnij swoim operatorom supermoce, łącząc akcje wyzwalające „Wyodrębnij tekst z obrazu” i „Przetłumacz”, aby przekształcić informacje w formie papierowej w coś, na podstawie czego operatorzy mogą podjąć działania.
Przykład uruchomienia
Użyj aplikacji mobilnej, aby zrobić zdjęcie etykiety na produkcie i uzyskać numer partii.
| Obraz | Wyzwalacz | Wynik |
|---|---|---|
| image.png{height="" width="400"} | image.png{height="" width="400"} | 11EP8F4WA58CCX |
Wyodrębnij wartość z obrazu
Dane wejściowe i wyjściowe
Akcja wyzwalająca posiada dwa wejścia: Obraz wejściowy i Zapytanie oraz jedno wyjście: wyodrębniony tekst.
Wejście: obraz wejściowy
Jest to obraz, z którego ma zostać wyodrębniony tekst. Może on pochodzić z widżetu wejściowego kamery, z Tulip Vision lub z systemów zewnętrznych.
| Obsługiwany typ danych | |
|---|---|
| Wejście | Adres URL obrazu |
Wejście: zapytanie
Jest to zapytanie używane do wyodrębniania tekstu z obrazu lub dokumentu.
Najlepsze praktyki dotyczące zapytań:* W miarę możliwości używaj słów pochodzących z dokumentu. Jest to szczególnie pomocne w przypadku akronimów i skrótów (np. SN, ID, SSN, nr partii itp.). Akcje wyzwalające „Wyodrębnij tekst” obsługują mniej złożone zapytania niż akcje wyzwalające „Odpowiedz na pytanie na podstawie danych/dokumentu”. * Przykład dobrego zapytania: „Kto jest dostawcą?” * Przykład złego zapytania: „Jak myślisz, kto mógł nam to wysłać?”* Pomocne może być również wskazanie lokalizacji informacji (np. „Jaki jest numer referencyjny na dole?”)
| Obsługiwane typy danych | |
|---|---|
| Dane wejściowe | Tekst |
Wynik: wyodrębniony tekst
Jest to tekst wyodrębniony z obrazu na podstawie zapytania.
| Obsługiwany typ danych | |
|---|---|
| Wynik | Tekst |
Wyodrębnij wartości z obrazu/dokumentu
Extracting values from documents is a relatively slow operation. We limit documents to 10 pages to limit execution time.
Funkcja „Wyodrębnij wartości z obrazu/dokumentu” działa tak samo jak „Wyodrębnij wartość z obrazu”, ale obsługuje szereg pytań. Zapewnia to znacznie większą wydajność niż uruchamianie akcji wyzwalającej „Wyodrębnij wartość z obrazu”.
Dane wejściowe: obraz/dokument wejściowy
Jest to obraz, z którego ma zostać wyodrębniony tekst. Może on pochodzić z widżetu wejściowego kamery, serwisu Tulip Vision lub systemów zewnętrznych. W przypadku plików można je ustawić statycznie, wprowadzić za pomocą widżetu wejściowego plików lub odwołać się do plików przechowywanych w tabelach.
| Obsługiwane typy danych | |
|---|---|
| Dane wejściowe | Adres URL obrazu |
Wejście: zapytanie
Jest to zapytanie używane do wyodrębniania tekstu z obrazu. Powinna to być tablica/lista wartości tekstowych.
| Obsługiwany typ danych | |
|---|---|
| Dane wejściowe | Lista tekstowa |
Wynik: wyodrębniony tekst
Jest to tekst wyodrębniony z obrazu na podstawie zapytania.
| Obsługiwany typ danych | |
|---|---|
| Wynik | Tablica obiektów. Każdy element będzie posiadał atrybuty „Pytanie” i „Odpowiedź”. |
Wyodrębnij cały tekst z obrazu/dokumentu
W niektórych przypadkach model „klucz:wartość” akcji wyzwalających typu „wyodrębnij wartość” nie ma sensu w danym przypadku użycia. Odczytanie wszystkich danych z obrazu zapewnia niemal nieograniczoną elastyczność w zakresie problemów, które może rozwiązać Copilot. Akcje wyzwalające typu „Wyodrębnij cały tekst” zapewniają tę elastyczność.
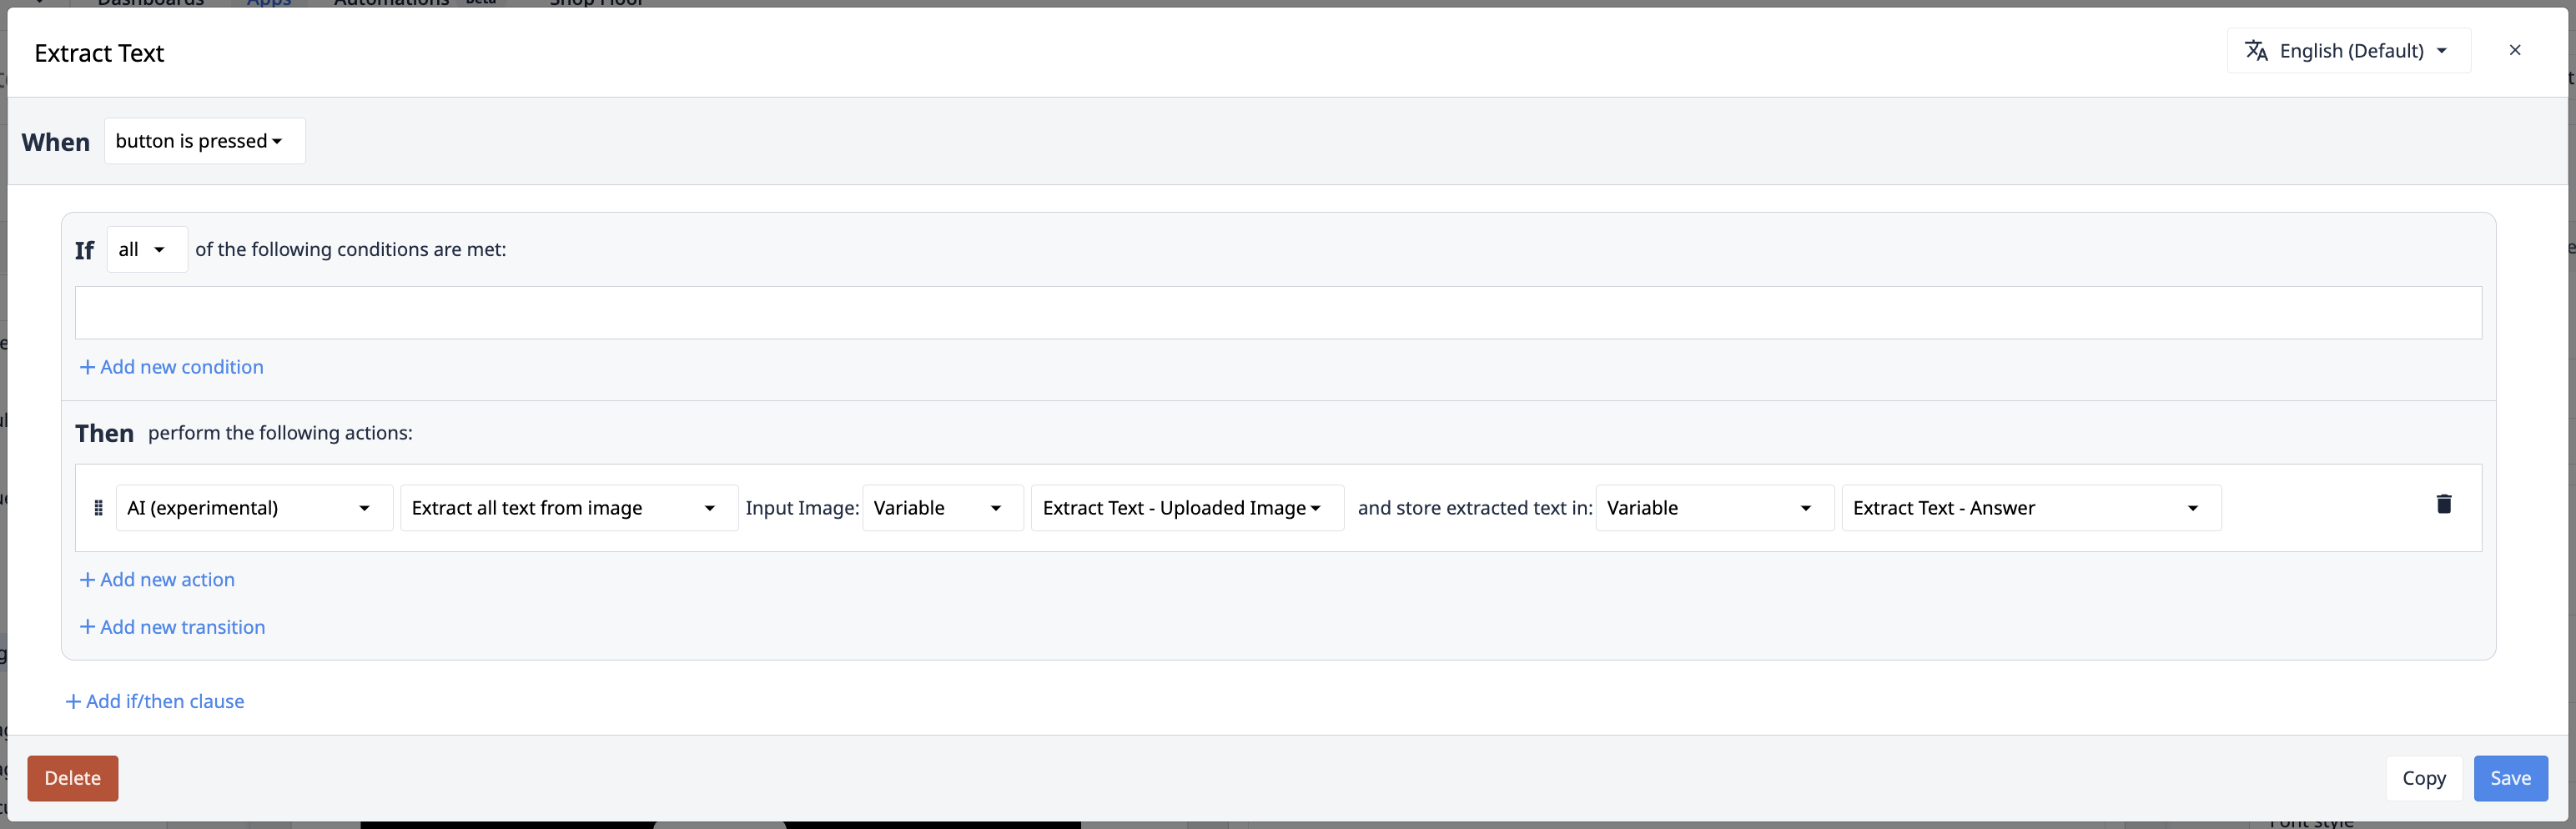
Dane wejściowe: obraz/dokument
Jest to obraz, z którego należy wyodrębnić tekst. Może on pochodzić z widżetu wejściowego kamery, Tulip Vision lub systemów zewnętrznych. W przypadku plików można to ustawić statycznie, wprowadzić za pomocą widżetu wejściowego plików lub odwołać się do plików przechowywanych w tabelach.
| Obsługiwany typ danych | |
|---|---|
| Dane wejściowe | Adres URL obrazu lub adresu pliku |
Wynik: wyodrębniony tekst
Jest to cały tekst znaleziony na danym obrazie lub w danym dokumencie. W przypadku dokumentów zwracana jest tablica danych, w której każdy element reprezentuje tekst z jednej strony dostarczonego dokumentu.
| Obsługiwany typ danych | |
|---|---|
| Wynik | (dla obrazów) Tekst. (dla dokumentów) Lista tekstowa |
Sytuacje graniczne
Brak obrazu wejściowego i/lub brak podanego zapytania
Jeśli do akcji wyzwalającej nie podano obrazu wejściowego ani zapytania, aplikacja wyświetli następujący błąd systemowy:Twoje dane wejściowe lub zapytanie są puste
Dzieje się tak we wszystkich poniższych przypadkach:* Obraz wejściowy i/lub zapytanie nie mają przypisanej wartości. Jest to równoważne z „null”.* Zapytaniu przypisano pusty ciąg znaków.
Brak wyników dla zapytania
Jeśli nie znaleziono żadnego wyniku dla zapytania, akcja wyzwalająca zwróci pusty tekst.
Limity
The following languages are the only ones supported for documents where values are being extracted: English, Spanish, Italian, Portuguese, French, German.
Ograniczenia te są monitorowane na poziomie Instance. W przypadku przekroczenia tych limitów akcja wyzwalająca „Wyodrębnij tekst z obrazu” zakończy się niepowodzeniem.
Dla wyzwalaczy „Wyodrębnij tekst z obrazu” obowiązują następujące limity:
| Limit | |
|---|---|
| Rozmiar obrazu | 5 MB |
| Limit miesięczny | 10 000 żądań miesięcznie |
| Limit częstotliwości | 10 żądań na minutę |
| Liczba wyodrębnianych wartości | 15 wartości wyodrębnianych na akcję |
Aby zapoznać się z dodatkowymi limitami, w tym dotyczącymi wykorzystania konta, zobacz sekcję „Wykorzystanie i ceny Tulip AI”.
{{snippet.Czy znalazłeś to, czego szukałeś?}}