

L’action déclencheuse « Extraire du texte d’une image » extrait du texte d’une image en fonction d’une requête. On peut également décrire ce processus comme un « OCR (reconnaissance optique de caractères) basé sur une requête » ou « extraire du texte d’une image en le demandant ».
Le déclencheur ne renverra toujours que le texte réellement présent dans l’image. Il n’y ajoutera aucune information supplémentaire ni aucune interprétation. Cela en fait un outil très puissant pour transférer des données du monde physique vers le monde numérique.
Exemples d’utilisation :
- Importer les données d’un bon de commande provenant d’un fournisseur externe. Plus besoin de transférer manuellement ce numéro de bon de commande à 14 caractères depuis la facture d’un fournisseur vers votre système de gestion d’entrepôt (WMS) : combinez une application simple et l’action « Extraire le texte d’une image » pour récupérer ces données en quelques secondes.
- Numérisez les formulaires papier. Les données contenues dans les documents papier existants ont encore plus de valeur lorsqu’elles sont accessibles depuis les applications Tulip. Les actions « Extraire le texte d’une image » constituent un excellent moyen de faire le lien entre le monde physique et le monde numérique.
- Travailler de manière fiable avec du texte rédigé dans des langues étrangères à vos opérateurs. Le monde de la fabrication est mondial : donnez des superpouvoirs à vos opérateurs en combinant les actions déclencheuses « Extraire le texte d’une image » et « Traduire » pour transformer les informations sur papier en informations exploitables par vos opérateurs.
Exemple de déclenchement
Utilisez une application mobile pour prendre une photo de l’étiquette d’un produit afin d’obtenir le numéro de lot.
| Image | Déclencheur | Résultat |
|---|---|---|
| image.png{height="" width="400"} | image.png{height="" width="400"} | 11EP8F4WA58CCX |
Extraire une valeur d'une image
Entrées et sorties
L'action de déclenchement comporte deux entrées, « Image d'entrée » et « Requête », ainsi qu'une sortie, le texte extrait.
Entrée : image d'entrée
Il s'agit de l'image à partir de laquelle le texte doit être extrait. Elle peut provenir du widget d'entrée de caméra, de Tulip Vision ou de systèmes externes.
| Type de données pris en charge | |
|---|---|
| Entrée | URL de l'image |
Entrée : requête
Il s'agit de la requête utilisée pour extraire le texte de l'image ou du document.
Bonnes pratiques pour les requêtes :* Dans la mesure du possible, utilisez des mots tirés du document. Cela s’avère particulièrement utile pour les acronymes et les abréviations (par exemple : SN, ID, SSN, n° de lot, etc.). Les actions de déclenchement « Extraire du texte » prennent en charge des requêtes moins complexes que les actions de déclenchement « Répondre à une question à partir de données/d’un document ». * Ex. Bonne saisie : « Qui est le fournisseur ? » * Ex. Mauvaise saisie : « À votre avis, qui aurait pu nous envoyer cela ? »* Préciser l'emplacement de l'information peut également aider (par exemple : « Quel est le numéro de référence indiqué en bas ? »)
| Types de données pris en charge | |
|---|---|
| Entrée | Texte |
Sortie : texte extrait
Il s'agit du texte extrait de l'image en fonction de la requête.
| Type de données pris en charge | |
|---|---|
| Sortie | Texte |
Extraire des valeurs d'une image/d'un document
Extracting values from documents is a relatively slow operation. We limit documents to 10 pages to limit execution time.
La fonction « Extraire des valeurs d’une image/d’un document » fonctionne exactement comme « Extraire une valeur d’une image », mais prend en charge un ensemble de questions. Elle offre des performances nettement supérieures à celles de l’action de déclenchement « Extraire une valeur d’une image ».
Entrée : image/document d'entrée
Il s'agit de l'image à partir de laquelle le texte doit être extrait. Elle peut provenir du widget d'entrée caméra, de Tulip Vision ou de systèmes externes. Pour les fichiers, cette entrée peut être définie de manière statique, saisie à l'aide du widget d'entrée de fichier ou faire référence à des fichiers stockés dans des tables.
| Types de données pris en charge | |
|---|---|
| Entrée | URL de l’image |
Entrée : requête
Il s'agit de la requête utilisée pour extraire le texte de l'image. Elle doit prendre la forme d'un tableau ou d'une liste de valeurs textuelles.
| Type de données pris en charge | |
|---|---|
| Entrée | Liste de texte |
Sortie : texte extrait
Il s'agit du texte qui a été extrait de l'image à partir de la requête.
| Type de données pris en charge | |
|---|---|
| Sortie | Tableau d'objets. Chaque élément comporte les attributs « Question » et « Réponse ». |
Extraire tout le texte d'une image ou d'un document
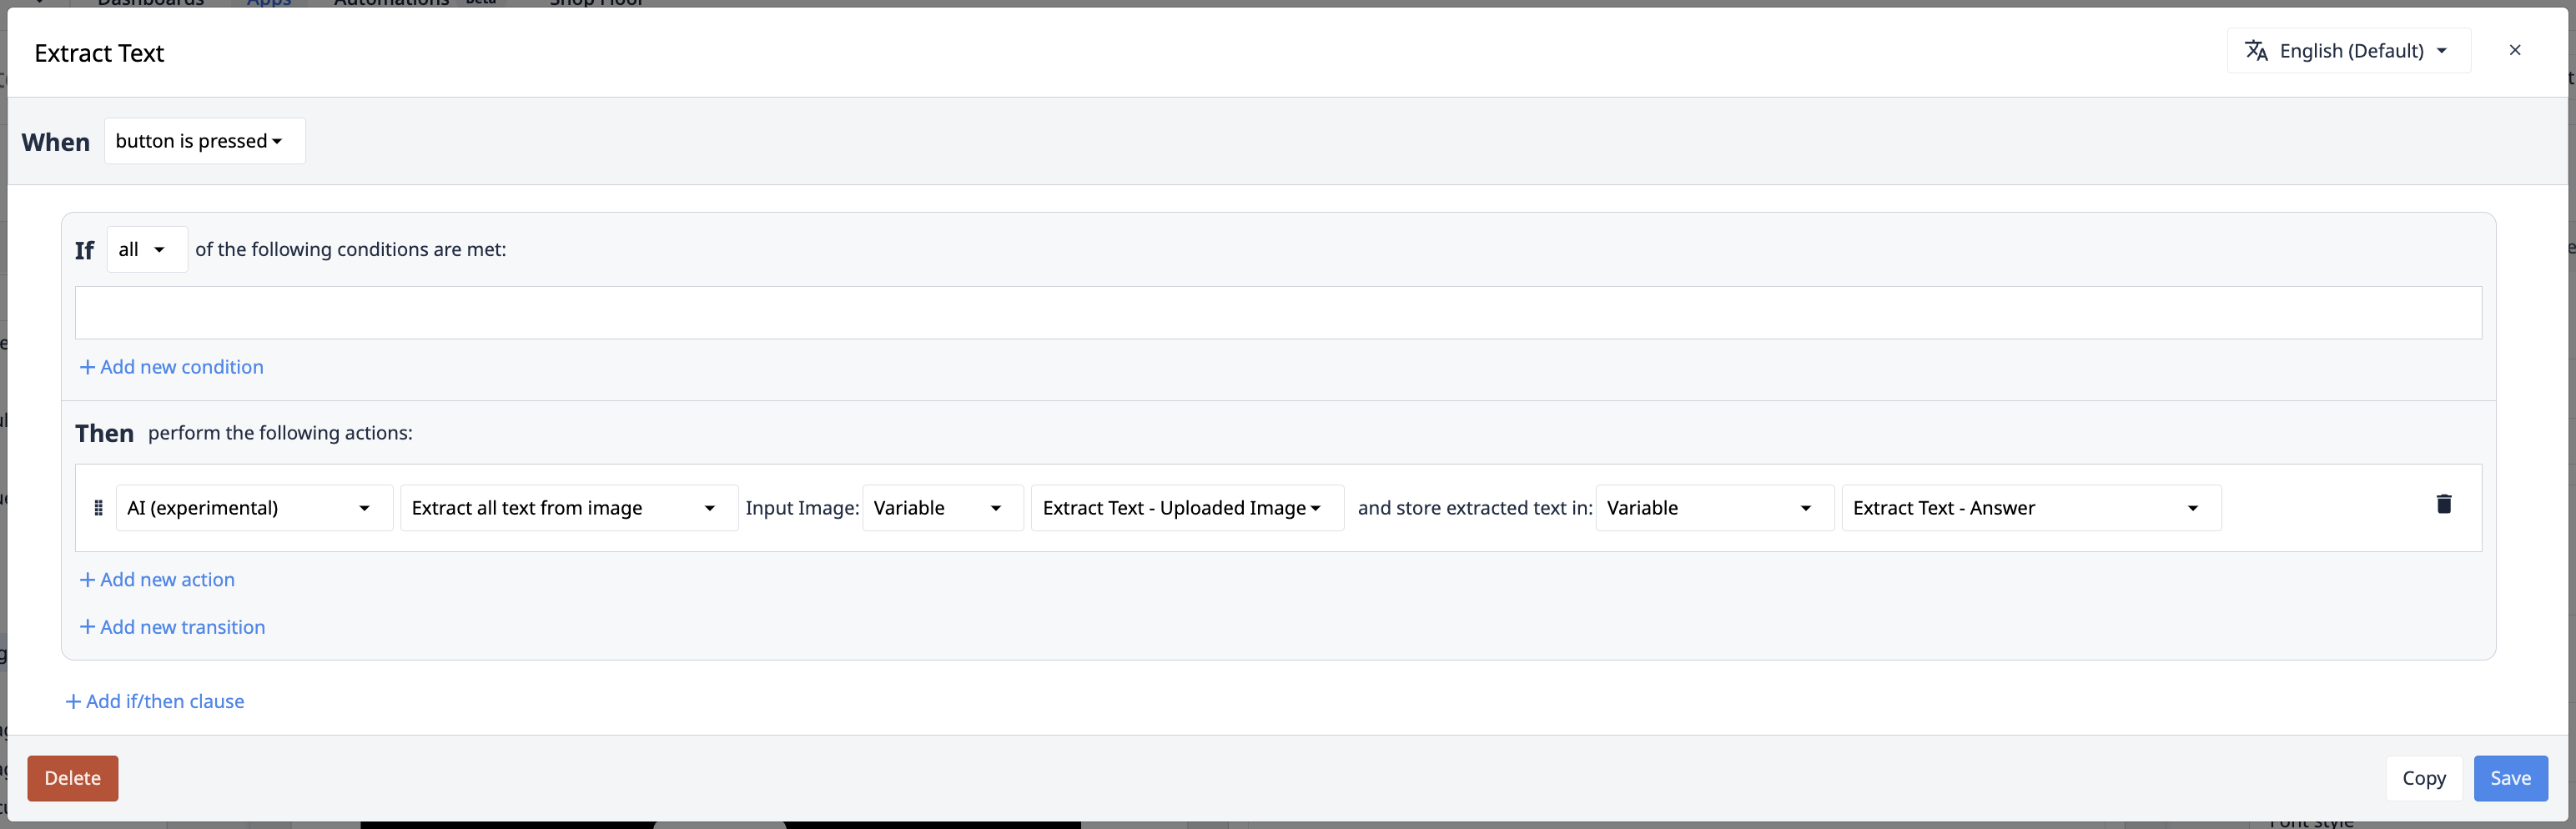
Dans certains cas, le modèle clé-valeur des actions de déclenchement « extraire une valeur » ne convient pas à votre cas d’utilisation. La lecture de toutes les données d’une image offre une flexibilité quasi infinie quant aux problèmes que Copilot peut résoudre. Les actions de déclenchement « Extraire tout le texte » vous offrent cette flexibilité.
Entrée : image ou document d’entrée
Il s’agit de l’image à partir de laquelle le texte doit être extrait. Elle peut provenir du widget d’entrée caméra, de Tulip Vision ou de systèmes externes. Pour les fichiers, cette valeur peut être définie de manière statique, saisie à l’aide du widget d’entrée de fichier ou faire référence à des fichiers stockés dans Tables.
| Types de données pris en charge | |
|---|---|
| Entrée | URL d’image ou URL de fichier |
Sortie : texte extrait
Il s'agit de l'intégralité du texte présent sur l'image ou le document concerné. Les documents renvoient un tableau de données, chaque élément représentant le texte d'une page du document fourni.
| Type de données pris en charge | |
|---|---|
| Sortie | (pour les images) Texte. (pour les documents) Liste de textes |
Cas particuliers
Aucune image d'entrée et/ou aucune requête fournie
Si aucune image d'entrée ou aucune requête n'est fournie à l'action déclencheuse, l'application affichera l'erreur système suivante : «Votre entrée ou votre requête est vide »
Cela se produit dans tous les cas suivants :* Aucune valeur n’est attribuée à l’image d’entrée et/ou à la requête. Cela équivaut à « null ».* Une chaîne vide est attribuée à la requête.
Aucun résultat pour la requête
Si aucun résultat n’a pu être trouvé pour la requête, l’action déclencheuse renverra un texte vide.
Limites
The following languages are the only ones supported for documents where values are being extracted: English, Spanish, Italian, Portuguese, French, German.
Ces limites sont suivies au niveau de l’ Instance. Si ces limites sont dépassées, l’action déclencheuse « Extraire le texte d’une image » échouera.
Les limites suivantes s’appliquent aux déclencheurs « Extraire le texte d’une image » :
| Limite | |
|---|---|
| Taille de l'image | 5 Mo |
| Limite mensuelle | 10 000 requêtes par mois |
| Limite de débit | 10 requêtes par minute |
| Nombre de valeurs extraites | 15 valeurs extraites par action |
Pour connaître les autres limites, notamment celles relatives à l'utilisation du compte, consultez la page Utilisation et tarifs de Tulip AI.
{{snippet.Avez-vous trouvé ce que vous cherchiez ?}}