
TulipからAWS S3へのデータ取得を効率化し、より広範な分析と統合の機会を拡大
目的
このガイドでは、Lambda関数を介してすべてのTulipテーブルのデータを取得し、S3バケットに書き込む方法をステップごとに解説します。
これは基本的な取得クエリの範囲を超え、指定されたインスタンス内のすべてのテーブルを順に処理します。これは、週次 ETL ジョブ(抽出、変換、ロード)に最適です。
Lambda関数は、Event BridgeのタイマーやAPI Gatewayなど、さまざまなリソースを介してトリガーできます。
アーキテクチャの例を以下に示します: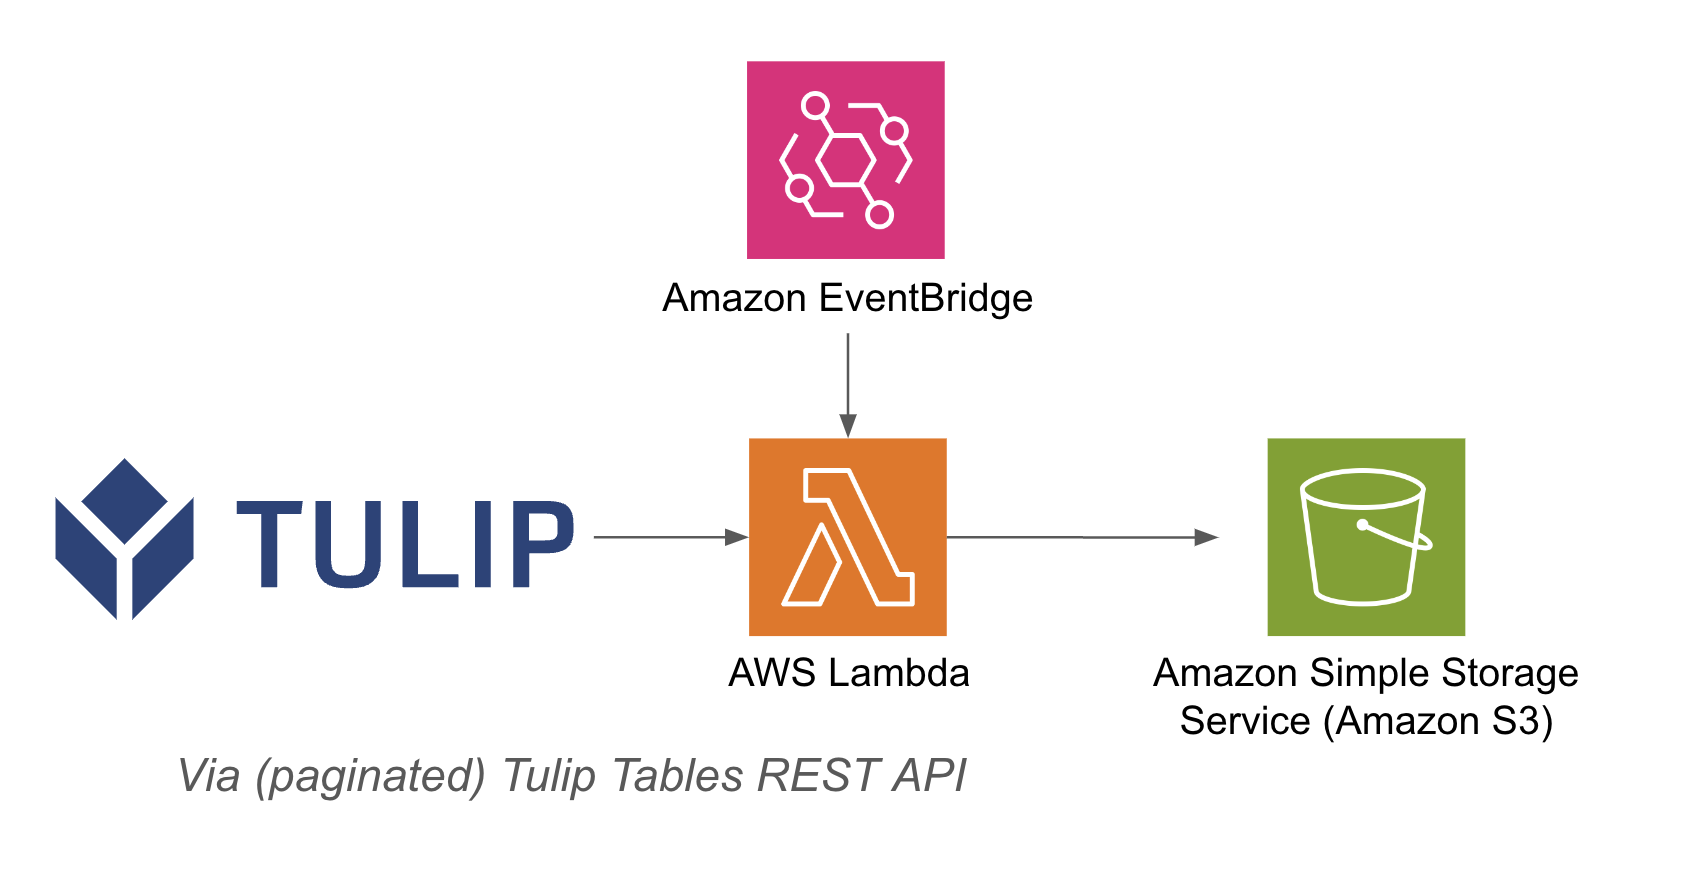
セットアップ
この統合例には、以下が必要です:
- Tulip Tables API の使用(API キーとシークレットはアカウント設定から取得してください)
- Tulipテーブル(テーブルの一意のIDを取得)
大まかな手順:1. 適切なトリガー(API Gateway、Event Bridge Timer など)を設定した AWS Lambda 関数を作成します。2. 適切な Lambda レイヤー(例:pandas や awswrangler など)が使用されていること、および Tulip Tables API キーに十分な権限が含まれていることを確認します。3. 以下の例を使用して、Tulipテーブルのデータを取得します(S3、Glue、Redshiftなど、あらゆるコンテキストで使用可能です)```pythonimport jsonimport awswrangler as wrimport boto3from datetime import datetimeimport pandas as pdimport requestsimport os
# 一意のファイル名用の現在のタイムスタンプを取得する
timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")
bucket = os.getenv('bucket_name')
# 辞書(ディクショナリ)を文字列に変換する関数
def dict_to_str(cell): if isinstance(cell, dict): return str(cell) return cell
def query_table(table_id, base_url, api_header): offset = 0 function = f'/tables/{table_id}/records?limit=100&offset={offset}&includeTotalCount=false&filterAggregator=all' r = requests.get(base_url+function, headers=api_header) df = pd.DataFrame(r.json()) length = len(r.json()) while length > 0: offset += 100 function = f'/tables/{table_id}/records?limit=100&offset={offset}&includeTotalCount=false&filterAggregator=all' r = requests.get(base_url+function, headers=api_header) length = len(r.json()) df_append = pd.DataFrame(r.json()) df = pd.concat([df, df_append], axis=0) df = df.apply(lambda row: row.apply(dict_to_str), axis=1) return df
# 関数の作成
def write_to_s3(row, base_url, api_header, bucket): table = row['label'] id = row['id'] df = query_table(id, base_url, api_header)
path = f's3://{bucket}/{timestamp}/{table}.csv'# DataFrameをCSV形式でS3に書き込みwr.s3.to_csv( df=df, path=path, index=False)print(f"{table}を{path}に書き込みました")return f"{table}を{path}に書き込みました"
def lambda_handler(event, context): api_header = {'Authorization' : os.getenv('tulip_api_basic_auth')} instance = os.getenv('tulip_instance') base_url = f'https://{instance}.tulip.co/api/v3' get_tables_function = '/tables' r = requests.get(base_url+get_tables_function, headers=api_header) table_names = pd.DataFrame(r.json())
# テーブルクエリ関数table_names.apply(lambda row: write_to_s3(row, base_url, api_header, bucket), axis=1)return { 'statusCode': 200, 'body': json.dumps('wrote to s3!')}
## ユースケースと今後の手順

Lambda との統合が完了したら、Sagemaker ノートブック、QuickSight、またはその他のさまざまなツールを使用して、データを簡単に分析できます。

**1. 欠陥予測 -** 生産上の欠陥が発生する前に特定し、「初回から正しく」を実現する。- 品質向上のための改善策を実施するために、生産における品質の主要な要因を特定する

**2. 品質コストの最適化 —** 顧客満足度に影響を与えることなく、製品設計を最適化する機会を特定する

**3. 生産エネルギーの最適化 —** エネルギー消費を最適化するための生産上の改善点を特定する

**4. 納期および計画の予測と最適化 —** 顧客の需要とリアルタイムの受注スケジュールに基づいて、生産スケジュールを最適化します

**5. グローバルな機械・ラインのベンチマーク —** 標準化を行い、類似の機械や設備とのベンチマークを実施する

**6. グローバル/地域別のデジタル業績管理 -** データを集約し、リアルタイムのダッシュボードを作成する