

HTTPコネクタの出力を構成する方法をご覧ください。
概要
Tulipのコネクタ関数エディタを使用すると、コネクタ関数が返すデータを、アプリケーション内で有用かつ利用しやすい形式に構成できます。この記事では、コネクタ関数のOutputのフォーマット設定の基本について、以下の内容を紹介しながら解説します:
- コネクタ出力の概念
- 出力のフォーマット設定に利用できるツール
- 一般的な出力形式の例
出力とは?
出力は、コネクタ関数の戻り値を定義し、構造化するために使用されます。これにより、大規模な HTTP レスポンス本文から、アプリケーションにとって重要な情報を抽出することができます。
出力の構成方法
コネクタ関数エディタの左下にある「出力」セクションを探します。
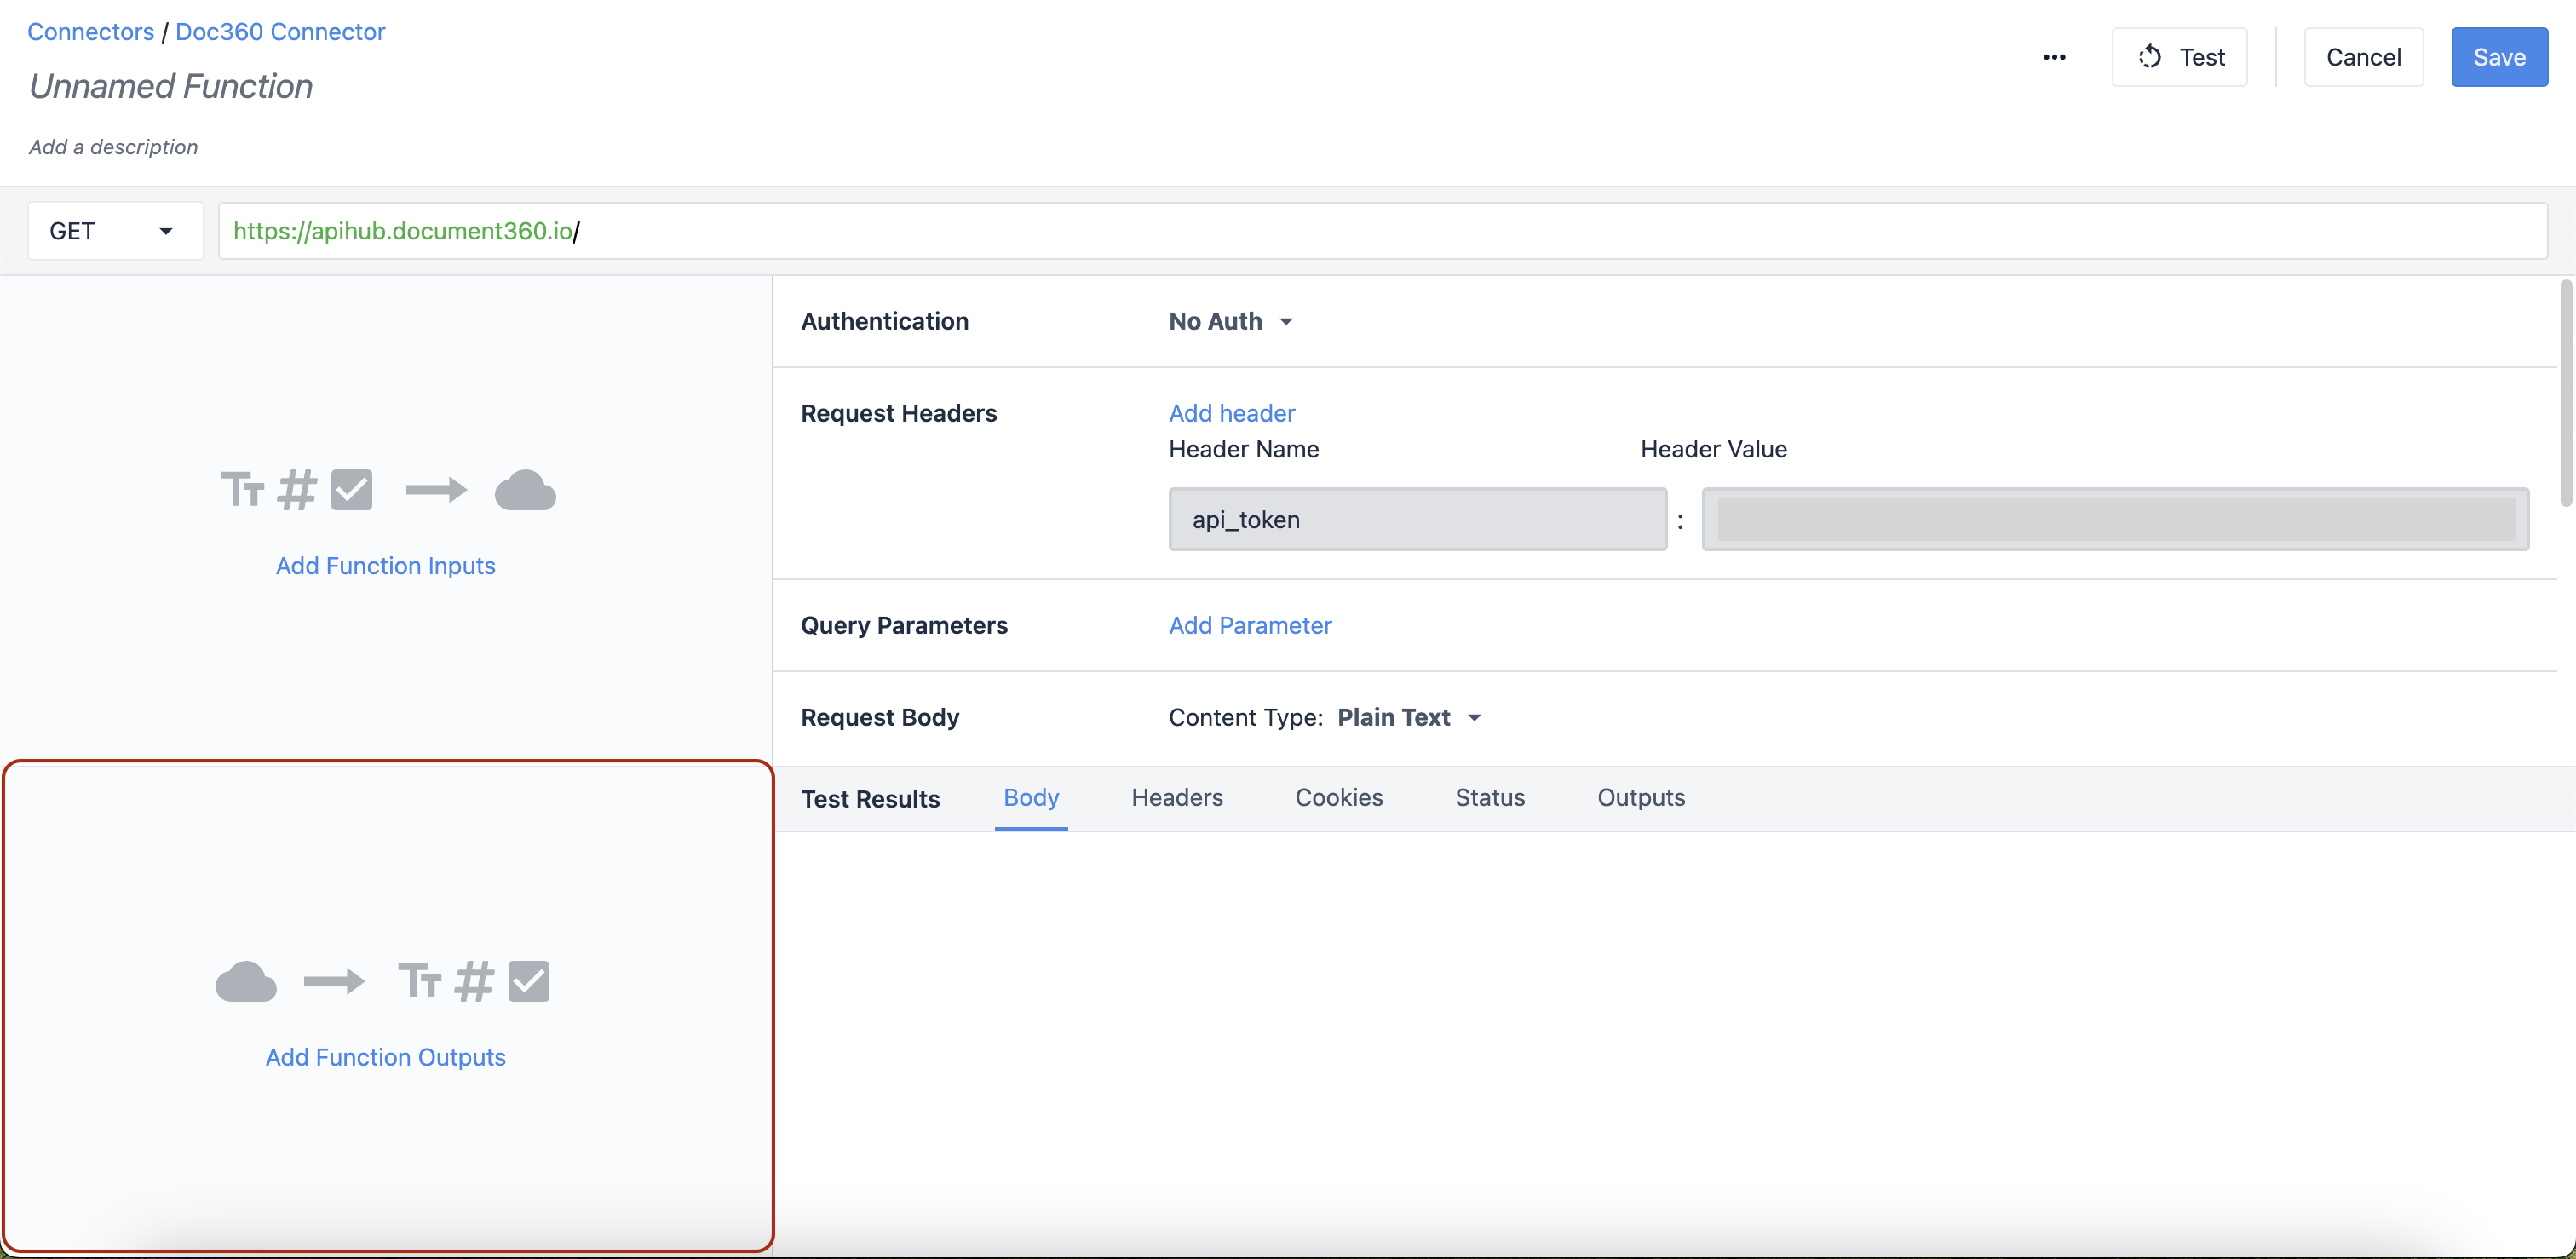
出力の追加を開始するには、「**関数の出力を追加」**をクリックします。
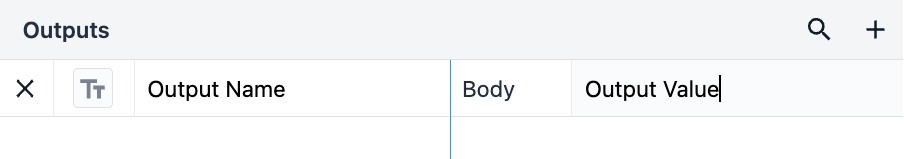
出力には、識別しやすいラベルを付けることをお勧めします。これらの名前はアプリ内で「変数」として表示されるため、区別できることが重要です。
HTTPリクエストの結果を理解するには、まず「テスト結果」で返されるオブジェクトの構造を理解することが重要です。以下の図は、結果が「オブジェクト」と「配列」のセクションにどのように分けられているかを示しています。
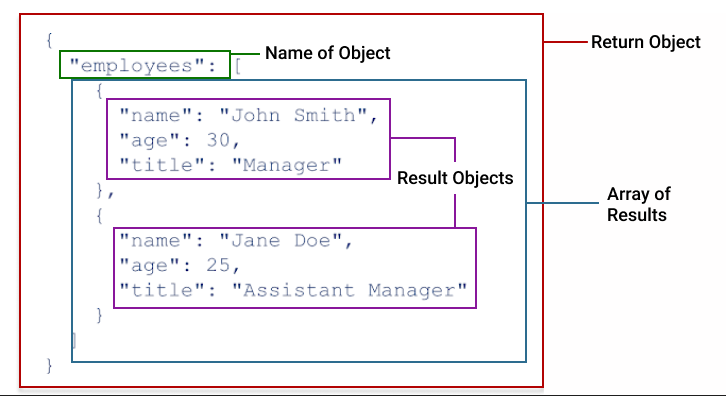
If you haven’t worked with JSON before, you may be unfamiliar with two critical datatypes, objects and arrays. Arrays are lists of values of the same type. For example, [1,2,3,5], or [oak, elm, alder, hickory]. Values in arrays are contained within square brackets, [ ]. Objects are a datatype for holding key:value pairs. The key:value pairs within an object can be of multiple different types, including arrays and nested objects. Objects are contained with curly brackets, { }.
オブジェクトと配列の詳細については、「コネクタ関数の出力における配列とオブジェクトの理解」をご覧ください。
ドット表記
HTTPコネクタの場合、出力にはと呼ばれる形式が使用されます。ドット表記を使用すると、オブジェクト内の値にアクセスできます。 ドット表記は、大規模な JSON レスポンス本文から必要な部分のみを抽出するのに役立ち、HTTP コネクタ関数のフォーマット設定においてより柔軟性を提供します。簡単に言えば、互いにネストされた値に基づいた構造化された形式です。
例を用いて、コネクタの出力におけるドット表記の使い方について詳しく見ていきましょう。
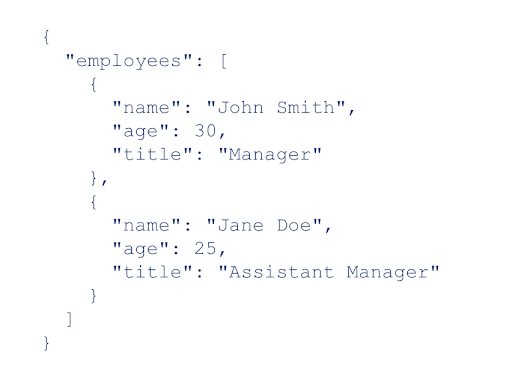
「employees」という名前の以下の例示オブジェクトには、各従業員の詳細を含むオブジェクトの配列が含まれています。各従業員の役職のみにアクセスしたい場合は、employees.title という構文を使用します。ドット(.)を使用して、関心のあるキーに関連付けられた値にアクセスしています。 最初の結果のみを取得したい場合を考えてみましょう。 これを行うには、メインオブジェクト「employees」の名前と、対象となる値「title」の間にインデックス位置を追加して指定します。構文は次のようになります:employees.0.title。より複雑なオブジェクトの場合、必要な情報を取得するためにオブジェクトのさらに奥深くまでアクセスする必要があるかもしれません。
さらに別の例で、この仕組みを詳しく見てみましょう。このケースでは、ナレッジベースの記事に関連する情報を取得するためのコネクタ関数を作成するとします。このコネクタは、特定の記事に関するデータを含む、名前「data」の次のJSONオブジェクトを返します:
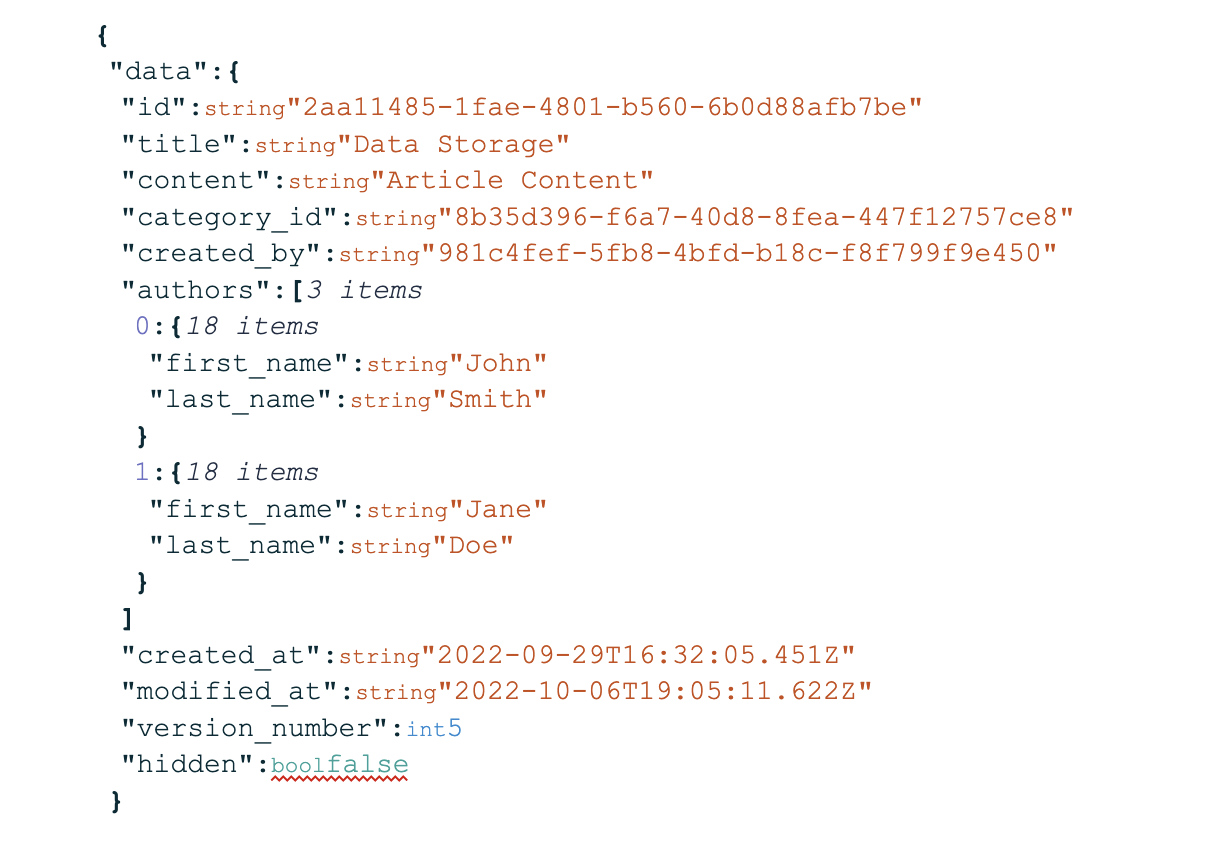
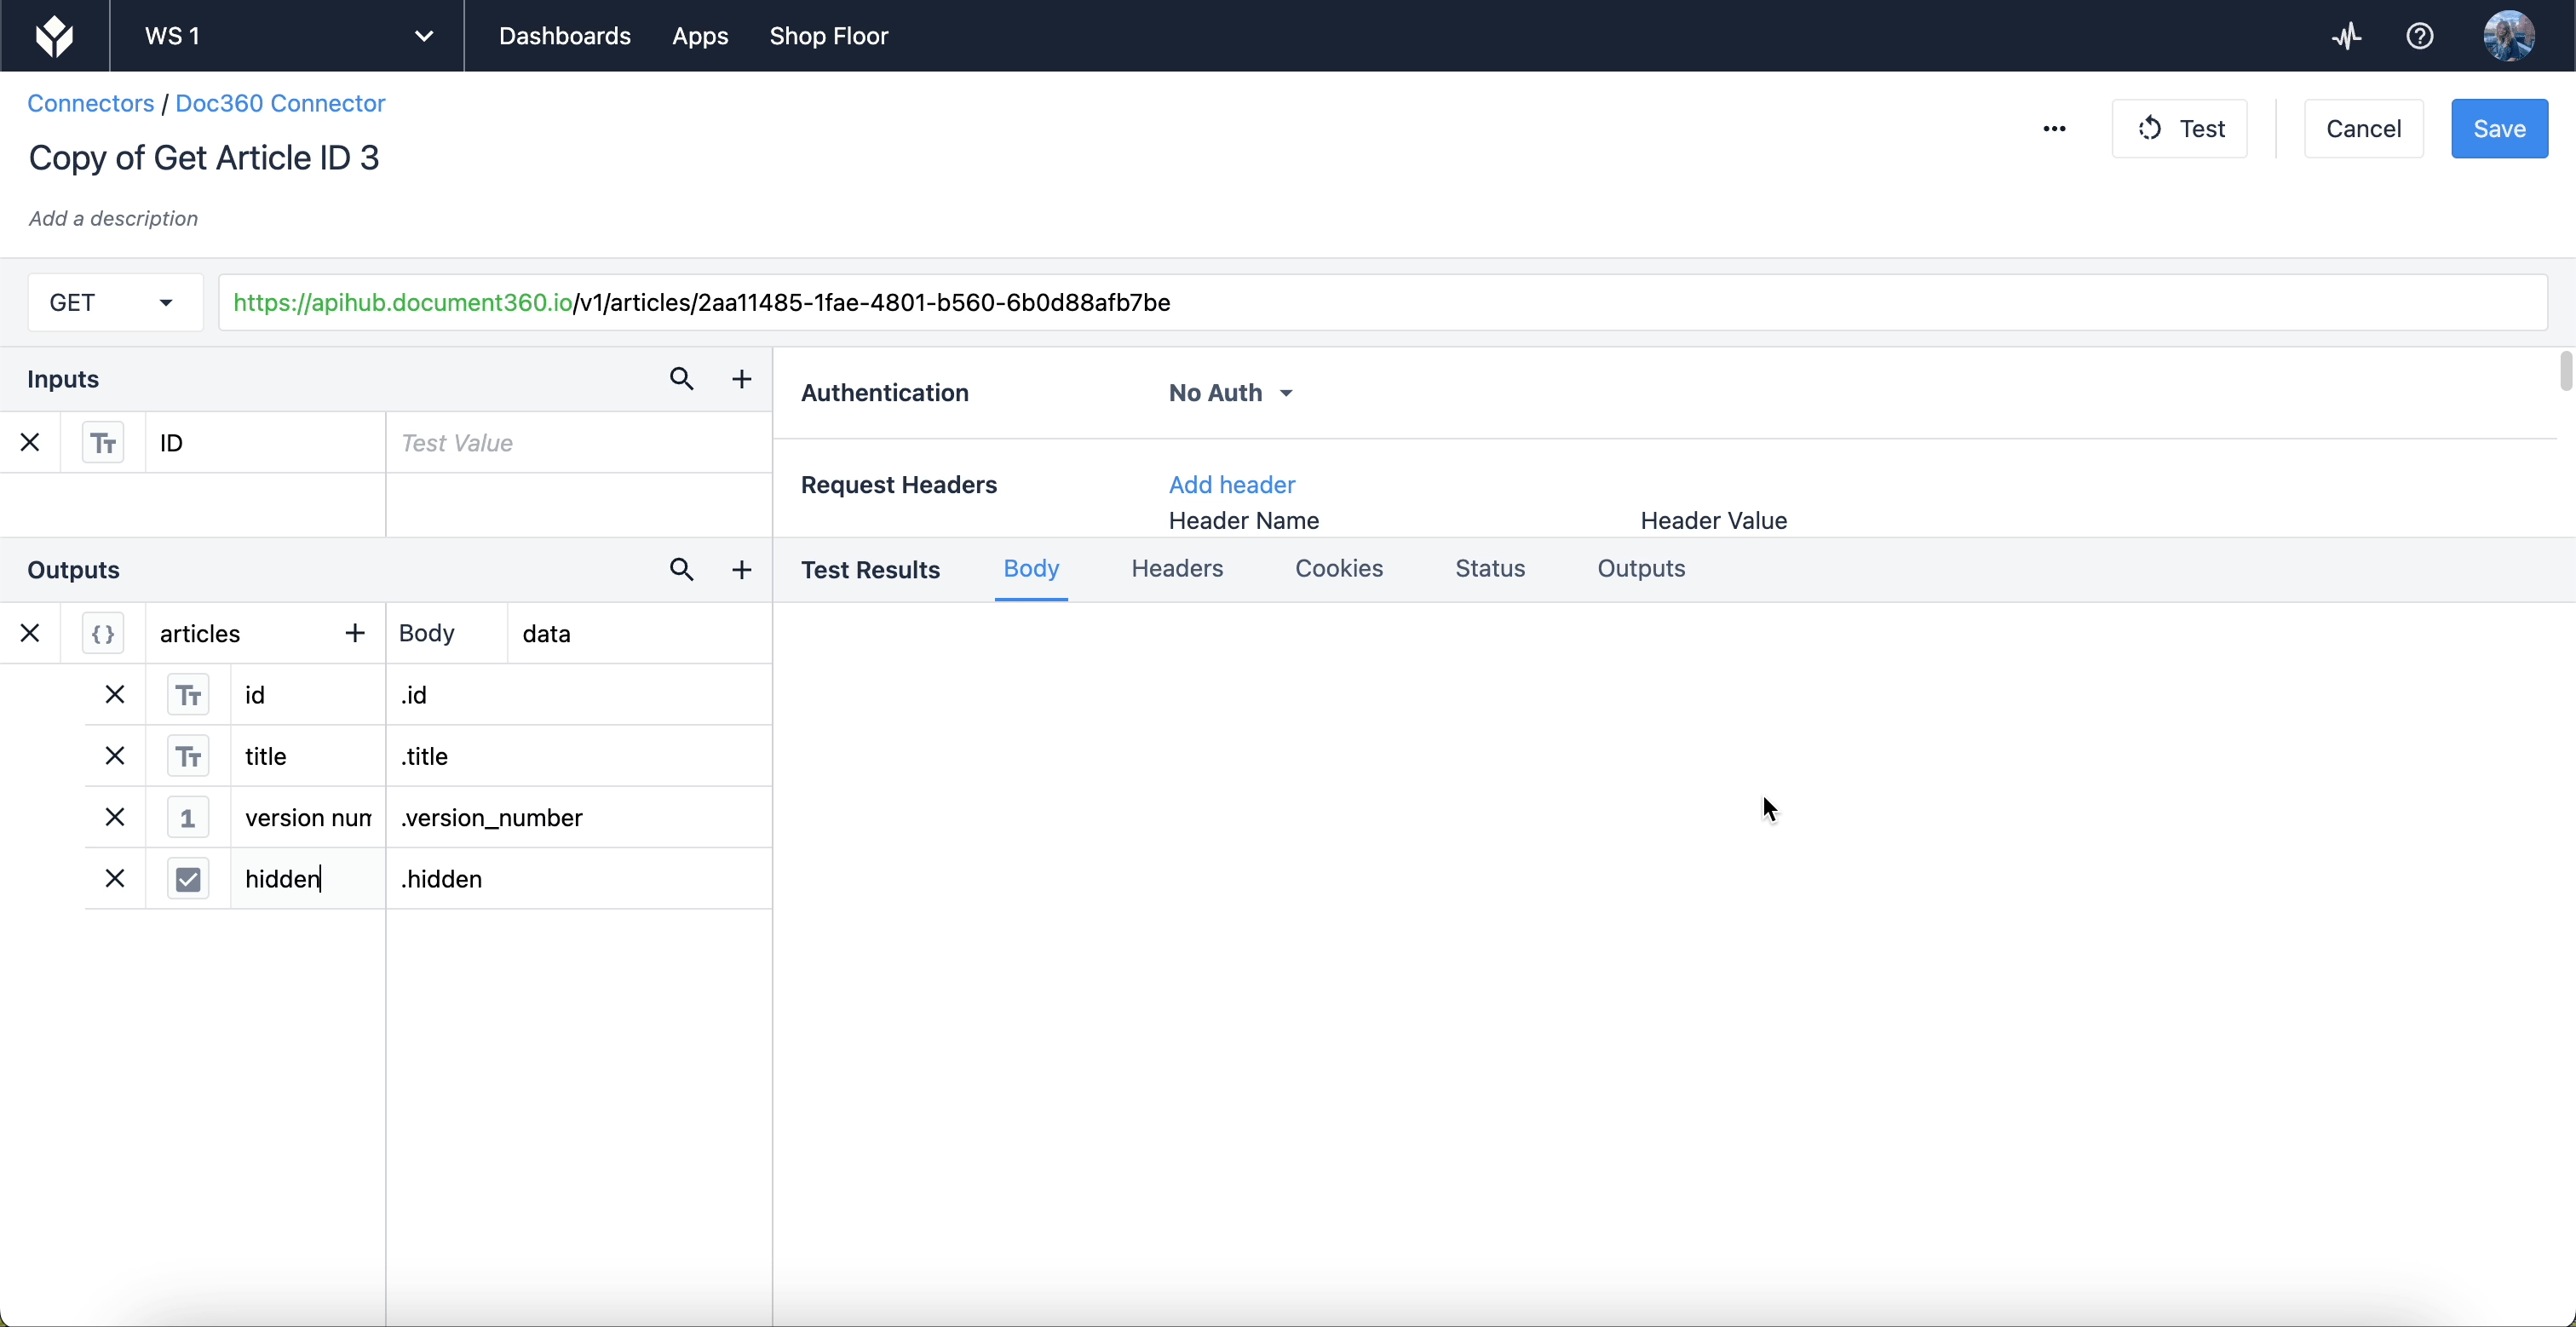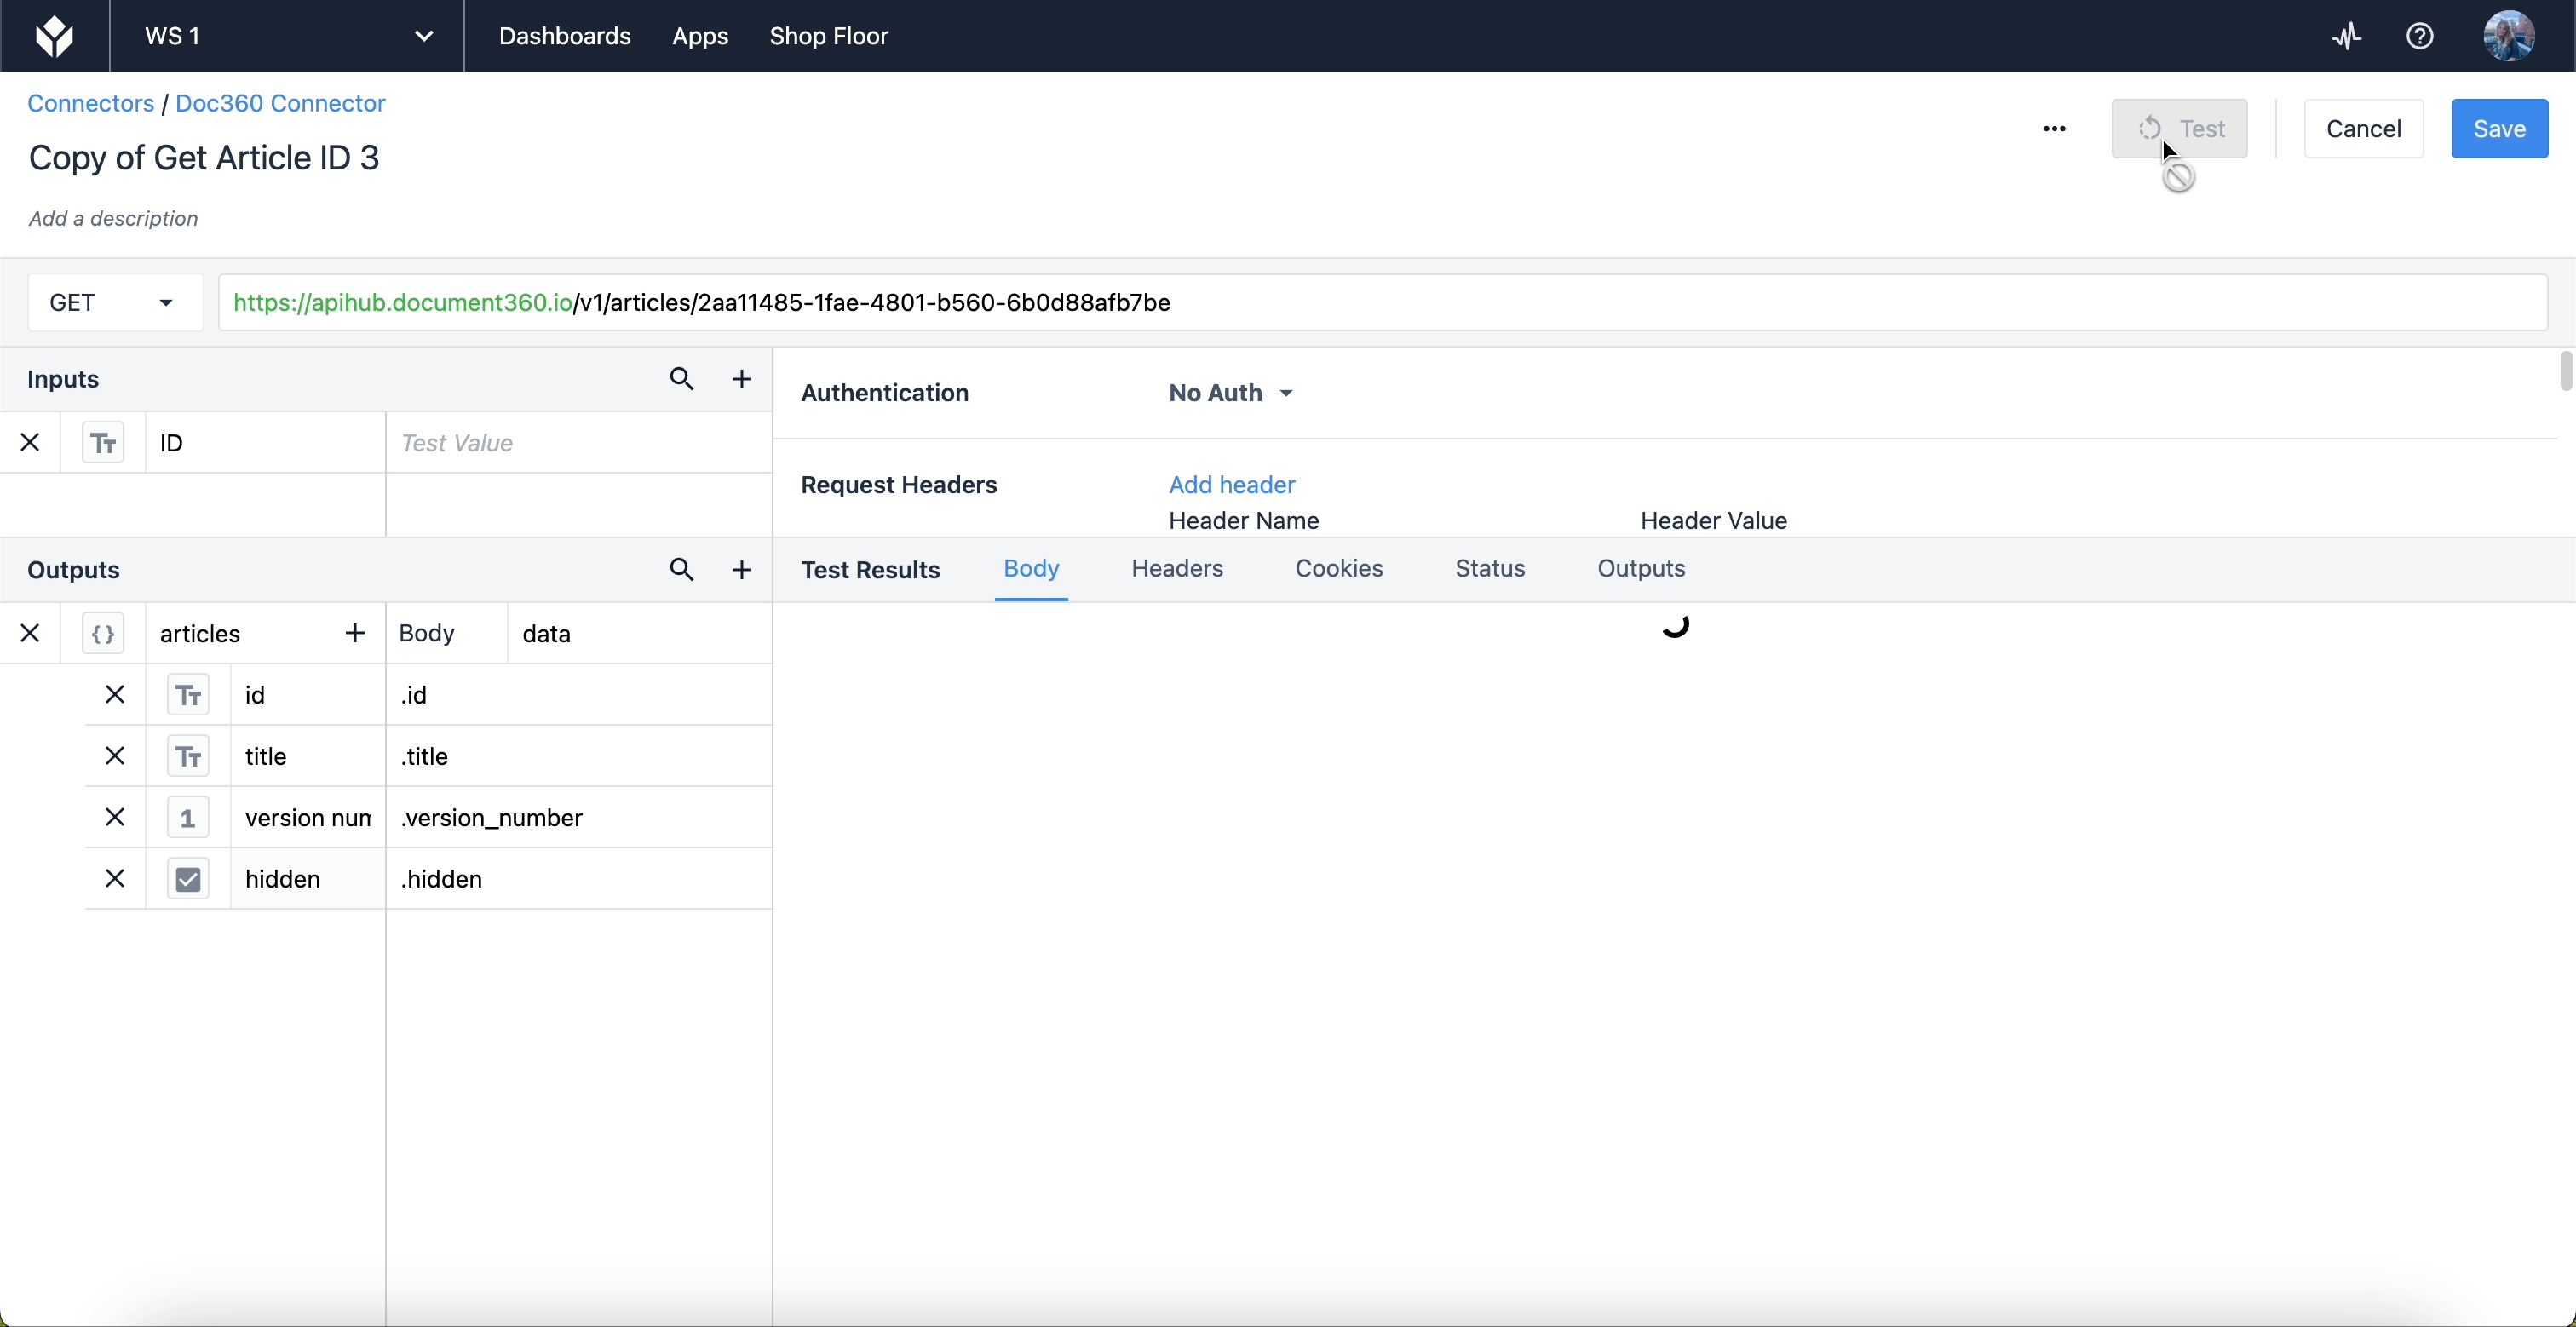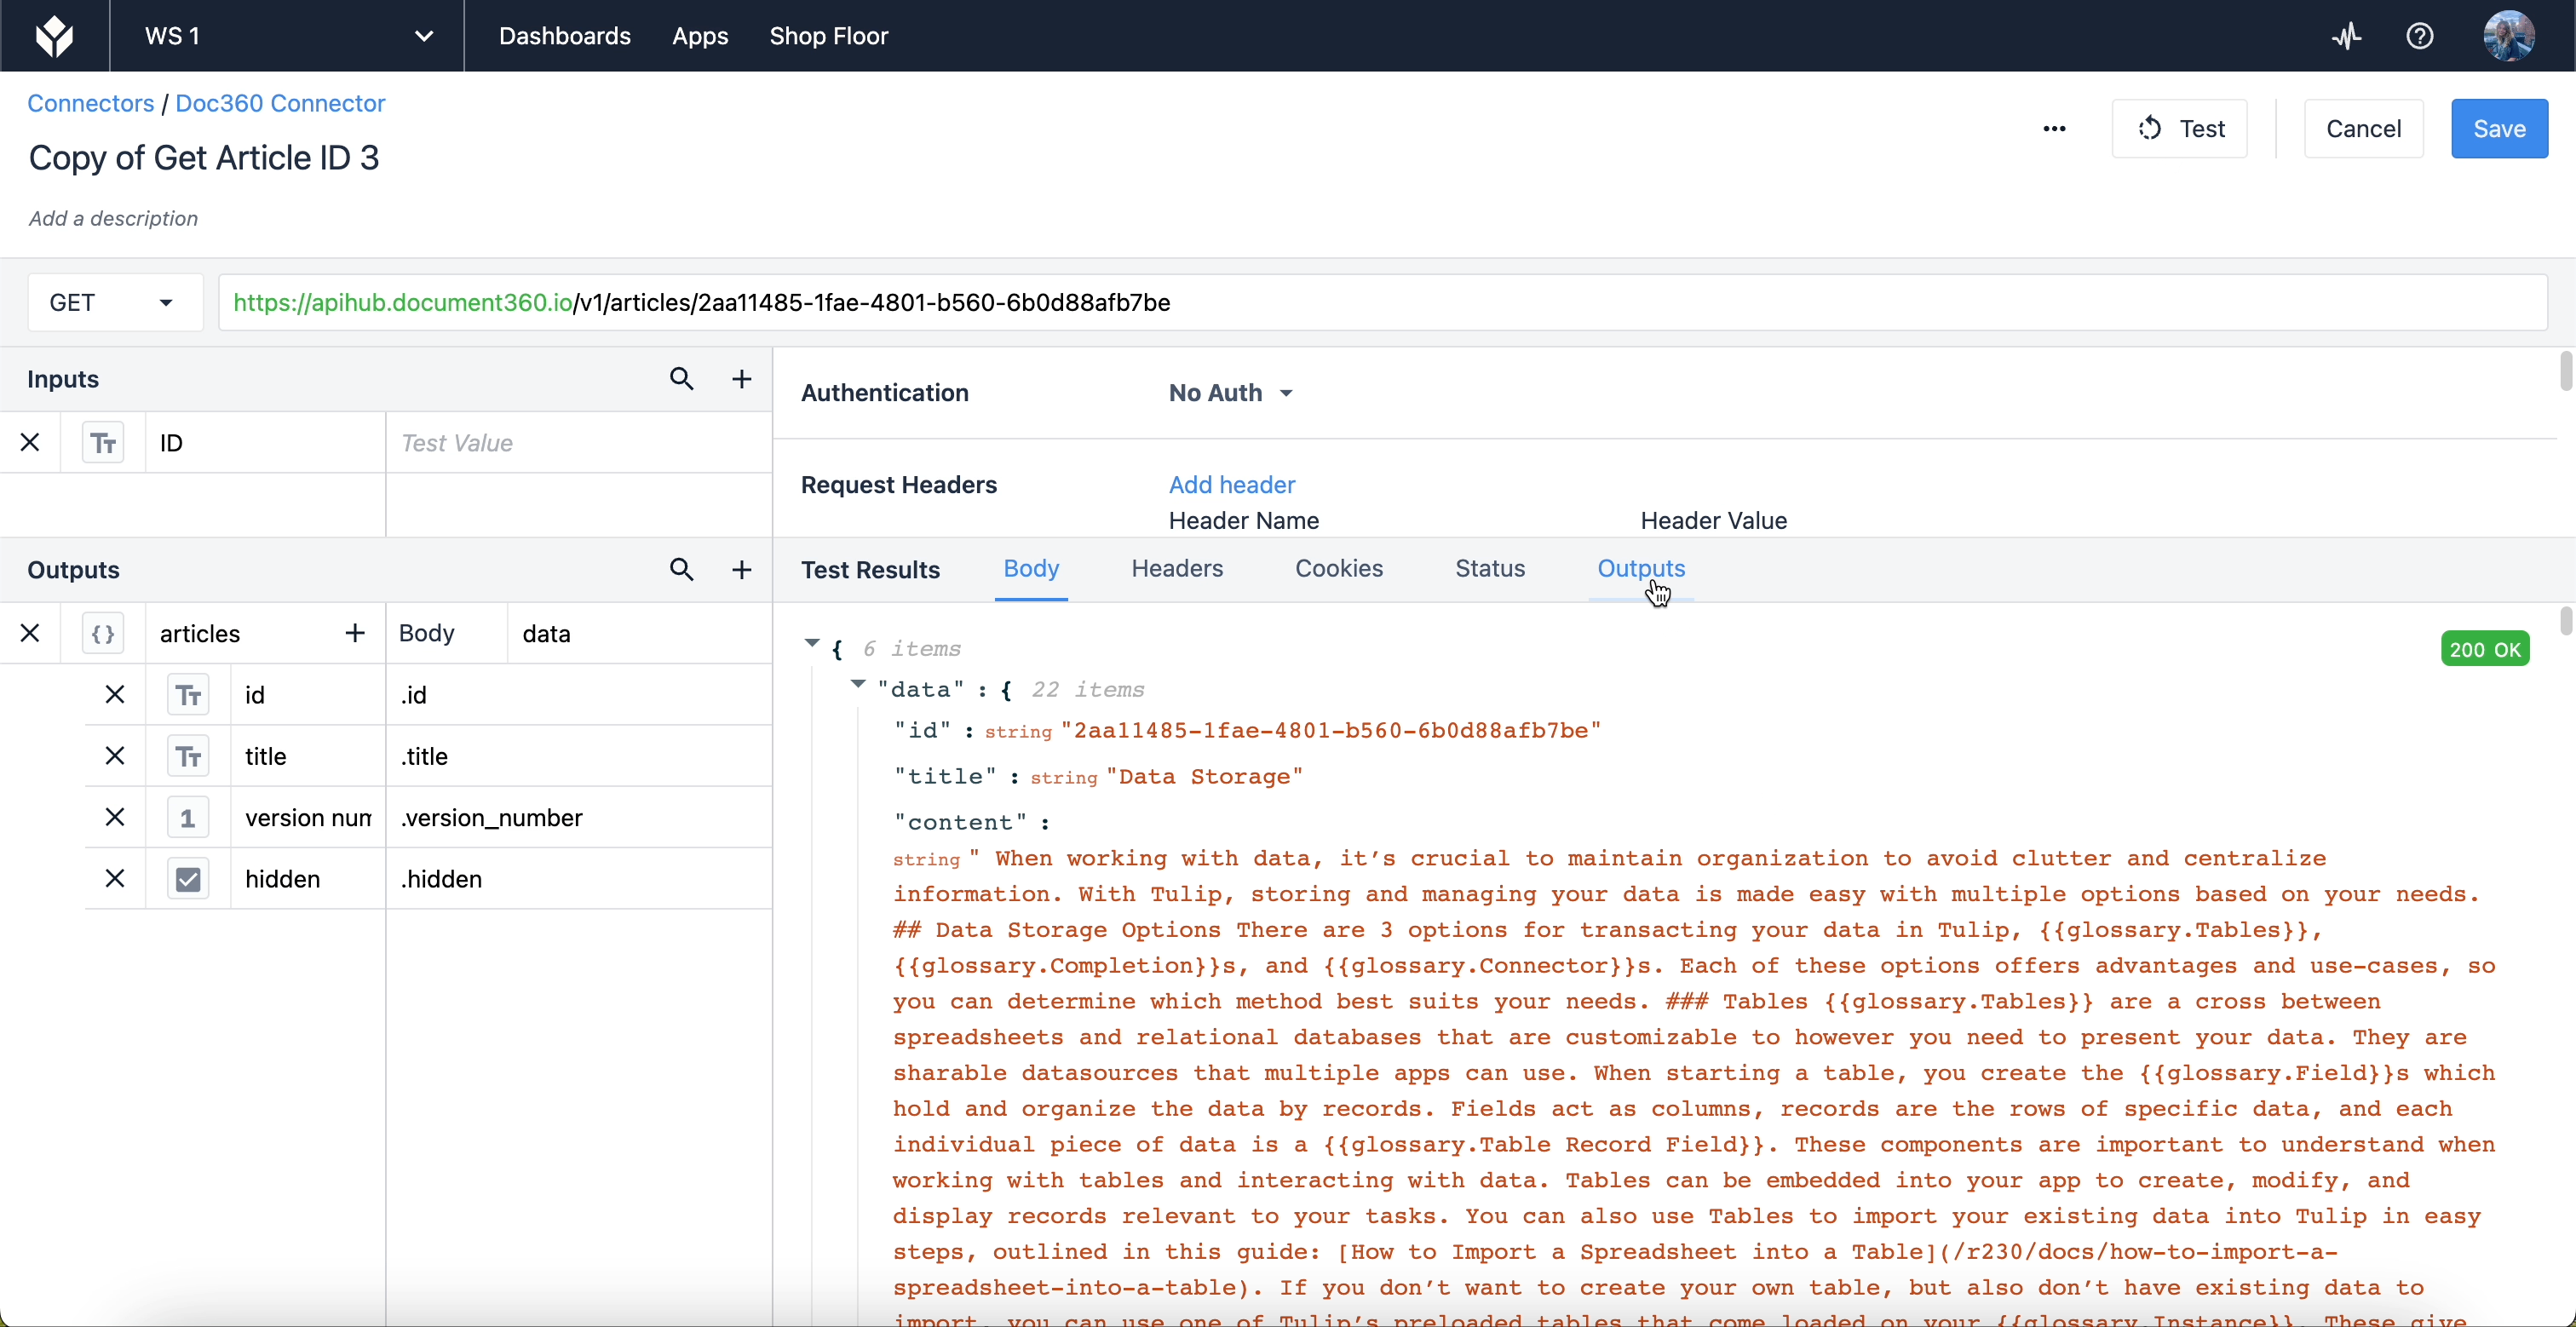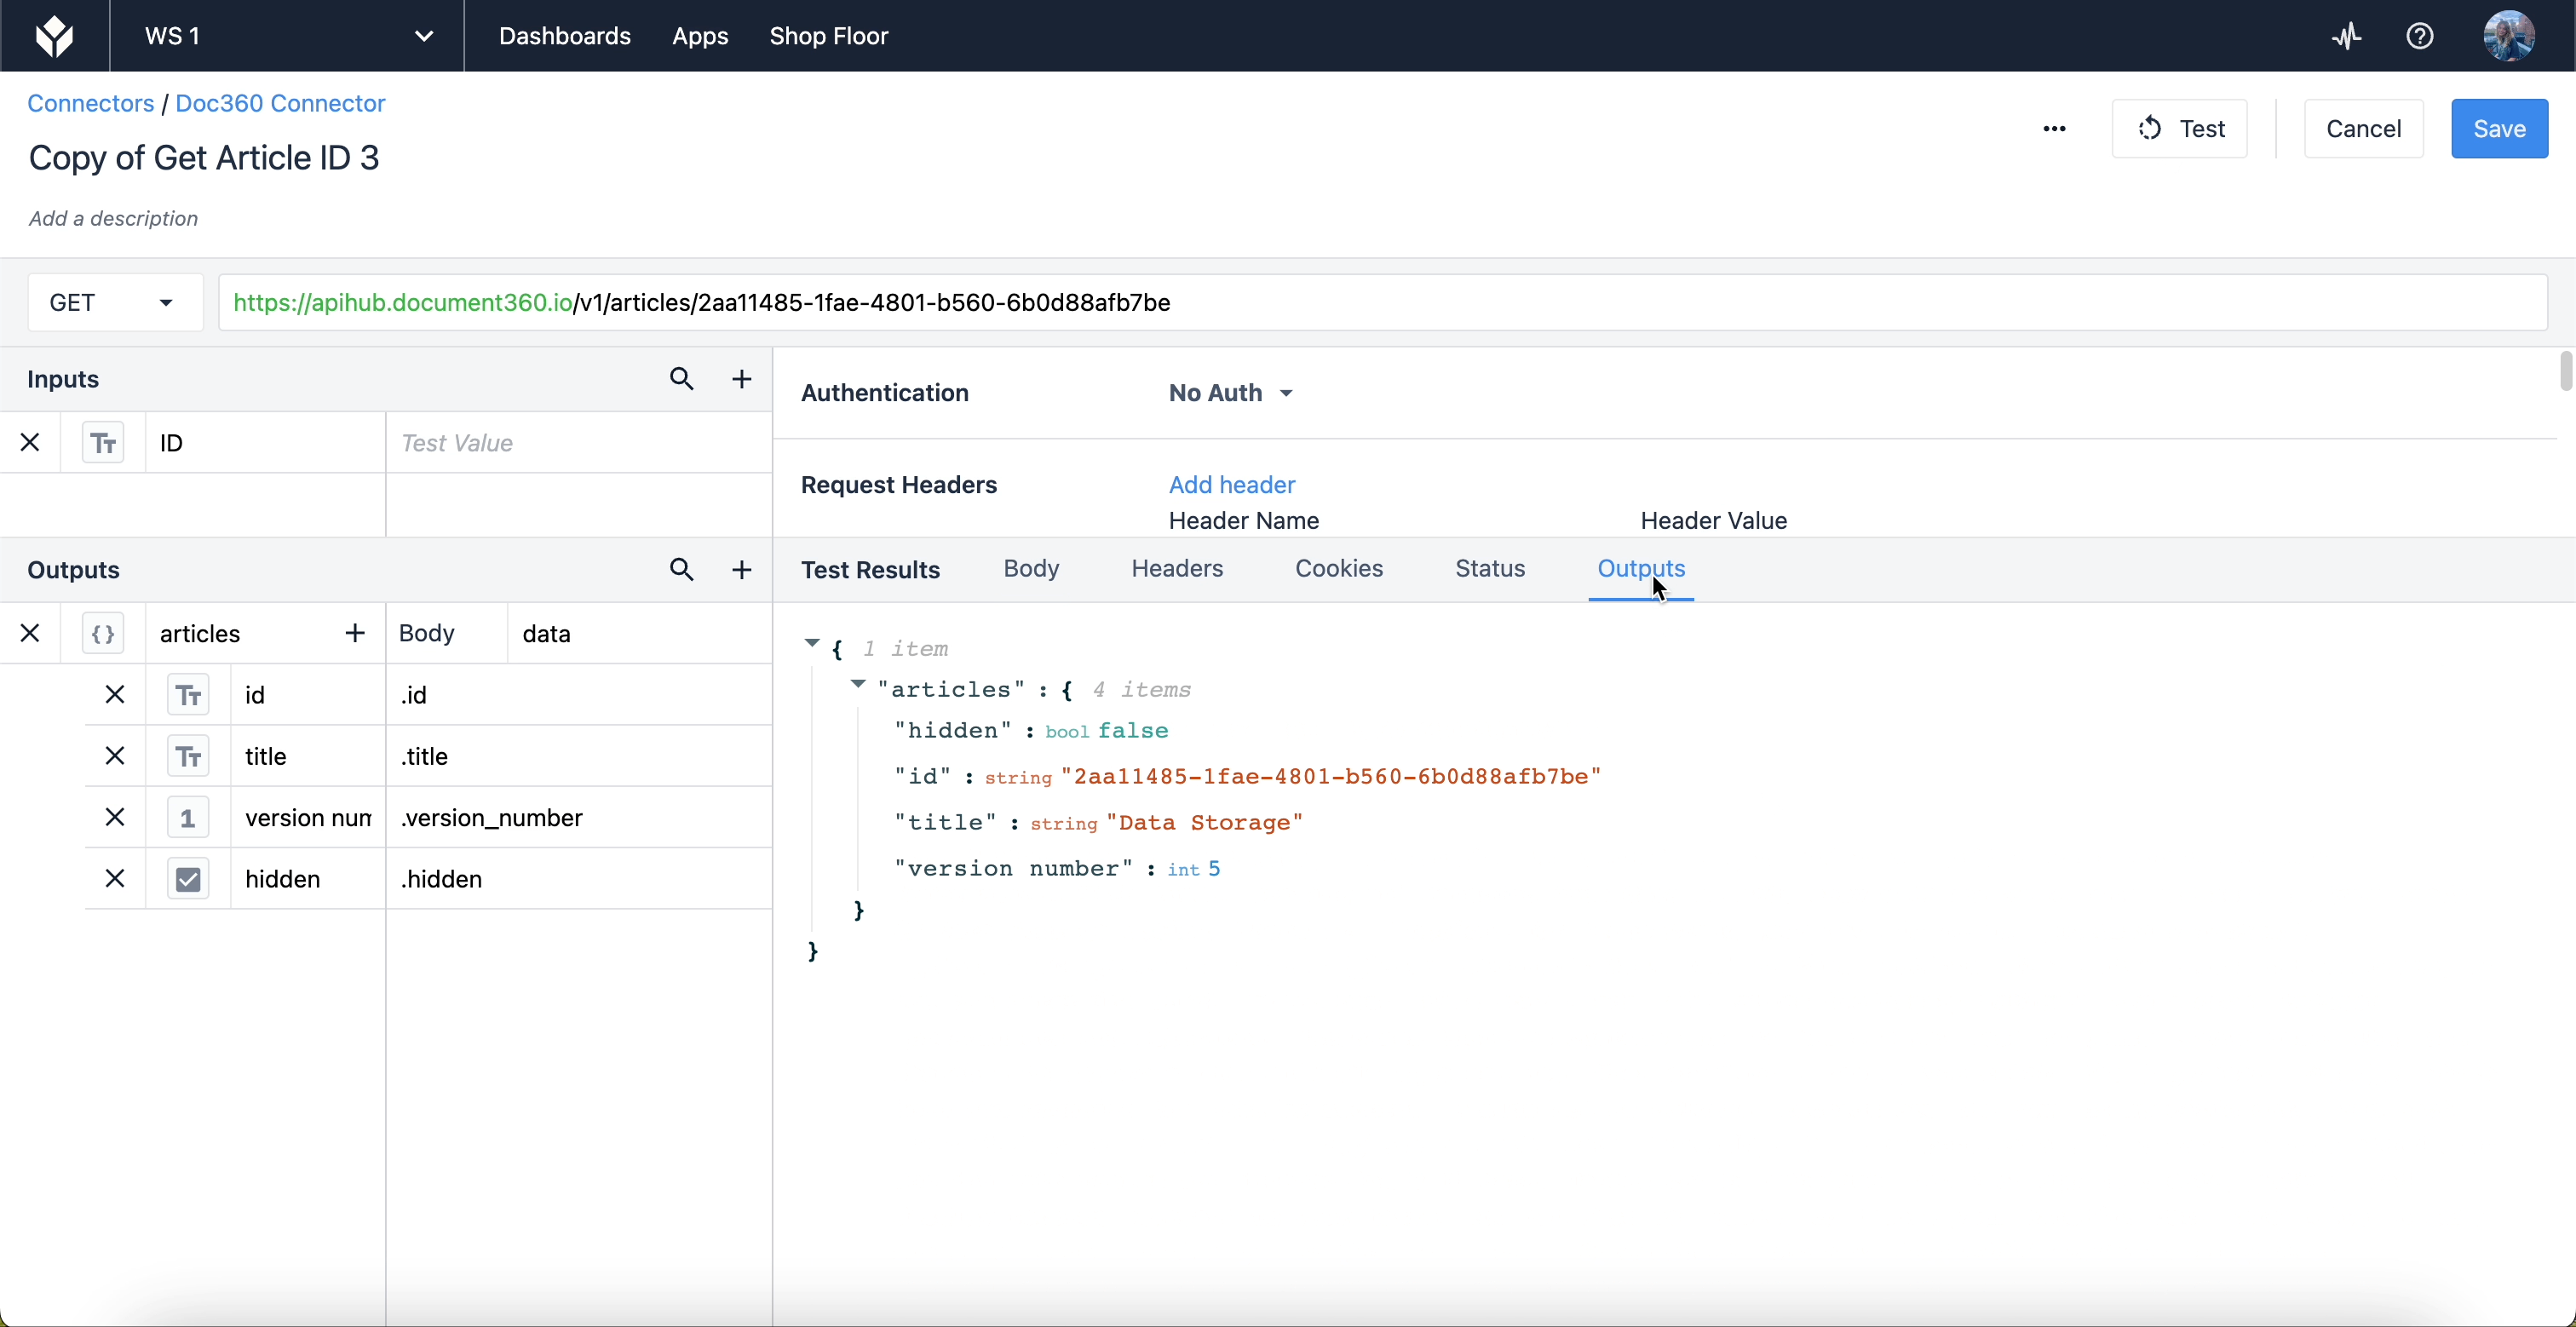
たとえば、ID、タイトル、バージョン、および記事が非表示かどうかといった情報のみを取得したい場合、outputs を使用してこれを指定する必要があります。エディタの outputs セクションでドット表記がどのように表示されるかを見てみましょう:
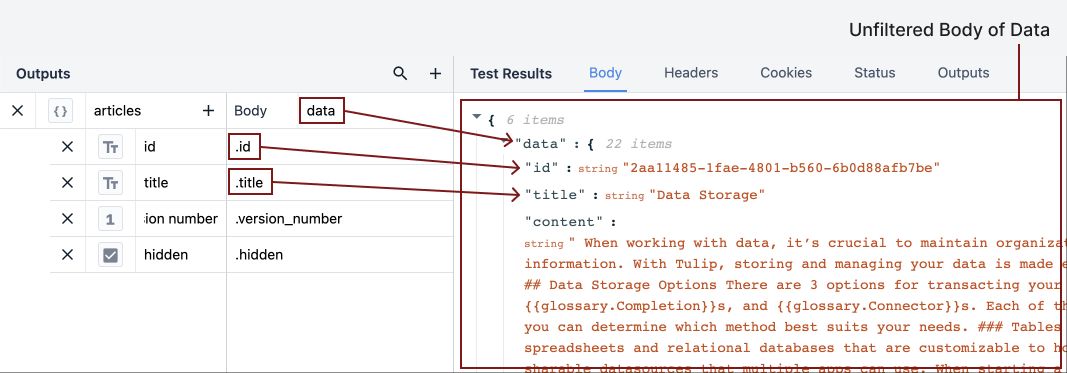
「id」や「title」といった結果を取得するには、JSON内のどこにそれらの結果があるかを指定する必要があります。出力の本体は「data」であり、これは「**テスト結果」**セクションの最初のドロップダウンに対応しています。 「data」ドロップダウン内の各結果は、そのオブジェクト内にネストされています。「出力」セクションでは、ピリオド(ドット)は「data」オブジェクトを1階層深く掘り下げることを意味します。
It doesn’t matter whether the dot is placed in the body, or in front of individual properties, so long as there is a dot separating each layer of the JSON.
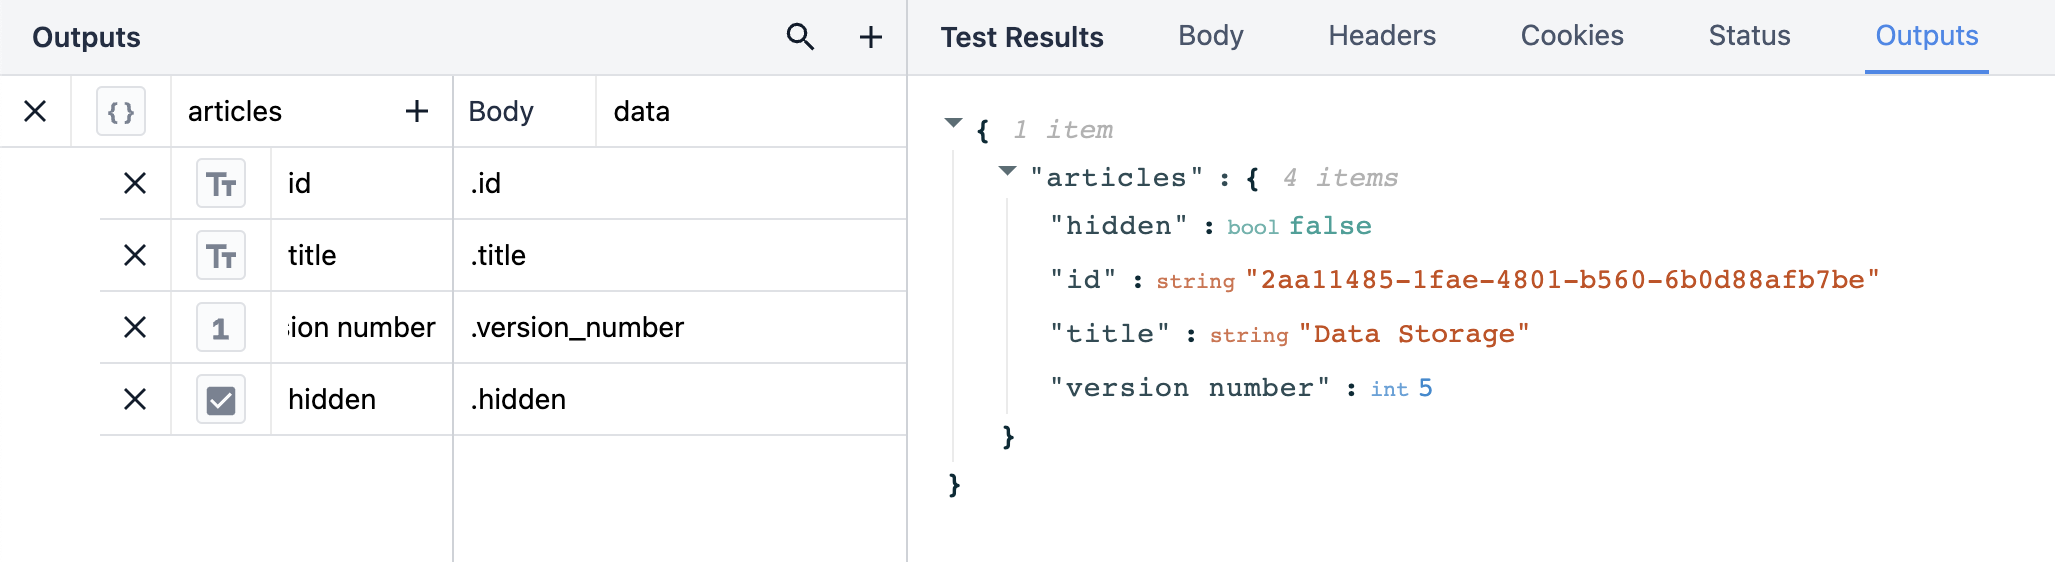
「テスト結果」セクションの「出力」タブをクリックすると、不要なデータがフィルタリングされ、必要な情報のみが表示されます。
出力を記述する別の方法として、1行で記述する方法があります。これにより、1つのクエリで完全なパスを示すことができます。
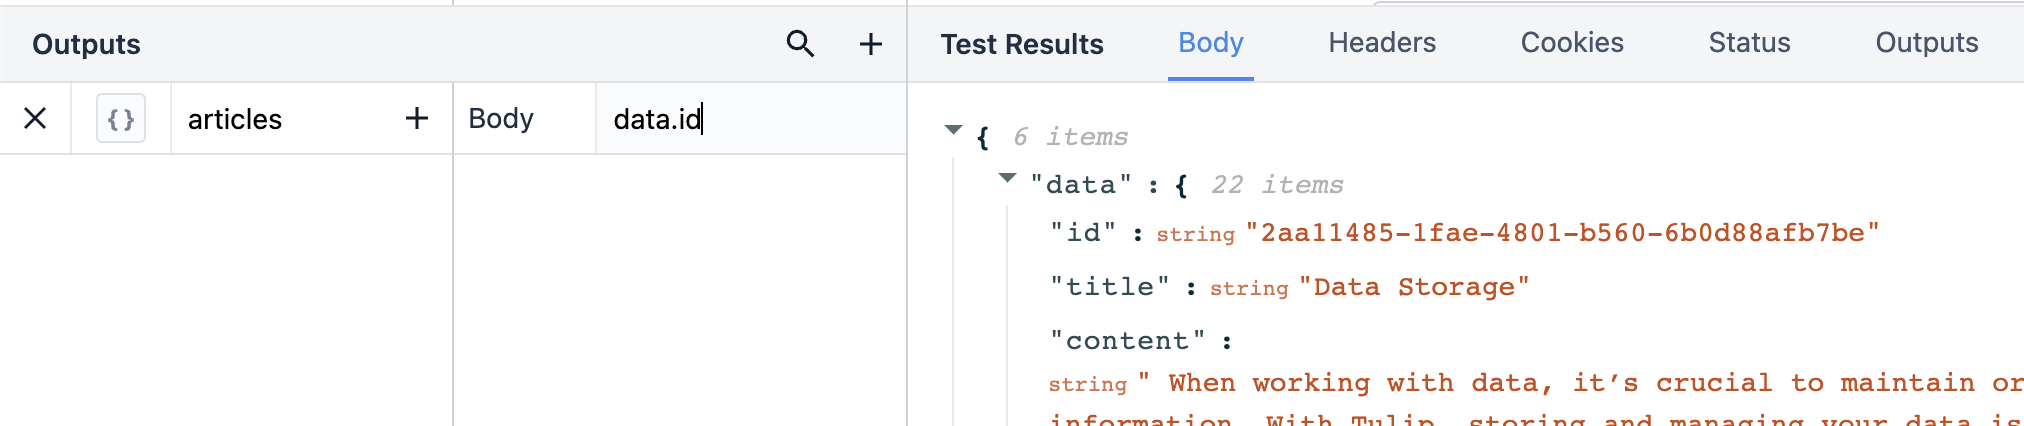
出力パスを簡単に記述する裏技として、データ行をクリックして新しい出力として追加することもできます。
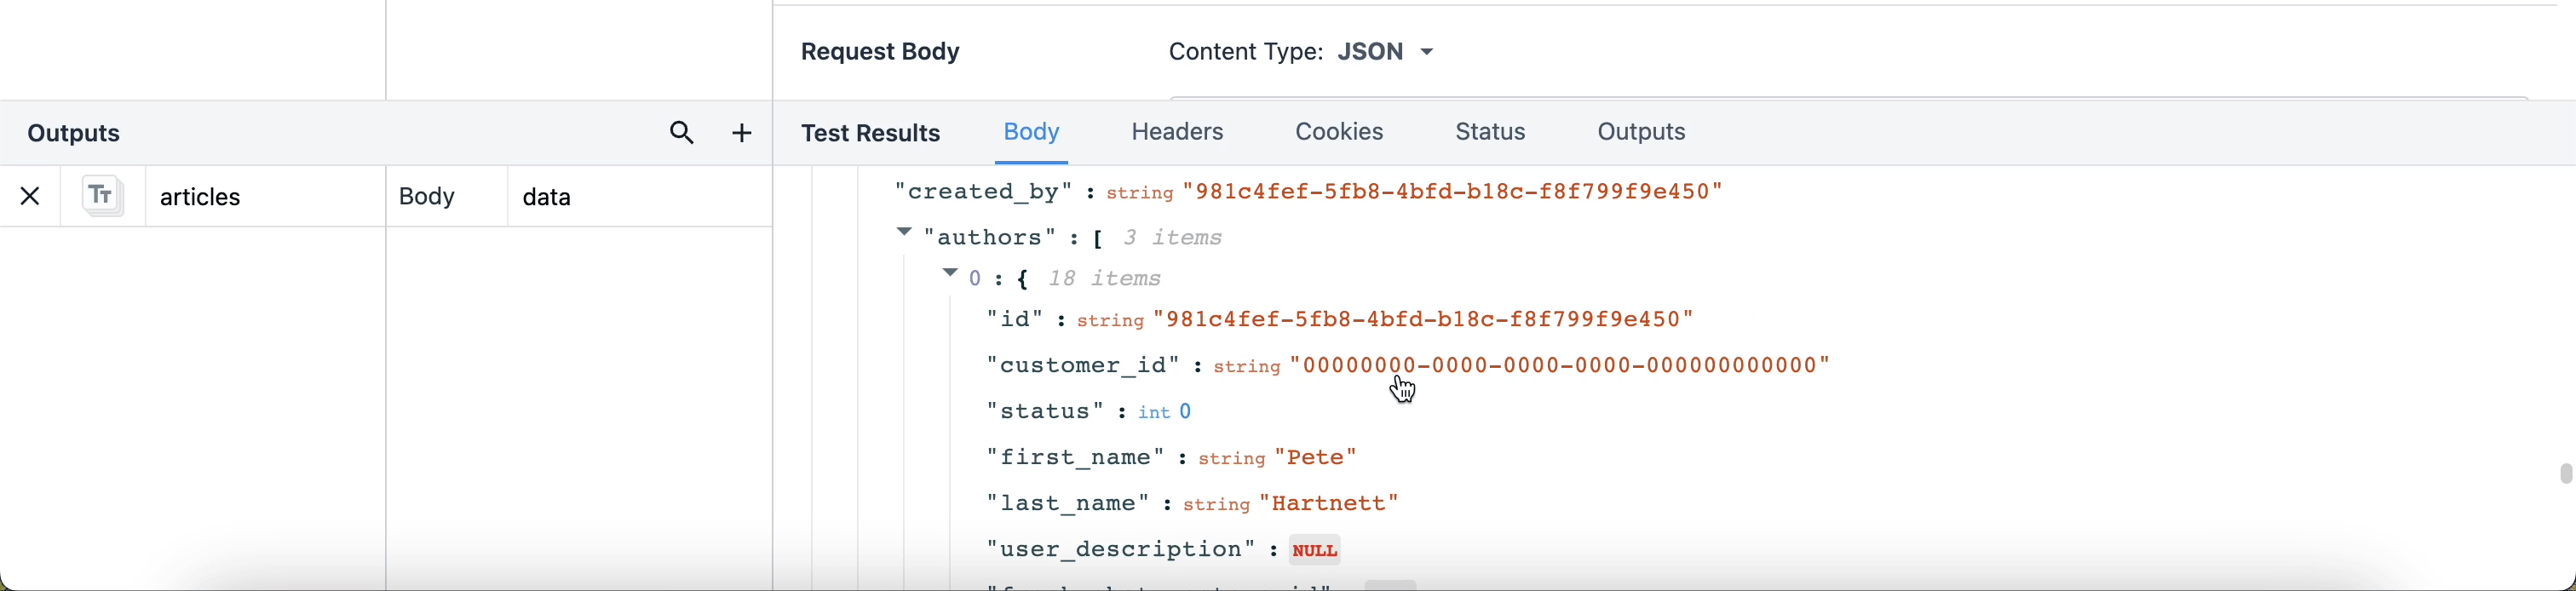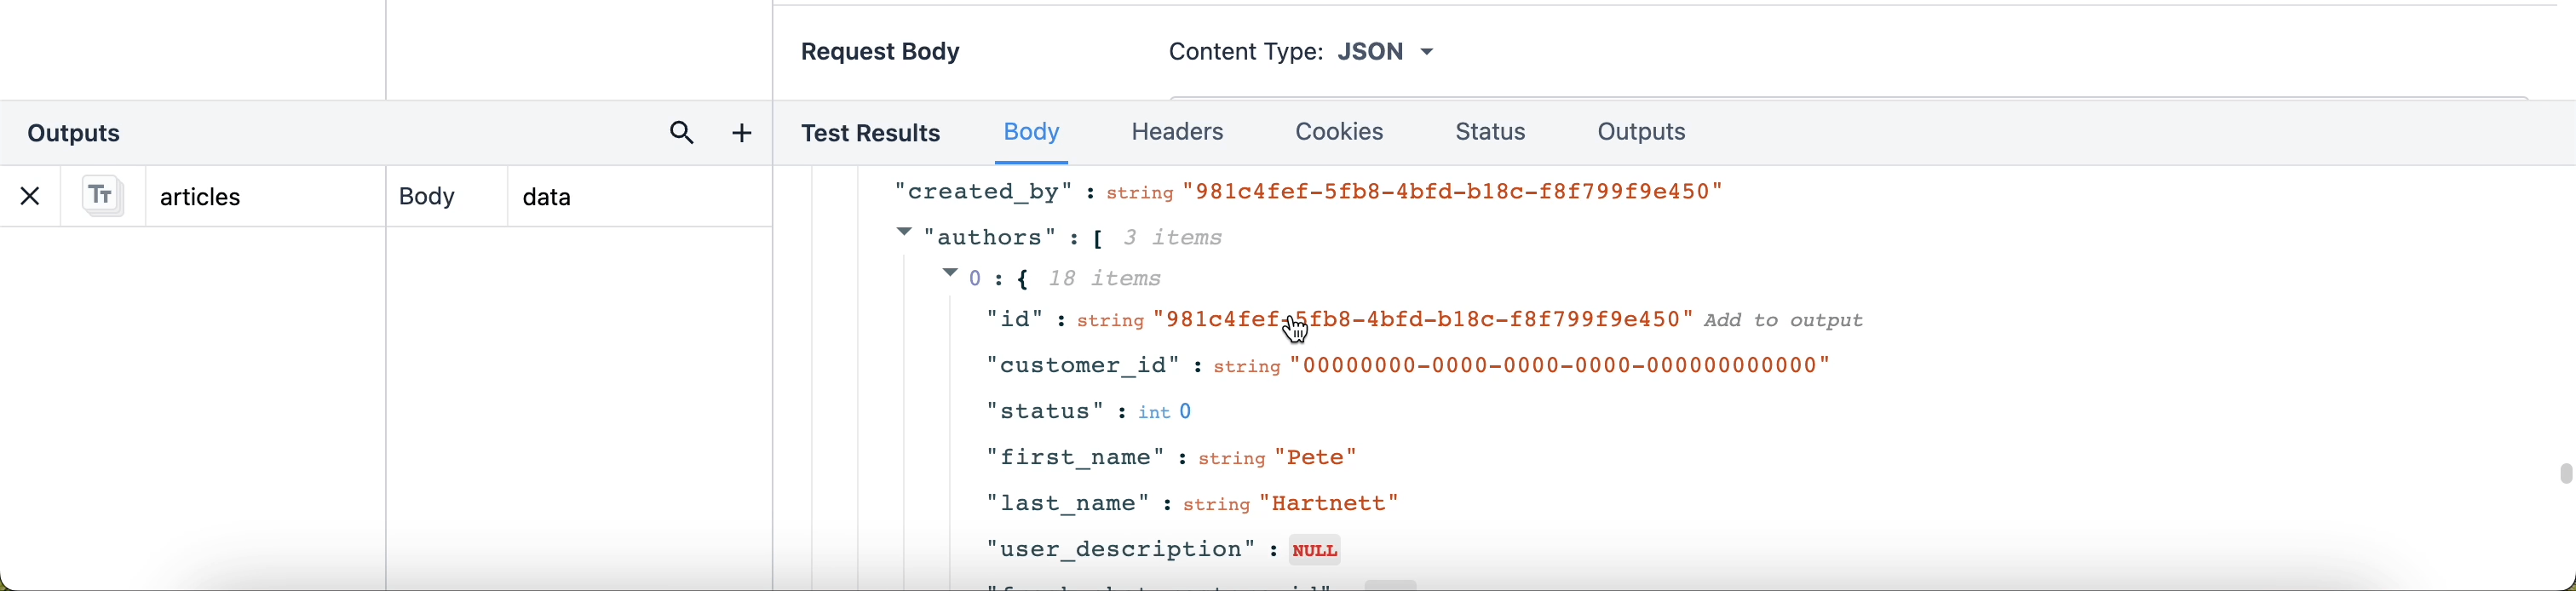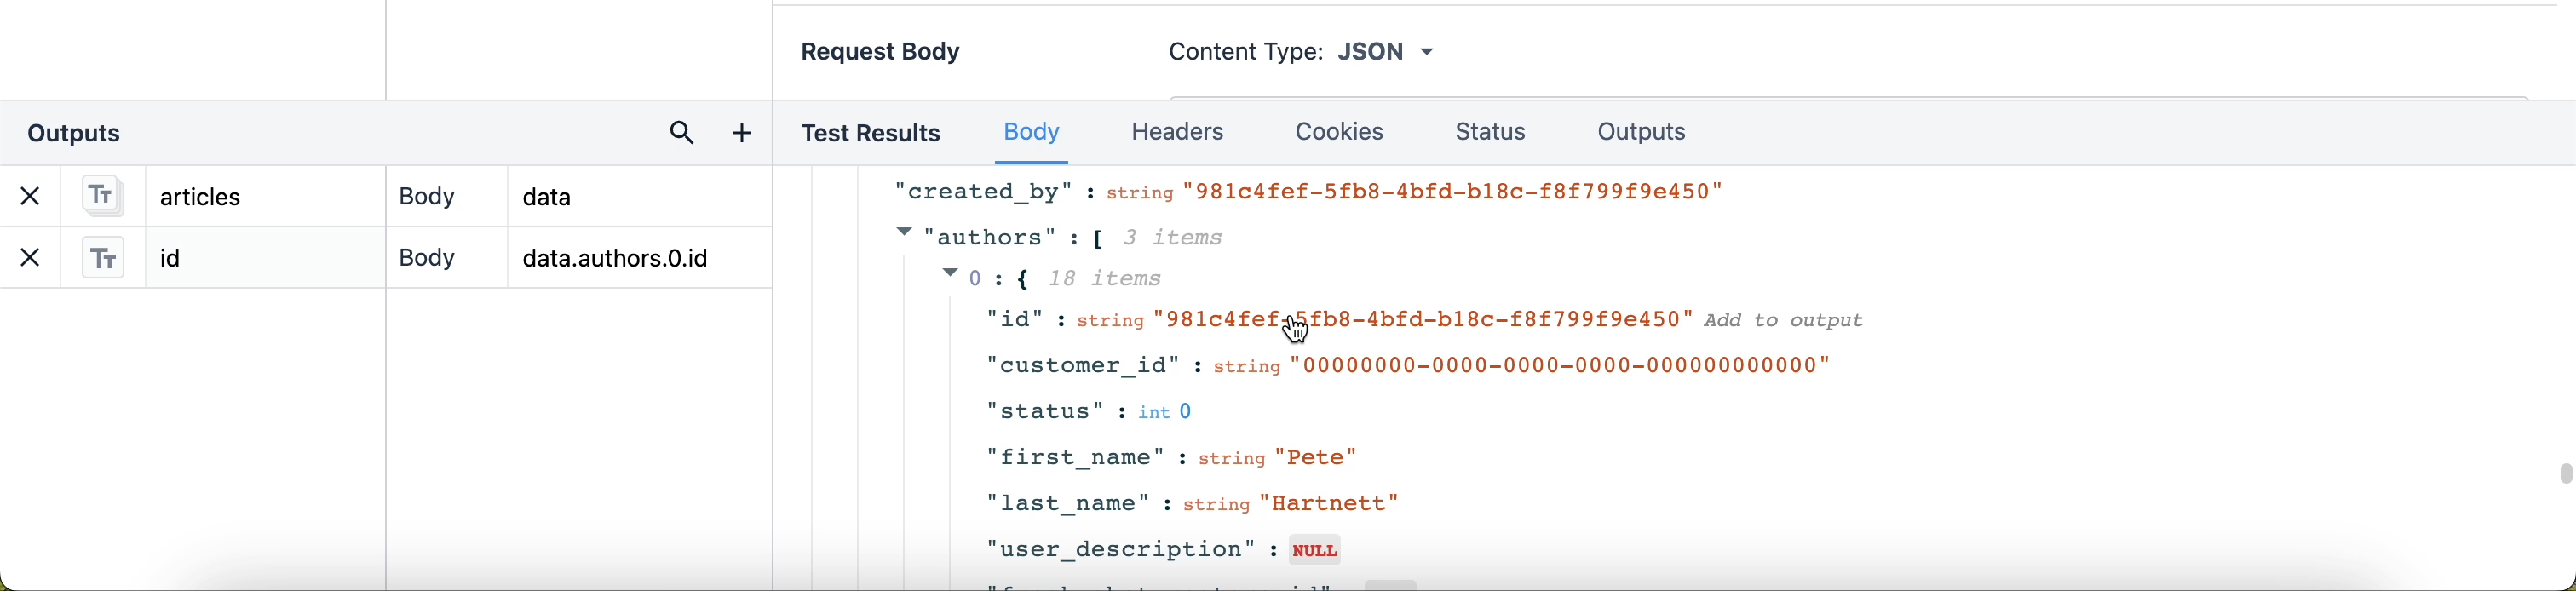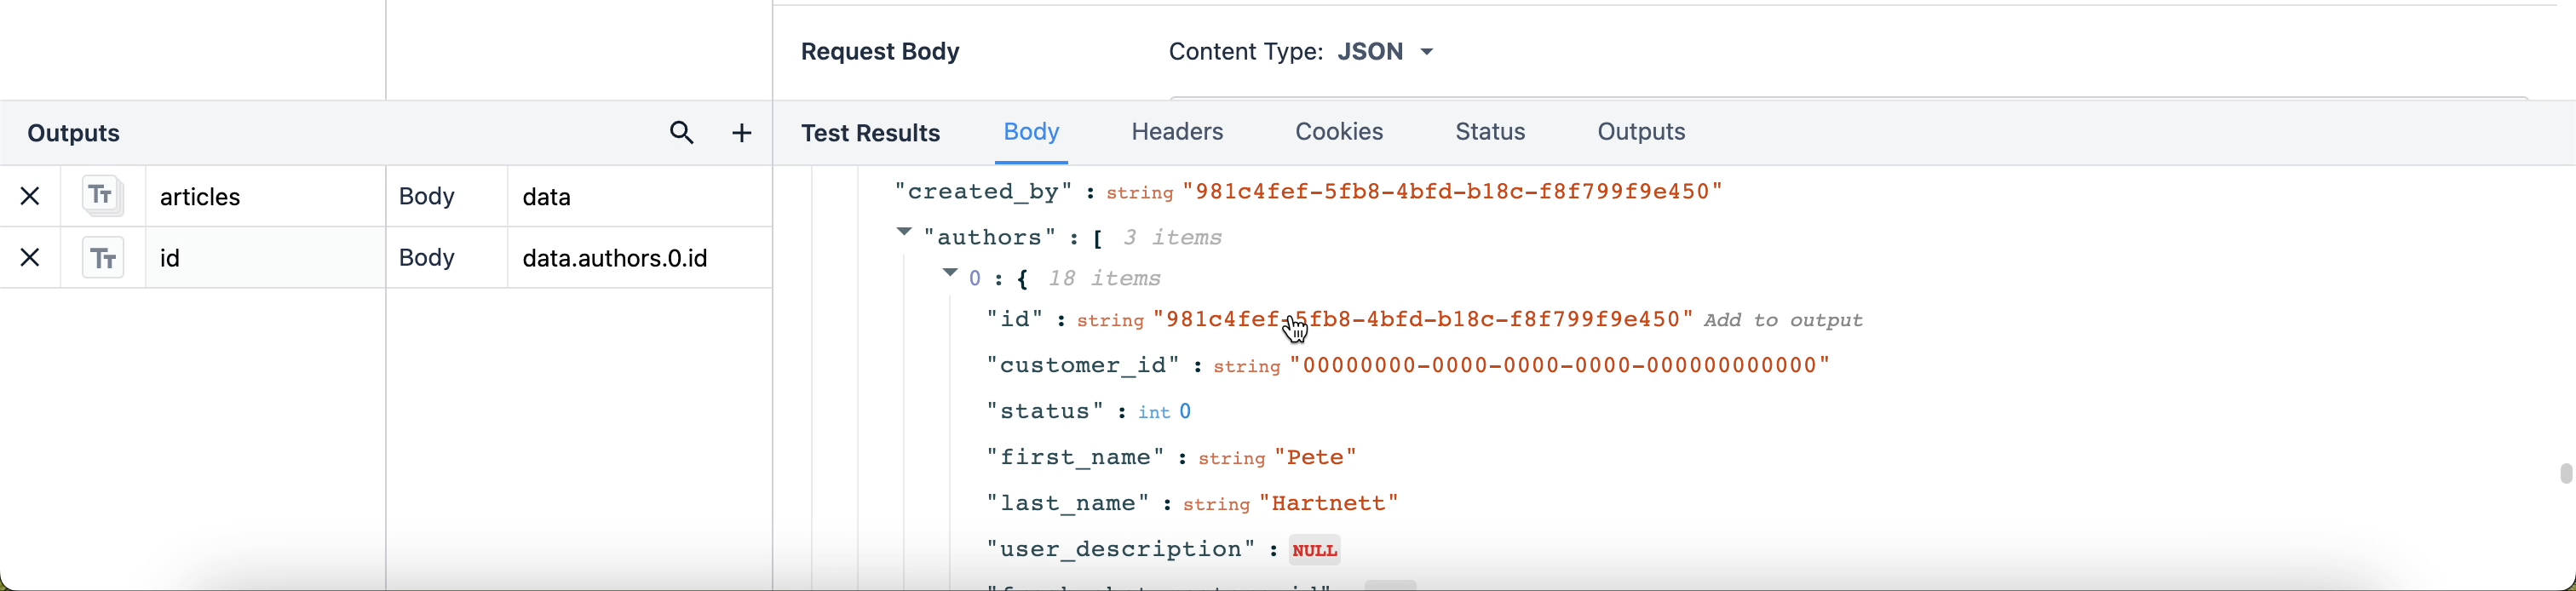
ドット表記の使用に関する詳細については、以下のリソースを参照してください:Processmaker: JSON ドット表記。
出力の結果
出力の構造化には複数の方法がありますが、その方法は、アプリケーション内のデータをどのように活用したいかによって完全に異なります。出力の構造化を始める前に、最終的な目標について考えてみてください。 複数のデータ型を個別の変数に表示したいですか? それとも、同じデータ型を 1 つの配列にまとめて、そこから関連情報を抽出したいだけですか?
以下の例はすべて同じコネクタ関数に基づいており、いずれの場合もテスト結果の本体は同じです。ただし、出力の構造によって結果は異なります。
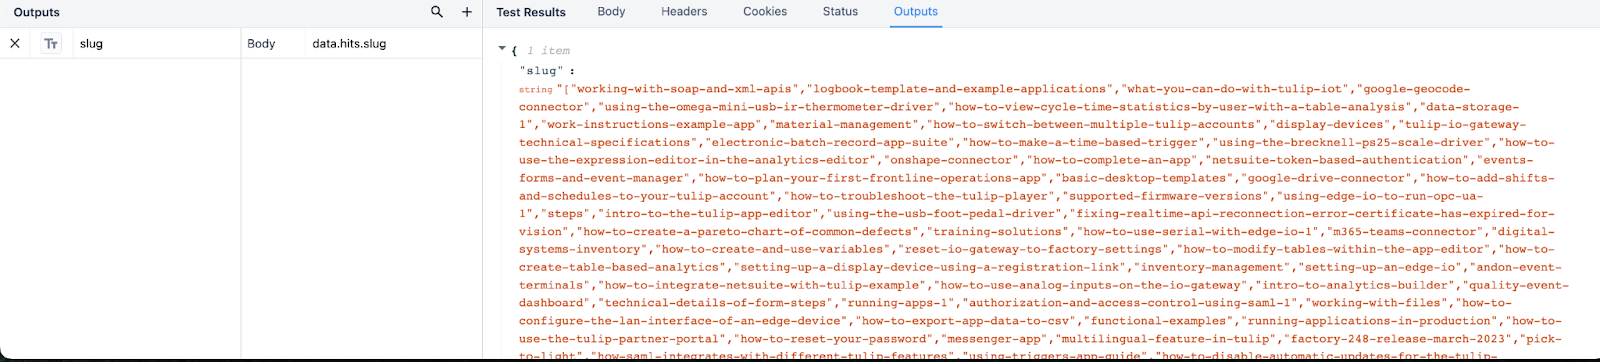
次の例は、コネクタが JSON パス data.hits.slug に対してどのように出力を生成するかを示しています。この出力の構成により、コネクタはナレッジベースの記事のすべての URL スラグを含む大規模な配列を返します。アプリケーション内では、このコネクタの戻り値は配列変数内で利用可能になります。
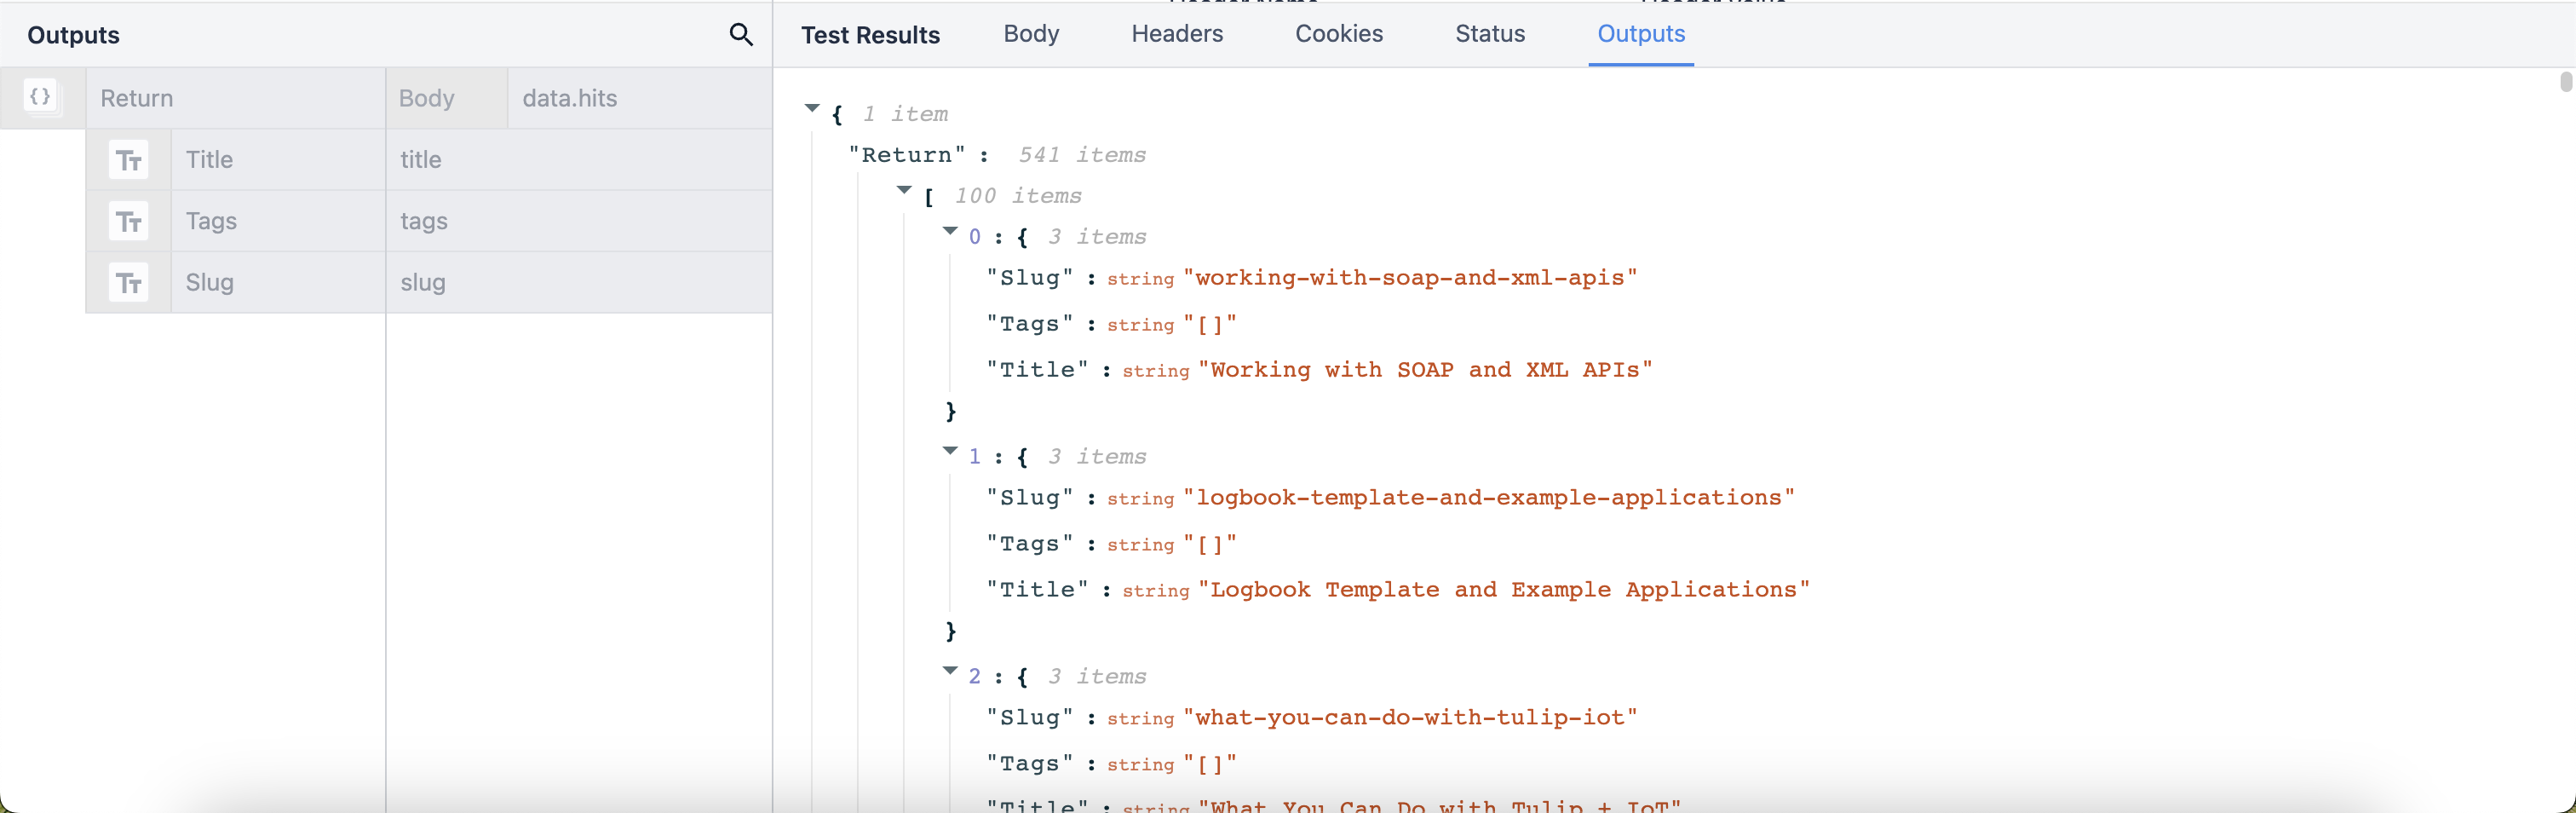
出力をオブジェクトのリストとして構成し、結果から個々のデータ型を抽出することで、アプリケーション内で個別に表示可能な複数のデータオブジェクトを作成できます。
オブジェクトのリストとは、その内部に複数のネストされたデータ型を含むオブジェクトのことです。オブジェクトのリストを使用するには、出力タイプをクリックし、右隅にある「リスト」スイッチを切り替えてください。
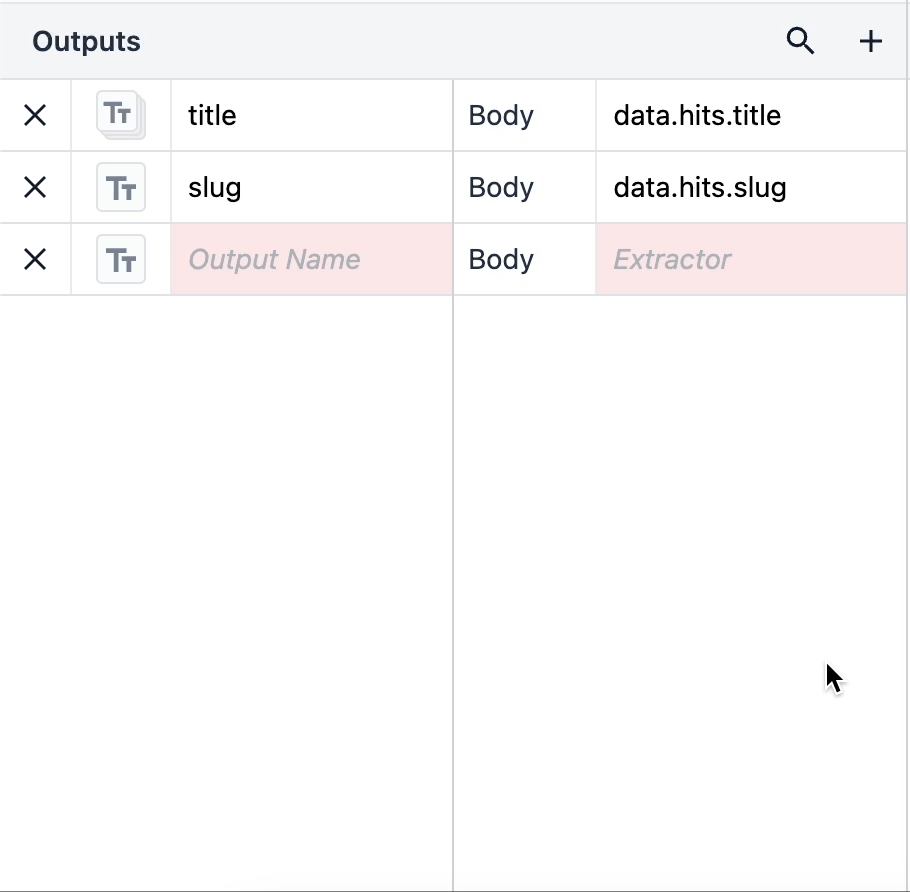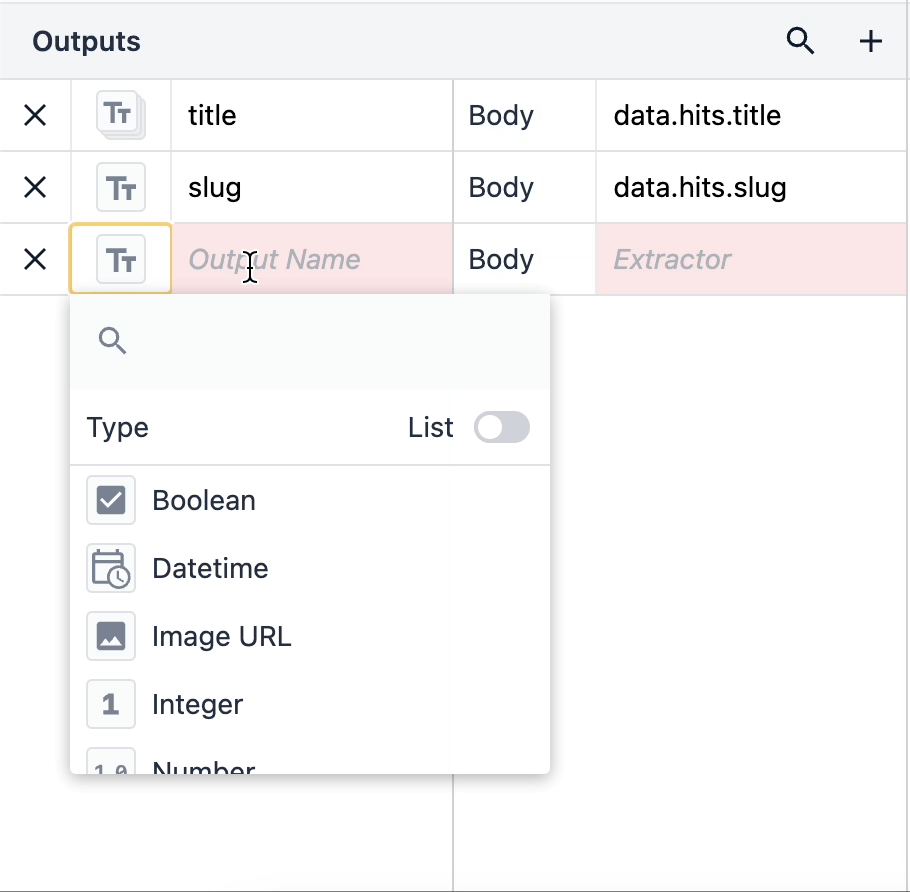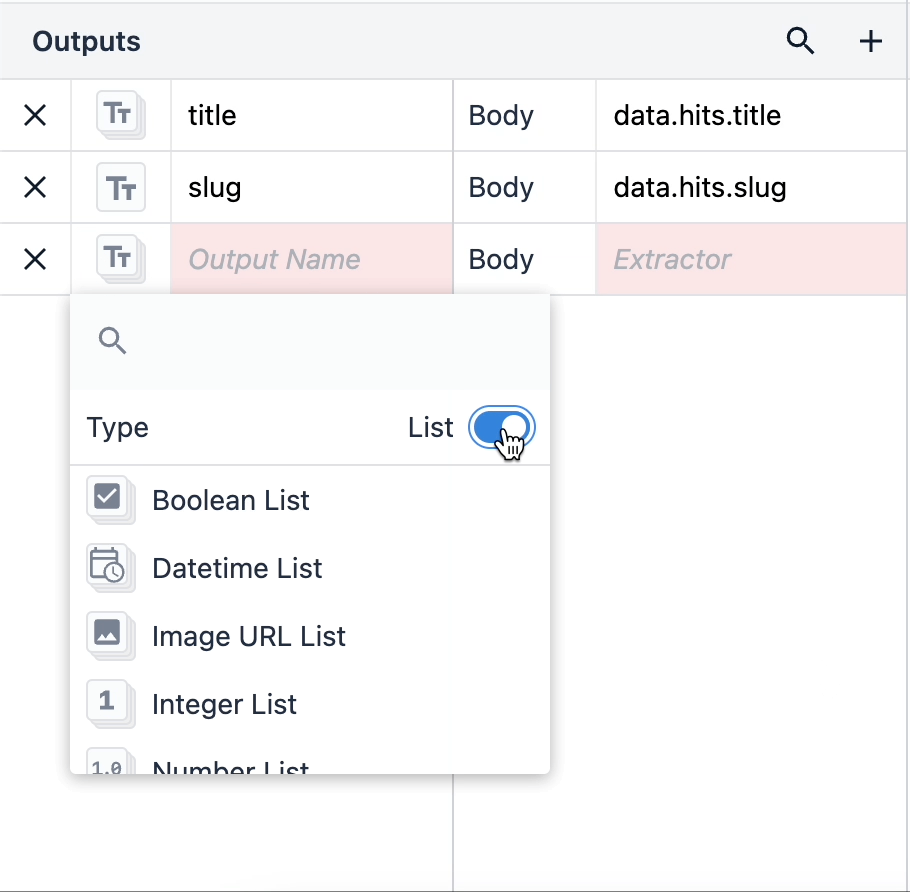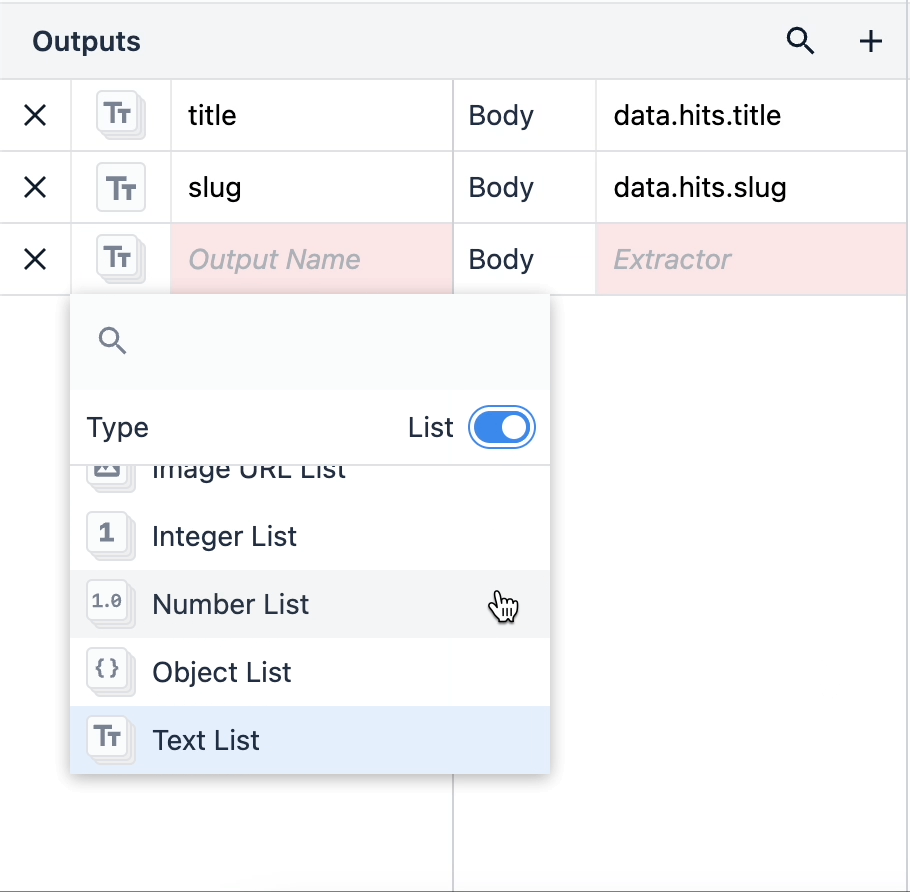
オブジェクトのリストがあれば、アプリケーション内で異なるデータ型を個別のデータとして簡単に利用できます。
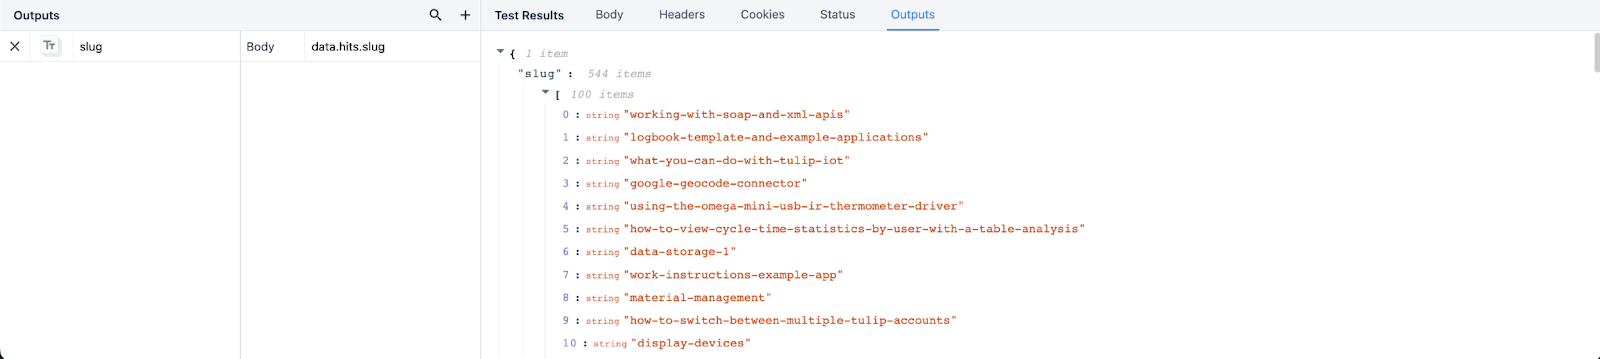
前述の例に戻って、出力パスdata.hits.slugをリストにしてみましょう。以下の結果からわかるように、Tulip はこのコネクタの戻り値を slug の配列として構造化しており、各値の横には対応するインデックス位置が表示されています。
出力に関するこの理解を踏まえて、出力内容を独自のコネクタ関数にマッピングし、コネクタからの返り値を最適化できるようになります!
Tulip AI を使った出力抽出
本記事で既に解説した例や概念(やオブジェクトのリストなど)を活用して、出力の構造化を迅速に行いましょう。
Tulip AI は、テスト結果内の JSON レスポンスを自動的に分析し、対応するドット表記のパスを生成するための強力なショートカットを提供します。ネストされたオブジェクト構造を再現しようとしますが、必要に応じて複雑な配列やオブジェクトをフラット化します。
Tulip AIは、既存の出力や抽出内容を変更することはありません。初期の出力設定プロセスを迅速化するために、新しい出力や未指定の出力を生成するだけです。
Tulip AI が出力を生成したら、アプリケーションの目的に照らしてそれらを確認する必要があります。
確認の際は、以下のベストプラクティスに従ってください:* 不要な出力を削除する* 分かりやすくするために変数名を変更する* 出力構造を手動で調整する(例:配列が正しく「オブジェクトのリスト」として設定されていることを確認する)
これらの手順により、アプリケーションに必要なデータのみを抽出できるようになります。
