
このガイドでは、以下の内容について解説します:
- Tulip でのデータ保存方法(2 種類)
- 各データ保存方法の適切な使用場面
- データモデルを採用することの重要性
データを扱う際、混乱を避け、情報を一元化するためには、整理整頓が不可欠です。Tulip なら、ニーズに応じた複数のオプションにより、データの保存と管理が簡単に行えます。
Tulipのデータは業務をどのように捉えているのでしょうか?
Tulipでは、データは複数のレベルで存在します。
アプリには、手順ごとのテキスト指示などの静的データが保存されます。
テーブルは、Tulipが構築したデータベースであり、作業指示書のスプレッドシートのようなもので、複数のアプリで共有して使用できます。
「Completions」には、アプリの所要時間、ステーション名、変数への入力データなどの生産メタデータが保存されます。
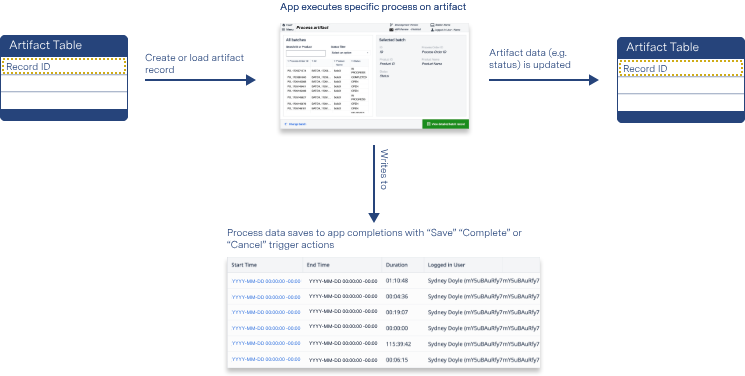
以下の図は、製造現場全体におけるデータの流れを示しています。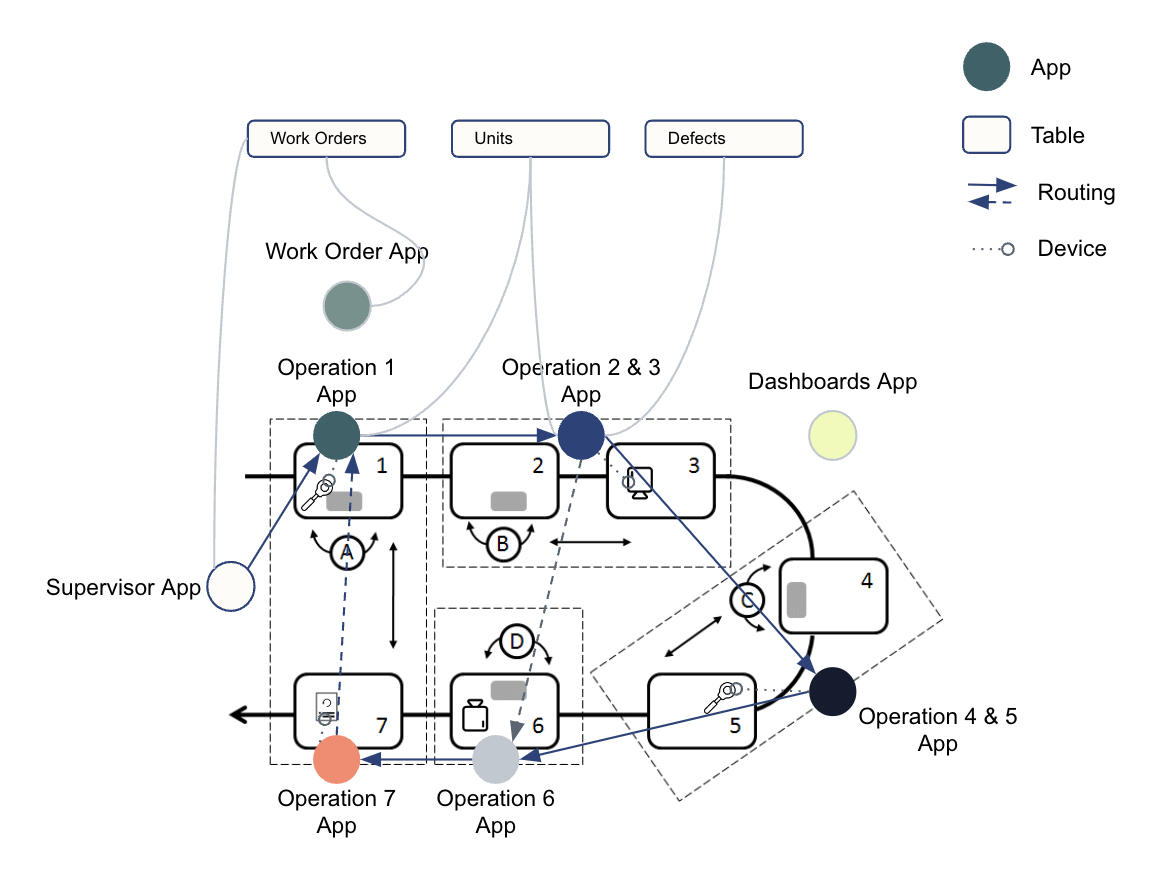
データ保存オプション
Tulip には、データを保存するための 2 つのオプション、つまり「テーブル」と「コンプリート」があります。
テーブル
「テーブル」は、スプレッドシートとリレーショナルデータベースを融合させたもので、データの表示方法に応じて自由にカスタマイズできます。これは、複数のアプリが利用できる共有可能なデータソースです。
テーブルを作成する際には、データをレコード単位で保持・整理する Field を作成します。フィールドは列として機能し、レコードは特定のデータの行であり、個々のデータは「テーブルレコードフィールド」となります。
テーブルをアプリに埋め込むことで、タスクに関連するレコードの作成、変更、表示を行うことができます。
既存のデータをTulipテーブルにインポートする方法については、こちらで説明しています。
独自のテーブルを作成したくない場合、かつインポートする既存のデータもない場合は、インスタンスにプリロードされているTulipの事前設定済みテーブルのいずれかを使用できます。これらを利用することで、テーブルで使用できるさまざまなフィールドや、ログに記録できる一般的なデータの種類について理解を深めることができます。データ型の選択肢には、以下のものがあります:
- テキスト
- 整数
- 数値
- ブール
- 日時
- 間隔
- 色
- 画像
- 動画
- ファイル
- マシン
- 関連レコード
これらの各フィールドは、アプリケーションで使用されるデータ入力項目に対応しています。レコードをテーブル形式で表示するには、Tulipインスタンスのページからテーブル画面に移動してください。「Apps」にカーソルを合わせ、「Tables」を選択します。
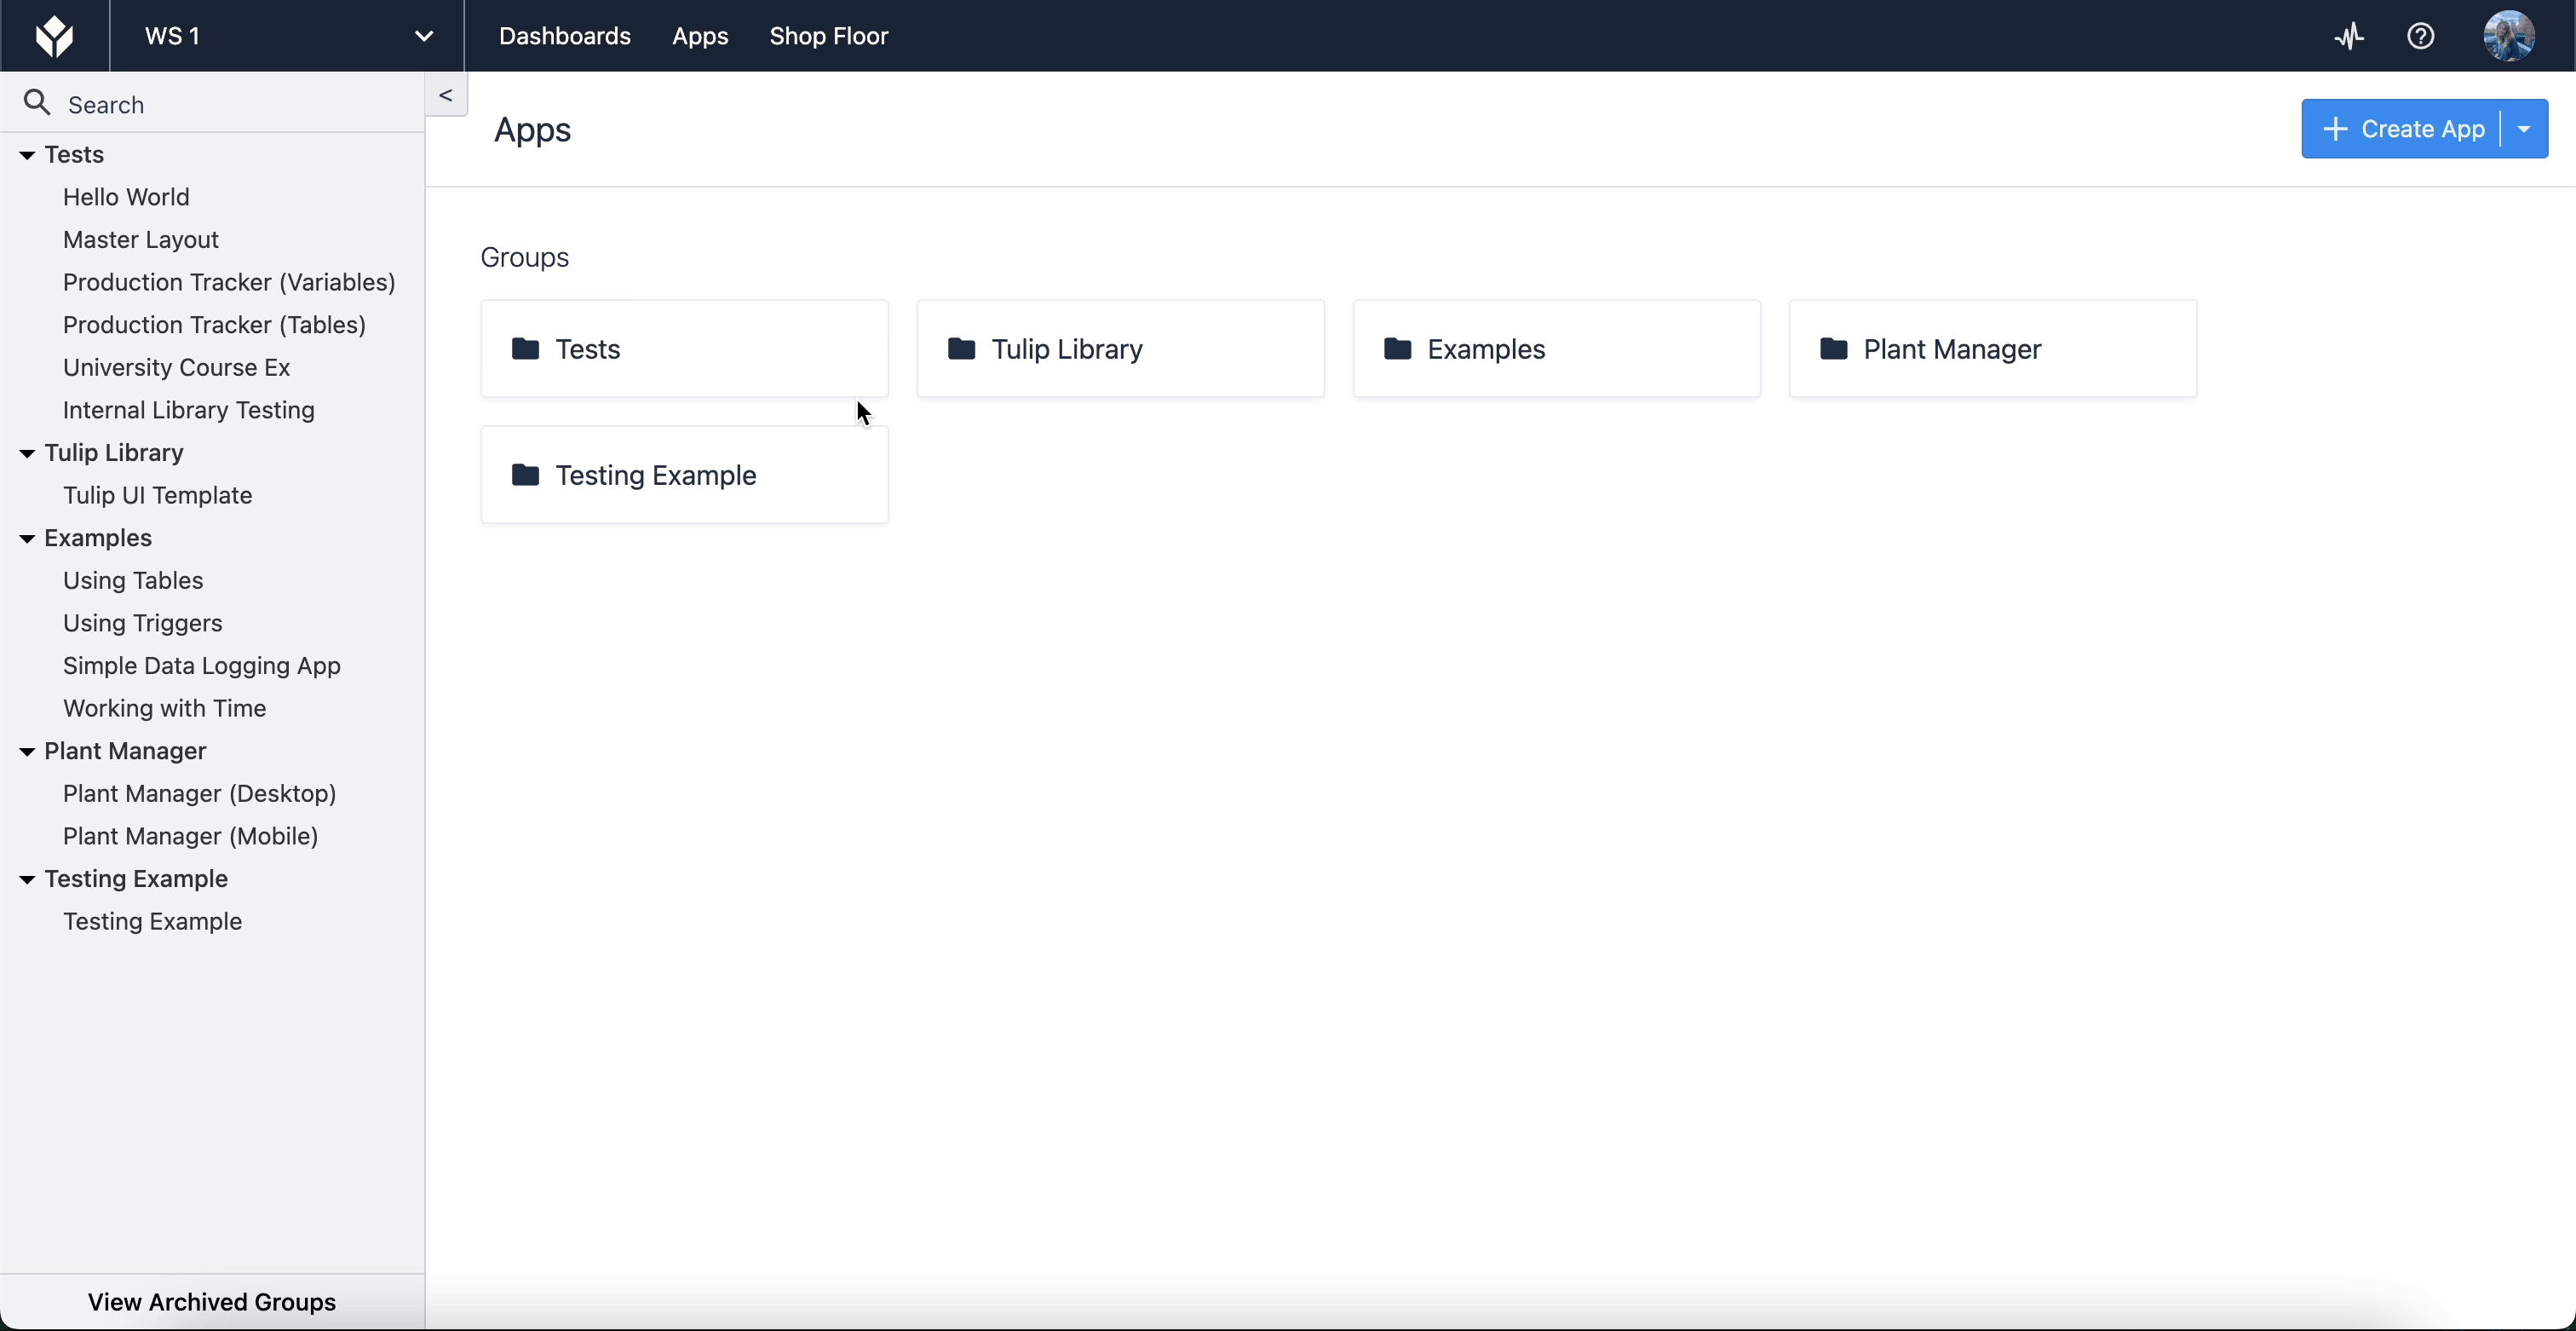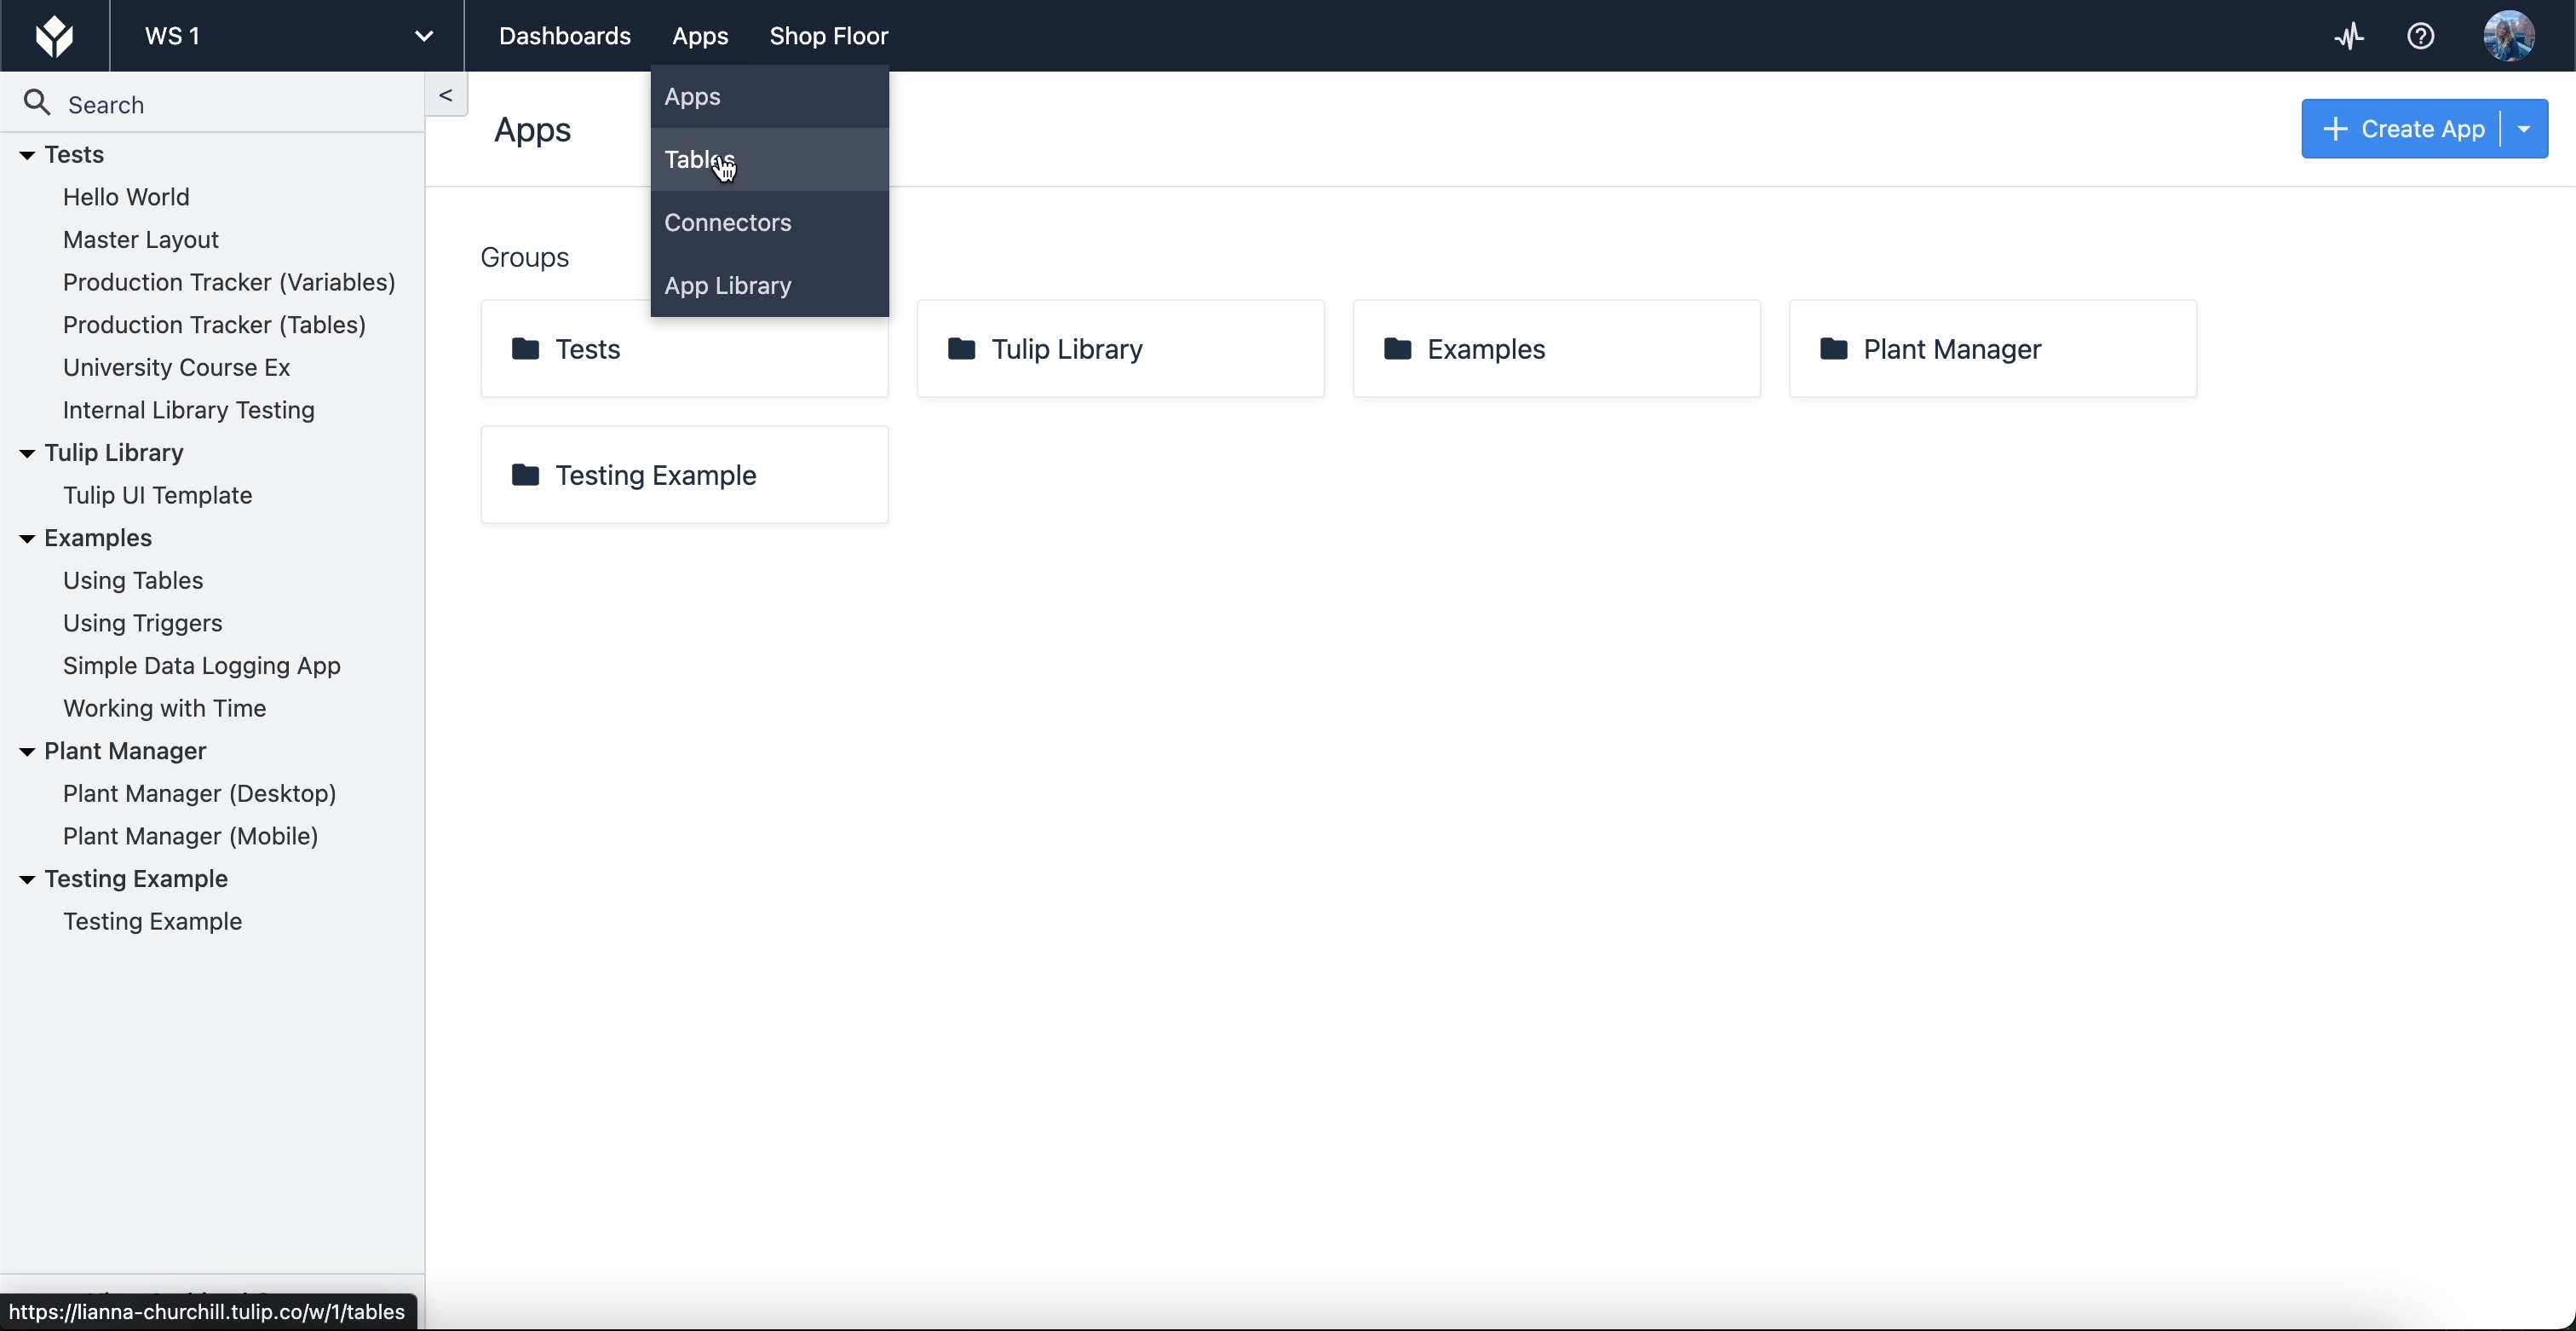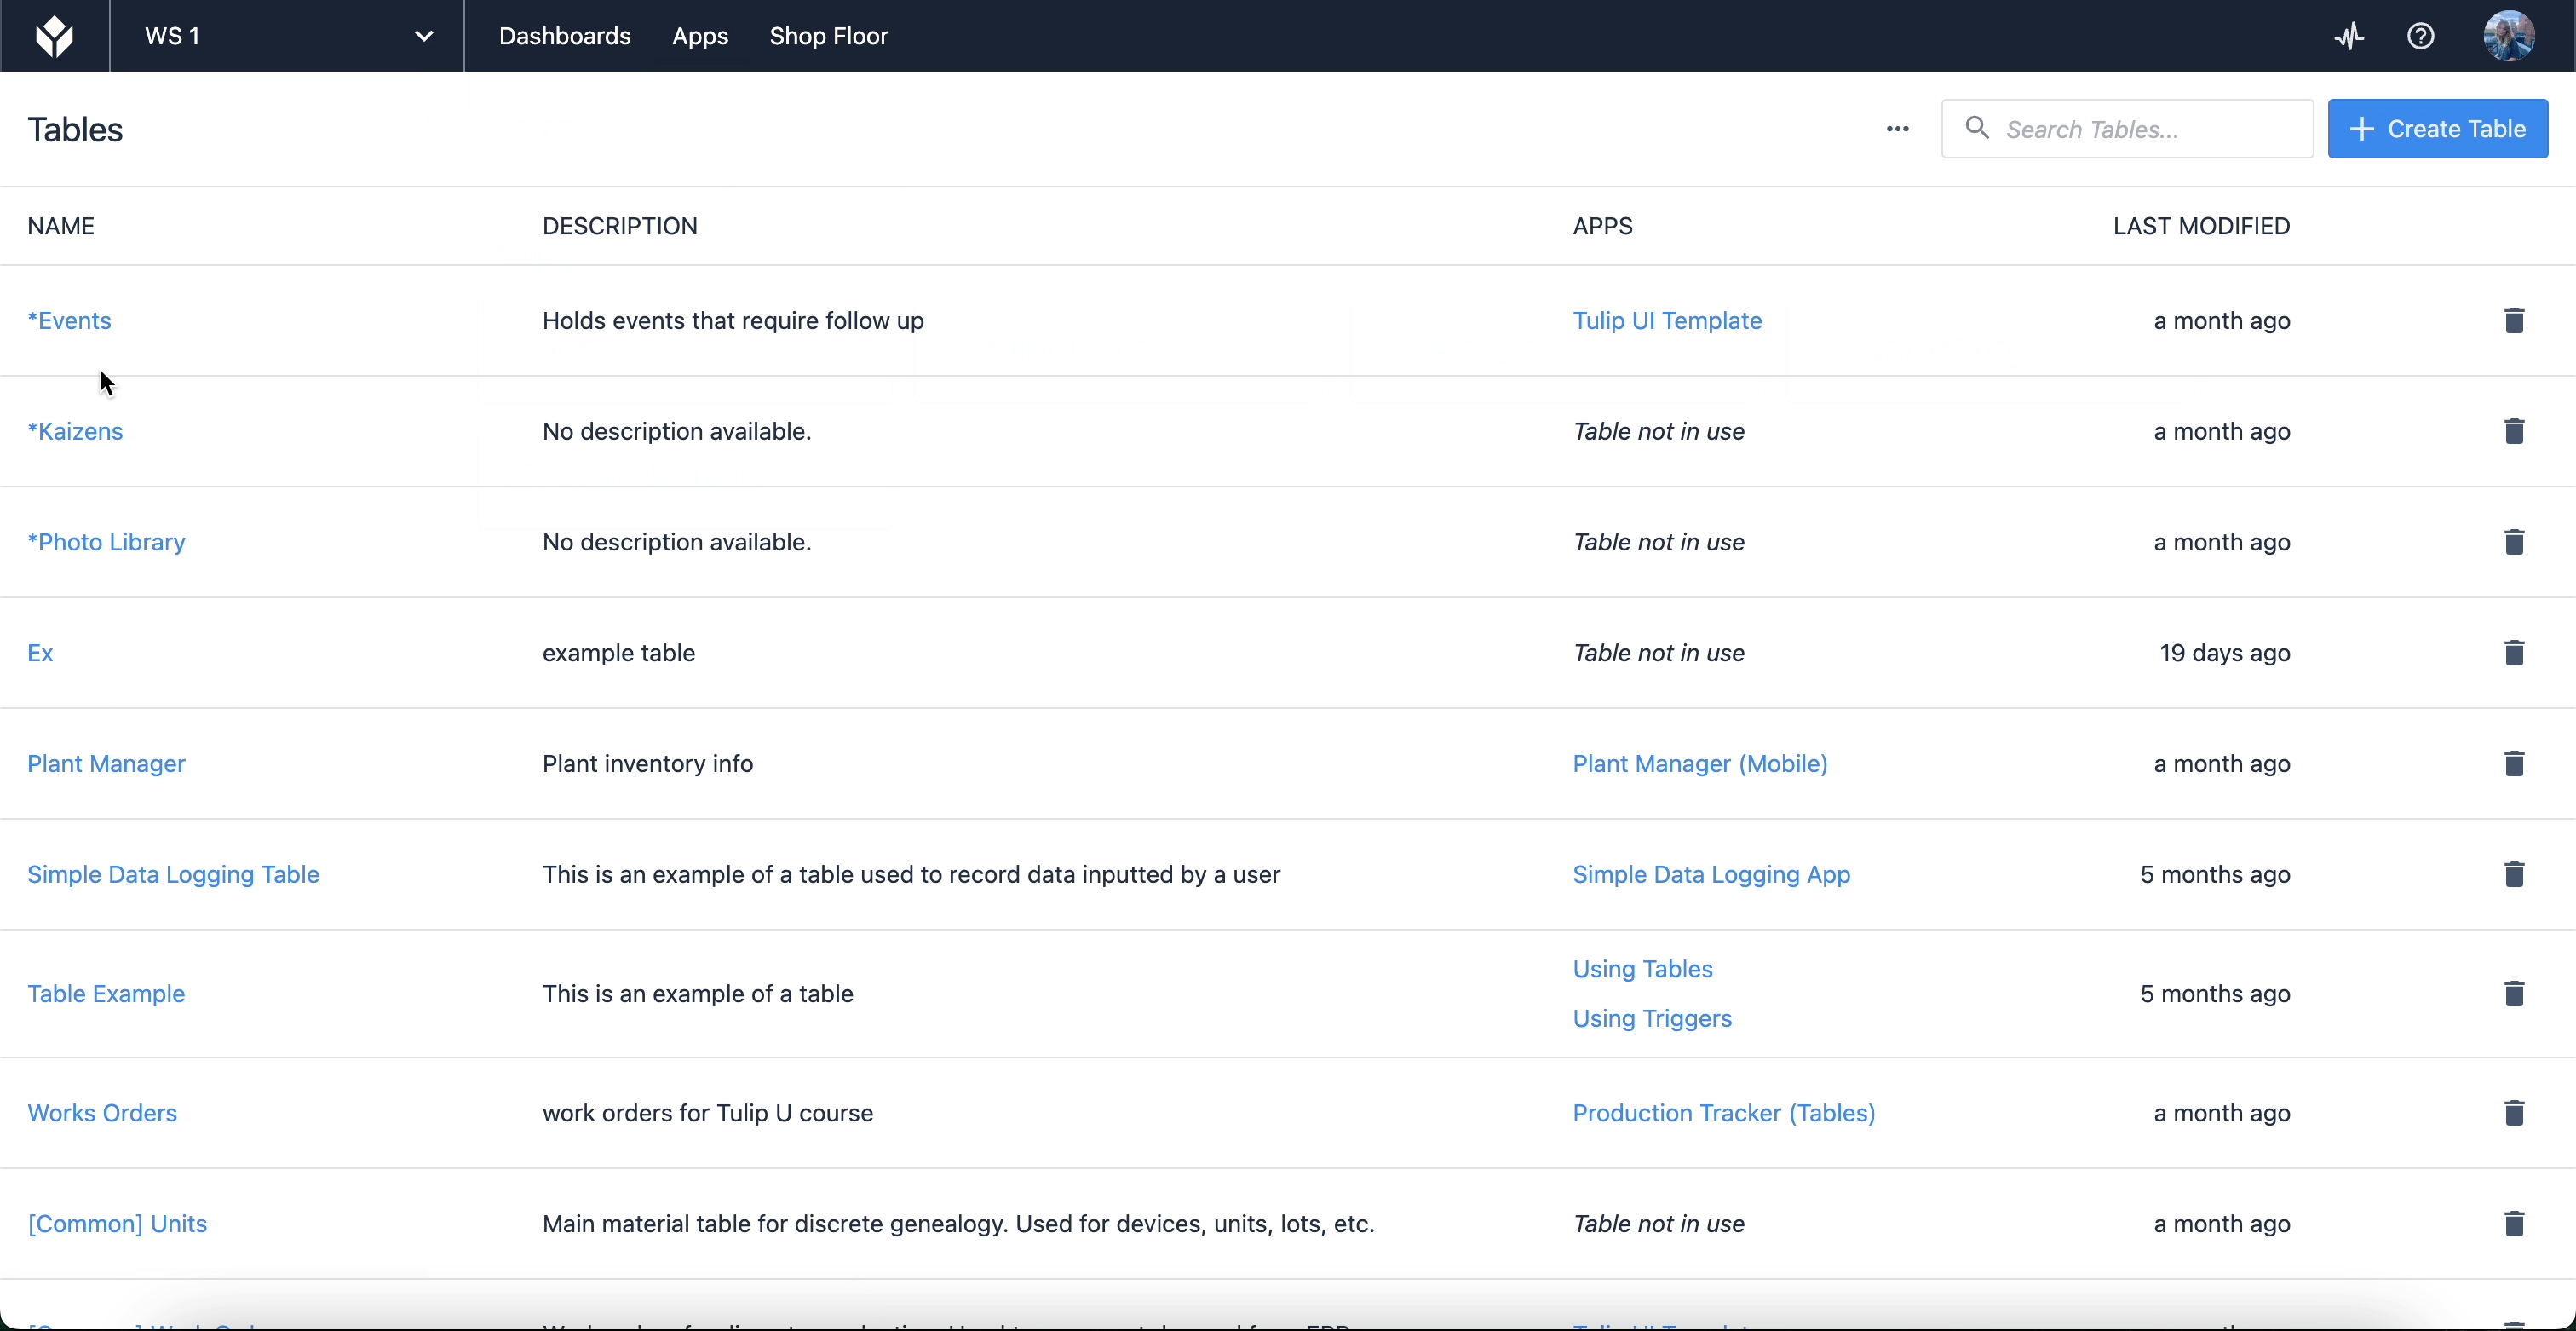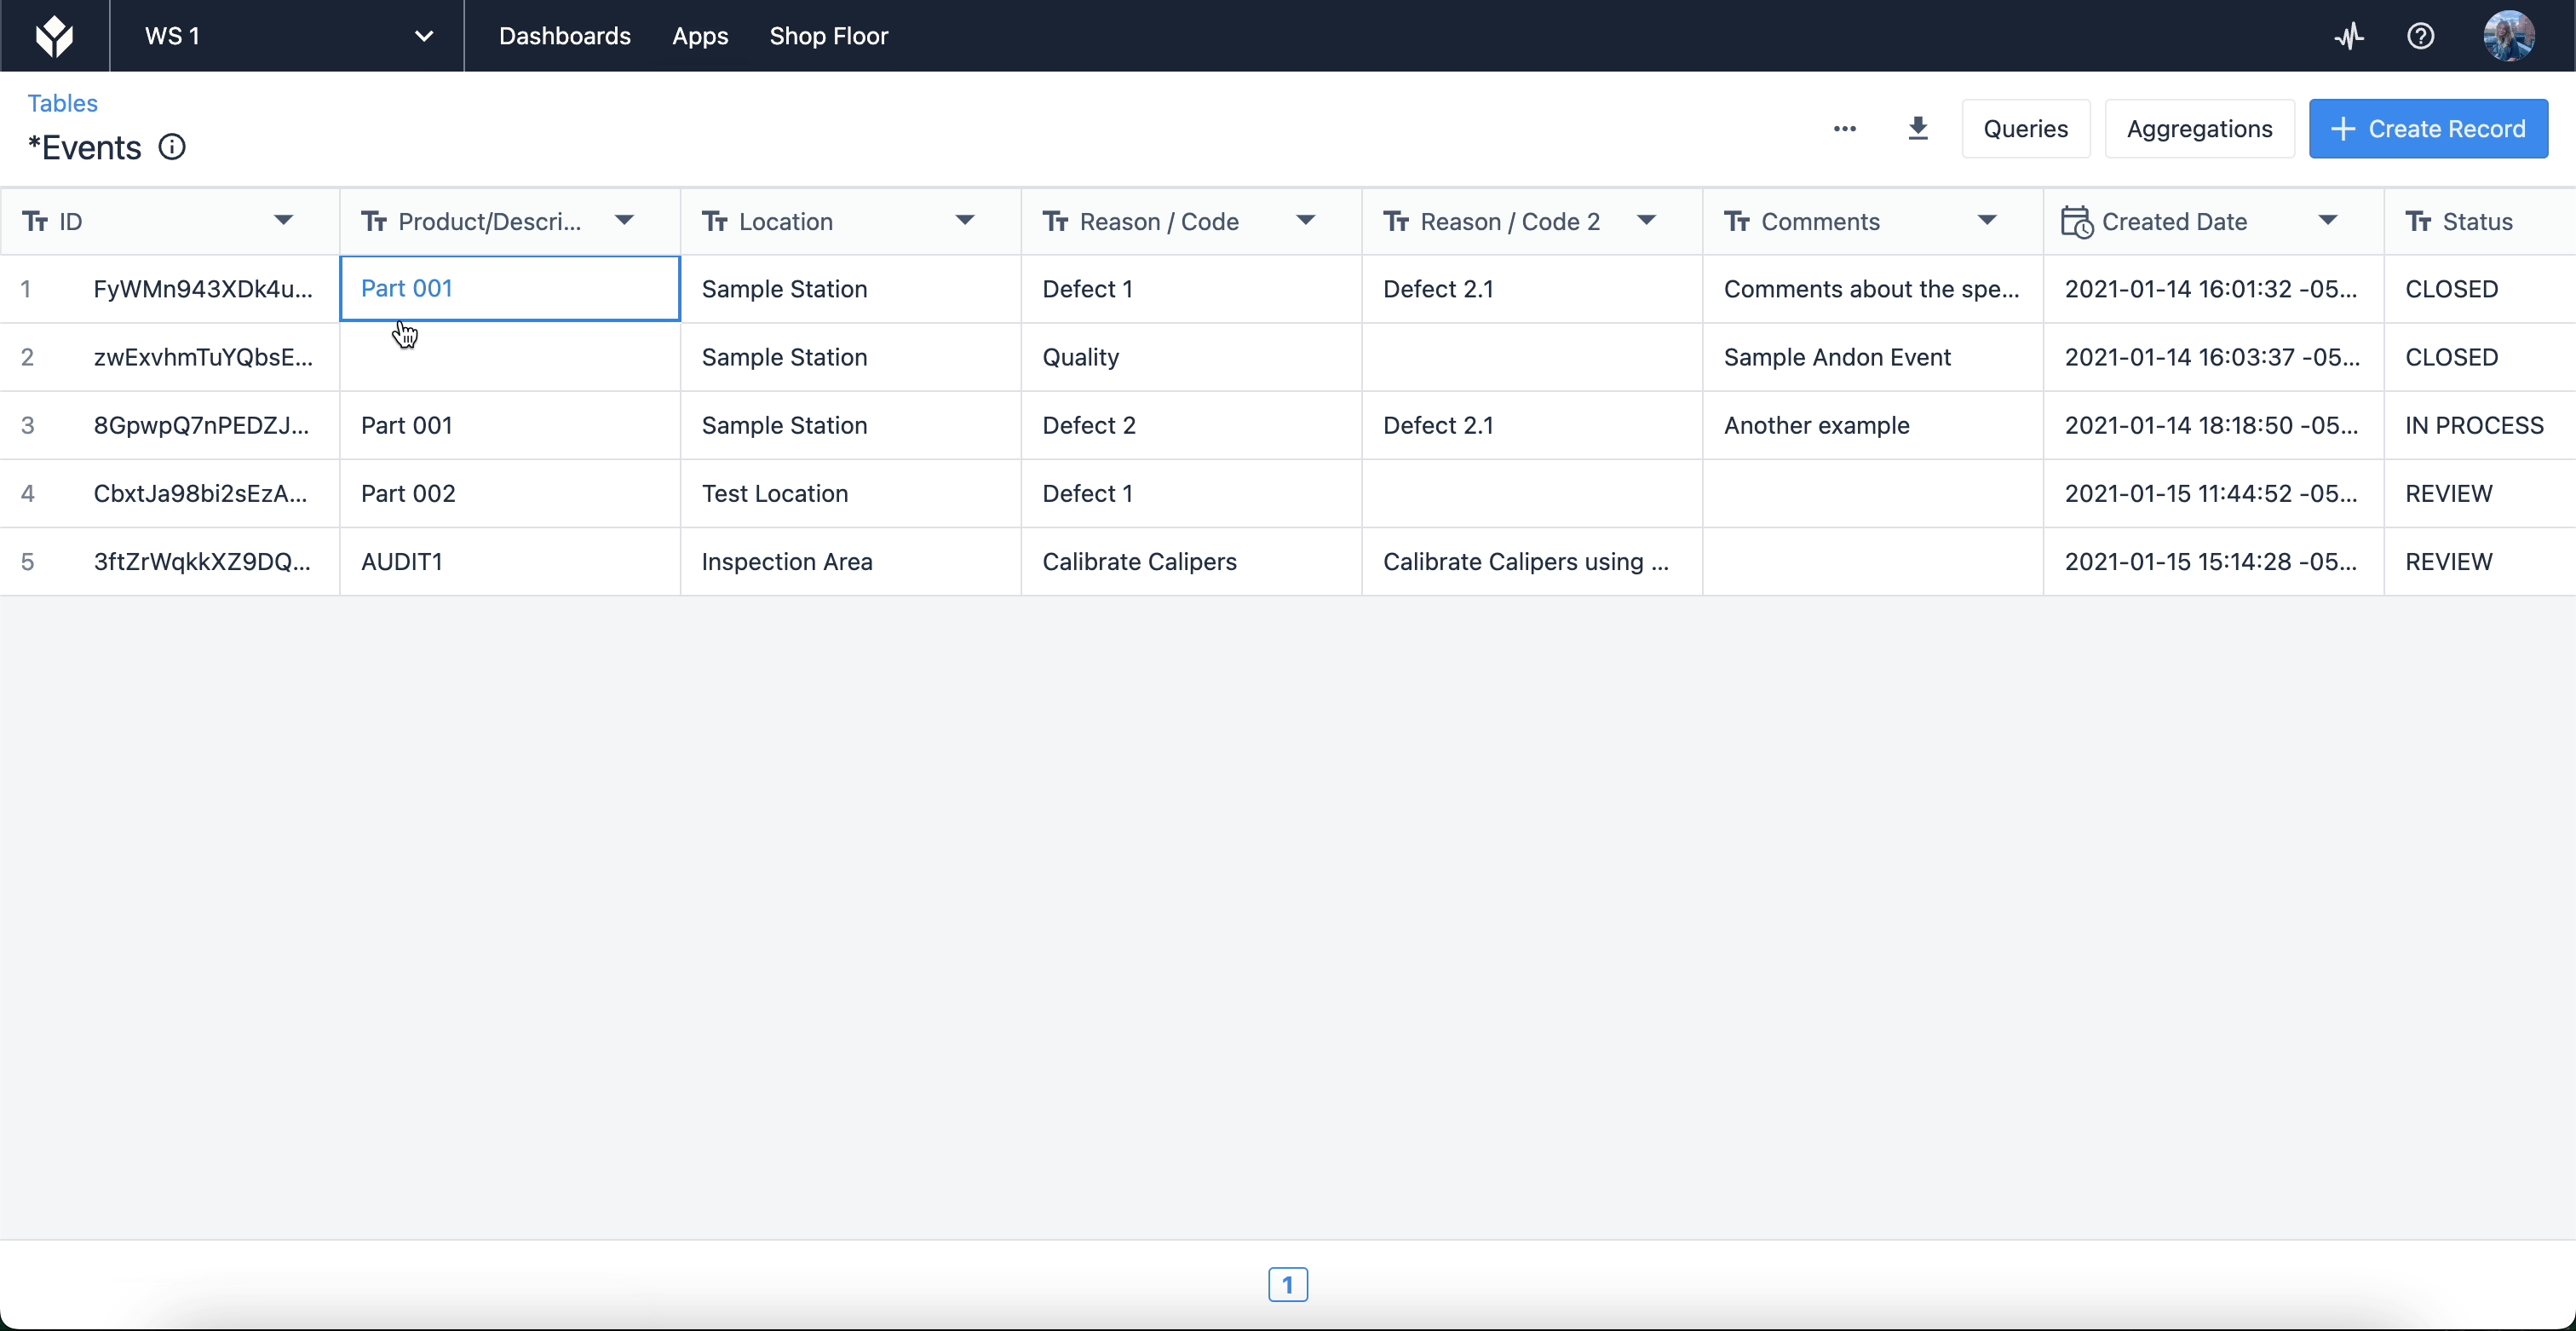
ここでは、アプリで使用するために作成した、またはアクセス権限のあるテーブルの一覧が表示されます。テーブルを選択すると、フィールドやレコード自体を編集できるほか、アプリ内でテーブルデータを活用するためのクエリや集計を作成することもできます。 また、テーブル同士を相互にリンクさせることも可能です(製品の系譜などのユースケース向け)。
Tulip テーブルの使用に関する推奨事項
Tulip では、大まかに分けて「物理的」と「運用上」の 2 種類のアーティファクトをテーブルに保存することを推奨しています。
物理的アーティファクトとは、バッチ/ロットや設備など、業務中に使用または生成される有形のオブジェクトやコンポーネントのことです。運用上のアーティファクトとは、欠陥イベントやカンバン設定など、業務を可能にしたり支援したりする非物理的な要素やコンポーネントのことです。
Tables の使用方法の詳細については、以下を参照してください:
完了
アプリの完了データは、生産データの保存や整理に最適です。ユーザーがアプリを完了またはキャンセルすると、メタデータフィールドが自動的に生成され、保存されます。これらのフィールドには以下が含まれます:
- アプリの実行時間
- 開始時刻と終了時刻
- ログインユーザー
- ステーション名
- コメント
- アプリのバージョン
- 実行ID
- キャンセル済み(アプリがキャンセルされたかどうかにかかわらず)
テーブルに保存されたデータとは異なり、アプリの「完了」に保存されたデータは編集できません。これにより、情報は絶対的なものとなり、操作や変更が不可能で、アプリの利用状況を正確に反映しています。
完了データは1つのアプリでのみ使用可能であり、外部システムからのアクセスも制限されています。
アプリの完了データにアクセスするには、Tulipインスタンス内のアプリグループからアプリを選択してください。アプリのメイン画面が表示されたら、「完了」タブを選択します。
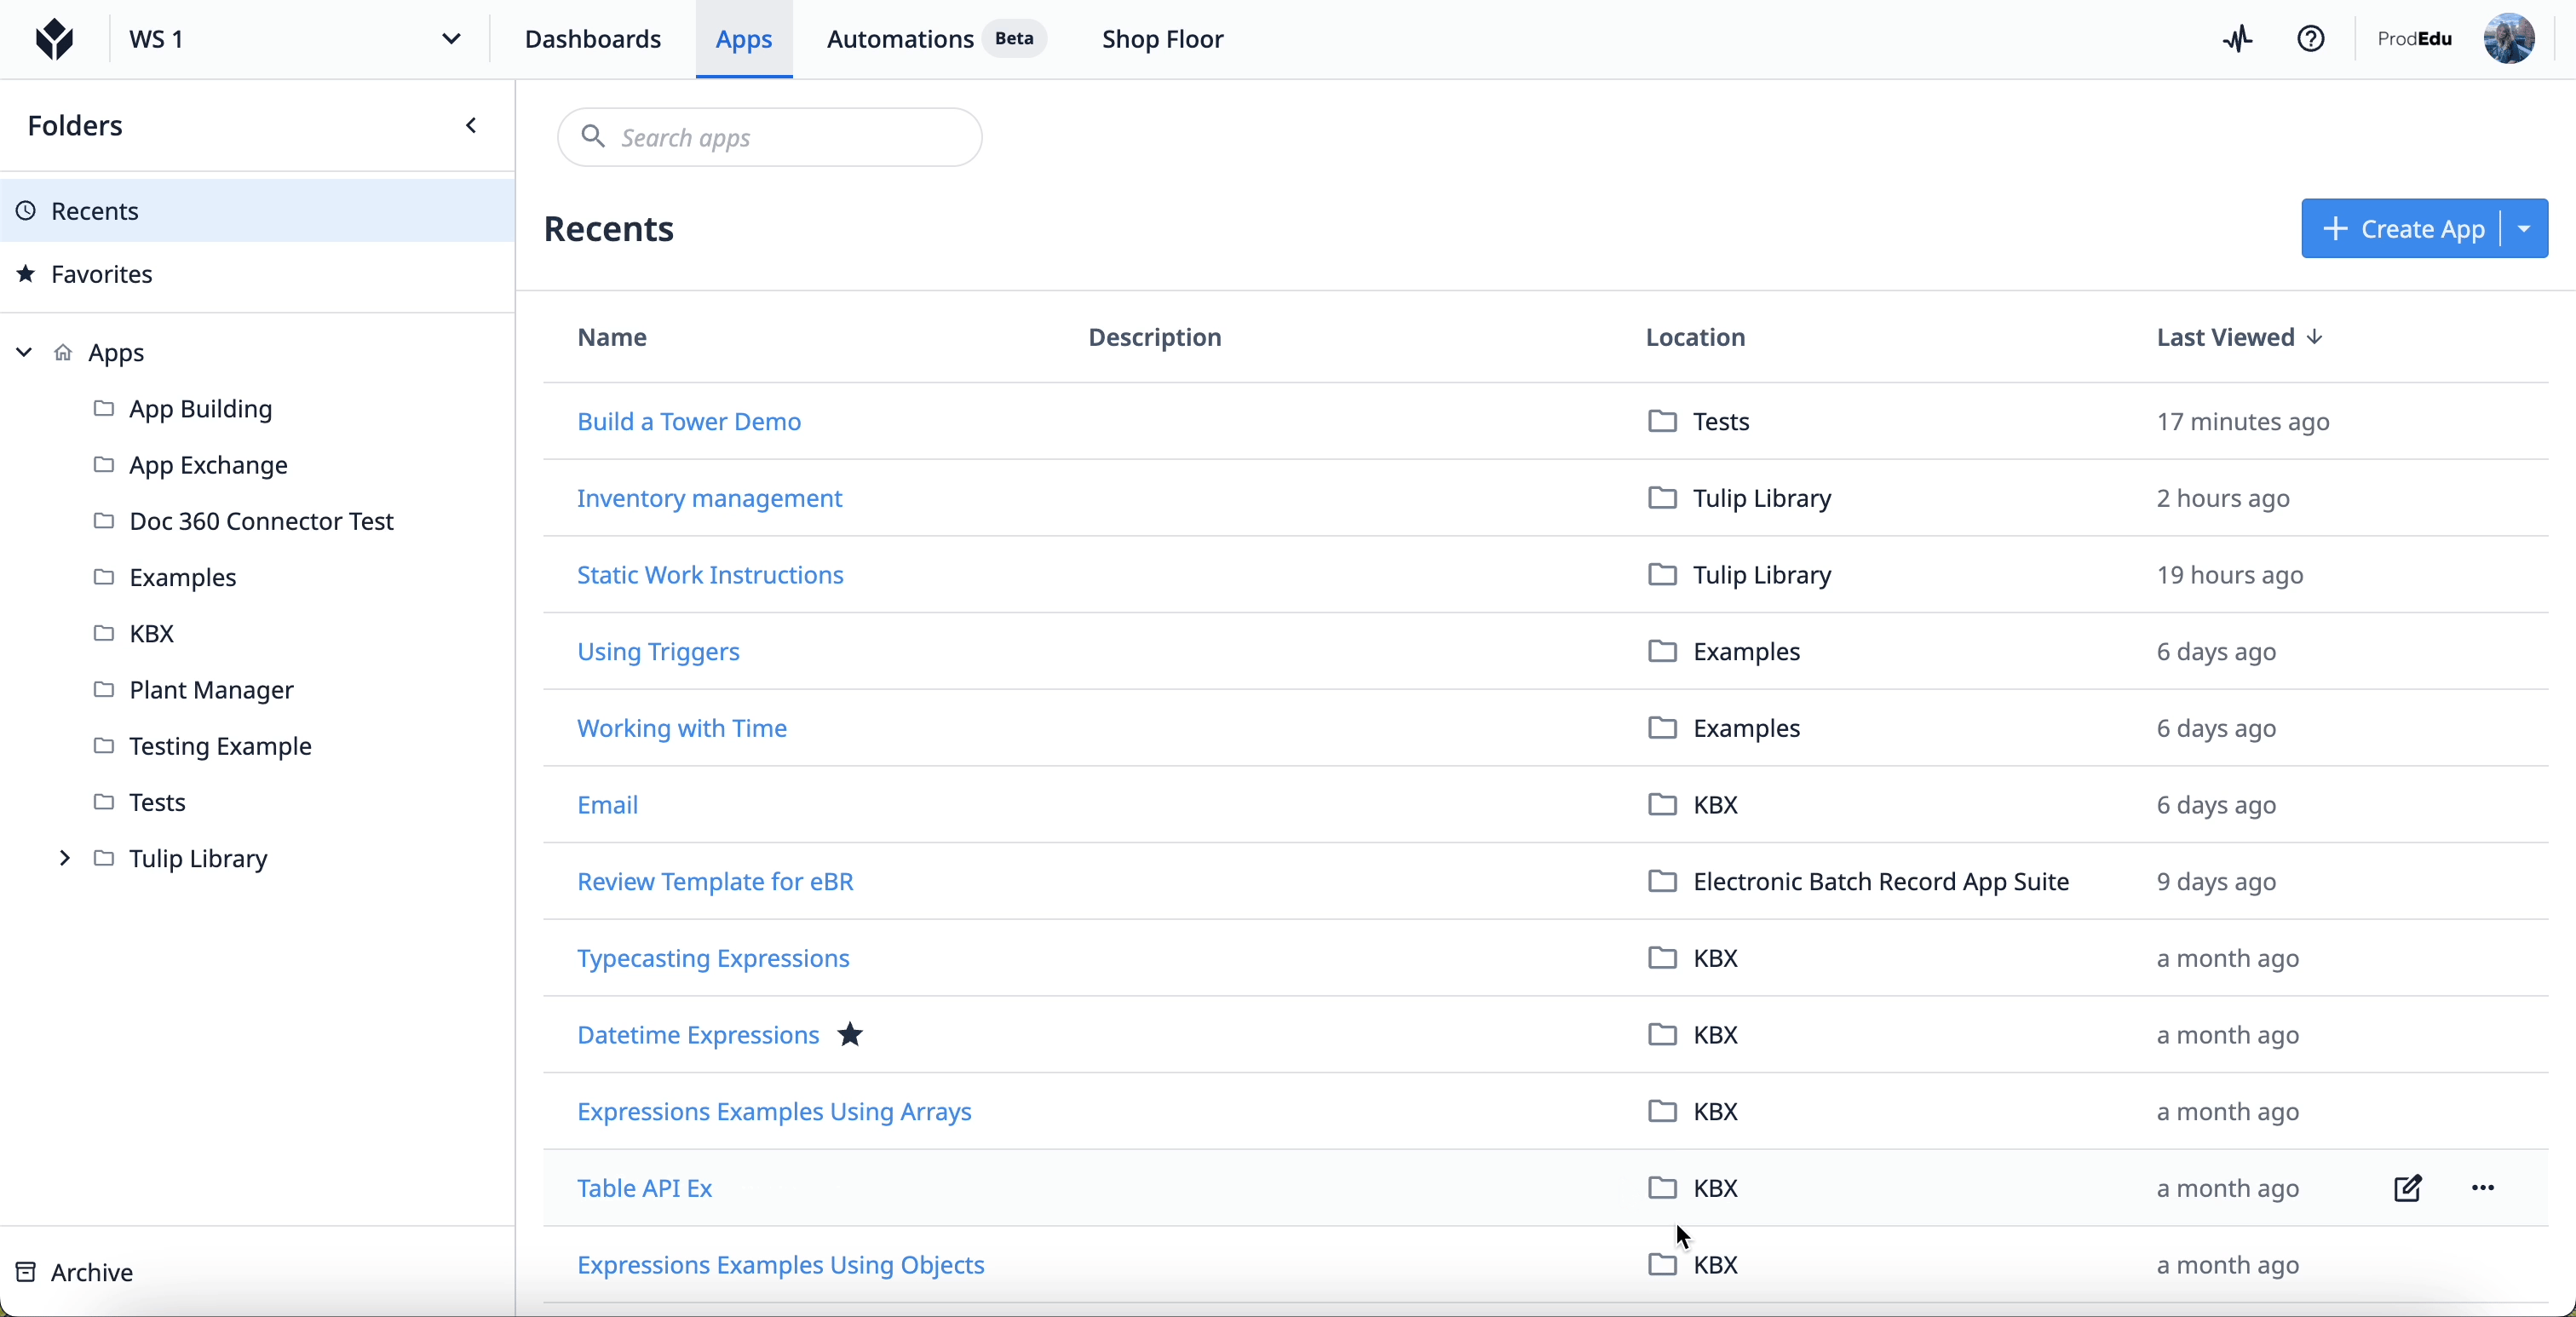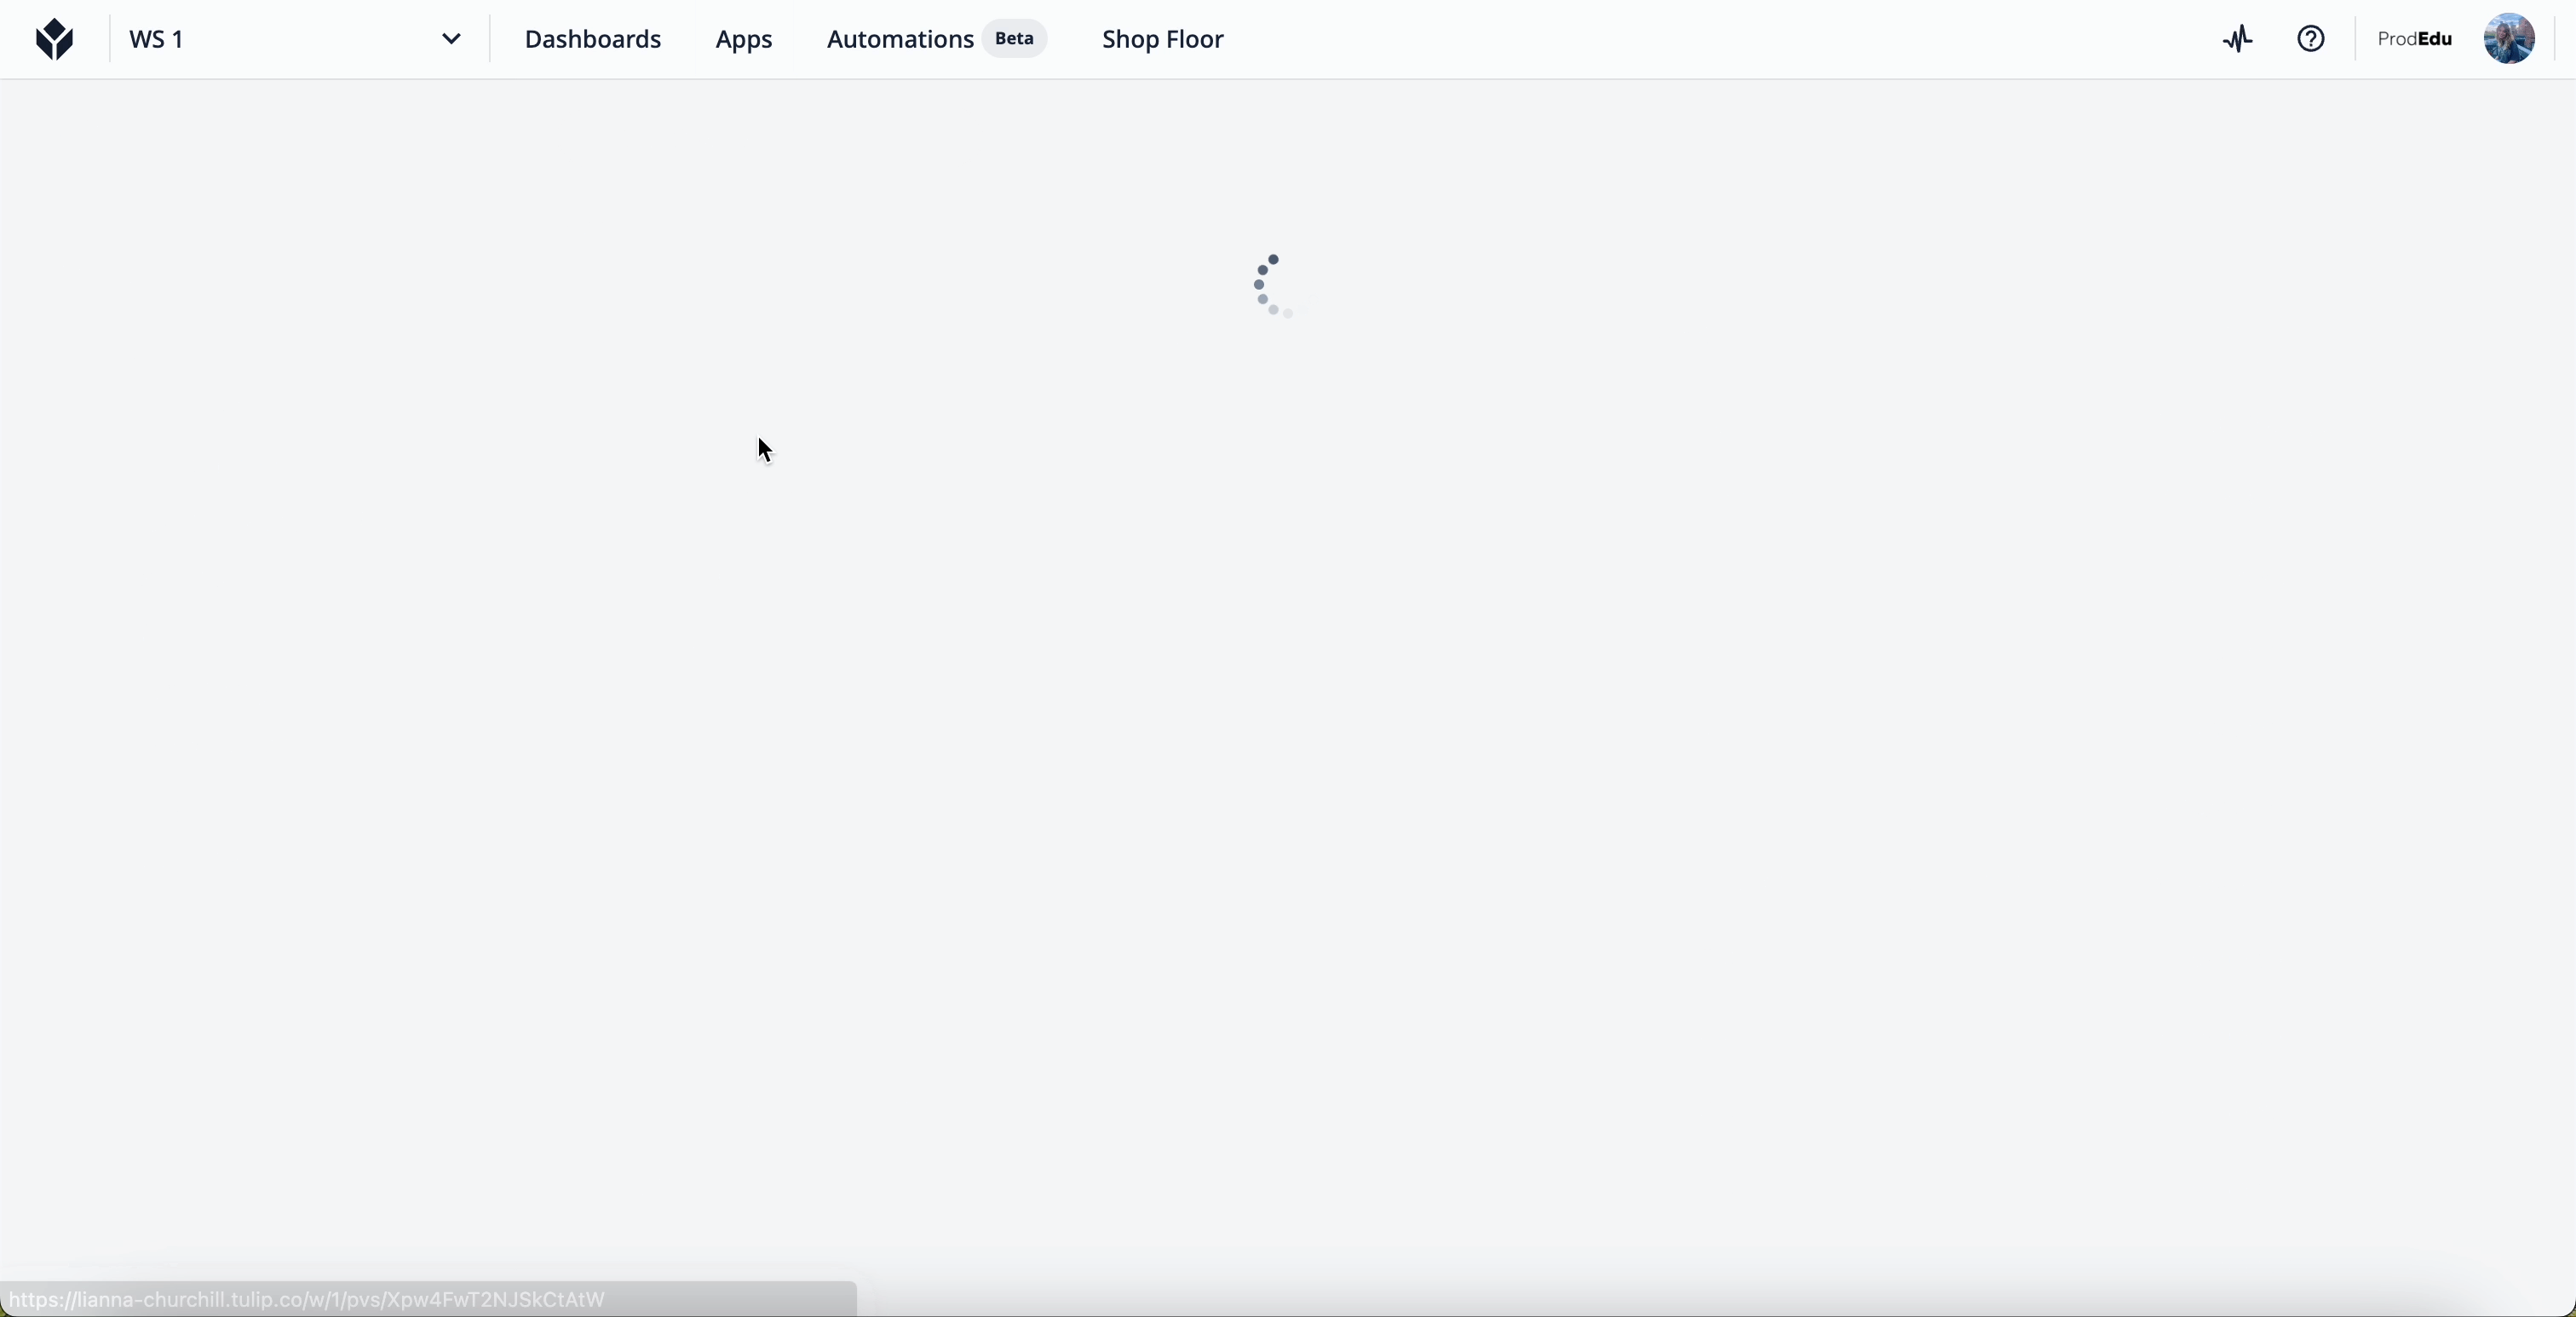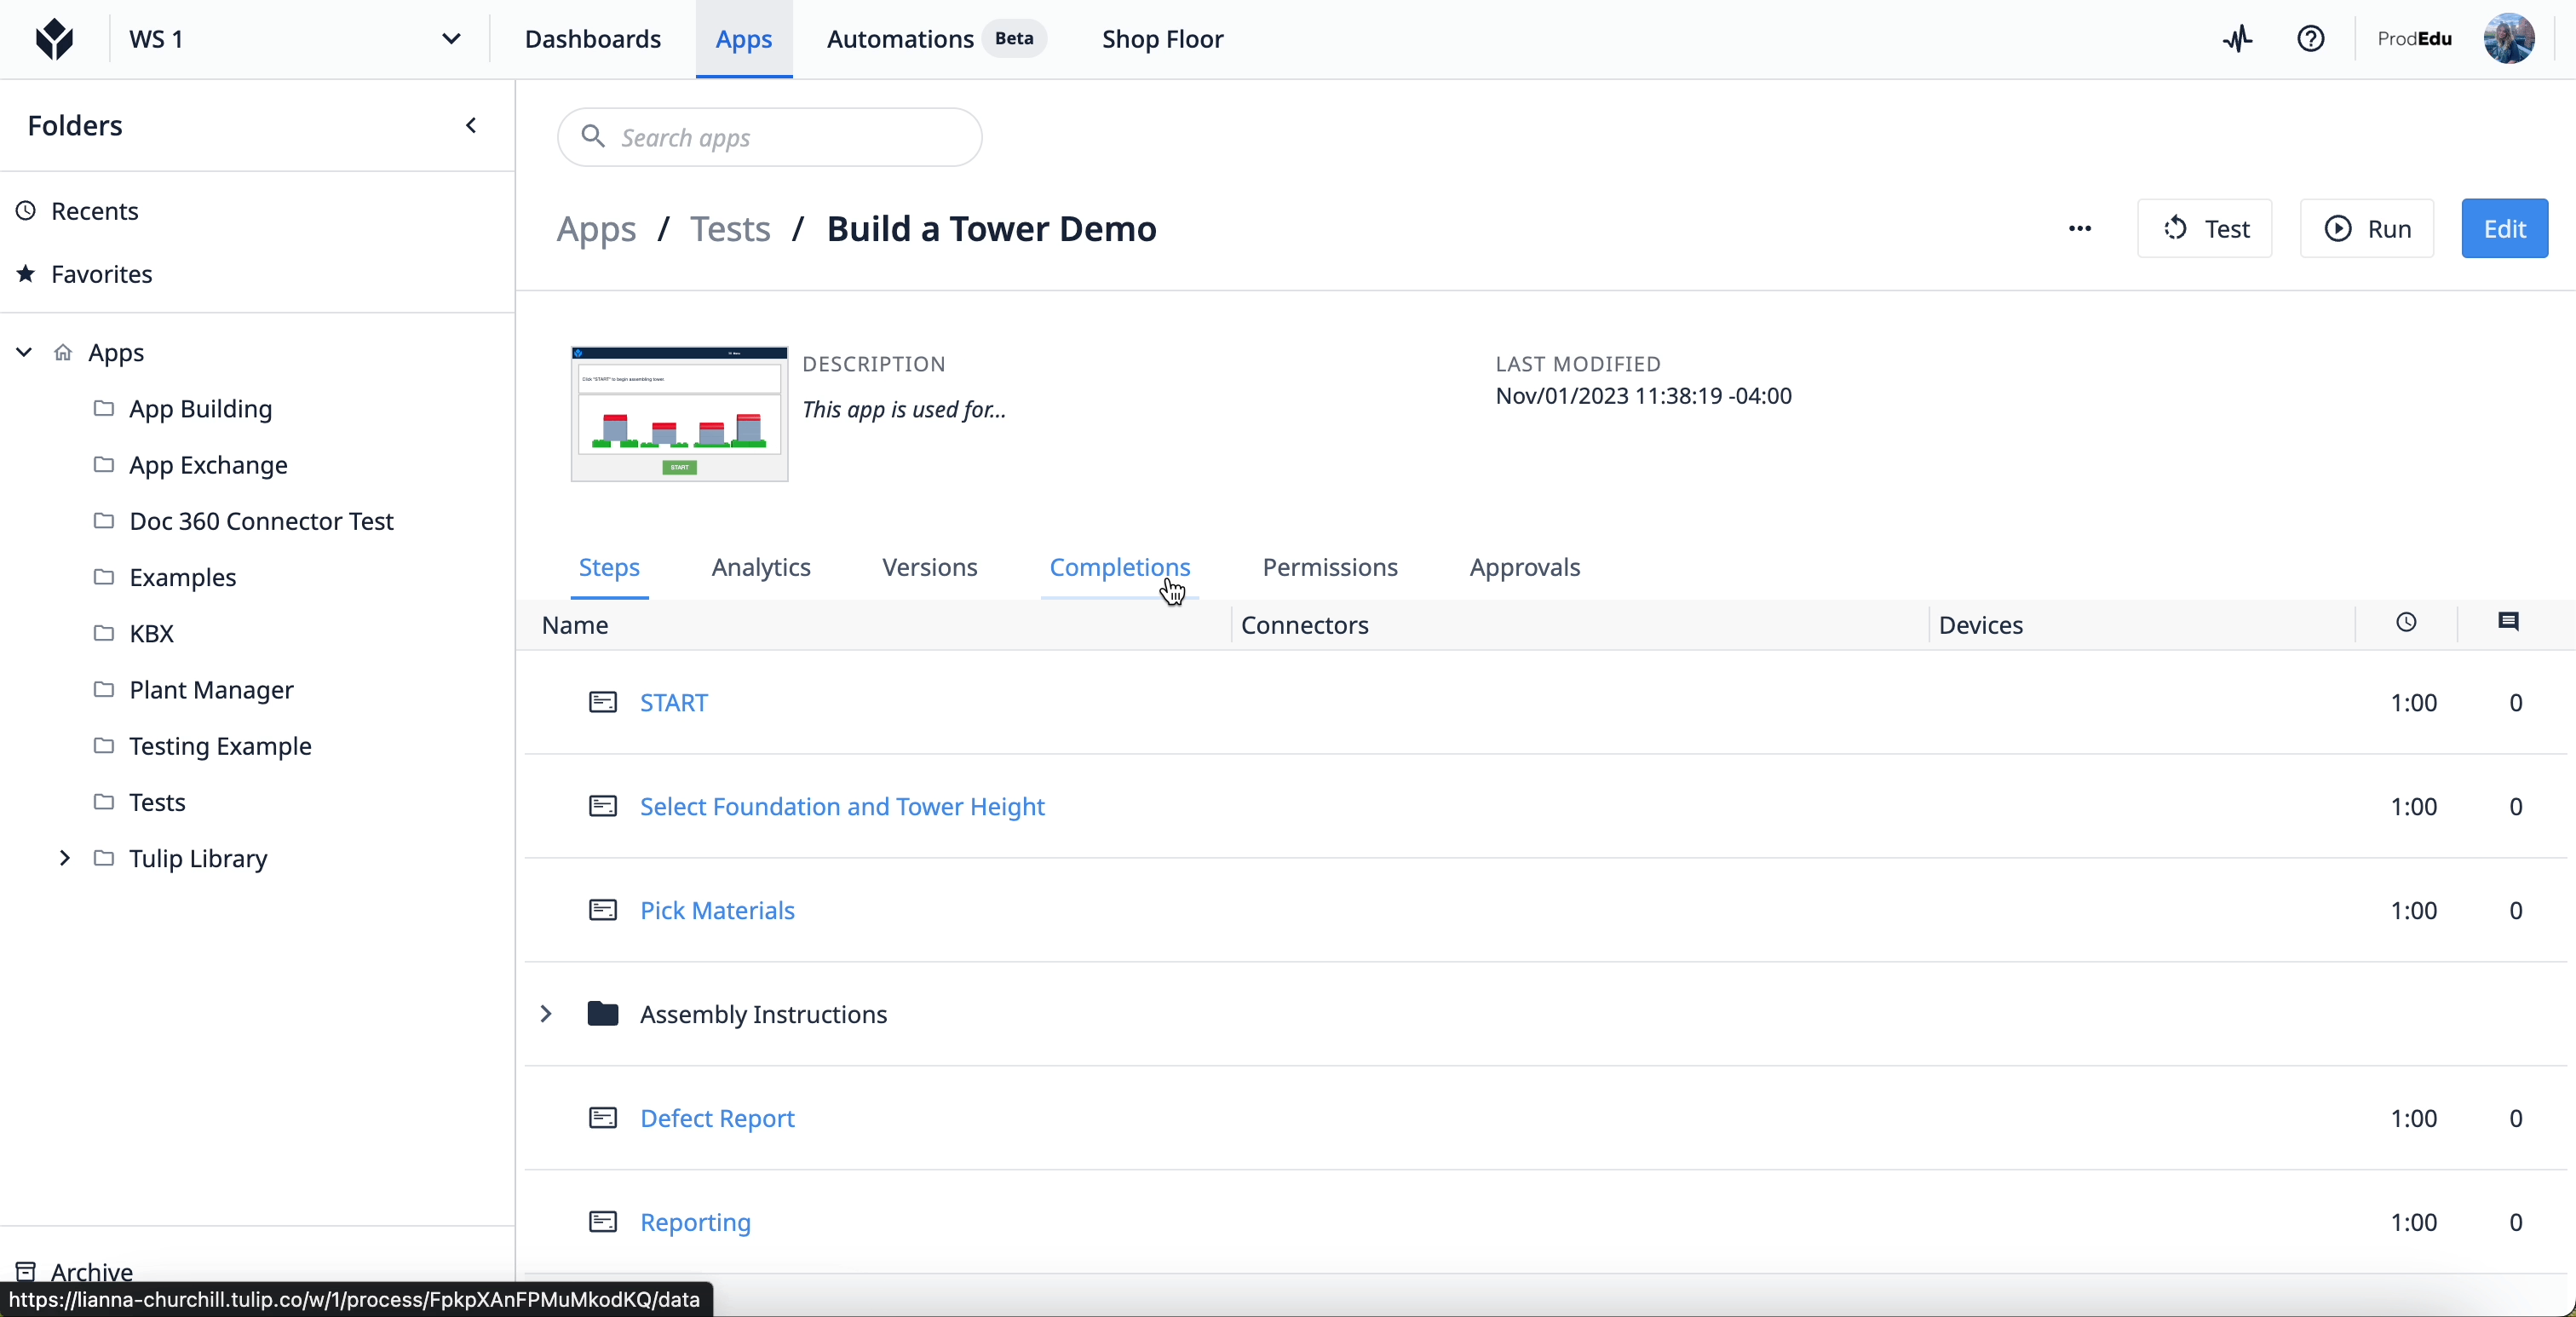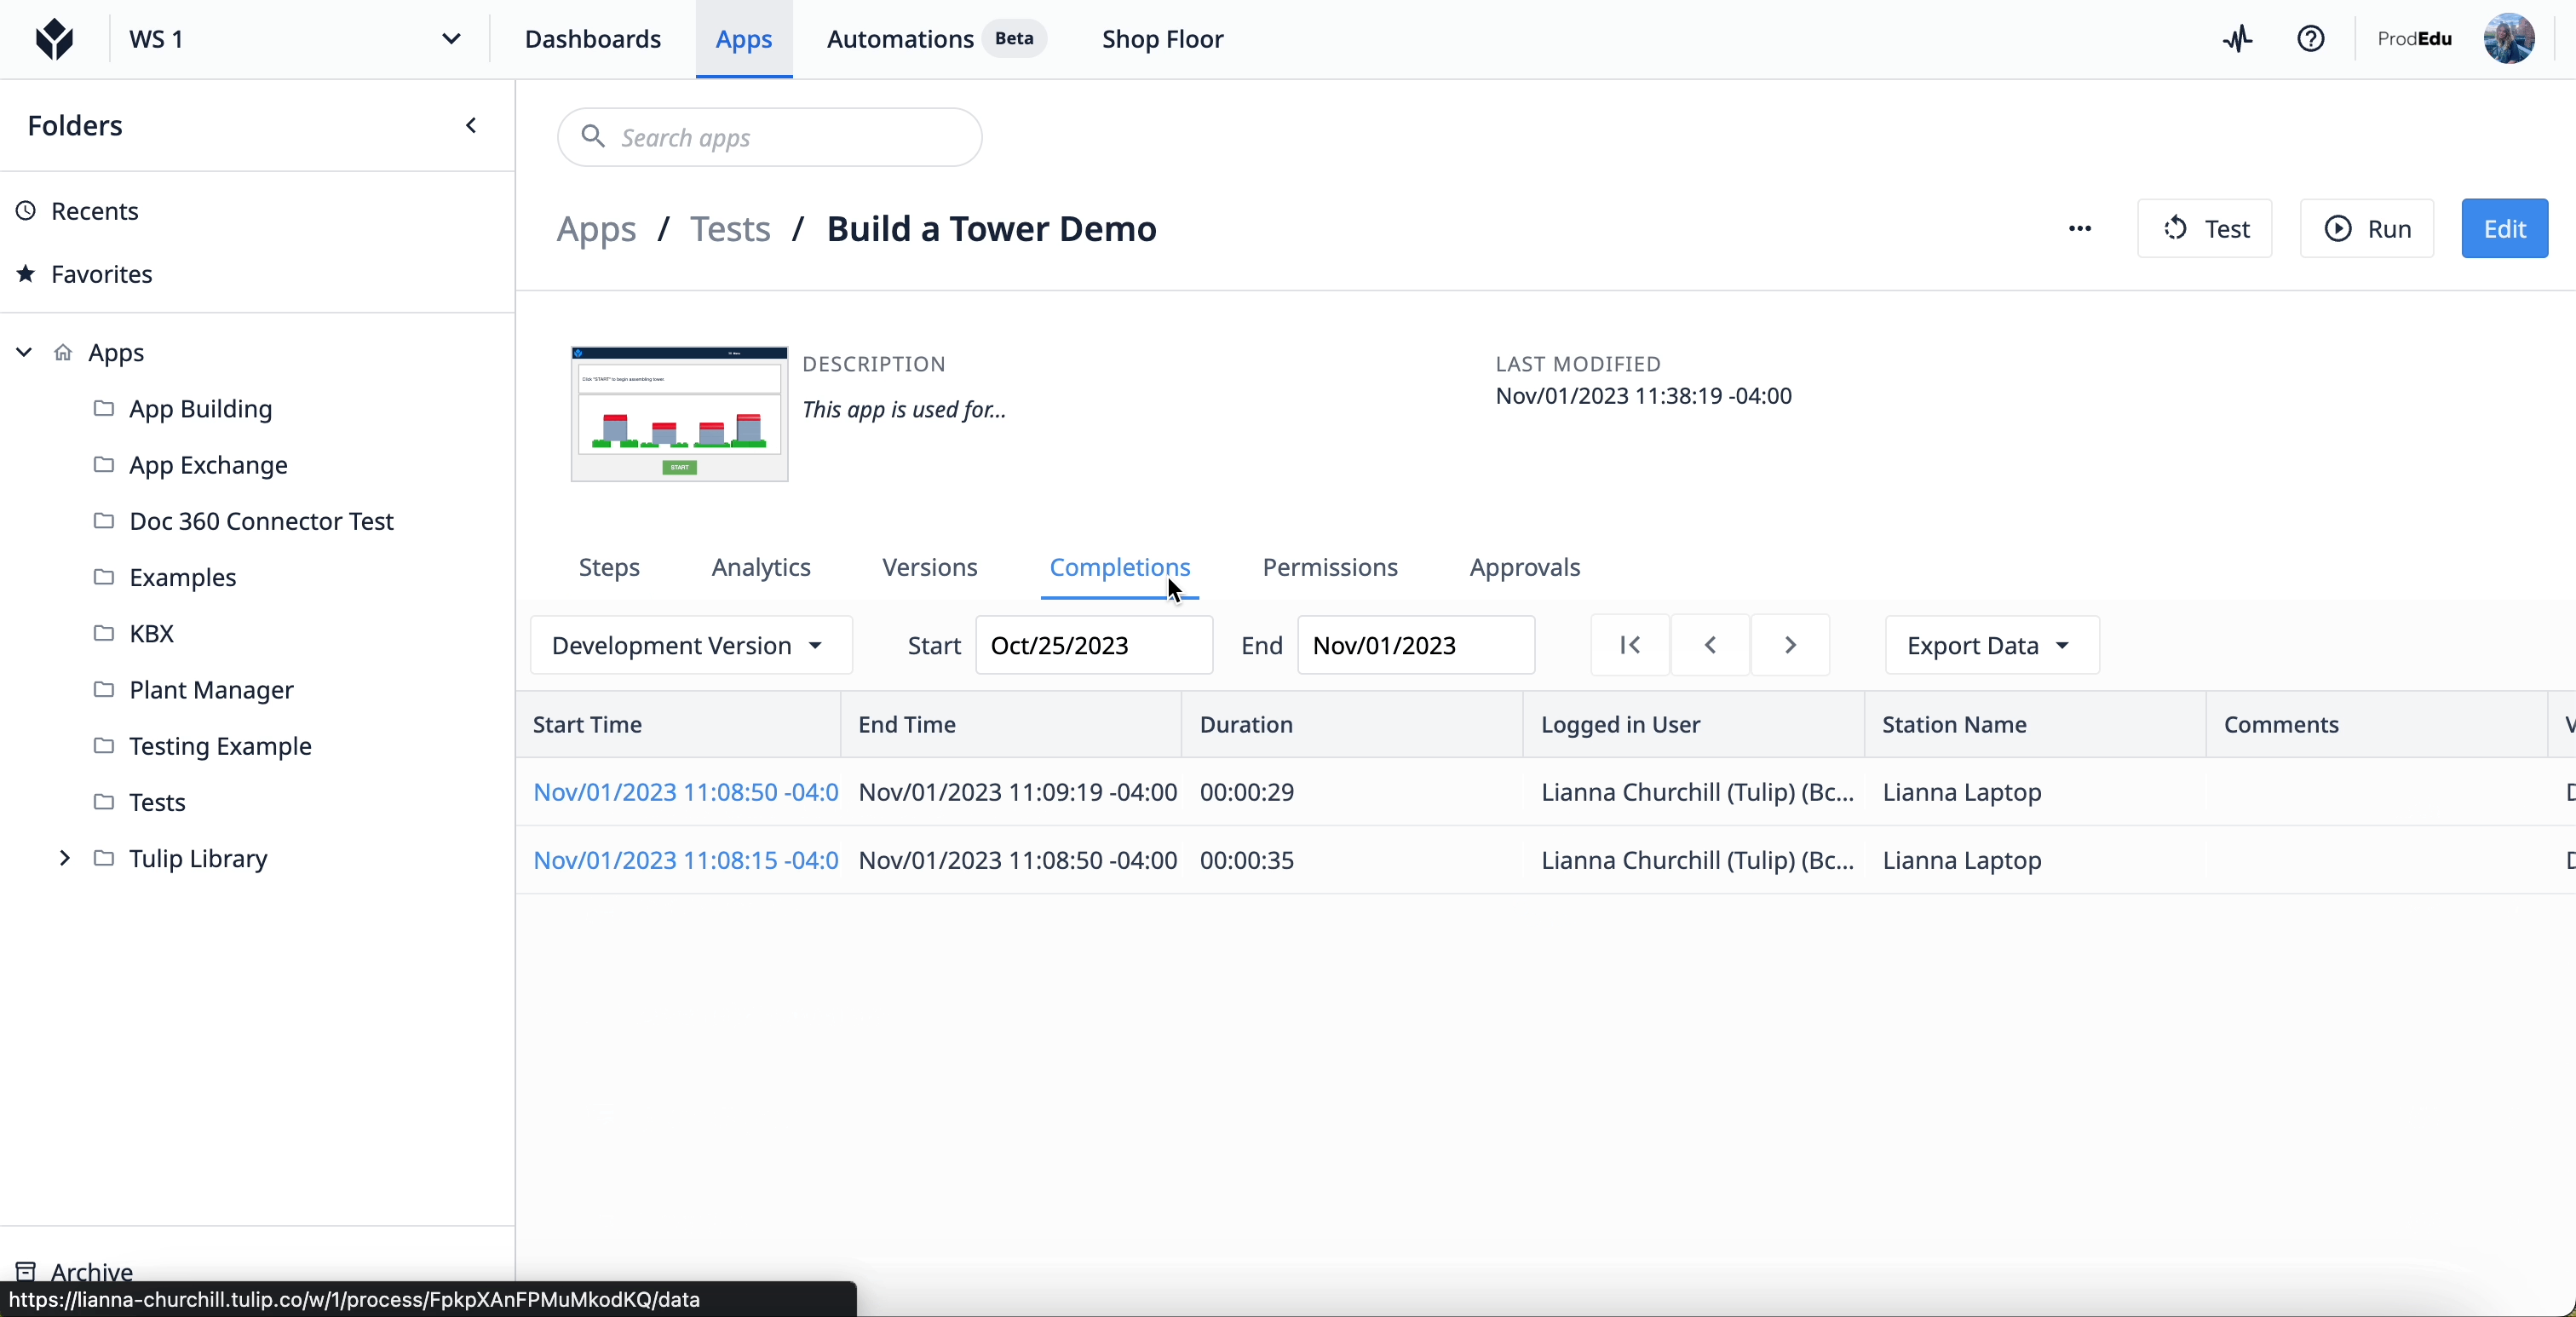
コンプリートに関する詳細はこちらをご覧ください。
テーブルとコンプリート
コンプリートデータはアプリデータに自動的に保存されるため、どのような場合にデータ用のテーブルを設定すべきか疑問に思うかもしれません。
完了データは変更不可能なのに対し、テーブル内のフィールドはニーズに応じて作成されます。 テーブルデータも、設定したトリガーや変数に基づいてアプリから書き込まれますが、コンプリートデータは、ユーザーがアプリを完了またはキャンセルしたときにのみ書き込まれます。コンプリートデータは手軽で即座に自動化が可能ですが、テーブルデータはアプリごとに独自に作成でき、複数のアプリでデータを柔軟に活用することができます。
データ保存のベストプラクティス
データストレージは運用に合わせてカスタマイズできるため、データ構造を設定する方法は多岐にわたります。Tulipでは、以下の目標に沿ってテーブルを構築し、データを保存するために、いくつかのベストプラクティスを推奨しています:
- データに容易にアクセスできる
- 必要なユーザーやシステムがデータを確認できる
- データは一元化され、他の場所に重複して保存されない
Tulipのデータ保存に関するベストプラクティスの詳細については、こちらをご覧ください。
データモデルの適用
Tulipには、さまざまなユースケースに対応した既成の共通データモデルが用意されており、特定のニーズに合わせて採用・適応させることができます:
Tulipにおける共通データモデルとは、アプリ群からなるソリューション全体でデータを共有できるほど柔軟性に富んだ、定義済みのテーブルの集合体です。
以下の図は、テーブルがアプリ間で共通データをどのように共有するかを示しています。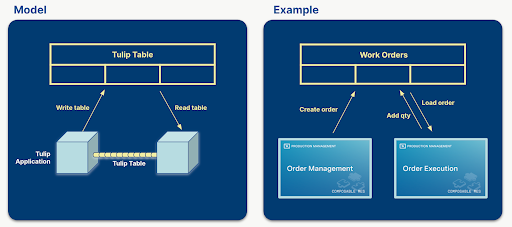
共通データモデルは、標準化され拡張可能なデータスキーマを提供し、広く使用されている概念(例:作業指示書、単位)を表現することで、システム間のデータ処理を効率化します。これにより、データの作成、集計、分析が簡素化され、データ管理の改善に向けた大きな機会がもたらされます。
Tulipのテーブルは、主にデジタルツインモデルに従う必要があります。つまり、テーブルは物理的なプラントや現場を可能な限り厳密に反映すべきです。テーブルにマスターデータが保存されたり、完了記録や外部レコードからのデータが重複したりしないよう、過去のアプリデータは完了記録に限定する必要があります。
共通データモデルの使用方法の詳細については、こちらをご覧ください。
Tulip Universityの「共通データモデル」コース はこちらで受講できます。
アプリでのデータの活用
アプリ内でテーブルデータを表示、編集、または入力するには、まずウィジェットについて理解する必要があります。Input Widgetを使用すると、テーブルに反映されるデータの編集や入力が可能です。埋め込みウィジェットは情報を表示し、テーブルと対話できるように設定できます。 テーブルデータの組み込みに関する完全なチュートリアルについては、以下をご覧ください:
完了データは、Analytics を通じてアプリに表示できます。まず、完了データを使用して分析を作成し、その分析をアプリに埋め込む必要があります。
完了データを使用して分析を作成する方法の詳細については、こちらをご覧ください。
Tulip によるデータの保存方法
Tulipはセルフサービス型のプラットフォームであるため、どのデータを送信・保存するかをユーザー自身が決定できます。 Tulip Cloudは、MongoDBまたはPostgreSQLデータベースを使用して、AWS上にデータを保存します。Tulipはすべての画像、動画、PDFを自動的にAmazonのS3ストレージにアップロードするため、ストレージの管理や収集したデータの追跡について心配する必要はありません。
次のステップ
Tulipの専門家によるガイダンスを参考に、データ活用を始めましょう:*チュートリアル:最初のテーブルを作成する* 「データとテーブルの扱い方」大学コース* 「アプリの完了とテーブル」の理解:Universityガイド* 外部システムとの連携
お探しの情報は見つかりましたか?
community.tulip.coにアクセスして、質問を投稿したり、他のユーザーが同様の質問を投稿していないか確認することもできます!
