

La acción de activador «Extraer texto de una imagen» extrae texto de una imagen basándose en una consulta. Otra forma de describirlo es «OCR (reconocimiento óptico de caracteres) basado en consultas» o «Extraer texto de una imagen solicitándolo».
El disparador siempre devolverá únicamente el texto que esté realmente presente en la imagen. No añadirá información adicional ni interpretaciones. Esto lo convierte en una herramienta muy potente para transferir datos del mundo físico al digital.
Ejemplos de casos de uso:
- Importar datos de un formulario de pedido procedente de un proveedor externo. Olvídate de transferir manualmente ese número de pedido de 14 caracteres de la factura de un proveedor a tu WMS; combina una aplicación sencilla con la acción «Extraer texto de una imagen» para obtener estos datos en segundos.
- Digitalizar formularios en papel. Los datos que contienen los formularios en papel existentes son aún más valiosos cuando se puede acceder a ellos desde las aplicaciones de Tulip. Las acciones de «Extraer texto de una imagen» son un mecanismo excelente para tender un puente entre el mundo físico y el digital.
- Trabaja con texto en idiomas desconocidos para tus operarios, de forma fiable. El mundo de la fabricación es global; dota a tus operarios de superpoderes combinando las acciones de activación «Extraer texto de una imagen» y «Traducir» para convertir la información en papel en algo sobre lo que tus operarios puedan actuar.
Ejemplo de activación
Utiliza una aplicación móvil para hacer una foto de la etiqueta de un producto y obtener el número de lote.
| Imagen | Desencadenante | Resultado |
|---|---|---|
| image.png{height="" width="400"} | image.png{height="" width="400"} | 11EP8F4WA58CCX |
Extraer valor de una imagen
Entradas y salidas
La acción de activación tiene dos entradas, «Imagen de entrada» y «Consulta», y una salida, el texto extraído.
Entrada: imagen de entrada
Se trata de la imagen de la que se debe extraer el texto. Puede proceder del widget de entrada de la cámara, de Tulip Vision o de sistemas externos.
| Tipo de datos admitido | |
|---|---|
| Entrada | URL de la imagen |
Entrada: consulta
Esta es la consulta que se utiliza para extraer el texto de la imagen o del documento.
Prácticas recomendadas para las consultas:* Siempre que sea posible, utiliza palabras del documento. Esto resulta especialmente útil para acrónimos y abreviaturas (p. ej., SN, ID, SSN, n.º de lote, etc.). Las acciones de activador «Extraer texto» admiten consultas menos complejas que las acciones de activador «Responder a una pregunta a partir de datos/documentos». * Ej. Entrada adecuada: «¿Quién es el proveedor?» * Ej. Entrada inadecuada: «¿Quién crees que nos podría haber enviado esto?»* Especificar la ubicación de la información también puede ayudar (p. ej., «¿Cuál es el número de referencia que aparece en la parte inferior?»).
| Tipos de datos admitidos | |
|---|---|
| Entrada | Texto |
Salida: texto extraído
Este es el texto que se ha extraído de la imagen en función de la consulta.
| Tipo de datos admitido | |
|---|---|
| Salida | Texto |
Extraer valores de una imagen o documento
Extracting values from documents is a relatively slow operation. We limit documents to 10 pages to limit execution time.
La función «Extraer valores de una imagen o documento» funciona igual que «Extraer valor de una imagen», pero admite una serie de preguntas. Esto ofrece un rendimiento significativamente mayor que ejecutar la acción de activador «Extraer valor de una imagen».
Entrada: imagen o documento de entrada
Esta es la imagen de la que se debe extraer el texto. Puede proceder del widget de entrada de cámara, de Tulip Vision o de sistemas externos. En el caso de los archivos, se puede establecer de forma estática, introducir mediante el widget de entrada de archivos o hacer referencia a archivos almacenados en Tables.
| Tipos de datos admitidos | |
|---|---|
| Entrada | URL de la imagen |
Entrada: consulta
Esta es la consulta que se utiliza para extraer el texto de la imagen. Debe ser una matriz o lista de valores de texto.
| Tipo de datos admitido | |
|---|---|
| Entrada | Lista de texto |
Salida: texto extraído
Este es el texto que se ha extraído de la imagen en función de la consulta.
| Tipo de datos admitido | |
|---|---|
| Salida | Matriz de objetos. Cada elemento tendrá un atributo «Pregunta» y otro «Respuesta». |
Extraer todo el texto de una imagen o documento
En algunos casos, el paradigma clave:valor de las acciones de activación de extracción de valores no tiene sentido para tu caso de uso. Leer todos los datos de una imagen ofrece una flexibilidad casi infinita a la hora de abordar los problemas que puede resolver Copilot. Las acciones de activación «Extraer todo el texto» te proporcionan esta flexibilidad.
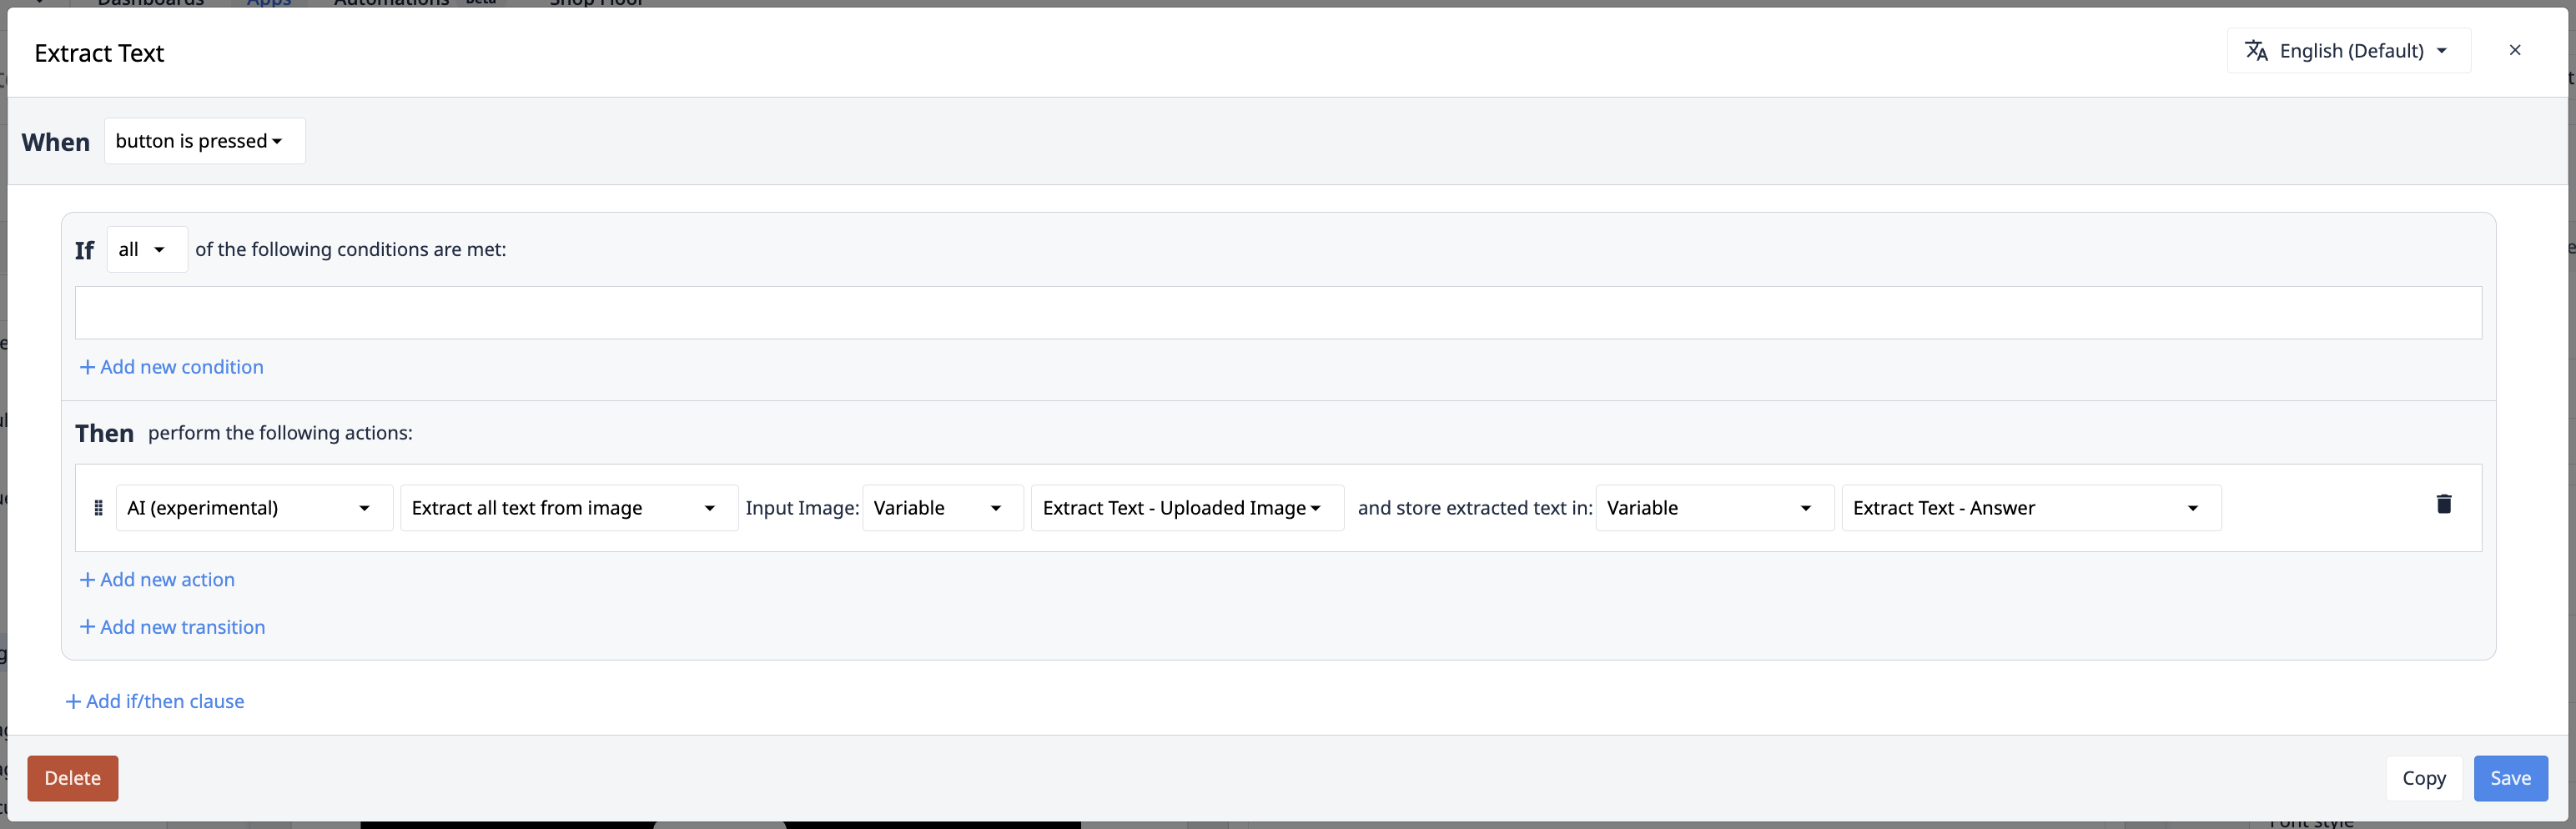
Entrada: imagen o documento de entrada
Esta es la imagen de la que se debe extraer el texto. Puede proceder del widget de entrada de la cámara, de Tulip Vision o de sistemas externos. En el caso de los archivos, se puede establecer de forma estática, introducir mediante el widget de entrada de archivos o hacer referencia a archivos almacenados en Tables.
| Tipo de datos admitido | |
|---|---|
| Entrada | URL de imagen o URL de archivo |
Salida: texto extraído
Se trata de todo el texto que se encuentra en la imagen o documento correspondiente. Los documentos devolverán una matriz de datos, en la que cada elemento representa el texto de una página del documento proporcionado.
| Tipo de datos admitido | |
|---|---|
| Salida | (para imágenes) Texto. (para documentos) Lista de texto |
Casos extremos
No se ha proporcionado ninguna imagen de entrada ni ninguna consulta
Si no se proporciona ninguna imagen de entrada o ninguna consulta a la acción desencadenante, la aplicación mostrará el siguiente error del sistema:«Tu entrada o consulta está vacía»
Esto ocurre en todos los casos siguientes:* A la imagen de entrada y/o a la consulta no se les ha asignado ningún valor. Esto equivale a «nulo».* A la consulta se le ha asignado una cadena vacía.
No hay resultados para la consulta
Si no se ha podido encontrar ningún resultado para la consulta, la acción desencadenante devolverá un texto vacío.
Límites
The following languages are the only ones supported for documents where values are being extracted: English, Spanish, Italian, Portuguese, French, German.
Estos límites se controlan a nivel de Instance. En caso de que se superen estos límites, la acción desencadenante «Extraer texto de la imagen» fallará.
Existen los siguientes límites para los desencadenadores «Extraer texto de imagen»:
| Límite | |
|---|---|
| Tamaño de la imagen | 5 MB |
| Límite mensual | 10 000 solicitudes al mes |
| Límite de frecuencia | 10 solicitudes por minuto |
| Número de valores extraídos | 15 valores extraídos por acción |
Para conocer otros límites, incluido el uso de la cuenta, consulta la sección «Uso y precios de Tulip AI».
{{snippet.¿Has encontrado lo que buscabas?}}