

Ismerje meg, hogyan lehet strukturálni a HTTP-csatlakozó kimeneteit.
Áttekintés
A Tulip csatlakozófunkció-szerkesztője lehetővé teszi a csatlakozófunkciók által visszaadott adatok olyan strukturálását, hogy azok hasznosak és felhasználhatók legyenek az alkalmazásokon belül. Ebben a cikkben áttekintjük a csatlakozófunkció Output kimeneteinek formázásának alapjait, bemutatva a következőket:
- A csatlakozó kimenetének fogalma
- A kimenetek formázásához rendelkezésre álló eszközök
- Különböző általános kimeneti formátumok
Mik azok a kimenetek?
A kimenetek a csatlakozófüggvény által visszaadott eredmények meghatározására és strukturálására szolgálnak. Segítségükkel vonhatja ki az alkalmazásai számára fontos információkat egy nagyobb HTTP-visszatérési testből.
A kimenetek strukturálása
Keresse meg a Kimenetek részt a csatlakozófüggvény-szerkesztő bal alsó sarkában.
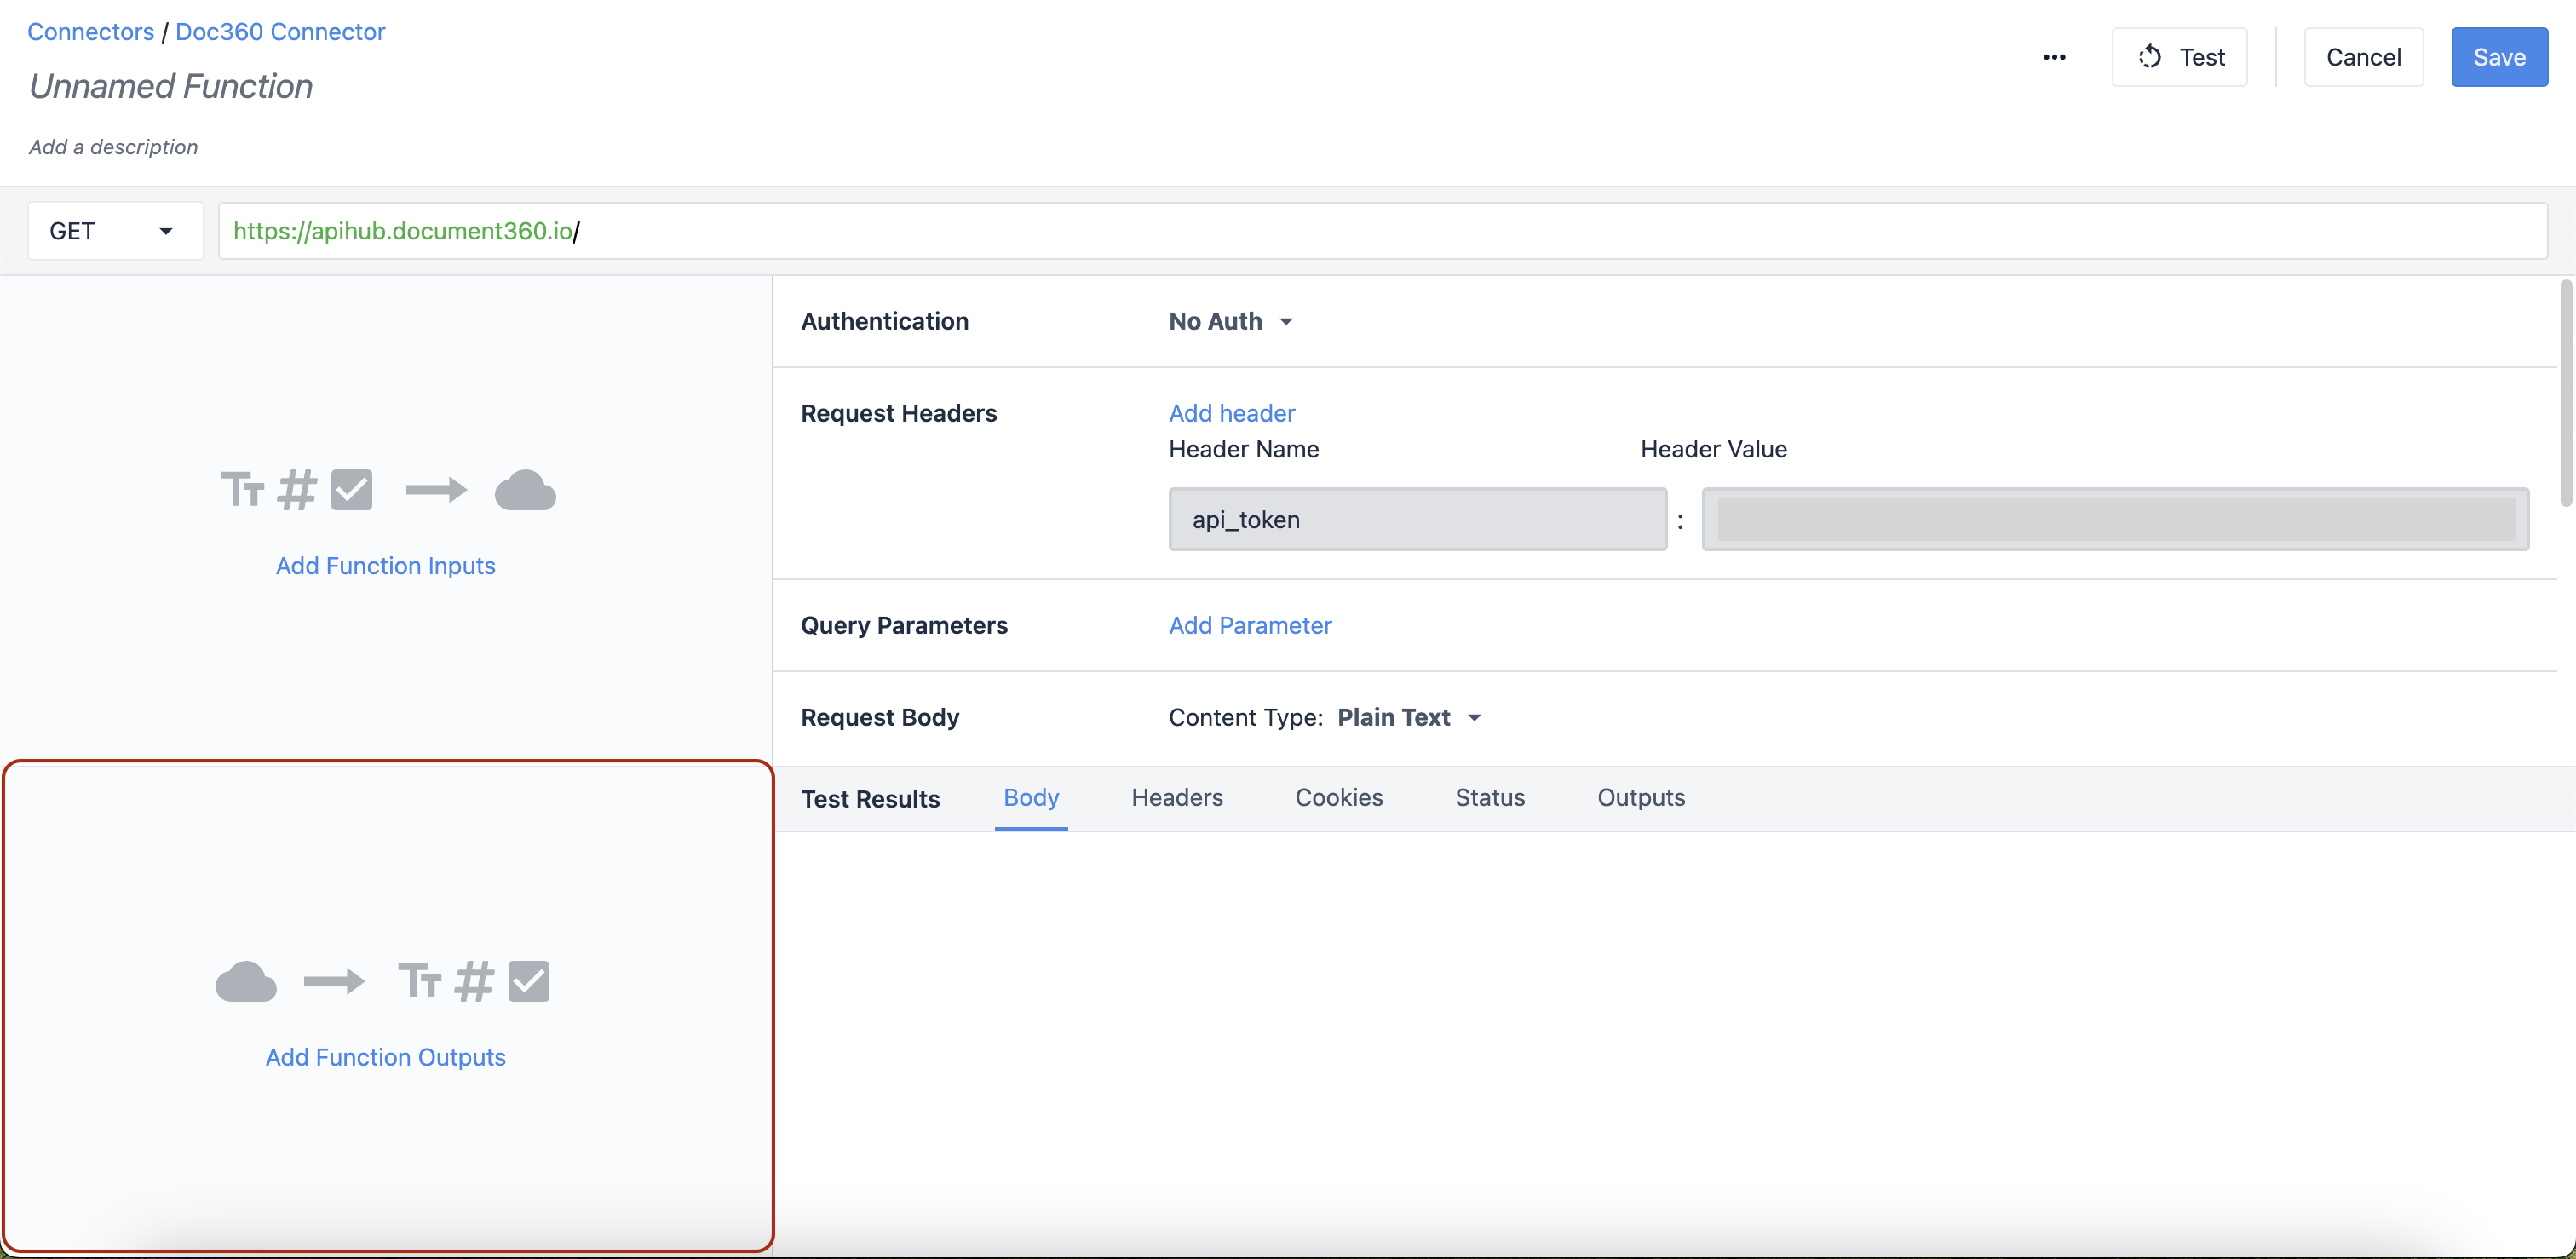
A kimenetek hozzáadásához kattintson a „Funkciókimenetek hozzáadása” gombra.
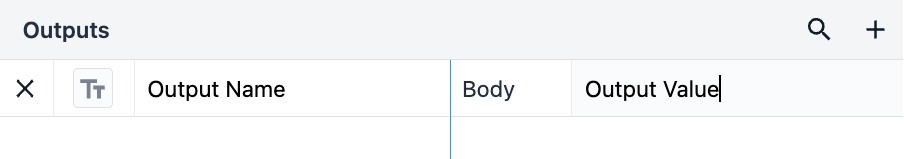
Jó gyakorlat, ha a kimeneteket egy könnyen azonosítható címkével látja el. Ezek a nevek az alkalmazásokban változóként jelennek meg, ezért fontos, hogy meg lehessen őket különböztetni.
Ahhoz, hogy megértsük egy HTTP-kérés eredményeit, először meg kell ismernünk a „Teszt eredmények” részben visszaküldött objektum felépítését. Az alábbi ábra szemlélteti, hogyan oszlanak az eredmények „Objektumok” és „Tömbök” szakaszokra.
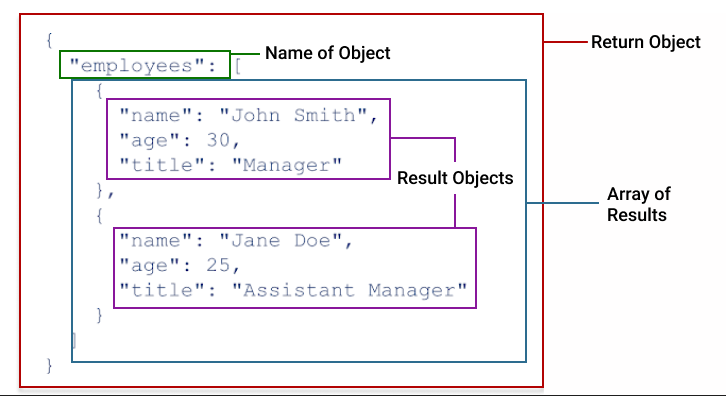
If you haven’t worked with JSON before, you may be unfamiliar with two critical datatypes, objects and arrays. Arrays are lists of values of the same type. For example, [1,2,3,5], or [oak, elm, alder, hickory]. Values in arrays are contained within square brackets, [ ]. Objects are a datatype for holding key:value pairs. The key:value pairs within an object can be of multiple different types, including arrays and nested objects. Objects are contained with curly brackets, { }.
Az objektumokról és tömbökről további információkat a „Tömbök és objektumok megértése a csatlakozófüggvény kimeneteiben” című cikkben talál.
Pontos jelölés
Az HTTP-csatlakozók esetében a kimenetek a nevű formátumot használják. A pontos jelölés lehetővé teszi az objektumon belüli értékek elérését. A pontjelölés hasznos, ha csak a szükséges adatokat szeretné kinyerni egy nagy JSON válasz testéből, és nagyobb rugalmasságot biztosít az HTTP-csatlakozó függvények formázásában. Egyszerűen fogalmazva: ez egy strukturált formátum, amely egymásba ágyazott értékeken alapul.
Nézzünk meg egy példát arra, hogyan használják a pontjelölést a csatlakozók kimeneteiben.
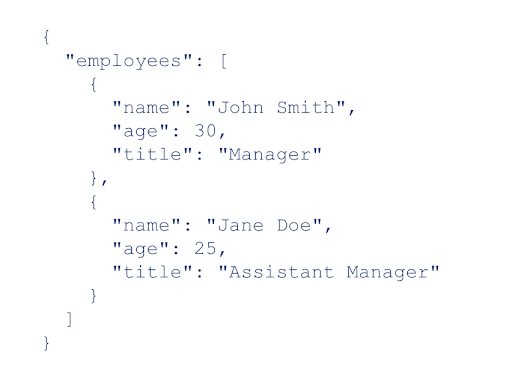
A következő „employees” nevű példaobjektum egy objektumtömböt tartalmaz, amely az egyes alkalmazottak adatait tartalmazza. Ha csak az egyes alkalmazottak beosztásához szeretnénk hozzáférni, a következő szintaxist használnánk: employees.title. Pontot használunk ahhoz, hogy hozzáférjünk az érdeklődésünk tárgyát képező kulcsokhoz tartozó értékekhez. Tegyük fel, hogy csak az első eredményt szeretnénk lekérni. Ezt úgy adnánk meg, hogy a fő objektum („employees”) neve és a minket érdeklő érték („title”) közé beillesztenénk az indexpozíciót. A szintaxis így nézne ki: employees.0.title. Bonyolultabb objektumok esetén előfordulhat, hogy mélyebbre kell hatolni az objektumban a kívánt információk lekéréséhez.
Vegyünk egy másik példát, hogy még egy lépéssel továbbmenjünk. Tegyük fel, hogy egy csatlakozó függvényt szeretnénk létrehozni a Tudásbázisban található cikkekhez kapcsolódó információk lekérésére. A csatlakozónk a következő „data” nevű JSON-objektumot adja vissza, amely egy adott cikkre vonatkozó adatokat tartalmaz:
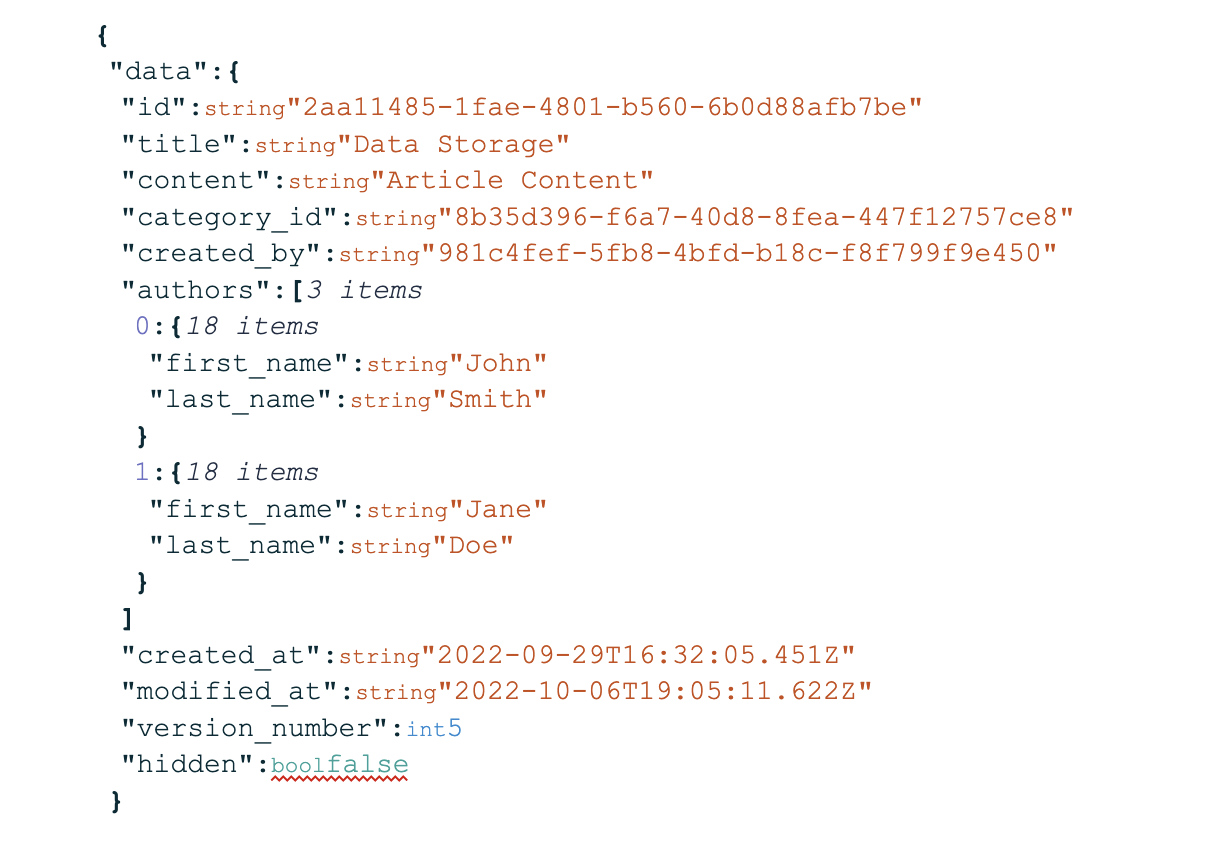
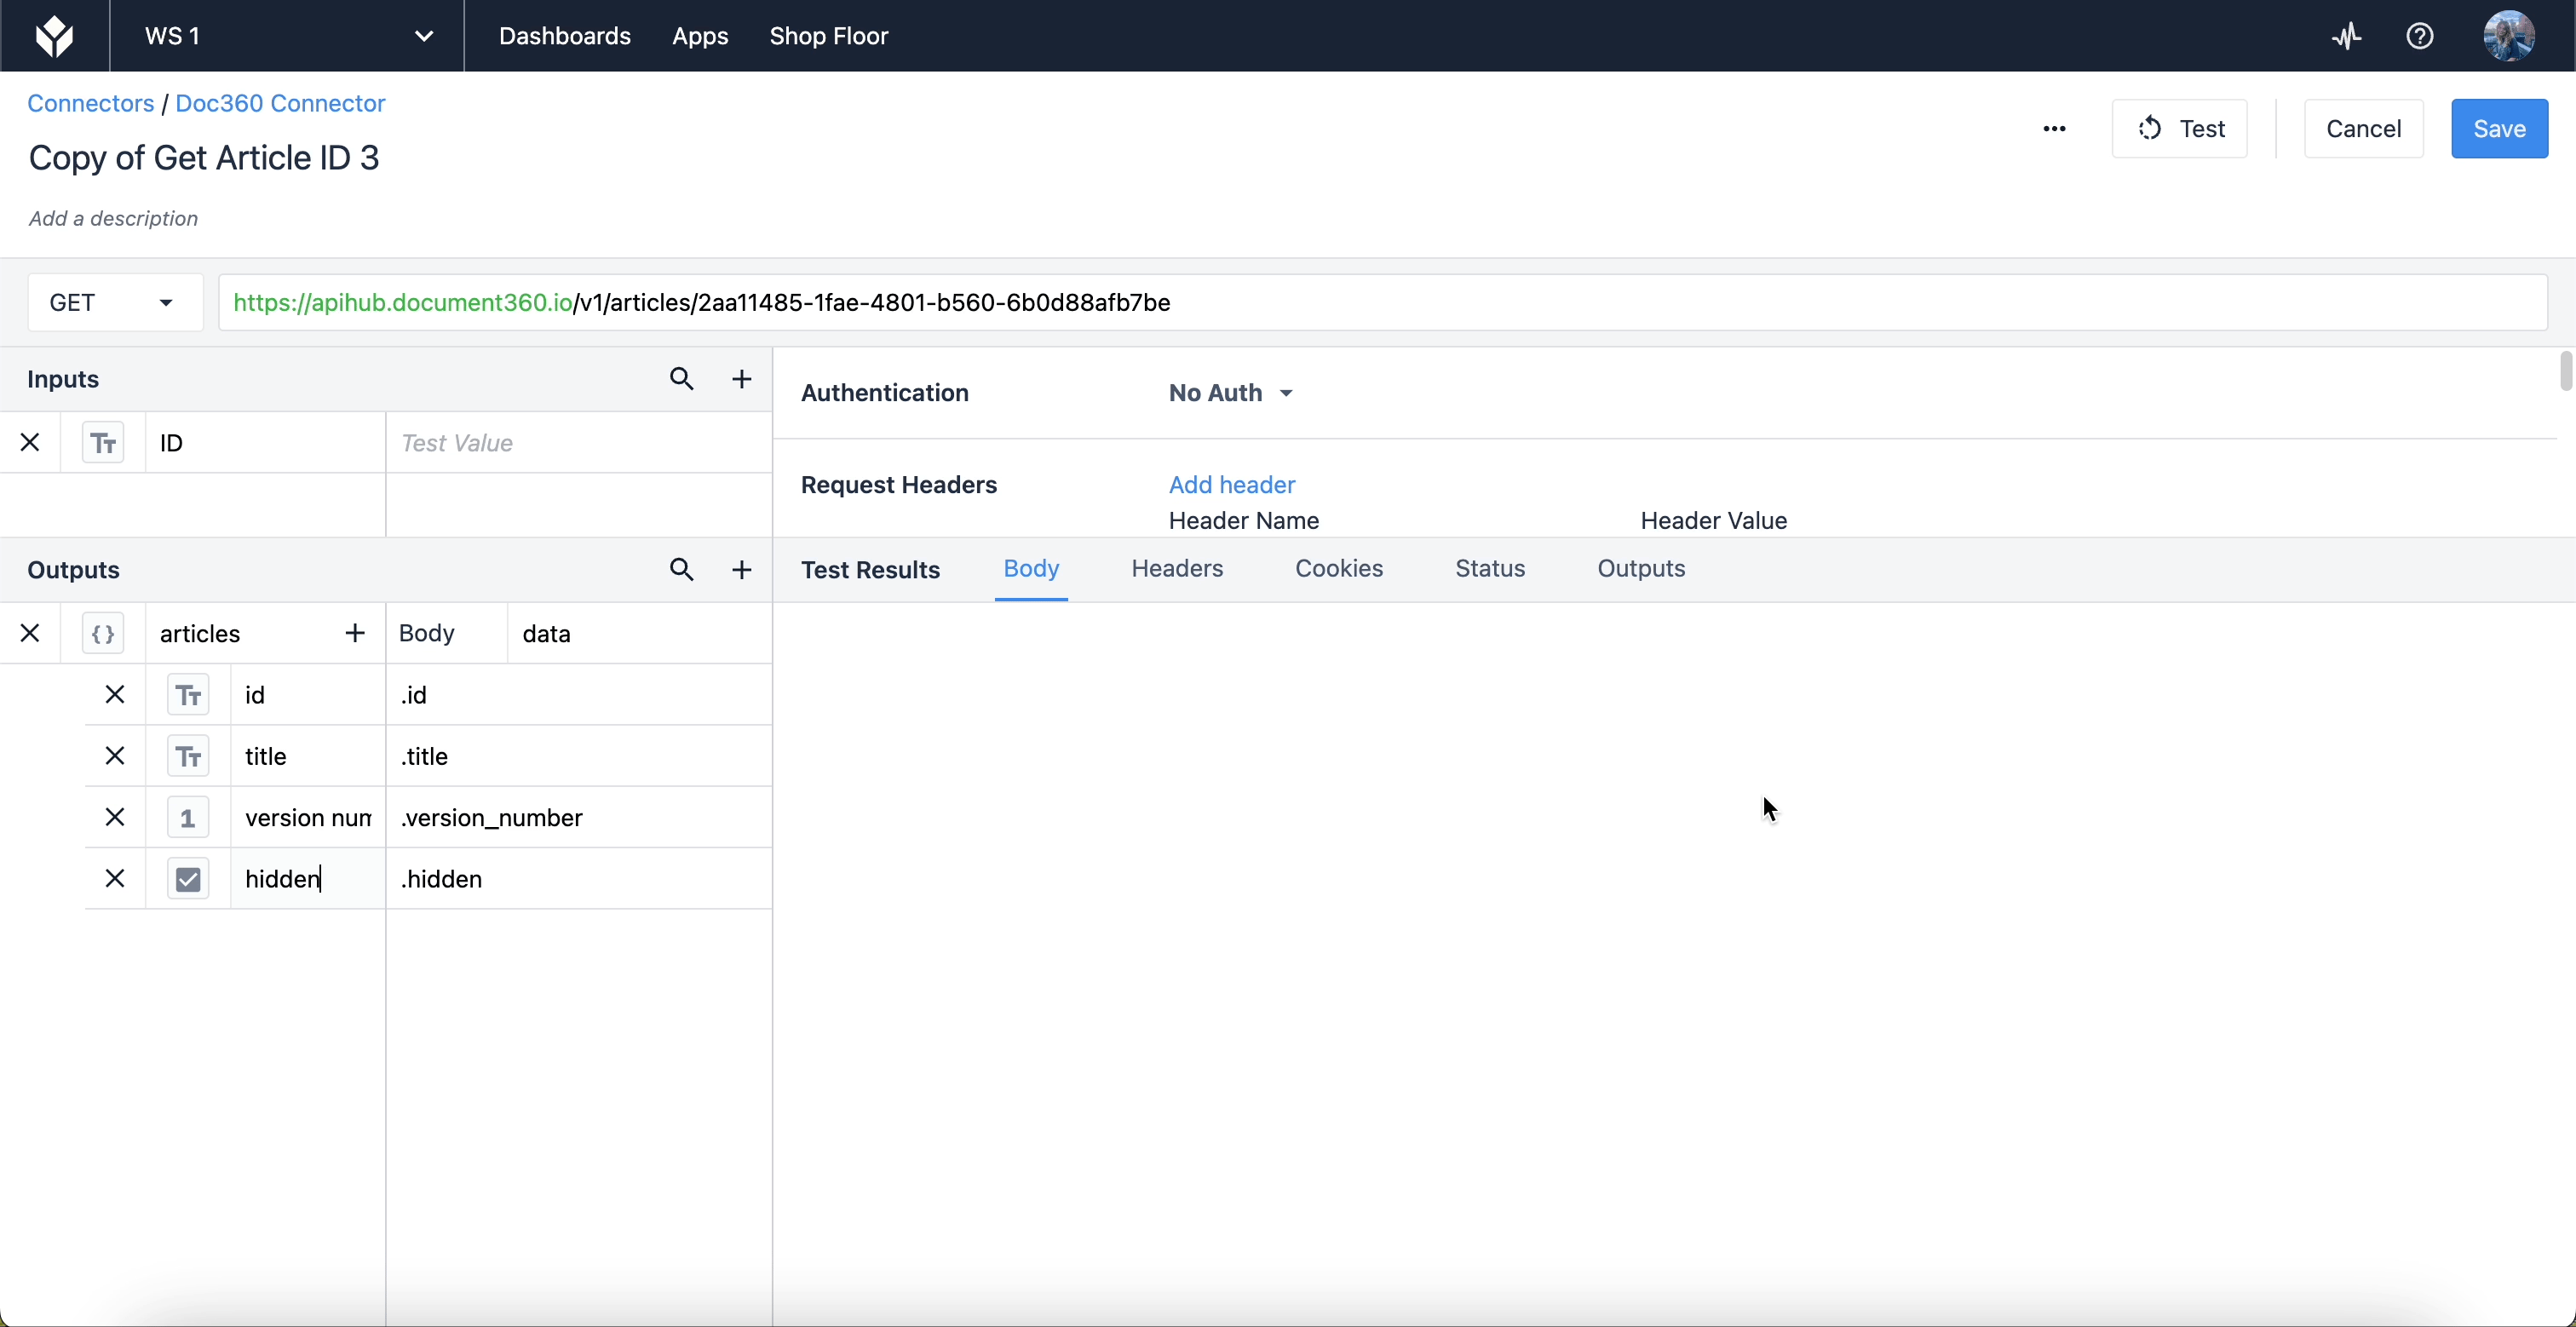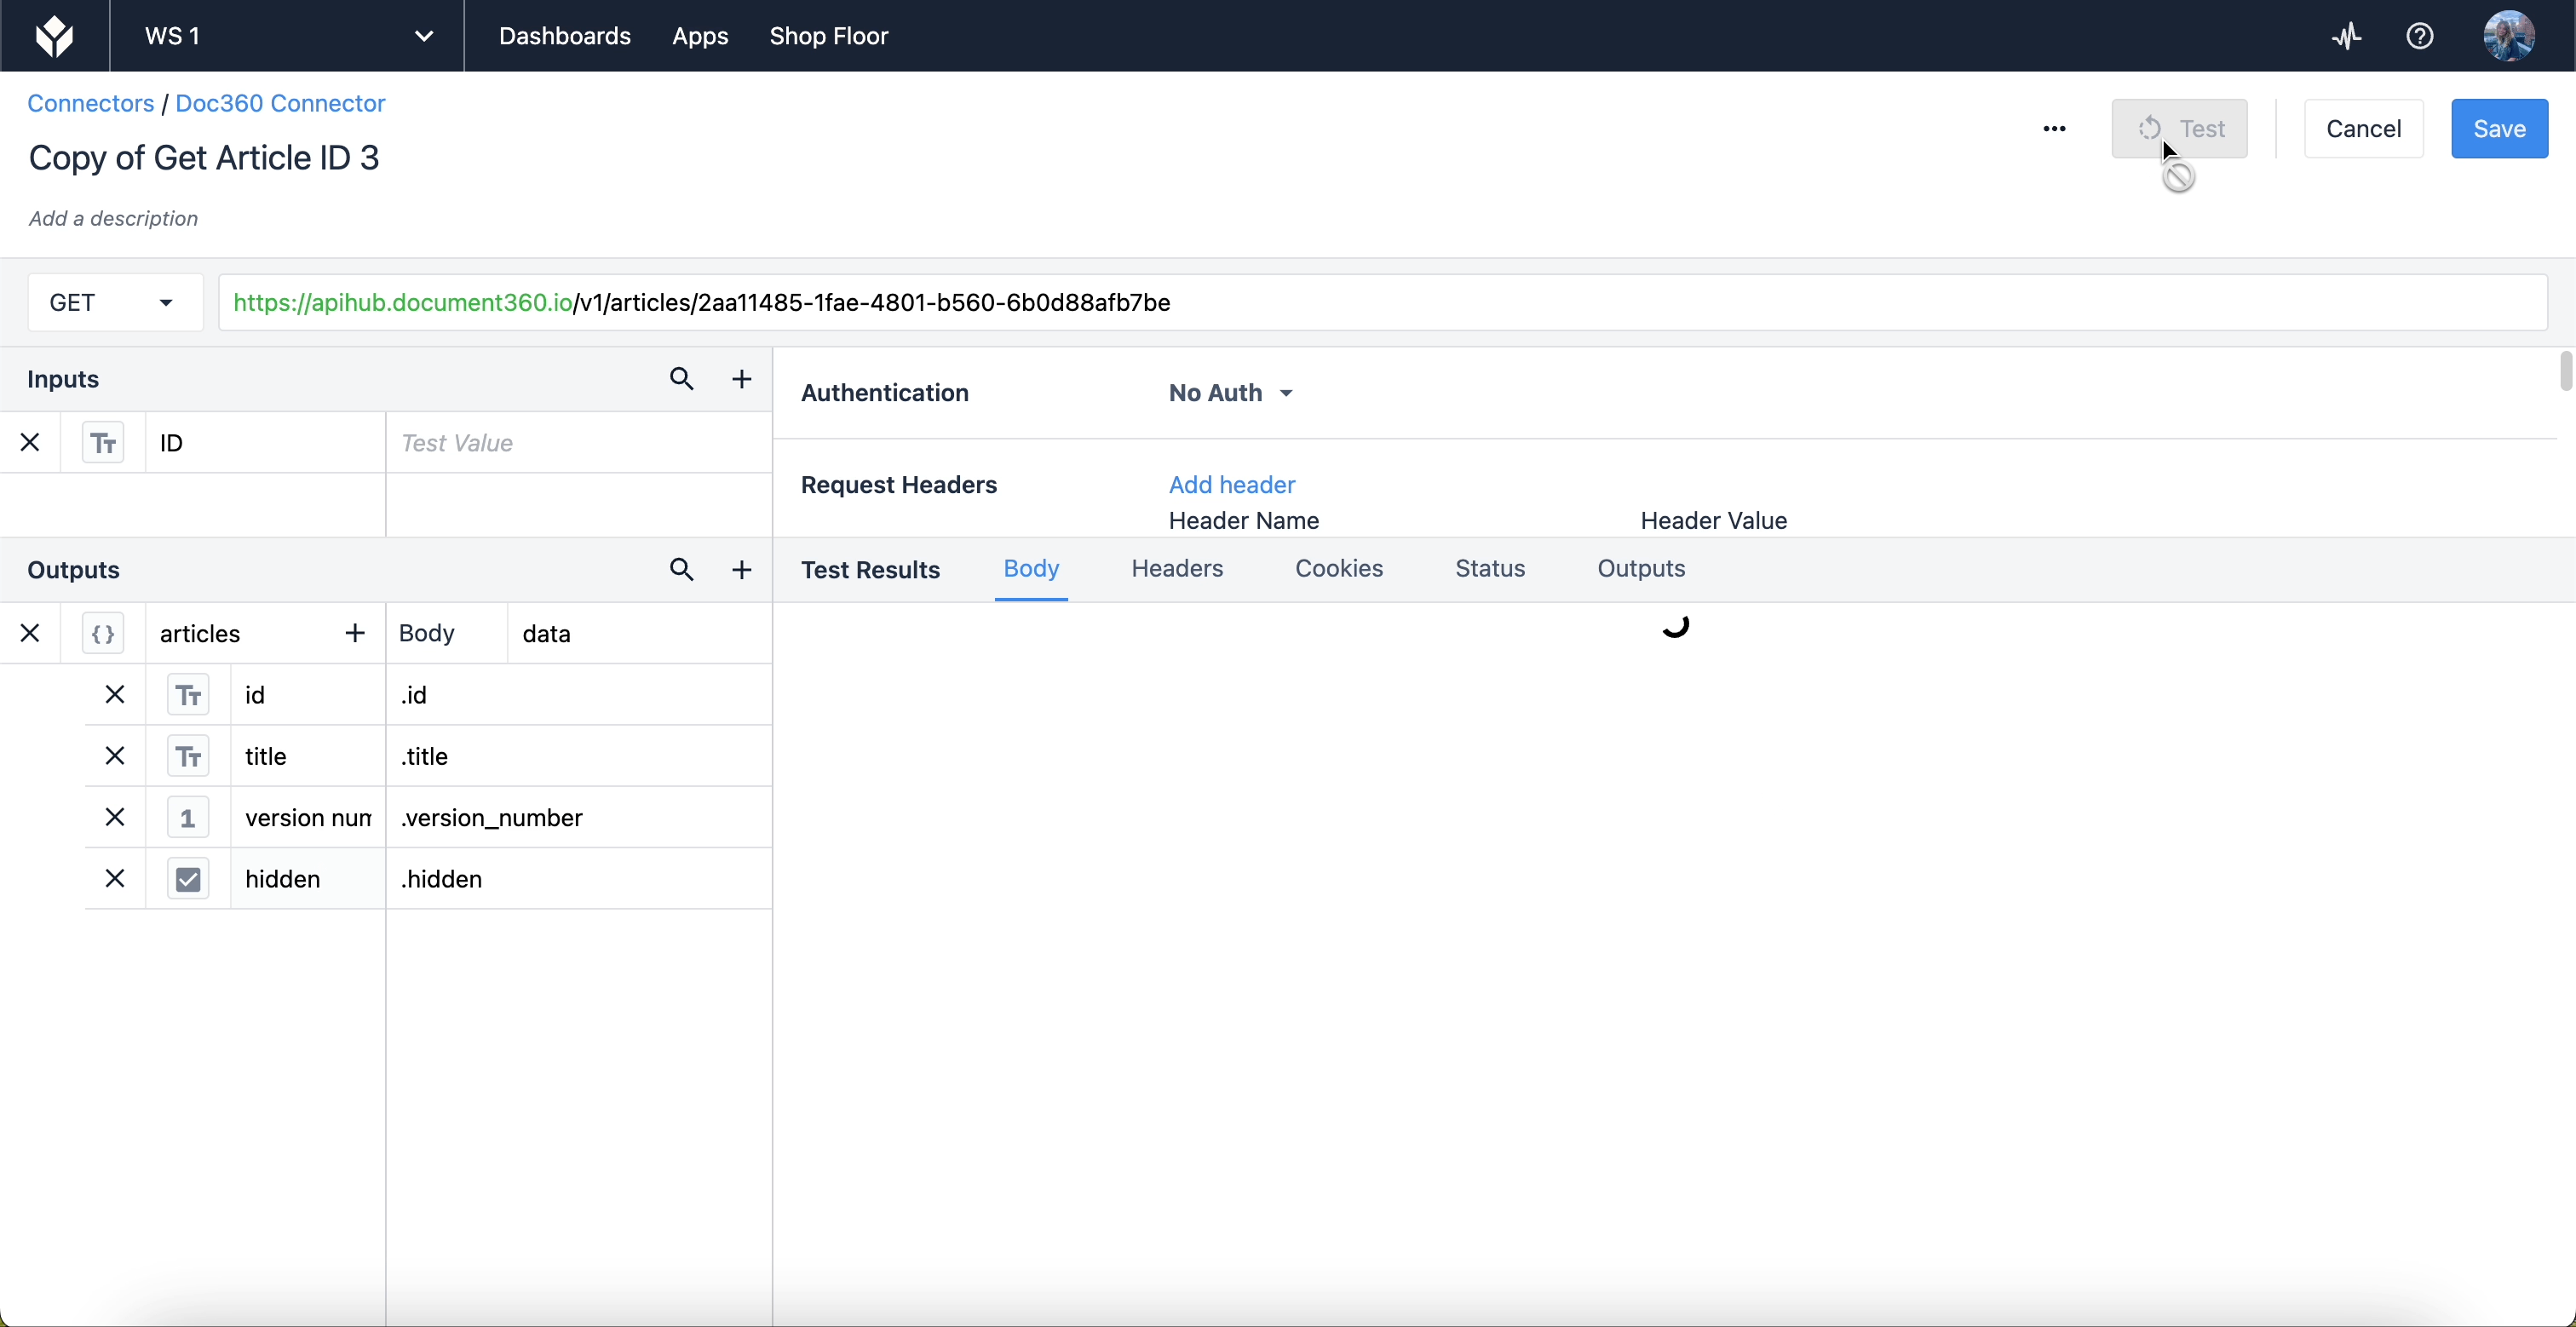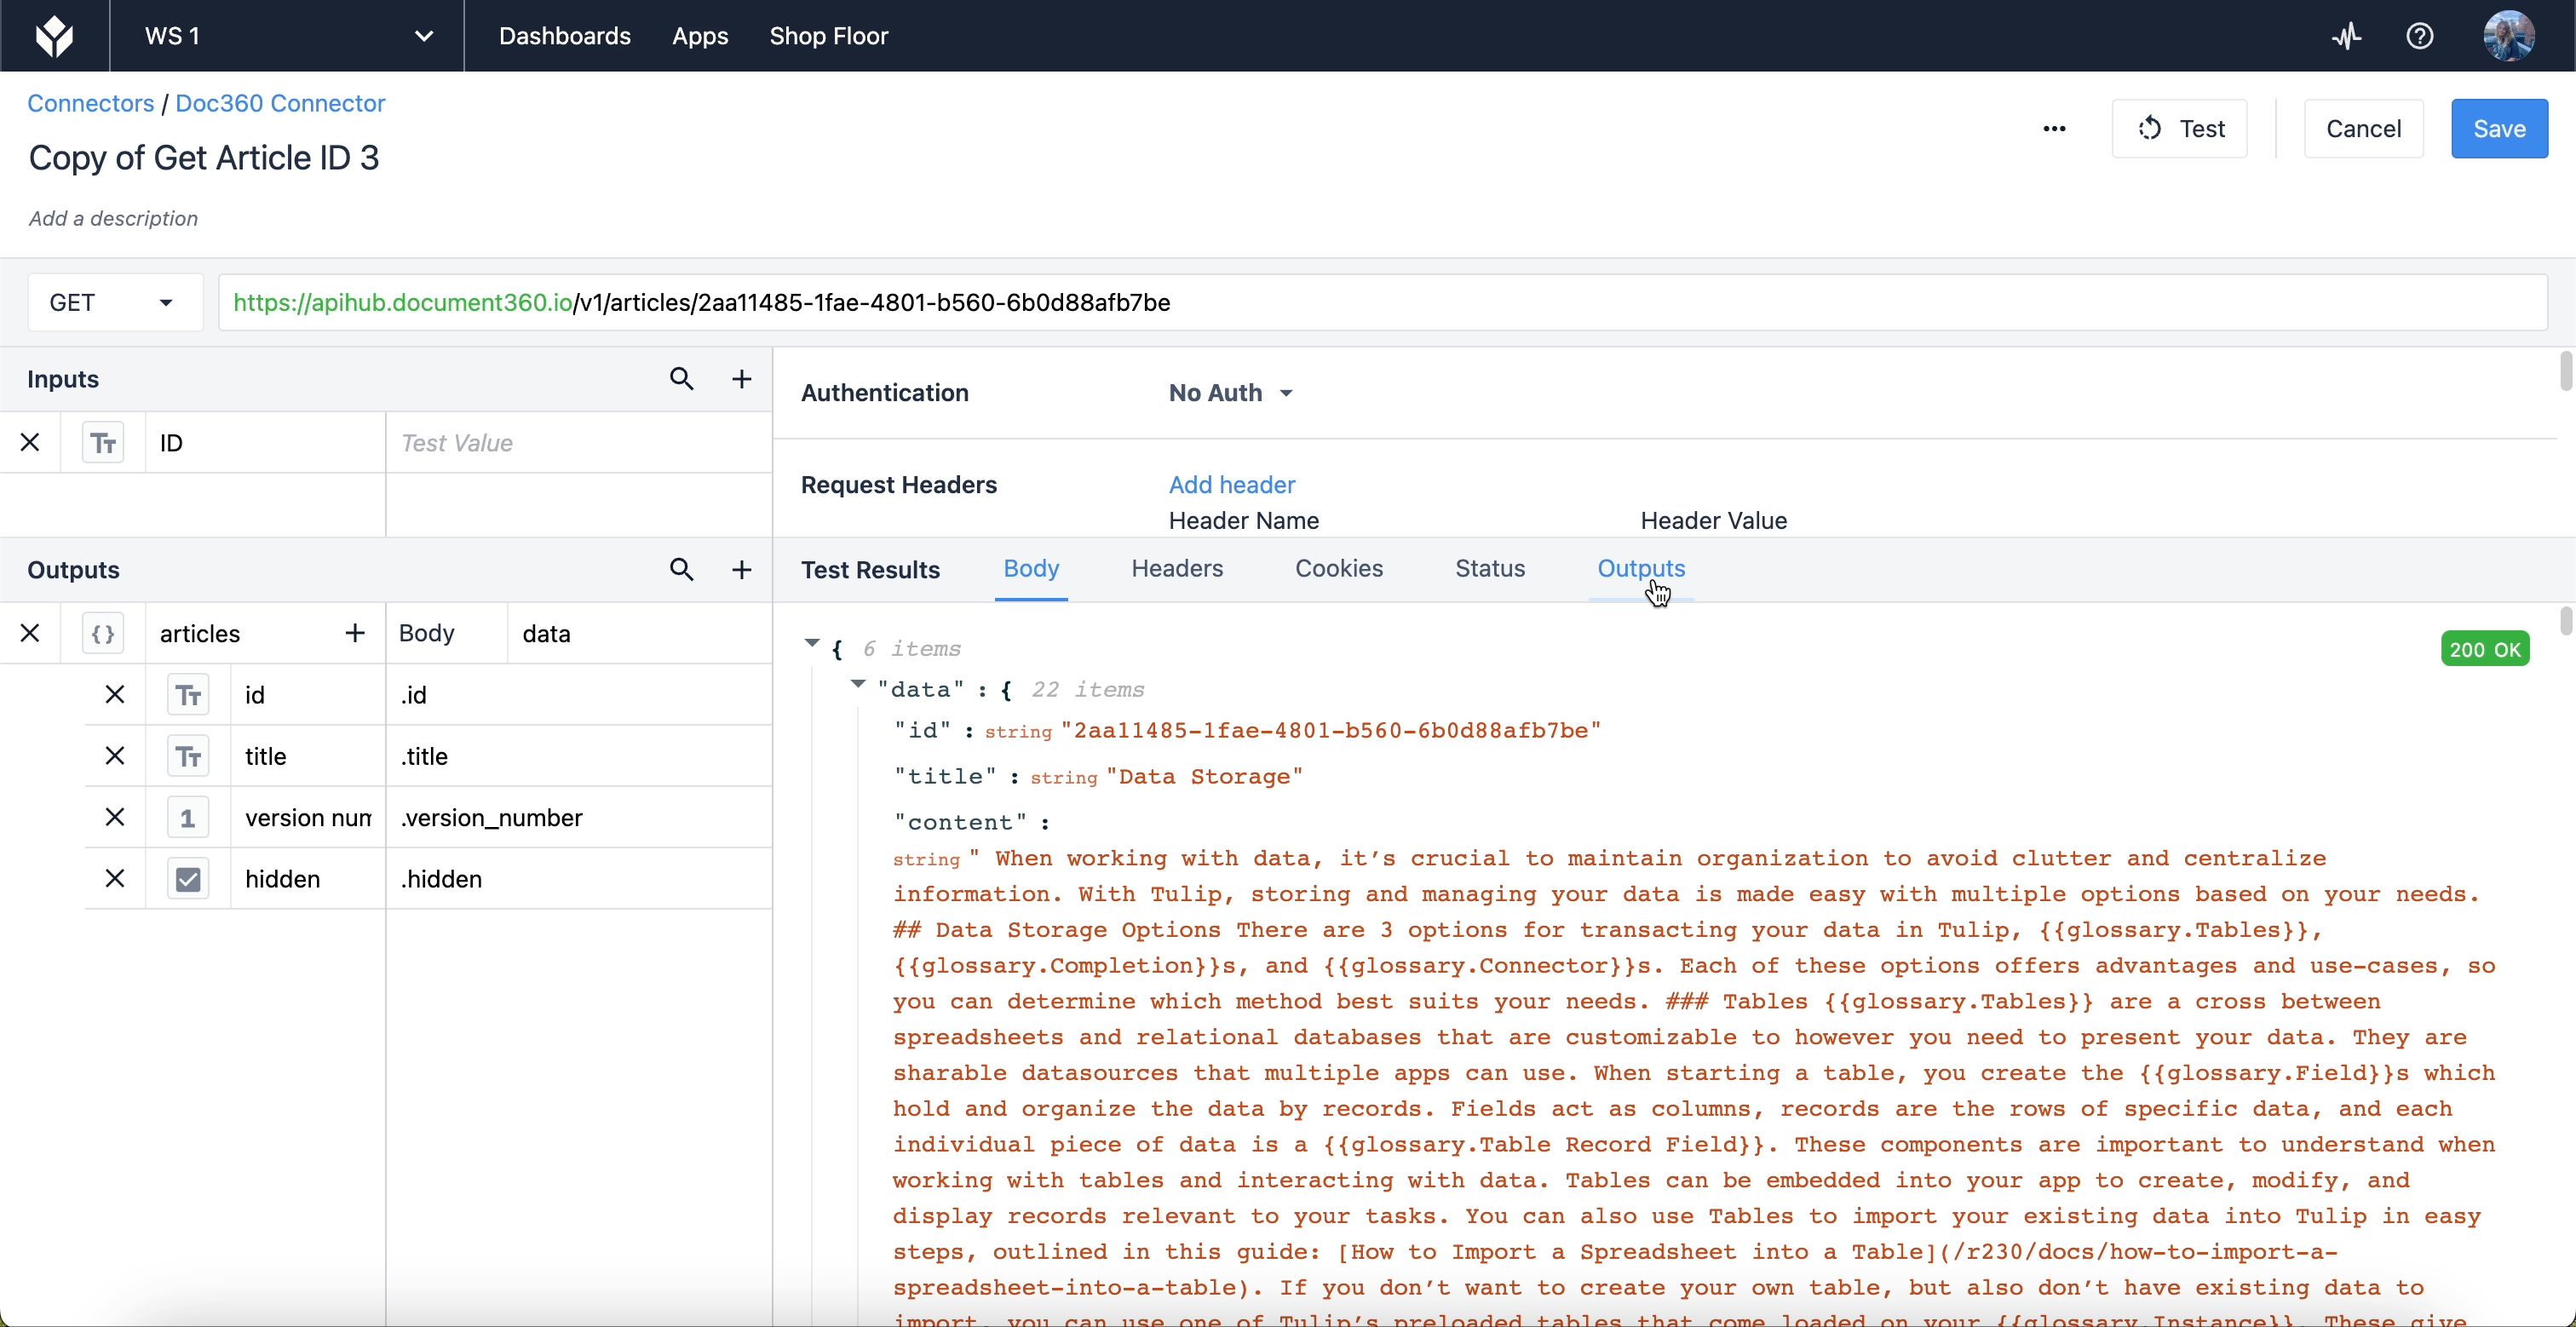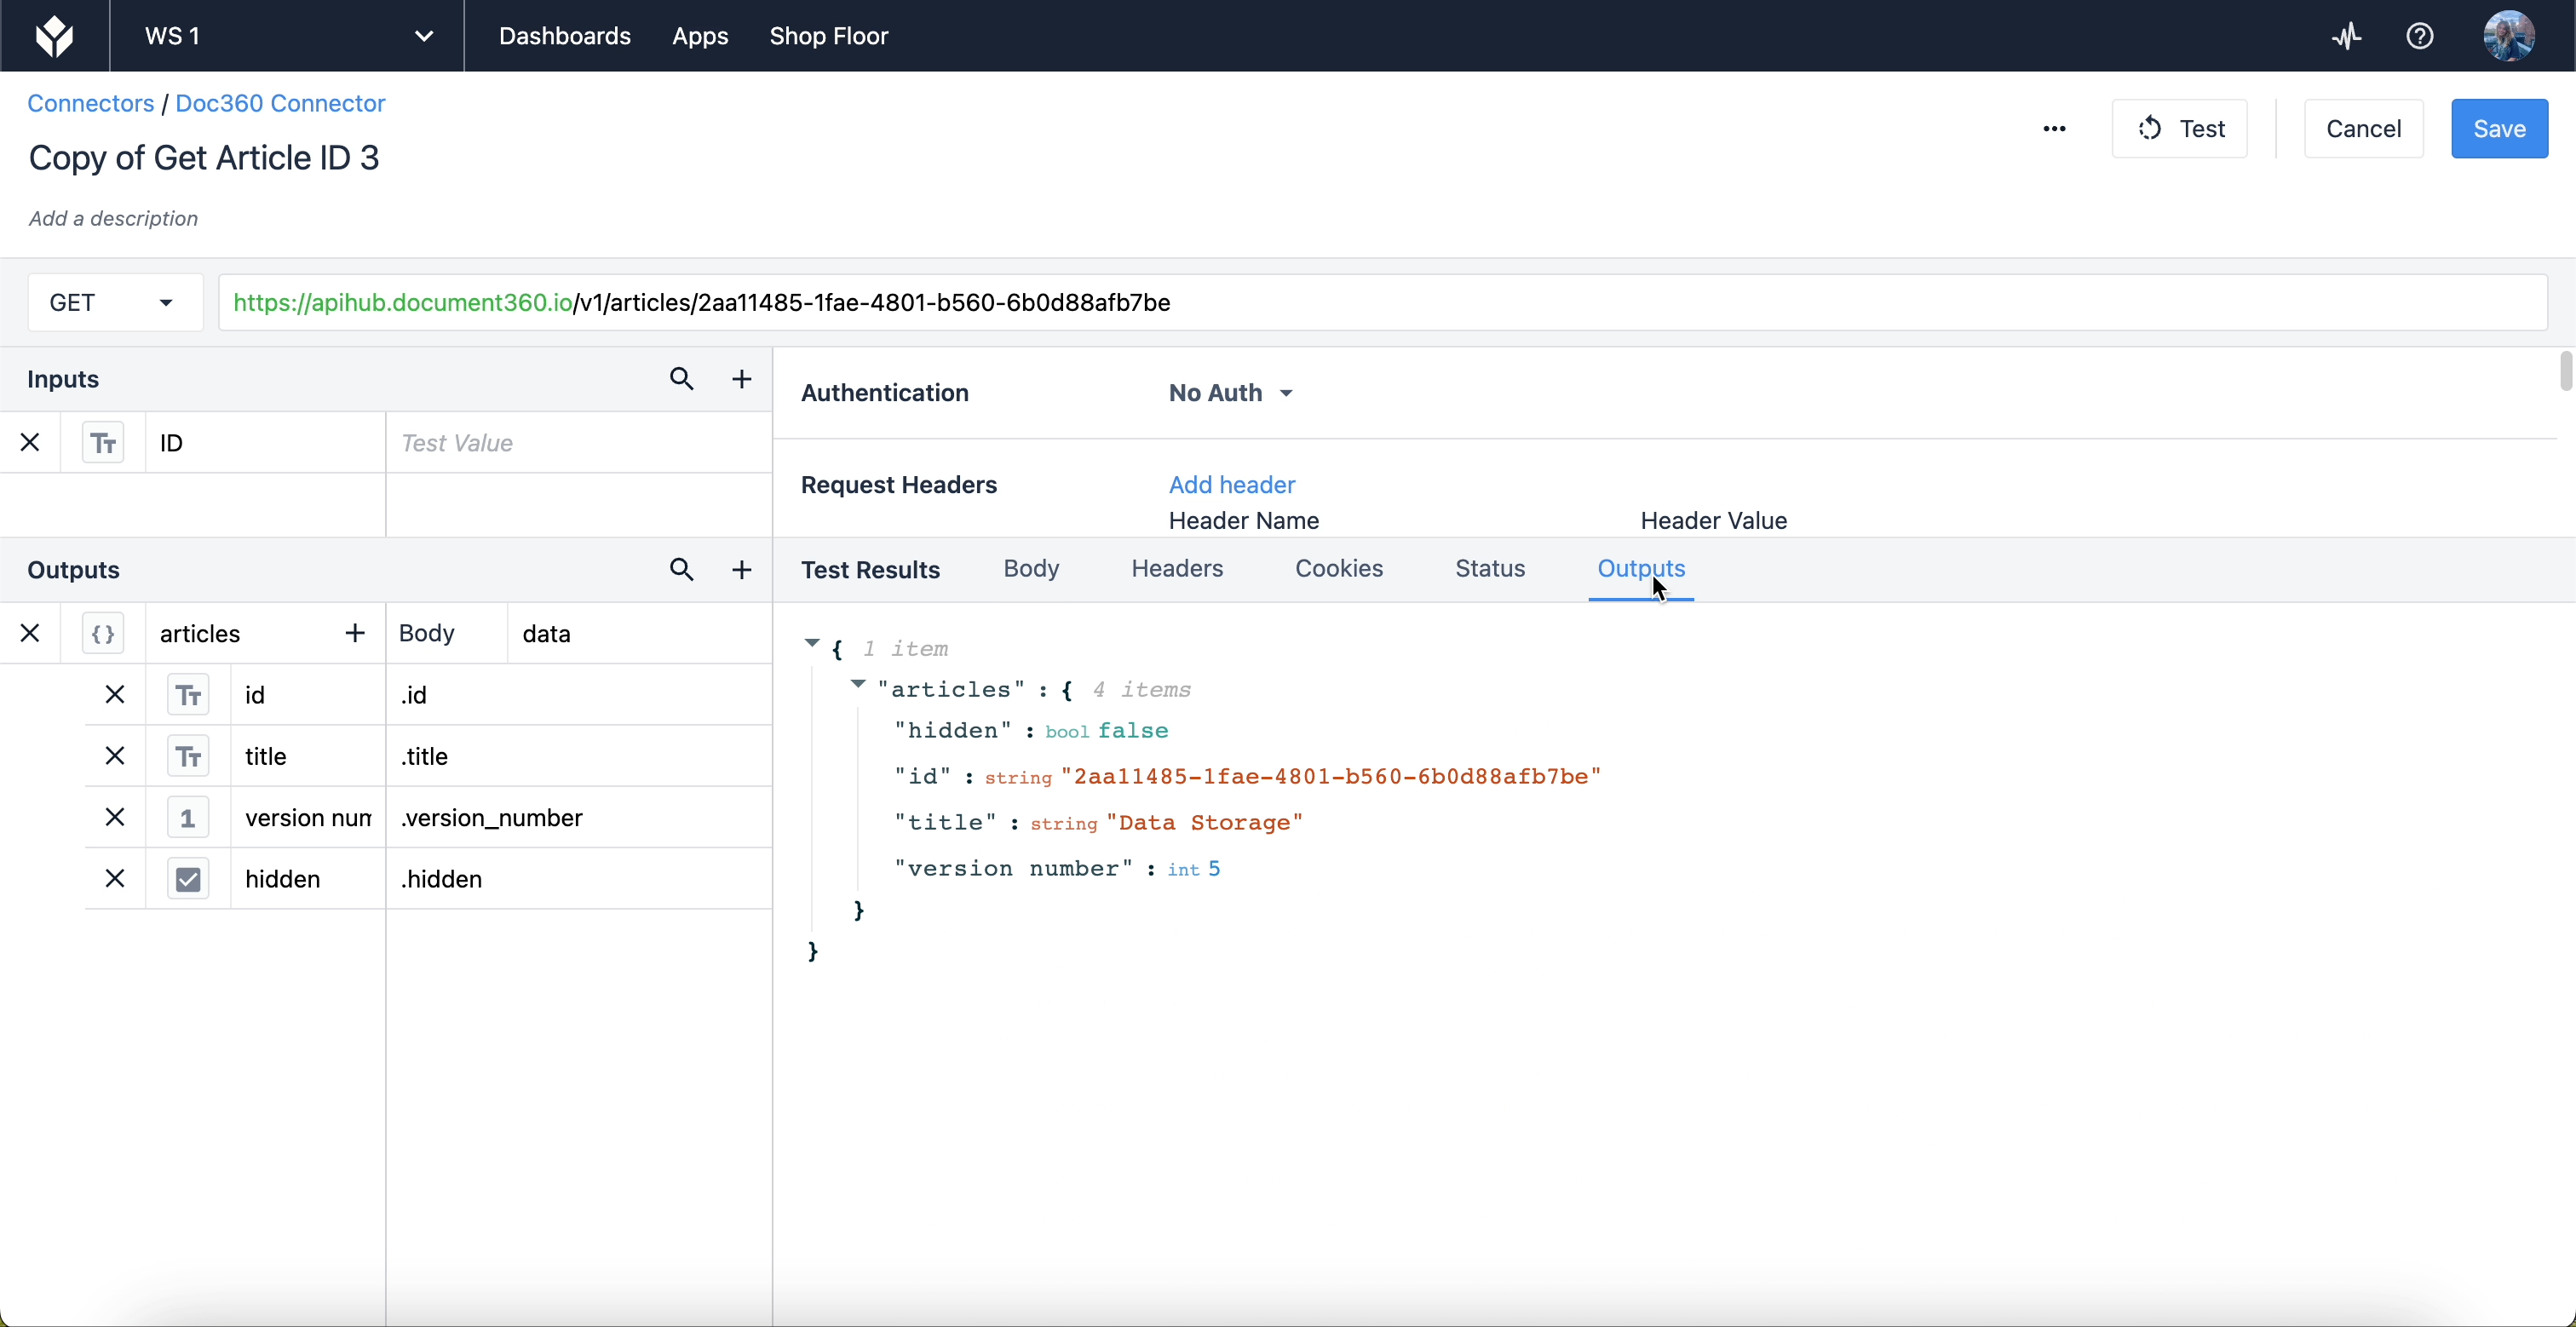
Ha például csak az azonosítót, a címet, a verziót és azt szeretnénk lekérni, hogy a cikk rejtett-e vagy sem, ezt az outputs segítségével kell megadnunk. Mutassuk be, hogyan néz ki a pontjelölés a szerkesztő outputs szakaszában:
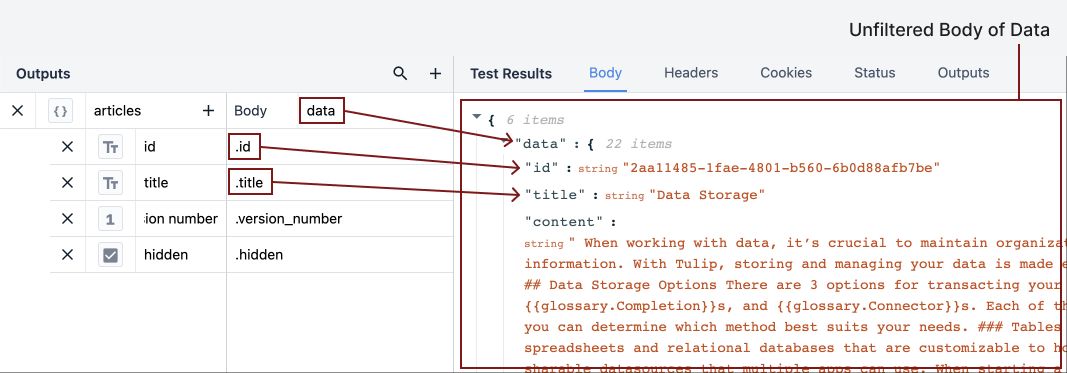
Ahhoz, hogy olyan eredményeket vonjunk ki, mint az „id” és a „title”, meg kell adnunk, hogy ezek az eredmények hol találhatók a JSON-on belül. A kimenet törzse a „data”, amely a Teszt eredmények szakasz első legördülő menüjének felel meg. A „data” legördülő menüben szereplő minden eredmény ebbe az objektumba van beágyazva. A Kimenetek szakaszban a pont azt jelenti, hogy egy réteggel mélyebbre lépünk a „data” objektumban.
It doesn’t matter whether the dot is placed in the body, or in front of individual properties, so long as there is a dot separating each layer of the JSON.
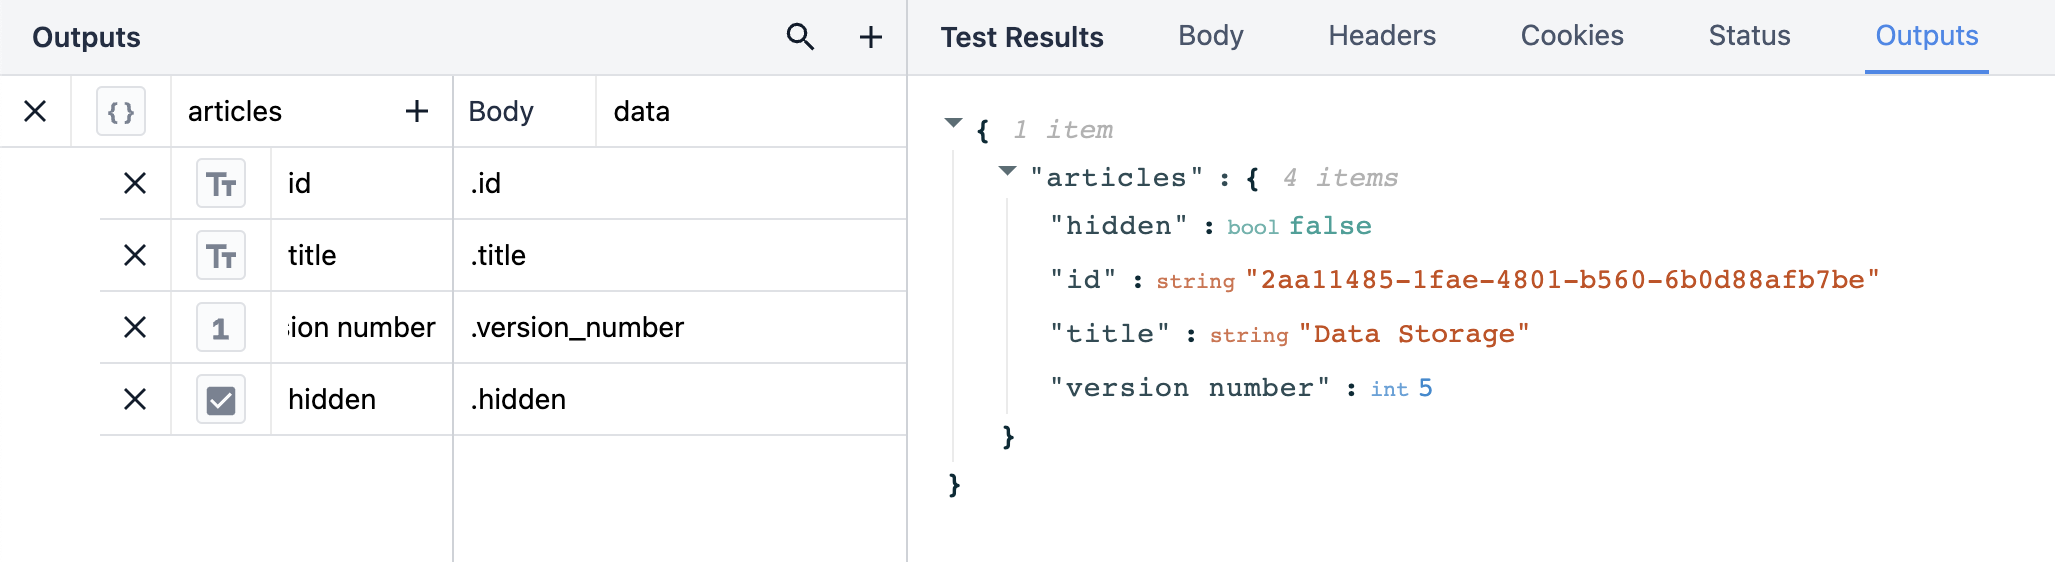
Amikor a „Teszt eredmények ” szakaszban a „Kimenetek” fülre kattintunk, a kimenetek kiszűrik a többi adatot, így csak azokat az információkat látjuk, amelyek érdekelnek minket.
A kimenetek megírásának egy másik módja az egy soros írás. Ez egy lekérdezésben mutatja a teljes útvonalat.
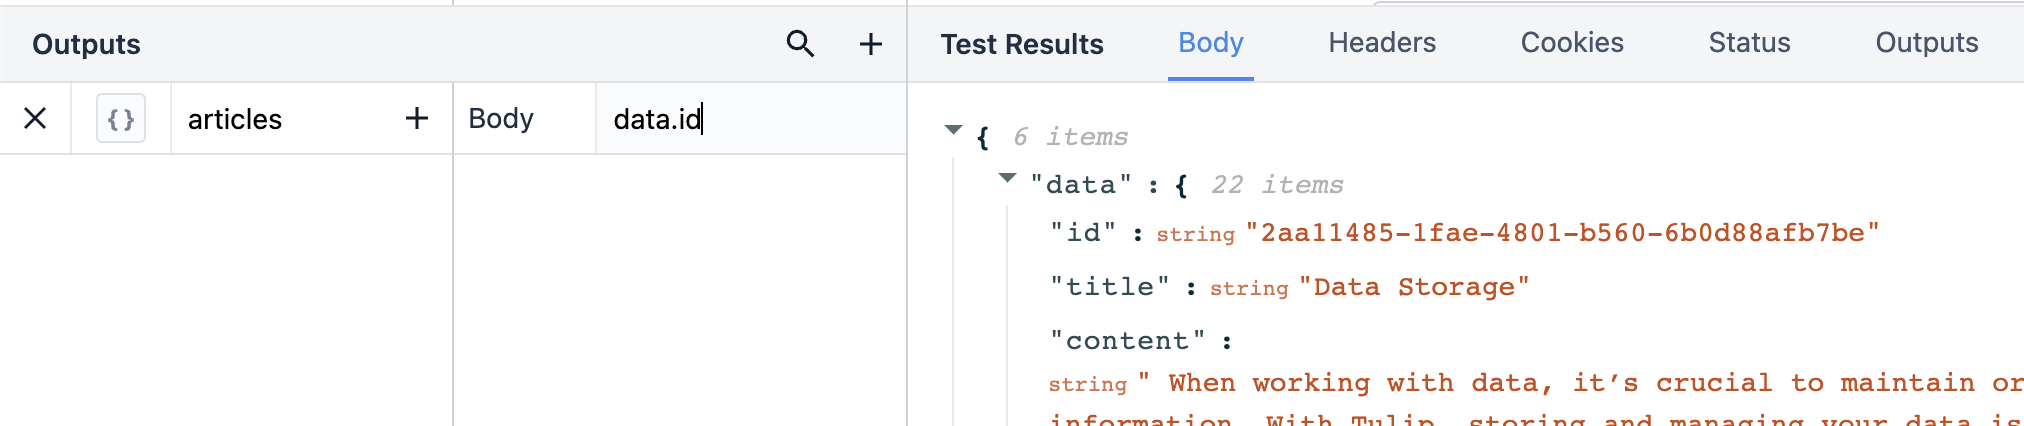
A kimeneti útvonal megírásának egyszerű trükkje, hogy rákattinthatunk egy adatsorra, és így új kimenetként hozzáadhatjuk azt.
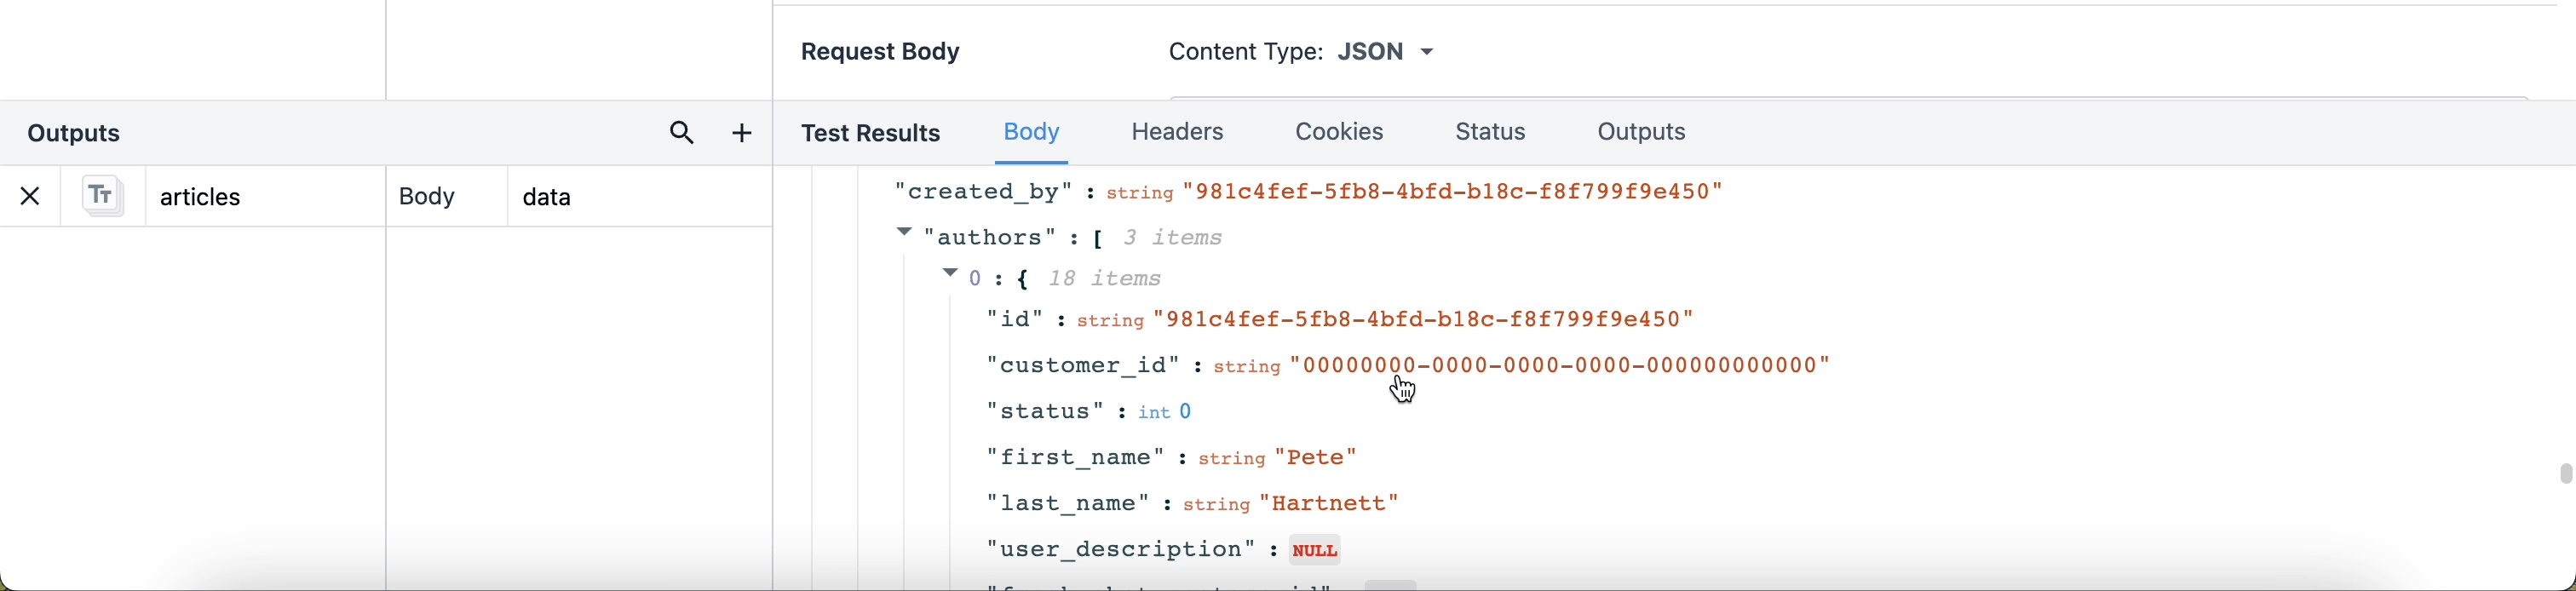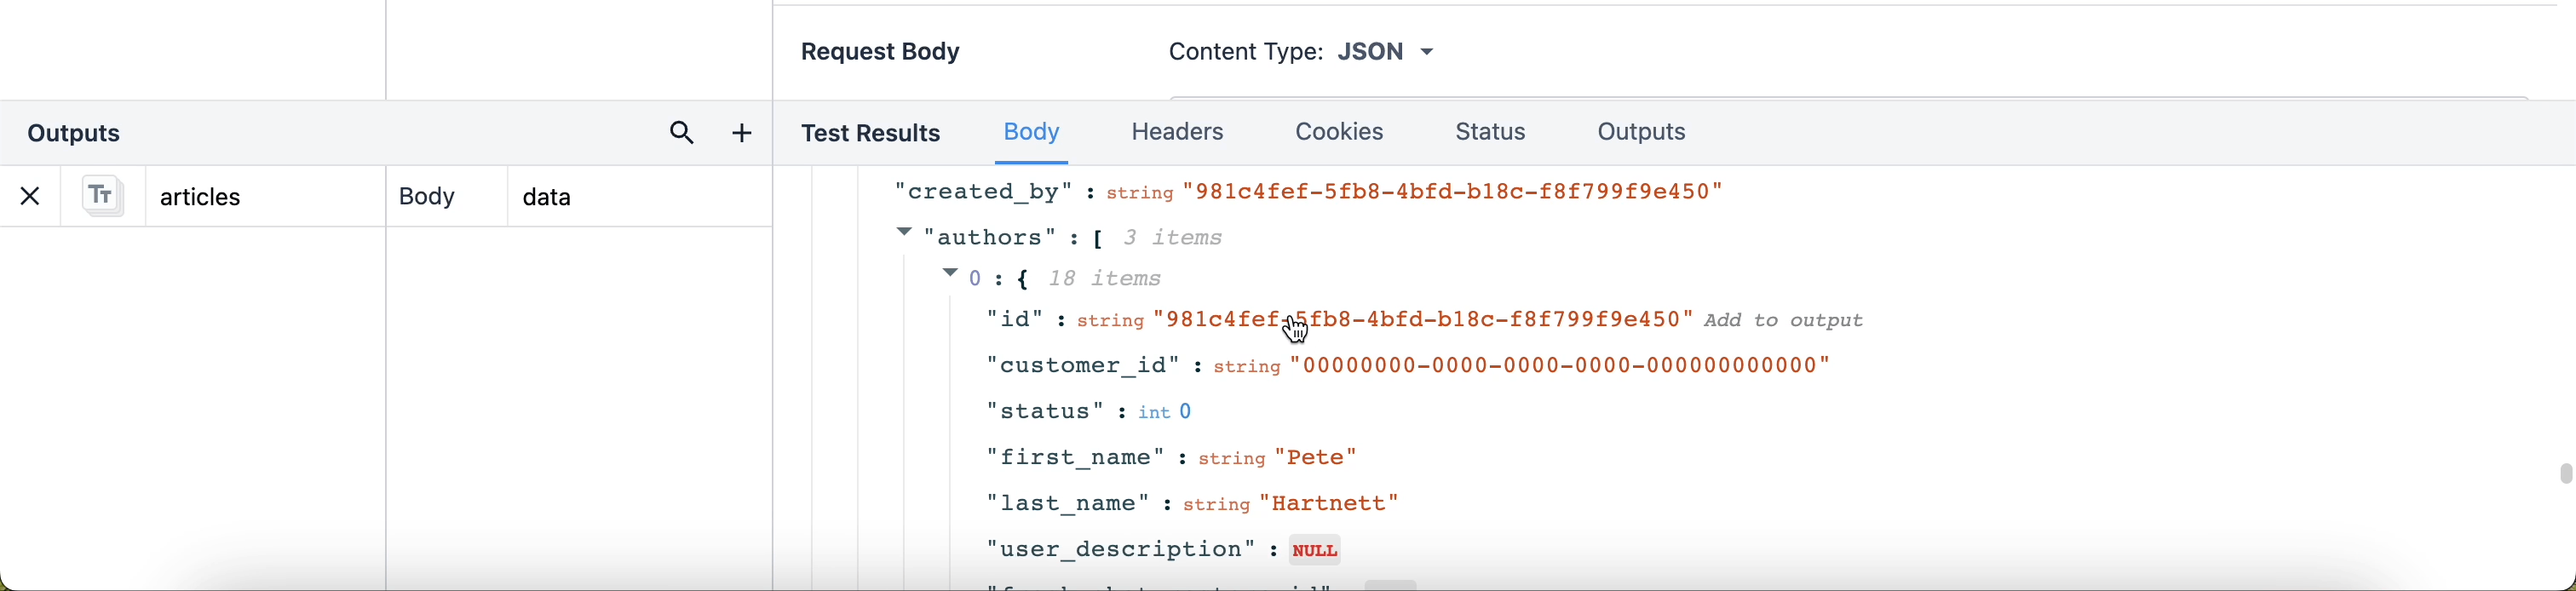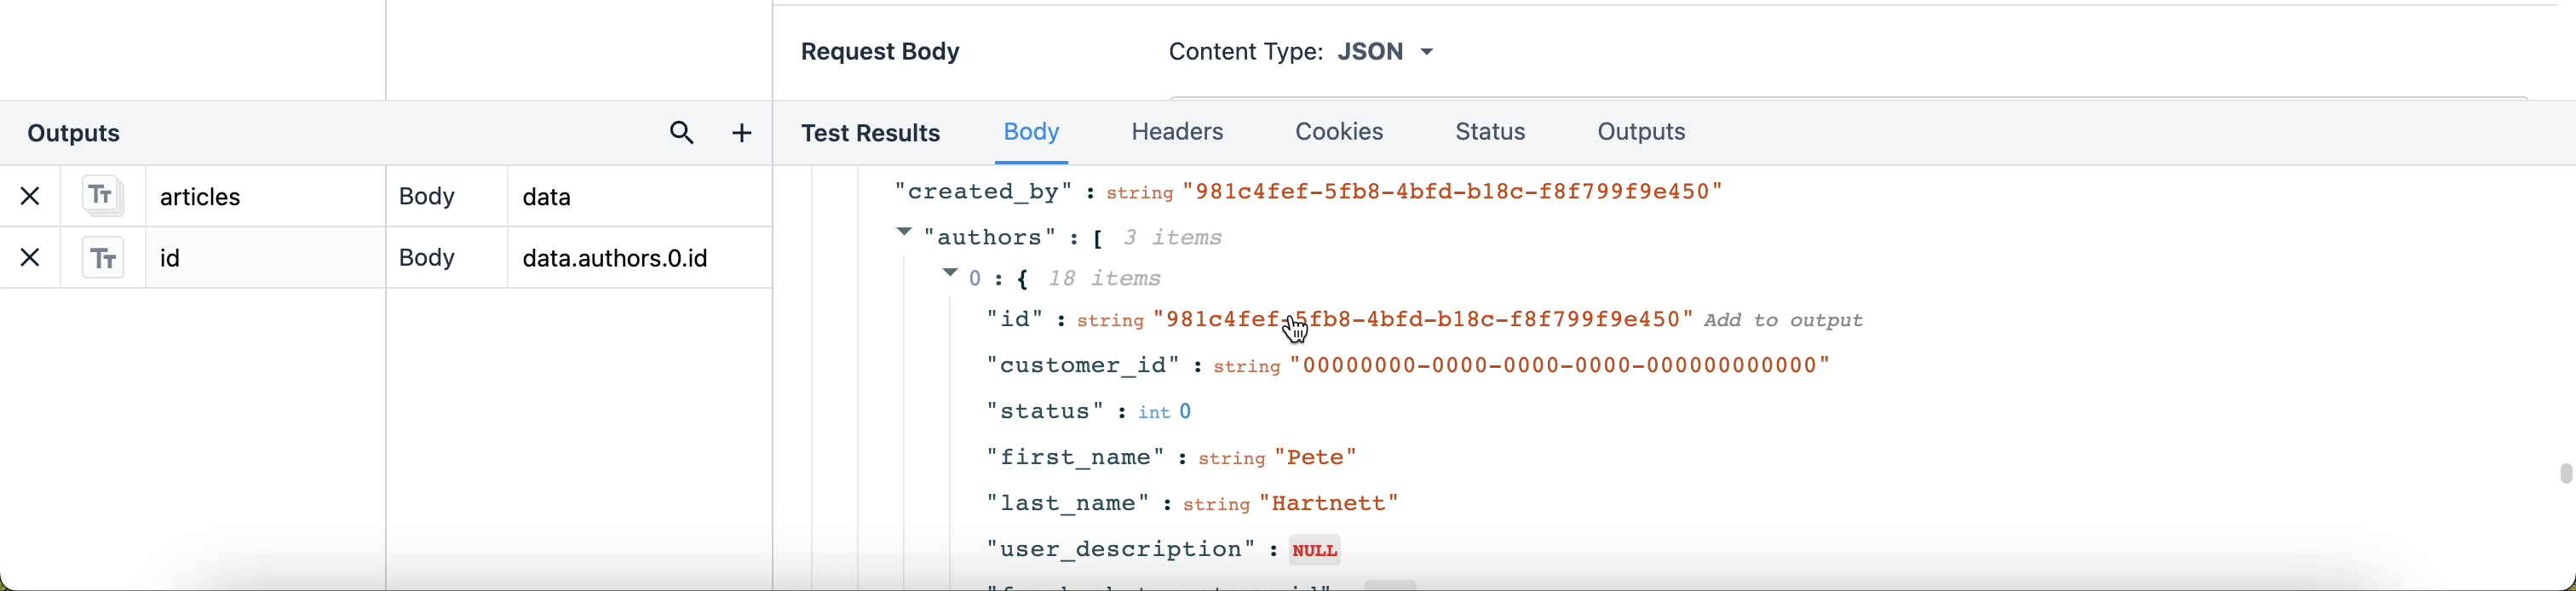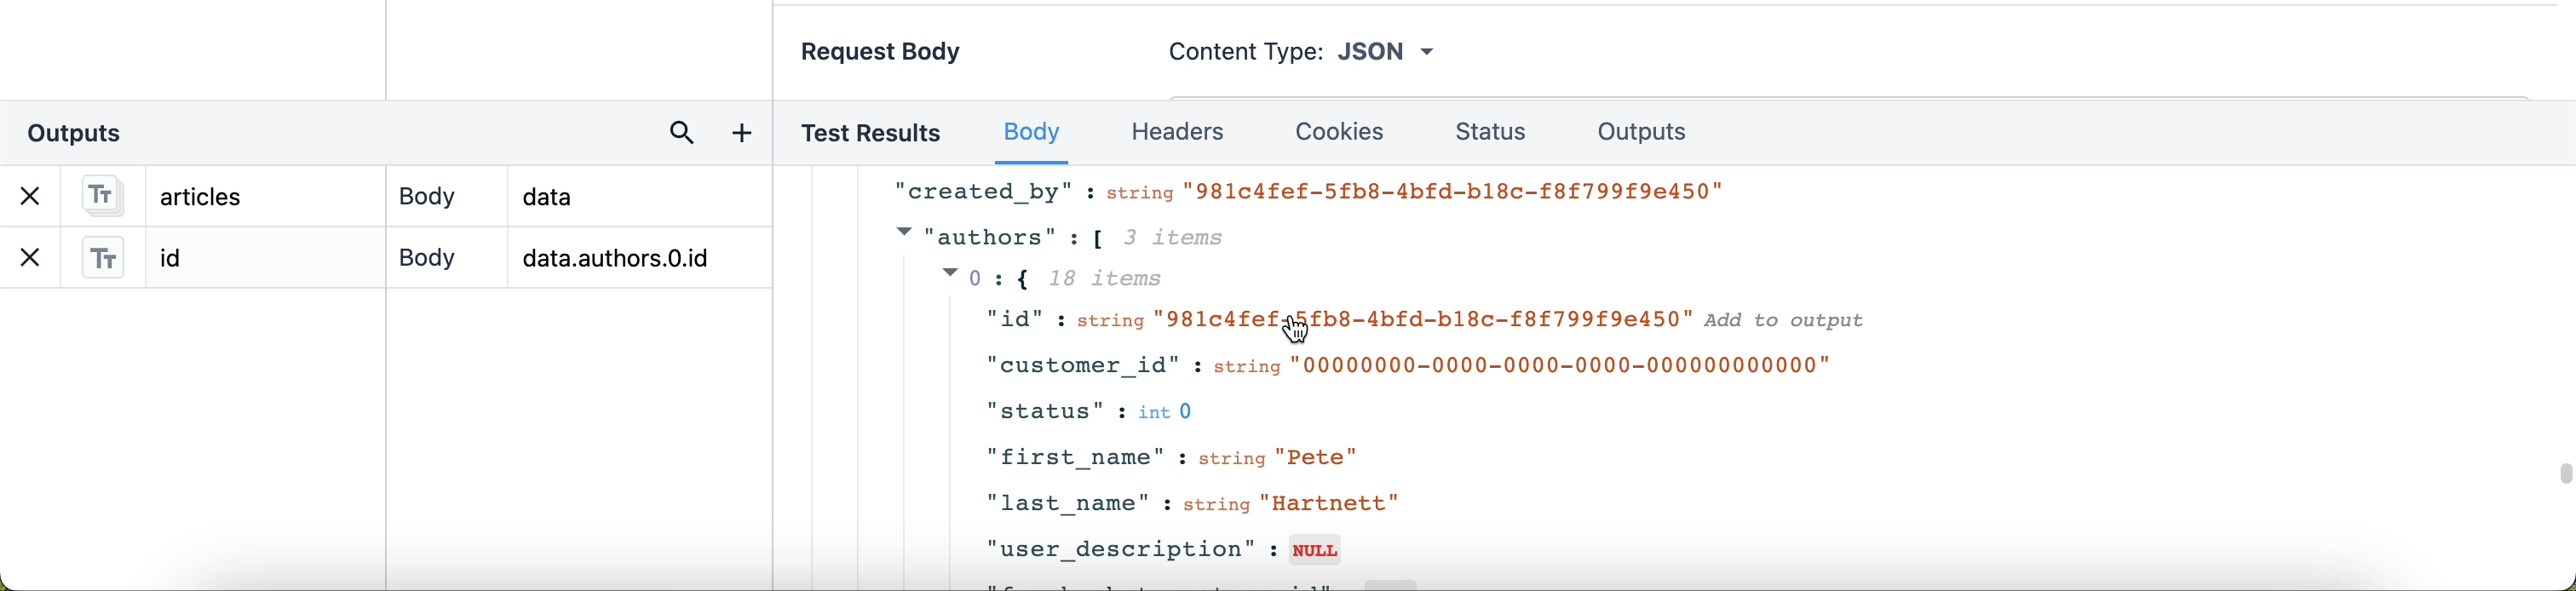
A pontjelölés használatáról további információkat ebben a forrásban talál: Processmaker: JSON pontjelölés.
Kimeneti eredmények
A kimenetek strukturálásának többféle módja létezik, de az, hogy hogyan csinálja, teljes mértékben attól függ, hogy mit szeretne kezdeni az alkalmazásában lévő adatokkal. Mielőtt elkezdené strukturálni a kimeneteket, gondolja át a végső célját. Többféle adattípust szeretne megjeleníteni különálló változókban? Vagy ugyanazok az adattípusok szerepelnek egy tömbben, amelyet egyszerűen csak át szeretne futtatni a releváns információk kinyerése érdekében?
Az alábbi példák mind ugyanazon csatlakozófüggvényen alapulnak, és minden esetben a teszt eredményeinek törzse megegyezik. A kimenetek azonban a felépítésük alapján eltérőek.
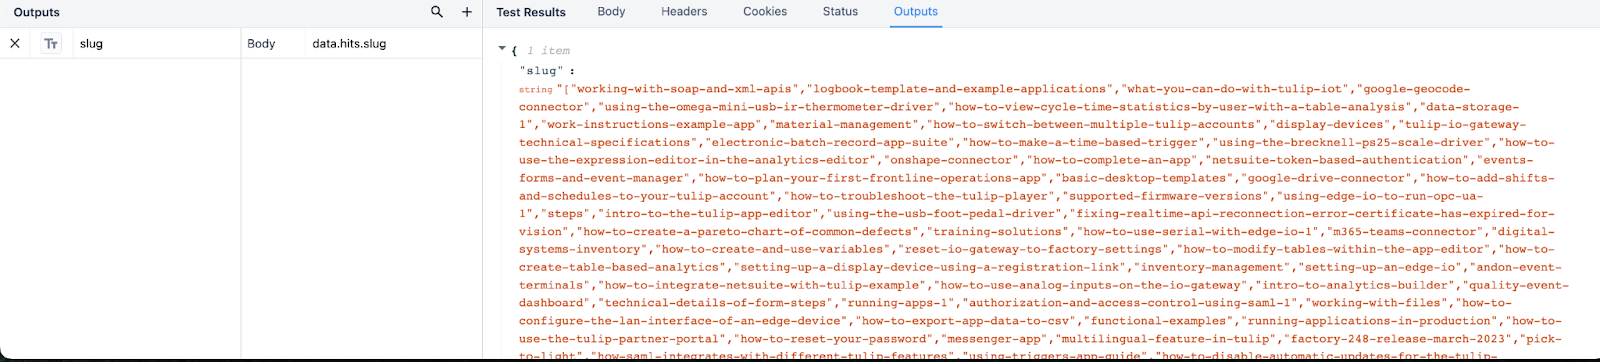
Az alábbi példa bemutatja, hogyan adja ki a csatlakozó a JSON path data.hits.slug értékét. A kimenet felépítésének köszönhetően a csatlakozó egy nagy tömböt ad vissza, amely tartalmazza a tudásbázis-cikkek összes URL-slugját. Alkalmazásainkban ez a csatlakozó-visszatérési érték egy tömbváltozóban lesz elérhető.
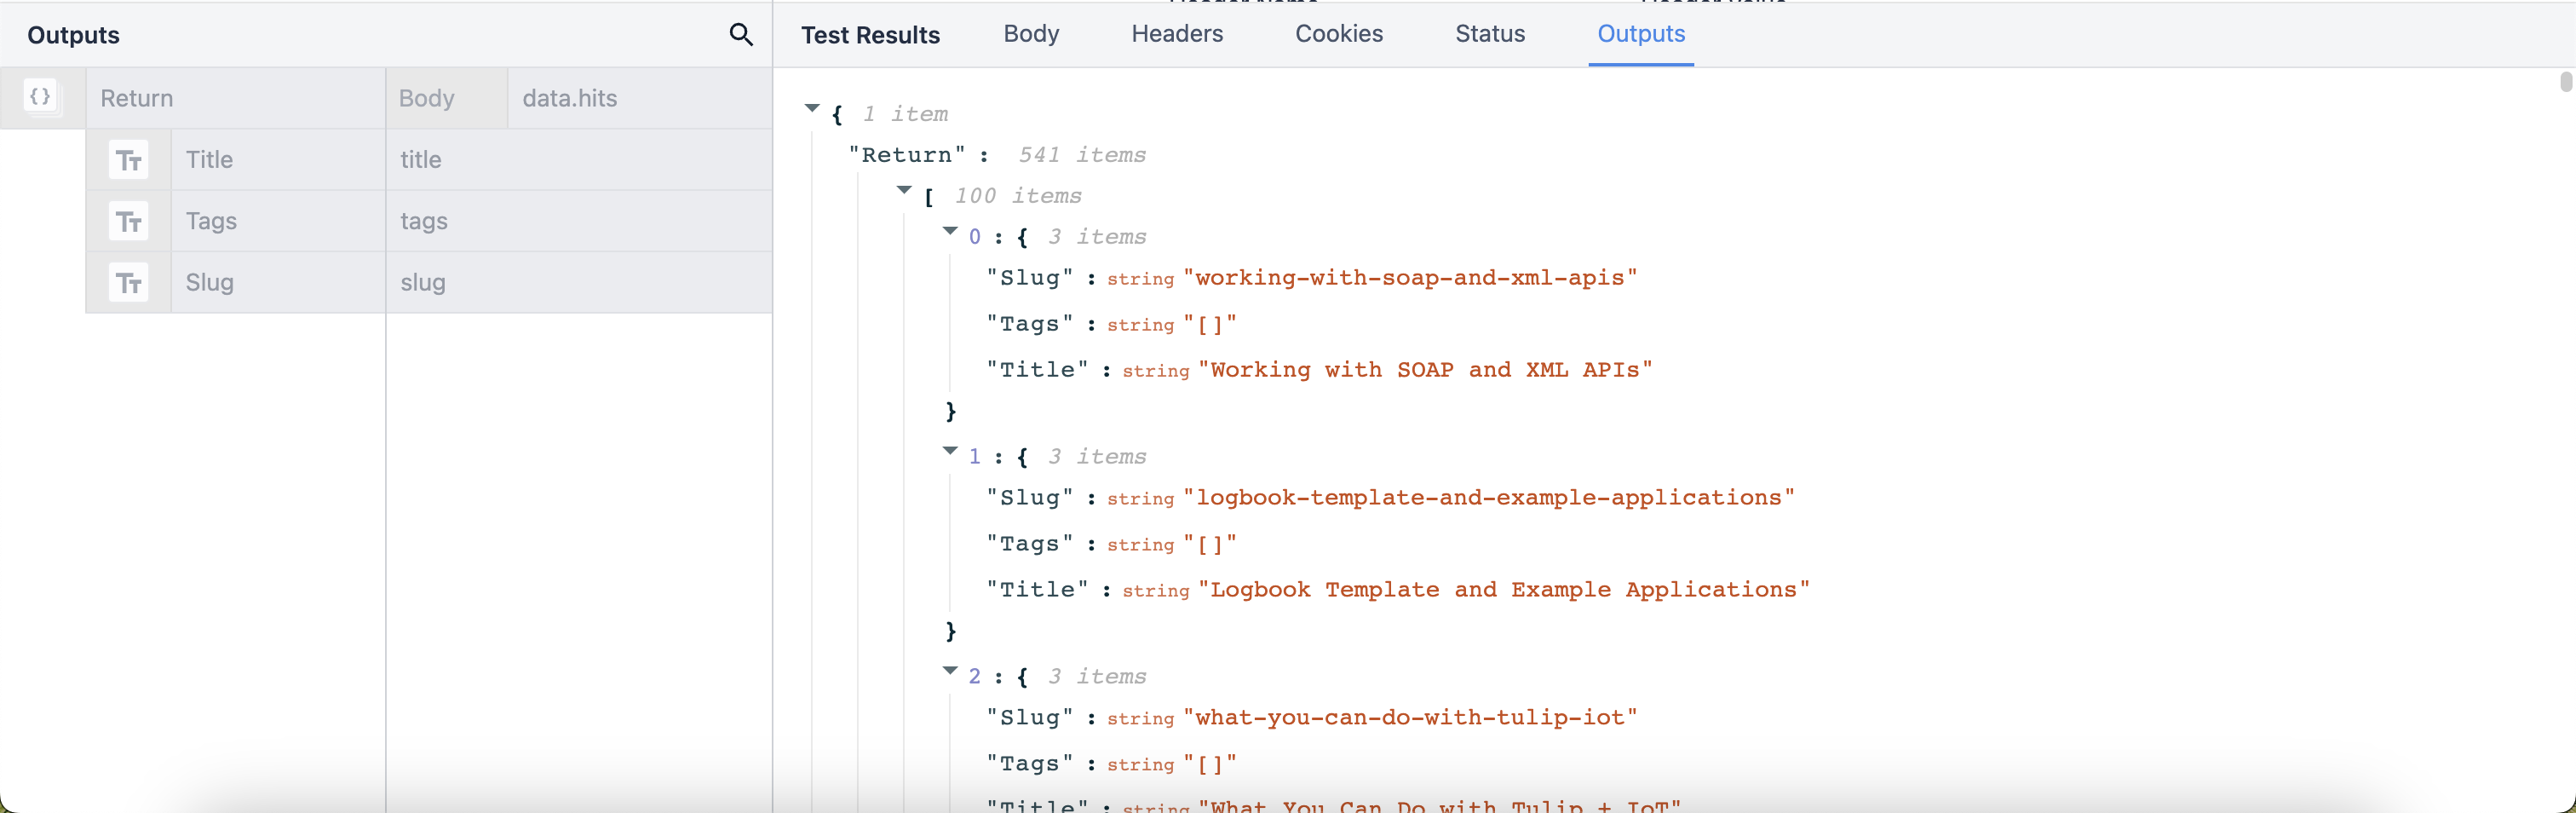
A kimeneteket objektumok listájaként is strukturálhatjuk, és az eredményekből egyes adattípusokat kiemelhetünk, így több olyan adatobjektumot hozhatunk létre, amelyek az alkalmazásokban külön-külön is megjeleníthetők.
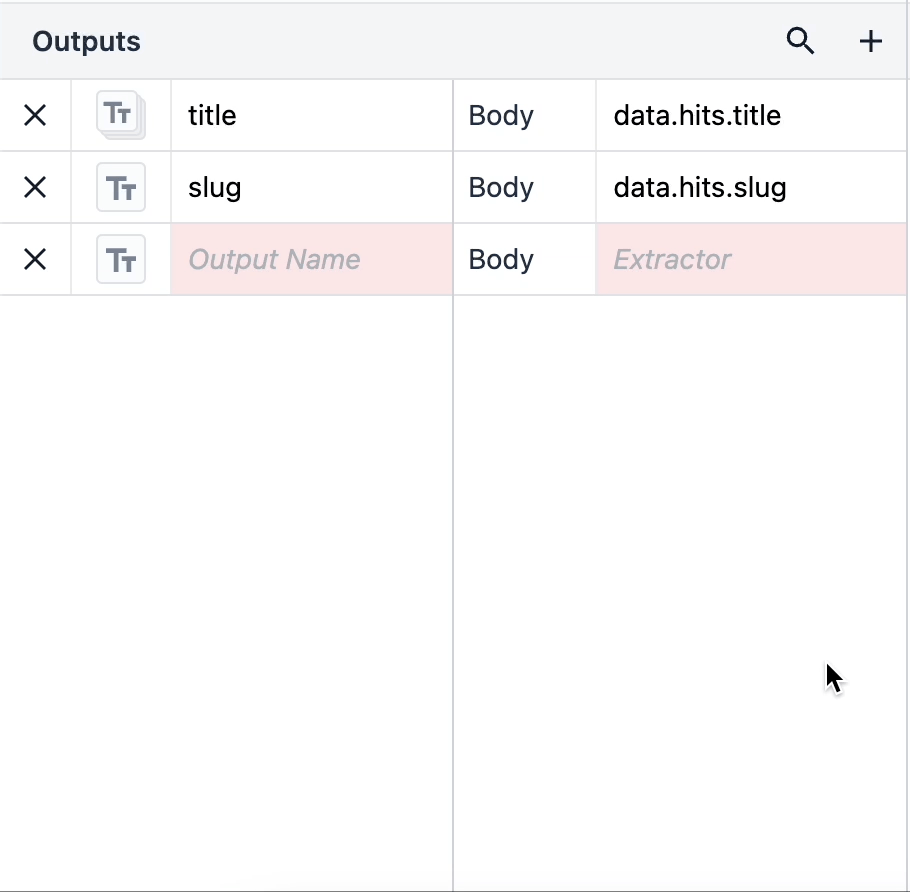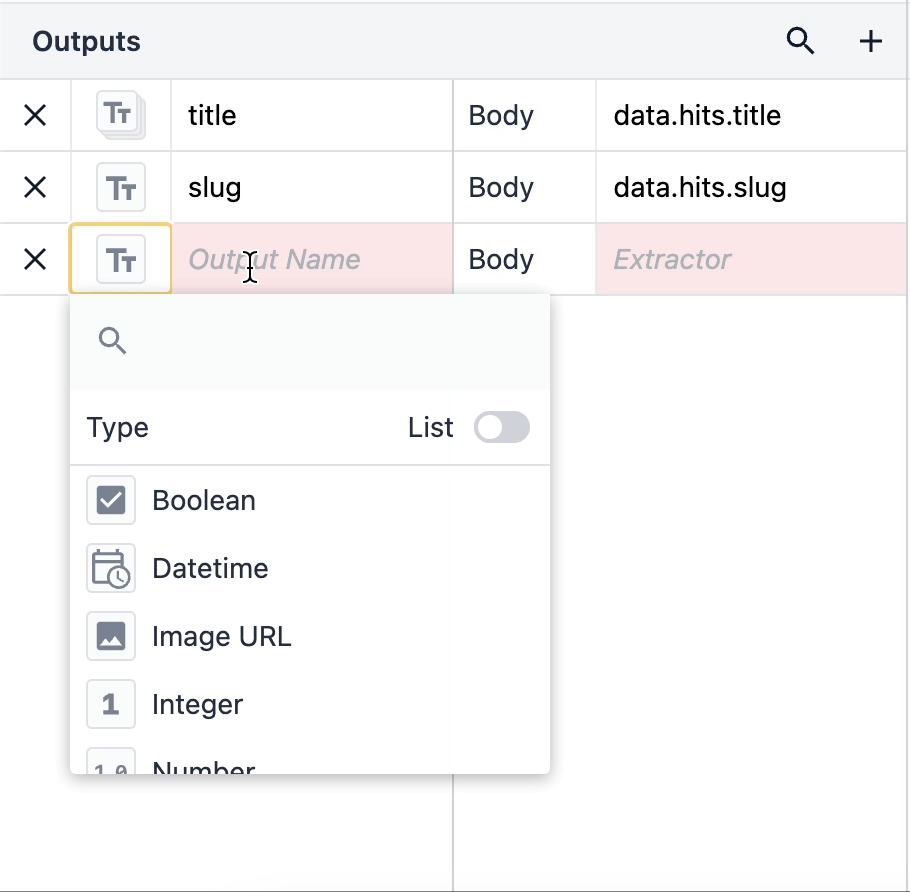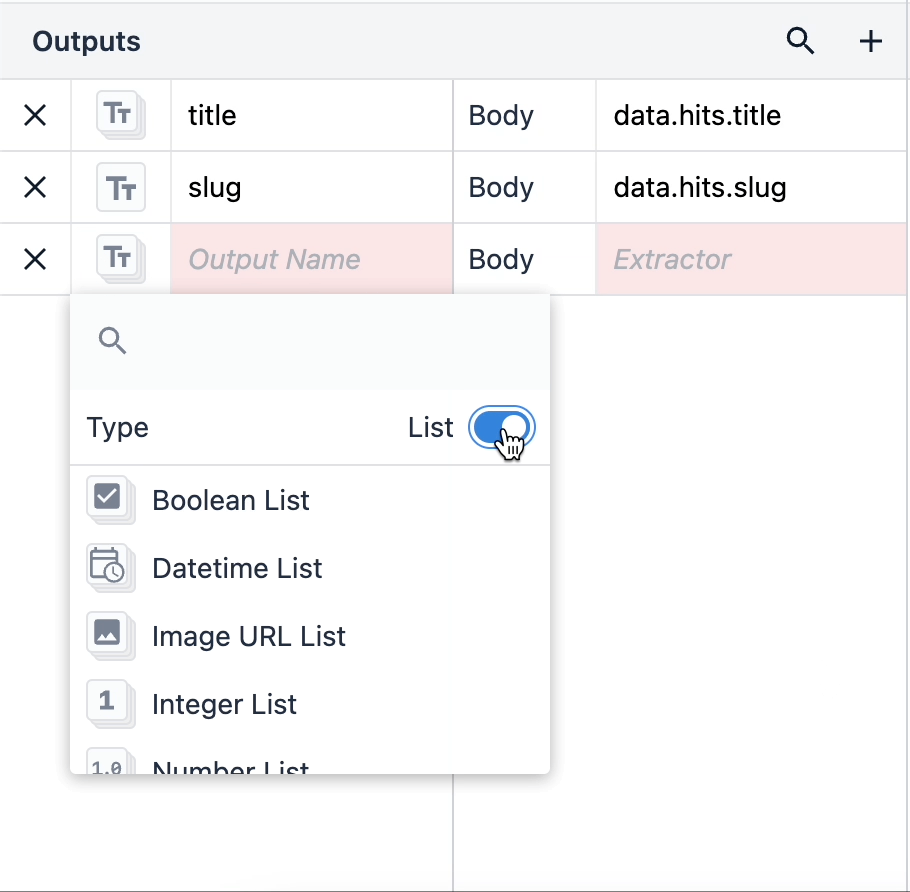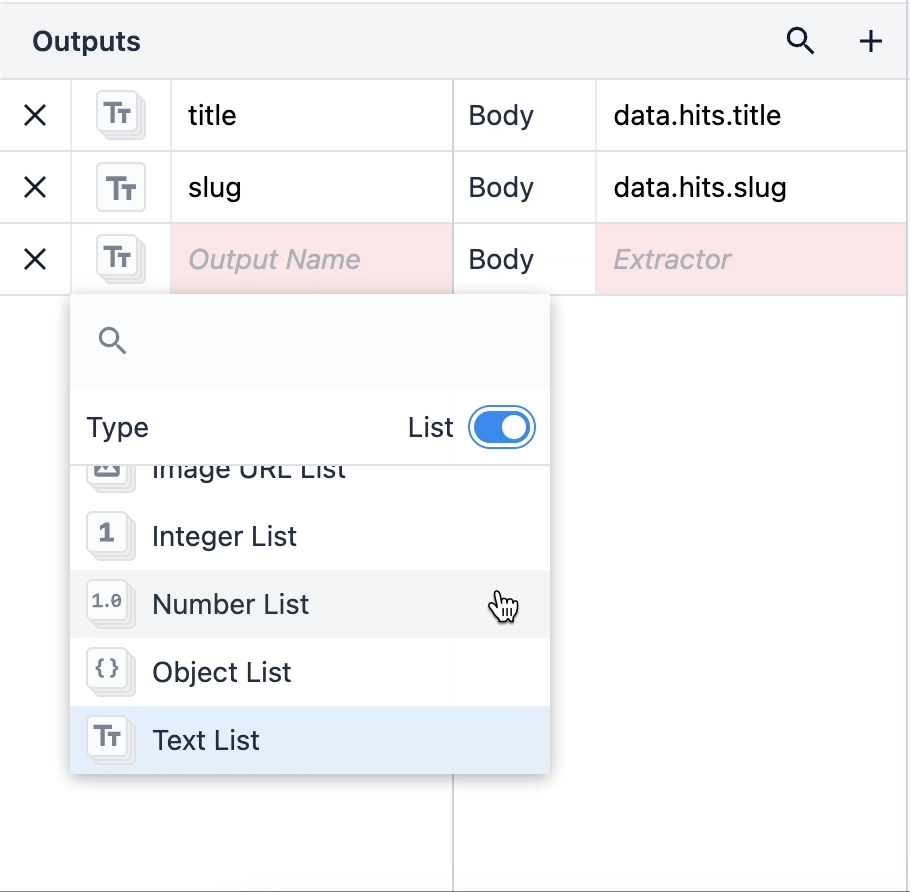
Az objektumlisták olyan objektumok, amelyek több beágyazott adattípust tartalmaznak. Az objektumlisták használatához kattintson a kimeneti típusra, majd kapcsolja be a jobb sarokban található „Lista” kapcsolót.
Ha rendelkezünk objektumlistával, az alkalmazásokban könnyedén felhasználhatjuk a különböző adattípusokat különálló adatokként.
Ha visszatérünk a fenti példához, tegyük listává a data.hits.slug kimeneti útvonalat. Az alábbi eredményekből látható, hogy a Tulip ezt a csatlakozó visszatérési értékét slugok tömbjeként strukturálja, az egyes indexpozíciók az egyes értékek mellett szerepelnek.
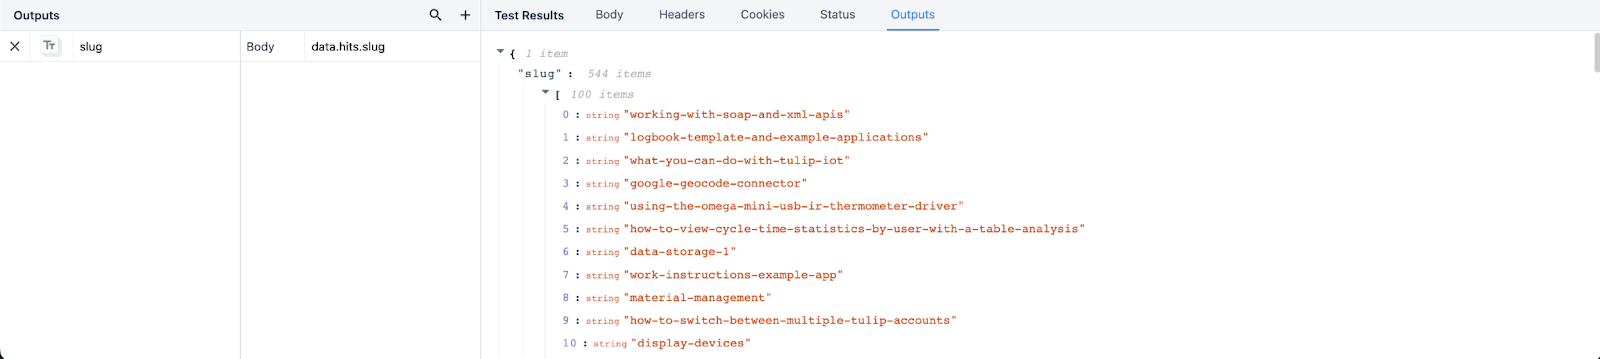
A kimenetekről szerzett ismereteid alapján most már hozzárendelheted a kimeneteket a saját csatlakozófüggvényeidhez, és optimalizálhatod a csatlakozóid által visszaadott eredményeket!
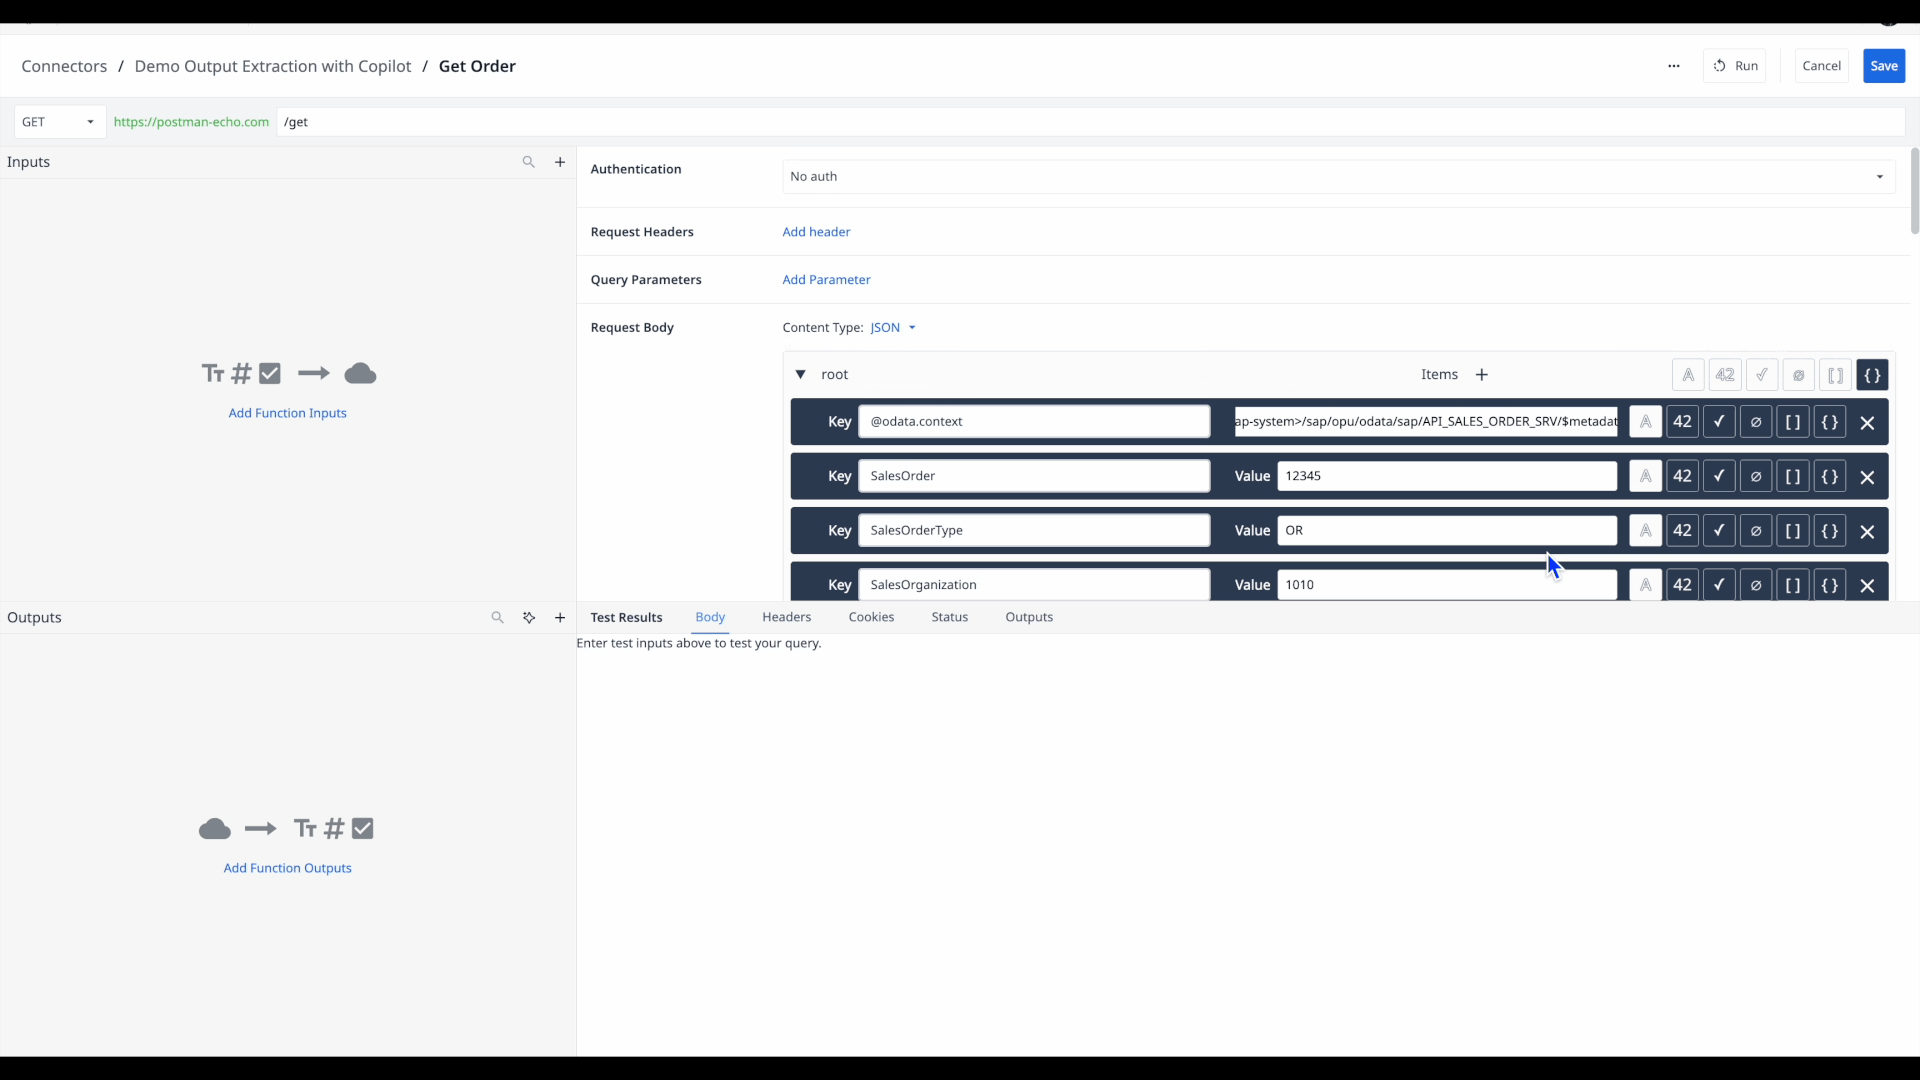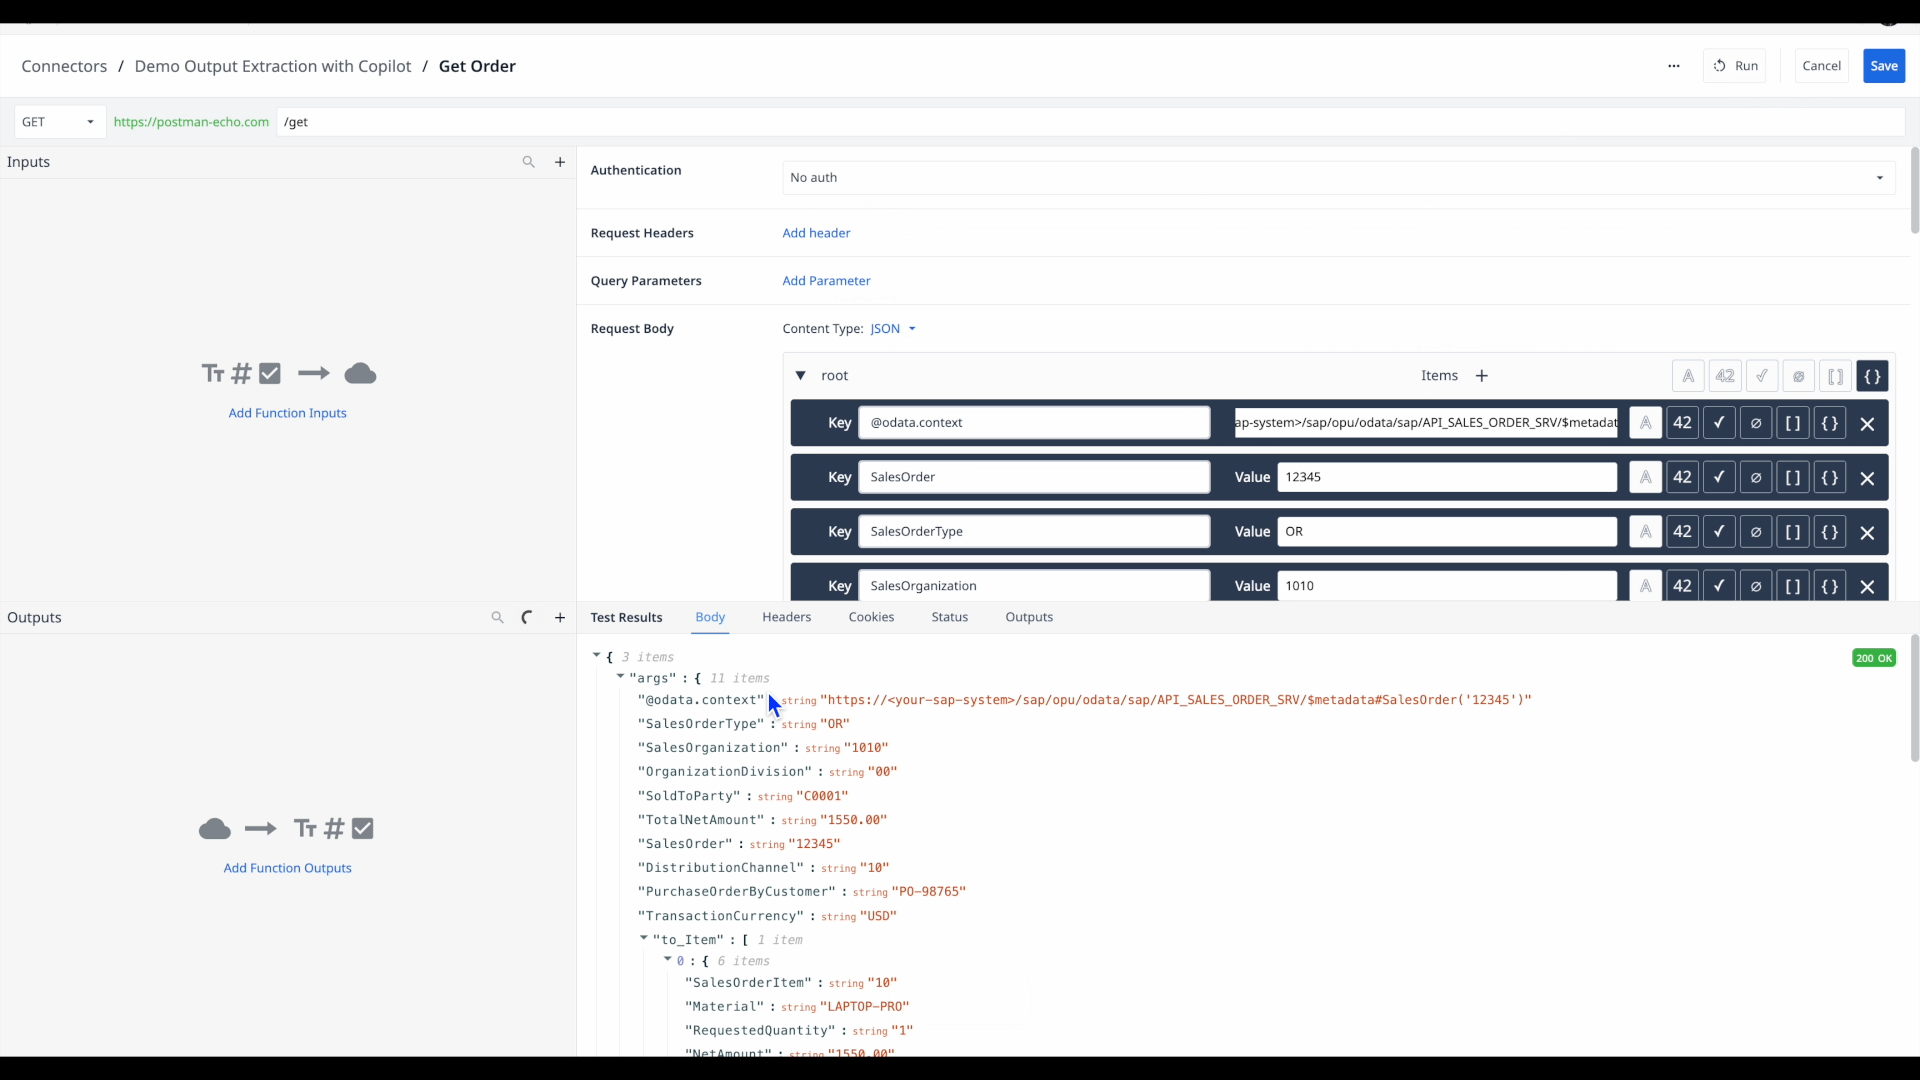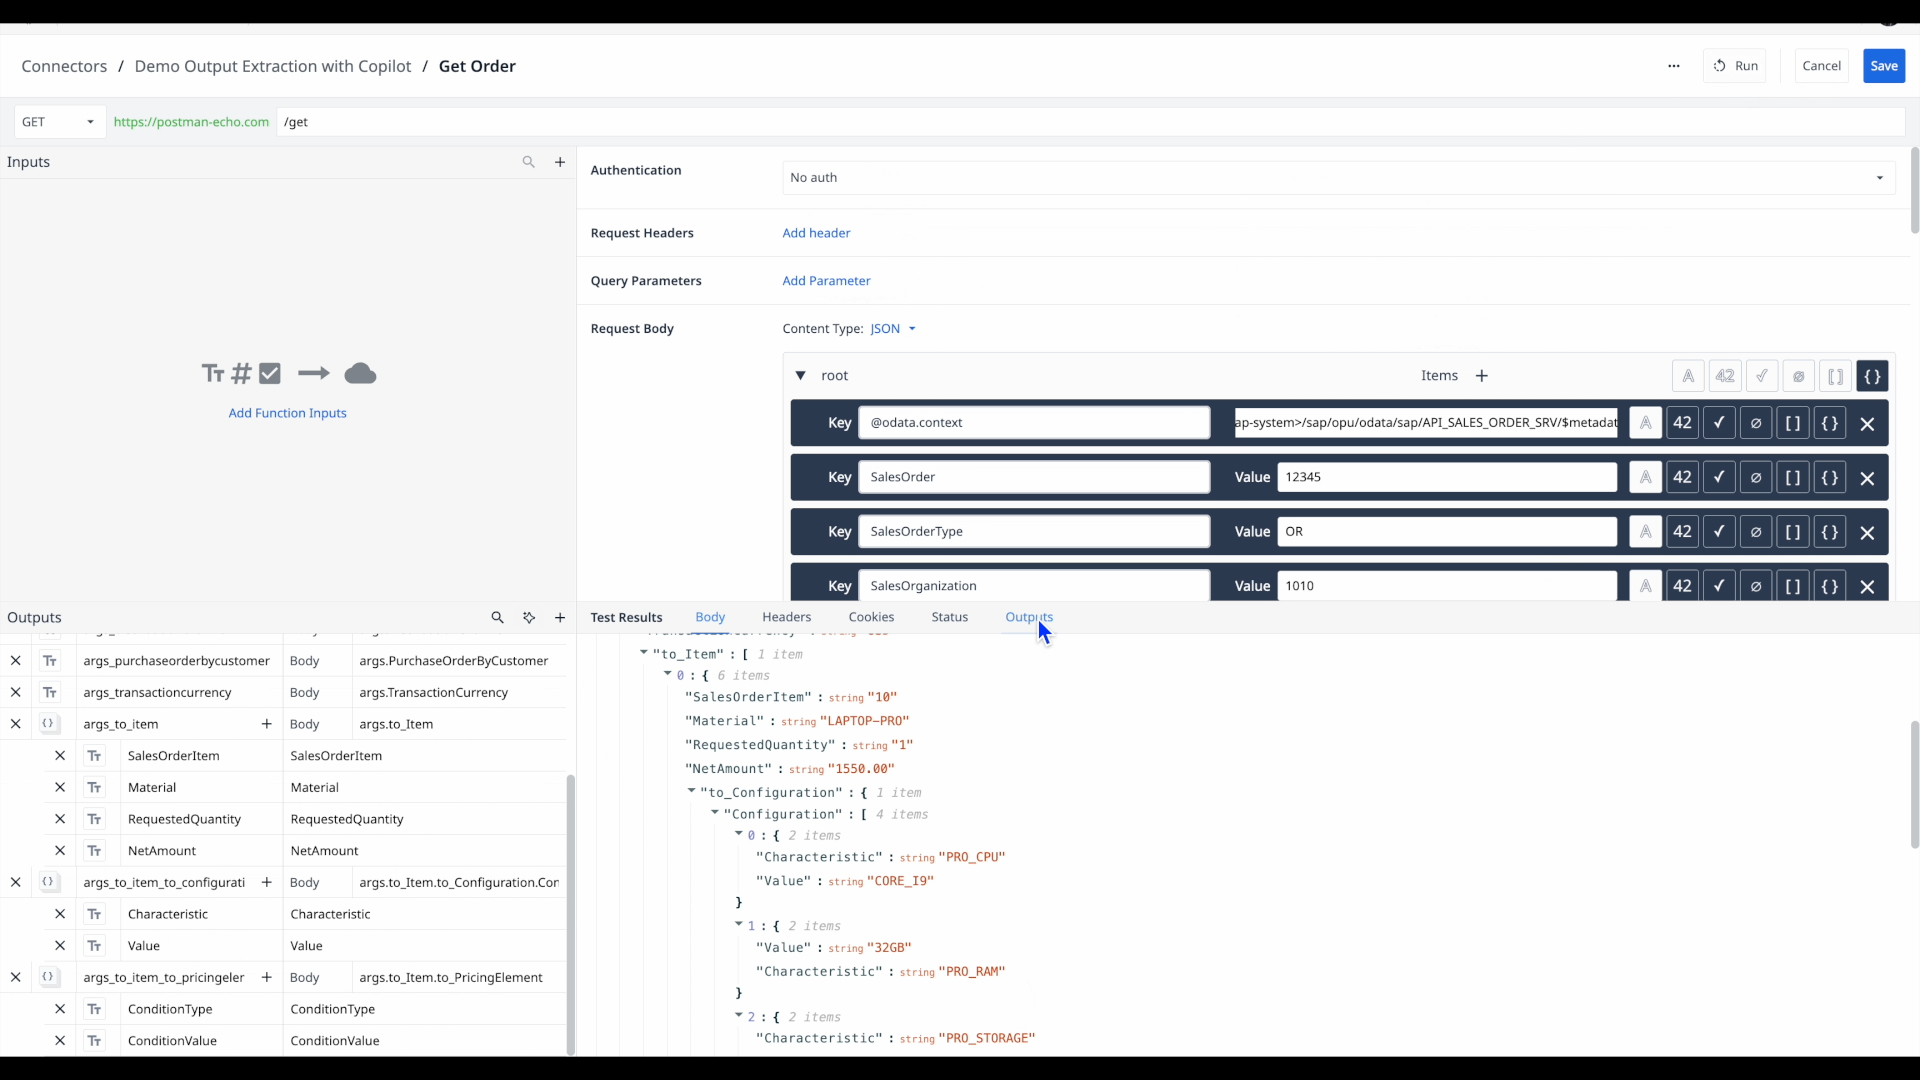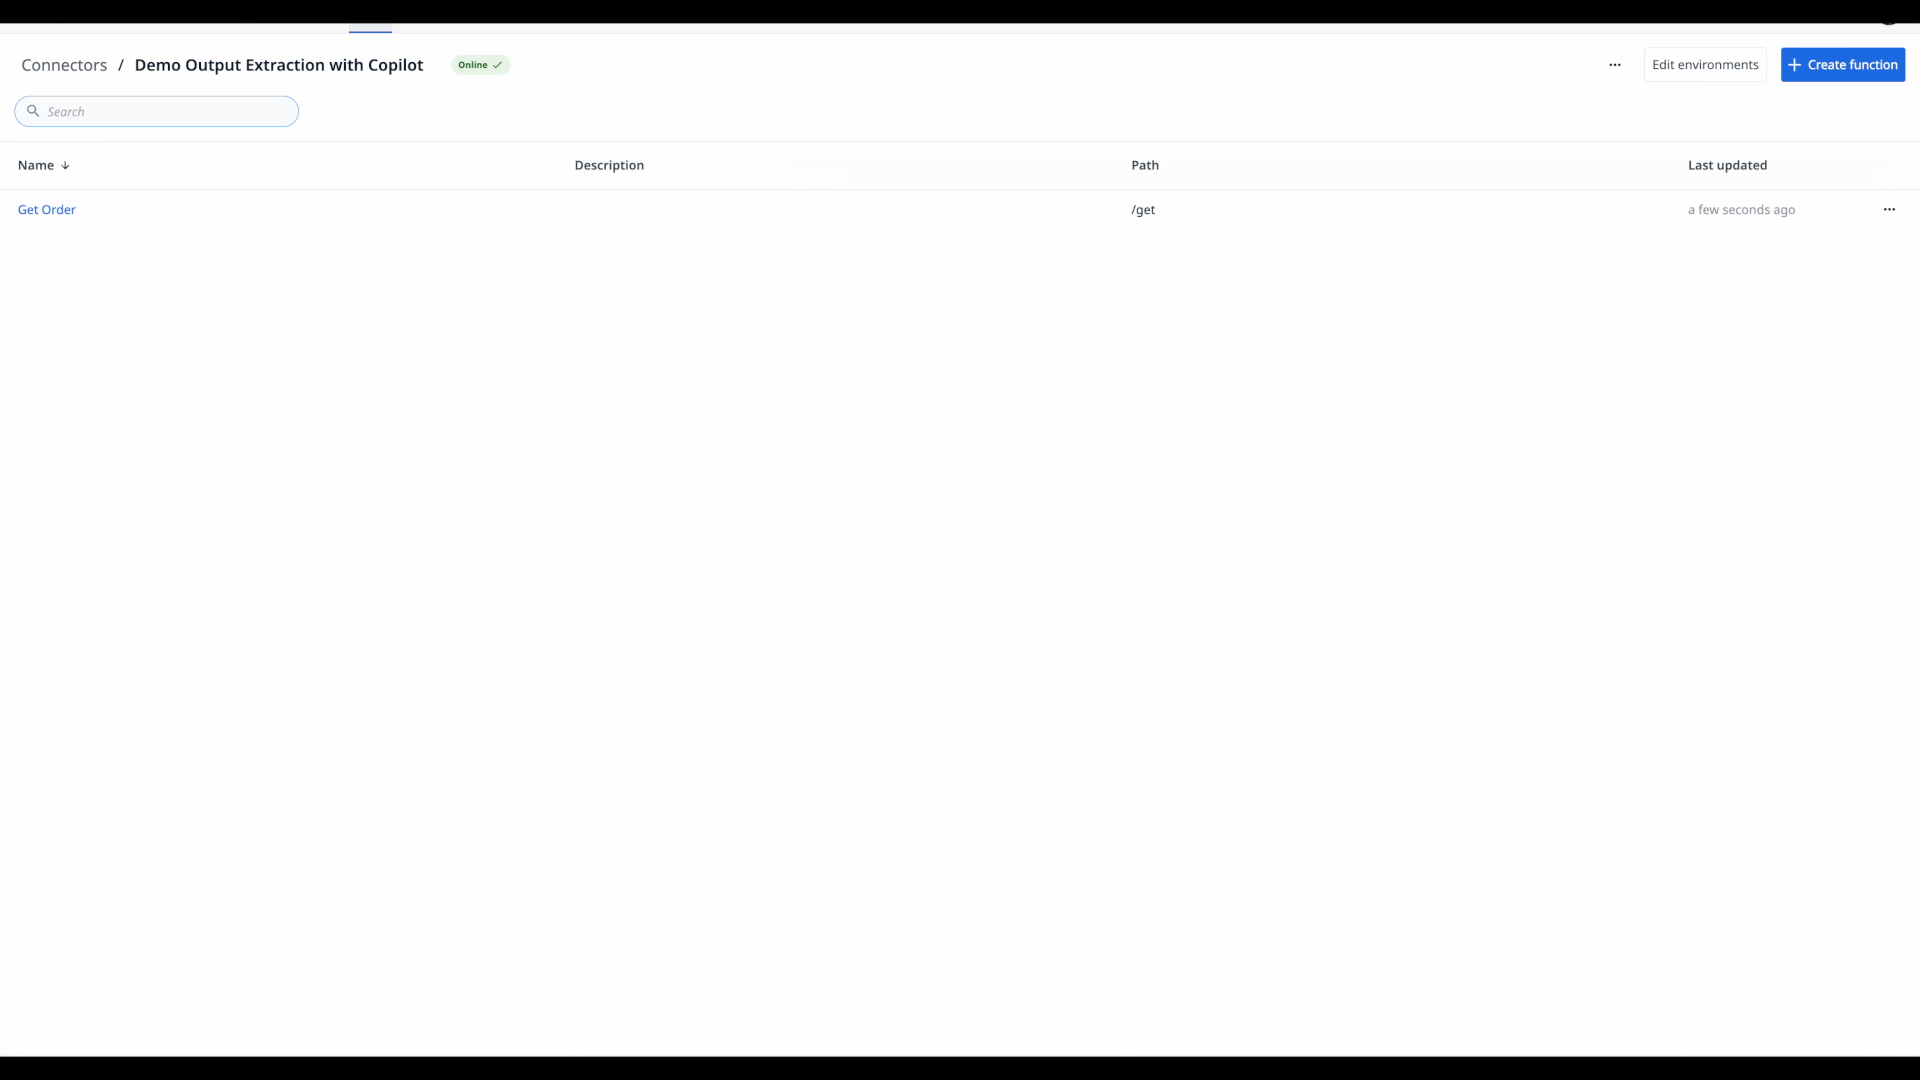
Használja a Tulip AI-t a kimenetek kivonásához
Gyorsan strukturálhatja a kimeneteit, kihasználva a cikkben már tárgyalt példákat és fogalmakat, mint például a (Dot Notation és az objektumok listája).
A Tulip AI hatékony segítséget nyújt a teszt eredményeiben található JSON-válasz automatikus elemzéséhez és a megfelelő Dot Notation útvonalak generálásához. Megpróbálja lemásolni a beágyazott objektumszerkezetet, de szükség esetén a komplex tömböket vagy objektumokat laposítja.
A Tulip AI nem módosítja a meglévő kimeneteit és kivonásait. Csak új vagy még nem megadott kimeneteket generál, hogy felgyorsítsa a kezdeti kimenet-konfigurációs folyamatot.
Miután a Tulip AI létrehozta a kimeneteket, azokat az alkalmazás céljával összevetve át kell tekintenie.
Az áttekintés során kövesse az alábbi bevált gyakorlatokat:* Távolítson el minden felesleges kimenetet* A jobb érthetőség érdekében nevezze át a változókat* Kézzel állítsa be a kimeneti struktúrát (pl. gondoskodjon arról, hogy a tömbök helyesen legyenek beállítva objektumlistaként)
Ezek a lépések biztosítják, hogy csak az alkalmazásához szükséges adatokat vonja ki.
További olvasnivaló
- HTTP-csatlakozók használata alkalmazásokban
- Interaktív táblázati rekordlisták vagy csatlakozói kimenetek megjelenítése alkalmazásokban
{{snippet.Megtalálta, amit keresett?}}