

Découvrez comment structurer les sorties des connecteurs HTTP.
Présentation
L’éditeur de fonctions de connecteur de Tulip vous permet de structurer les données renvoyées par vos fonctions de connecteur afin qu’elles soient utiles et exploitables au sein de vos applications. Dans cet article, nous aborderons les principes de base du formatage des sorties Output des fonctions de connecteur en vous présentant :
- Le concept de sortie de connecteur
- Les outils disponibles pour formater les sorties
- Les différents formats de sortie courants
Que sont les sorties ?
Les sorties servent à définir et à structurer les résultats renvoyés par la fonction de connecteur. Elles vous permettent d’extraire les informations importantes pour vos applications à partir d’un corps de réponse HTTP plus volumineux.
Comment structurer les sorties
Recherchez la section « Sorties » en bas à gauche de l’éditeur de fonction de connecteur.
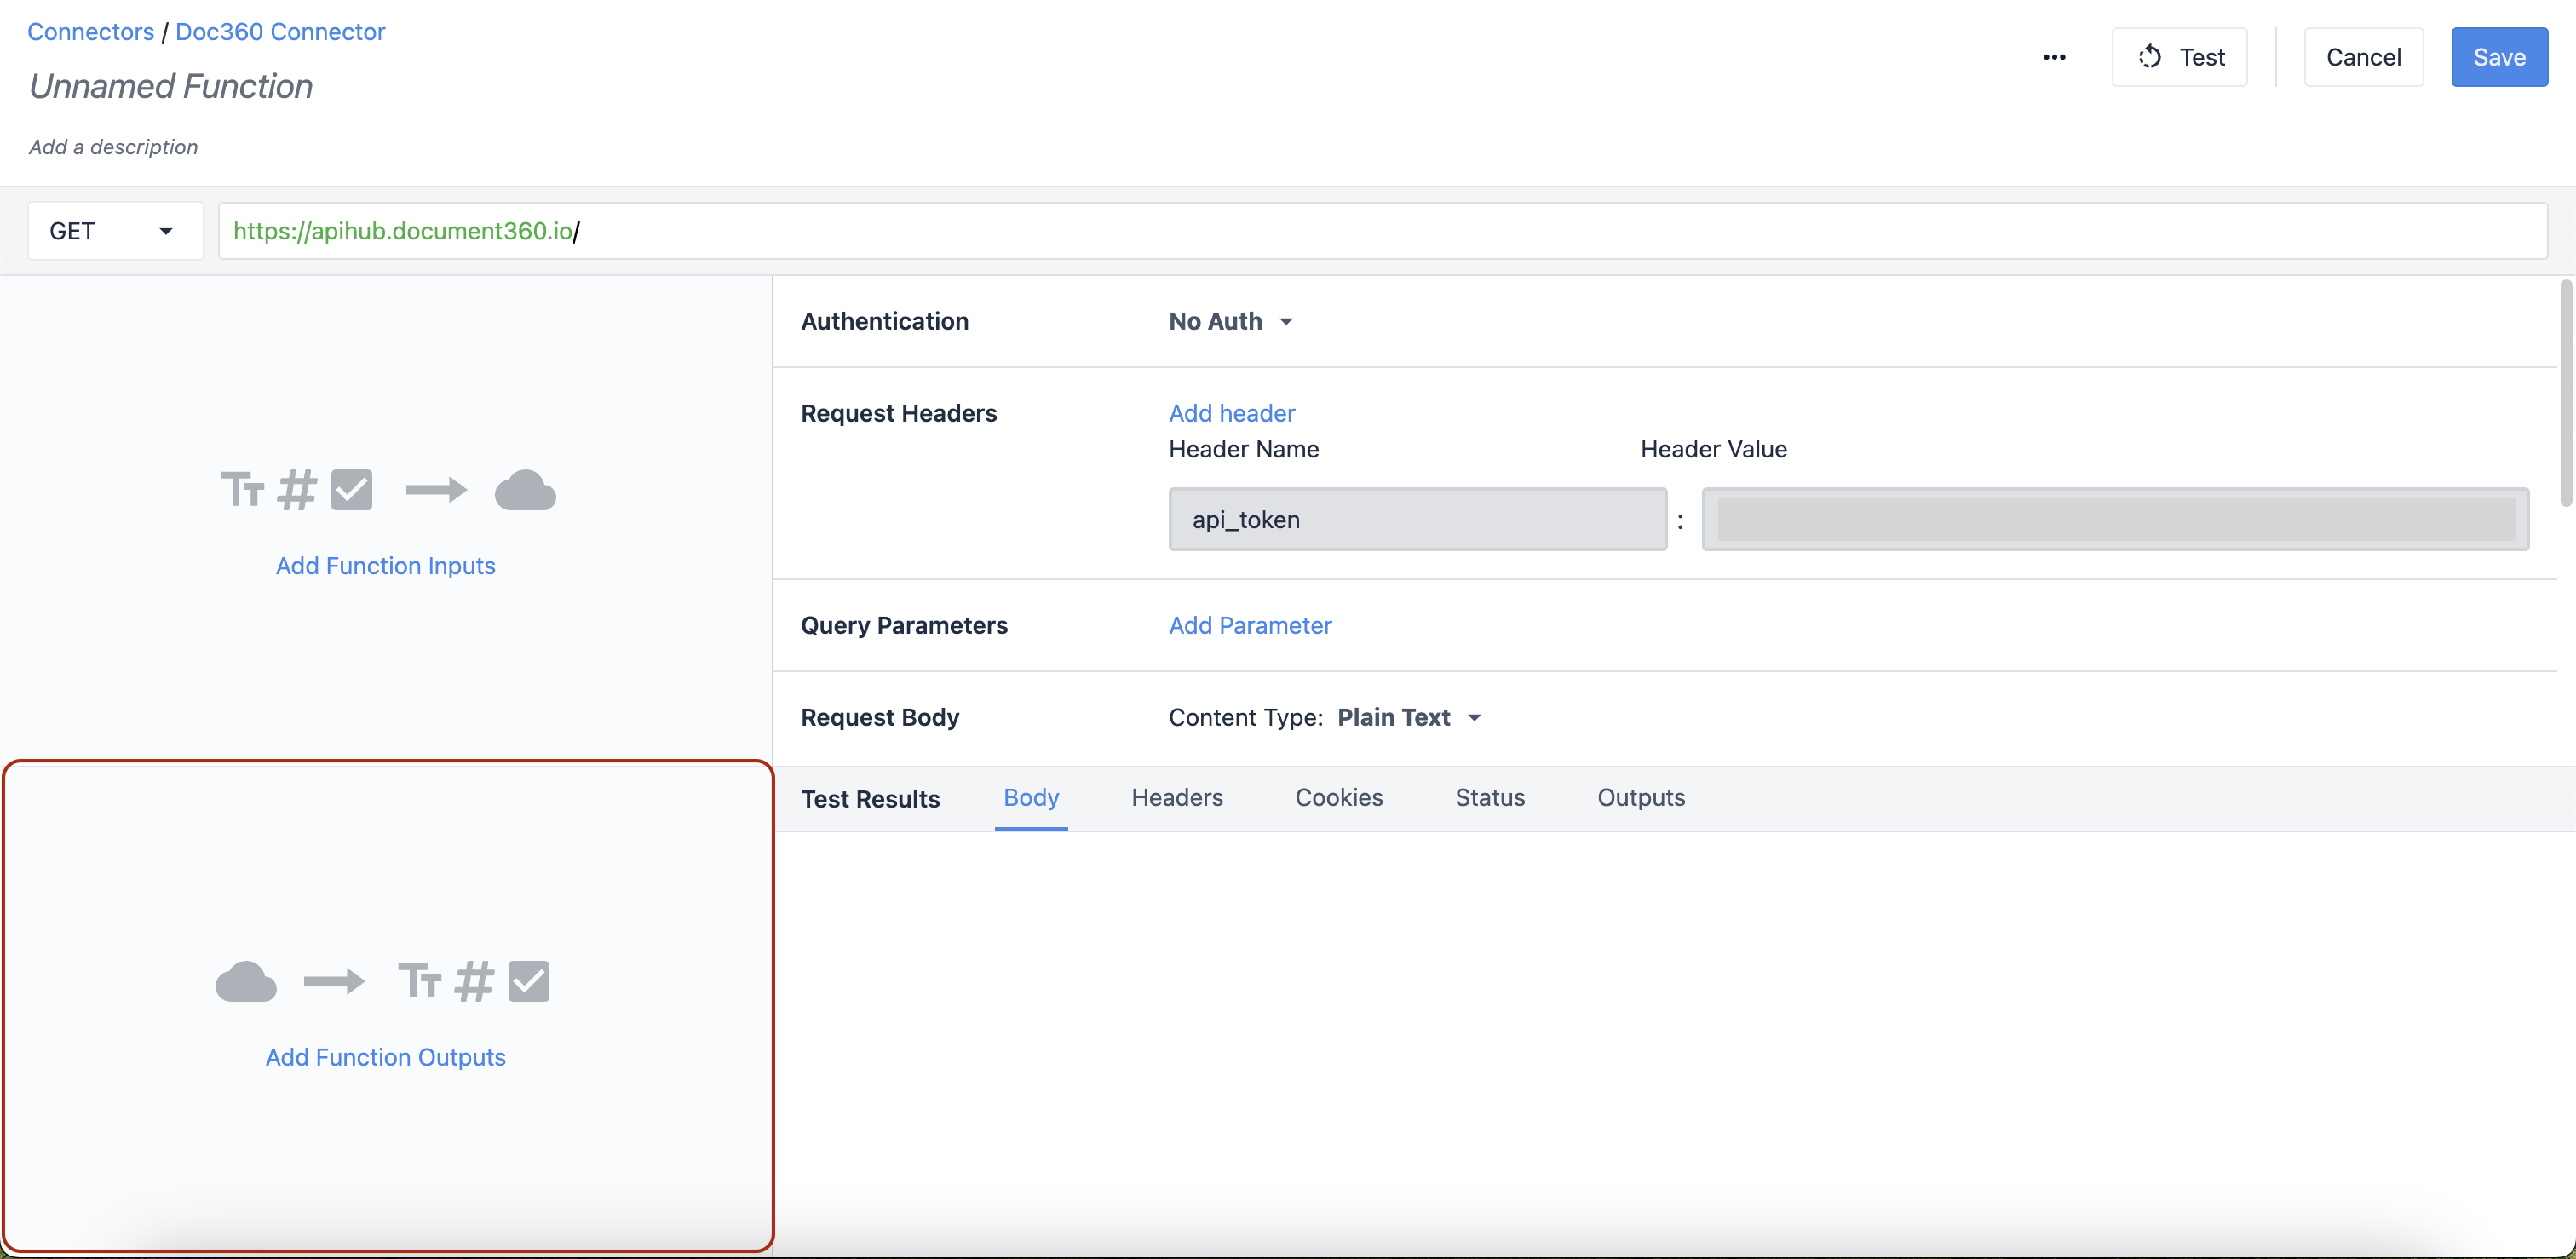
Pour commencer à ajouter des sorties, cliquez sur « Ajouter des sorties de fonction ».
Il est recommandé de donner à vos sorties un nom permettant de les identifier facilement. Ces noms apparaissent sous forme de variables dans les applications ; il est donc important de pouvoir les distinguer.
Pour comprendre les résultats d’une requête HTTP, il est important de commencer par comprendre la structure d’un objet renvoyé dans les « Test Results » (Résultats du test). Le schéma ci-dessous illustre comment les résultats sont divisés en sections d’objets et de tableaux.
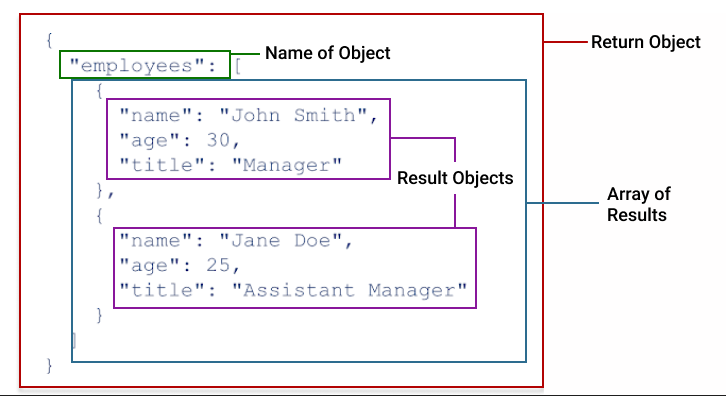
If you haven’t worked with JSON before, you may be unfamiliar with two critical datatypes, objects and arrays. Arrays are lists of values of the same type. For example, [1,2,3,5], or [oak, elm, alder, hickory]. Values in arrays are contained within square brackets, [ ]. Objects are a datatype for holding key:value pairs. The key:value pairs within an object can be of multiple different types, including arrays and nested objects. Objects are contained with curly brackets, { }.
Pour plus d’informations sur les objets et les tableaux, consultez la section Comprendre les tableaux et les objets dans les sorties des fonctions de connecteur.
Notation par points
Pour les connecteurs HTTP, les sorties utilisent un format appelé . La notation par points vous permet d’accéder aux valeurs contenues dans un objet. La notation par points est utile pour extraire uniquement ce dont vous avez besoin d’un corps de réponse JSON volumineux, et elle vous offre davantage de flexibilité dans le formatage des fonctions des connecteurs HTTP. Pour faire simple : il s’agit d’un format structuré basé sur des valeurs imbriquées les unes dans les autres.
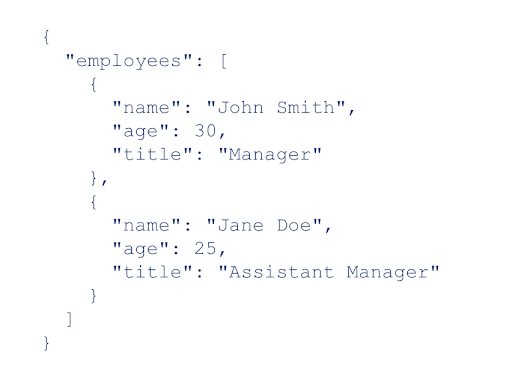
Voyons comment la notation par points est utilisée dans les sorties des connecteurs à l’aide d’un exemple.
L’objet suivant, appelé « employees », contient un tableau d’objets avec des détails sur chaque employé. Si nous souhaitons uniquement accéder au titre de chaque employé, nous utiliserons la syntaxe : employees.title. Nous utilisons un point pour accéder aux valeurs associées aux clés qui nous intéressent. Imaginons que nous souhaitions uniquement obtenir le premier résultat. Nous le préciserions en ajoutant l’indice entre le nom de l’objet principal, « employees », et la valeur qui nous intéresse, « title ». La syntaxe ressemblerait à ceci : employees.0.title. Pour des objets plus complexes, vous devrez peut-être remonter plus loin dans l’arborescence de l’objet pour extraire les informations souhaitées.
Allons un peu plus loin avec un autre exemple. Dans ce cas, imaginons que nous souhaitions créer une fonction de connecteur pour extraire des informations associées aux articles de la base de connaissances. Notre connecteur renvoie l’objet JSON suivant, nommé « data », contenant des données sur un article particulier :
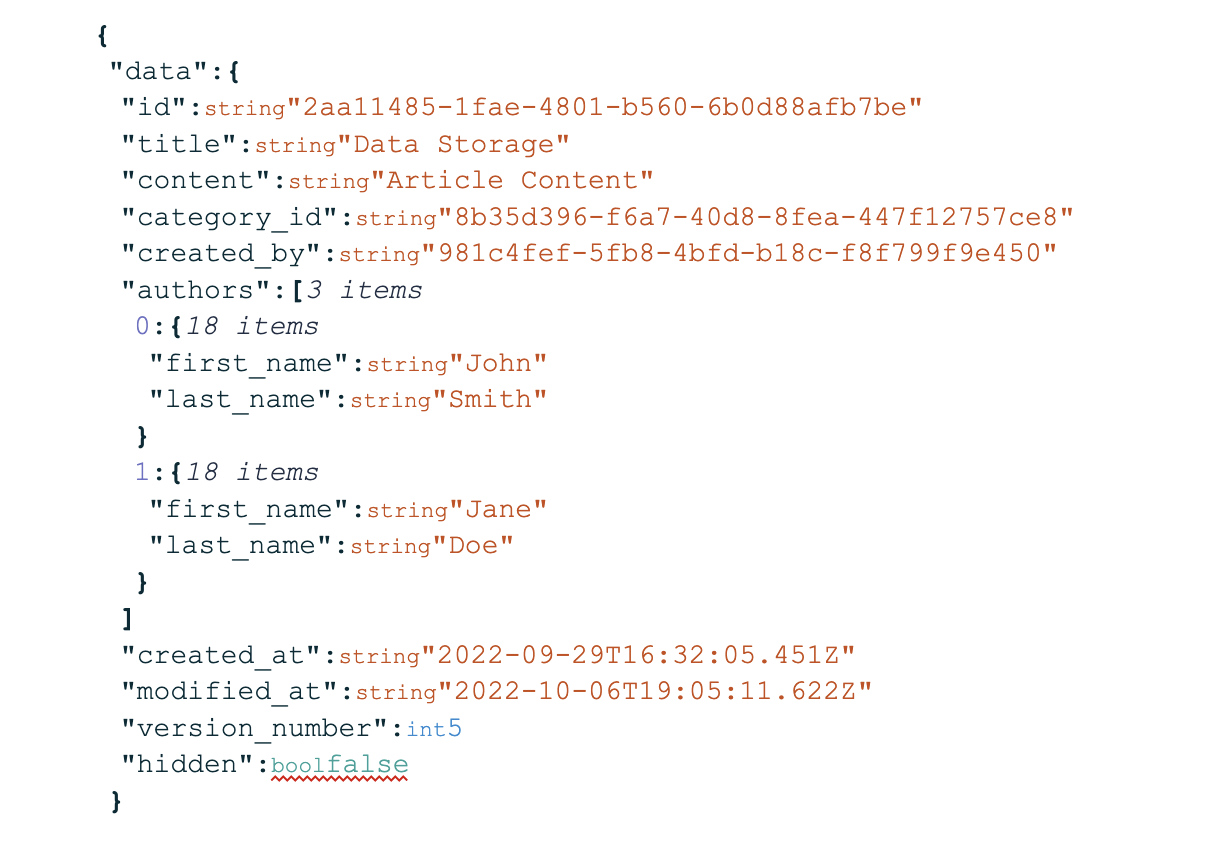
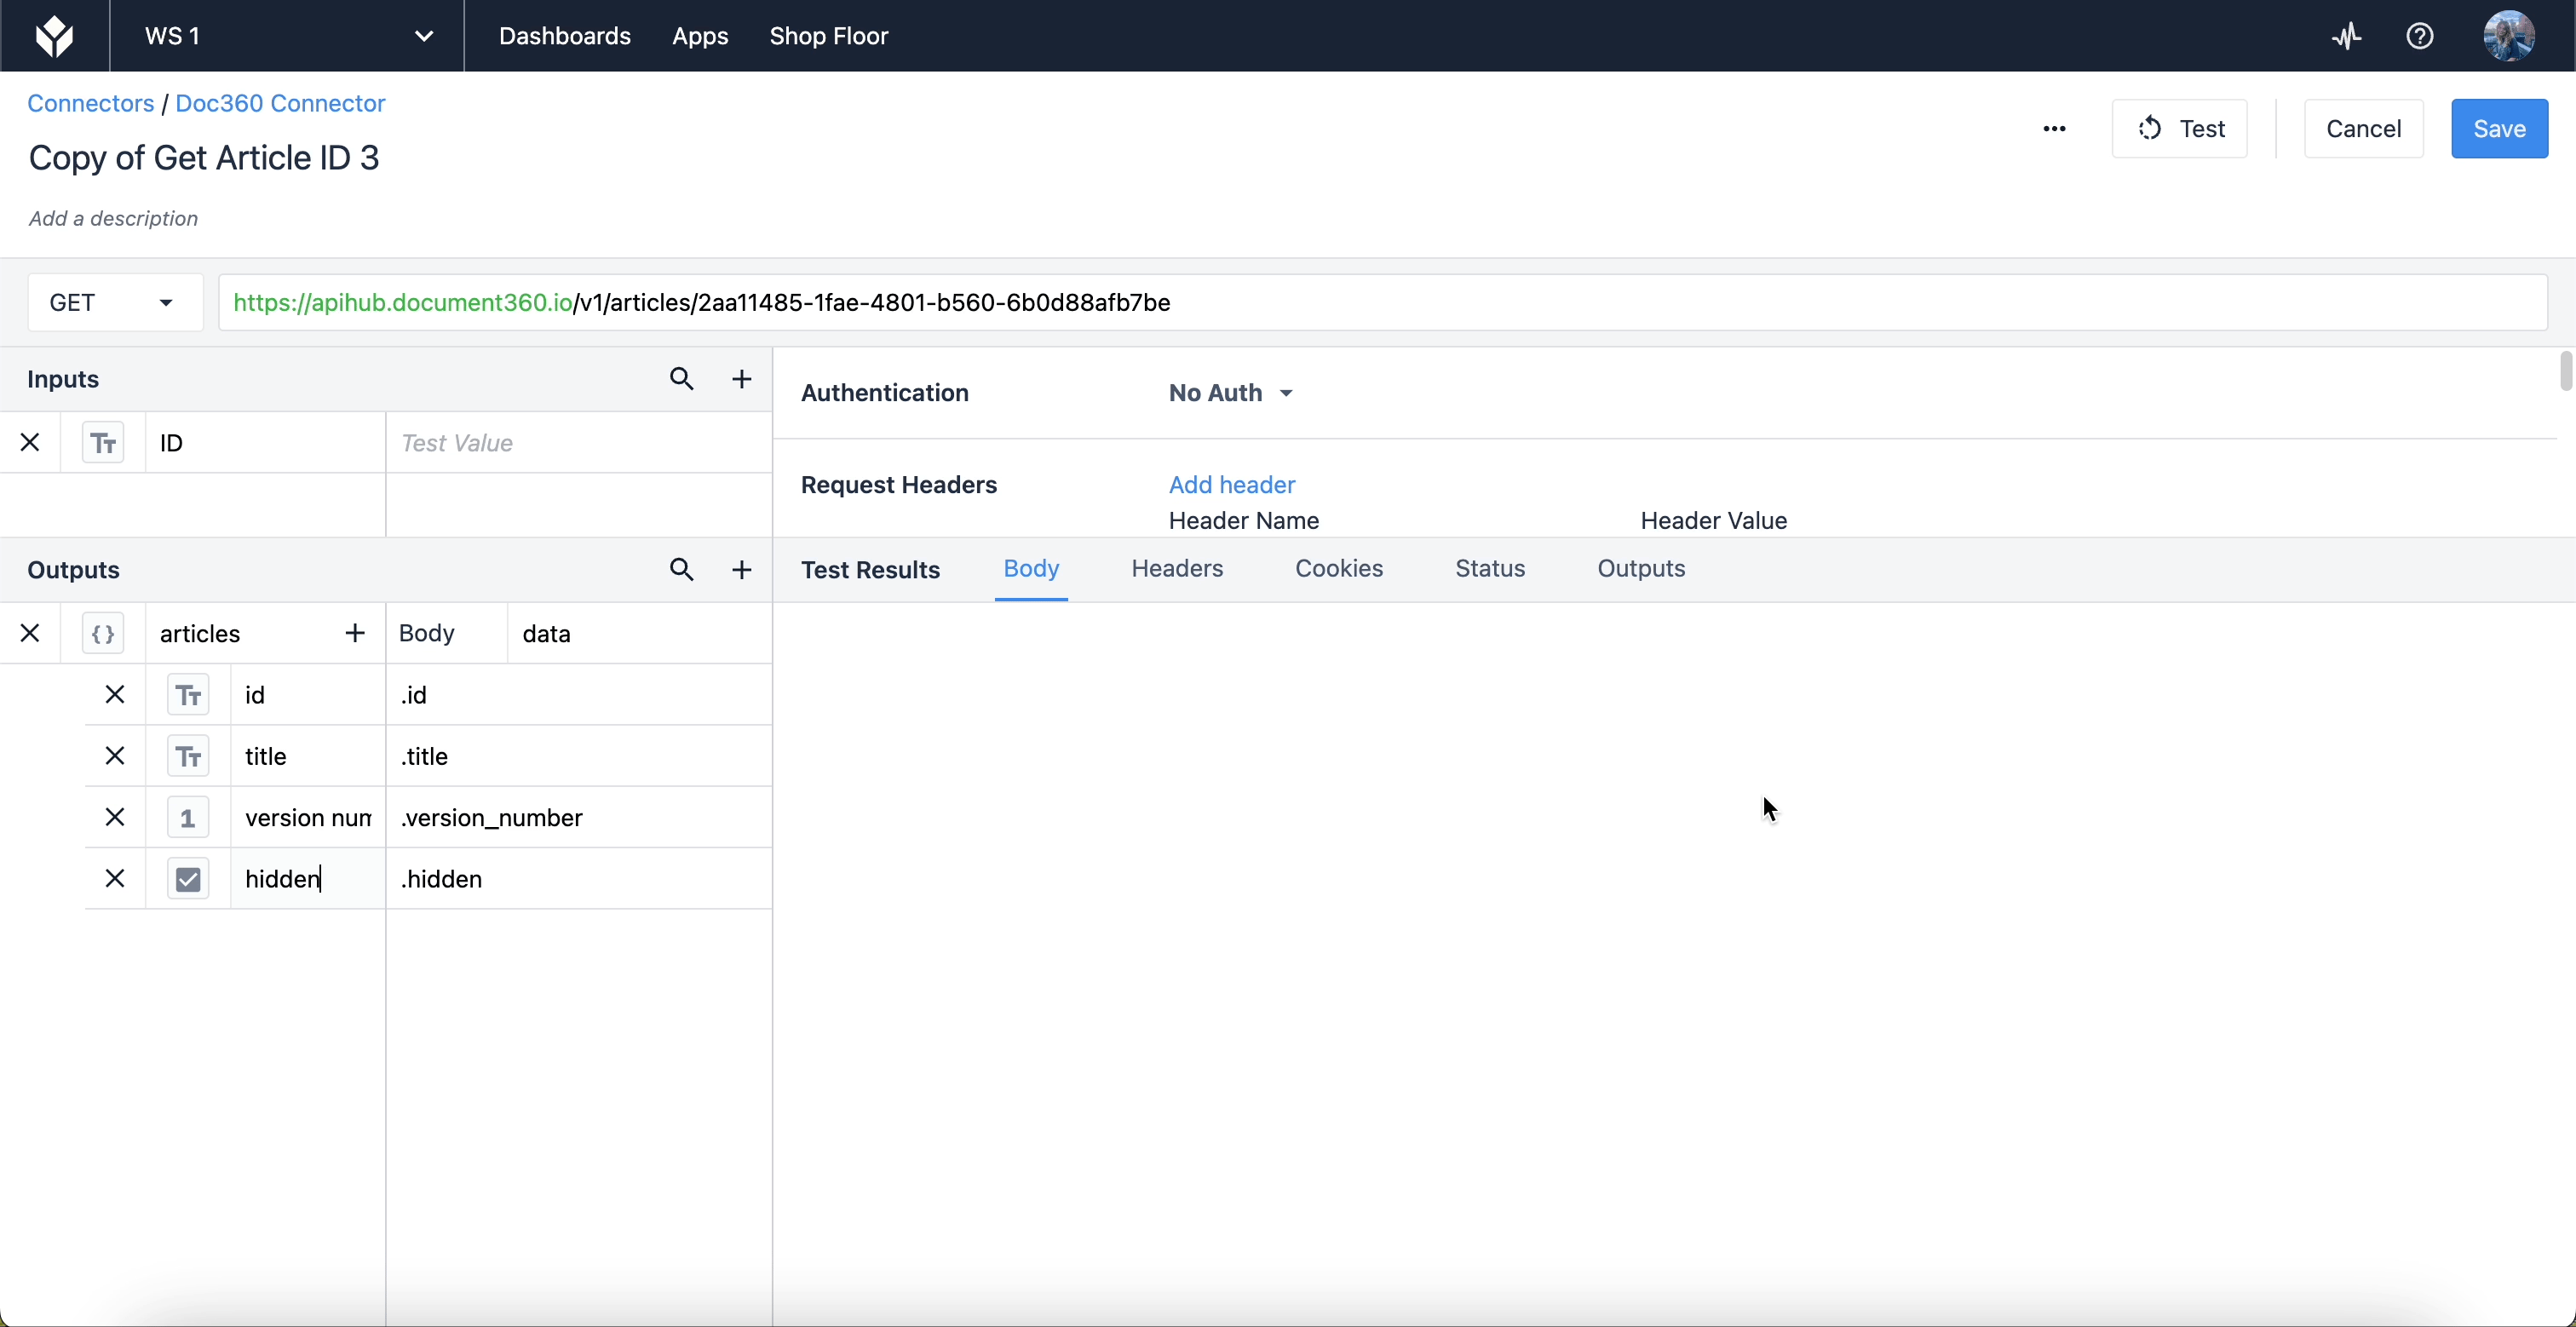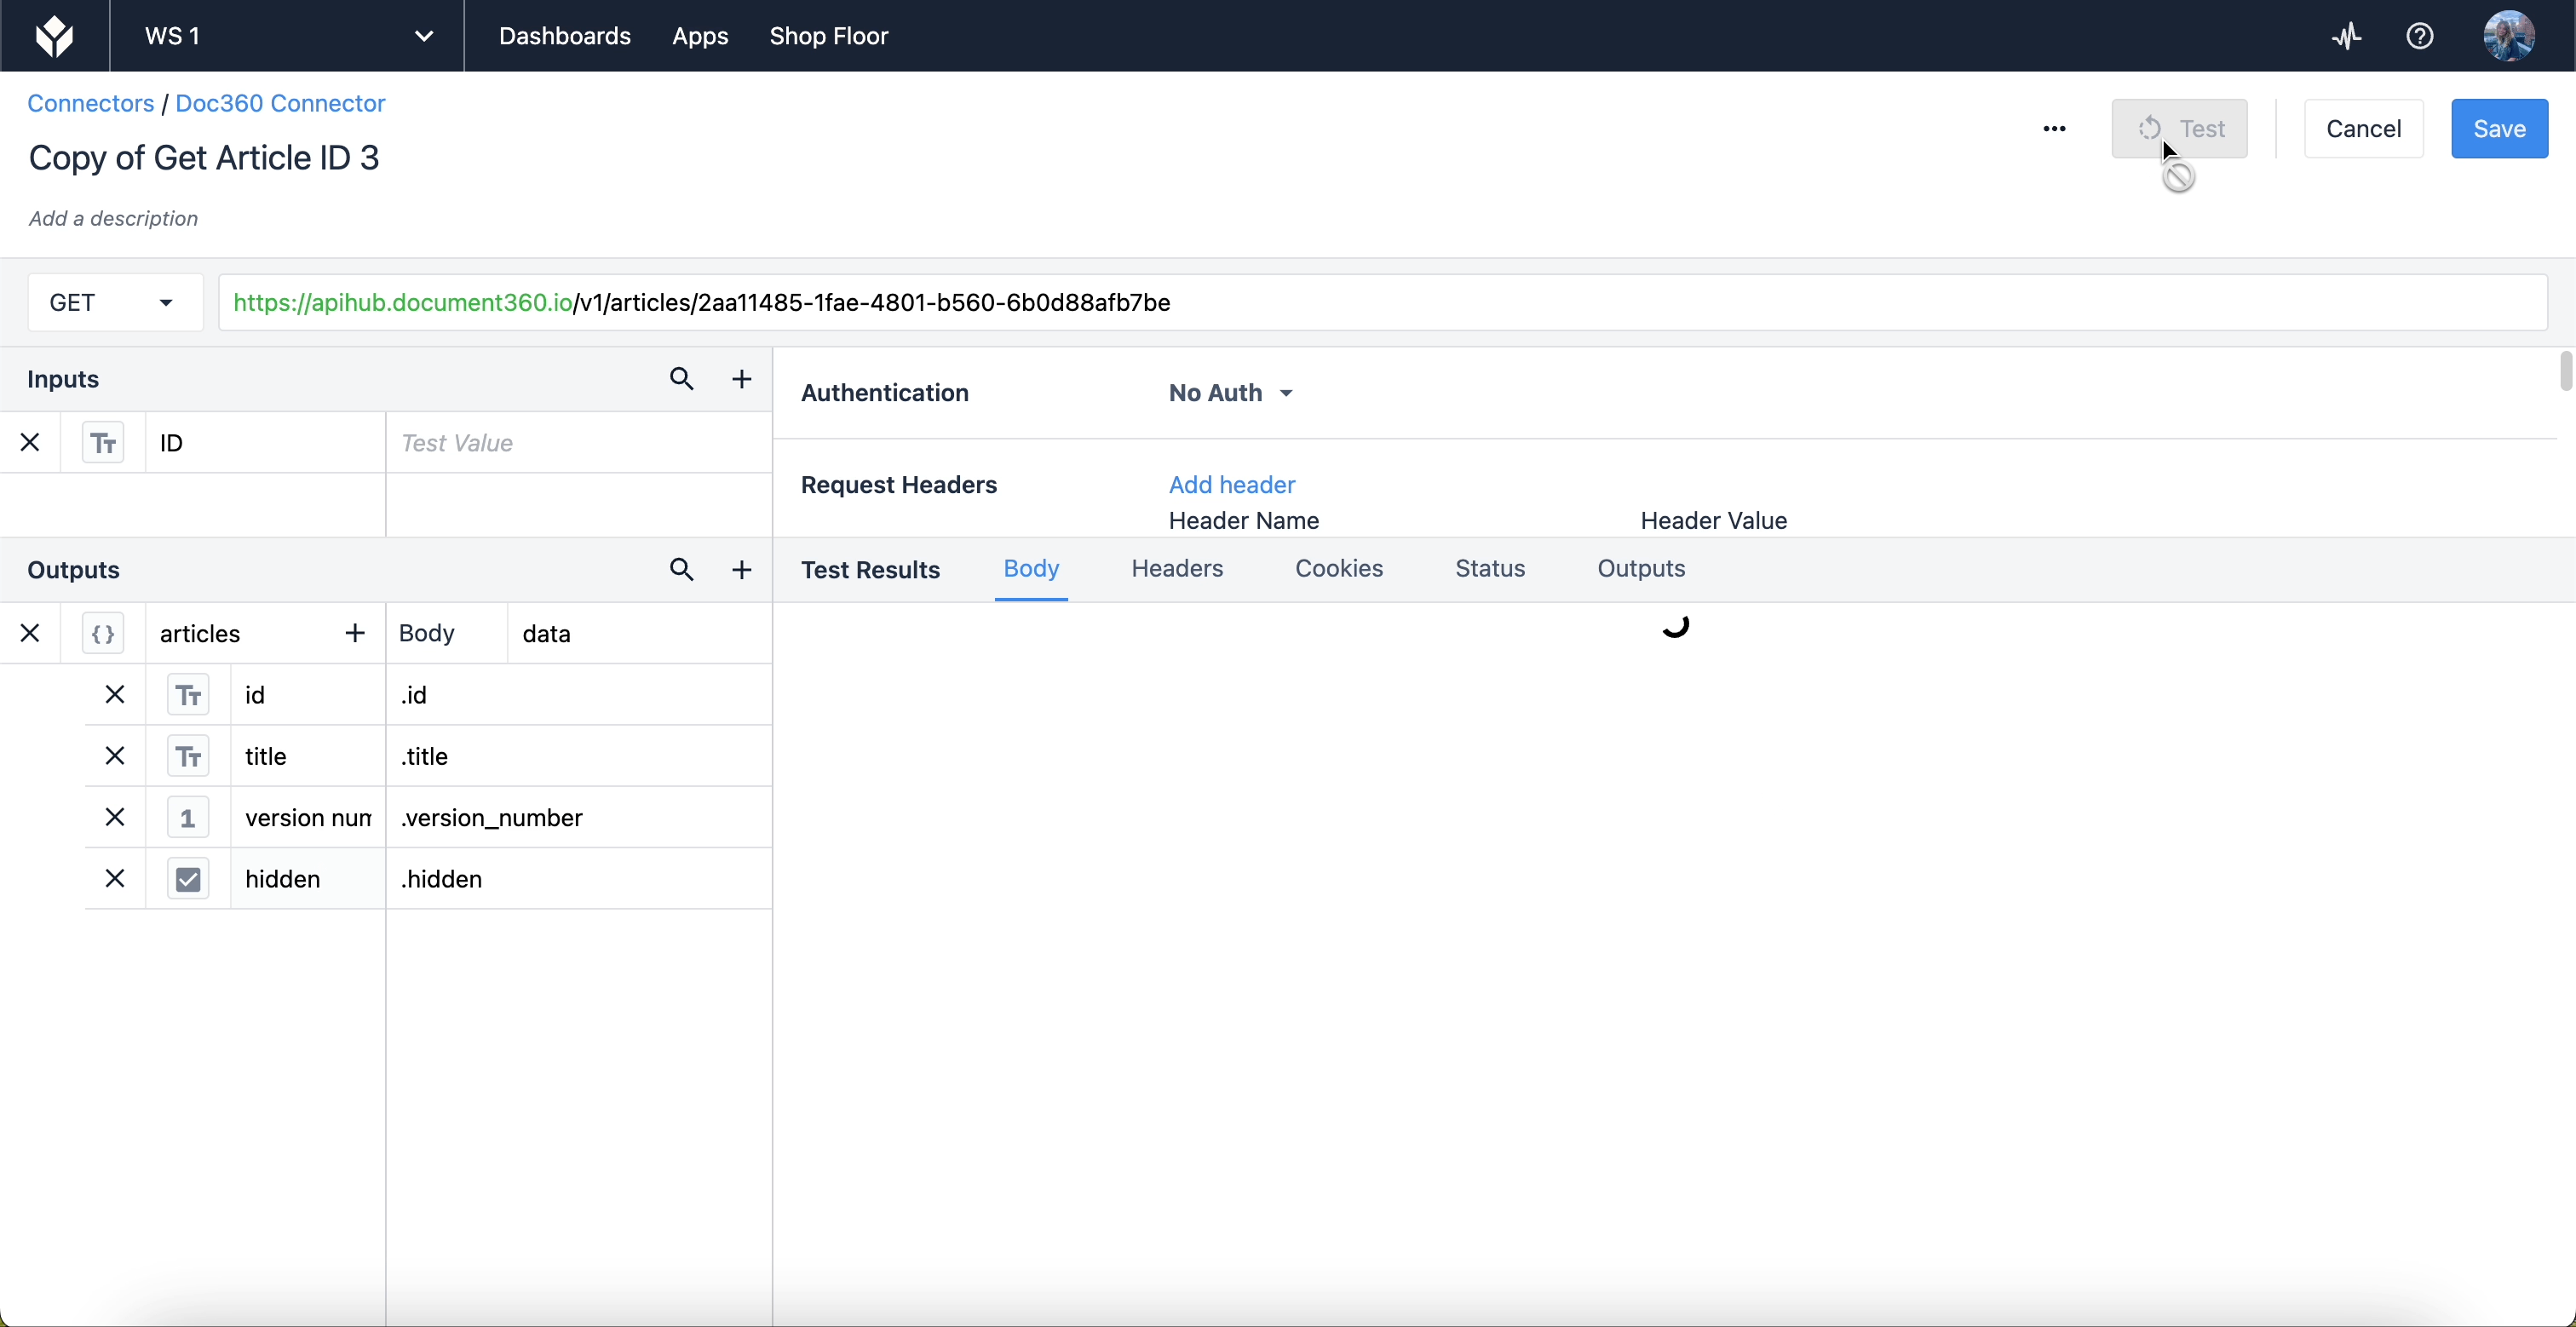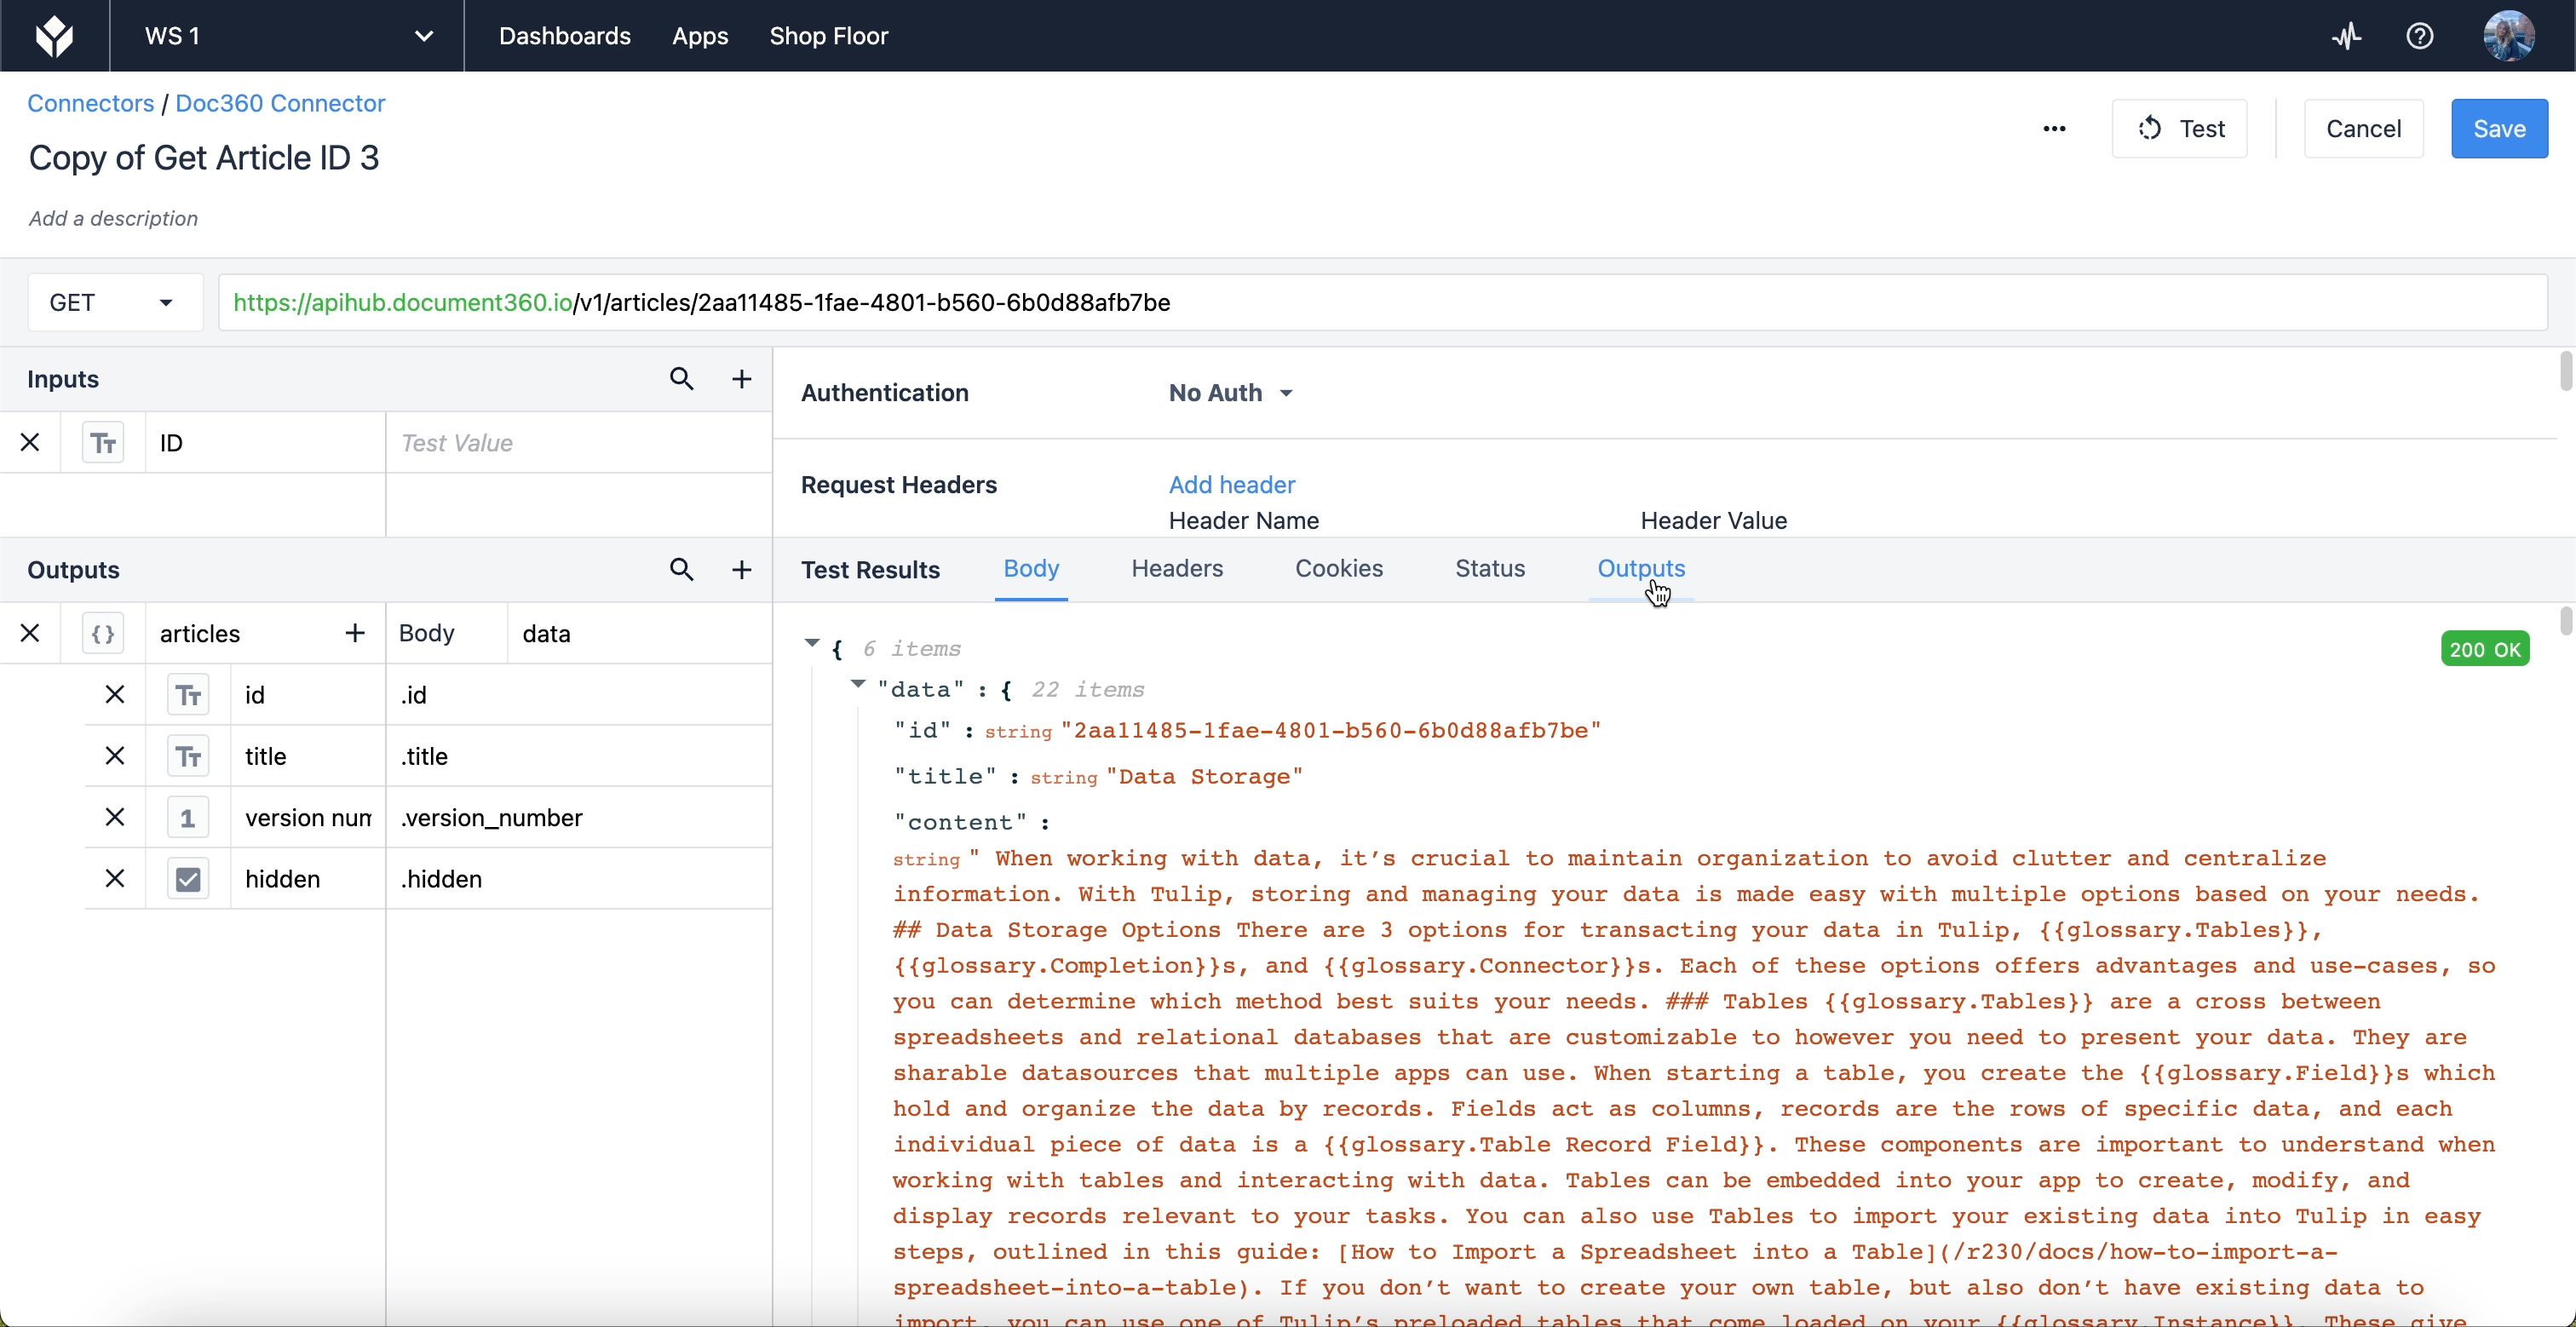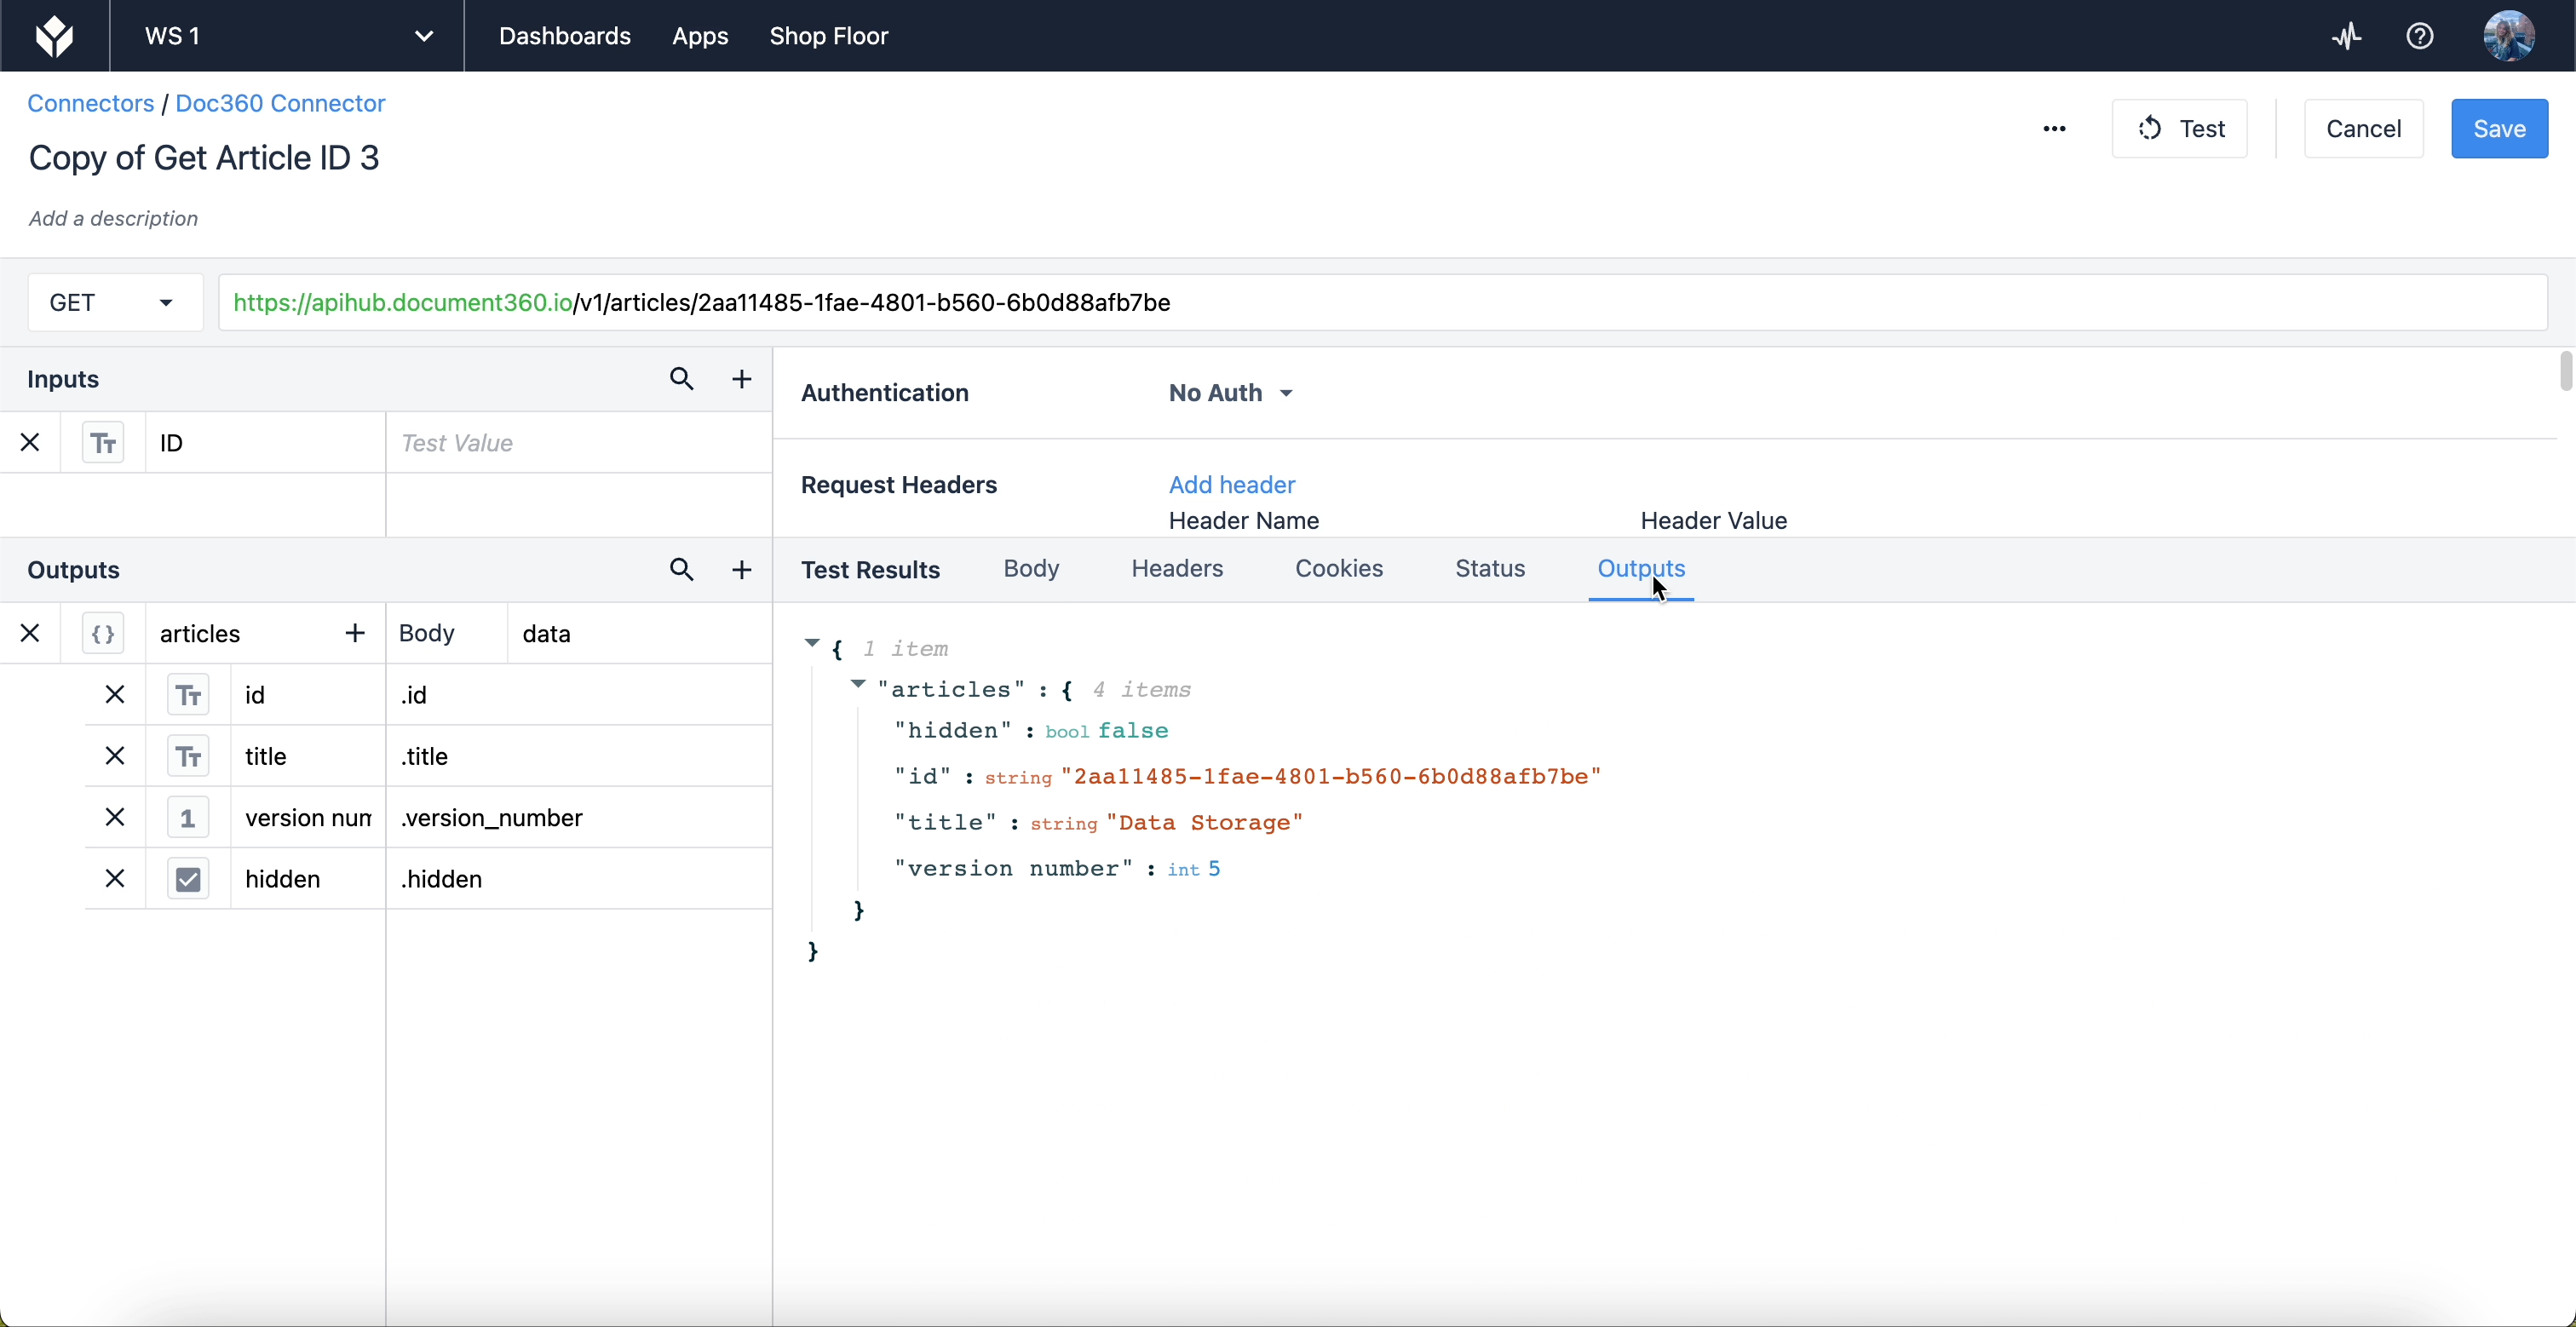
Si nous souhaitions extraire uniquement, par exemple, l’ID, le titre, la version et indiquer si l’article est masqué ou non, nous devrions le spécifier à l’aide des sorties. Voyons à quoi ressemble la notation par points dans la section des sorties de l’éditeur :
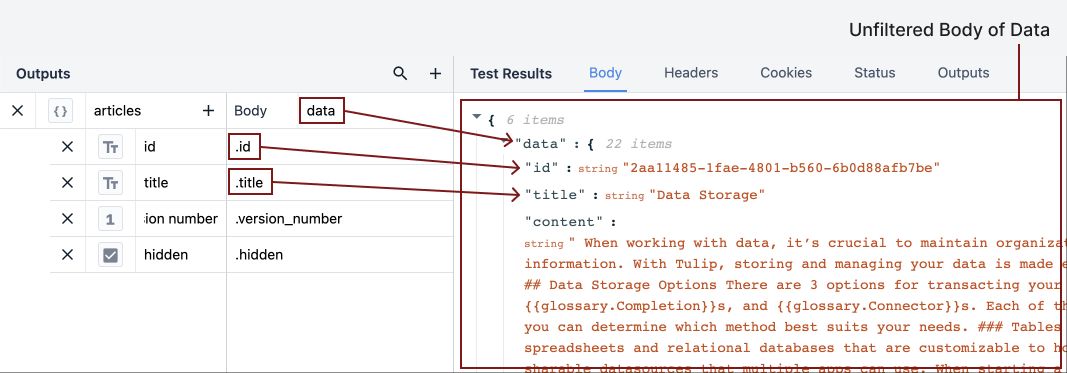
Pour extraire des résultats tels que « id » et « title », nous devons préciser où se trouvent ces résultats dans le JSON. Le corps de la sortie est « data », ce qui correspond au premier menu déroulant de la section « Test Results ». Chaque résultat du menu déroulant « data » est imbriqué dans cet objet. Dans la section « Outputs », un point signifie qu’il faut descendre d’un niveau dans l’objet « data ».
It doesn’t matter whether the dot is placed in the body, or in front of individual properties, so long as there is a dot separating each layer of the JSON.
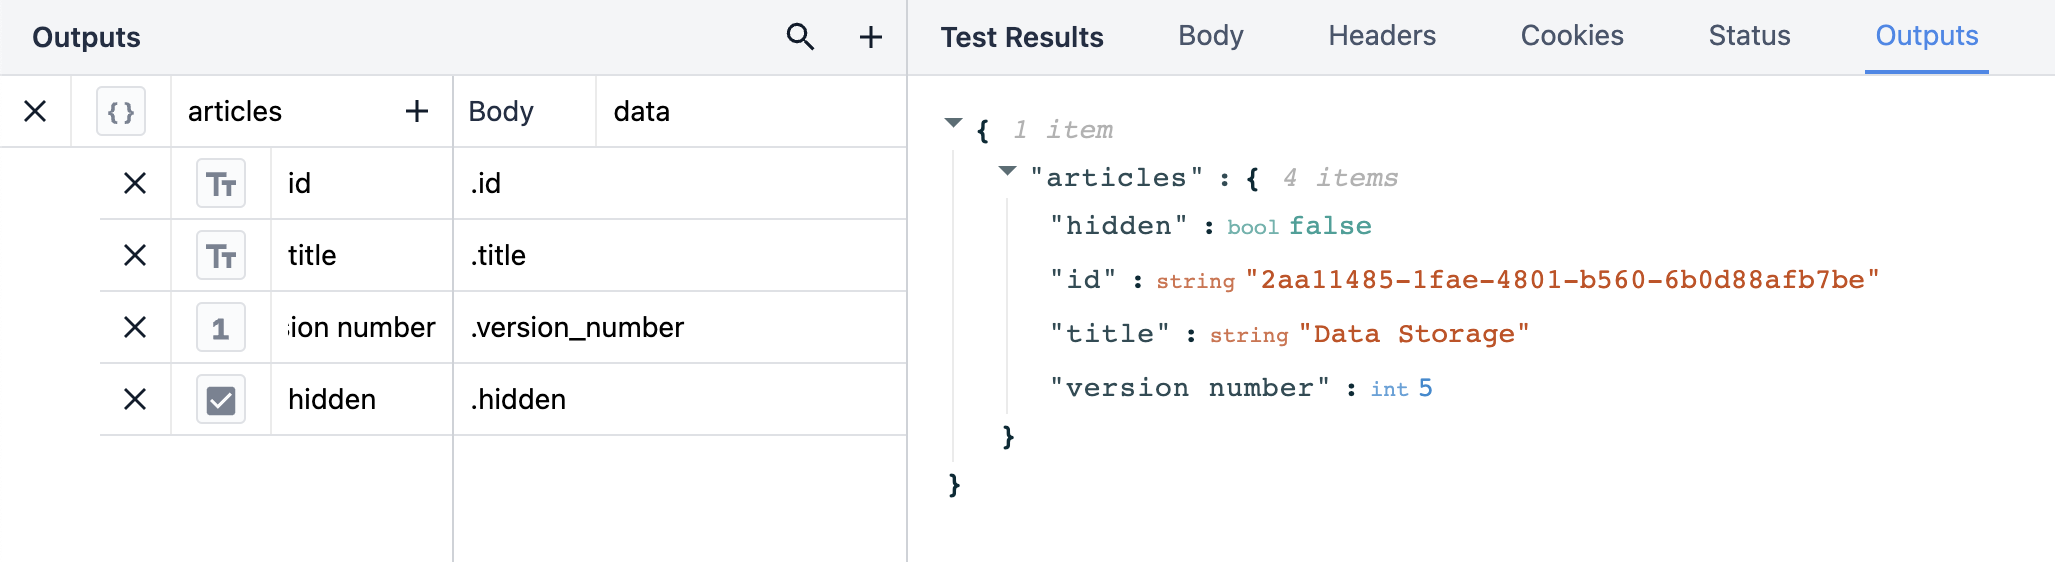
Lorsque nous cliquons sur l’onglet « Outputs » dans la section « Test Results », les sorties filtrent le reste des données afin que nous ne voyions que les informations qui nous intéressent.
Une autre façon d’écrire vos sorties consiste à les regrouper sur une seule ligne. Cela permet d’afficher le chemin complet en une seule requête.
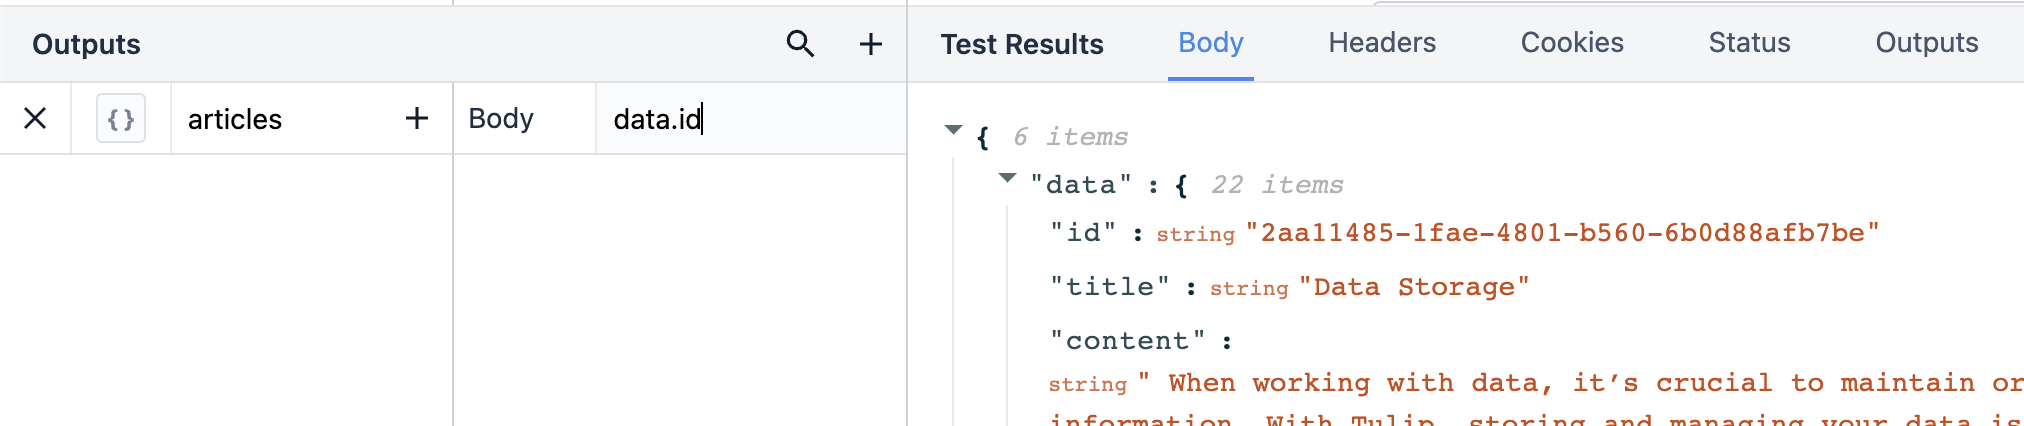
Pour faciliter la saisie du chemin de sortie, vous pouvez également cliquer sur une ligne de données afin de l’ajouter en tant que nouvelle sortie.
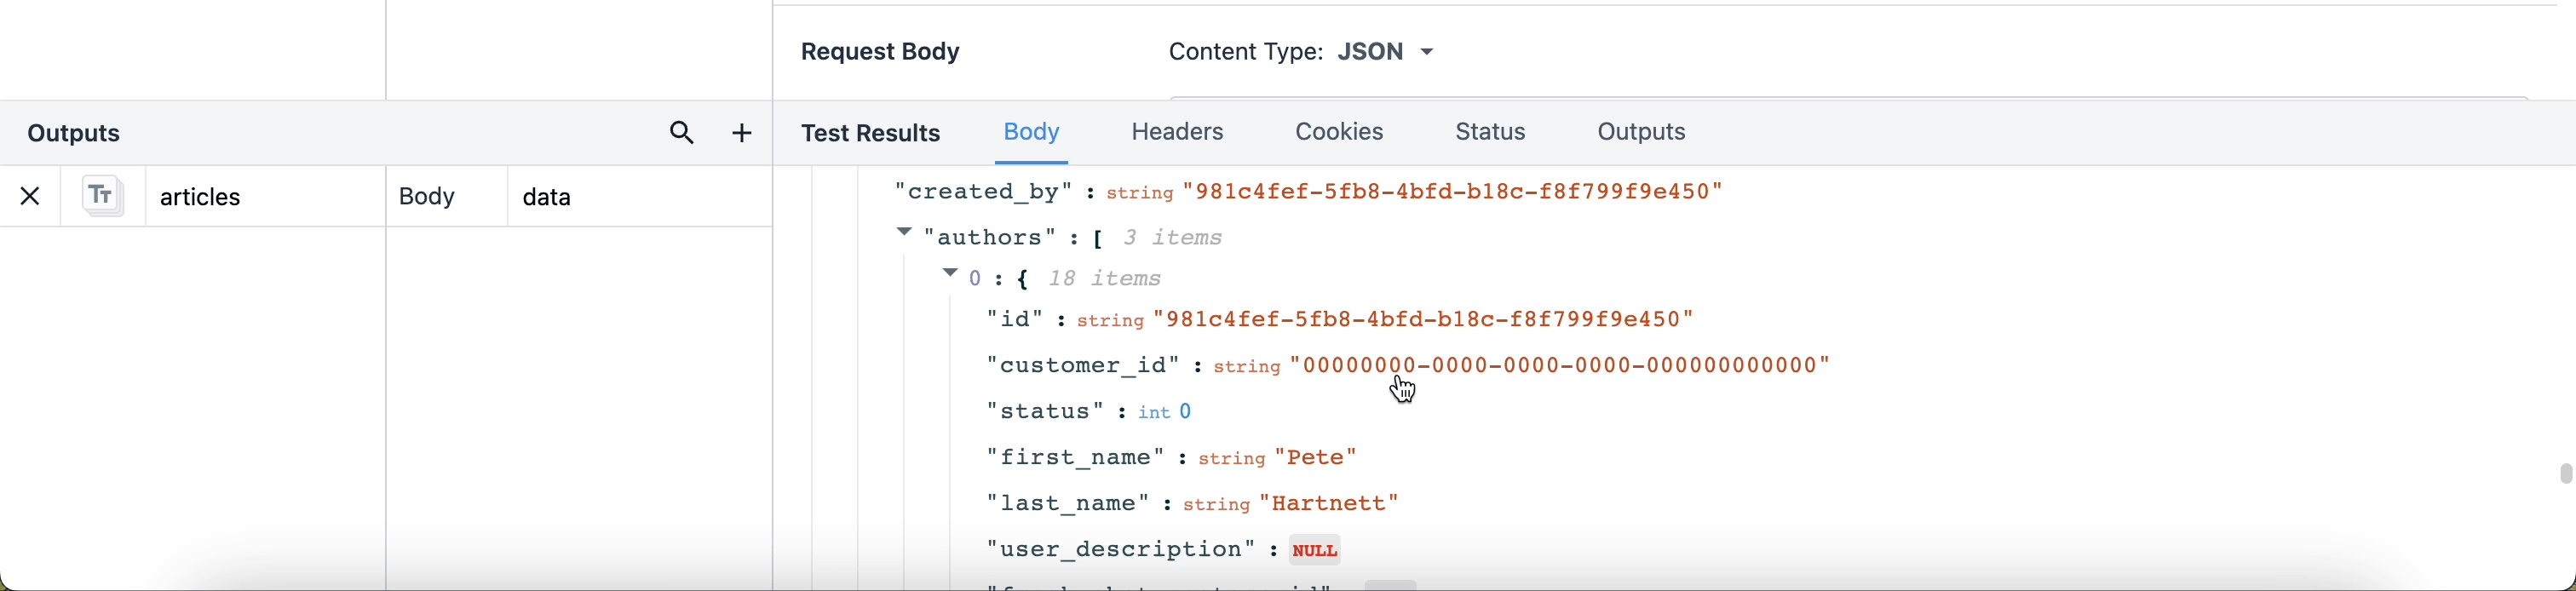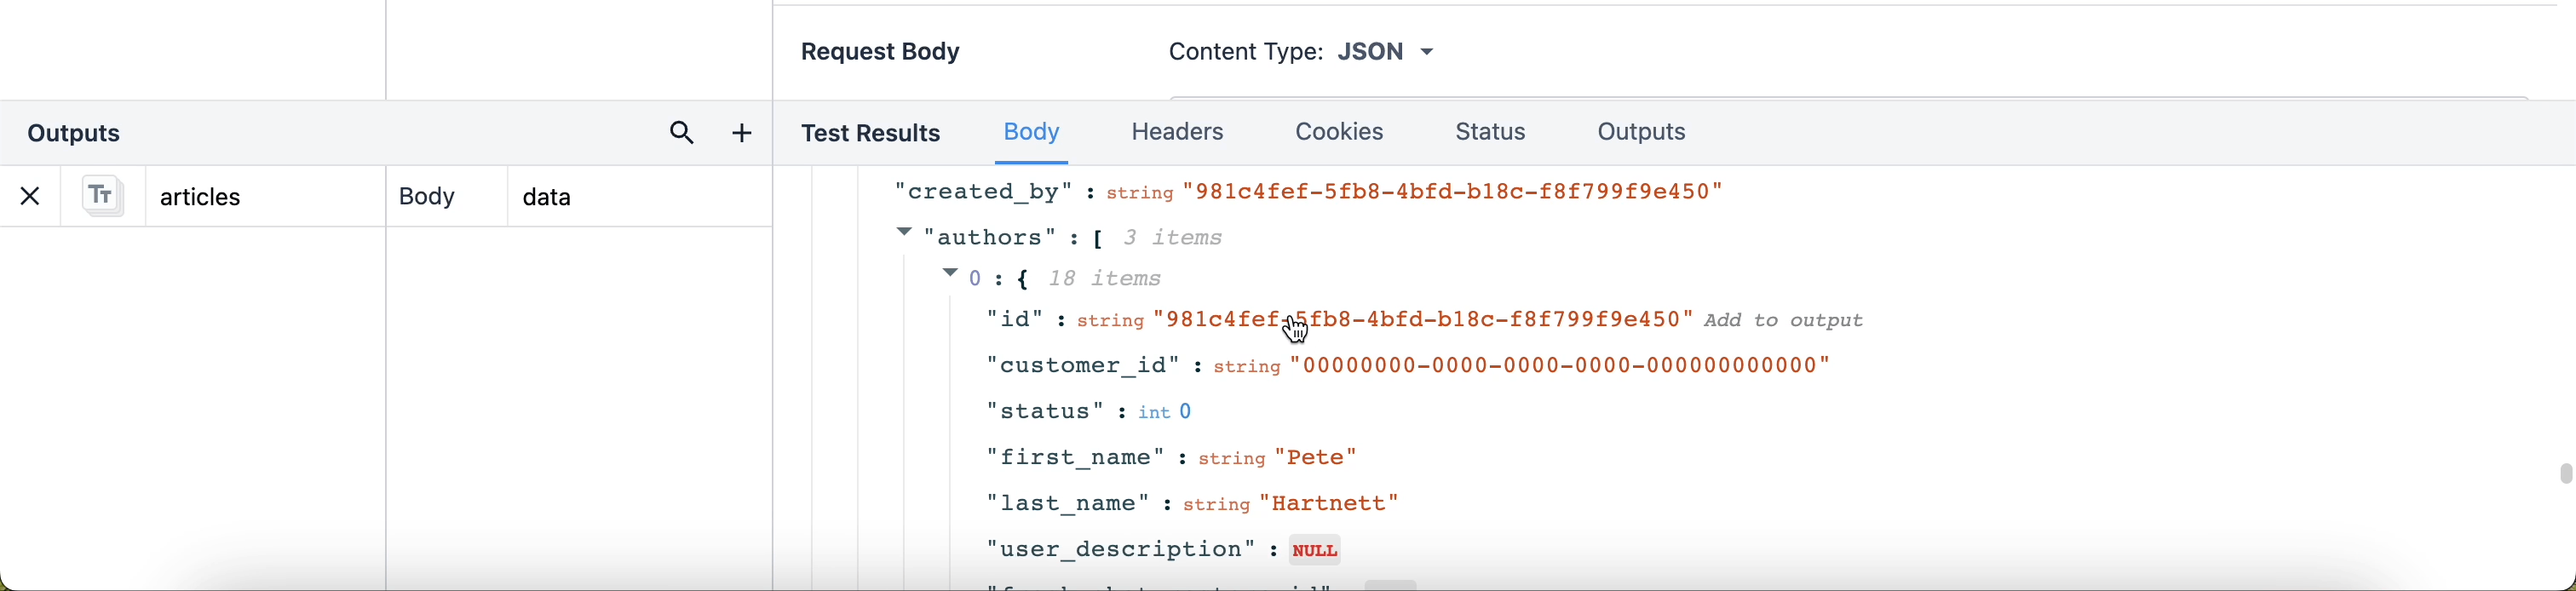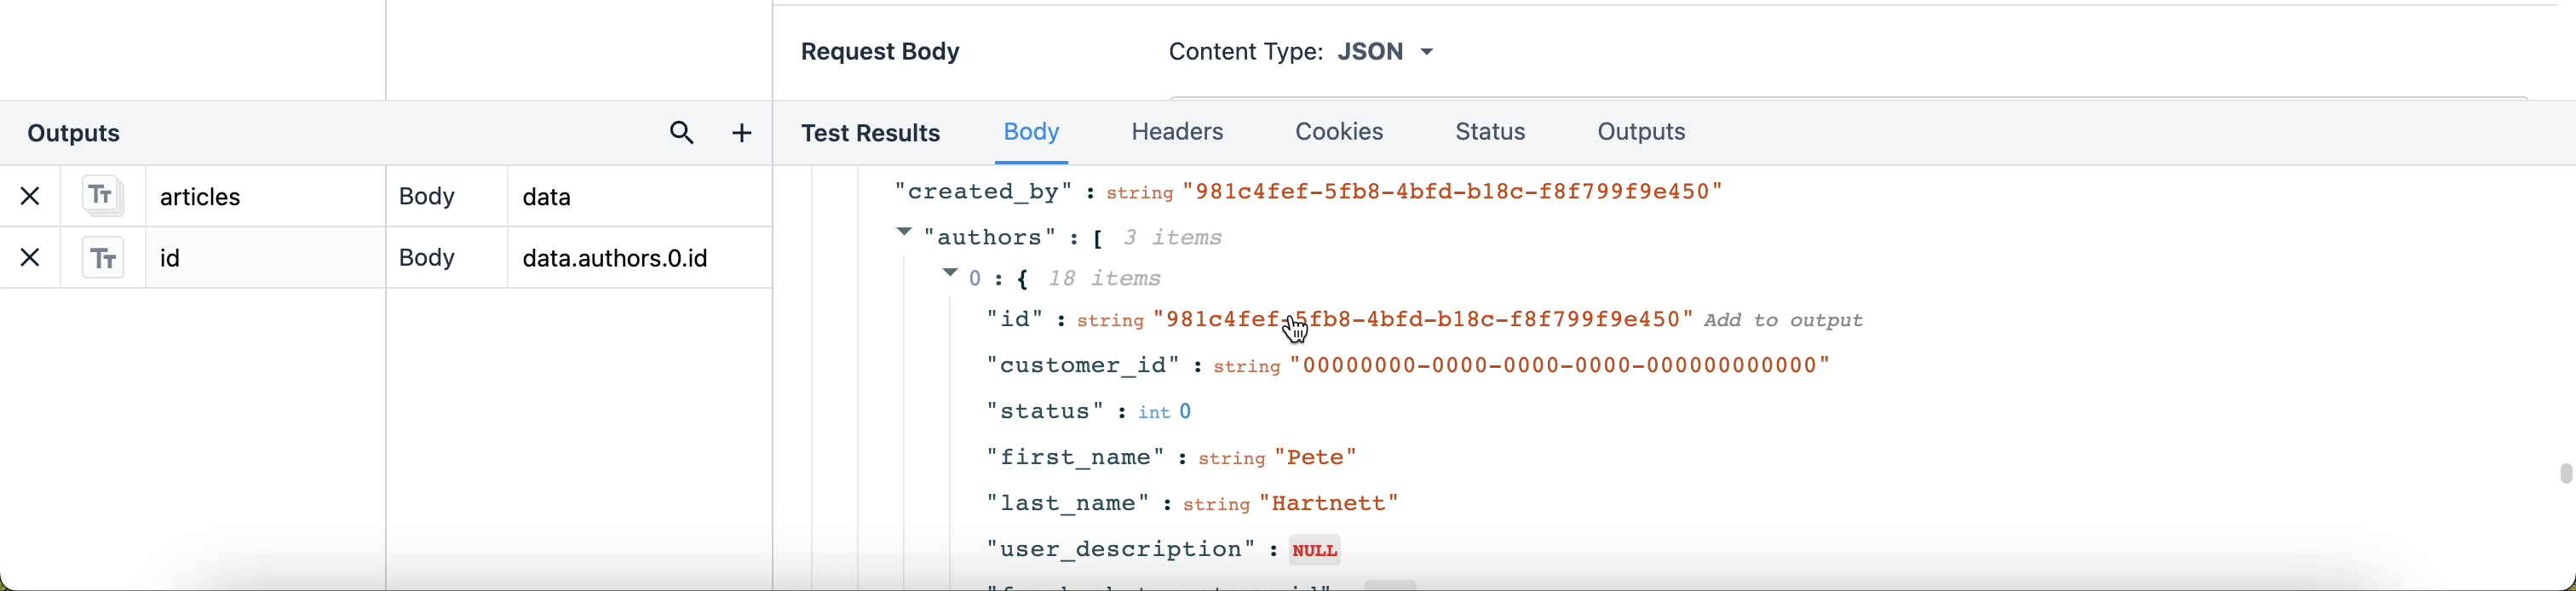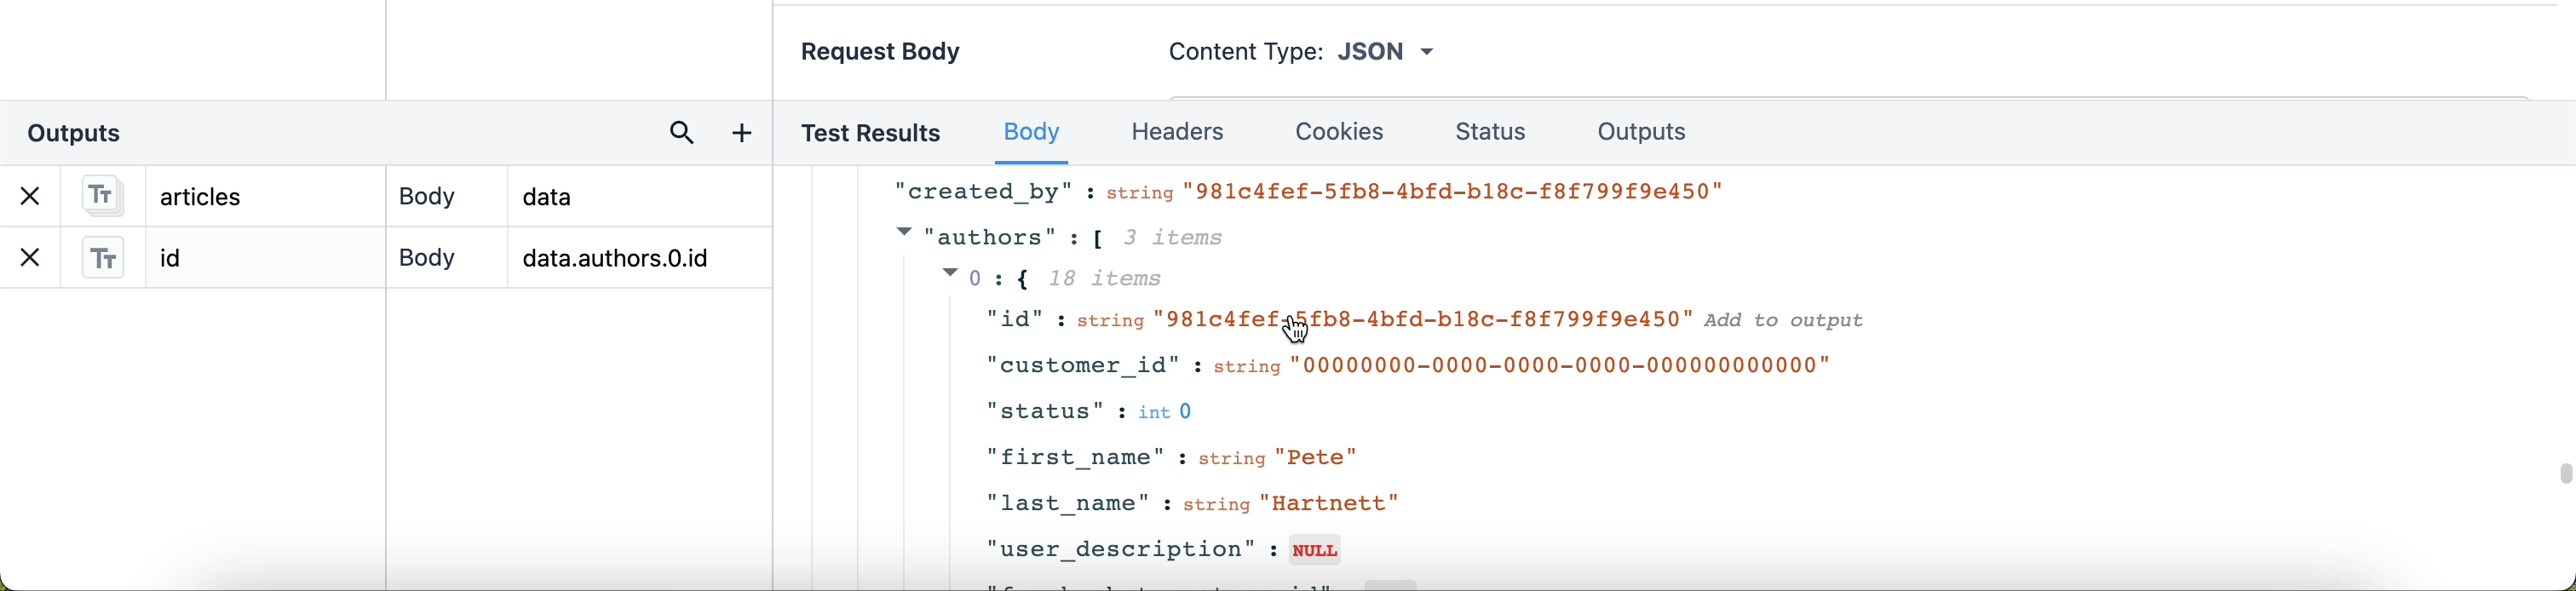
Pour plus d’informations sur l’utilisation de la notation par points, consultez cette ressource : Processmaker : Notation par points JSON.
Résultats de sortie
Il existe plusieurs façons de structurer les sorties, mais la méthode que vous choisirez dépendra entièrement de ce que vous souhaitez faire avec les données dans vos applications. Avant de commencer à structurer les sorties, réfléchissez à votre objectif final. Souhaitez-vous afficher plusieurs types de données dans des variables individuelles ? Ou disposez-vous des mêmes types de données dans un tableau que vous souhaitez simplement analyser pour en extraire les informations pertinentes ?
Les exemples suivants reposent tous sur la même fonction de connecteur, et dans chaque cas, le corps des résultats du test est identique. Les sorties, en revanche, varient en fonction de leur structure.
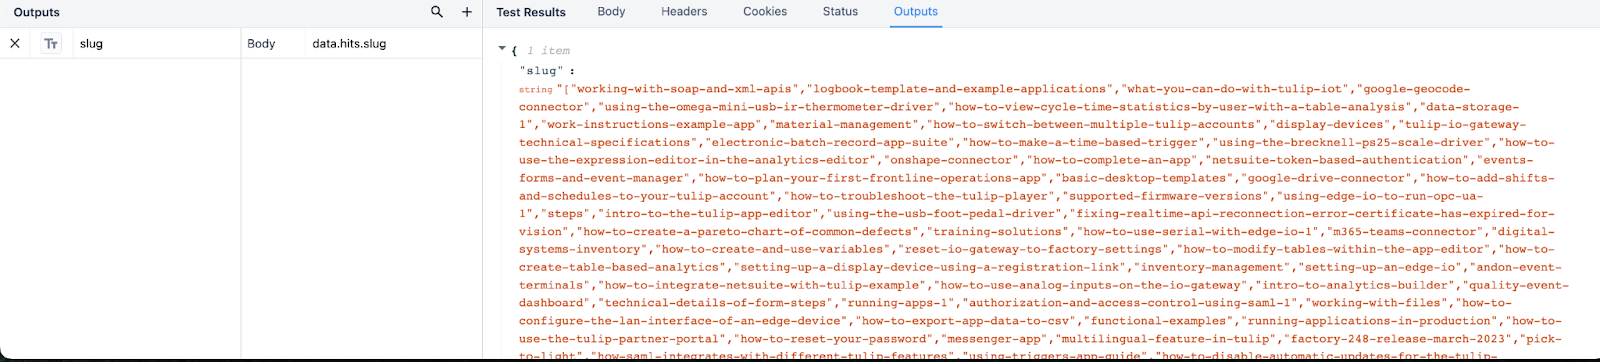
L’exemple suivant montre comment le connecteur génère la sortie pour le chemin JSON data.hits.slug. Compte tenu de la structure de cette sortie, le connecteur renvoie un grand tableau contenant tous les slugs d’URL des articles de la base de connaissances. Dans nos applications, cette sortie du connecteur sera accessible via une variable de type tableau.
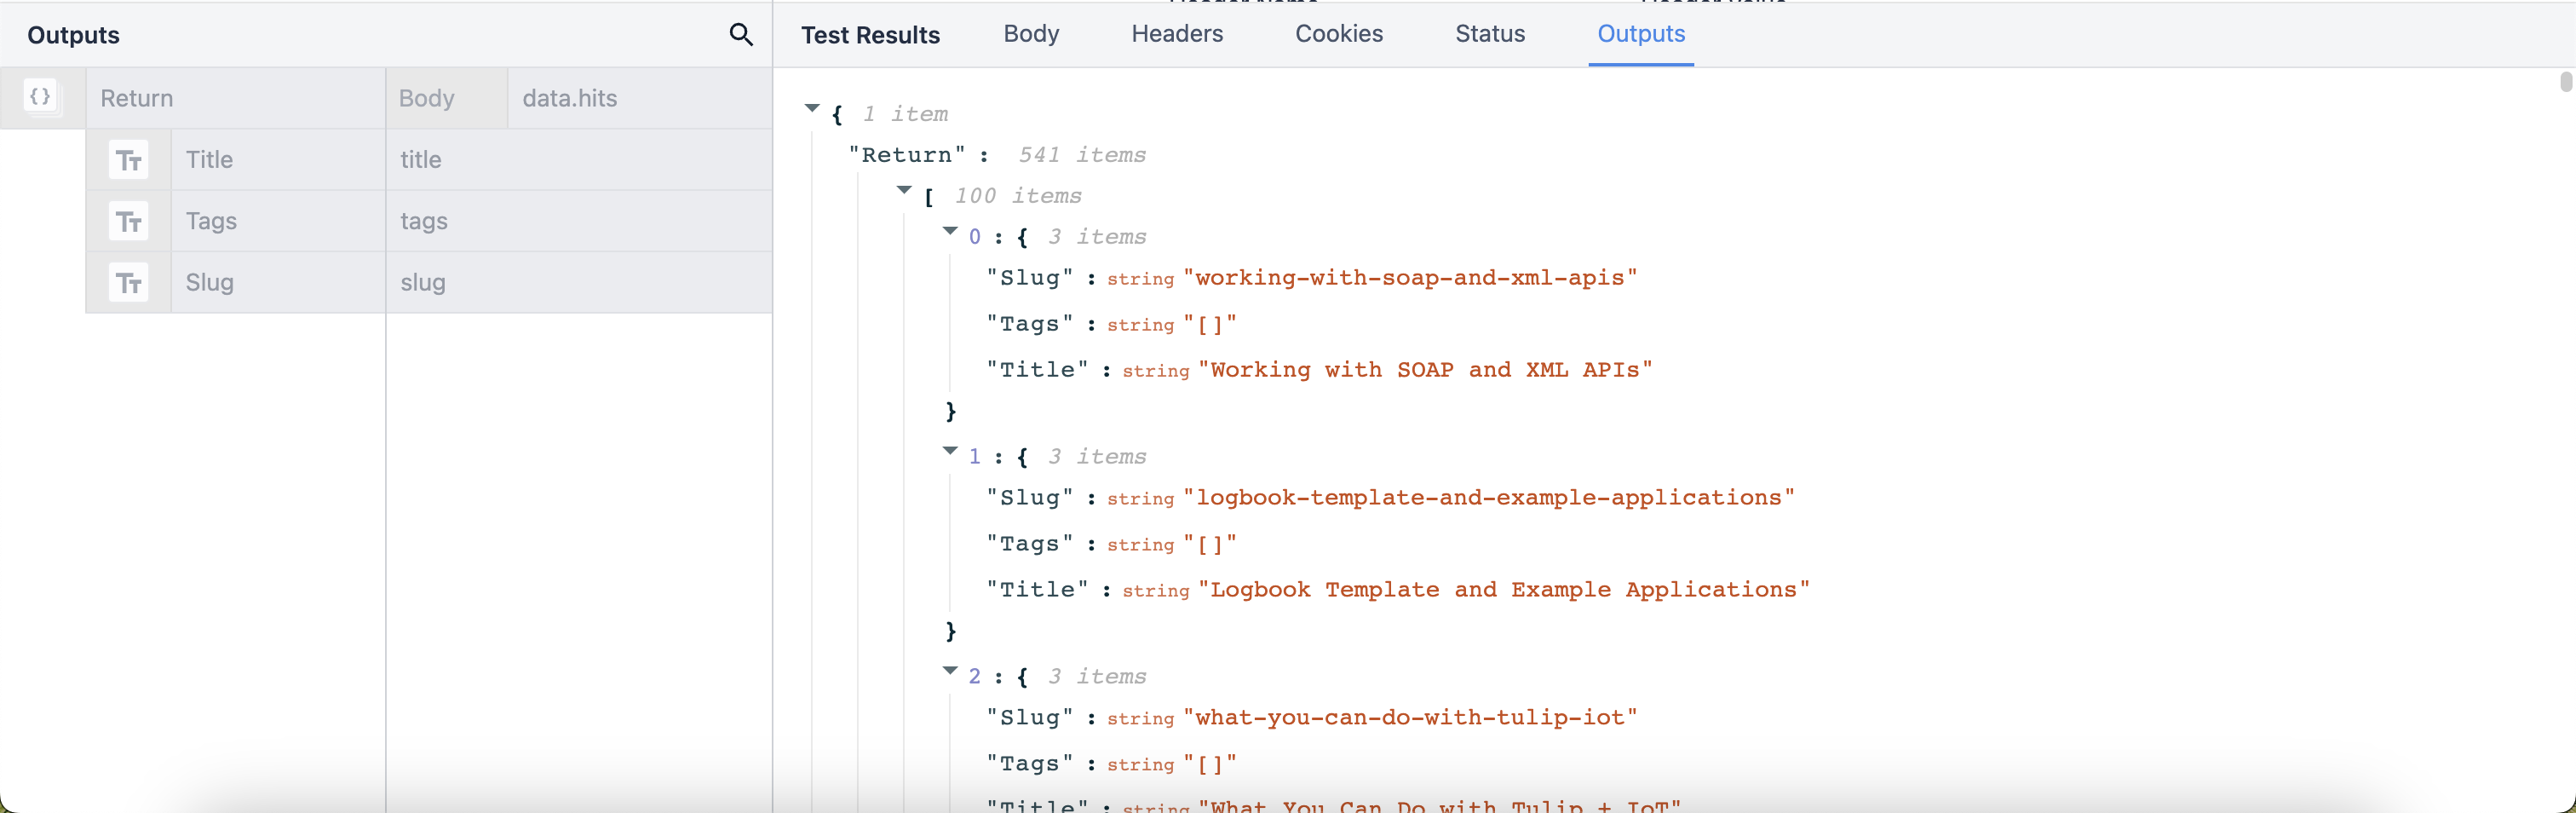
Nous pouvons structurer les résultats sous forme de liste d’objets et extraire des types de données individuels des résultats, créant ainsi plusieurs objets de données qui peuvent être affichés individuellement dans les applications.
Les listes d’objets sont des objets qui contiennent plusieurs types de données imbriqués. Pour utiliser des listes d’objets, cliquez sur le type de sortie et activez le bouton « Liste » situé dans le coin droit.
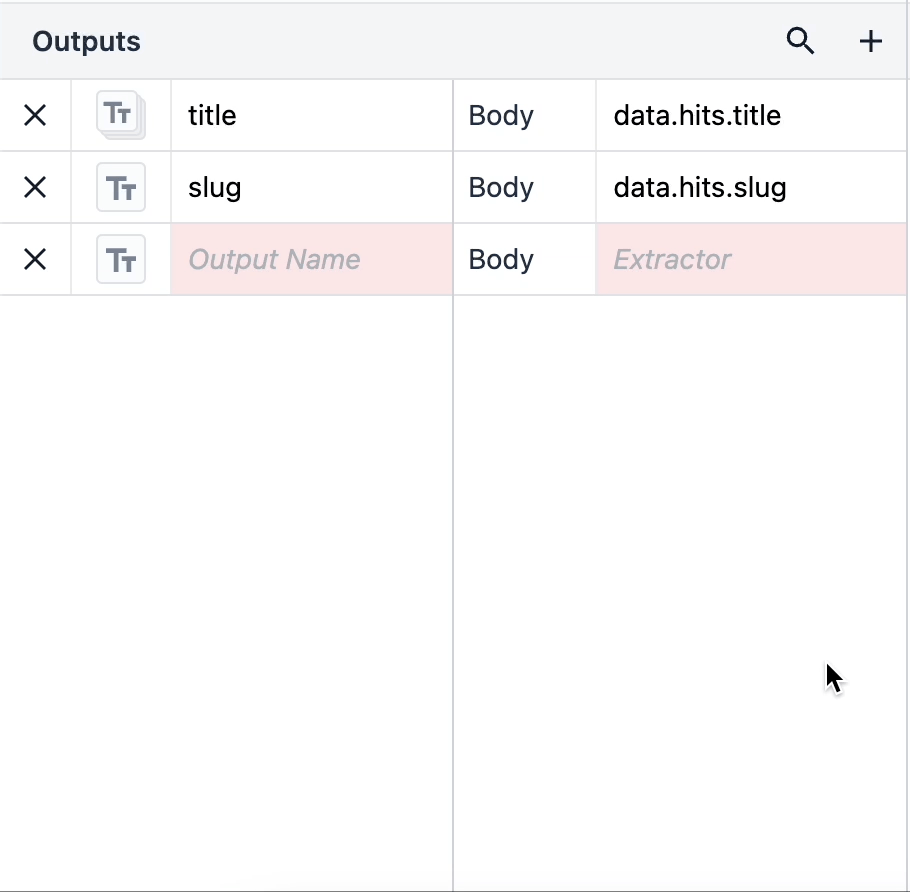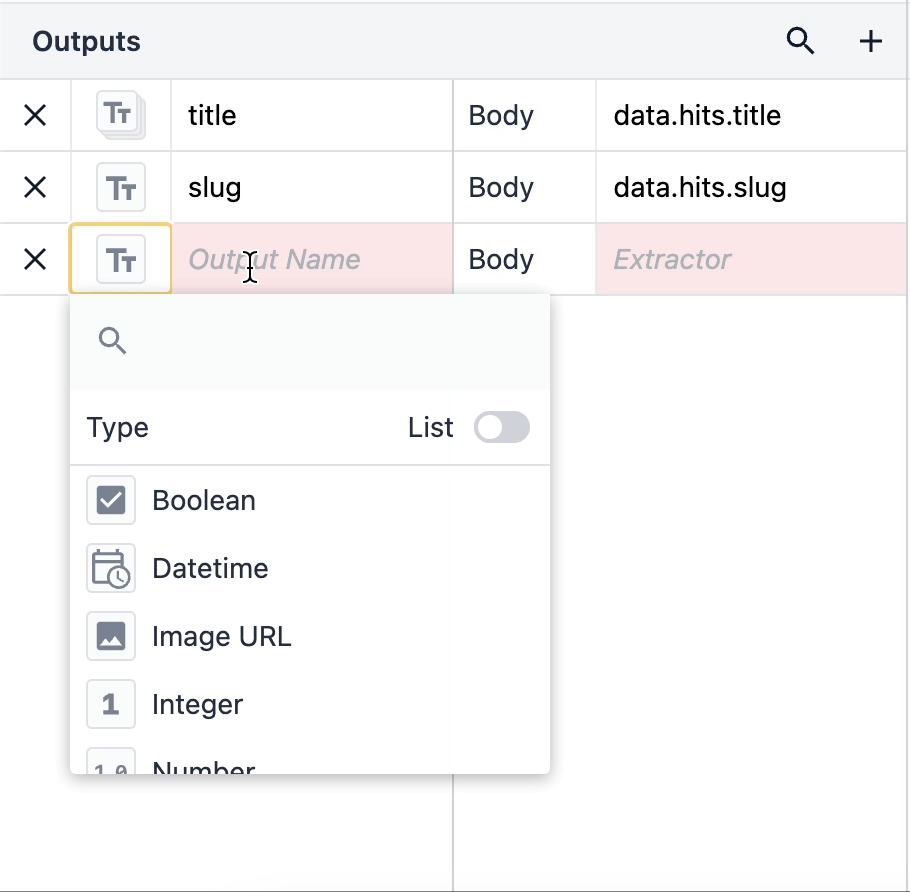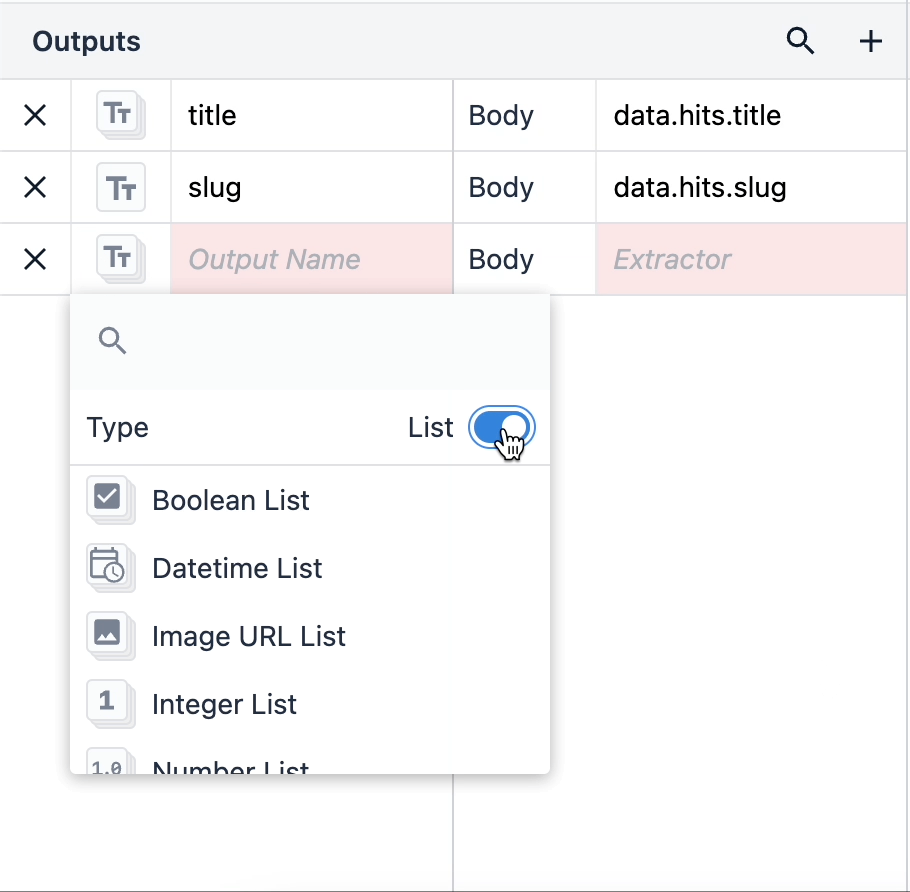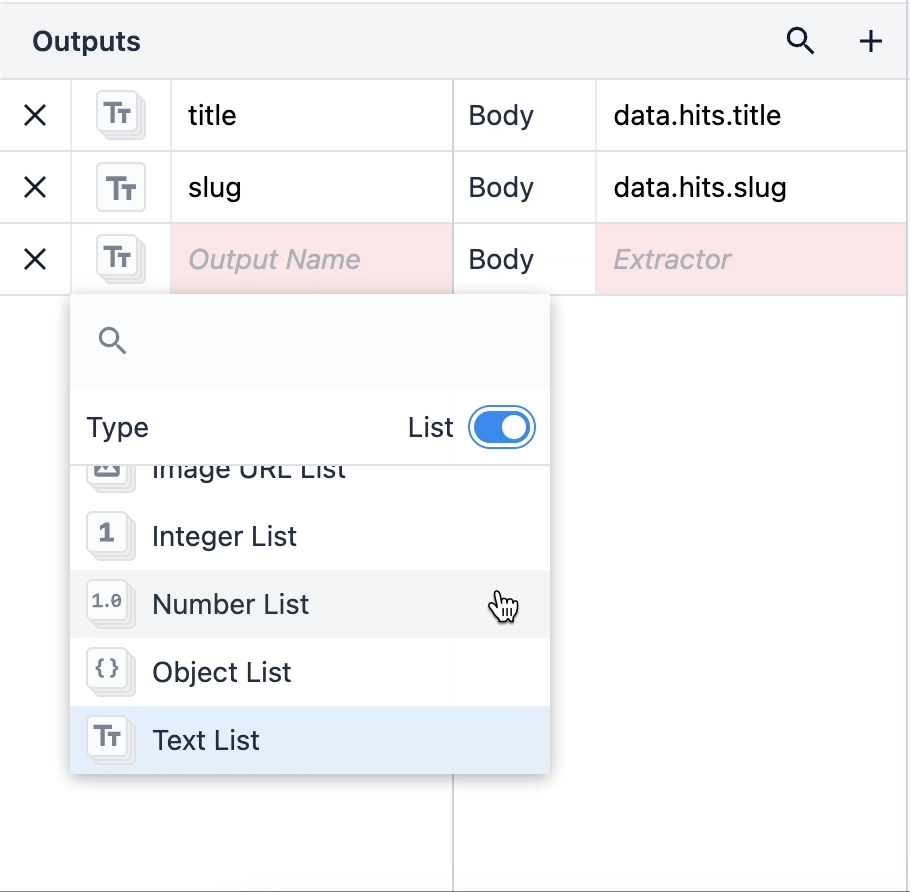
Lorsque vous disposez d’une liste d’objets, vous pouvez facilement utiliser différents types de données comme des éléments de données individuels dans vos applications.
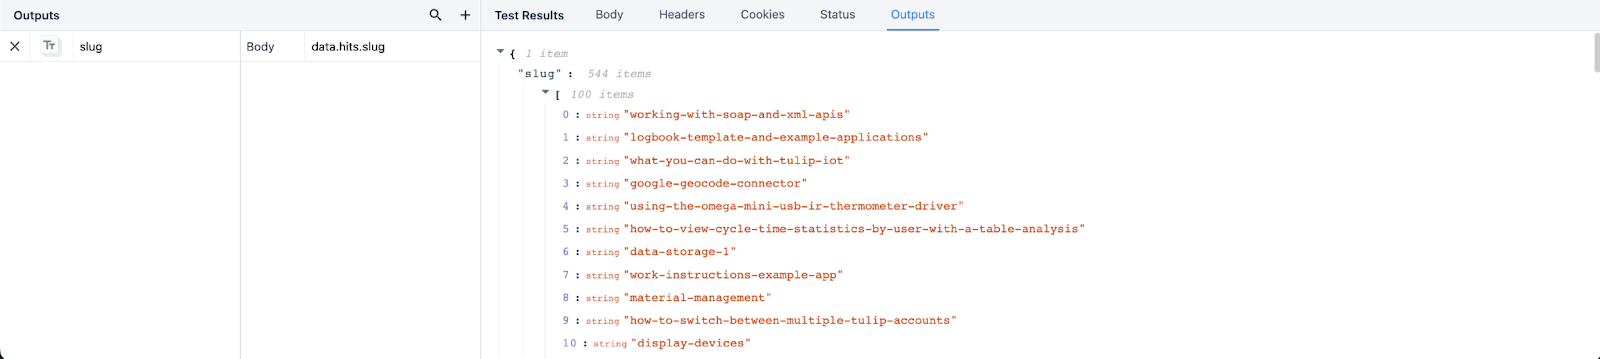
Si nous reprenons l’exemple ci-dessus, transformons notre chemin de sortie data.hits.slug en liste. Vous pouvez voir dans les résultats ci-dessous que Tulip structure le résultat de ce connecteur sous la forme d’un tableau de slugs, chaque position d’index étant indiquée à côté de chaque valeur.
Fort de cette compréhension des sorties, vous pouvez désormais mapper les sorties à vos propres fonctions de connecteur et optimiser les résultats renvoyés par vos connecteurs !
Utilisez Tulip AI pour l’extraction des sorties
Structurez rapidement vos sorties en tirant parti des exemples et des concepts déjà abordés dans cet article, tels que la ( et la liste d’objets).
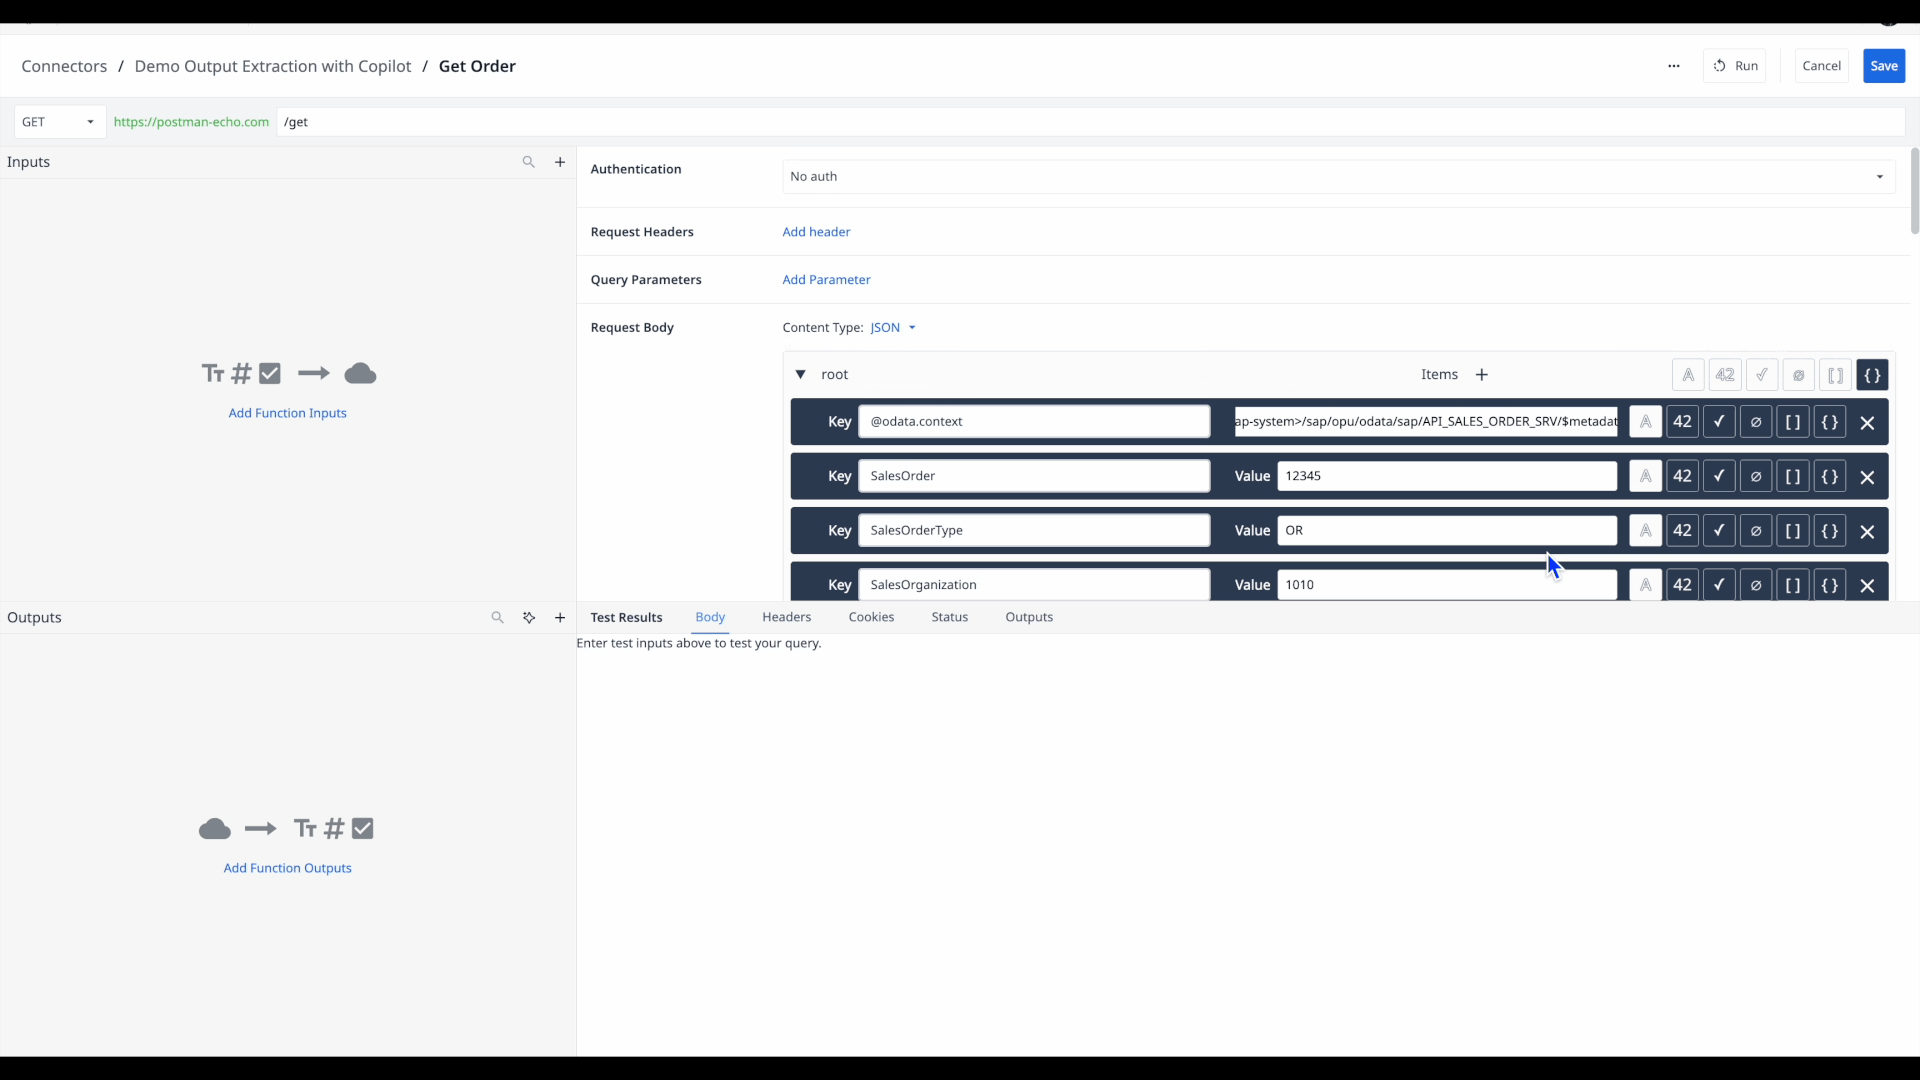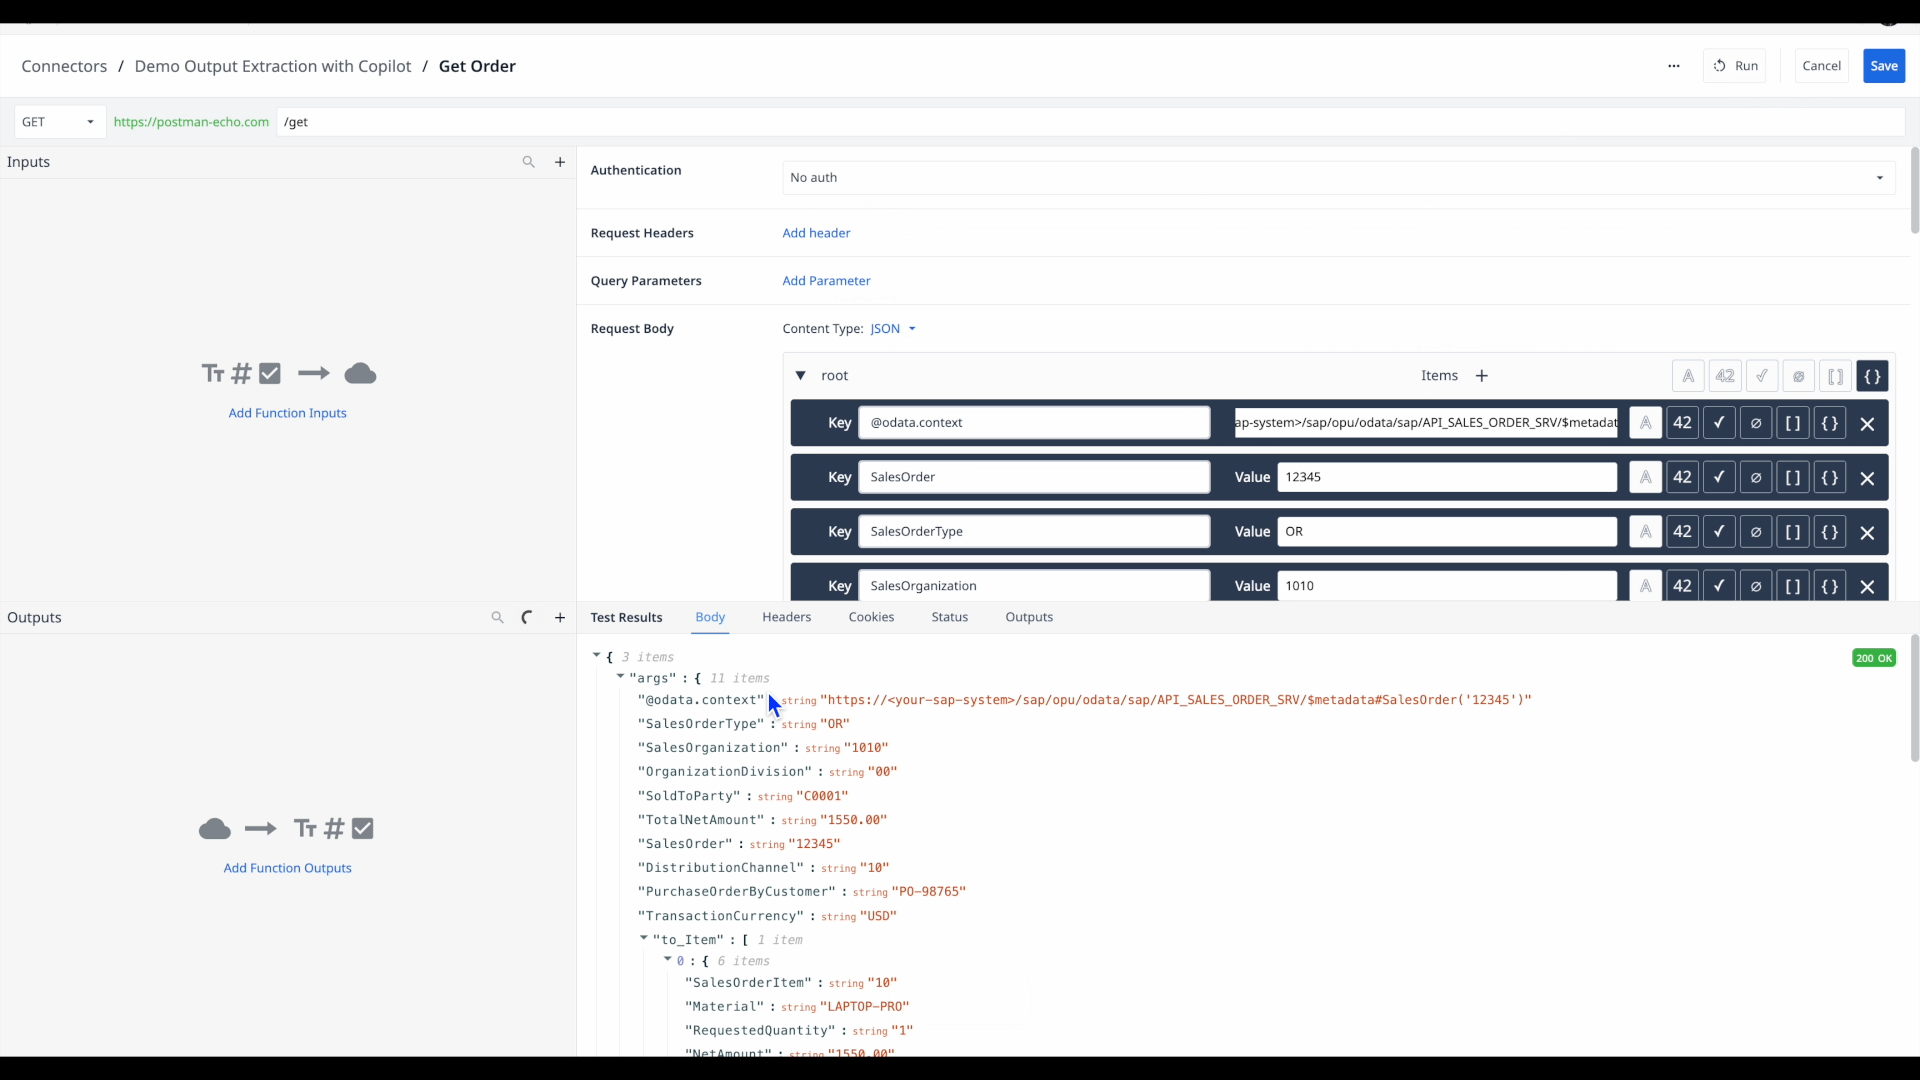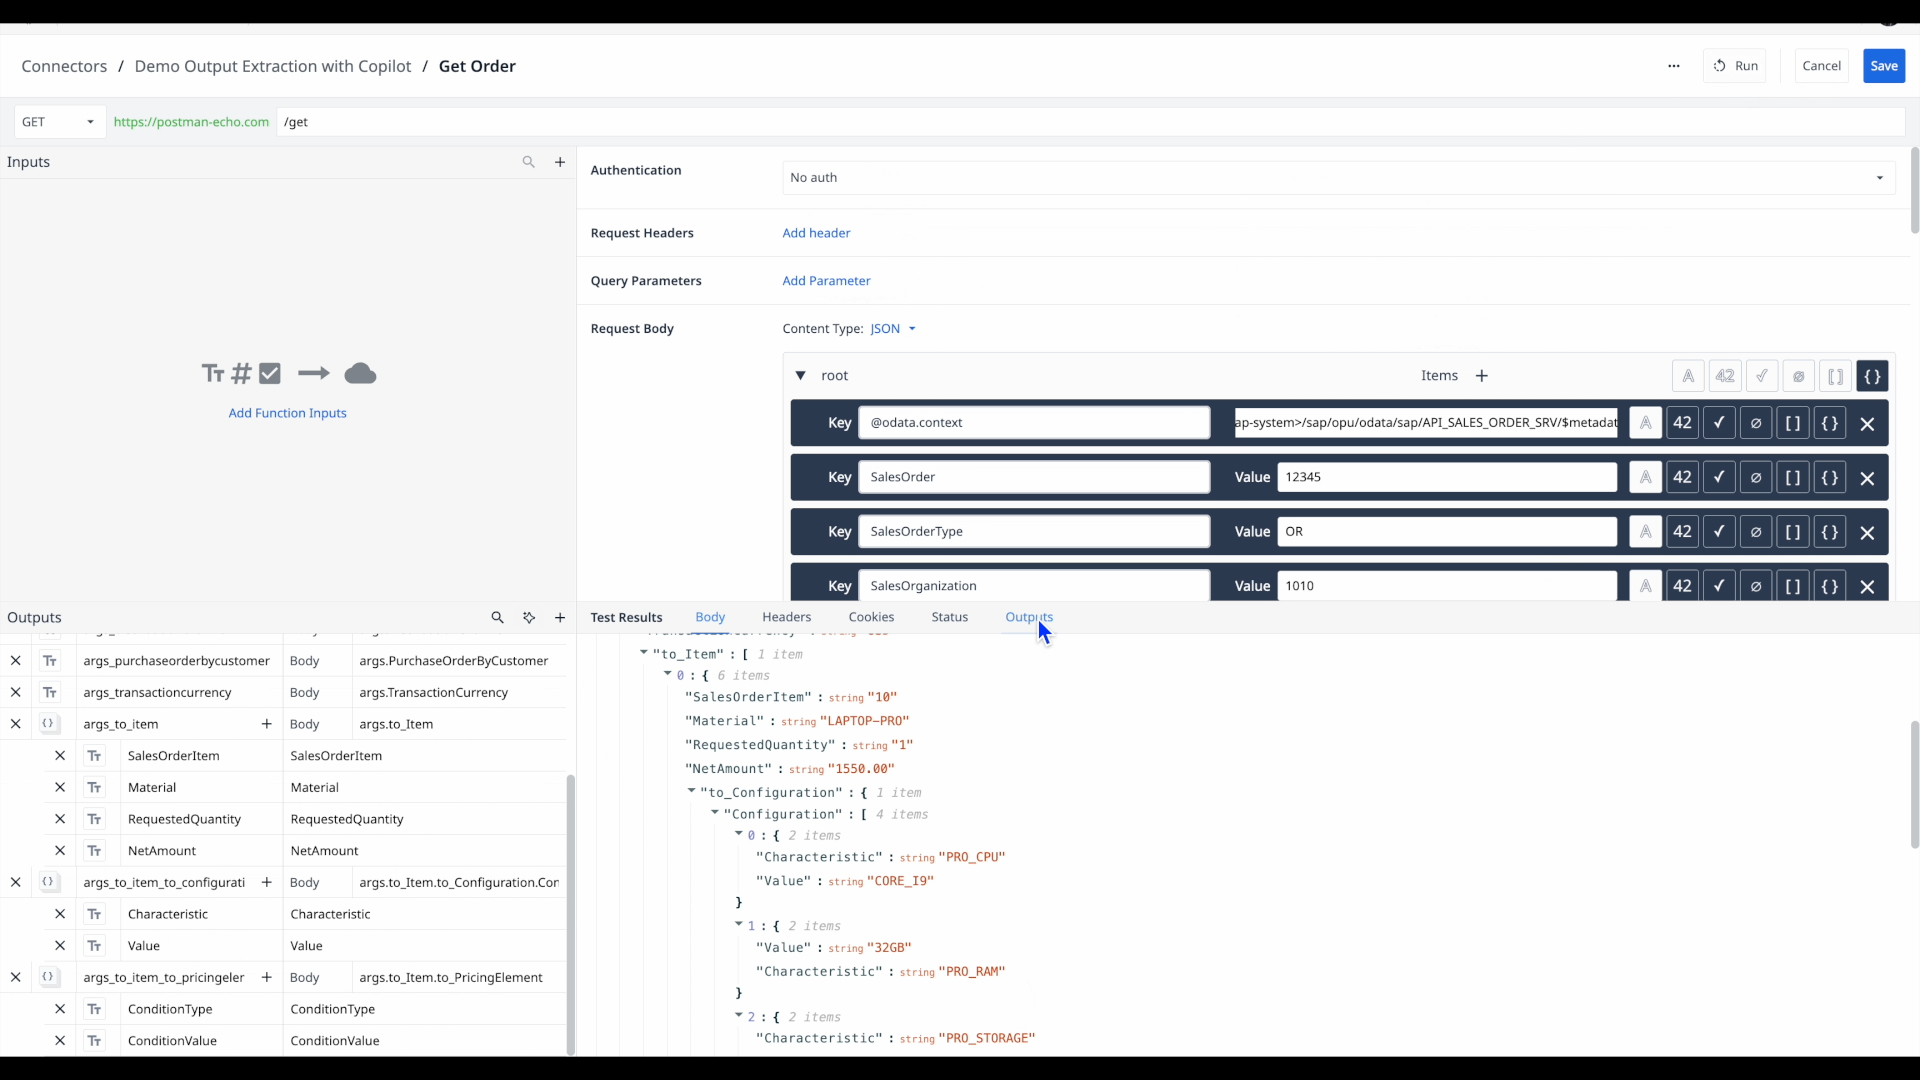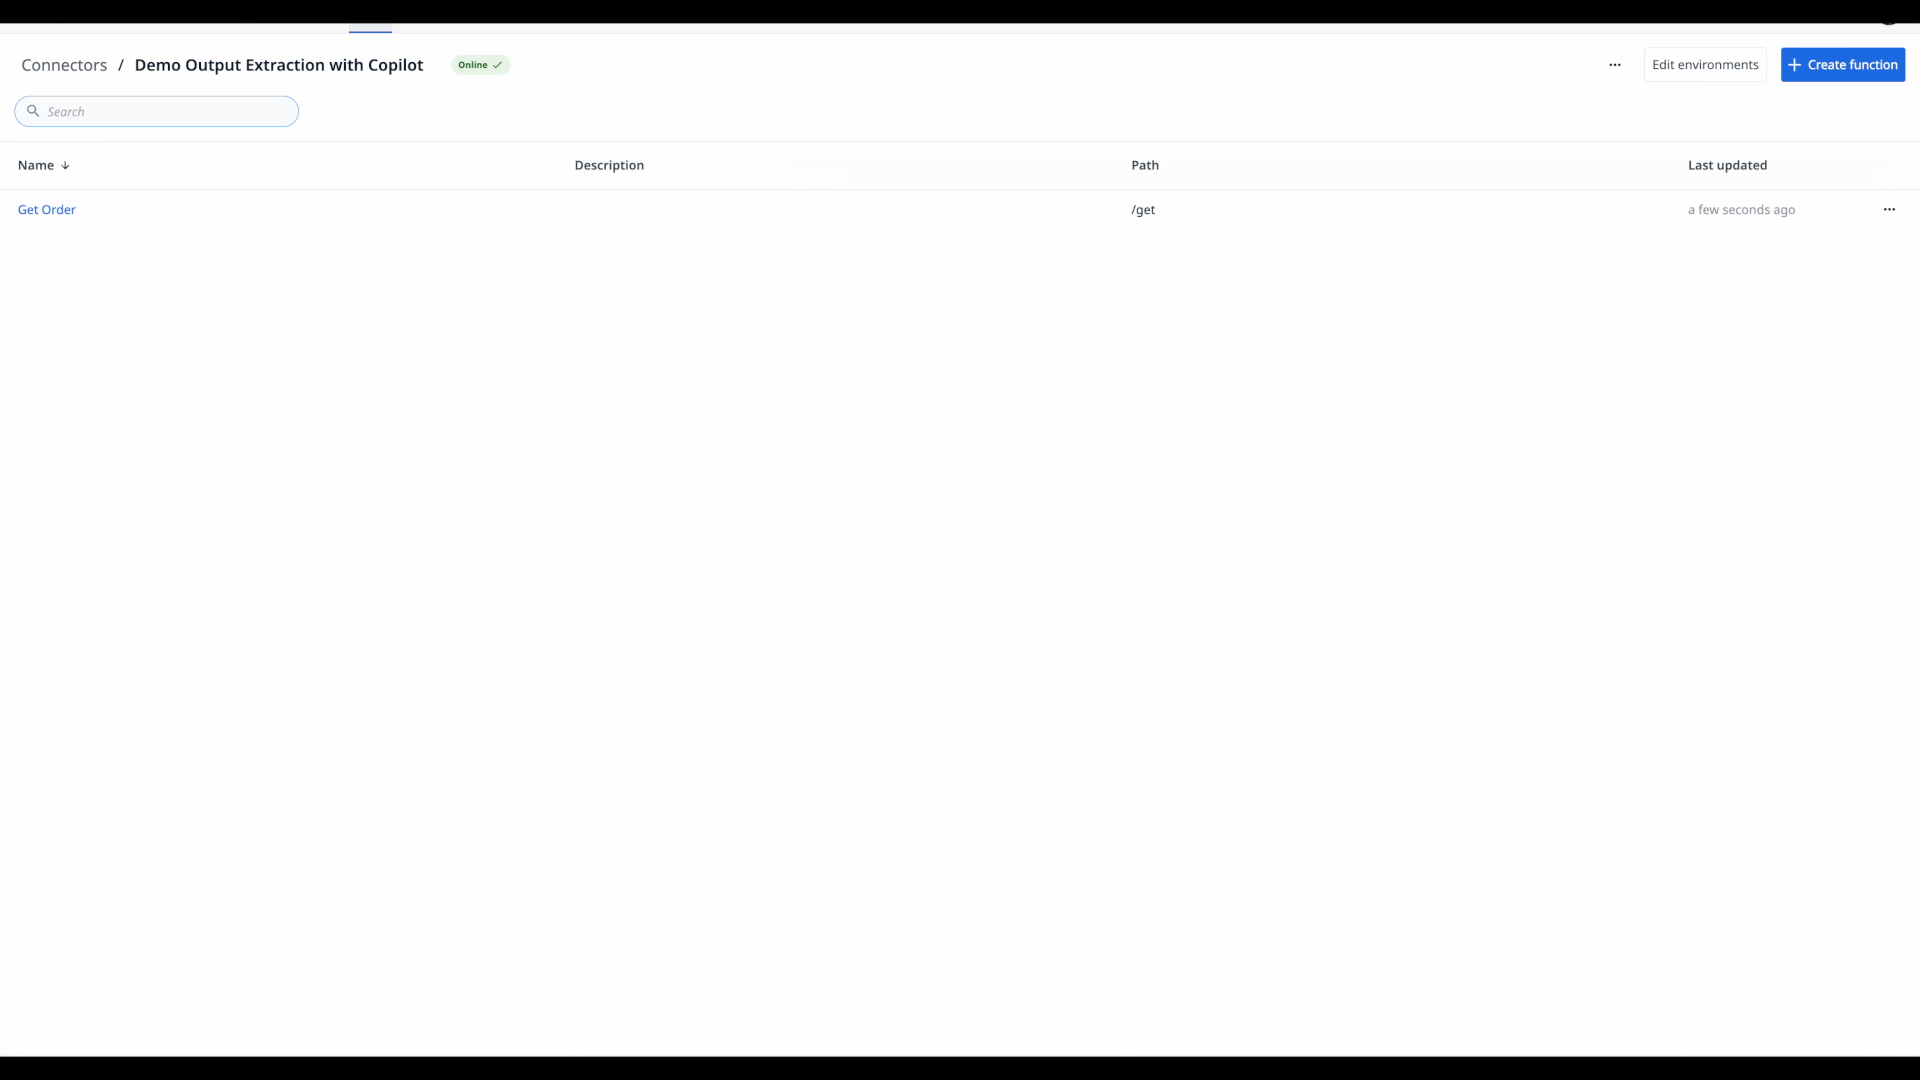
Tulip AI offre un raccourci puissant pour analyser automatiquement la réponse JSON de vos résultats de test et générer les chemins de notation Dot correspondants. Il tente de reproduire la structure imbriquée des objets, mais aplatira les tableaux ou objets complexes si nécessaire.
Tulip AI ne modifie pas vos sorties et extractions existantes. Il génère uniquement des sorties nouvelles ou non spécifiées afin d’accélérer le processus initial de configuration des sorties.
Une fois que Tulip AI a généré les sorties, vous devez les vérifier par rapport à l’objectif de votre application.
Lors de cette vérification, suivez ces bonnes pratiques :* Supprimez toutes les sorties inutiles* Renommez les variables pour plus de clarté* Ajustez manuellement la structure des sorties (par exemple, en vous assurant que les tableaux sont correctement définis comme des listes d’objets)
Ces étapes vous permettent de vous assurer que vous n’extrayez que les données nécessaires à votre application.
Pour en savoir plus
- Utilisation des connecteurs HTTP dans les applications
- Affichage de listes interactives d'enregistrements de table ou de résultats de connecteurs dans les applications
{{snippet.Avez-vous trouvé ce que vous cherchiez ?}}