

Saiba como estruturar as saídas do conector HTTP.
Visão geral
O editor de funções de conector no Tulip permite que você estruture os dados retornados pelas suas funções de conector para que sejam úteis e utilizáveis em seus aplicativos. Neste artigo, abordaremos os fundamentos da formatação das saídas Output das funções de conector, apresentando a você:
- O conceito de saída de um conector
- Ferramentas disponíveis para formatar saídas
- Vários formatos de saída comuns
O que são saídas?
As saídas são usadas para definir e estruturar os resultados retornados pela função de conector. Elas permitem que você extraia as informações importantes para seus aplicativos a partir de um corpo de resposta HTTP mais extenso.
Como estruturar saídas
Localize a seção Saídas no canto inferior esquerdo do Editor de Funções do Conector.
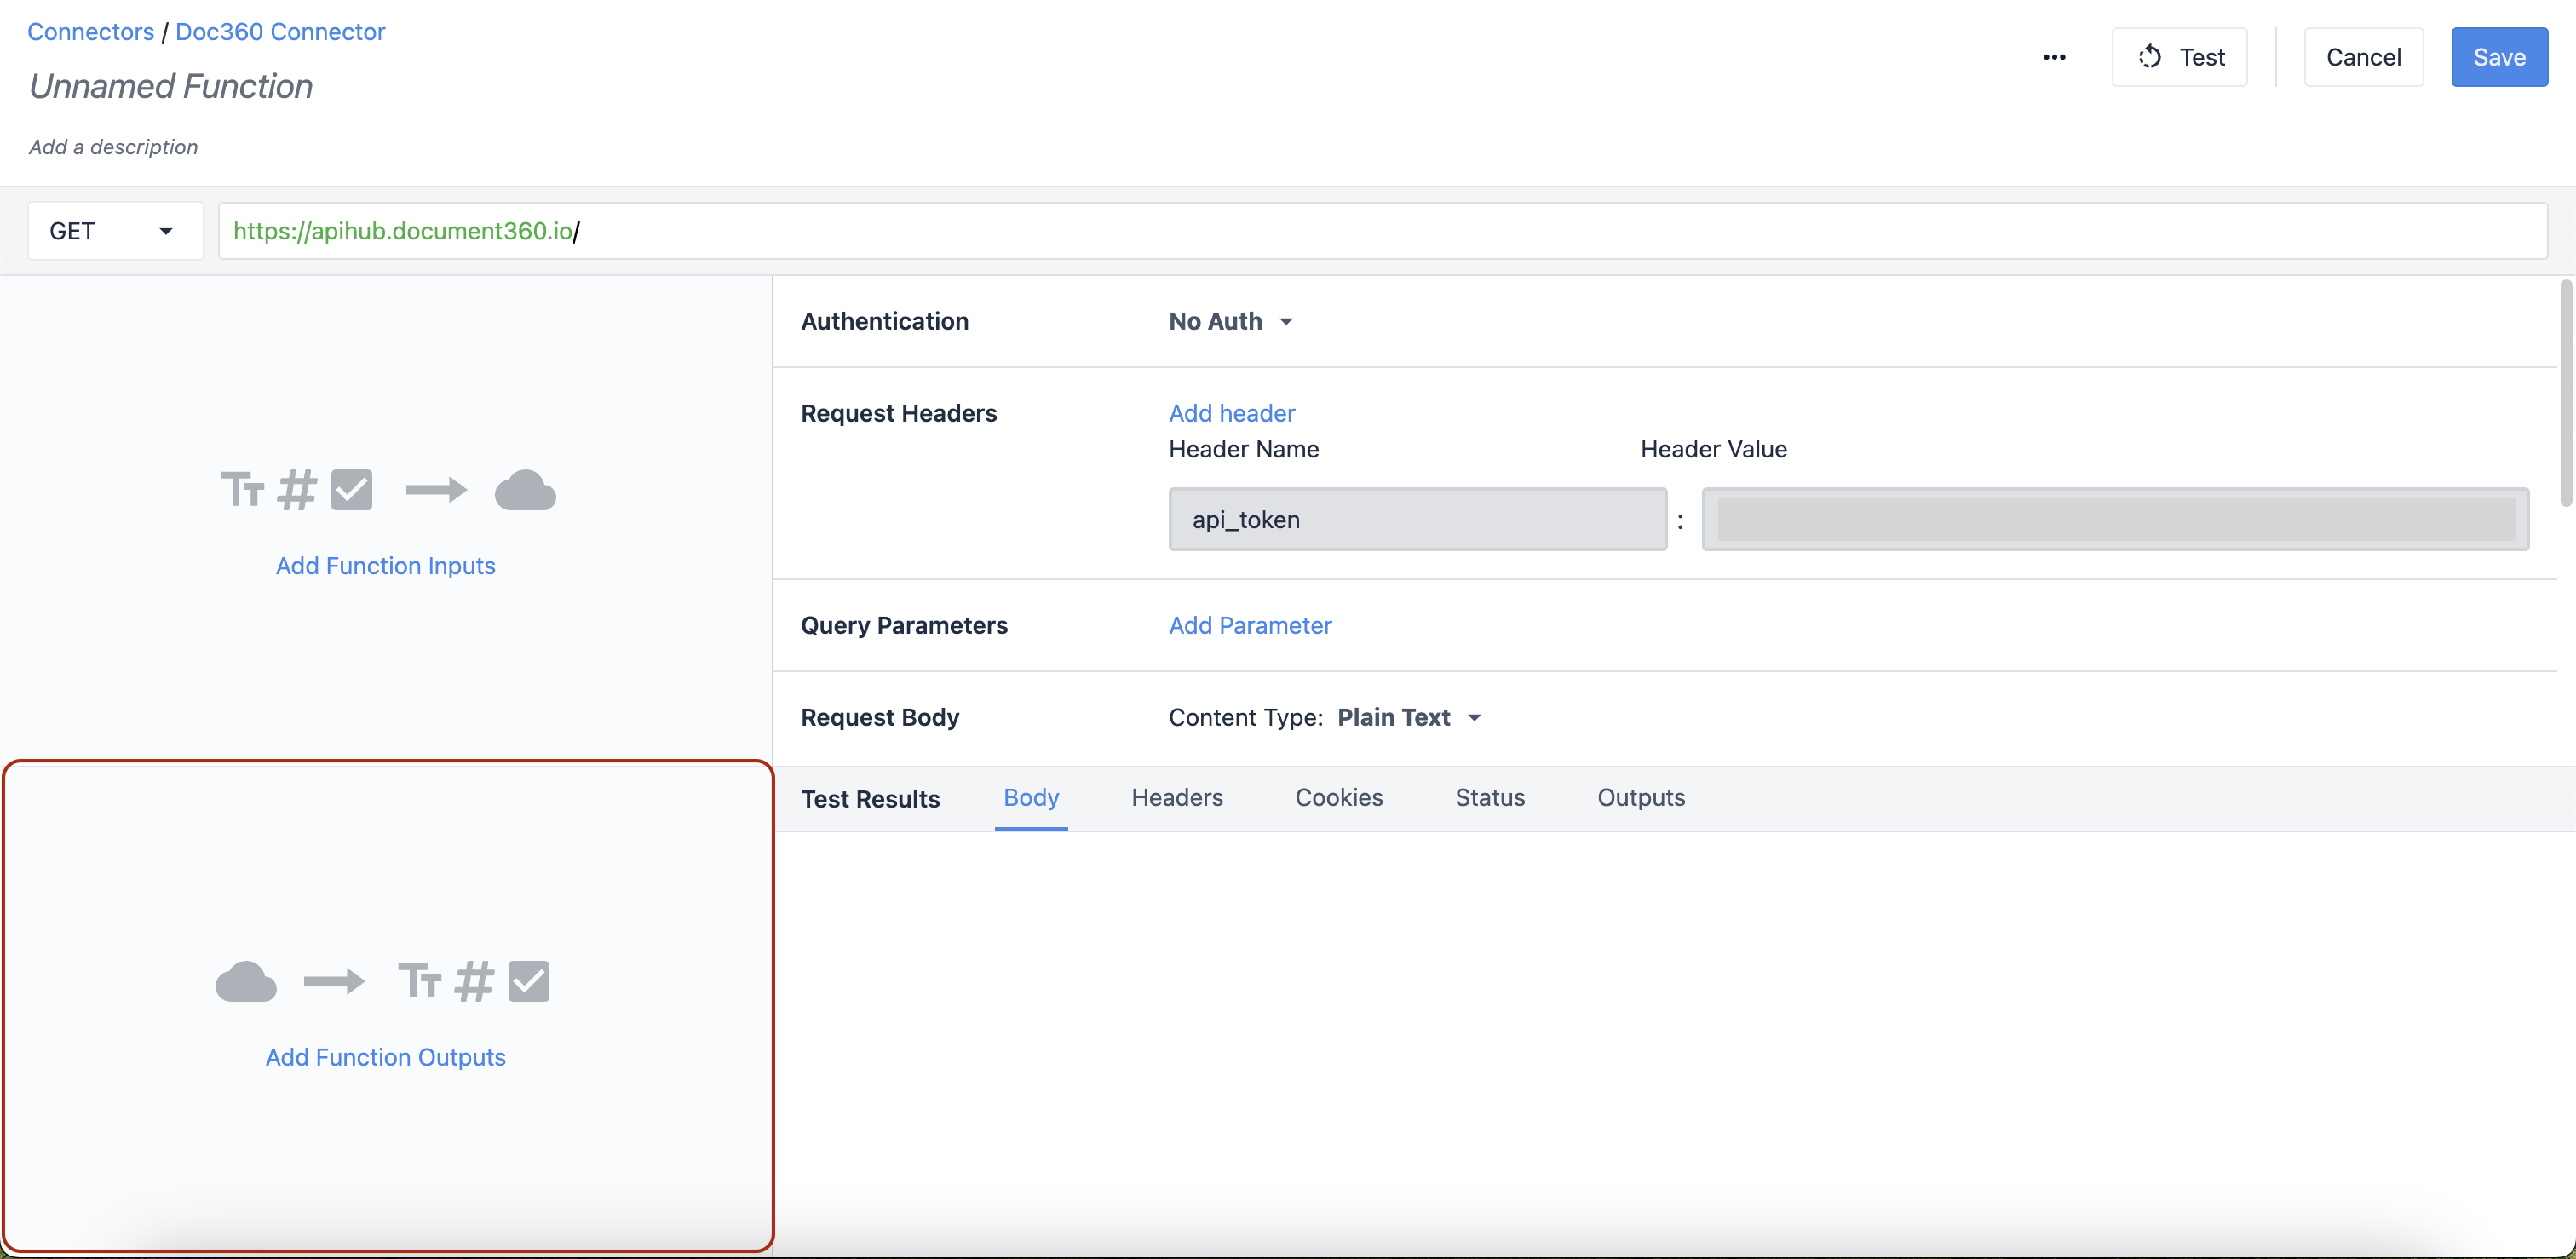
Para começar a adicionar saídas, clique em “Adicionar saídas da função”.
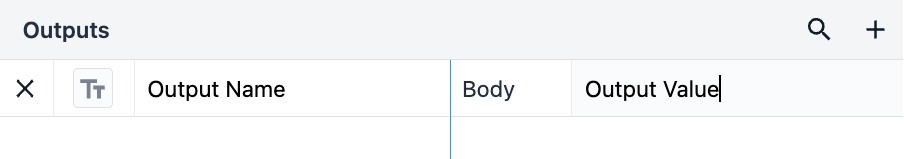
É recomendável nomear suas saídas com um rótulo que seja identificável. Esses nomes aparecem como Variáveis nos aplicativos, por isso é importante poder distingui-los.
Para entender os resultados de uma solicitação HTTP, é importante primeiro compreender a estrutura de um objeto retornado nos “Resultados do Teste”. O diagrama abaixo ilustra como os resultados são divididos em seções de “Objetos” e “Matrizes”.
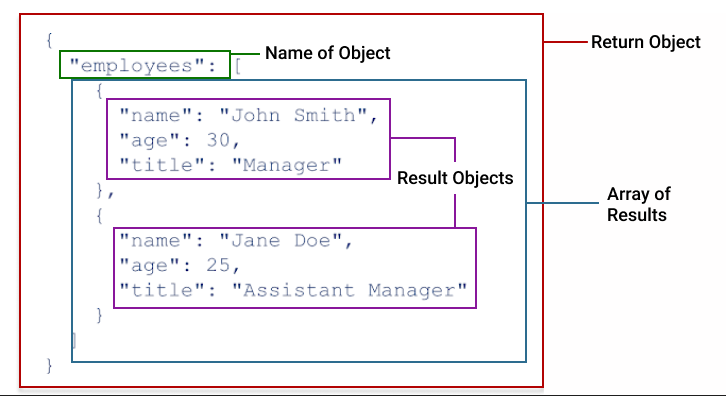
If you haven’t worked with JSON before, you may be unfamiliar with two critical datatypes, objects and arrays. Arrays are lists of values of the same type. For example, [1,2,3,5], or [oak, elm, alder, hickory]. Values in arrays are contained within square brackets, [ ]. Objects are a datatype for holding key:value pairs. The key:value pairs within an object can be of multiple different types, including arrays and nested objects. Objects are contained with curly brackets, { }.
Para obter mais informações sobre objetos e matrizes, consulte “Entendendo matrizes e objetos nas saídas das funções do conector”.
Notação por ponto
Para conectores HTTP, as saídas usam um formato chamado . A notação de ponto permite que você acesse valores dentro de um objeto. A notação de ponto é útil para extrair apenas o que você precisa de um grande corpo de resposta JSON e oferece mais flexibilidade na formatação das funções dos conectores HTTP. Em termos simples: é um formato estruturado baseado em valores aninhados uns dentro dos outros.
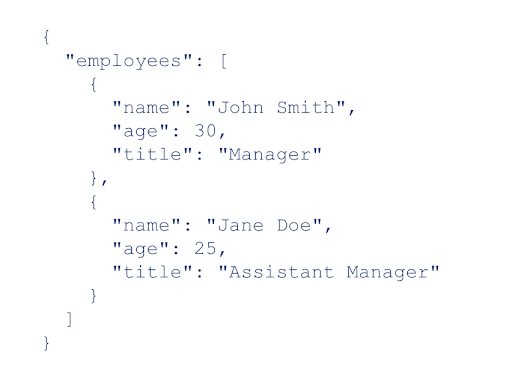
Vamos explicar como a notação de ponto é usada nas saídas dos conectores com um exemplo.
O objeto do exemplo a seguir, chamado “employees”, contém uma matriz de objetos com detalhes sobre cada funcionário. Se quisermos acessar apenas o cargo de cada funcionário, usaríamos a sintaxe: employees.title. Estamos usando um ponto para acessar os valores associados às chaves que nos interessam. Digamos que queiramos obter apenas o primeiro resultado. Especificaríamos isso adicionando a posição do índice entre o nome do objeto principal, “employees”, e o valor que nos interessa, “title”. A sintaxe ficaria assim: employees.0.title. Para objetos mais complexos, talvez seja necessário ir mais fundo no objeto para extrair as informações desejadas.
Vamos dar um passo adiante com outro exemplo. Nesse caso, digamos que estejamos interessados em criar uma função de conector para extrair informações associadas a artigos na Base de Conhecimento. Nosso conector retorna o seguinte objeto JSON chamado “data”, contendo dados sobre um artigo específico:
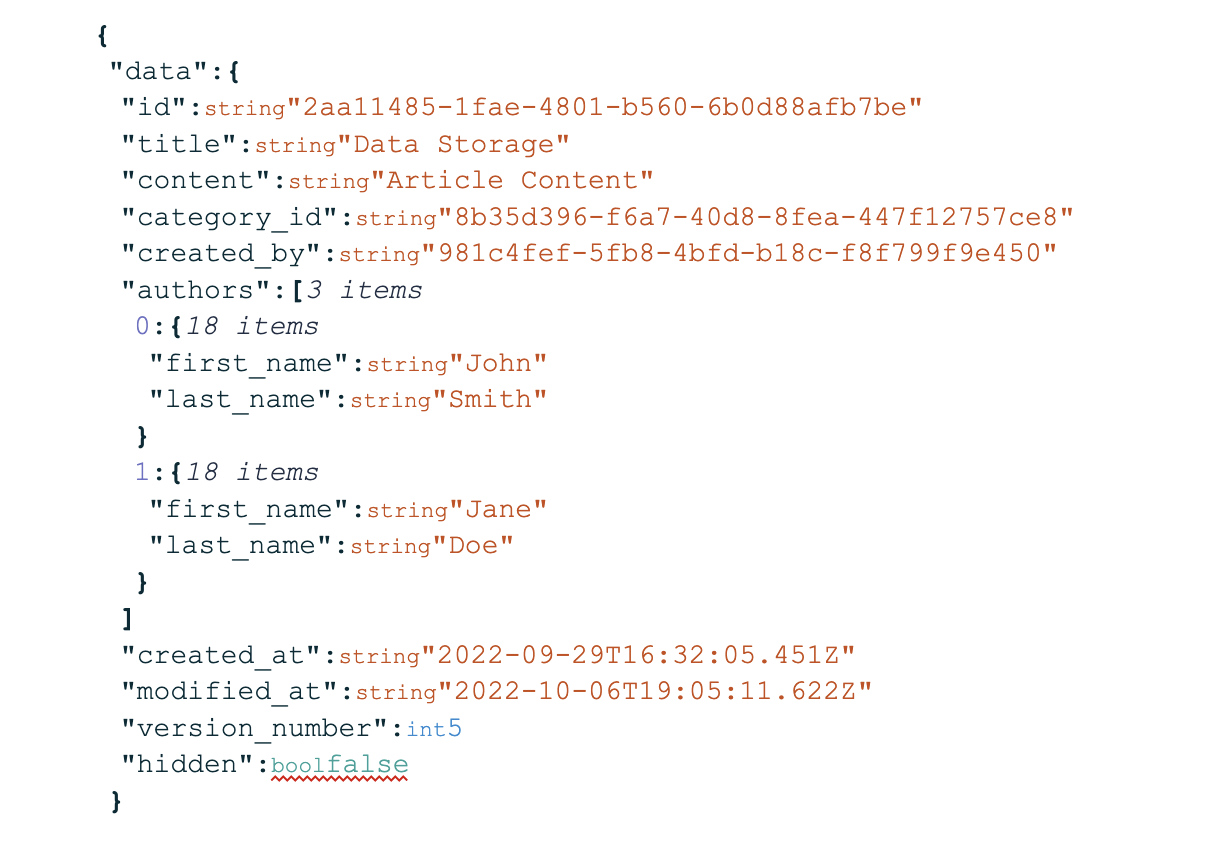
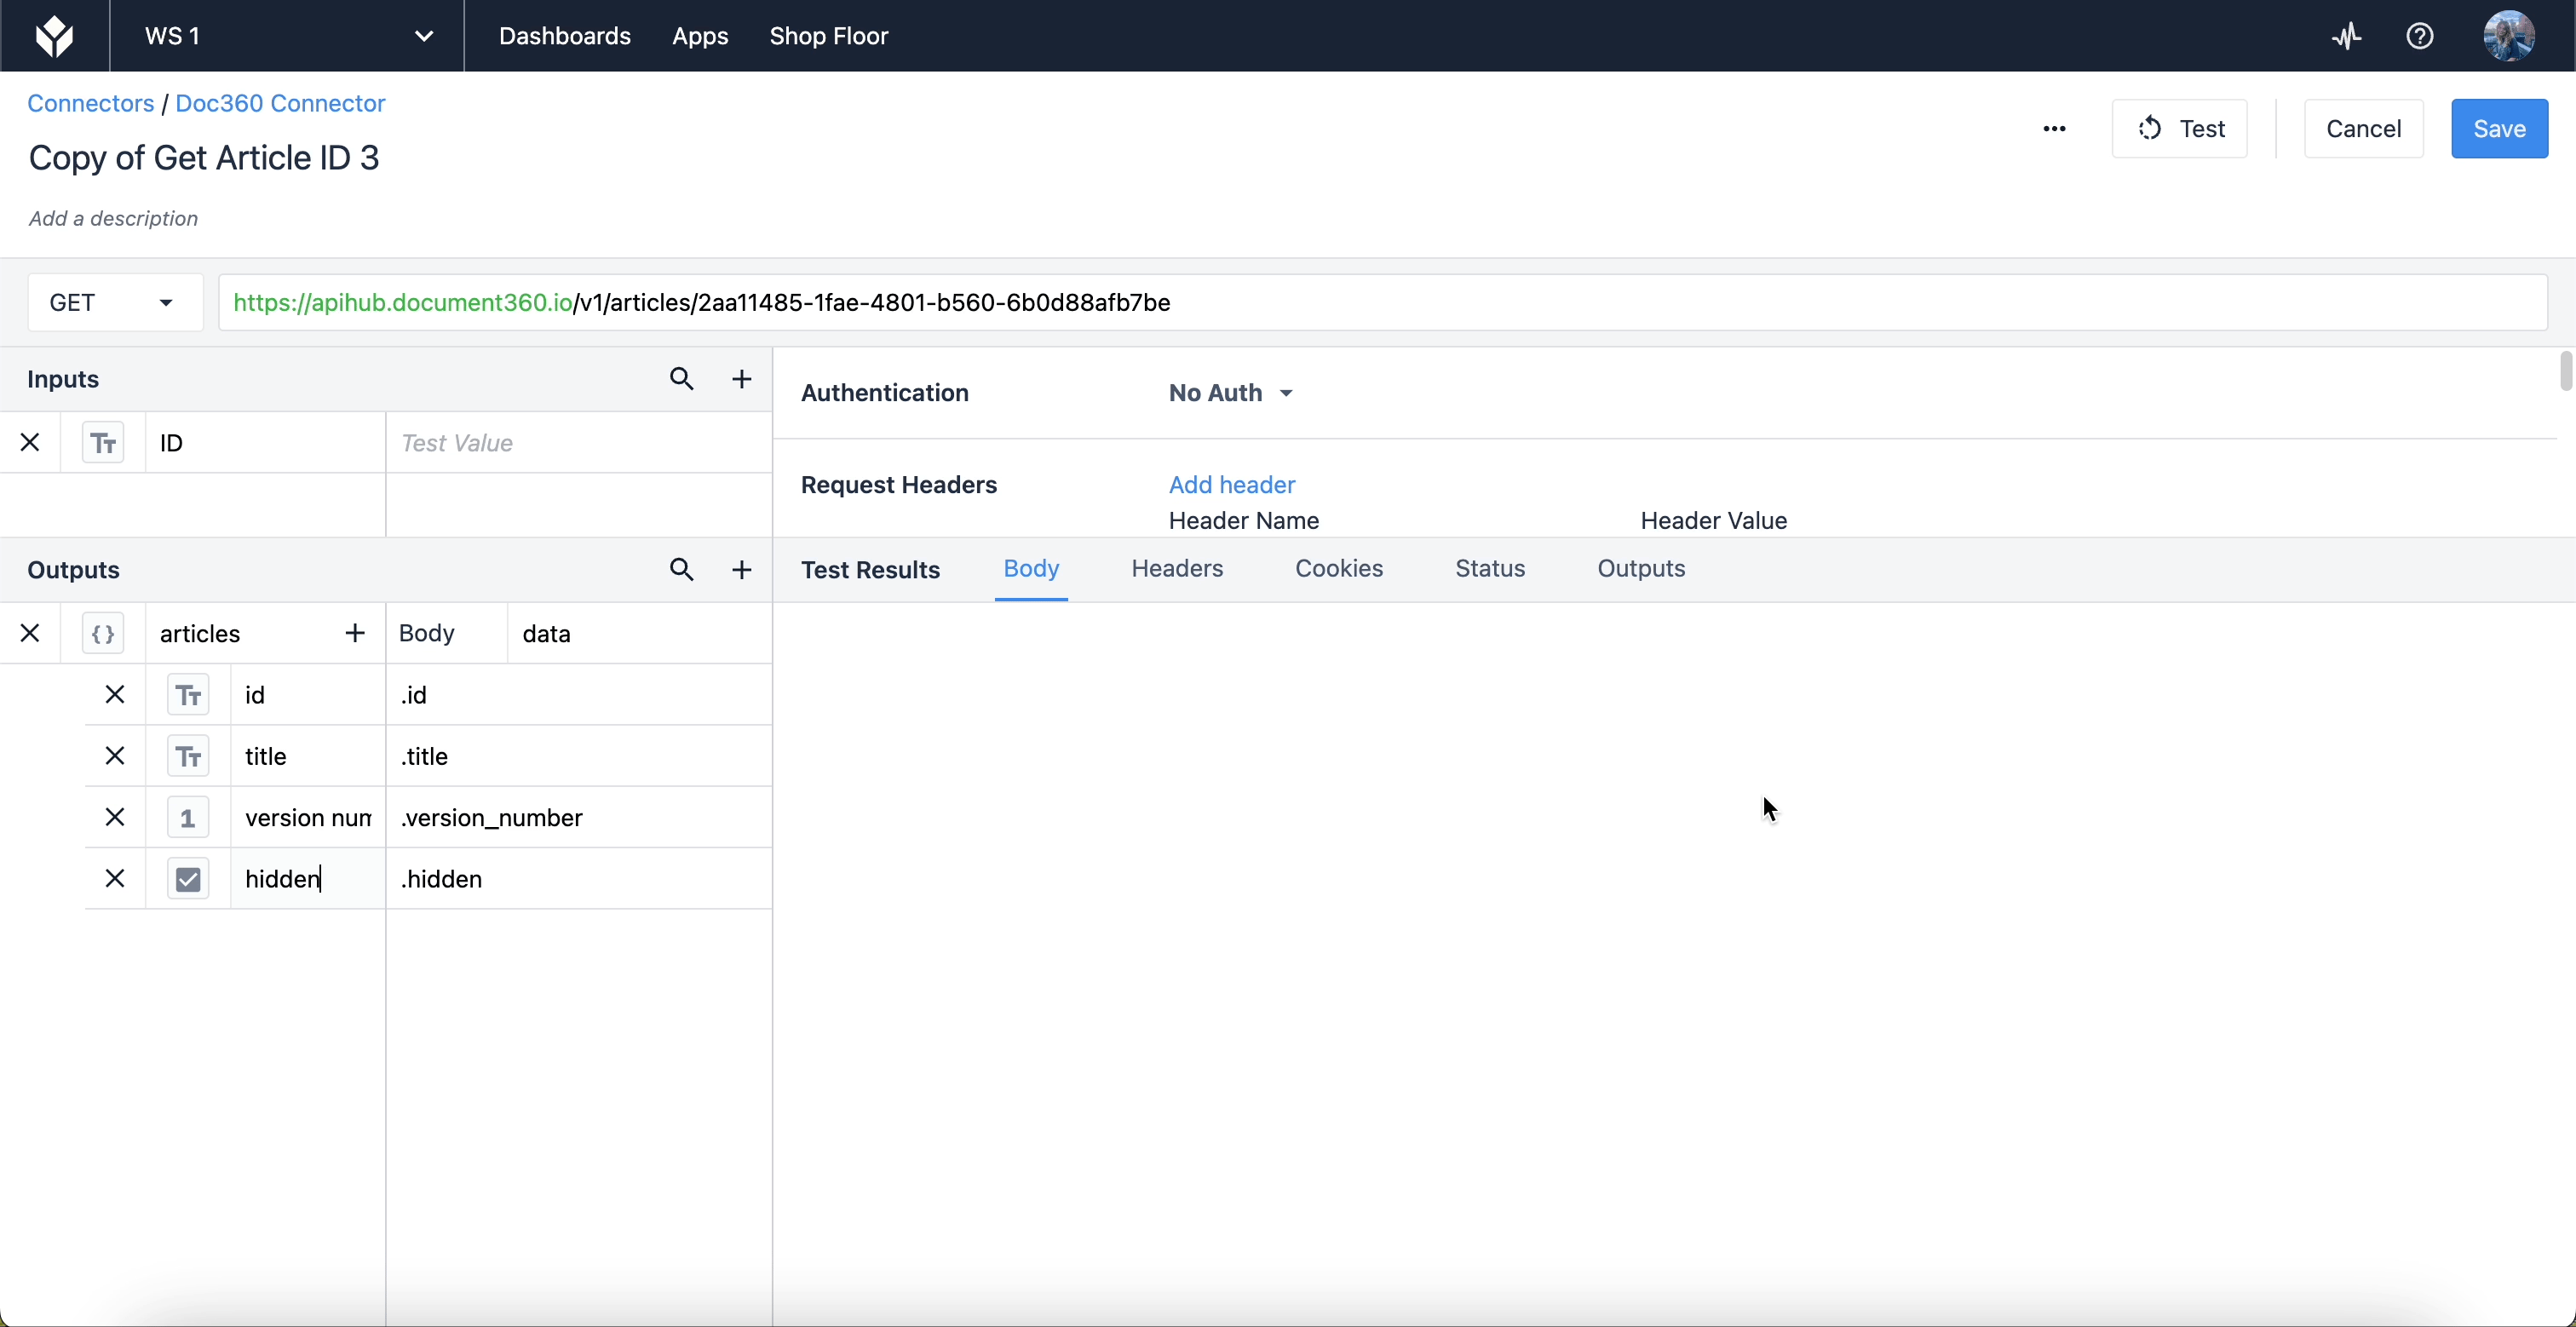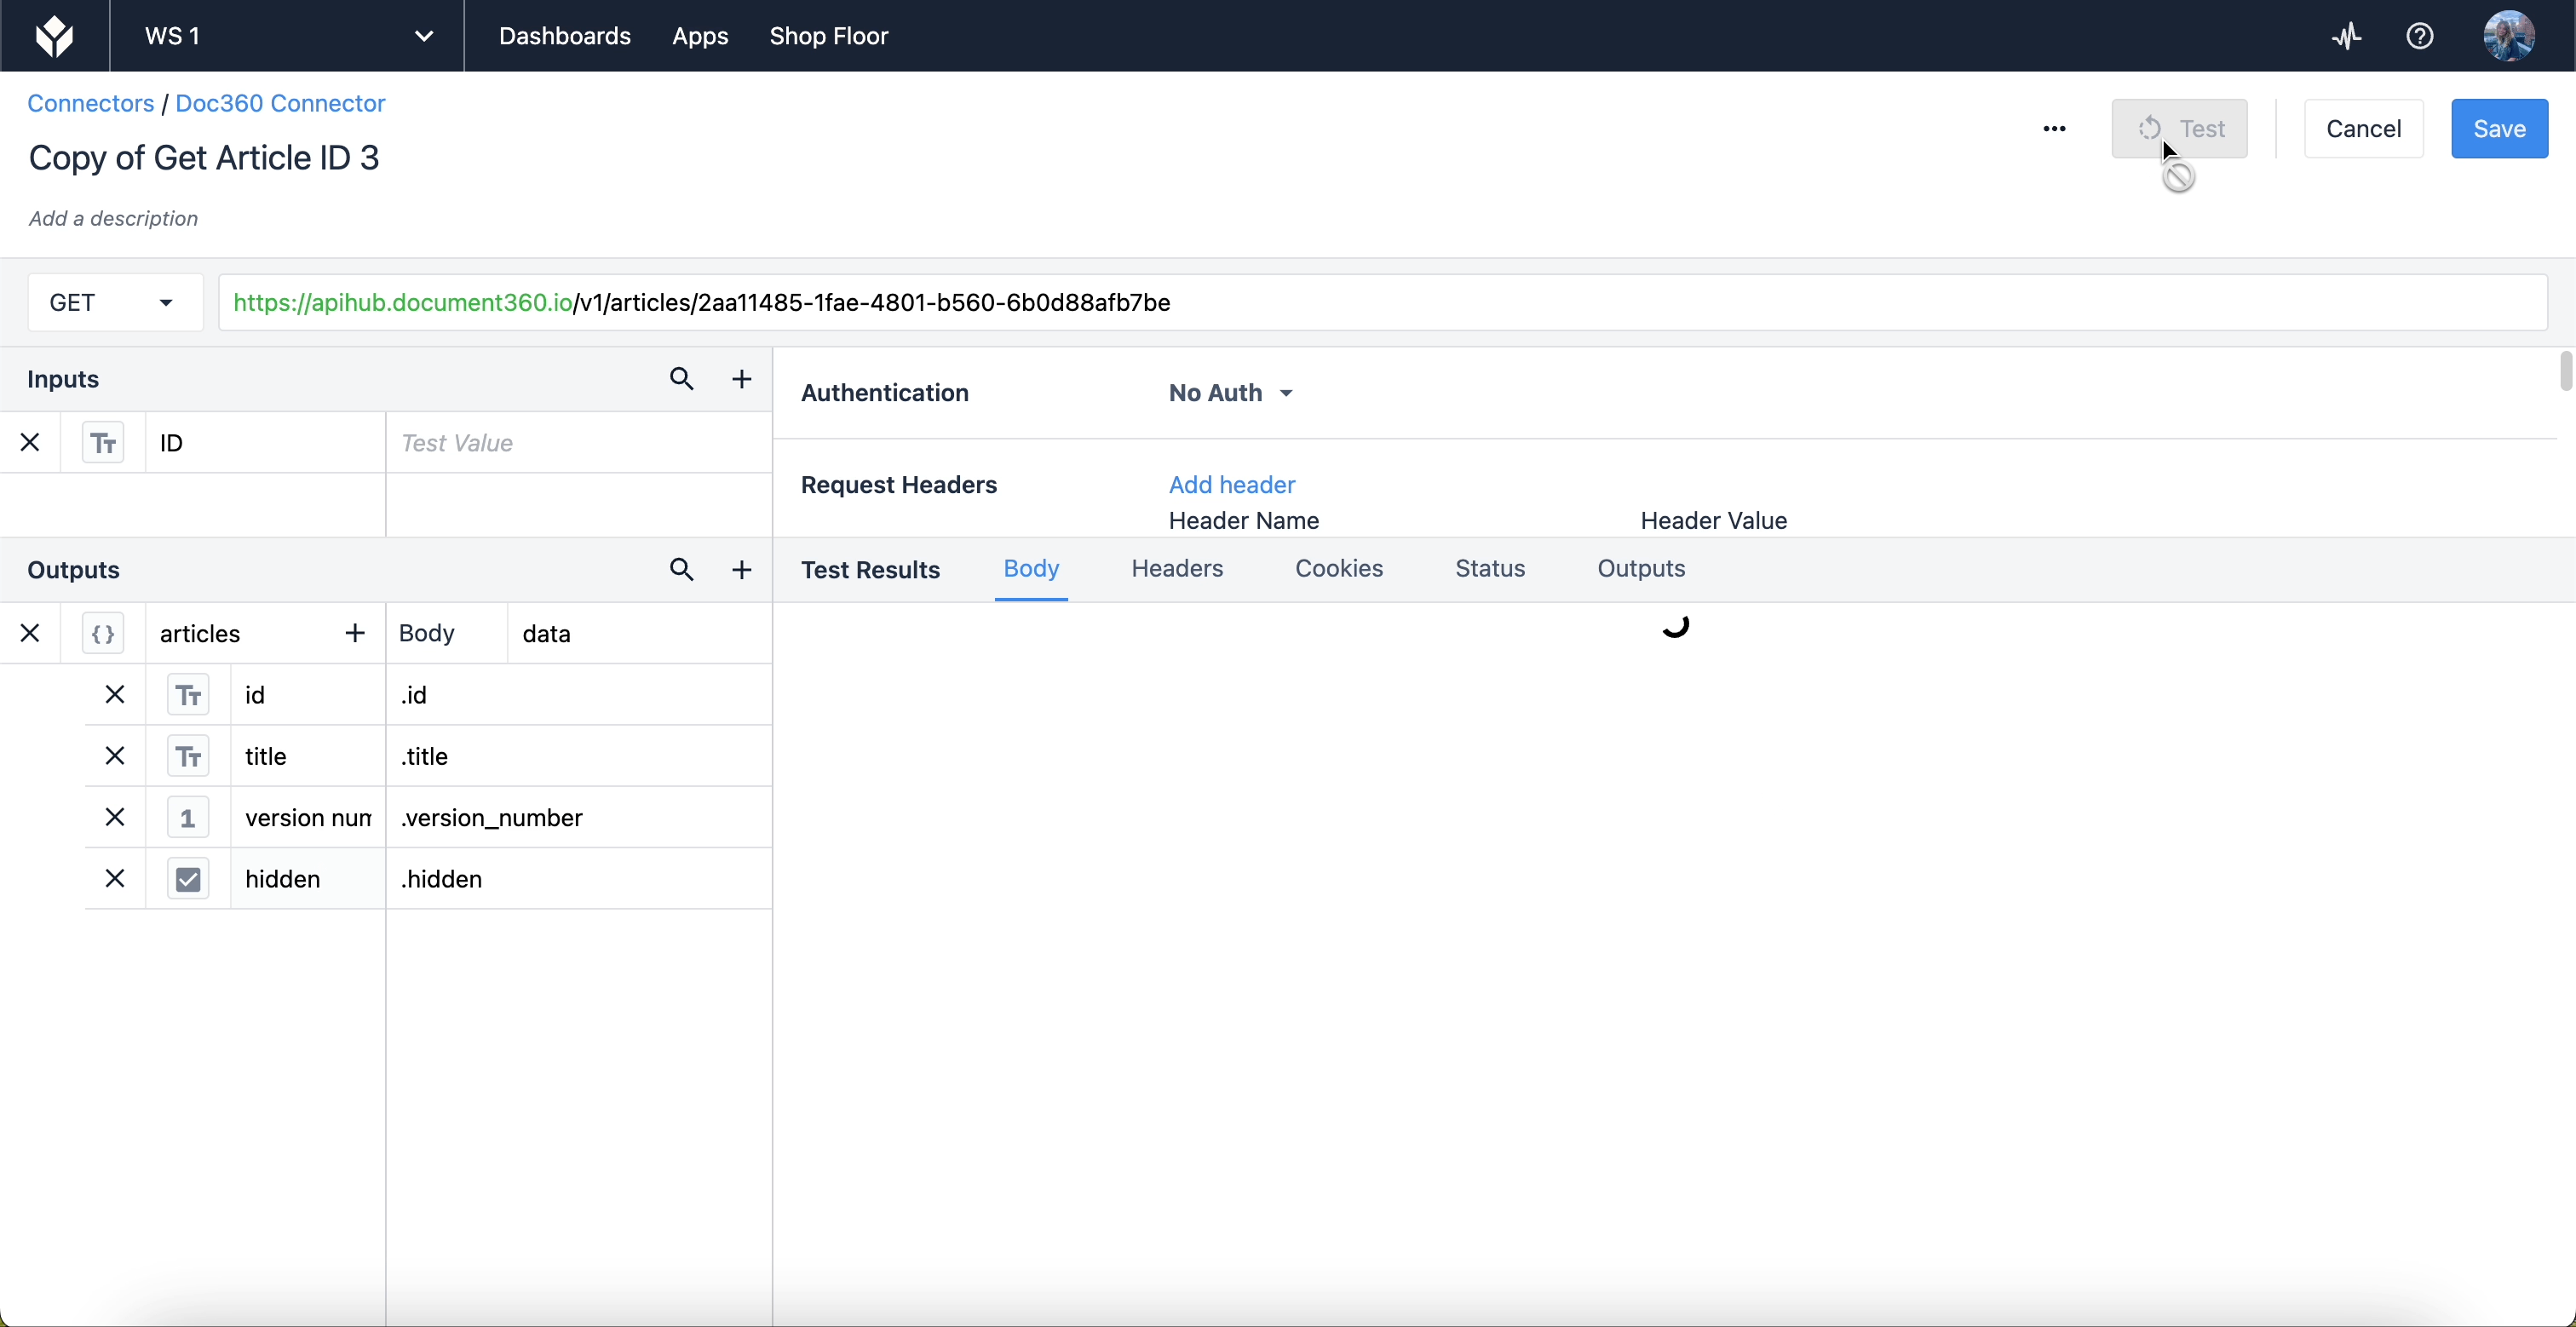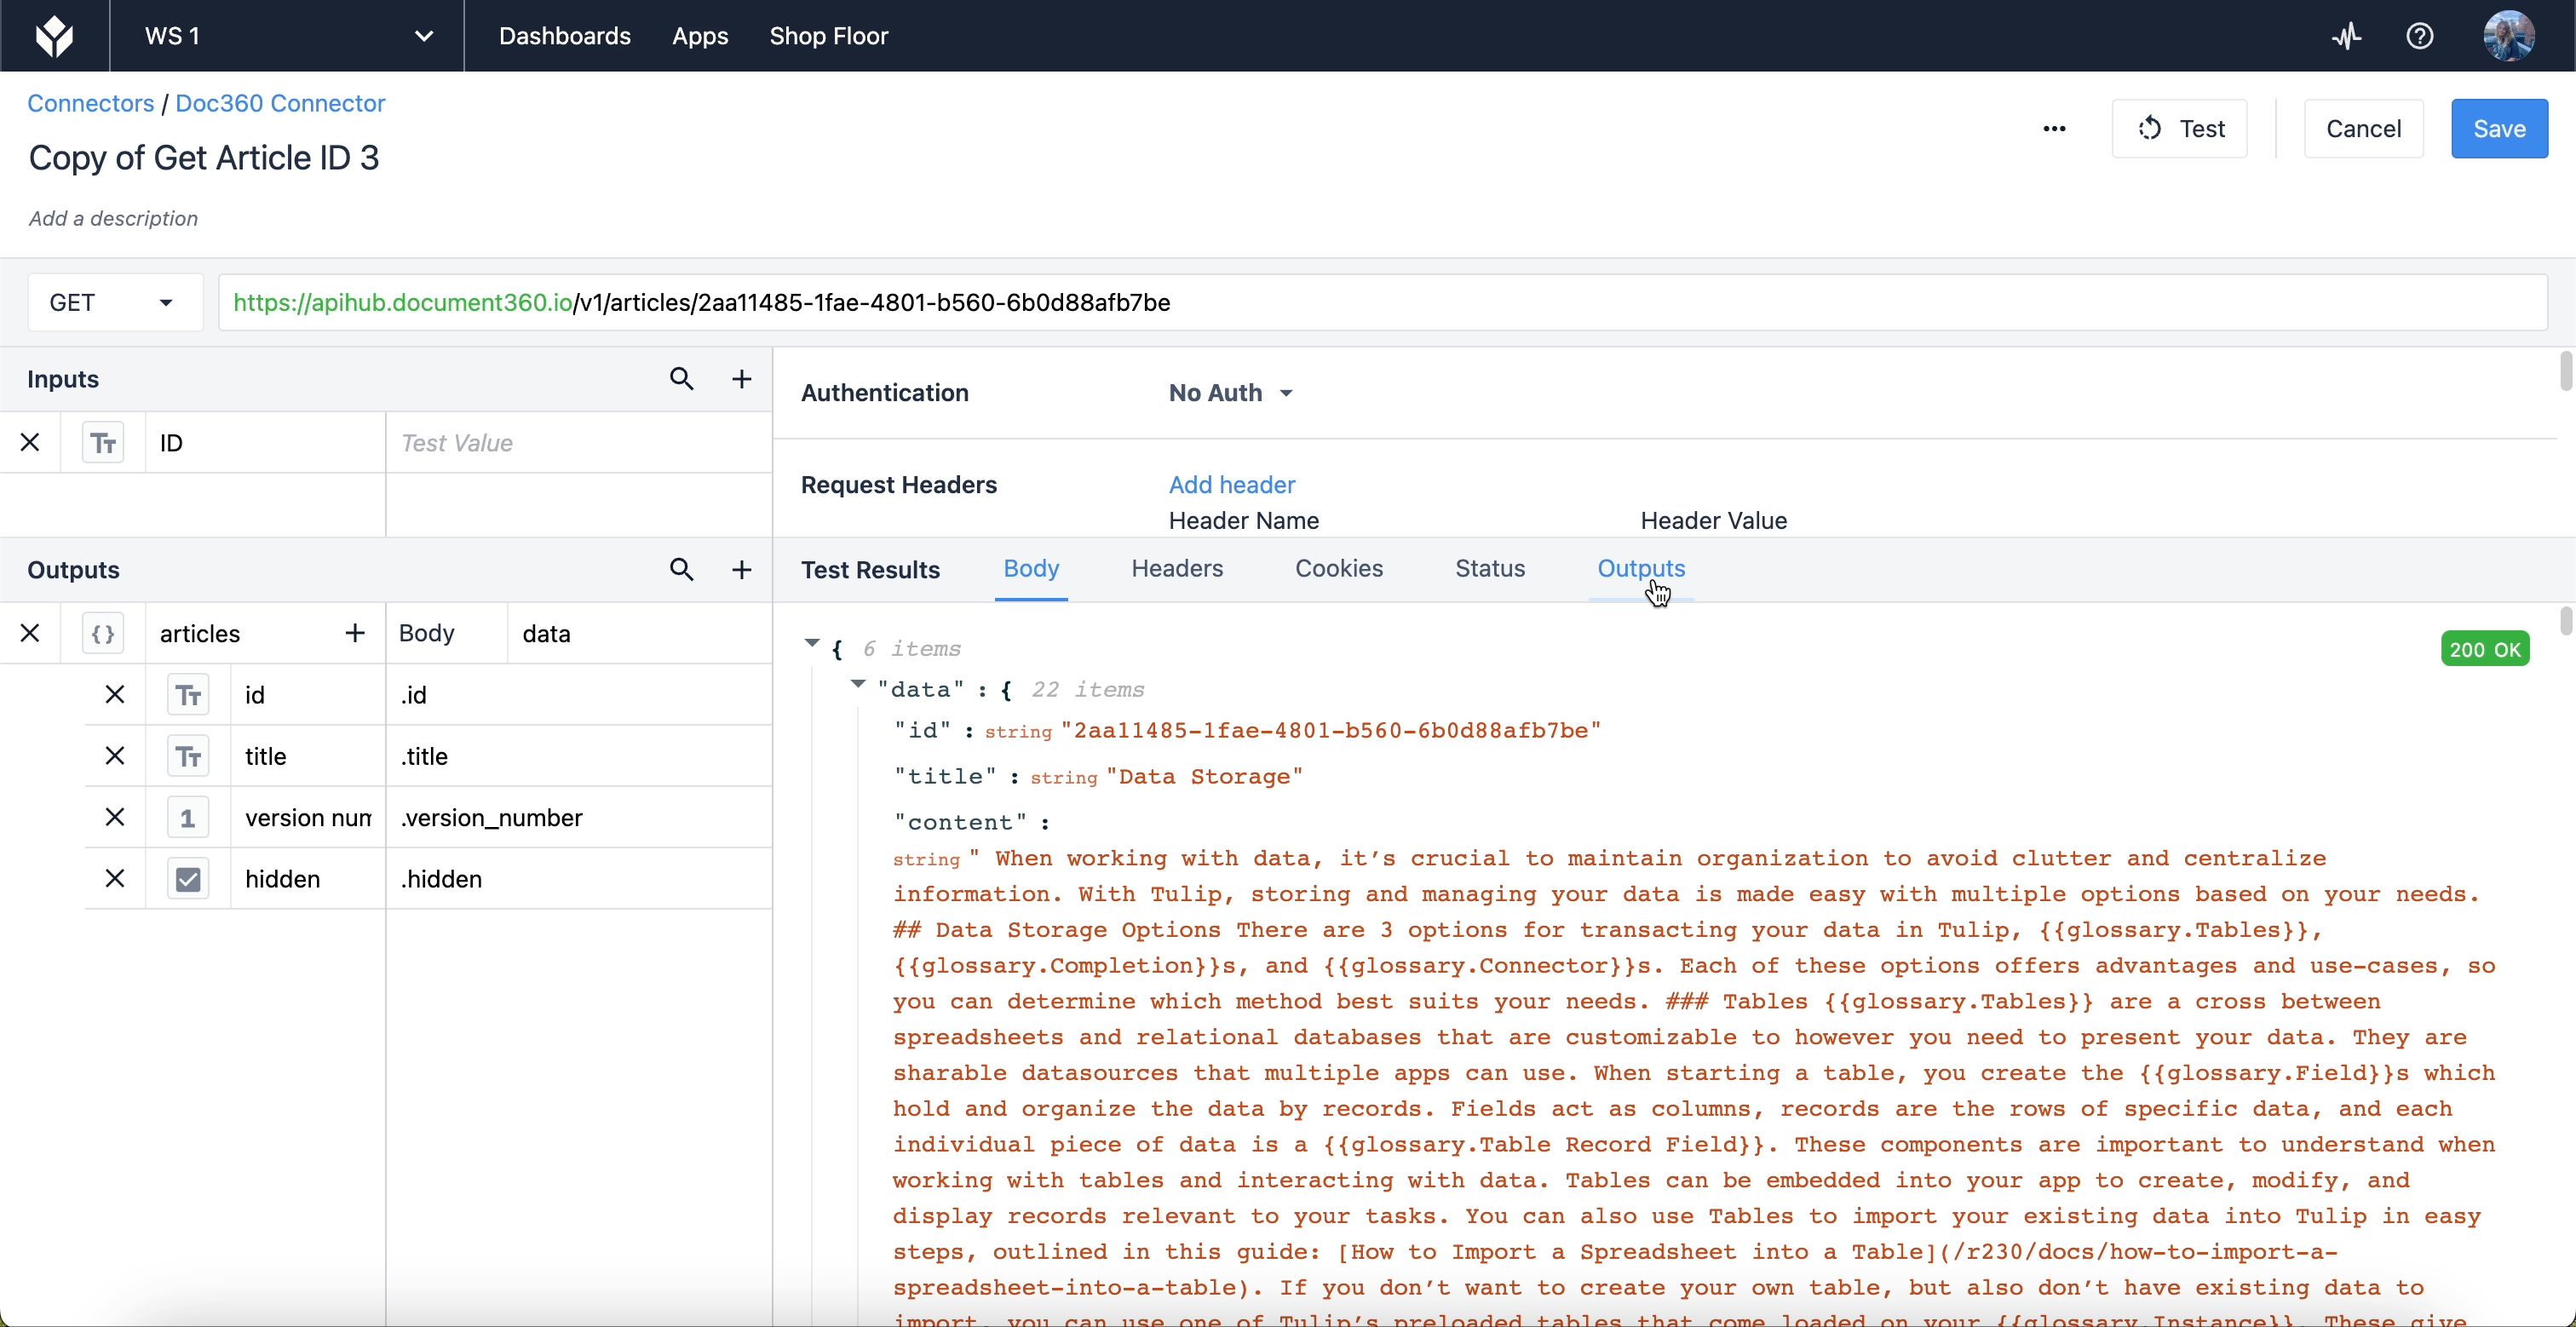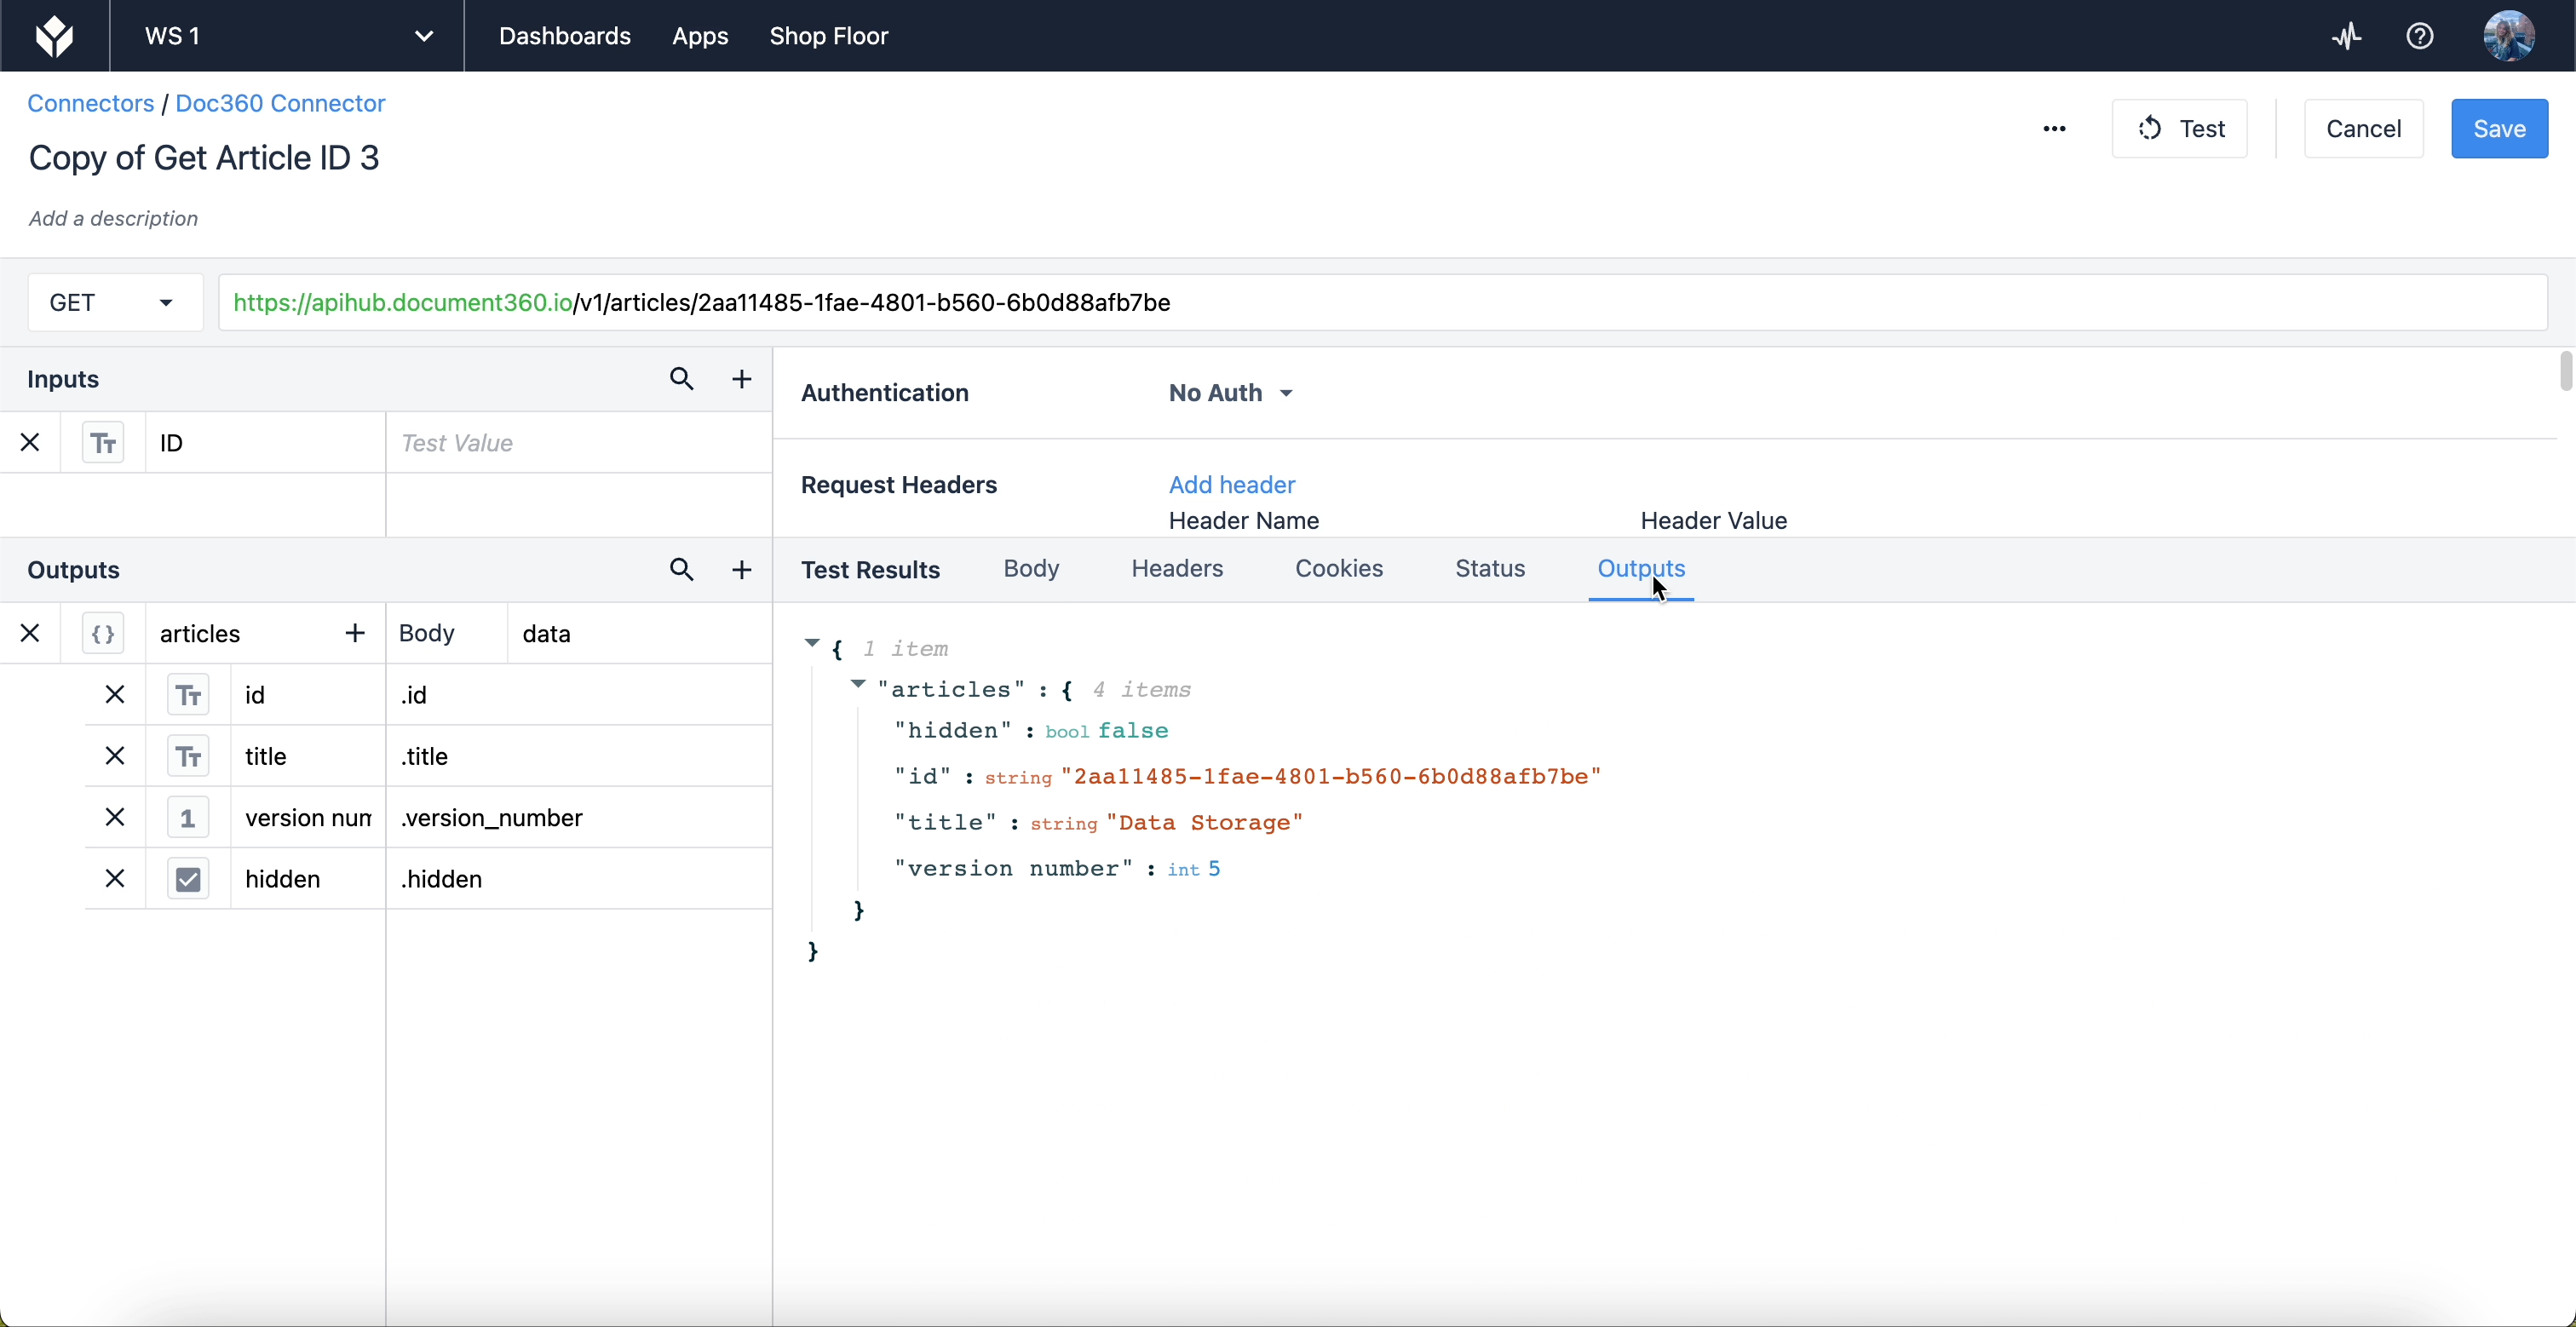
Se quiséssemos extrair apenas, digamos, o ID, o título, a versão e se o artigo está ou não oculto, precisaríamos especificar isso usando saídas. Vamos demonstrar como a notação por ponto aparece na seção de saídas do editor:
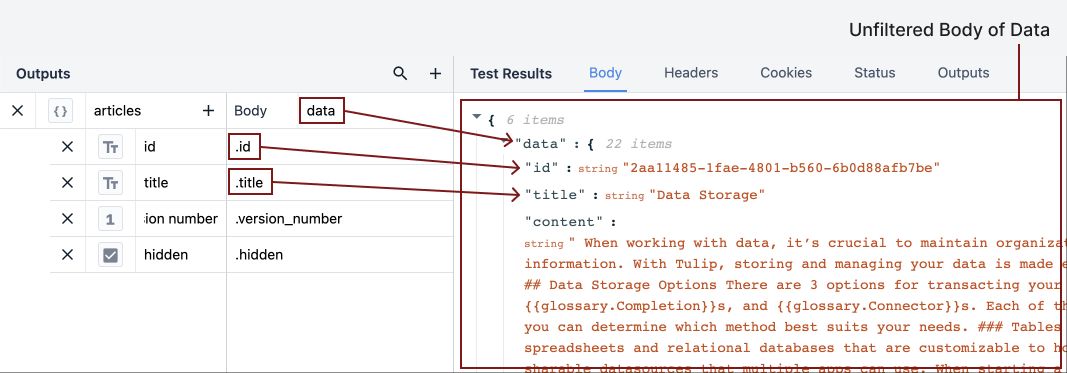
Para extrair resultados como “id” e “title”, precisamos especificar onde esses resultados estão dentro do JSON. O corpo da saída é “data”, correspondendo ao primeiro menu suspenso na seção Resultados do Teste. Cada resultado no menu suspenso “data” está aninhado dentro desse objeto. Na seção Saídas, um ponto significa entrar uma camada mais fundo no objeto “data”.
It doesn’t matter whether the dot is placed in the body, or in front of individual properties, so long as there is a dot separating each layer of the JSON.
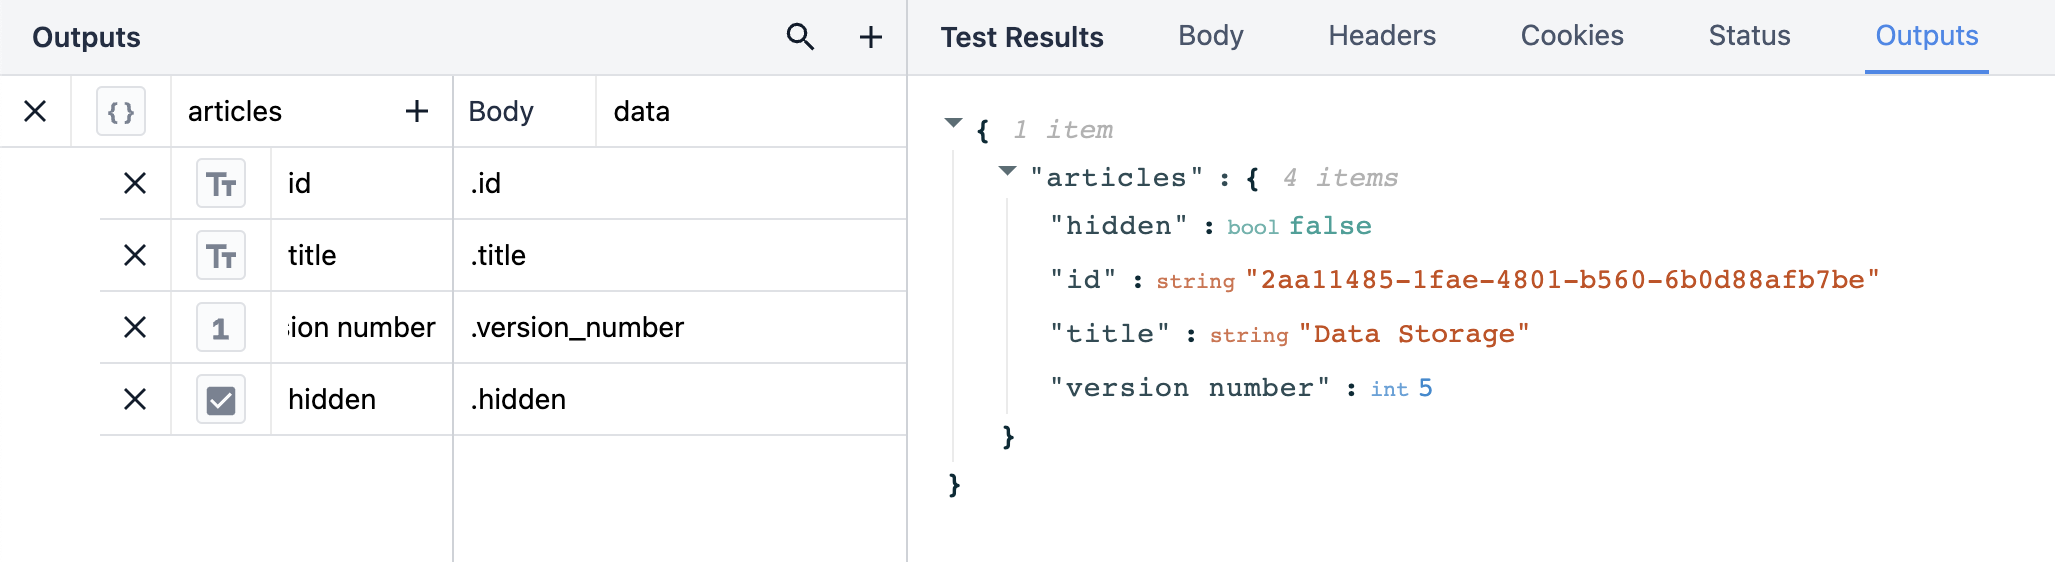
Quando clicamos na aba “Saídas” na seção “Resultados do Teste ”, filtramos o restante dos dados para ver apenas as informações que nos interessam.
Outra maneira de escrever suas saídas é em uma única linha. Isso mostra o caminho completo em uma única consulta.
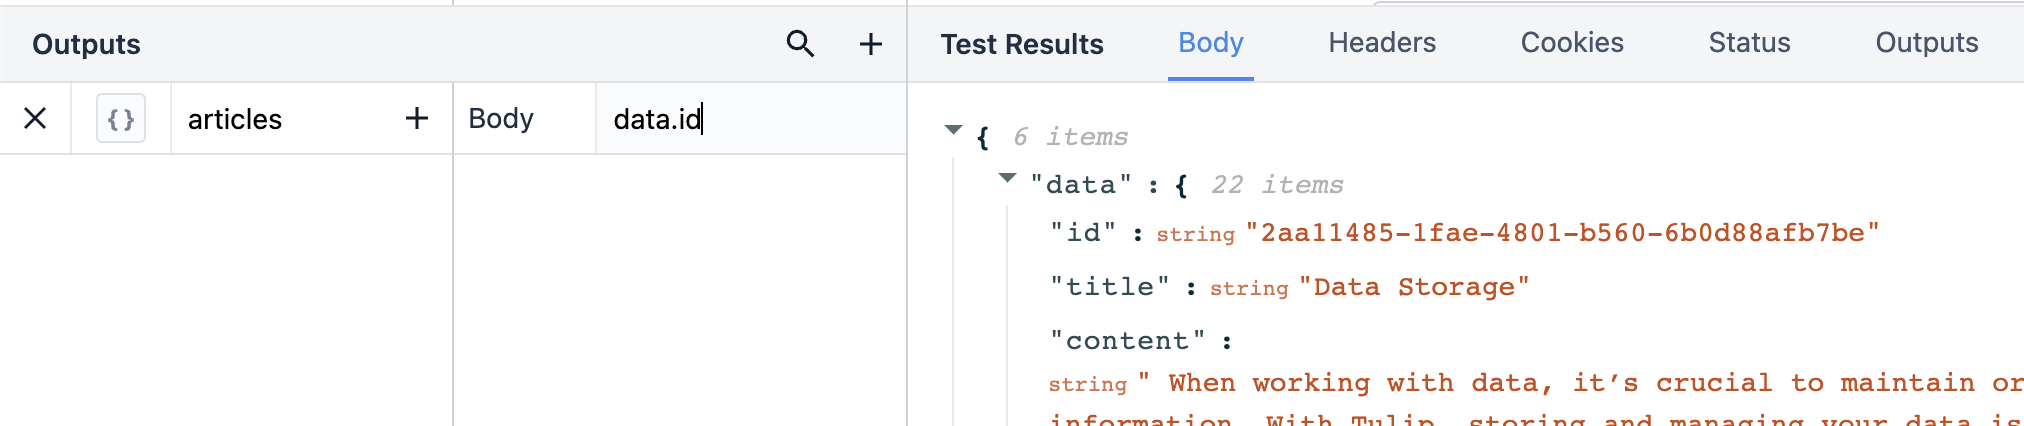
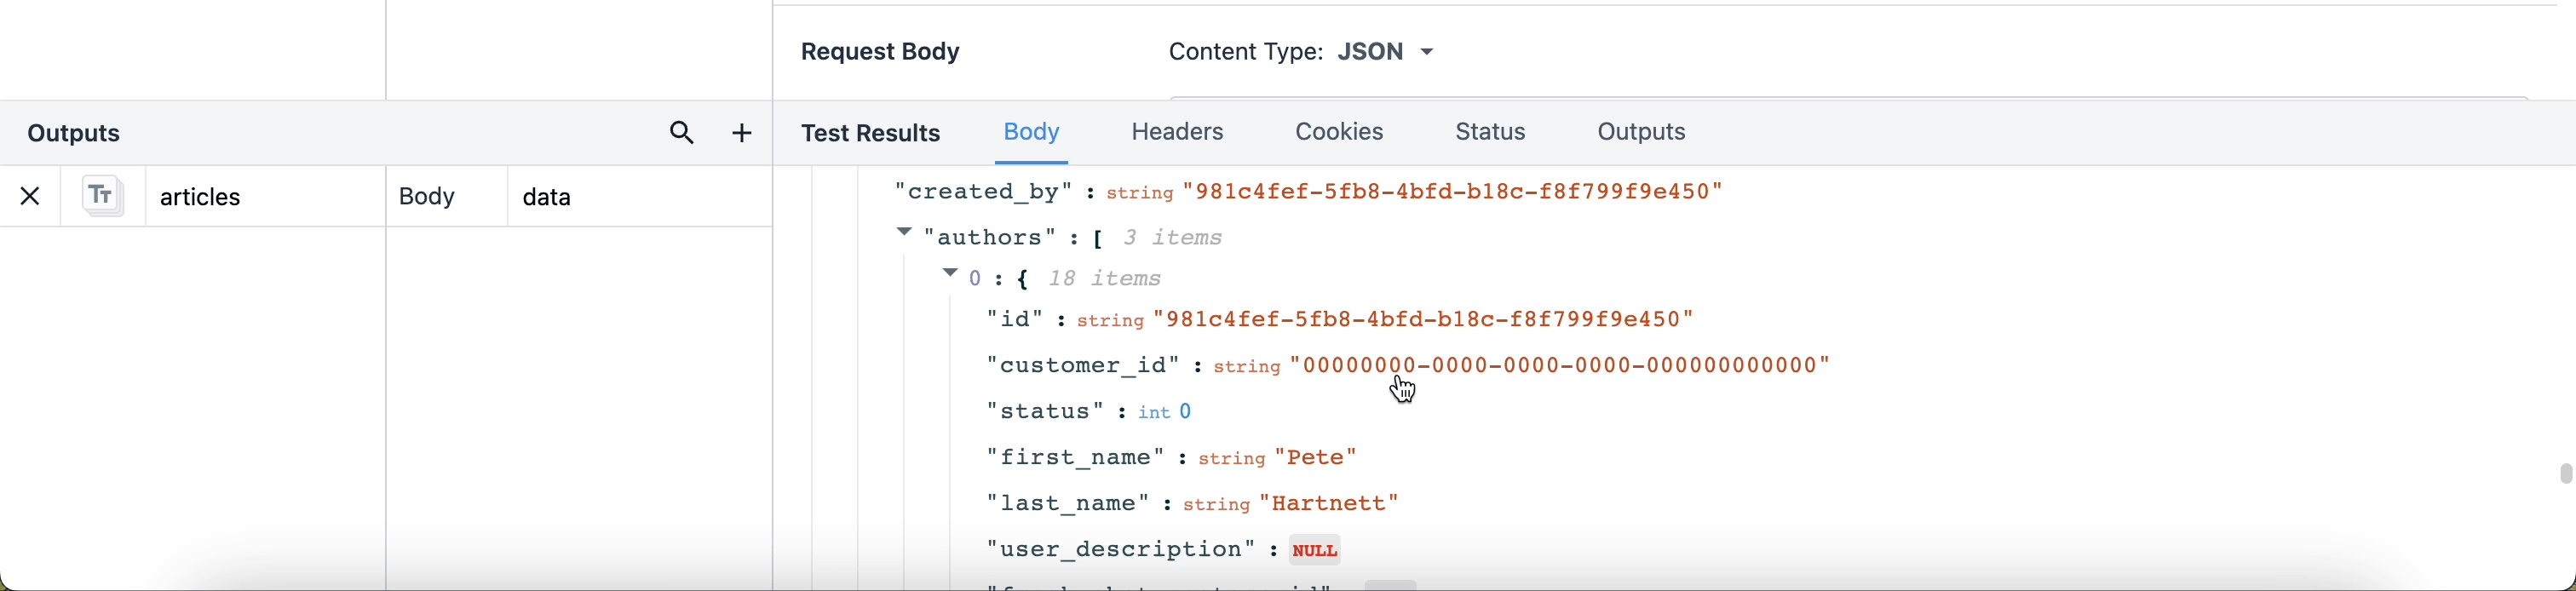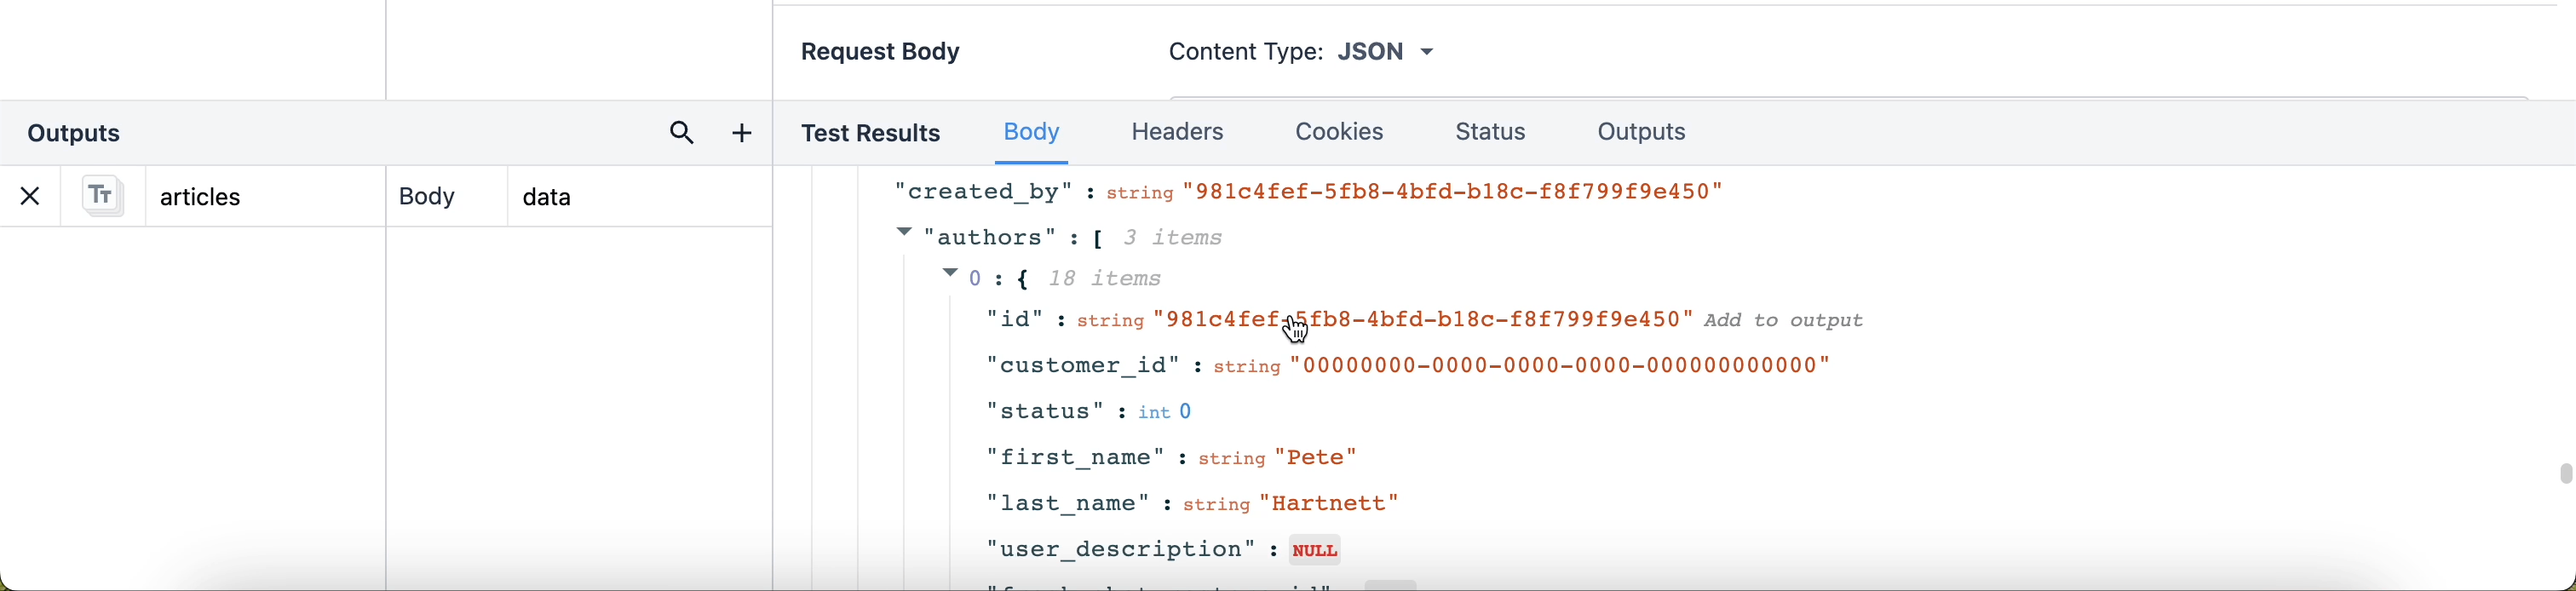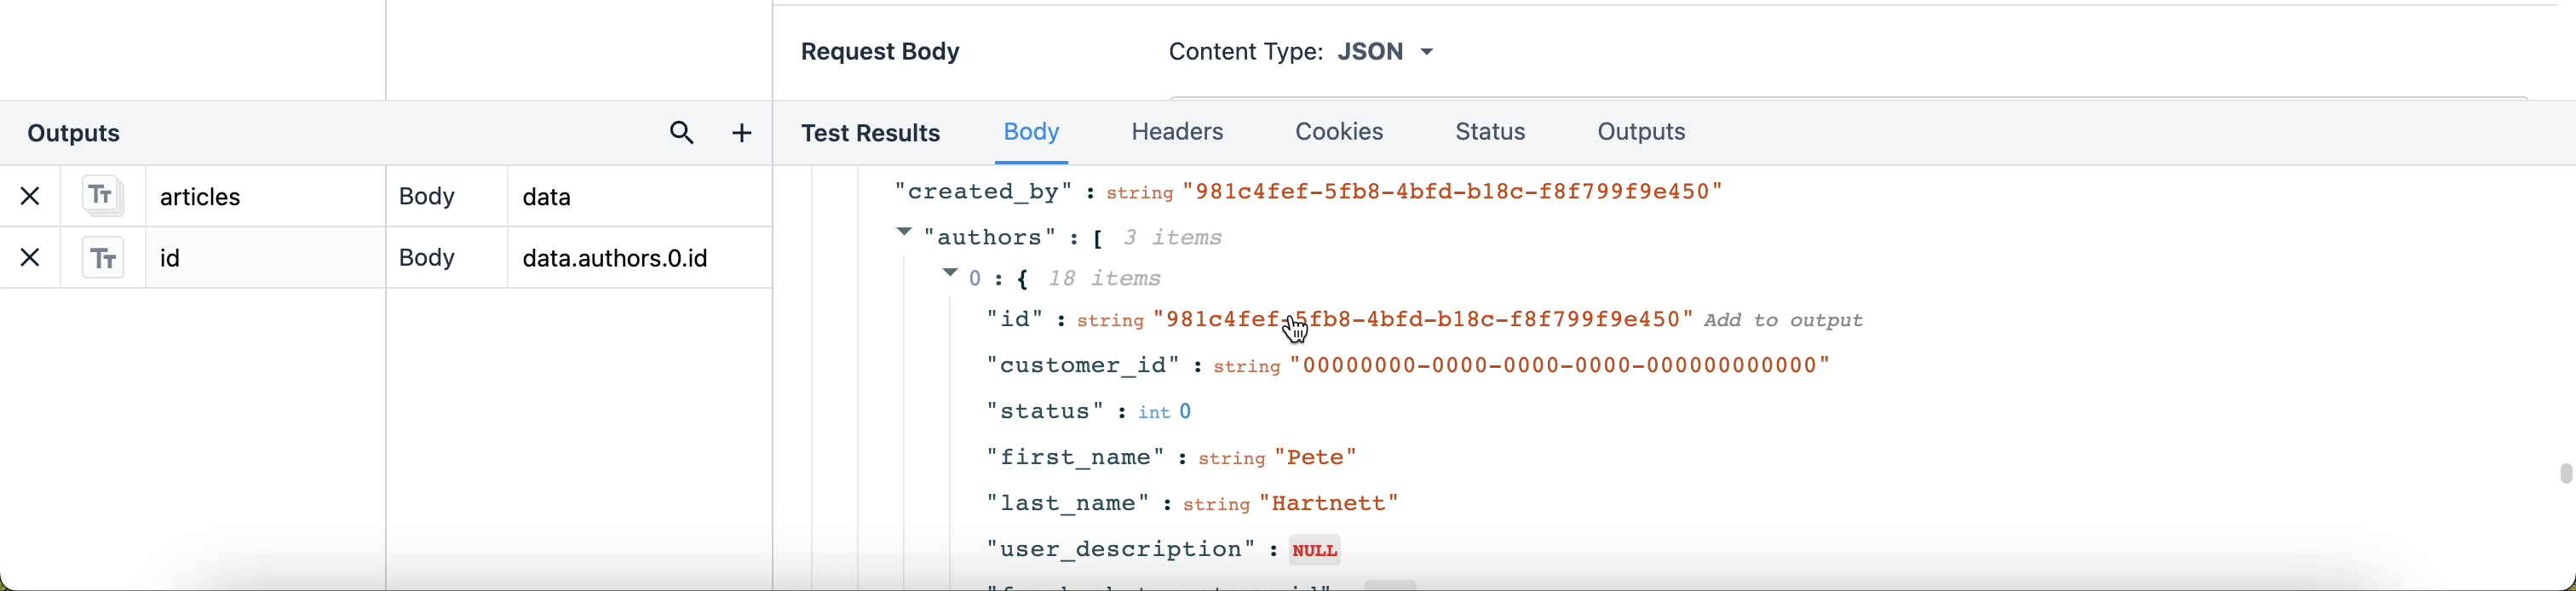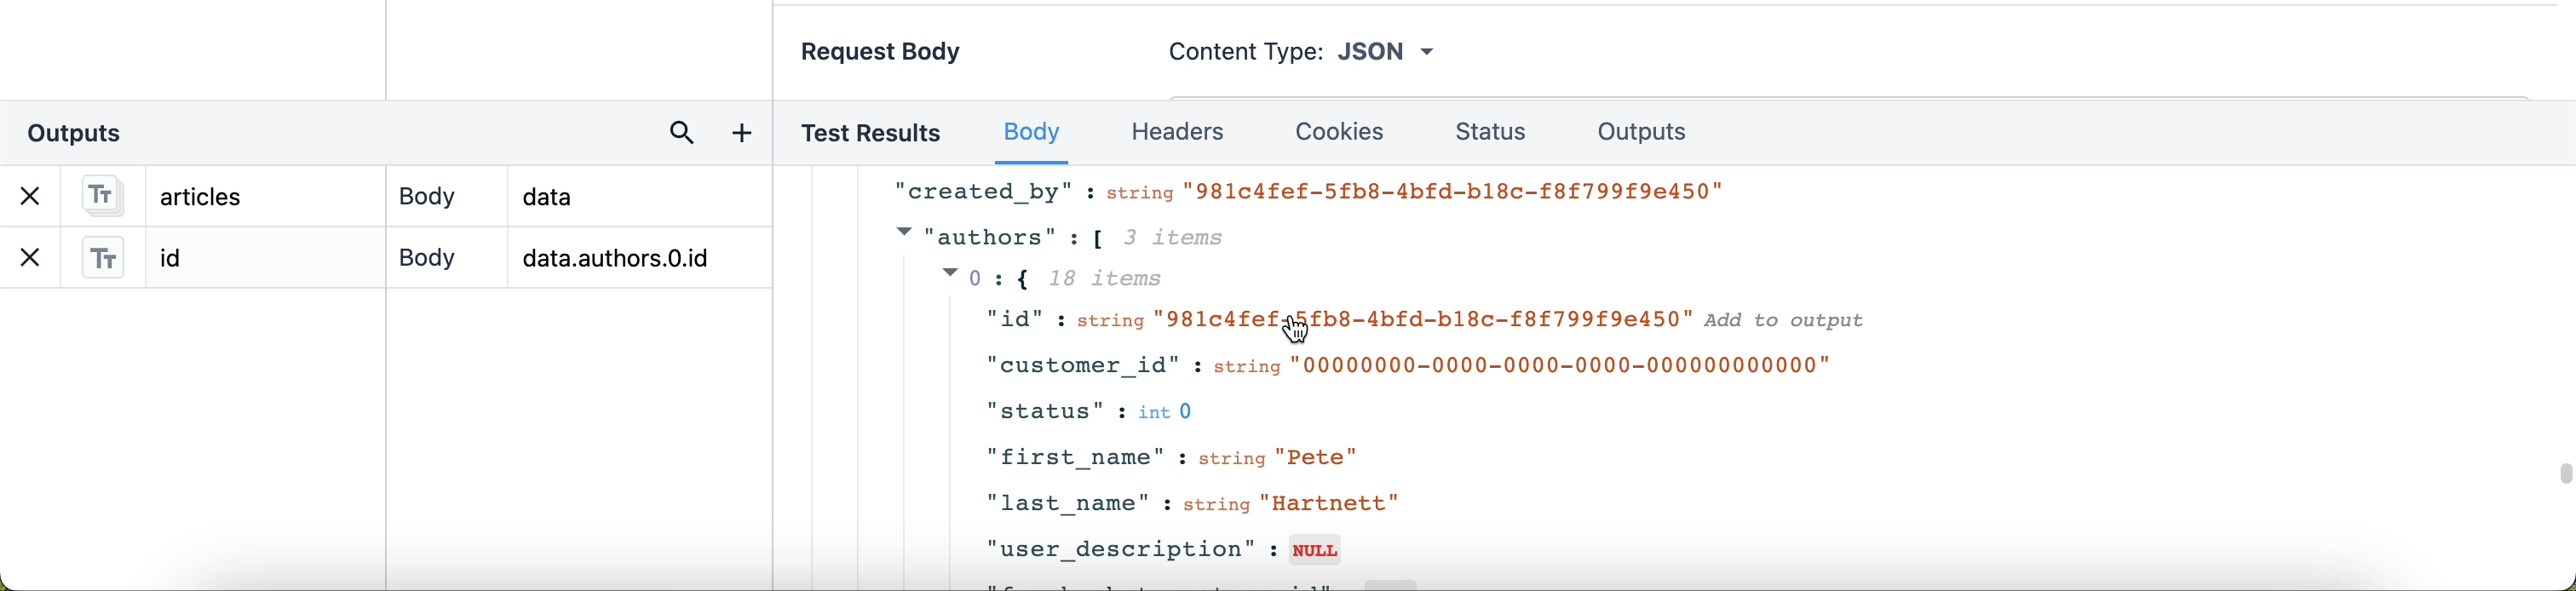
Para uma maneira fácil de escrever o caminho de saída, você também pode clicar em uma linha de dados para adicioná-la como uma nova saída.
Para mais informações sobre o uso da notação por pontos, consulte este recurso: Processmaker: Notação por Pontos em JSON.
Resultados de saída
Existem várias maneiras de estruturar saídas, mas a forma como você faz isso depende inteiramente do que deseja fazer com os dados em seus aplicativos. Antes de começar a estruturar as saídas, pense no seu objetivo final. Você deseja exibir vários tipos de dados em variáveis individuais? Ou você tem os mesmos tipos de dados em um array que deseja simplesmente analisar para extrair informações relevantes?
Todos os exemplos a seguir se baseiam na mesma função de conector e, em cada caso, o corpo dos resultados do teste é o mesmo. As saídas, no entanto, variam de acordo com a forma como são estruturadas.
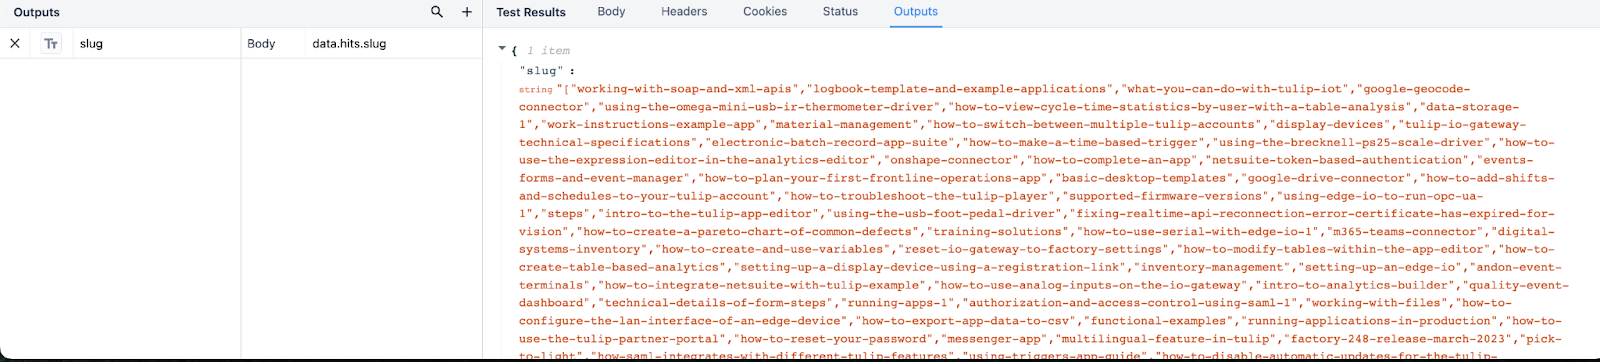
O exemplo a seguir mostra como o conector gera saídas para o caminho JSON data.hits.slug. Da forma como essa saída está estruturada, o conector retorna um grande array com todos os slugs de URL dos artigos da Base de Conhecimento. Em nossos aplicativos, esse retorno do conector estará acessível dentro de uma variável de array.
Podemos estruturar as saídas como uma lista de objetos e extrair tipos de dados individuais dos resultados, criando vários objetos de dados que podem ser visualizados individualmente nas aplicações.
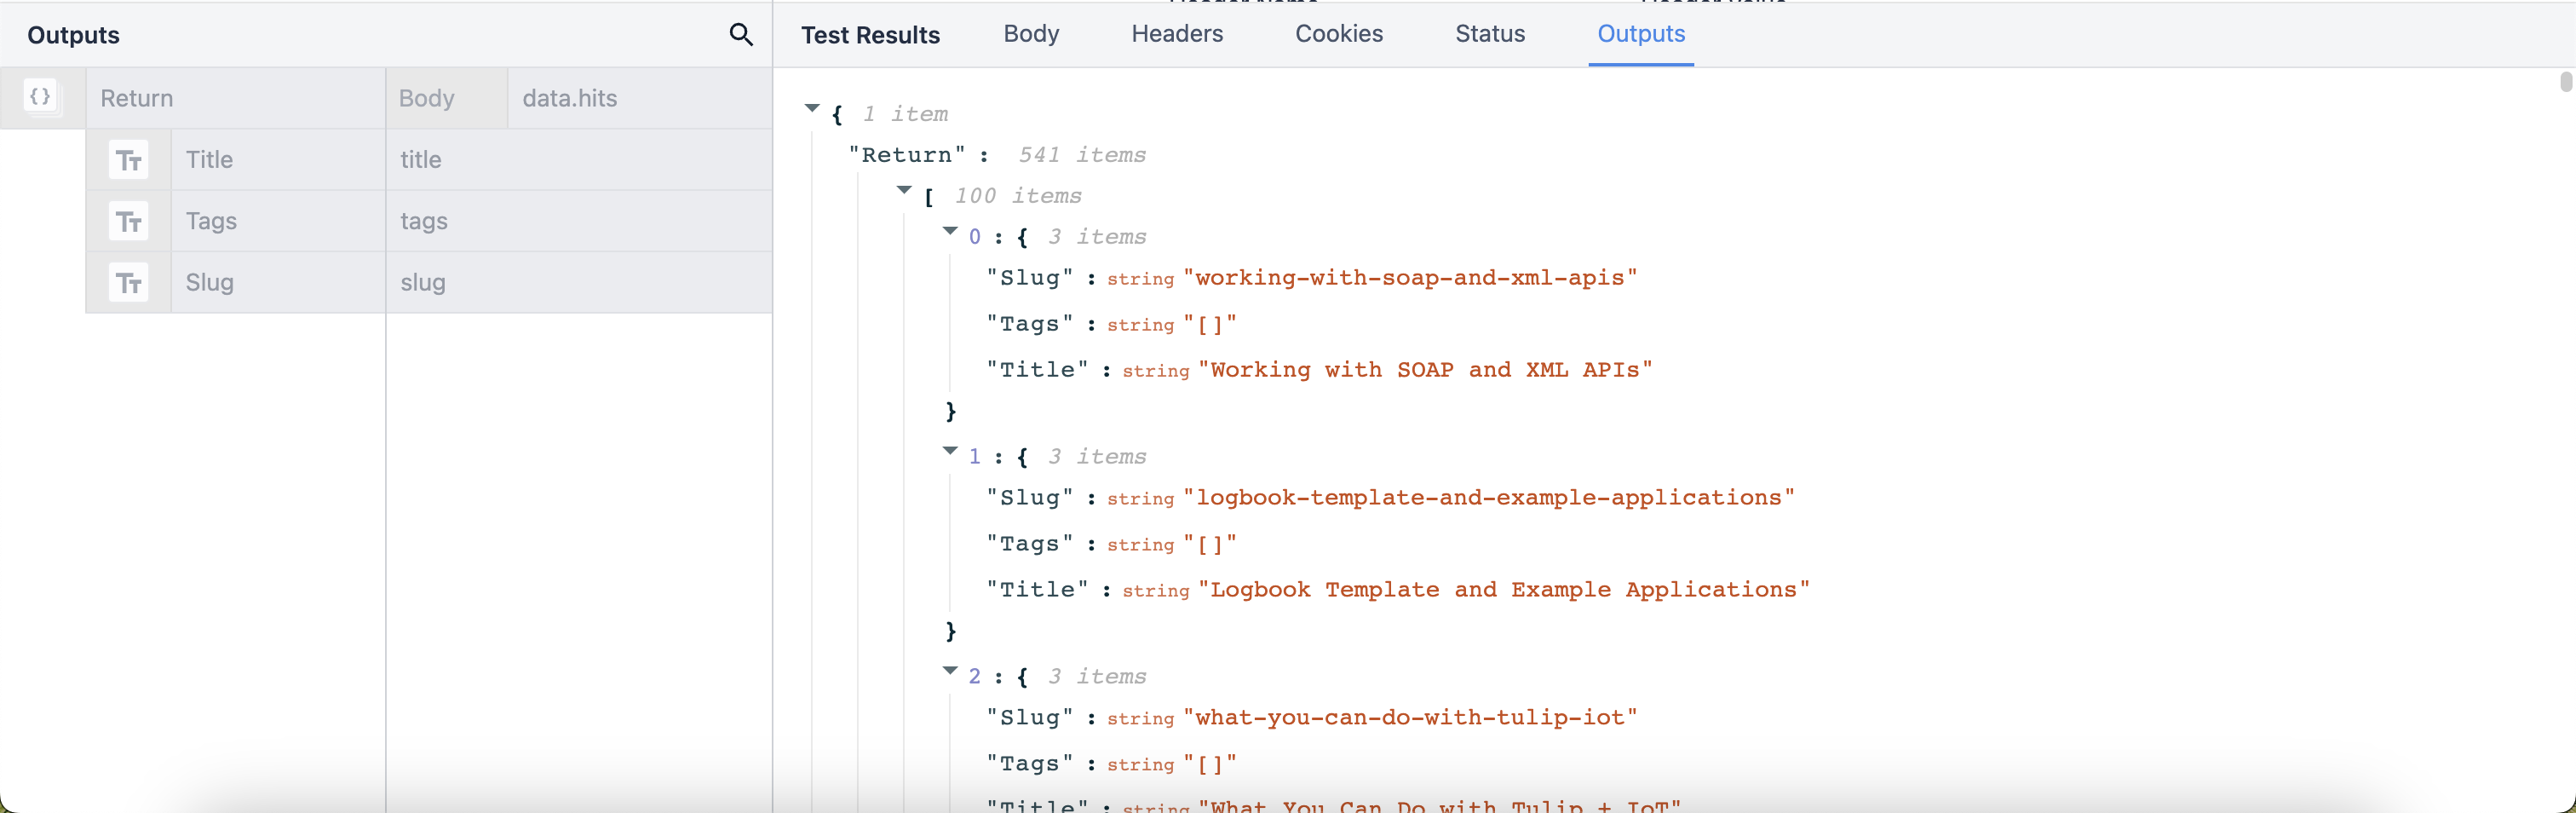
Listas de objetos são objetos que contêm vários tipos de dados aninhados em seu interior. Use listas de objetos clicando no tipo de saída e ativando o botão “Lista” no canto direito.
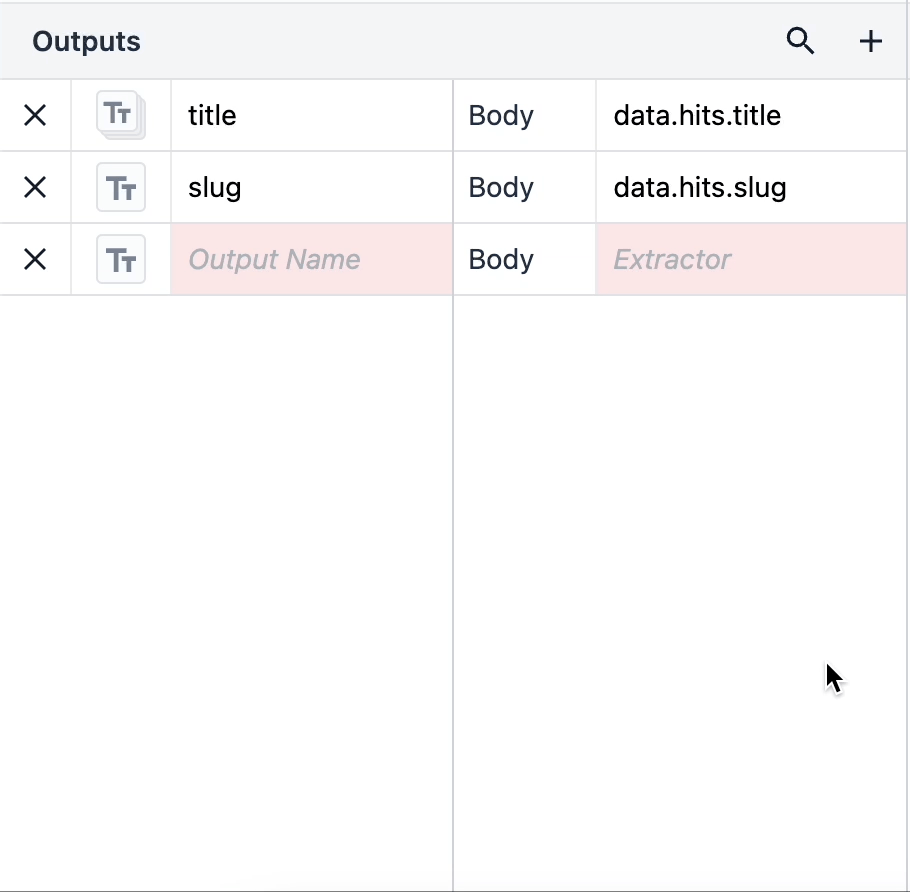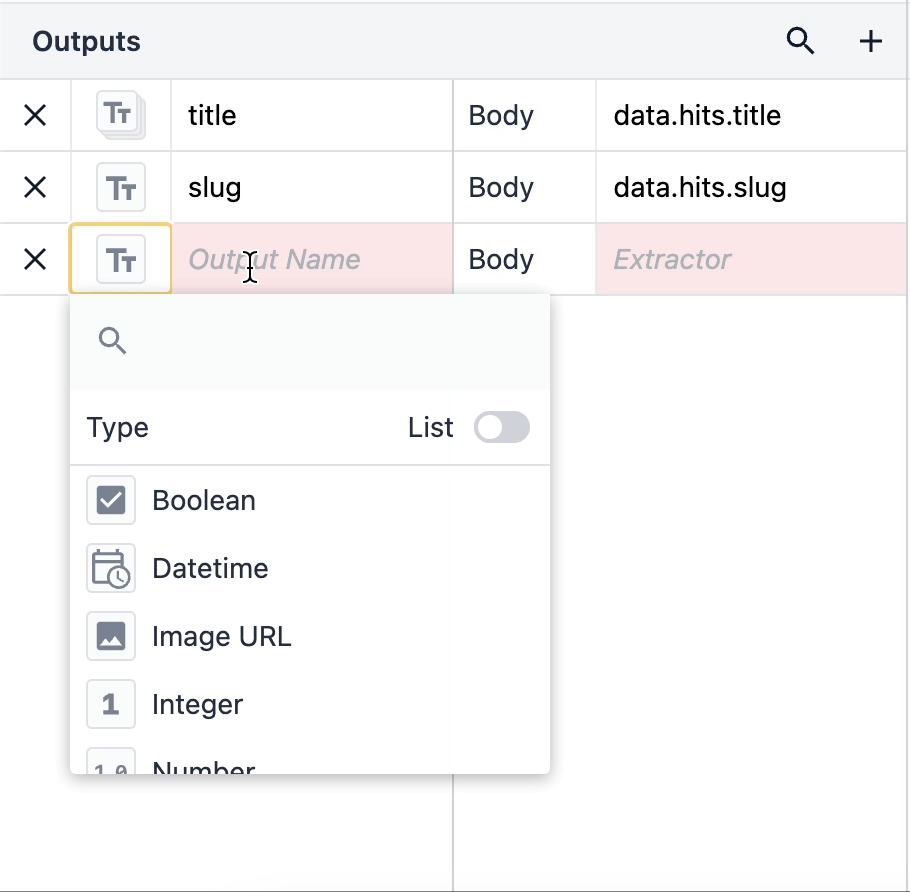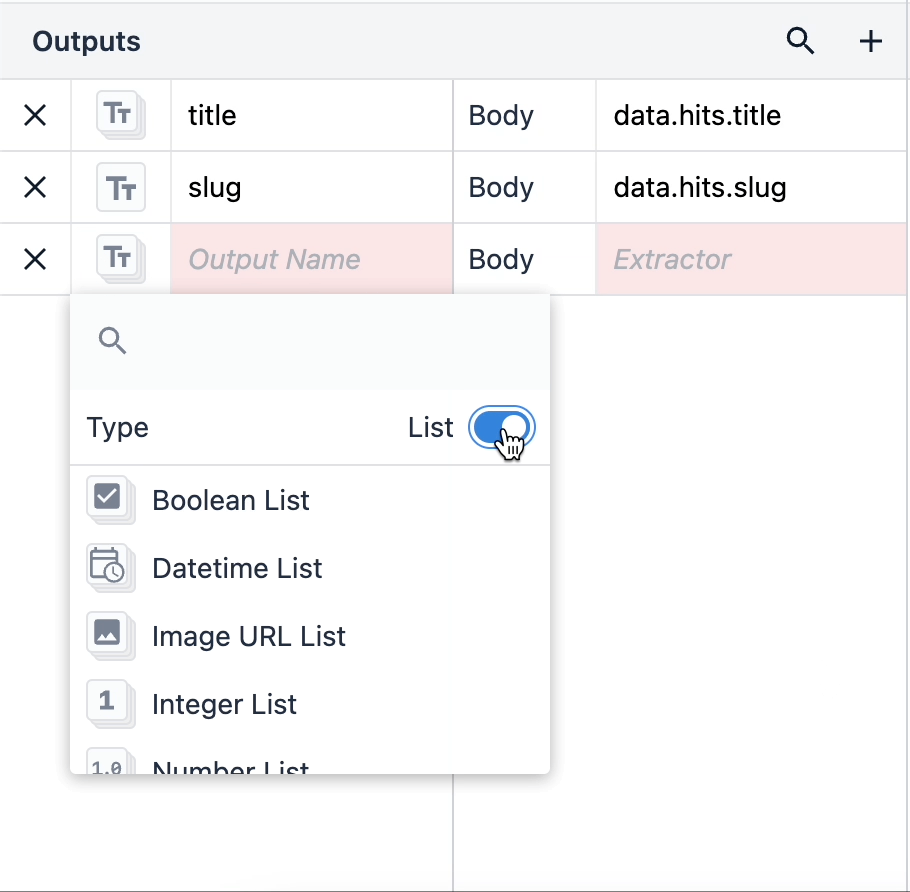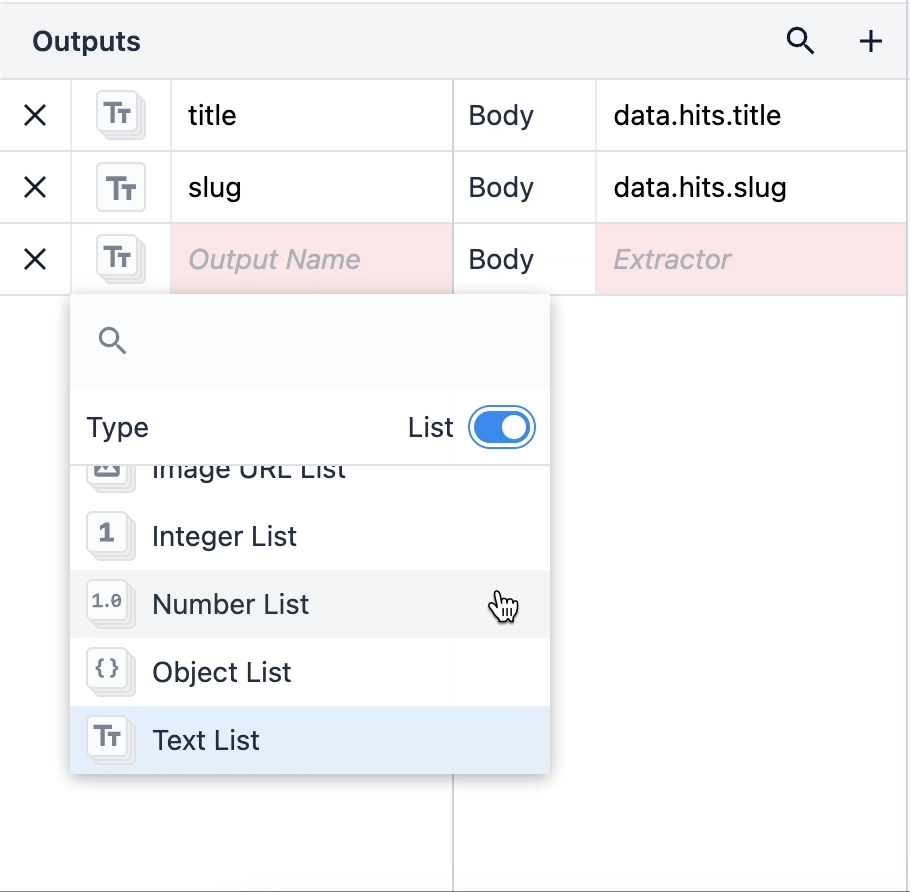
Quando você tem uma lista de objetos, pode usar facilmente diferentes tipos de dados como elementos individuais em seus aplicativos.
Se voltarmos ao exemplo acima, vamos transformar nosso caminho de saída data.hits.slug em uma lista. Você pode ver nos resultados abaixo que o Tulip está estruturando o retorno desse conector como uma matriz de slugs, com cada posição de índice listada ao lado de cada valor.
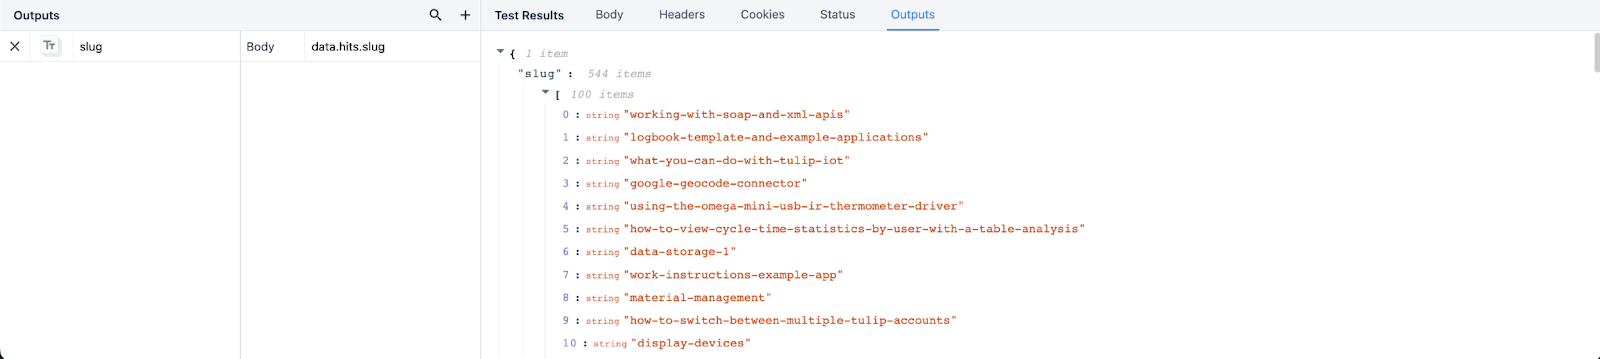
Com esse entendimento sobre as saídas em mente, agora você pode mapear as saídas para suas próprias funções de conector e otimizar os resultados retornados pelos seus conectores!
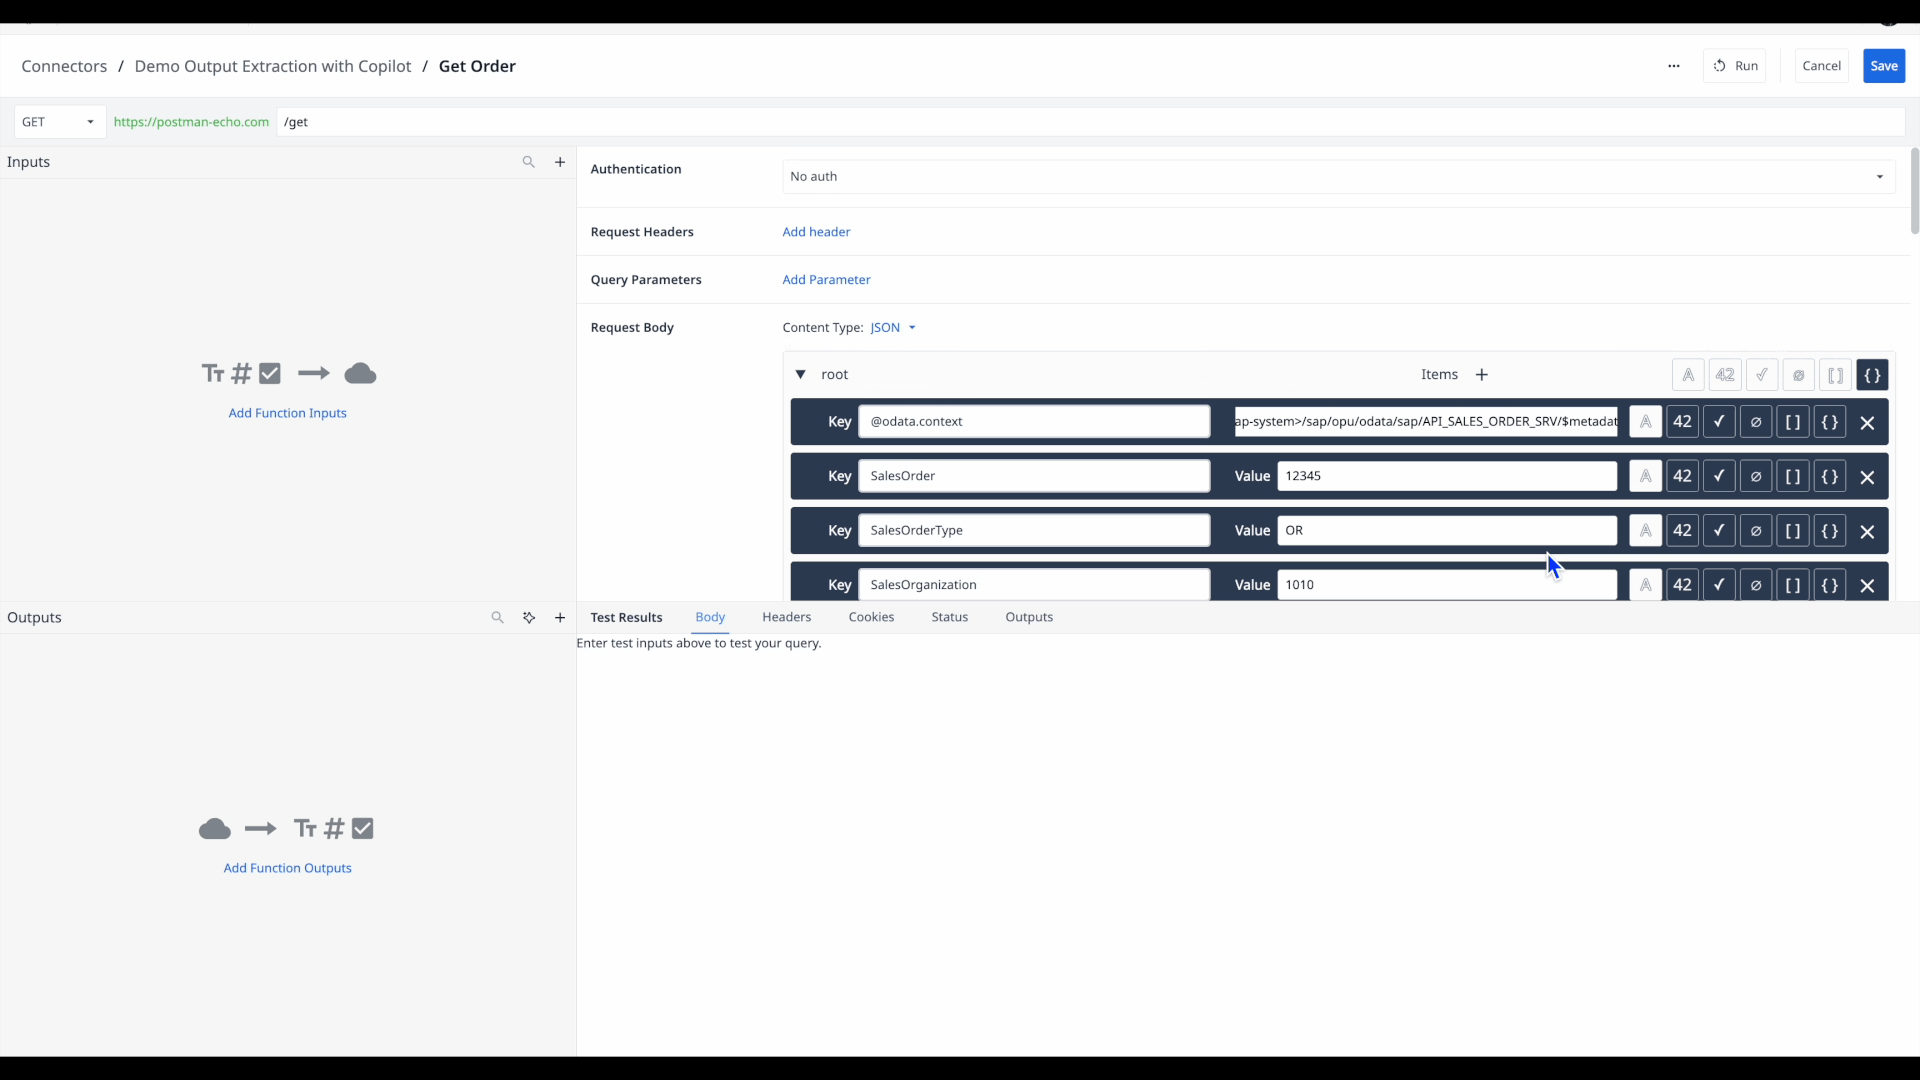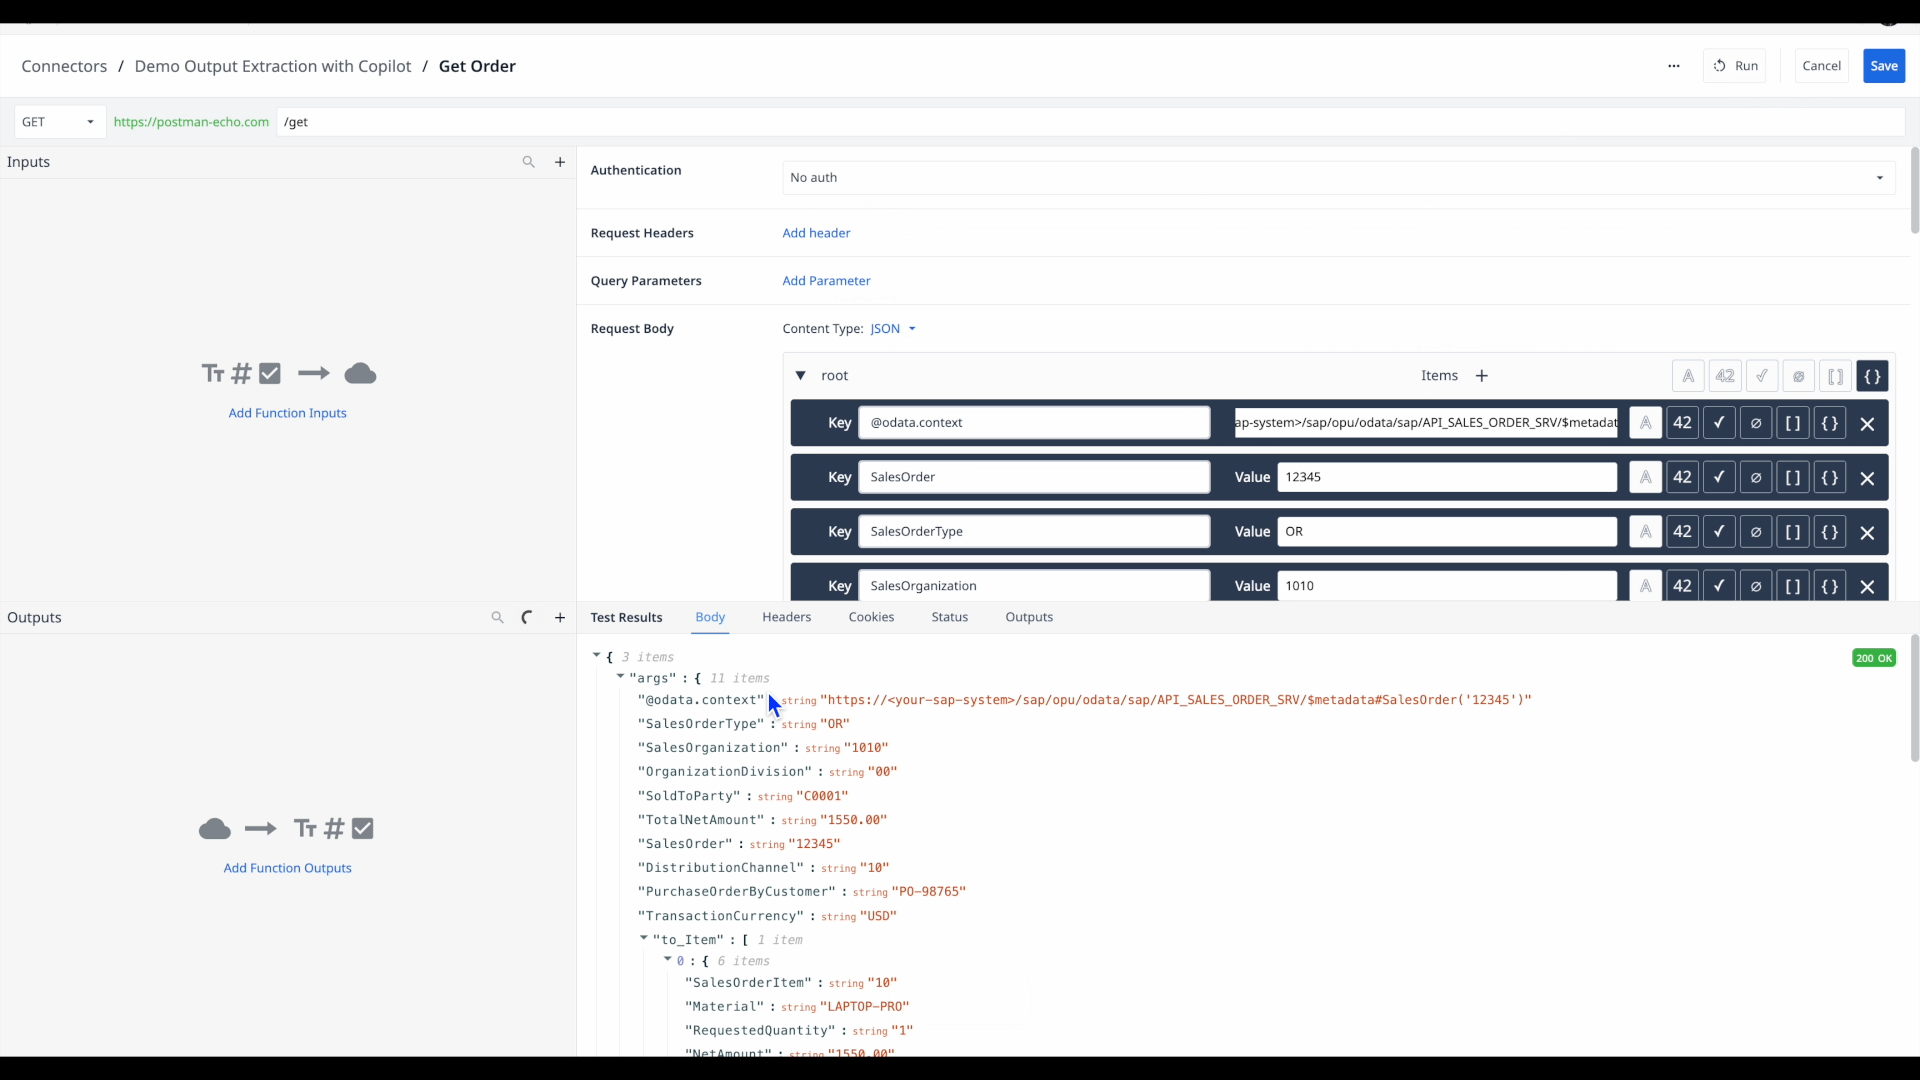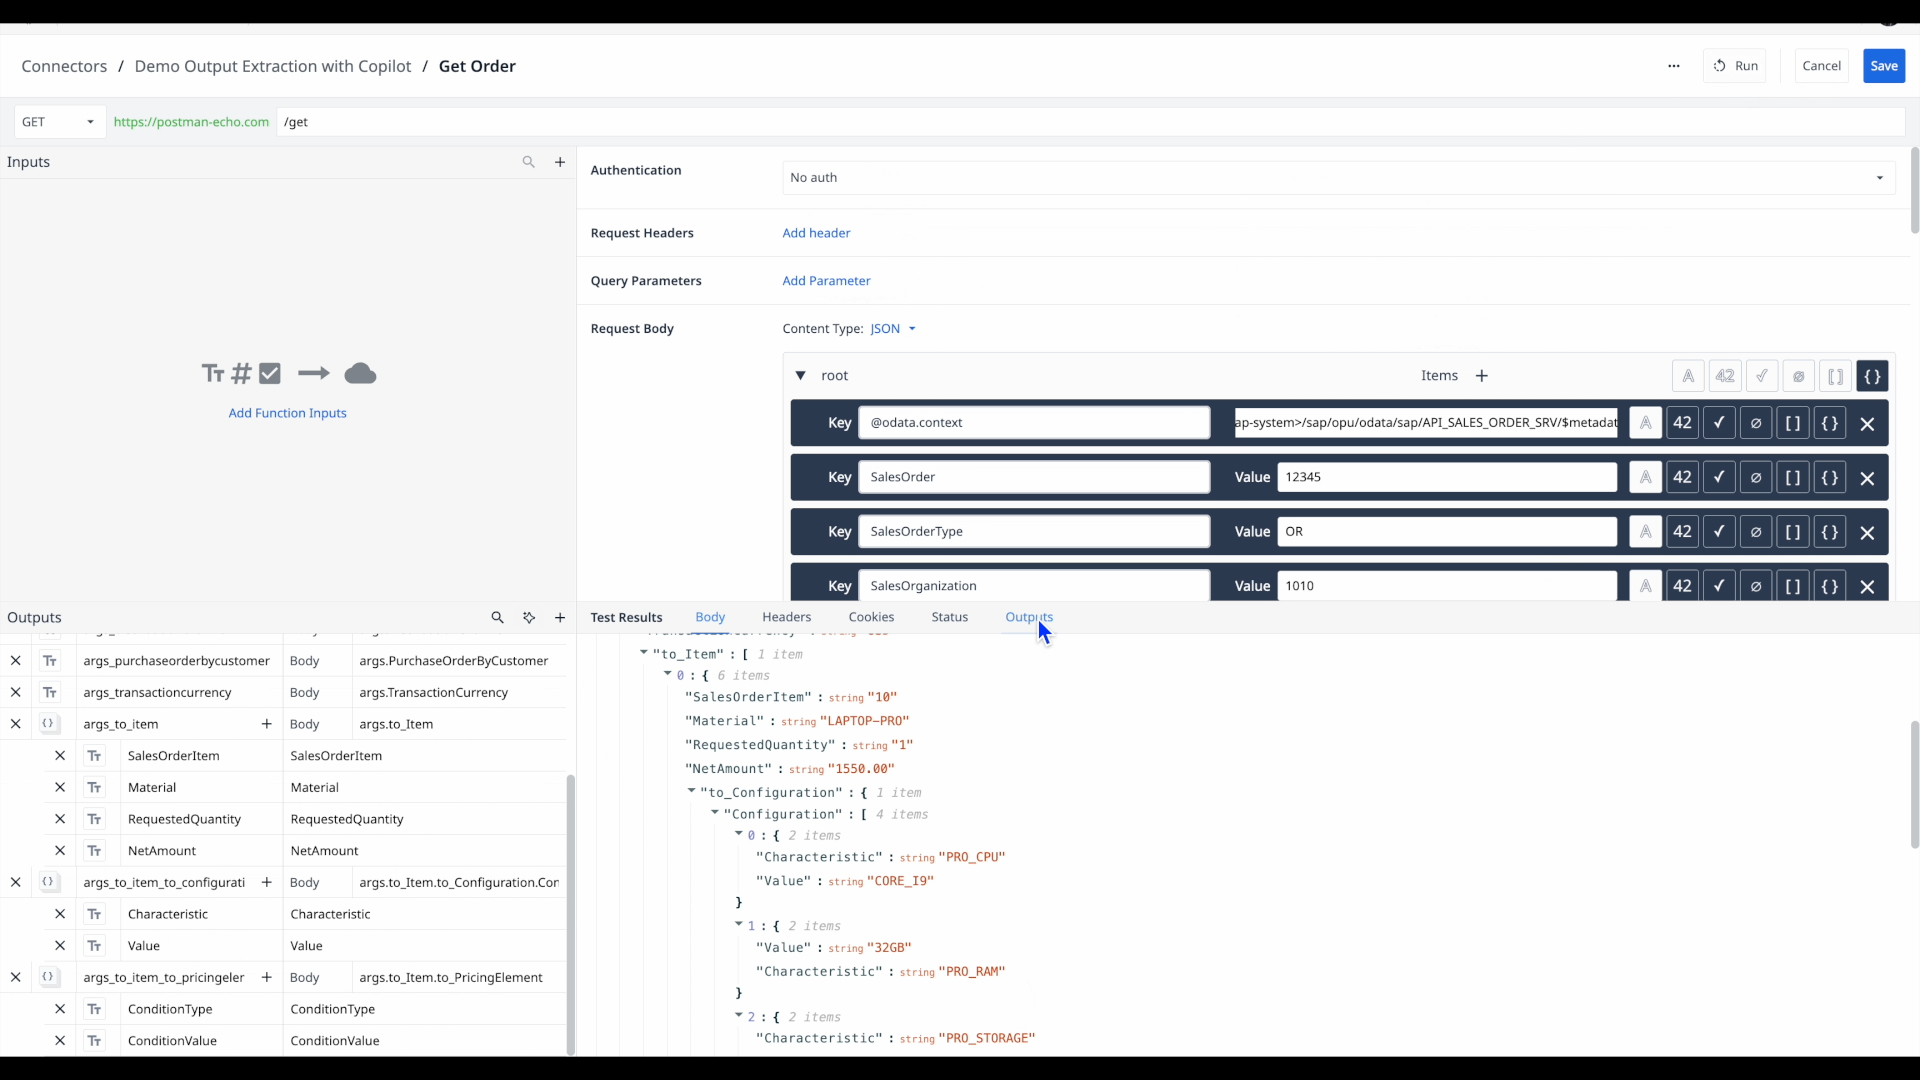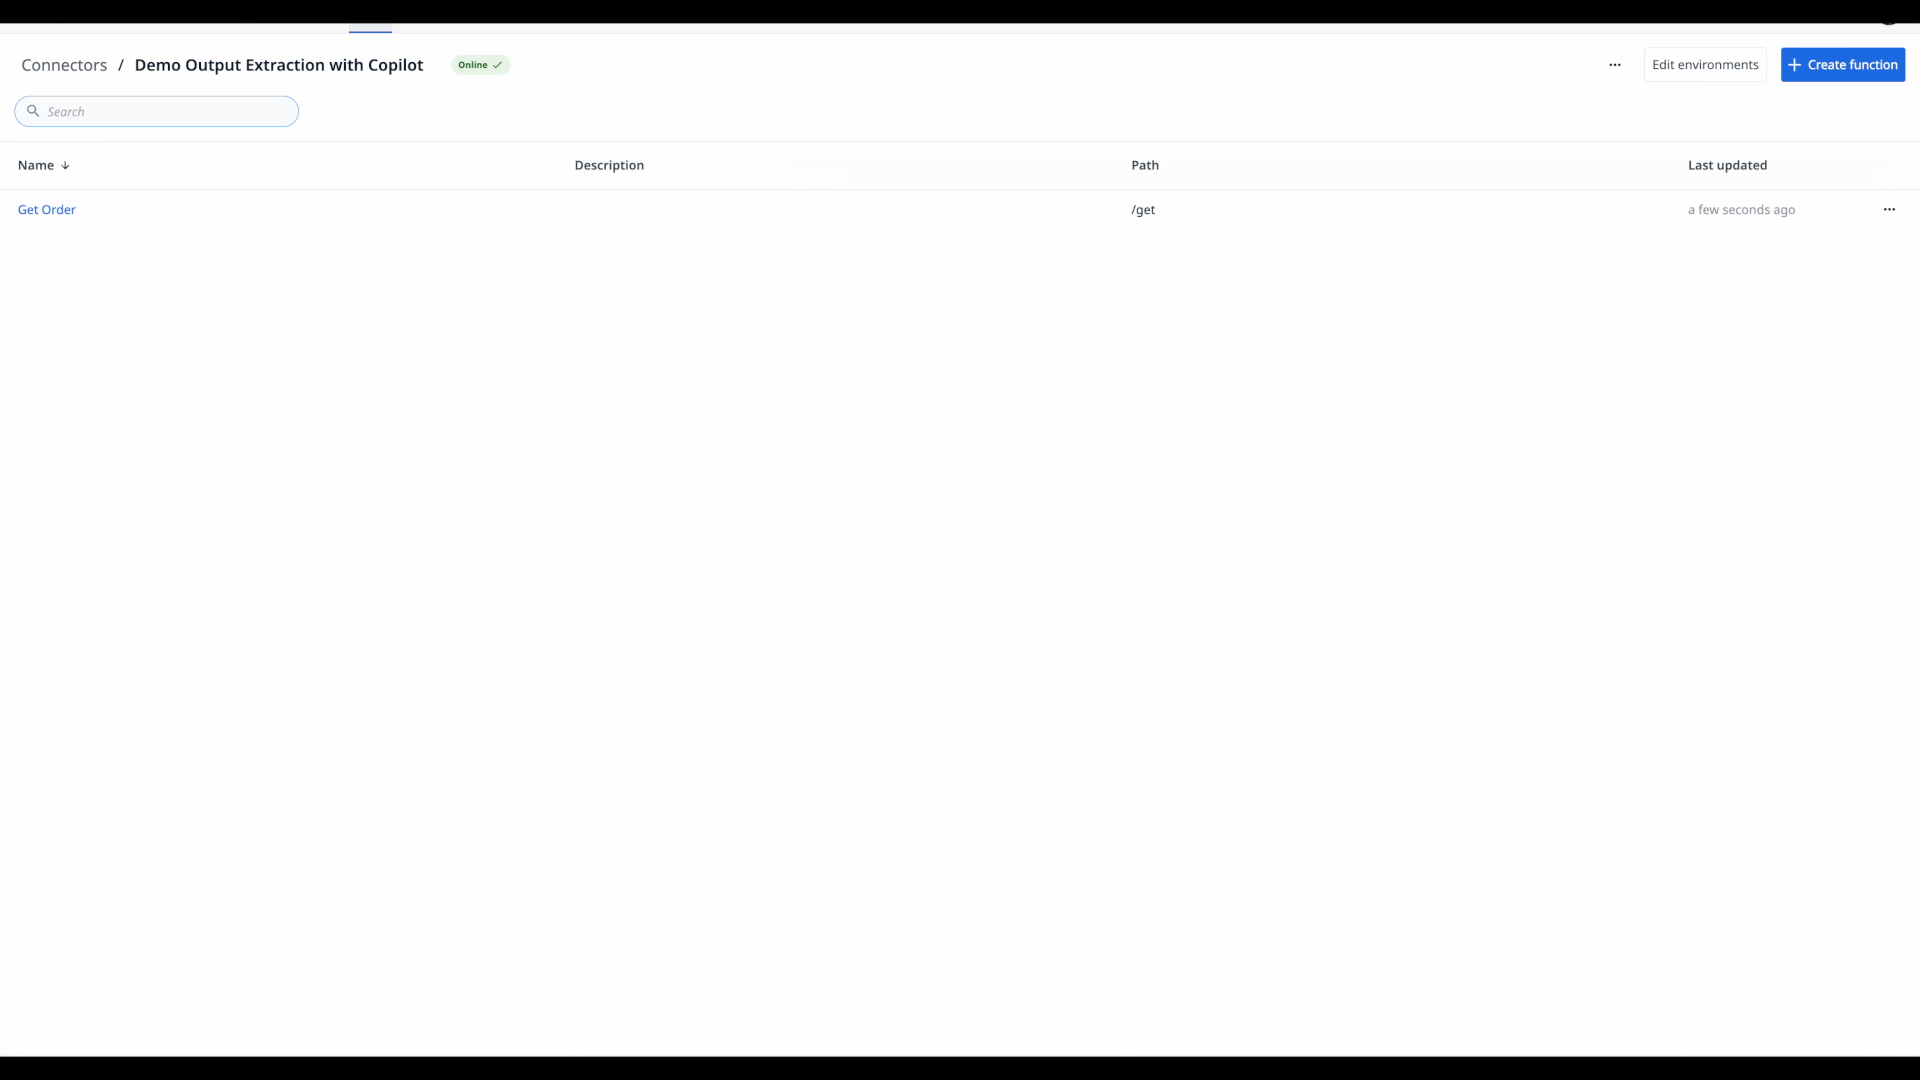
Use o Tulip AI para extração de saídas
Estruture rapidamente suas saídas, aproveitando os exemplos e conceitos já abordados no artigo, como ( e Lista de Objetos).
O Tulip AI oferece um atalho poderoso para analisar automaticamente a resposta JSON em seus Resultados de Teste e gerar os caminhos correspondentes na Notação Dot. Ele tenta replicar a estrutura de objetos aninhados, mas simplificará matrizes ou objetos complexos quando necessário.
O Tulip AI não altera suas saídas e extrações existentes. Ele apenas gera saídas novas, ou não especificadas, para acelerar o processo inicial de configuração das saídas.
Depois que o Tulip AI gerar as saídas, você deverá revisá-las em relação ao objetivo do seu aplicativo.
Ao revisar, siga estas práticas recomendadas:* Remova quaisquer saídas desnecessárias* Renomeie as variáveis para maior clareza* Ajuste manualmente a estrutura de saída (por exemplo, garantindo que as matrizes estejam corretamente definidas como listas de objetos)
Essas etapas garantem que você esteja extraindo apenas os dados necessários para sua aplicação.
Leitura complementar
- Uso de conectores HTTP em aplicativos
- Exibição de listas interativas de registros de tabela ou resultados de conectores em aplicativos
{{snippet.Você encontrou o que estava procurando?}}