
Qui peut utiliser cette fonctionnalité ?
Les utilisateurs disposant d’un forfait Entreprise ou supérieur.
Schéma d’importation et d’exportation
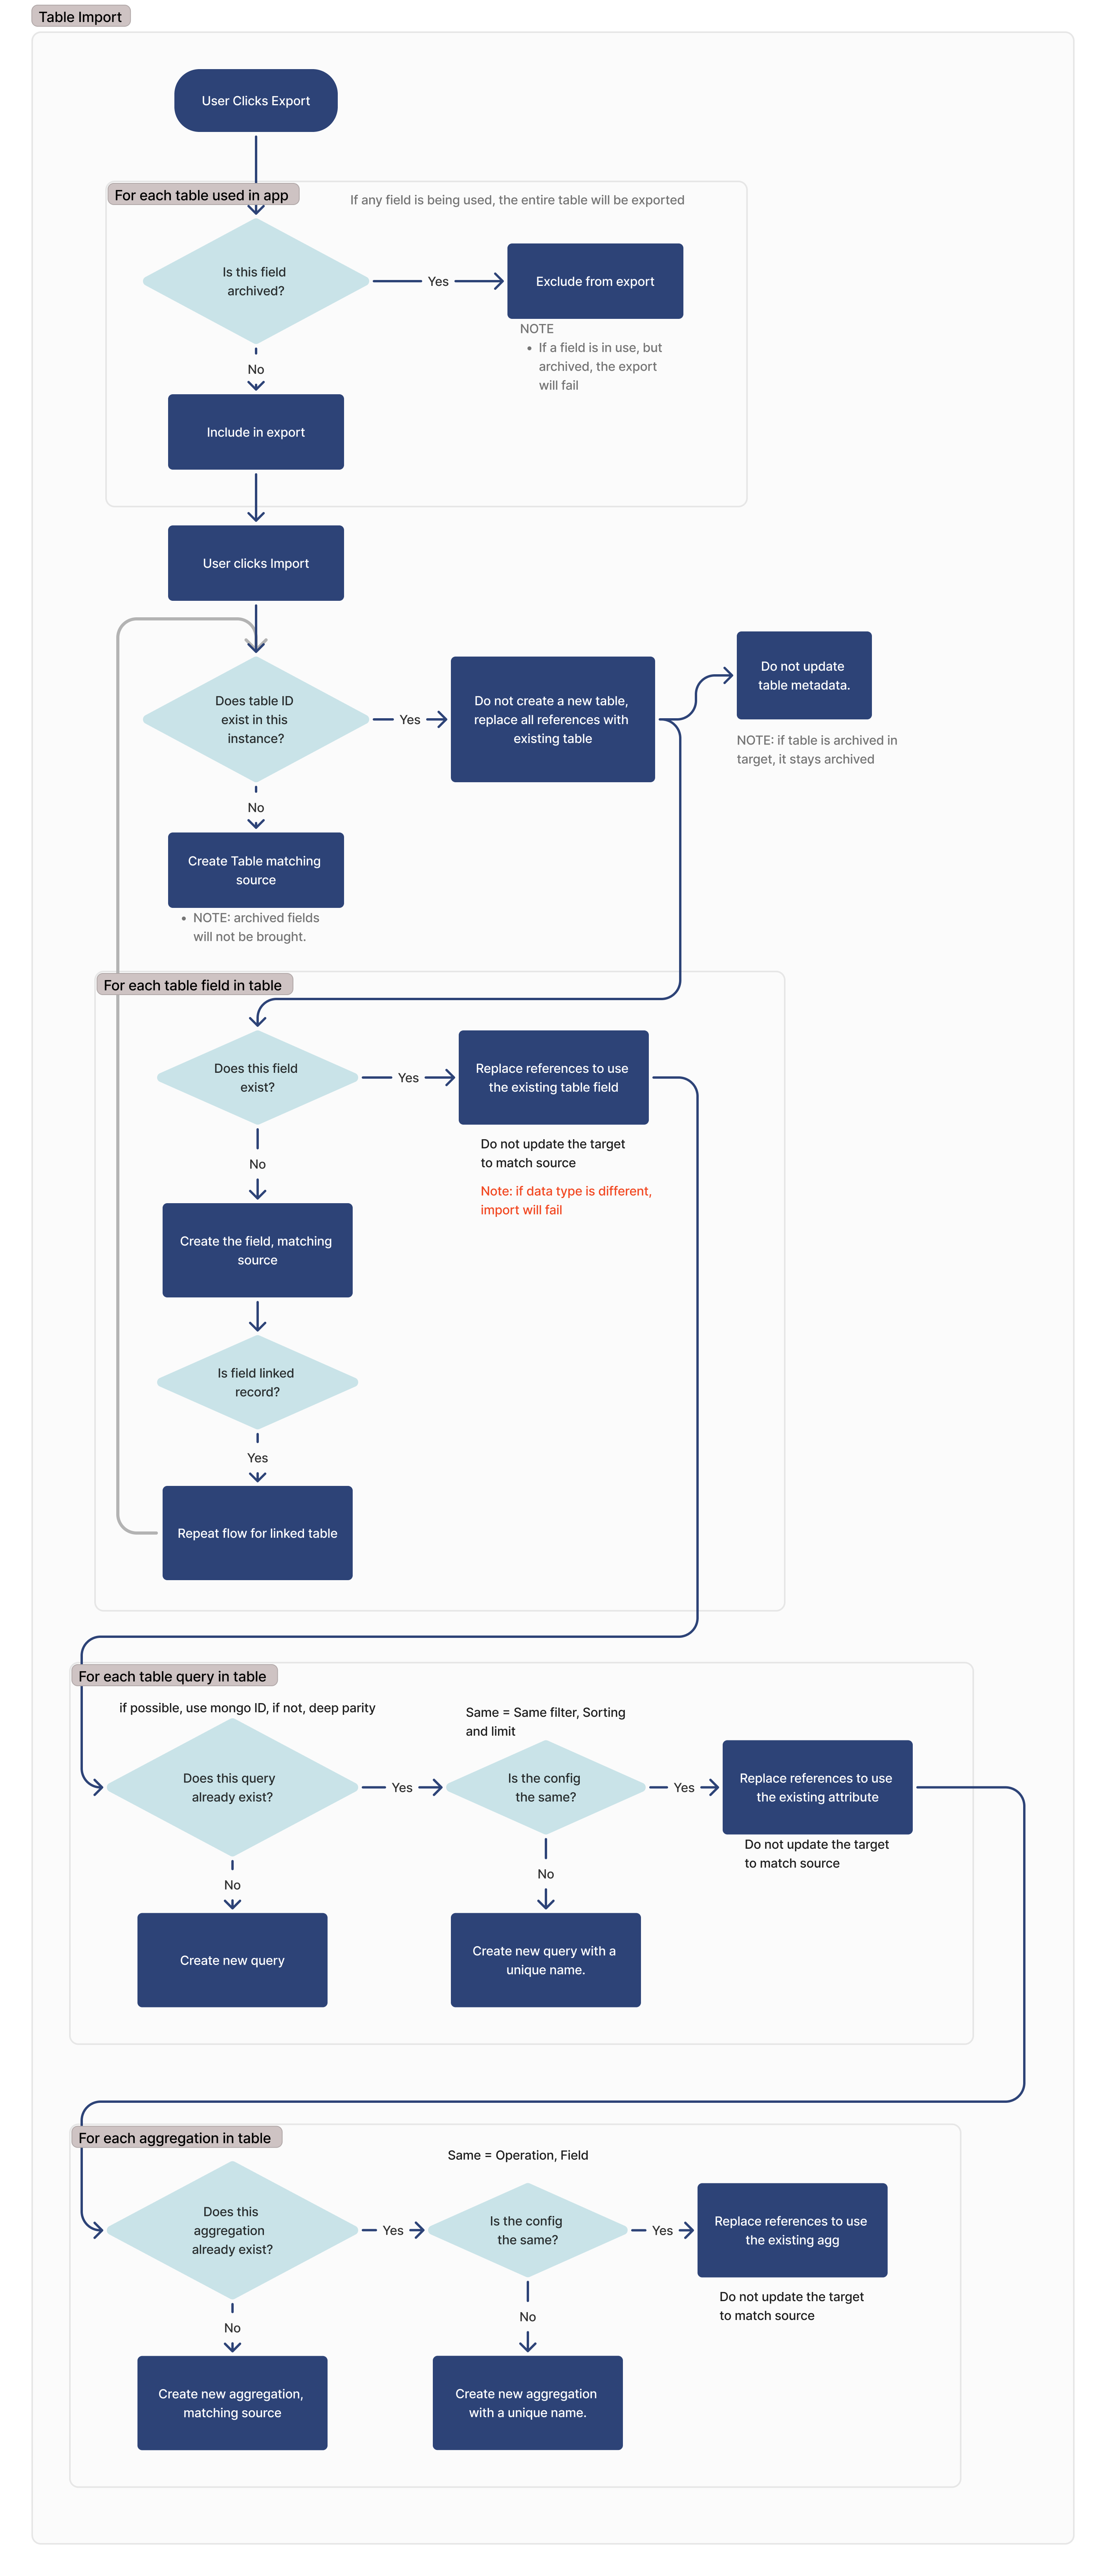
Vous trouverez ci-dessous l'ensemble du flux de transfert pour les tables, requêtes et agrégations Tulip. Ce document fournit une explication détaillée de ce flux.
Champs utilisateur personnalisés et tables d'activité des machines
Le processus décrit ci-dessous s'applique également à l'exportation et à l'importation des tables de champs utilisateur personnalisés et des tables d'activité des machines.
Exportation
Au cours du processus d’exportation, l’application ou l’automatisation exportée inclura toutes les tables utilisées au sein de cette application. Une table est considérée comme utilisée si l’une des conditions suivantes est remplie :
- Affichée dans un widget « Enregistrement de tableau »
- Utilisée dans un widget de saisie
- Affichée dans un tableau interactif
- Utilisée dans un déclencheur
- Utilisée dans une action d’automatisation
- Utilisé dans un bloc d’événement d’automatisation
- Utilisé dans un filtre pour une requête de tableau, un tableau interactif ou un widget d'analyse
- Utilisé comme entrée ou sortie pour un widget personnalisé
Si un champ est archivé, il ne sera pas exporté. Si un champ est archivé mais utilisé, l'exportation échouera.
Importation
Recherche d’une table identique
Pour identifier les tables correspondantes lors de l’importation, nous recherchons les ID correspondants. Si une table portant le même ID est trouvée, nous ne créons pas de nouvelle table et utilisons celle qui existe déjà.
Si une table est archivée sur la source et n'existe pas sur la destination, elle est créée sur la destination et sera archivée.
Si la table de l’instance source est archivée, elle le restera. Une table archivée reste archivée ; une table non archivée reste non archivée.
Pour chaque champ de table
Pour chaque champ de table, nous recherchons un champ correspondant en fonction de l’ID de colonne de ce champ.
Si le type de données du champ correspondant est différent, l’importation échouera.
Si le champ est un champ d’enregistrement lié, la table liée sera ajoutée à la liste des dépendances pour l’importation, et ce processus sera répété pour cette table.
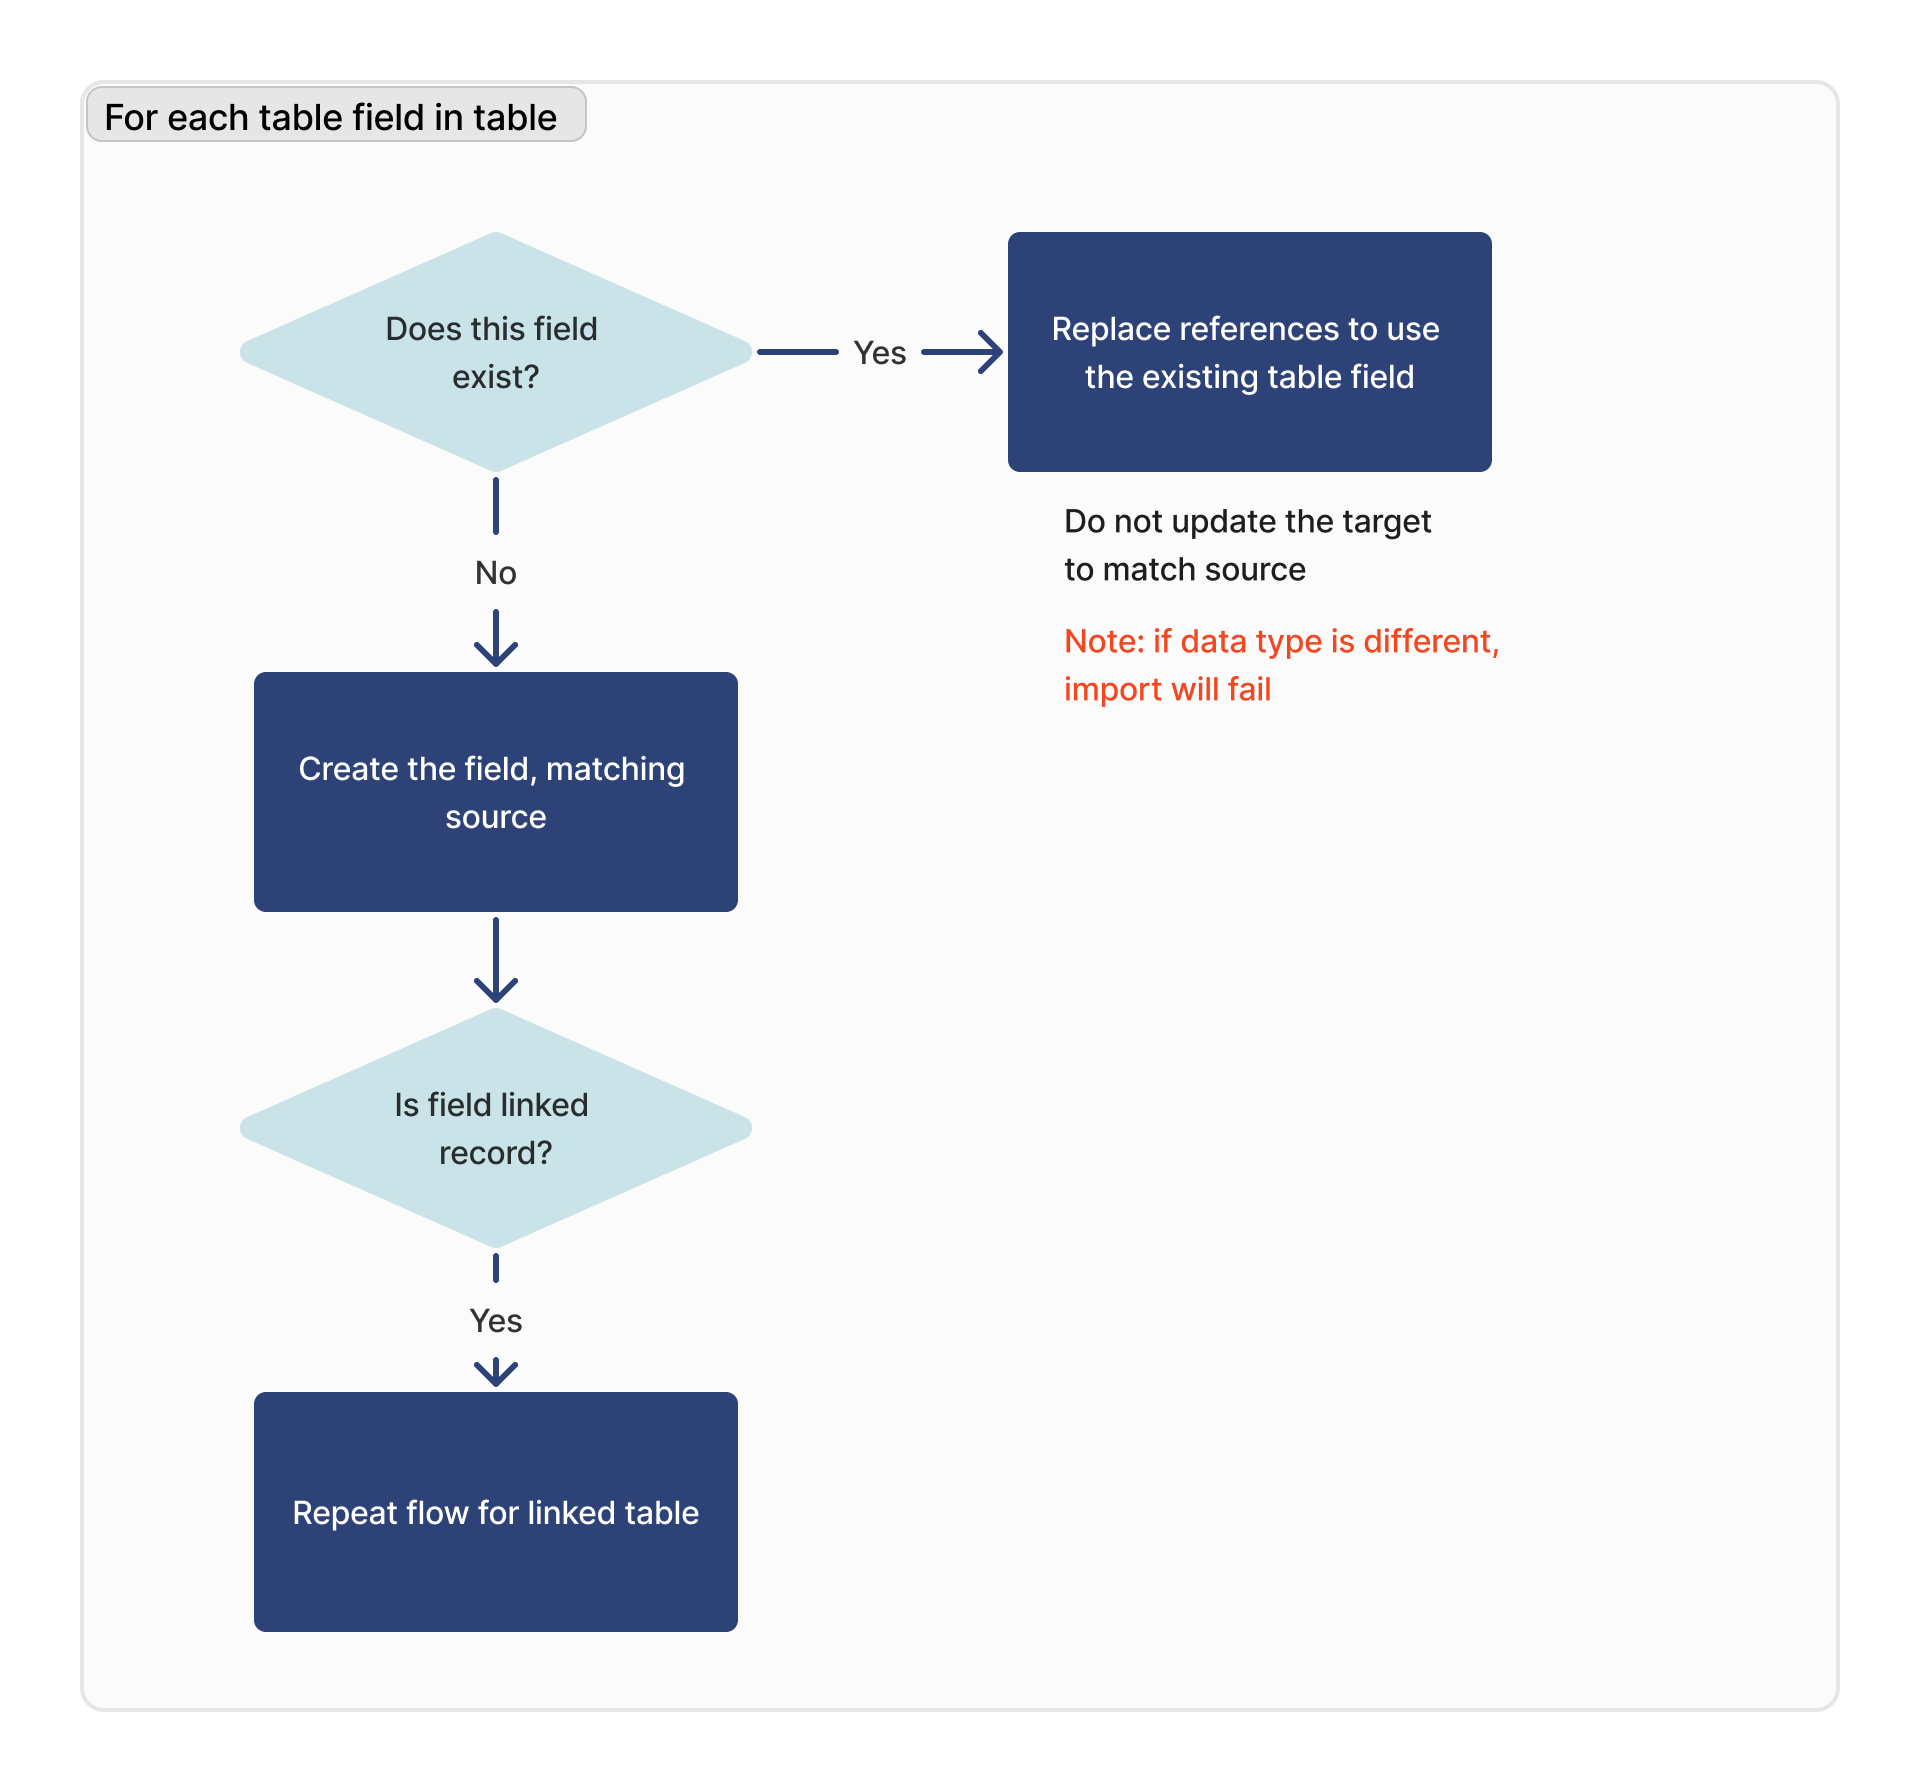
Si un champ est archivé dans la source et n’existe pas dans la destination, il est créé dans la destination en tant que champ non archivé (remarque : ce comportement diffère de celui des tables).
Si un champ existe déjà dans la base de destination, son statut d’archivage n’est jamais mis à jour par l’importation. Un champ archivé reste archivé ; un champ non archivé reste non archivé.
When exporting a table directly, archived fields are not included. However, if an archived field is referenced by an app, it will be included in the export (with the above import rules applying).
Pour chaque requête
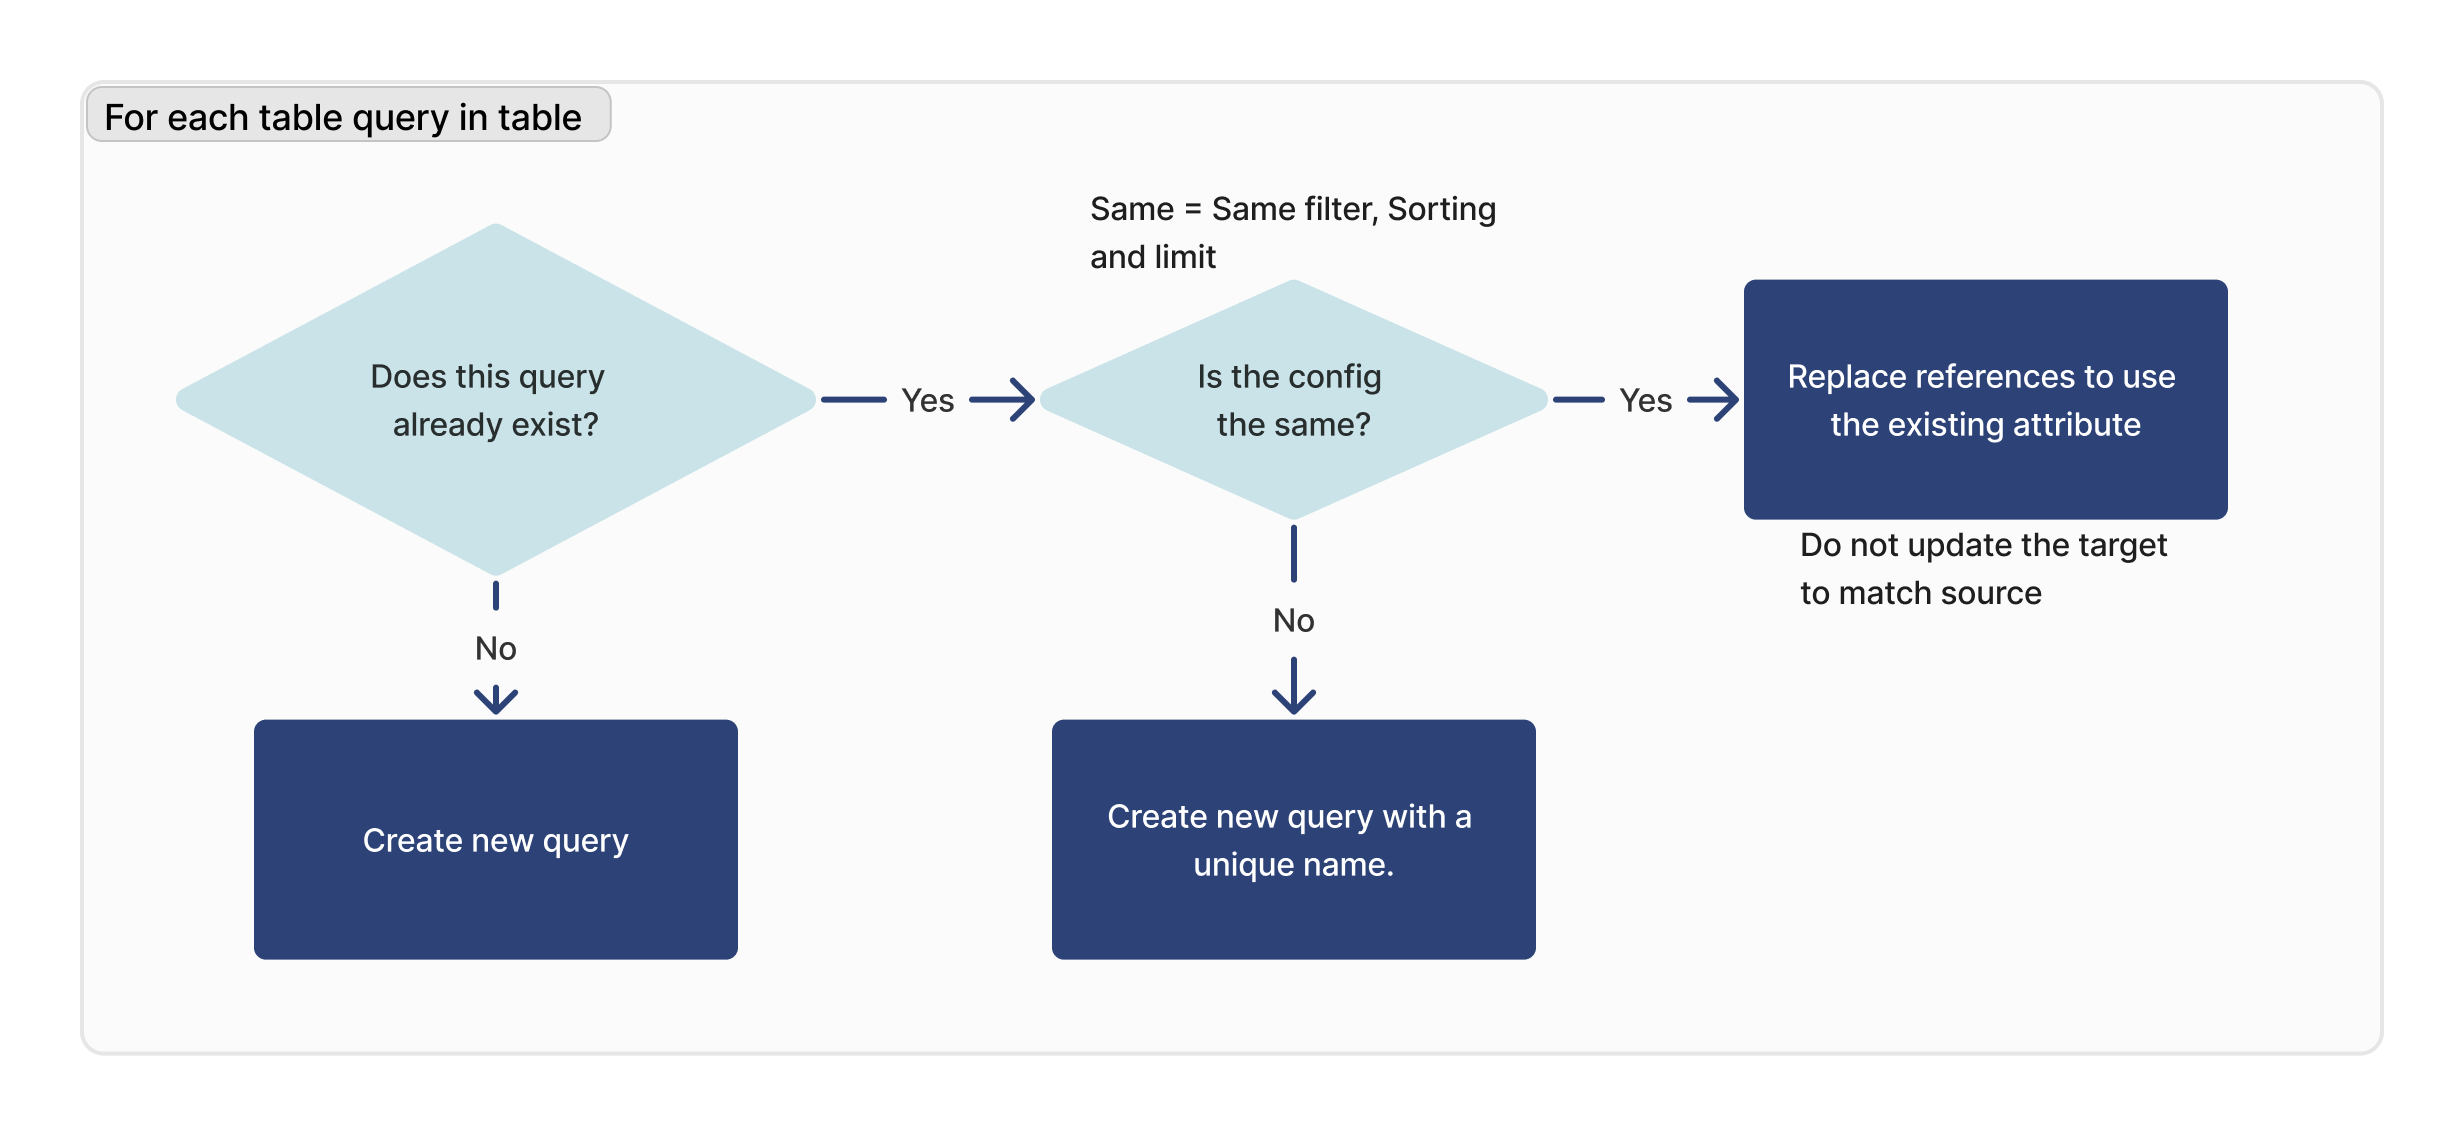
Pour chaque requête de la table importée, nous vérifions si cette requête existe. Si un ID correspondant est trouvé, nous vérifions que la configuration est identique (limite, tri et filtrage) entre la cible et la source.
Si aucune requête correspondante n’est trouvée, une nouvelle requête sera créée. Si une requête correspondante est trouvée, mais qu’elle n’est pas identique à celle de l’instance cible, une nouvelle requête sera créée avec un nouveau nom.
Remarque : cela ne s'applique pas aux champs utilisateur personnalisés ni aux tables d'activité des machines.
Les mises à jour apportées au comportement d’importation/exportation réduisent les doublons. Les requêtes de table sont désormais importées sous forme de « development version ». La requête de table ne sera importée en tant qu’instantané que si la même requête existe déjà et présente une configuration différente.
development versions L’ancien comportement (qui existe toujours dans les instances r329/LTS14 et antérieures) importait les instantanés en tant qu’instantanés et les requêtes de table en tant que development versions.
Pour chaque agrégation
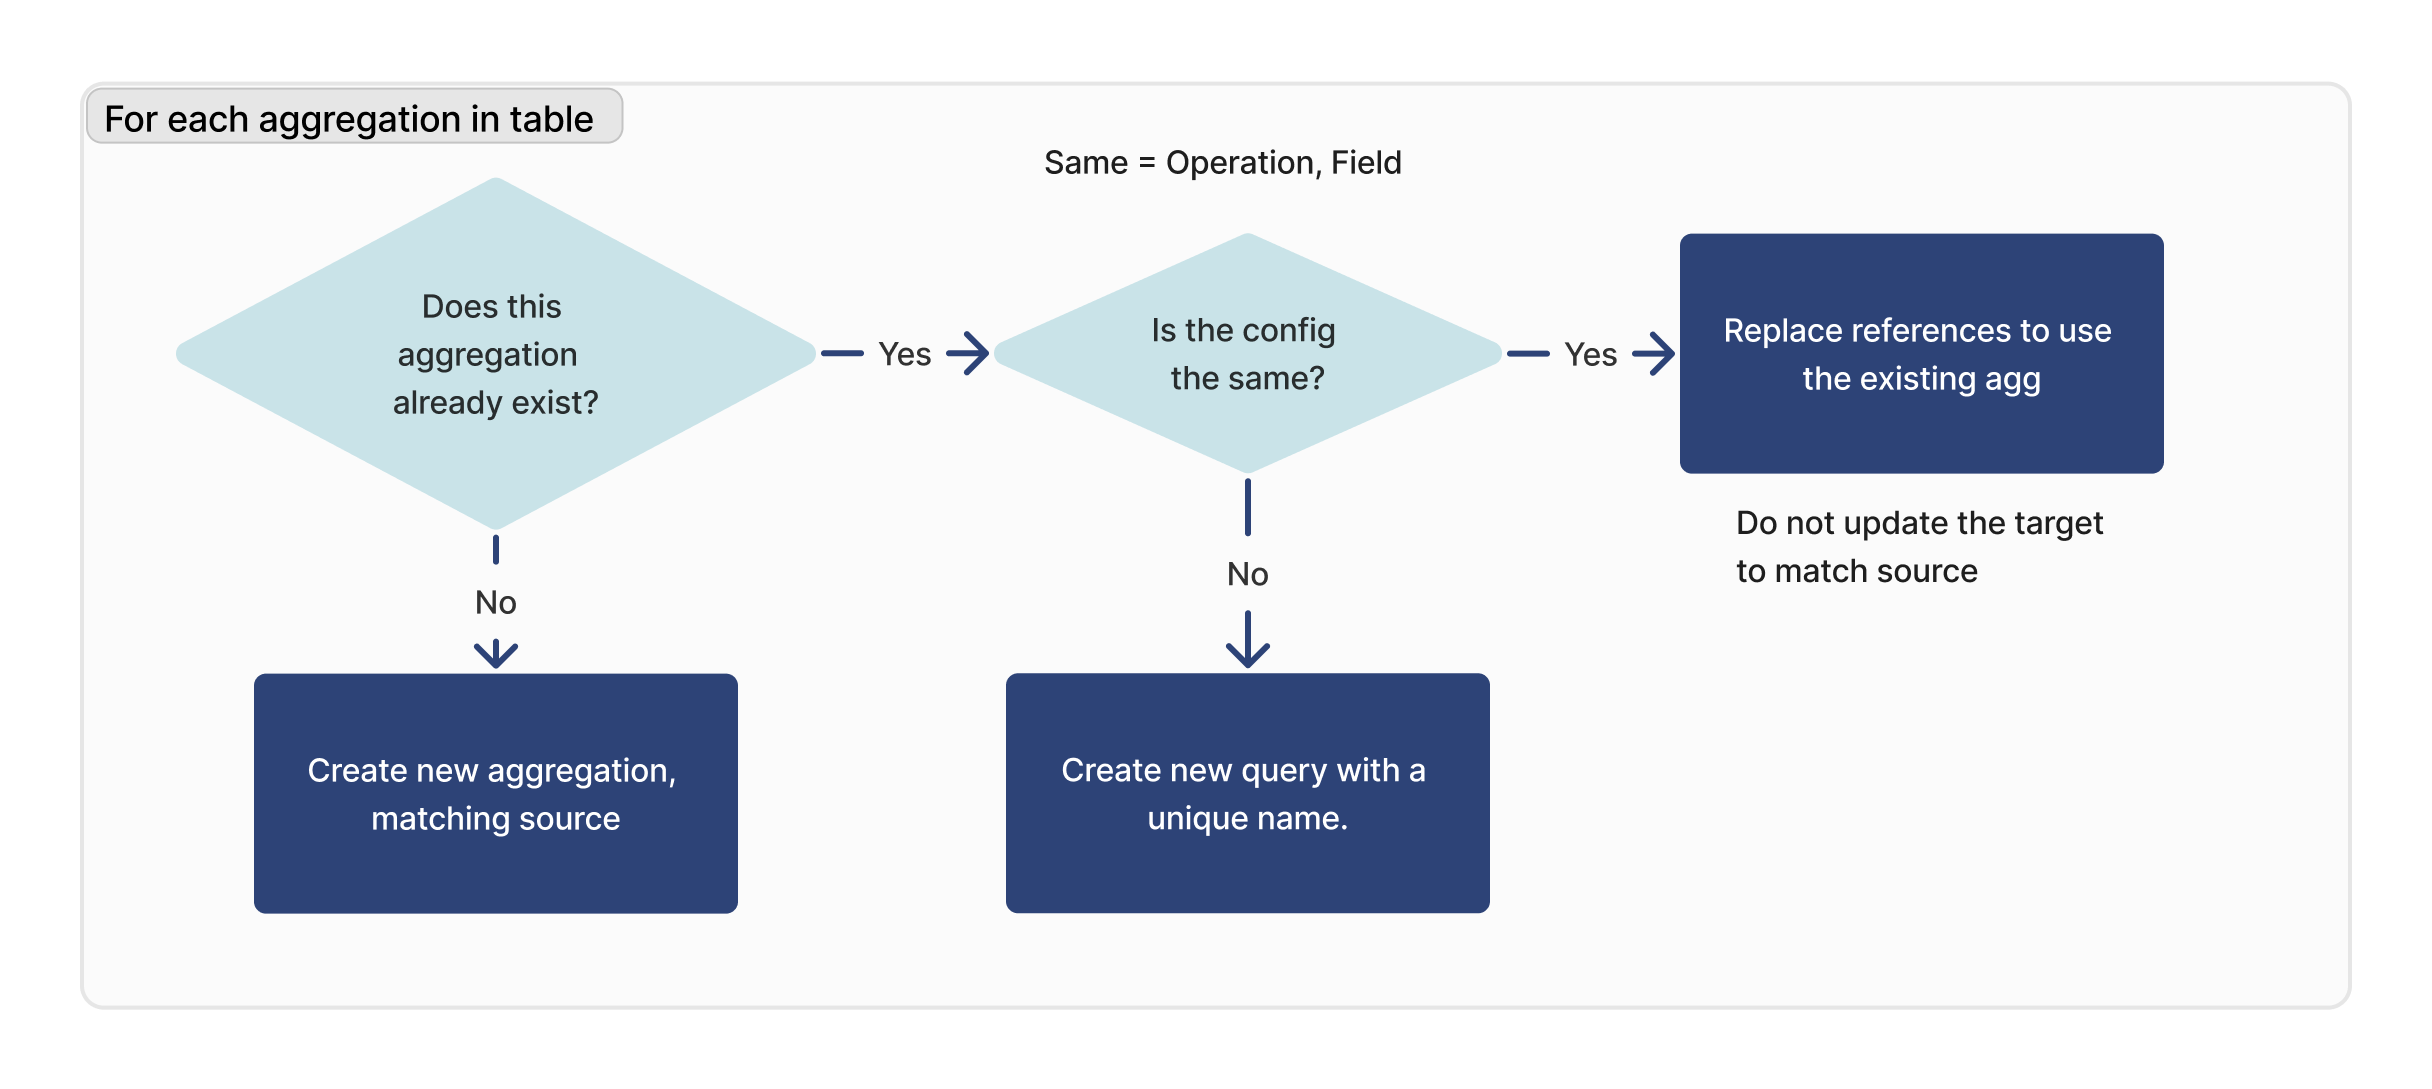
Pour chaque agrégation de la table importée, nous vérifions si cette requête existe. Si un ID correspondant est trouvé, nous vérifions que la configuration est identique (opération, champ) entre la cible et la source.
Si aucune agrégation correspondante n’est trouvée, une nouvelle agrégation sera créée. Si une agrégation correspondante est trouvée, mais qu’elle n’est pas identique à celle de l’instance cible, une nouvelle agrégation sera créée avec un nouveau nom.
Remarque : cela ne s'applique pas aux champs utilisateur personnalisés ni aux tables d'activité des machines.
Les mises à jour apportées au comportement d’importation/exportation réduisent les doublons. Les agrégations de tables sont désormais importées sous forme de « development version ». L’agrégation de table ne sera importée sous forme d’instantané que si la même agrégation existe déjà et présente une configuration différente.
L’ancien comportement (qui existe toujours dans les instances r329/LTS14 et antérieures) importait les instantanés en tant qu’instantanés et les « development versions » en tant que « development versions ».
{{snippet.Avez-vous trouvé ce que vous cherchiez ?}}