
Dans ce guide, vous apprendrez :
- Deux méthodes différentes pour stocker des données avec Tulip
- Quand utiliser les différentes méthodes de stockage des données
- L’importance d’adopter un modèle de données
Lorsque l’on travaille avec des données, il est essentiel de maintenir une bonne organisation pour éviter l’encombrement et centraliser les informations. Avec Tulip, le stockage et la gestion de vos données sont simplifiés grâce à de multiples options adaptées à vos besoins.
Comment Tulip capture-t-il vos opérations ?
Les données existent à plusieurs niveaux dans Tulip.
Les applications stockent des données statiques, telles que des instructions textuelles relatives à une étape.
Les tables sont des bases de données créées par Tulip, à l’image d’un tableur de bons de travail, que vous pouvez utiliser dans plusieurs applications.
Les « Completions » stockent des métadonnées de production, telles que la durée de l’application, le nom du poste et toutes les données saisies dans les variables.
Le schéma ci-dessous illustre le flux opérationnel des données au sein d'un atelier.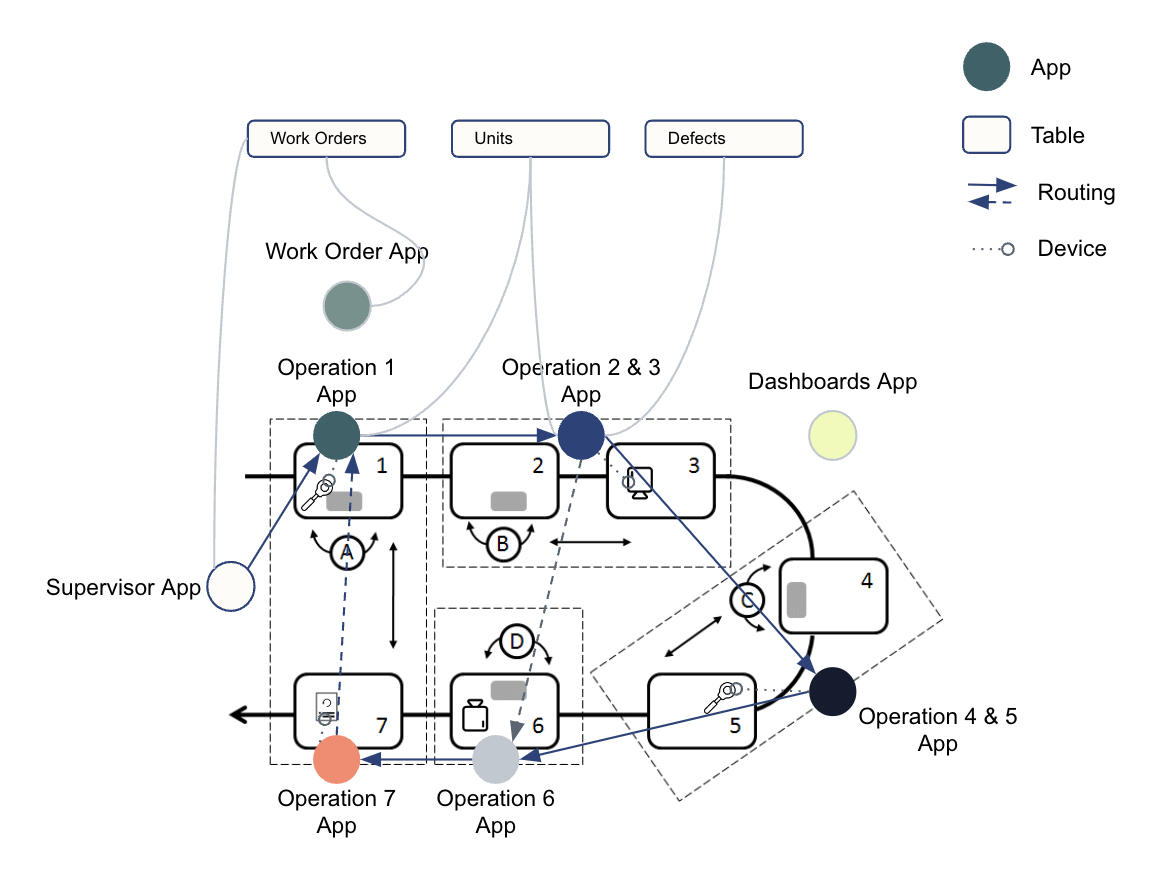
Options de stockage des données
Il existe deux options pour stocker des données dans Tulip : les « Tables » et les « Completions ».
Les « Tables »
Les « Tables » sont un mélange entre des feuilles de calcul et des bases de données relationnelles, personnalisables en fonction de la manière dont vous souhaitez présenter vos données. Il s’agit de sources de données partageables pouvant être utilisées par plusieurs applications.
Lorsque vous créez un tableau, vous définissez les Fields qui contiennent et organisent les données par enregistrements. Les champs correspondent aux colonnes, les enregistrements aux lignes de données spécifiques, et chaque élément de données individuel est un champ d’enregistrement du tableau.
Les tableaux peuvent être intégrés à votre application pour créer, modifier et afficher les enregistrements pertinents pour vos tâches.
Vous pouvez importer des données existantes dans les tables Tulip, comme expliqué ici.
Si vous ne souhaitez pas créer votre propre table, mais que vous ne disposez pas non plus de données existantes à importer, vous pouvez utiliser l’une des tables préconfigurées de Tulip fournies avec votre instance. Celles-ci vous donnent une idée des différents champs que vous pouvez utiliser dans les tables et des types généraux de données pouvant être enregistrées. Les options de types de données incluent :
- Texte
- Entier
- Nombre
- Booléen
- Date-heure
- Intervalle
- Couleur
- Image
- Vidéo
- Fichier
- Machine
- Enregistrement lié
Chacun de ces champs correspondra aux entrées de données utilisées dans votre application. Pour afficher les enregistrements dans un tableau, accédez à l'écran du tableau via la page de votre instance Tulip. Passez votre curseur sur « Apps » et sélectionnez « Tables ».
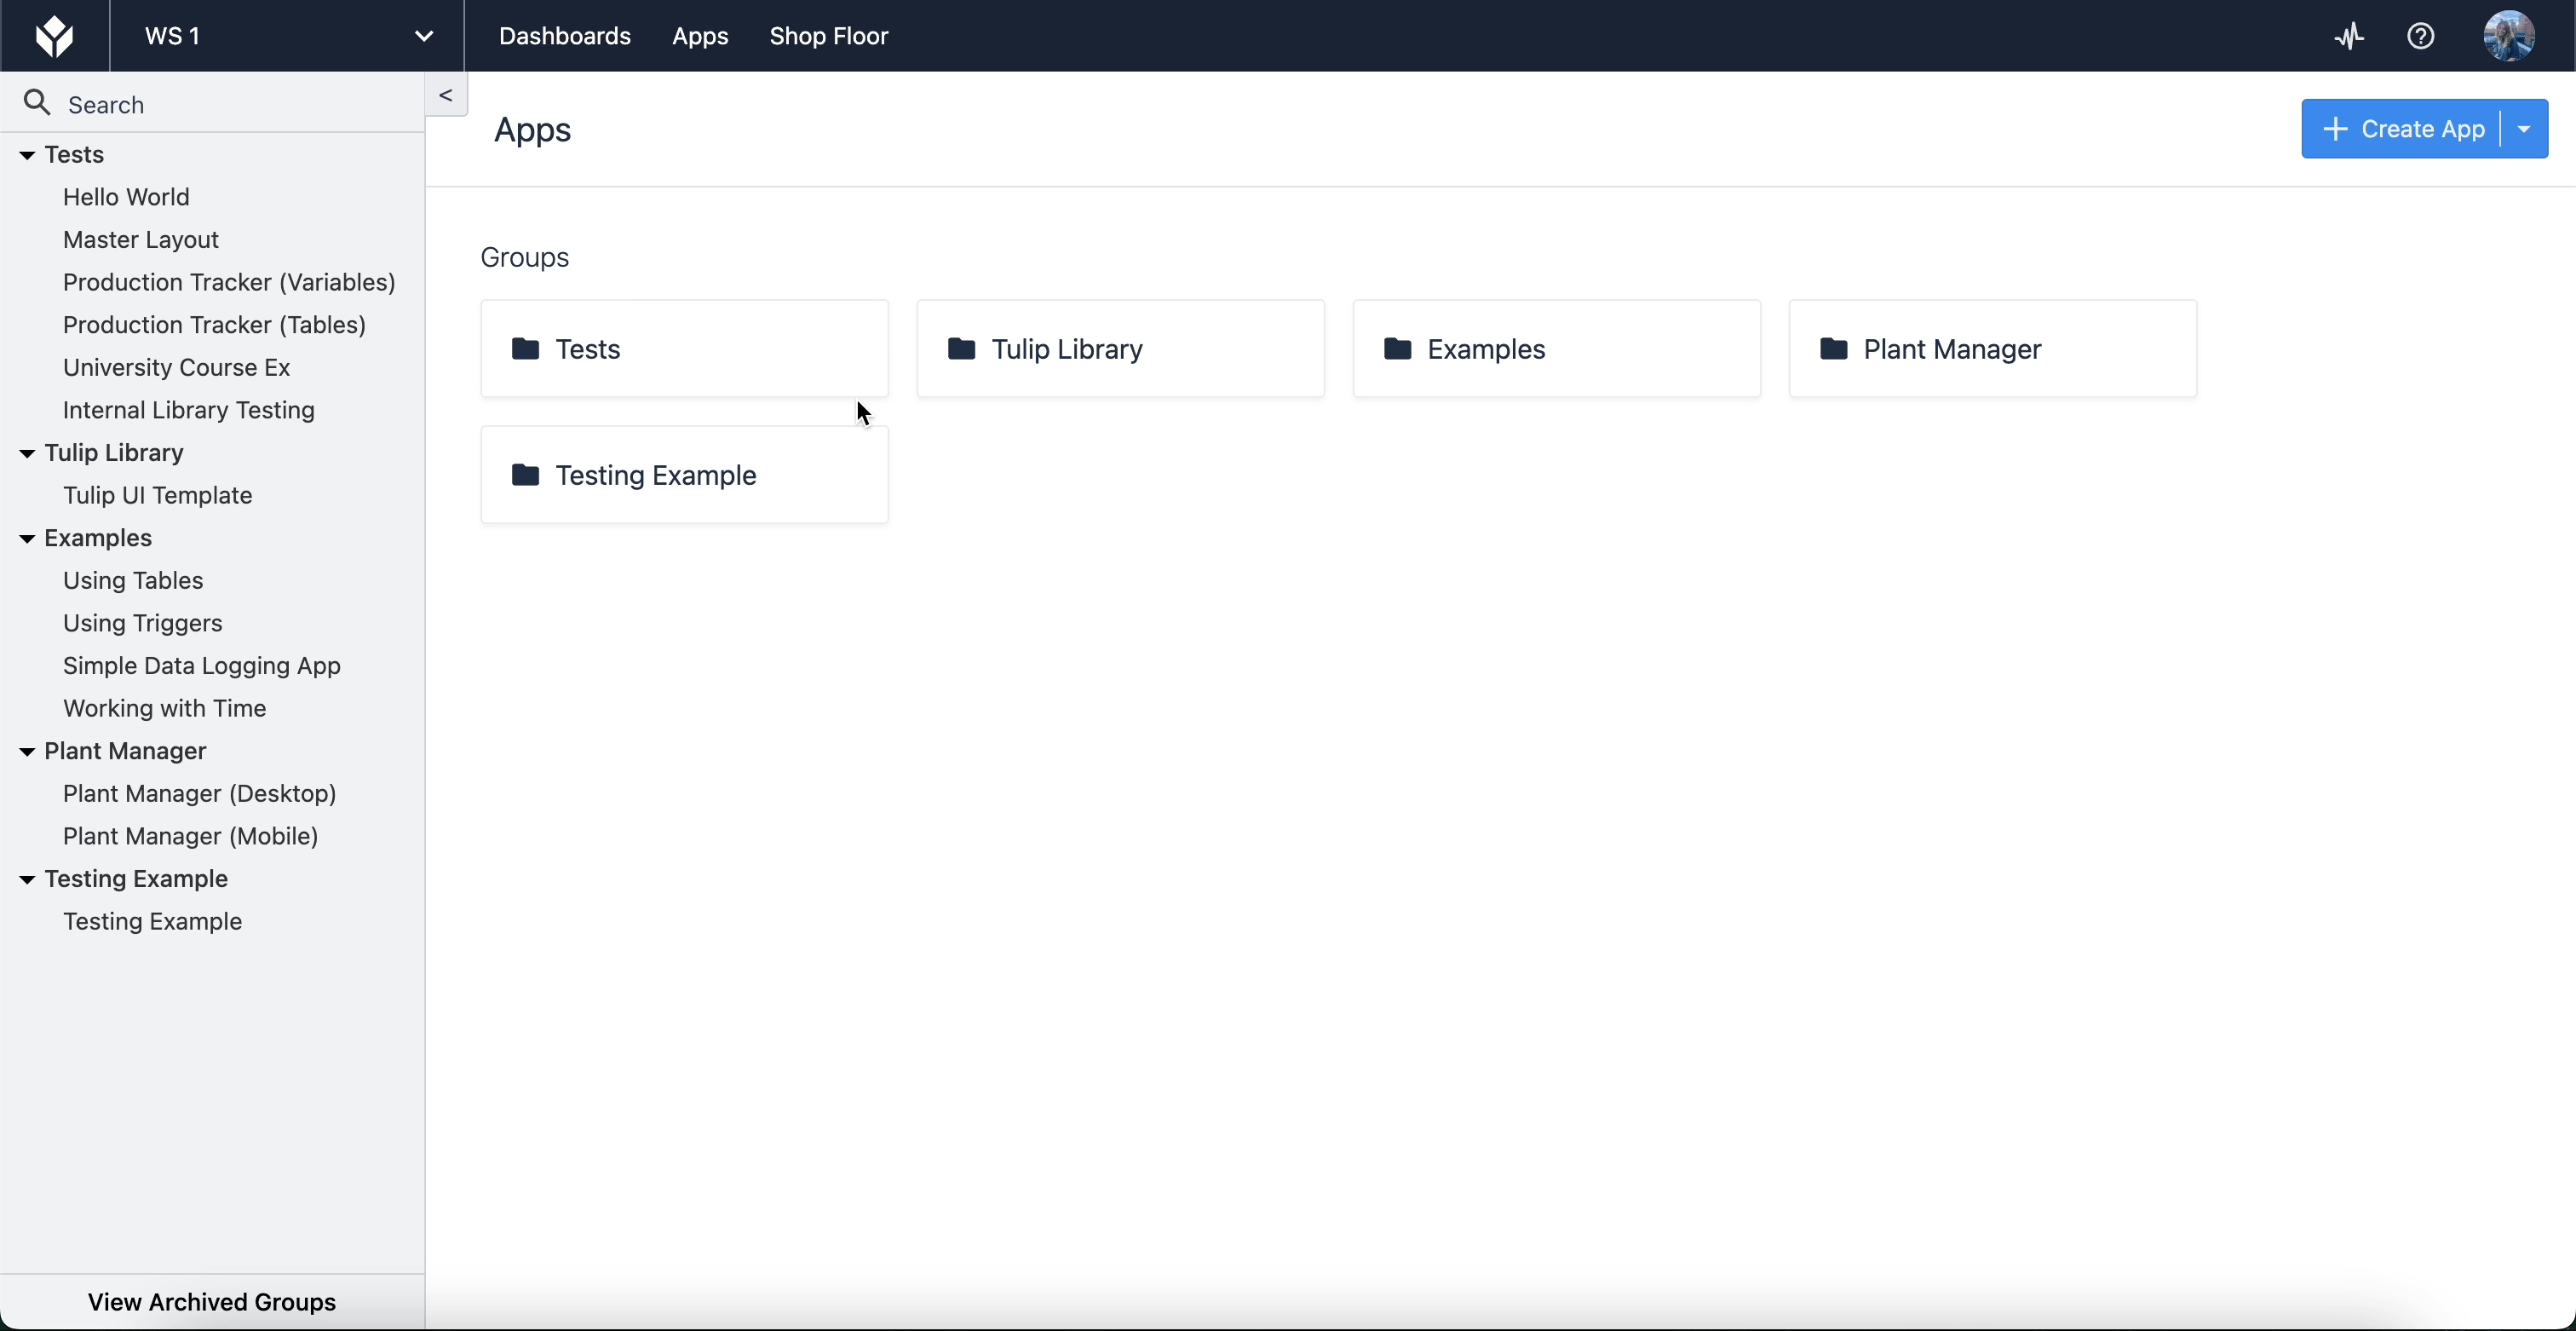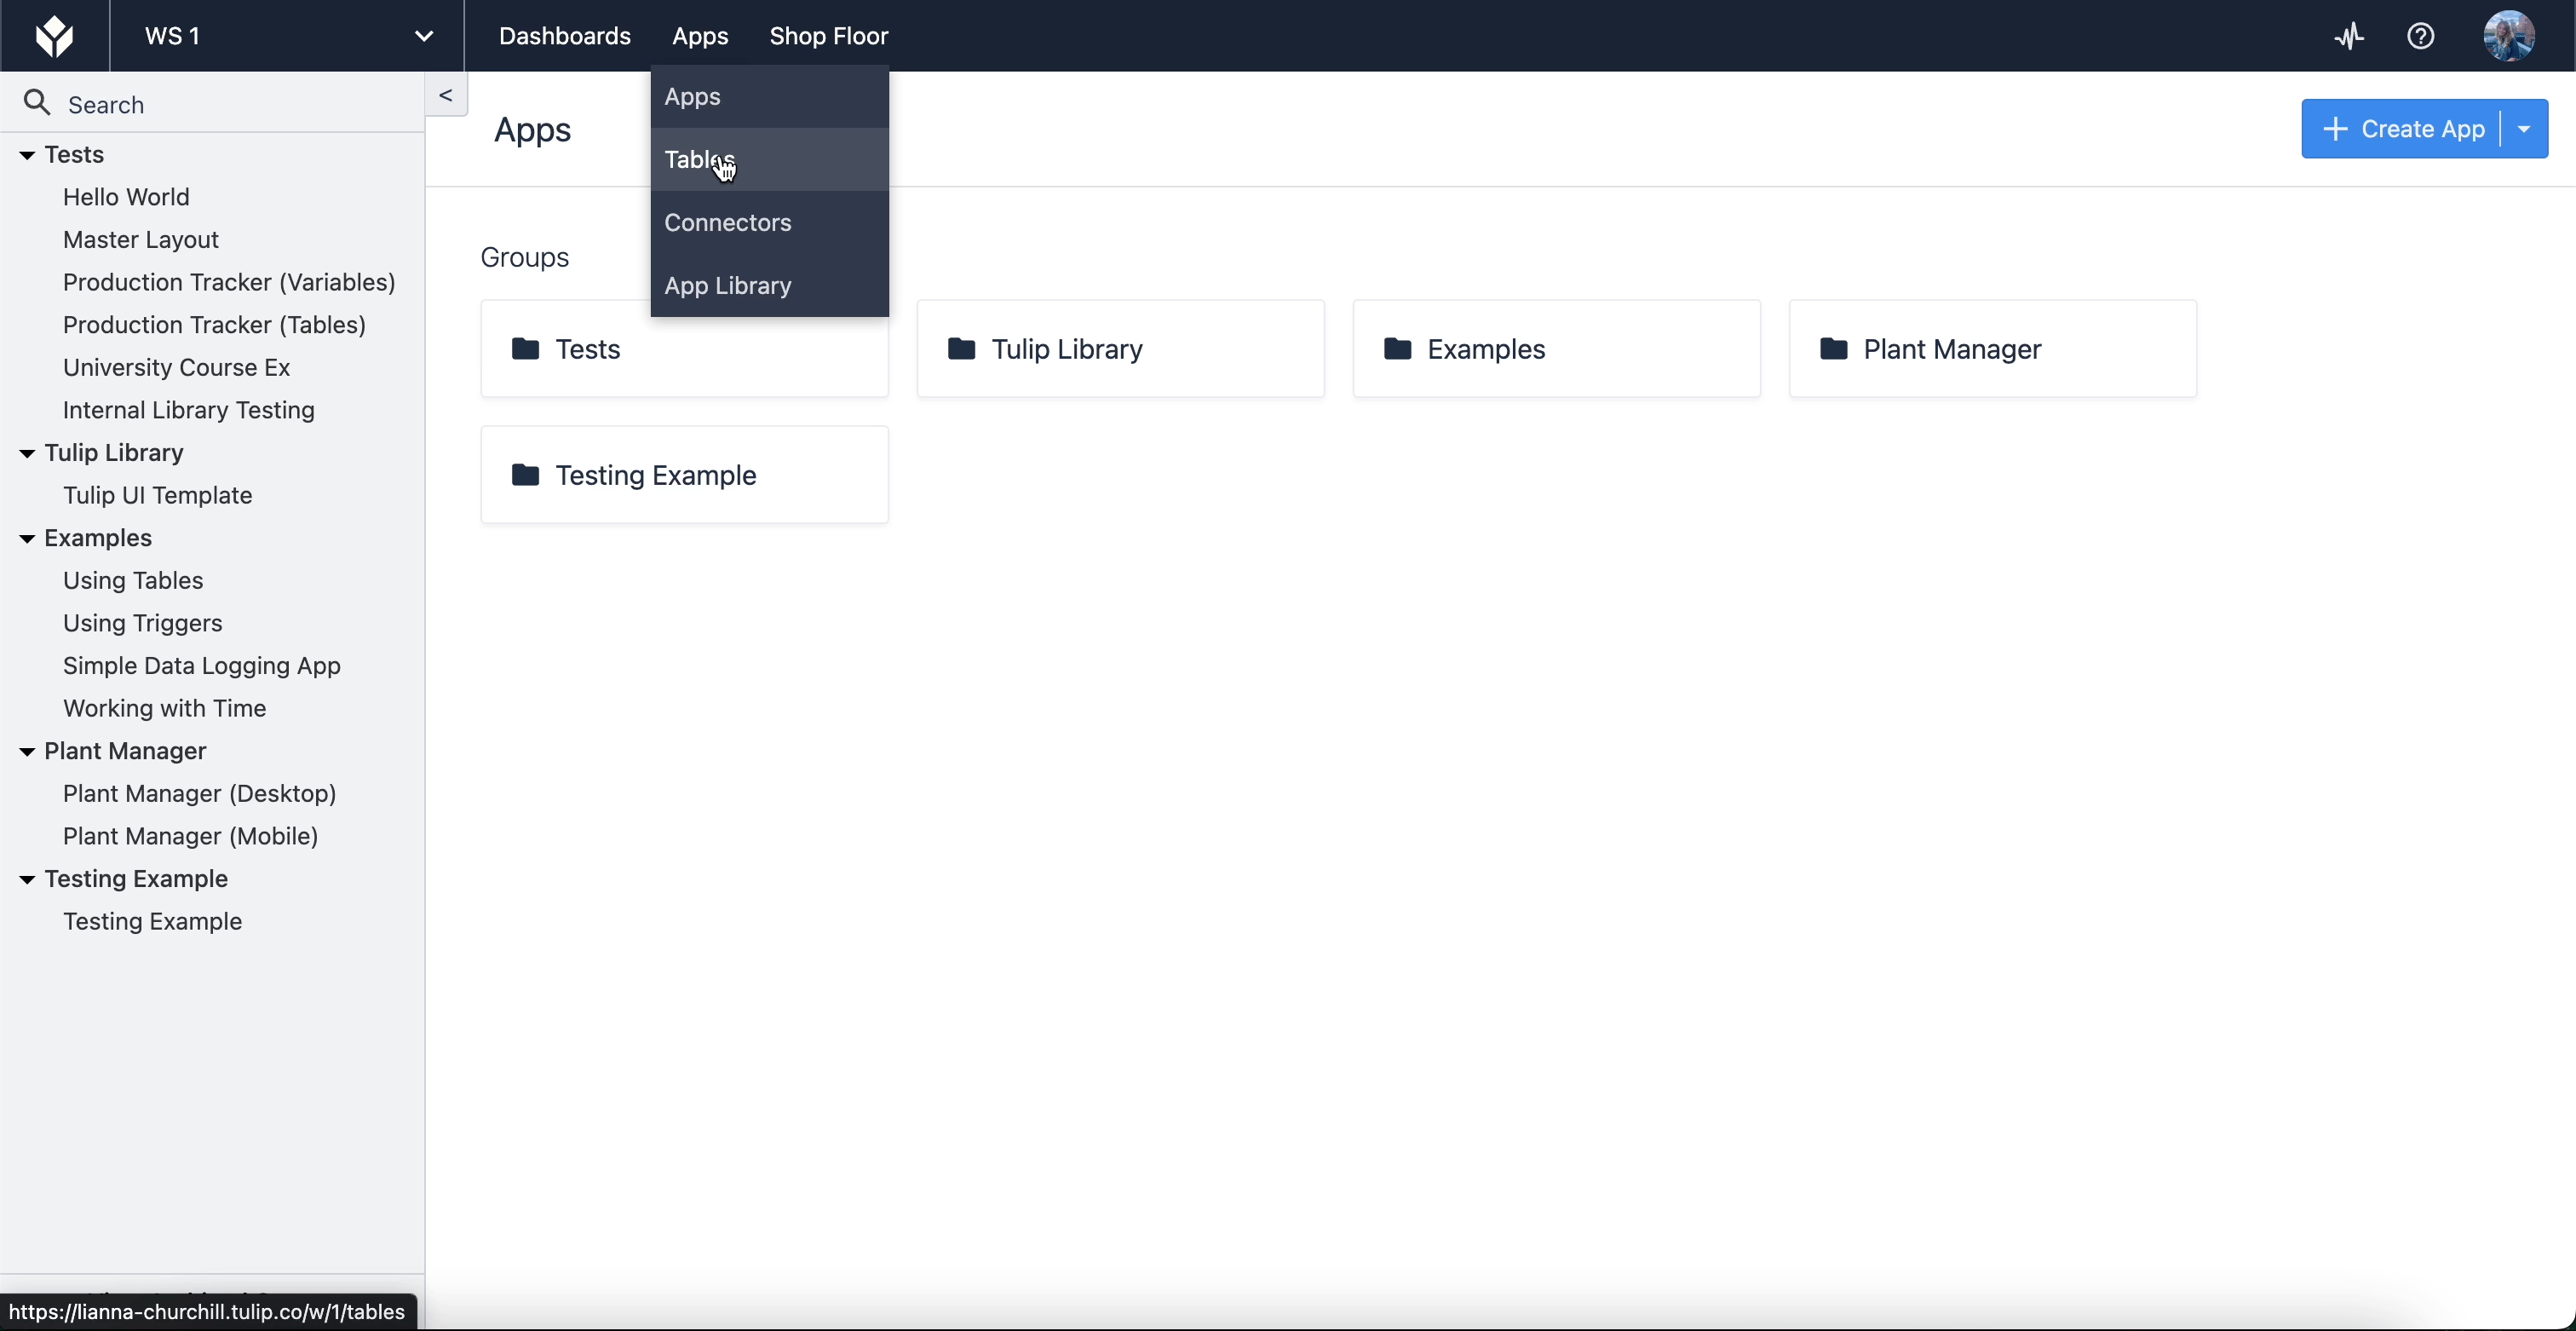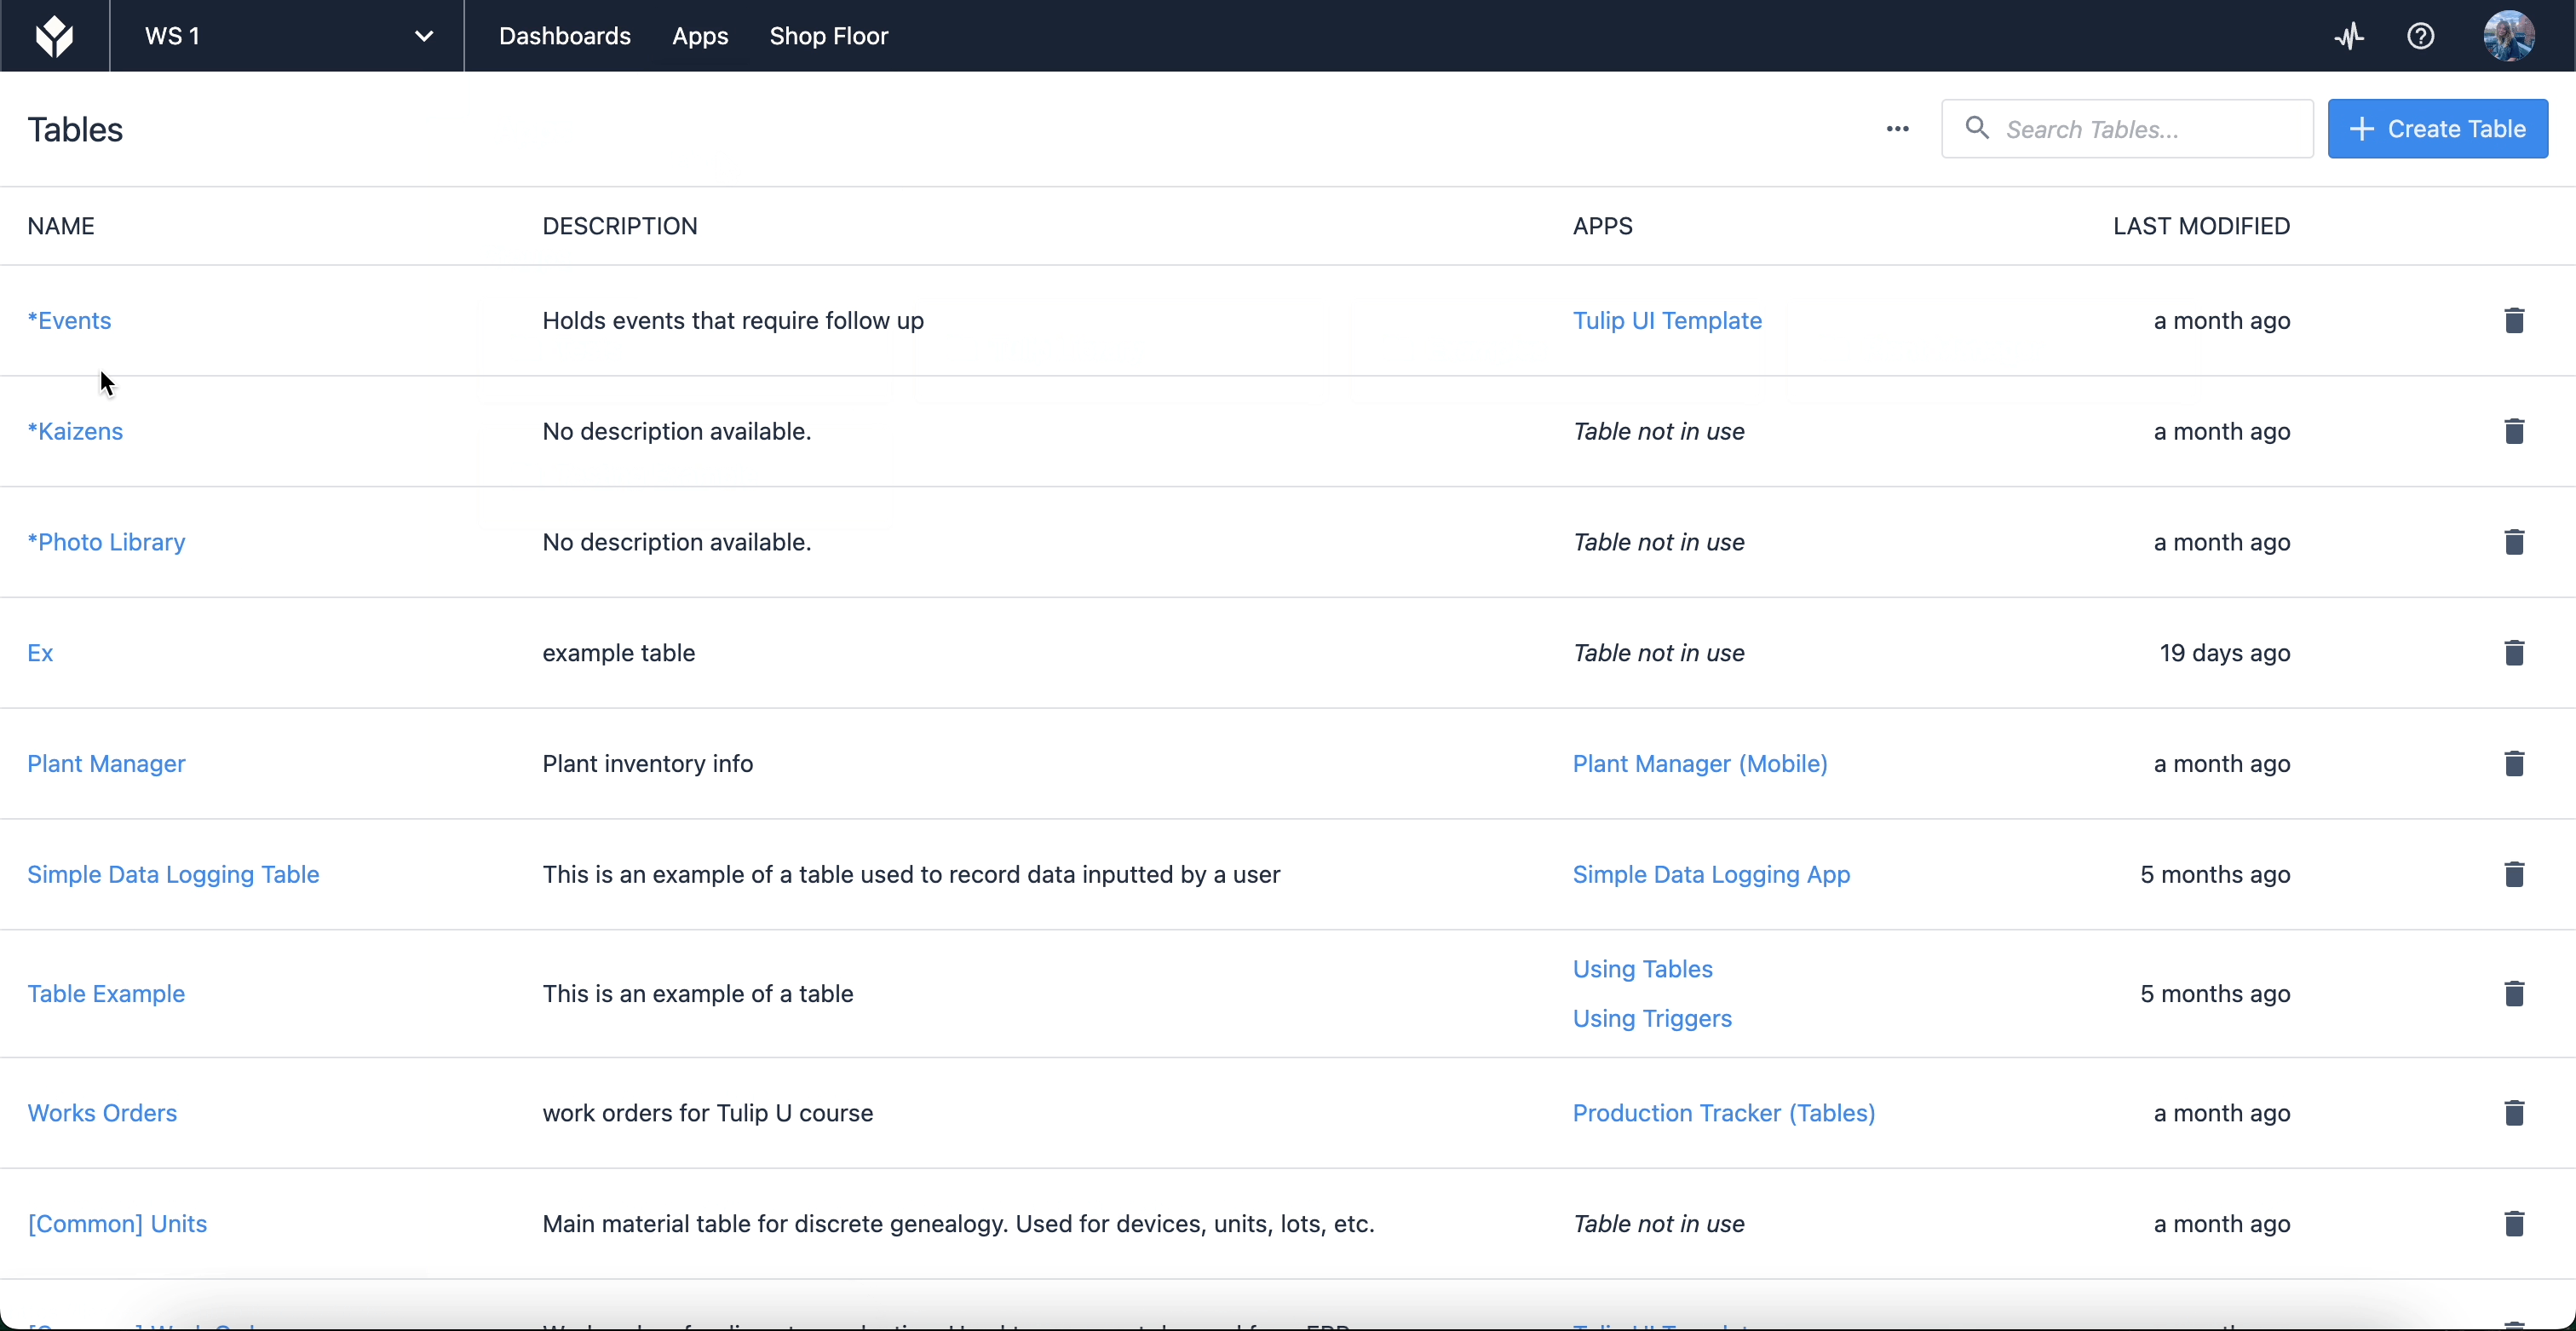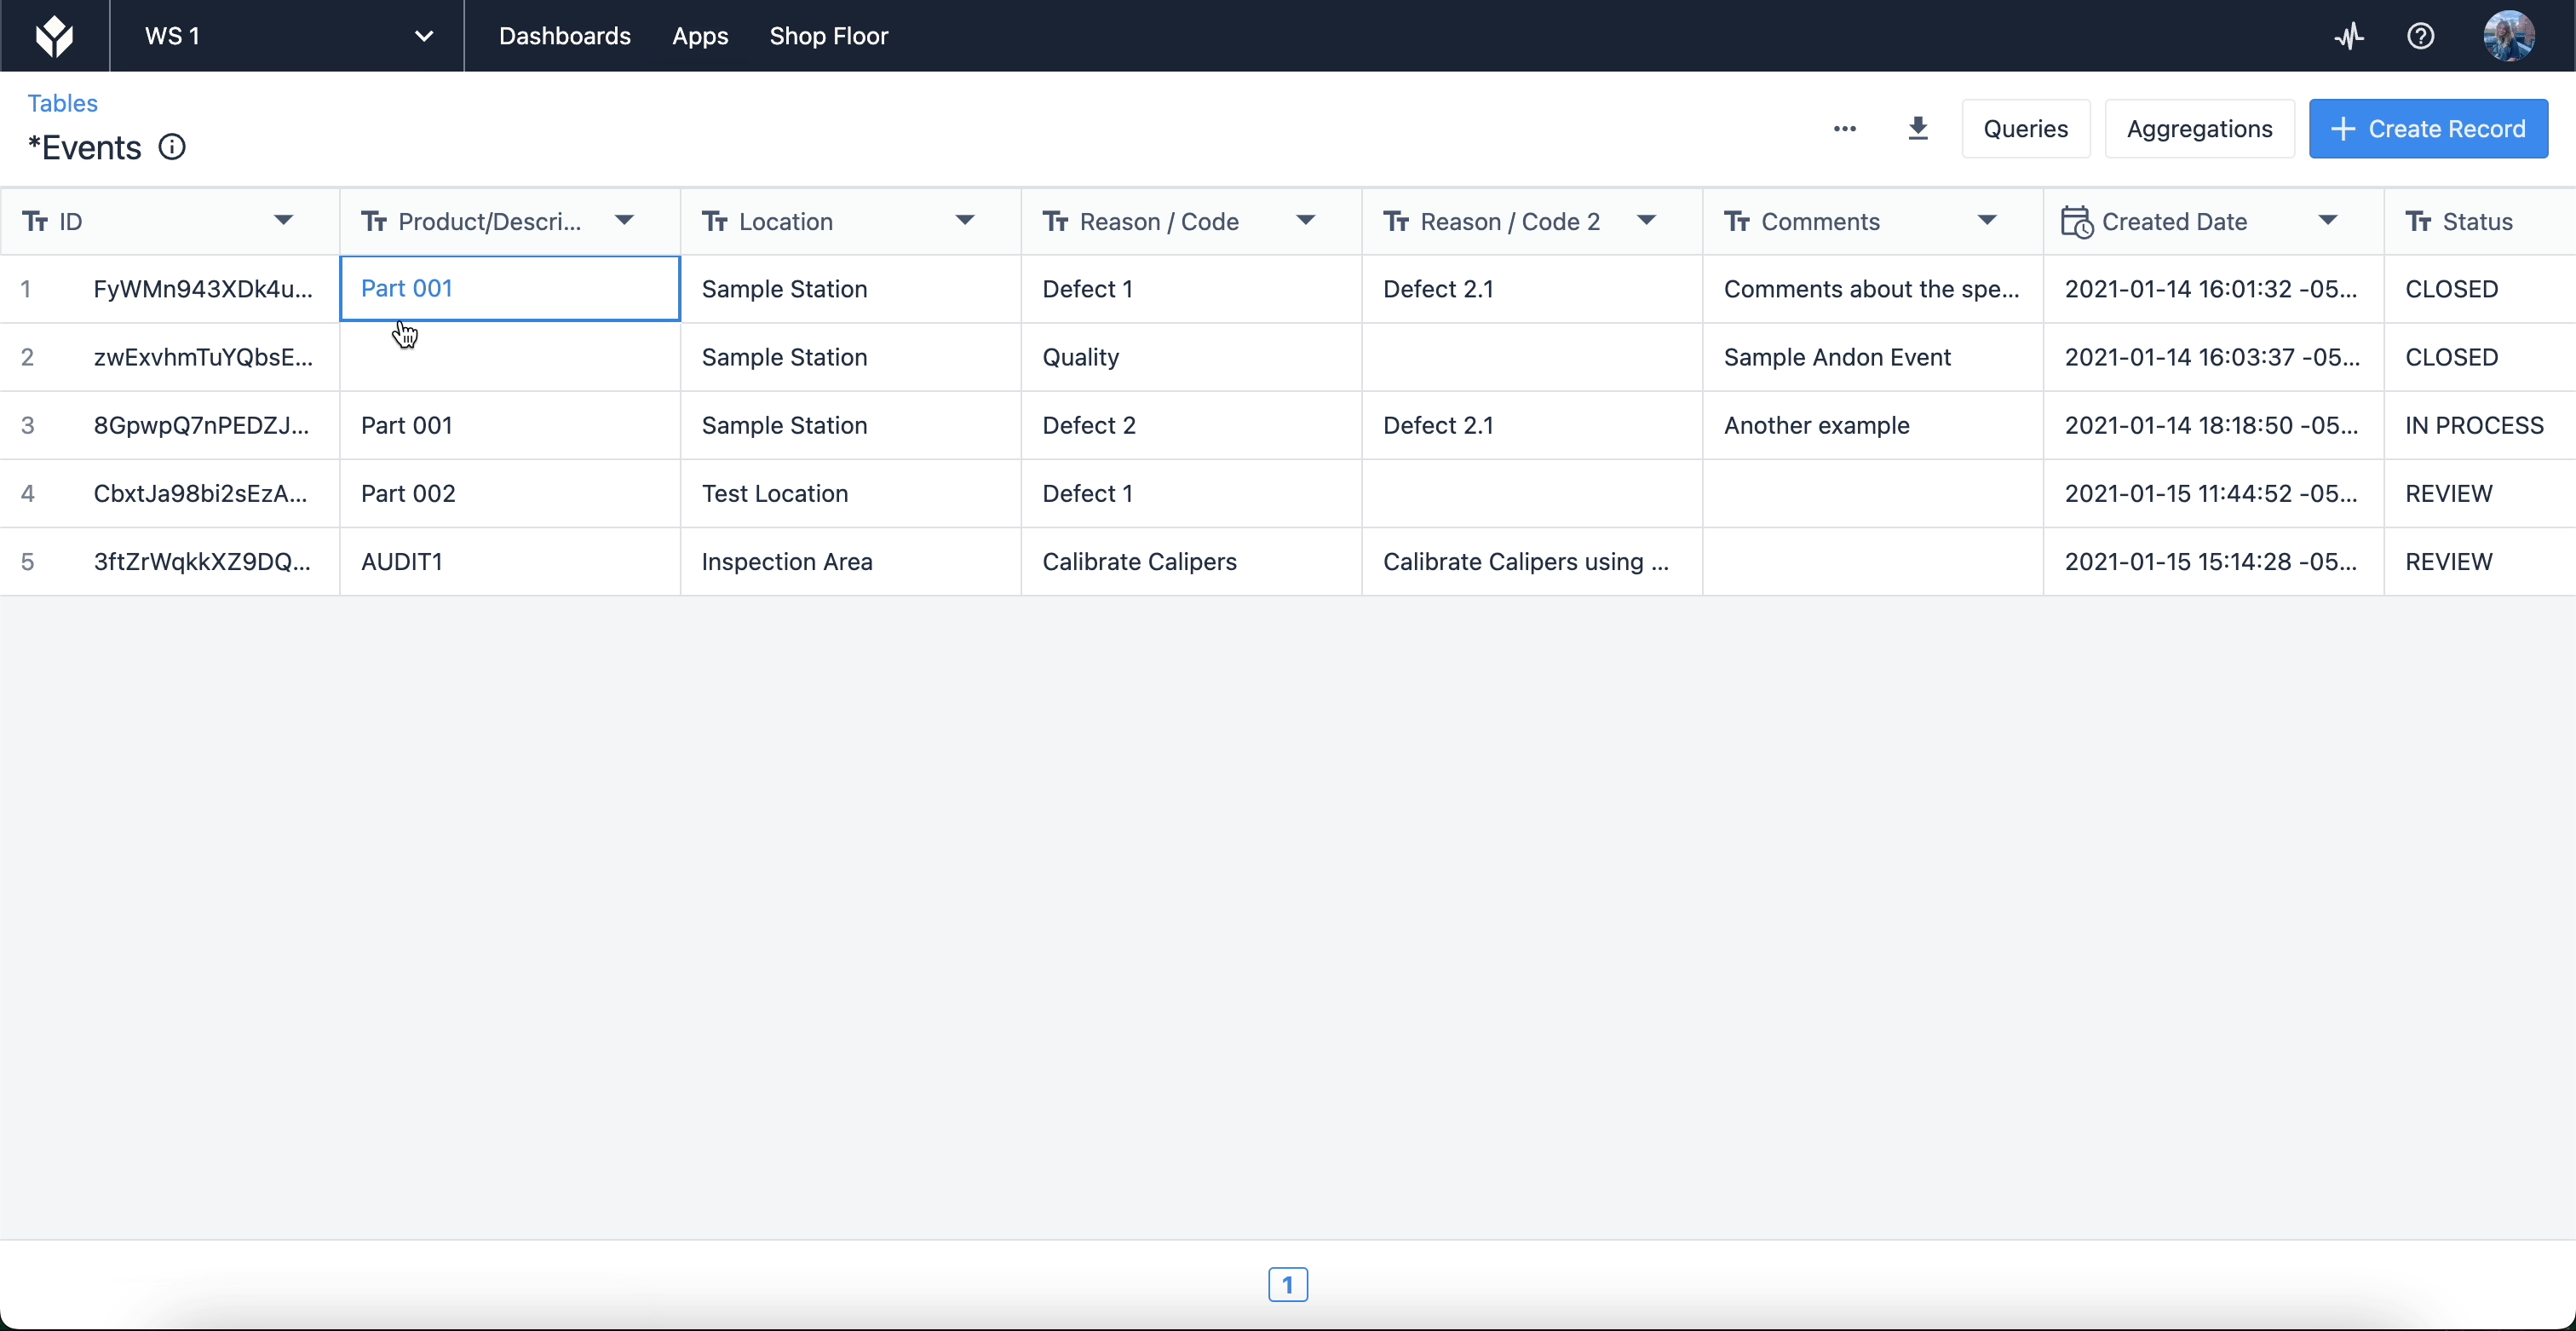
Vous y trouverez une liste des tables que vous avez créées ou auxquelles vous avez accès pour les utiliser dans vos applications. Lorsque vous sélectionnez une table, vous pouvez modifier les champs et les enregistrements eux-mêmes, ainsi que créer des requêtes et des agrégations qui vous permettent d’exploiter les données de la table au sein de vos applications. Les tables peuvent également être reliées entre elles (pour des cas d’utilisation tels que la généalogie des produits).
Utilisation recommandée des tables Tulip
Tulip recommande d’utiliser les tables pour stocker, de manière générale, deux types d’artefacts : physiques et opérationnels.
Les artefacts physiques sont des objets ou composants tangibles utilisés ou produits au cours des opérations, tels que les lots ou les équipements.Les artefacts opérationnels sont des éléments ou composants non physiques qui permettent ou soutiennent les opérations, tels que les événements de défaut ou la configuration Kanban.
Pour en savoir plus sur l’utilisation des tables, consultez :
Finalisations
Les « Complétions » de l’application sont idéales pour stocker et organiser les données de production. Les champs de métadonnées sont automatiquement générés et stockés dès qu’un utilisateur termine ou annule l’application. Ces champs comprennent :
- Durée de l'application
- Heure de début et de fin
- Utilisateur connecté
- Nom de la station
- Commentaires
- Version de l'application
- ID d'exécution
- Annulé (que l'application ait été annulée ou non)
Contrairement aux données stockées dans les tables, celles stockées dans les « Completions » de l’application ne peuvent pas être modifiées. Cela garantit que les informations sont immuables : elles ne peuvent être ni manipulées ni modifiées et reflètent fidèlement l’utilisation de l’application.
Les données de « Completions » ne peuvent être utilisées que par une seule application et sont également moins accessibles depuis des systèmes externes.
Pour accéder aux données de « Completions » d’une application, sélectionnez une application dans un groupe d’applications de votre instance Tulip. Une fois sur l’écran principal de l’application, sélectionnez l’onglet « Completions ».
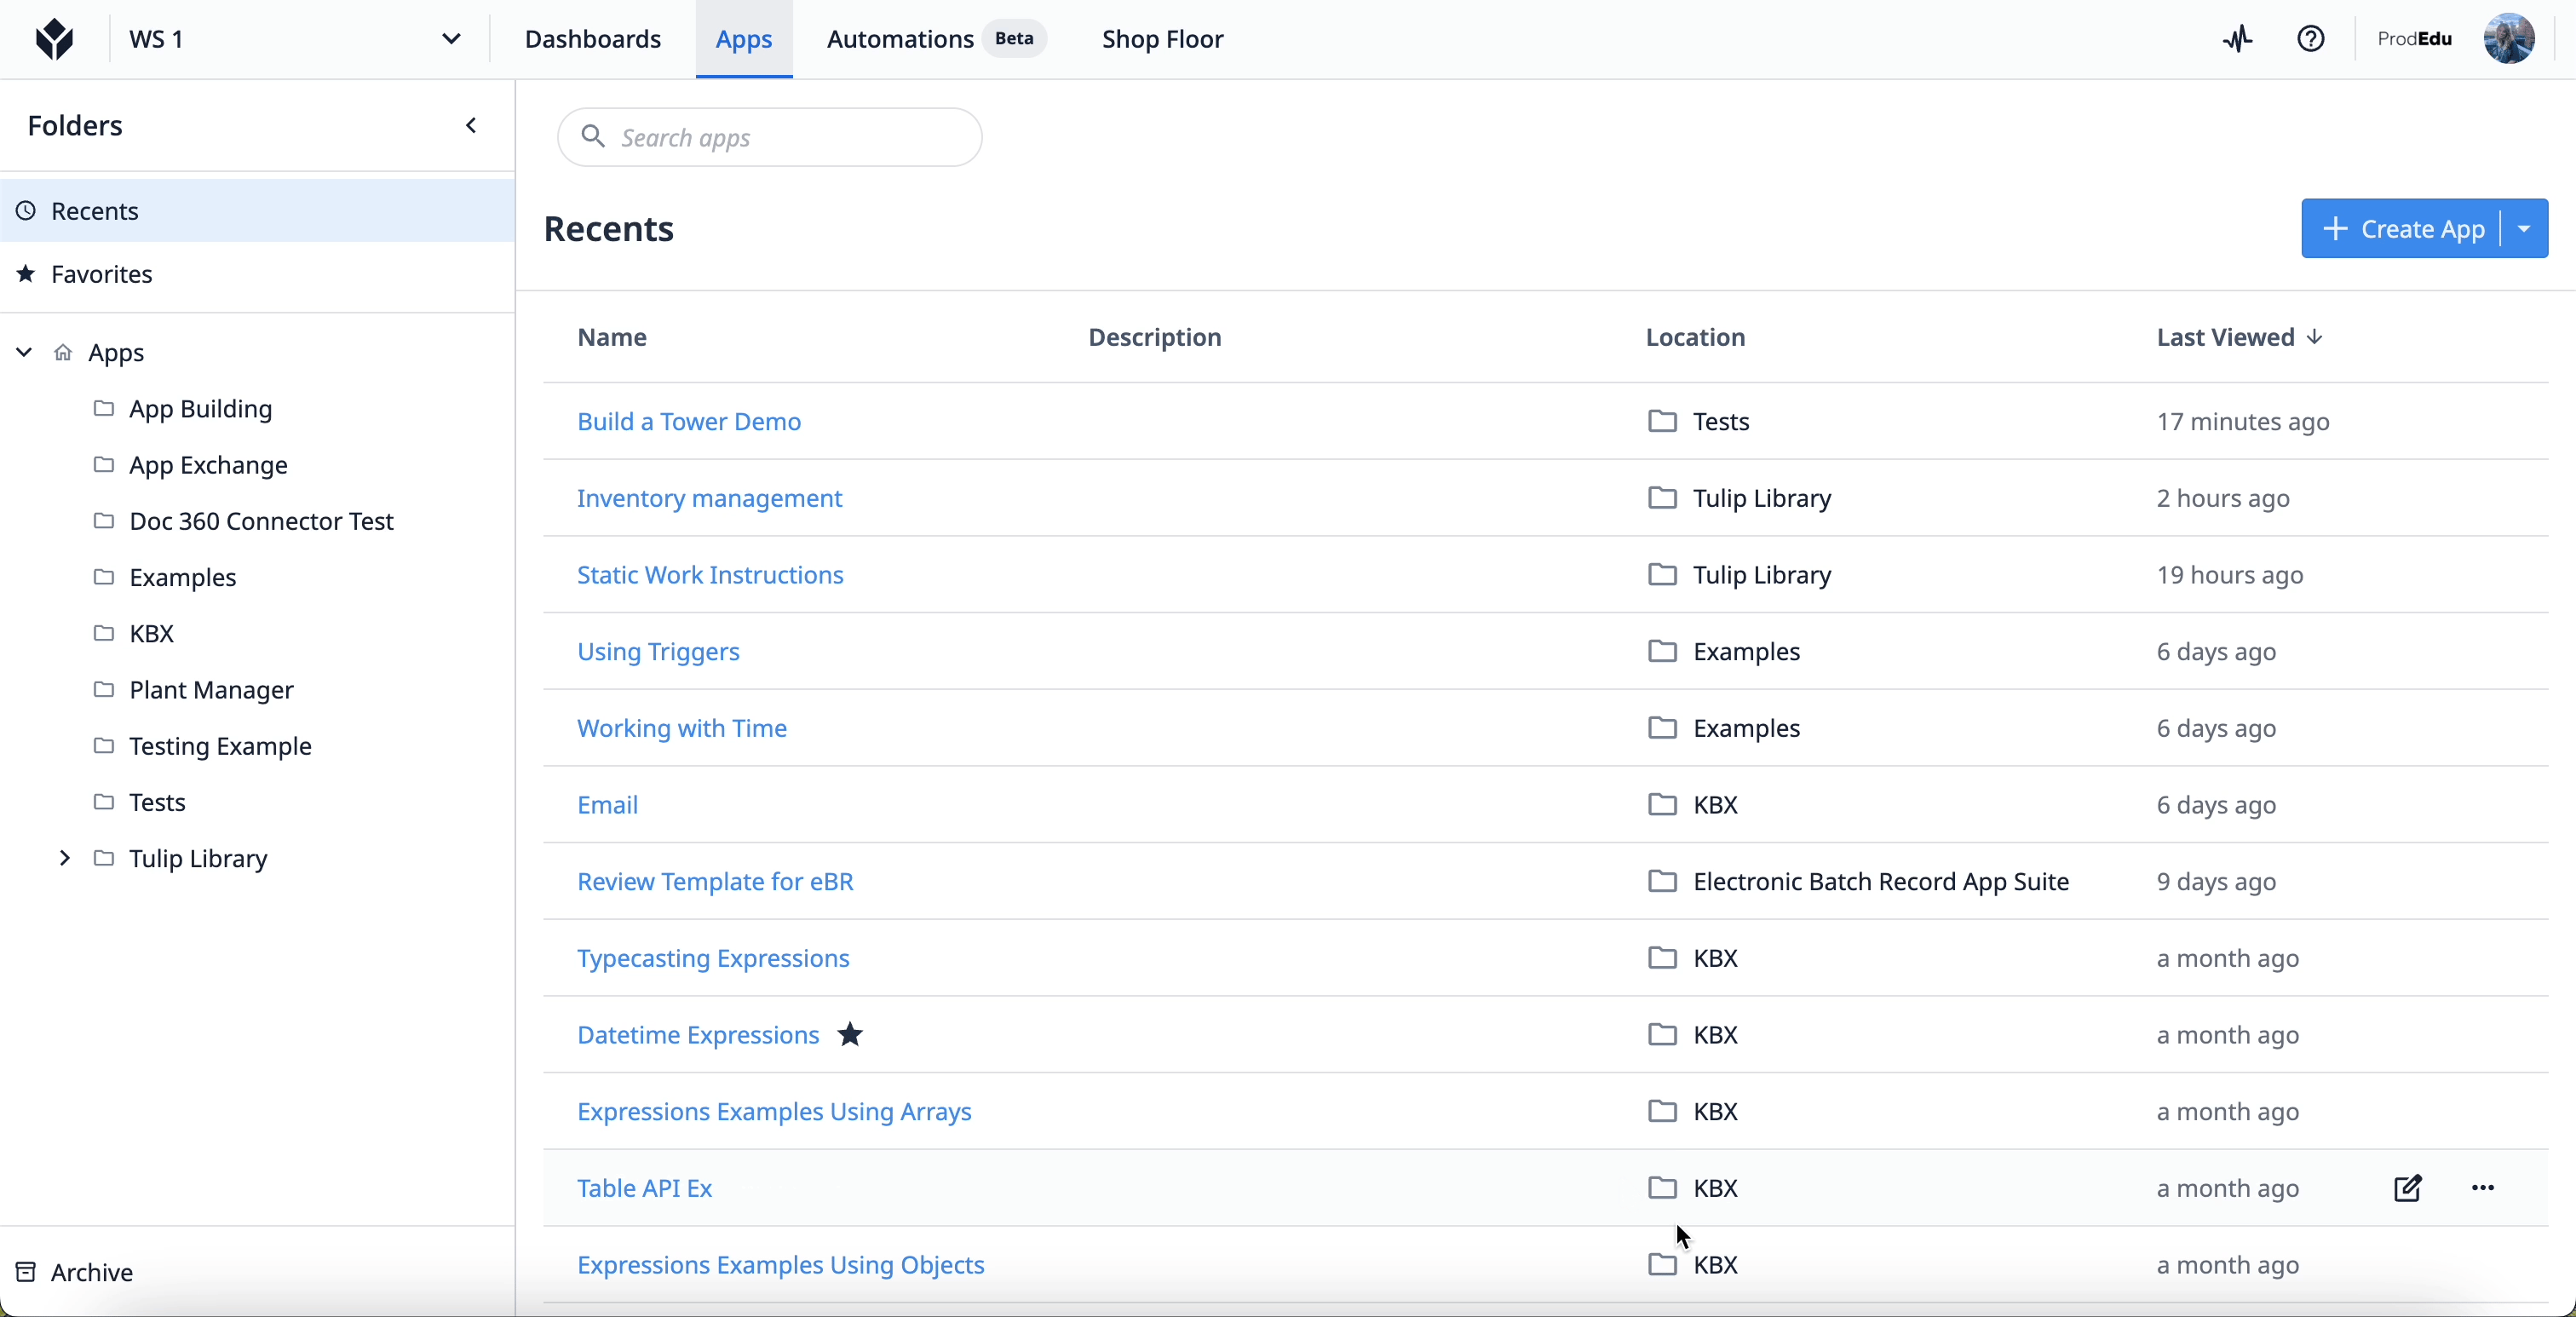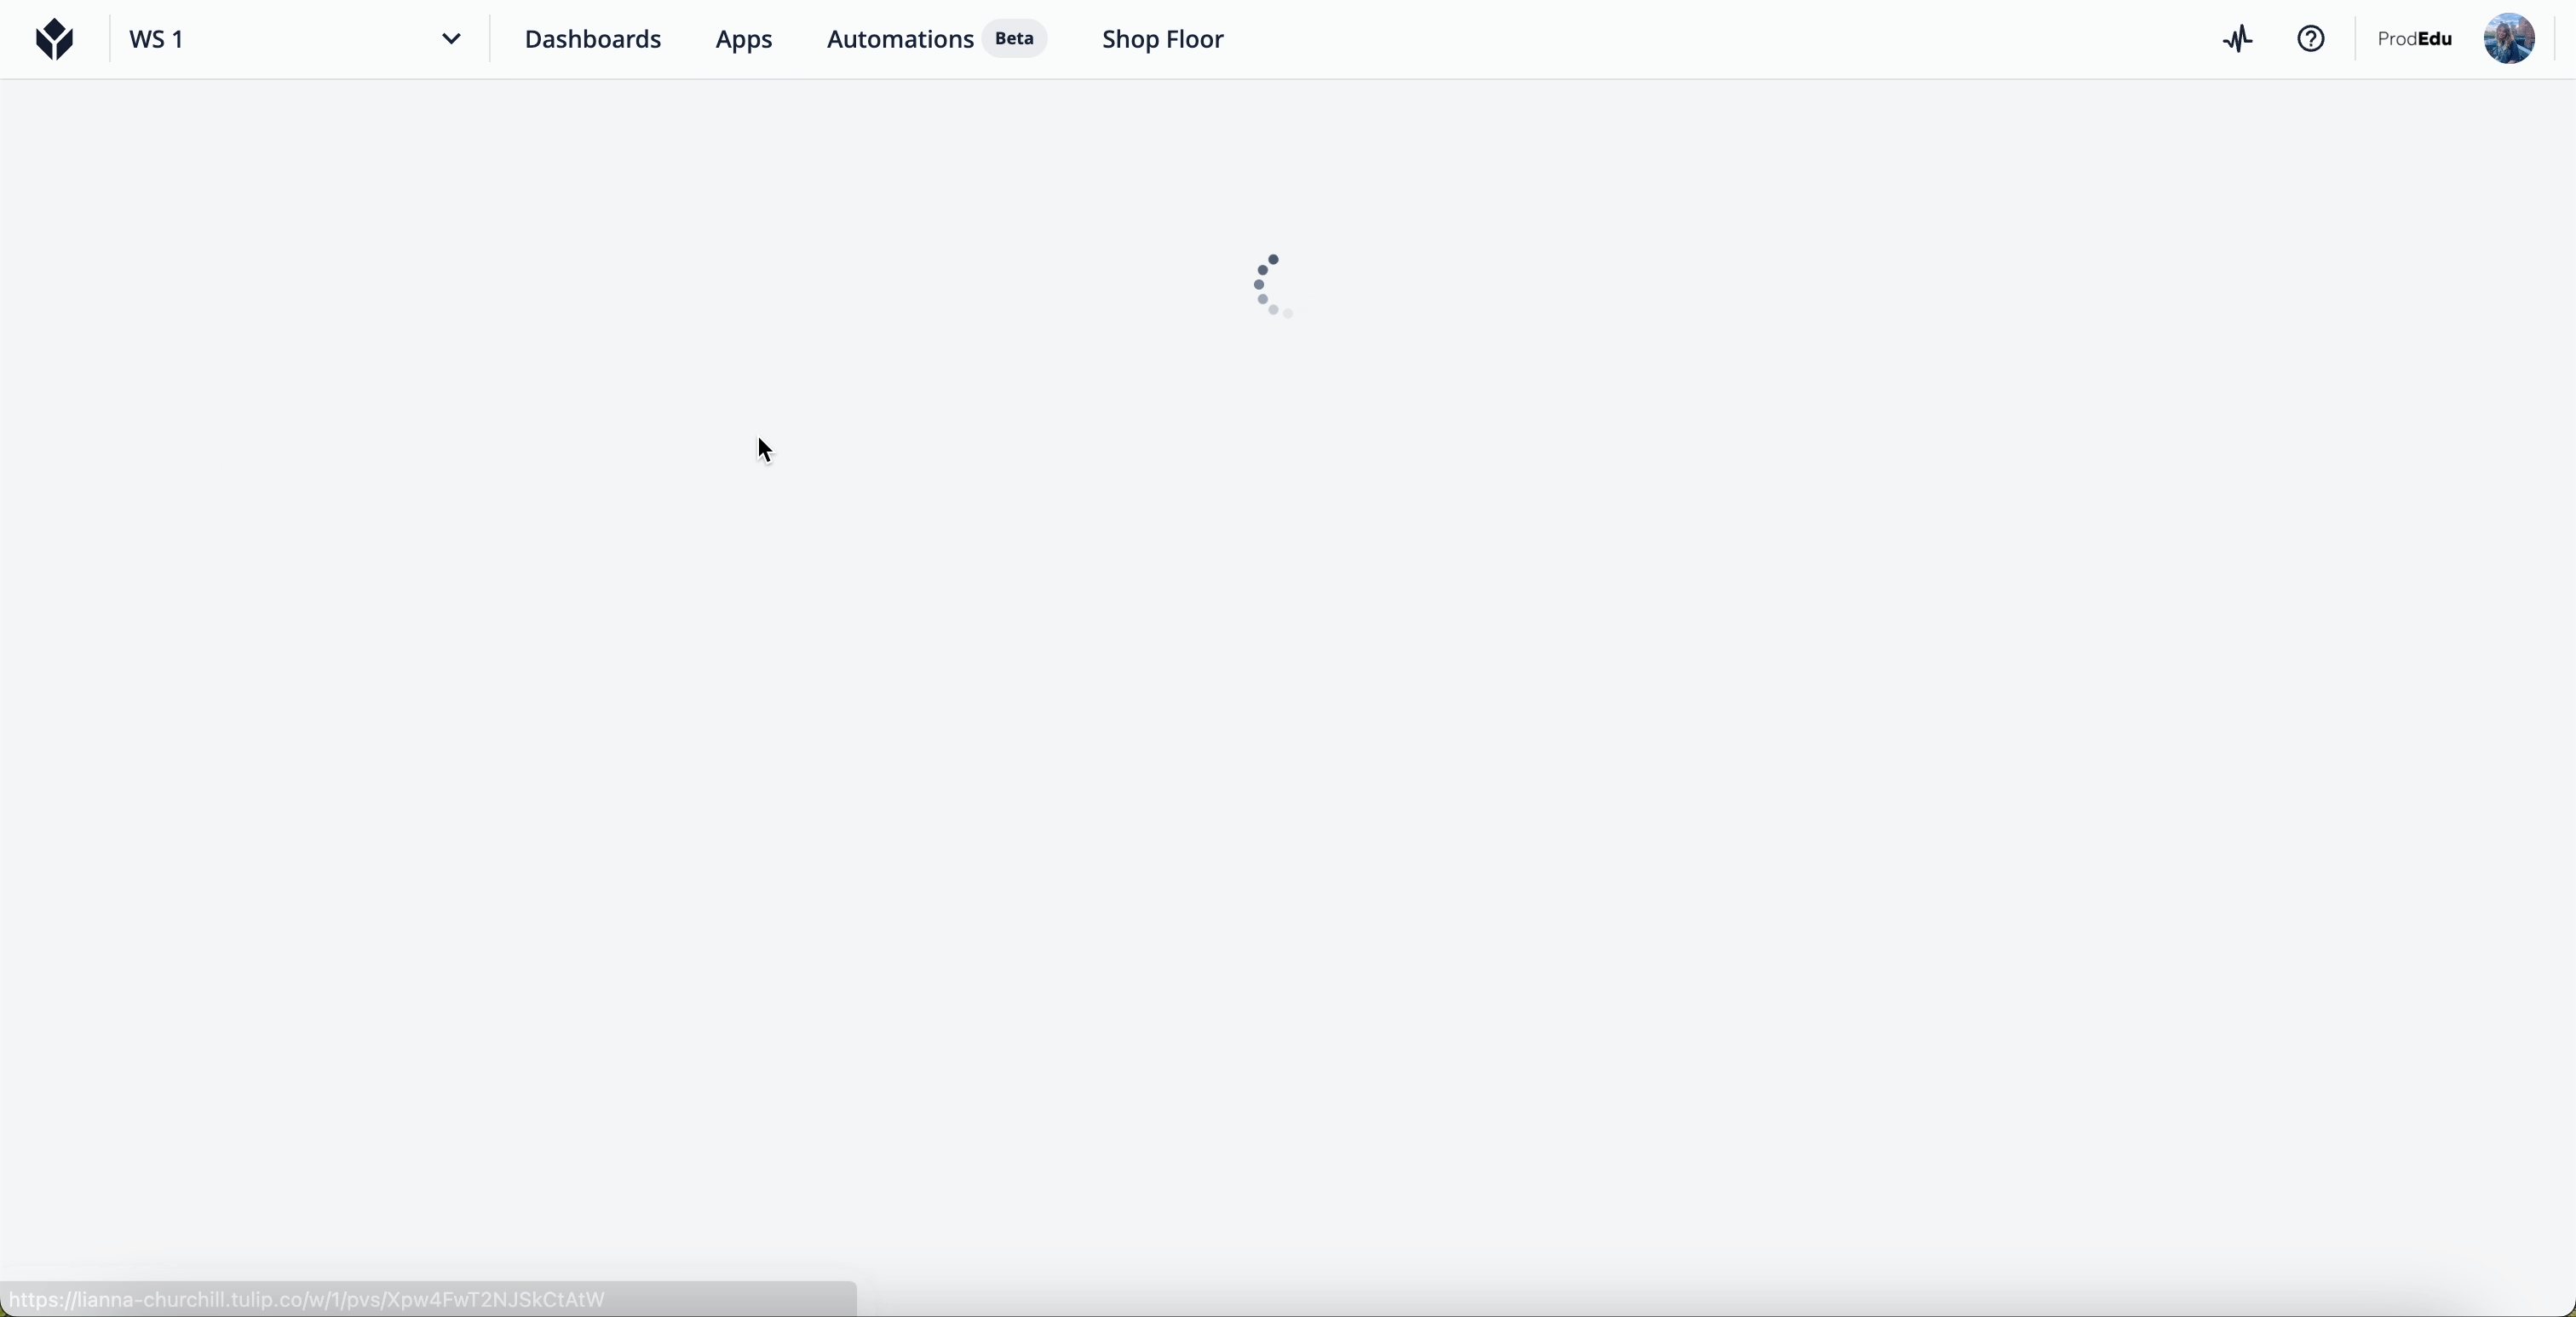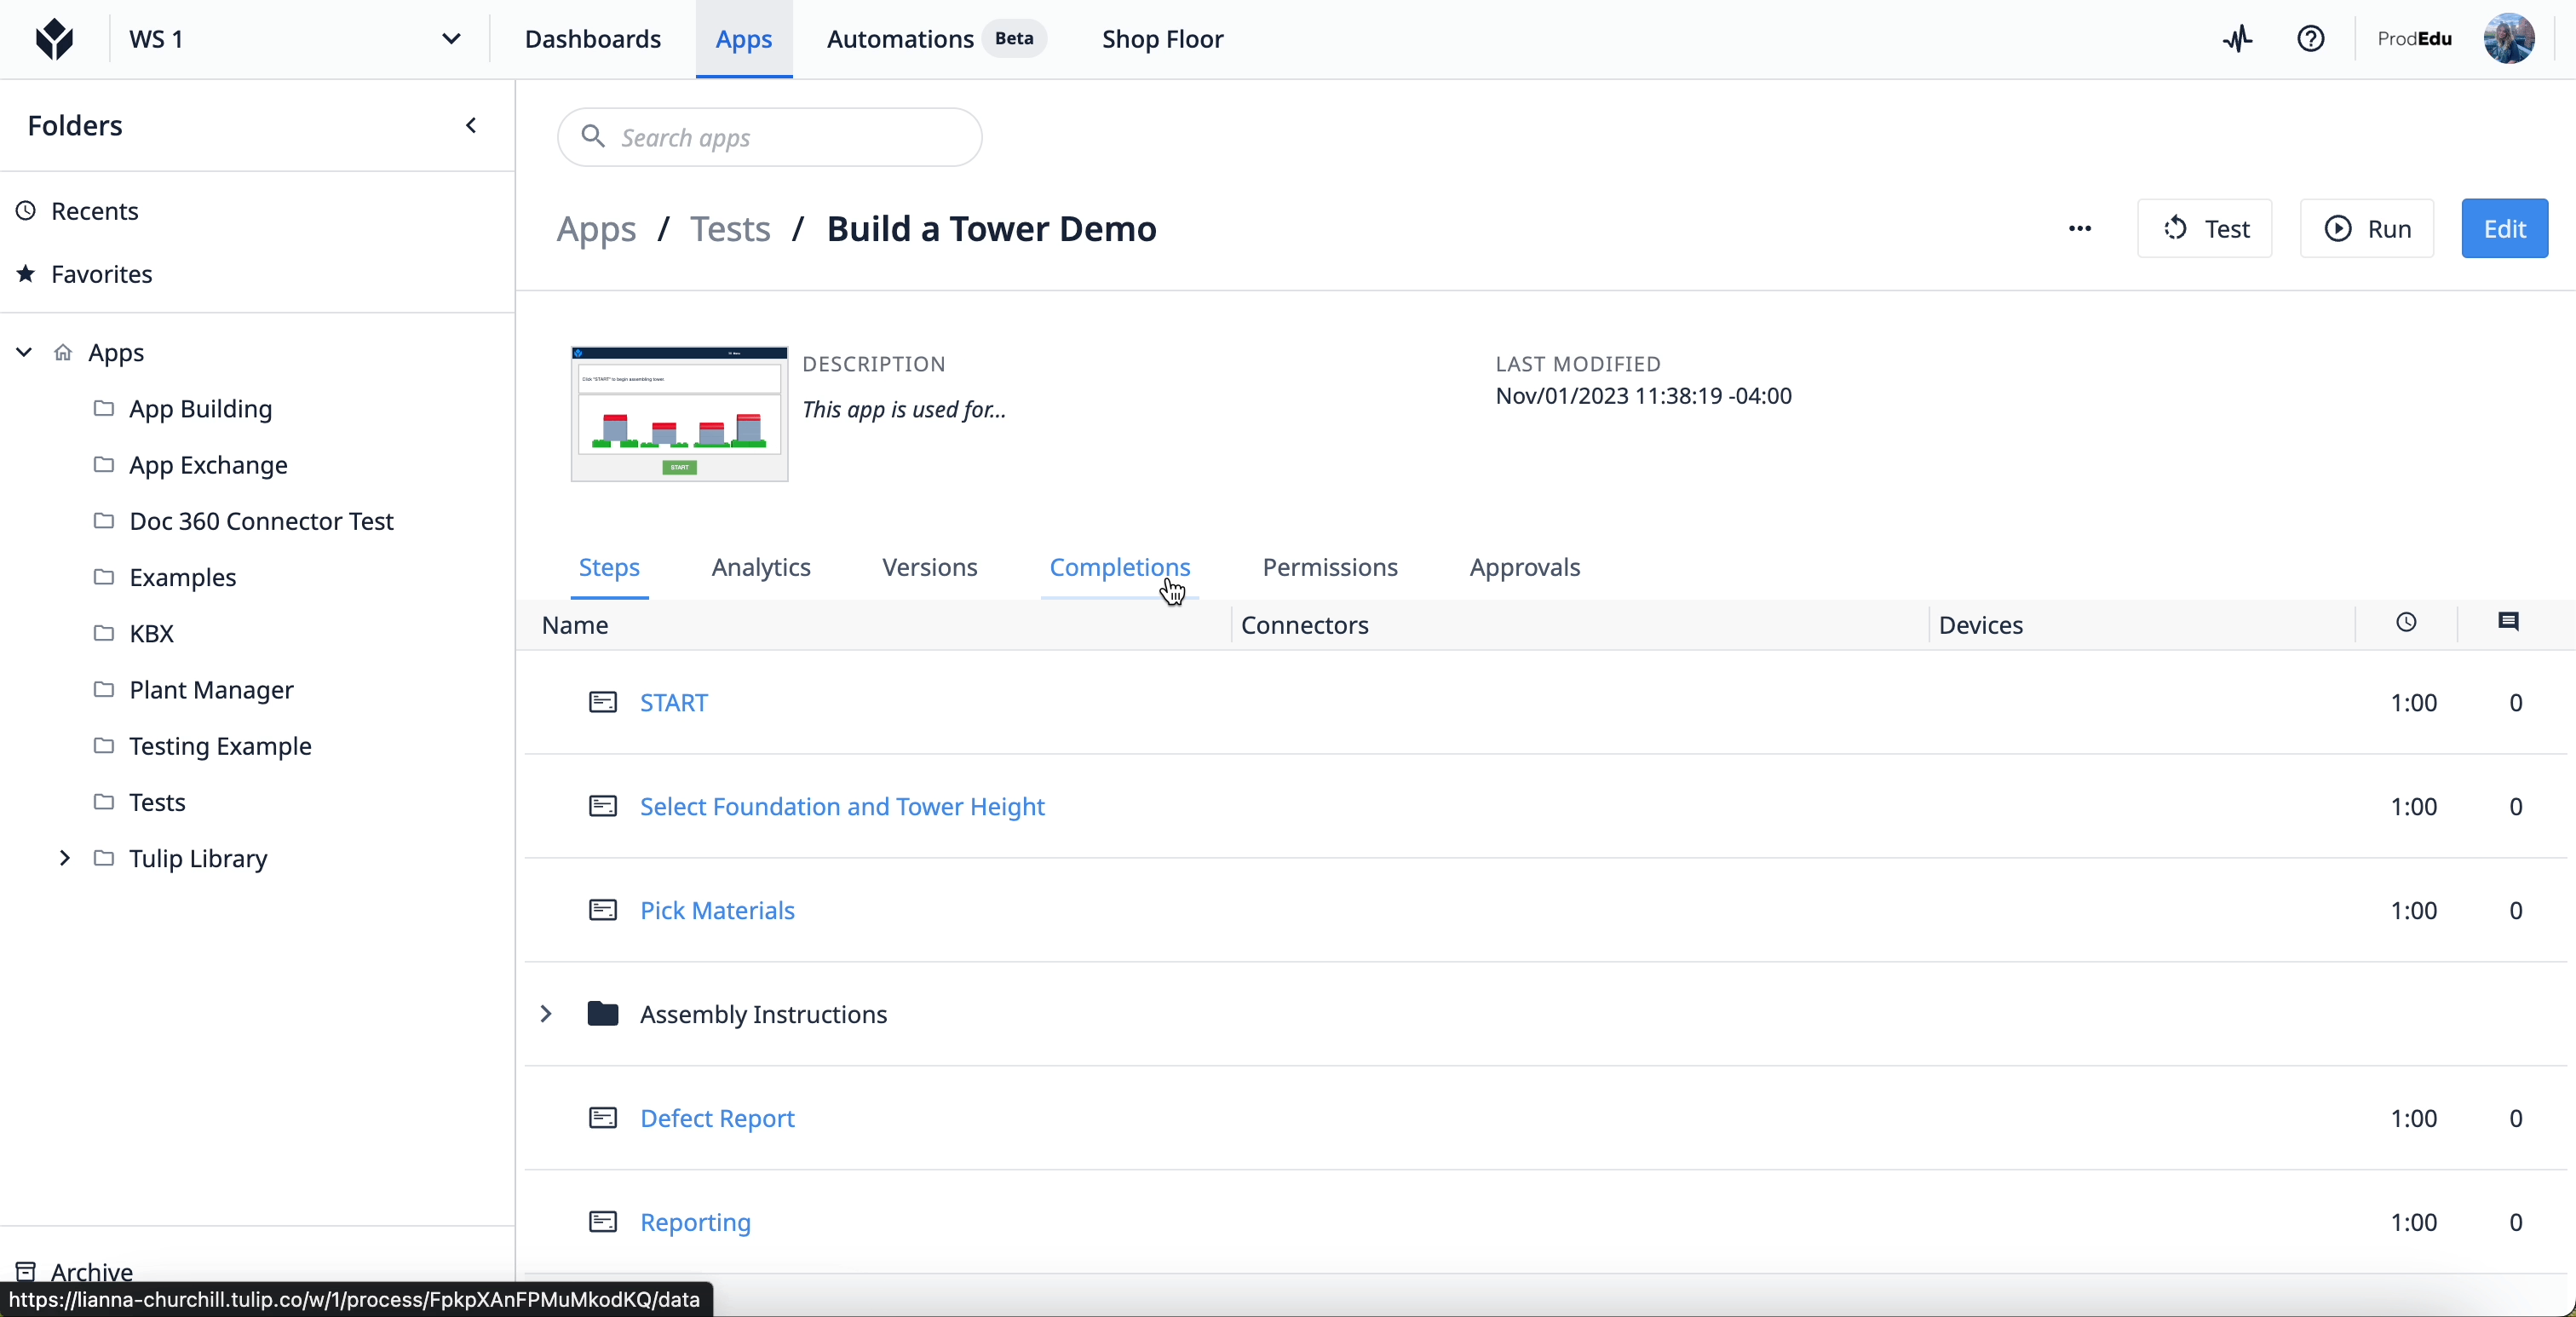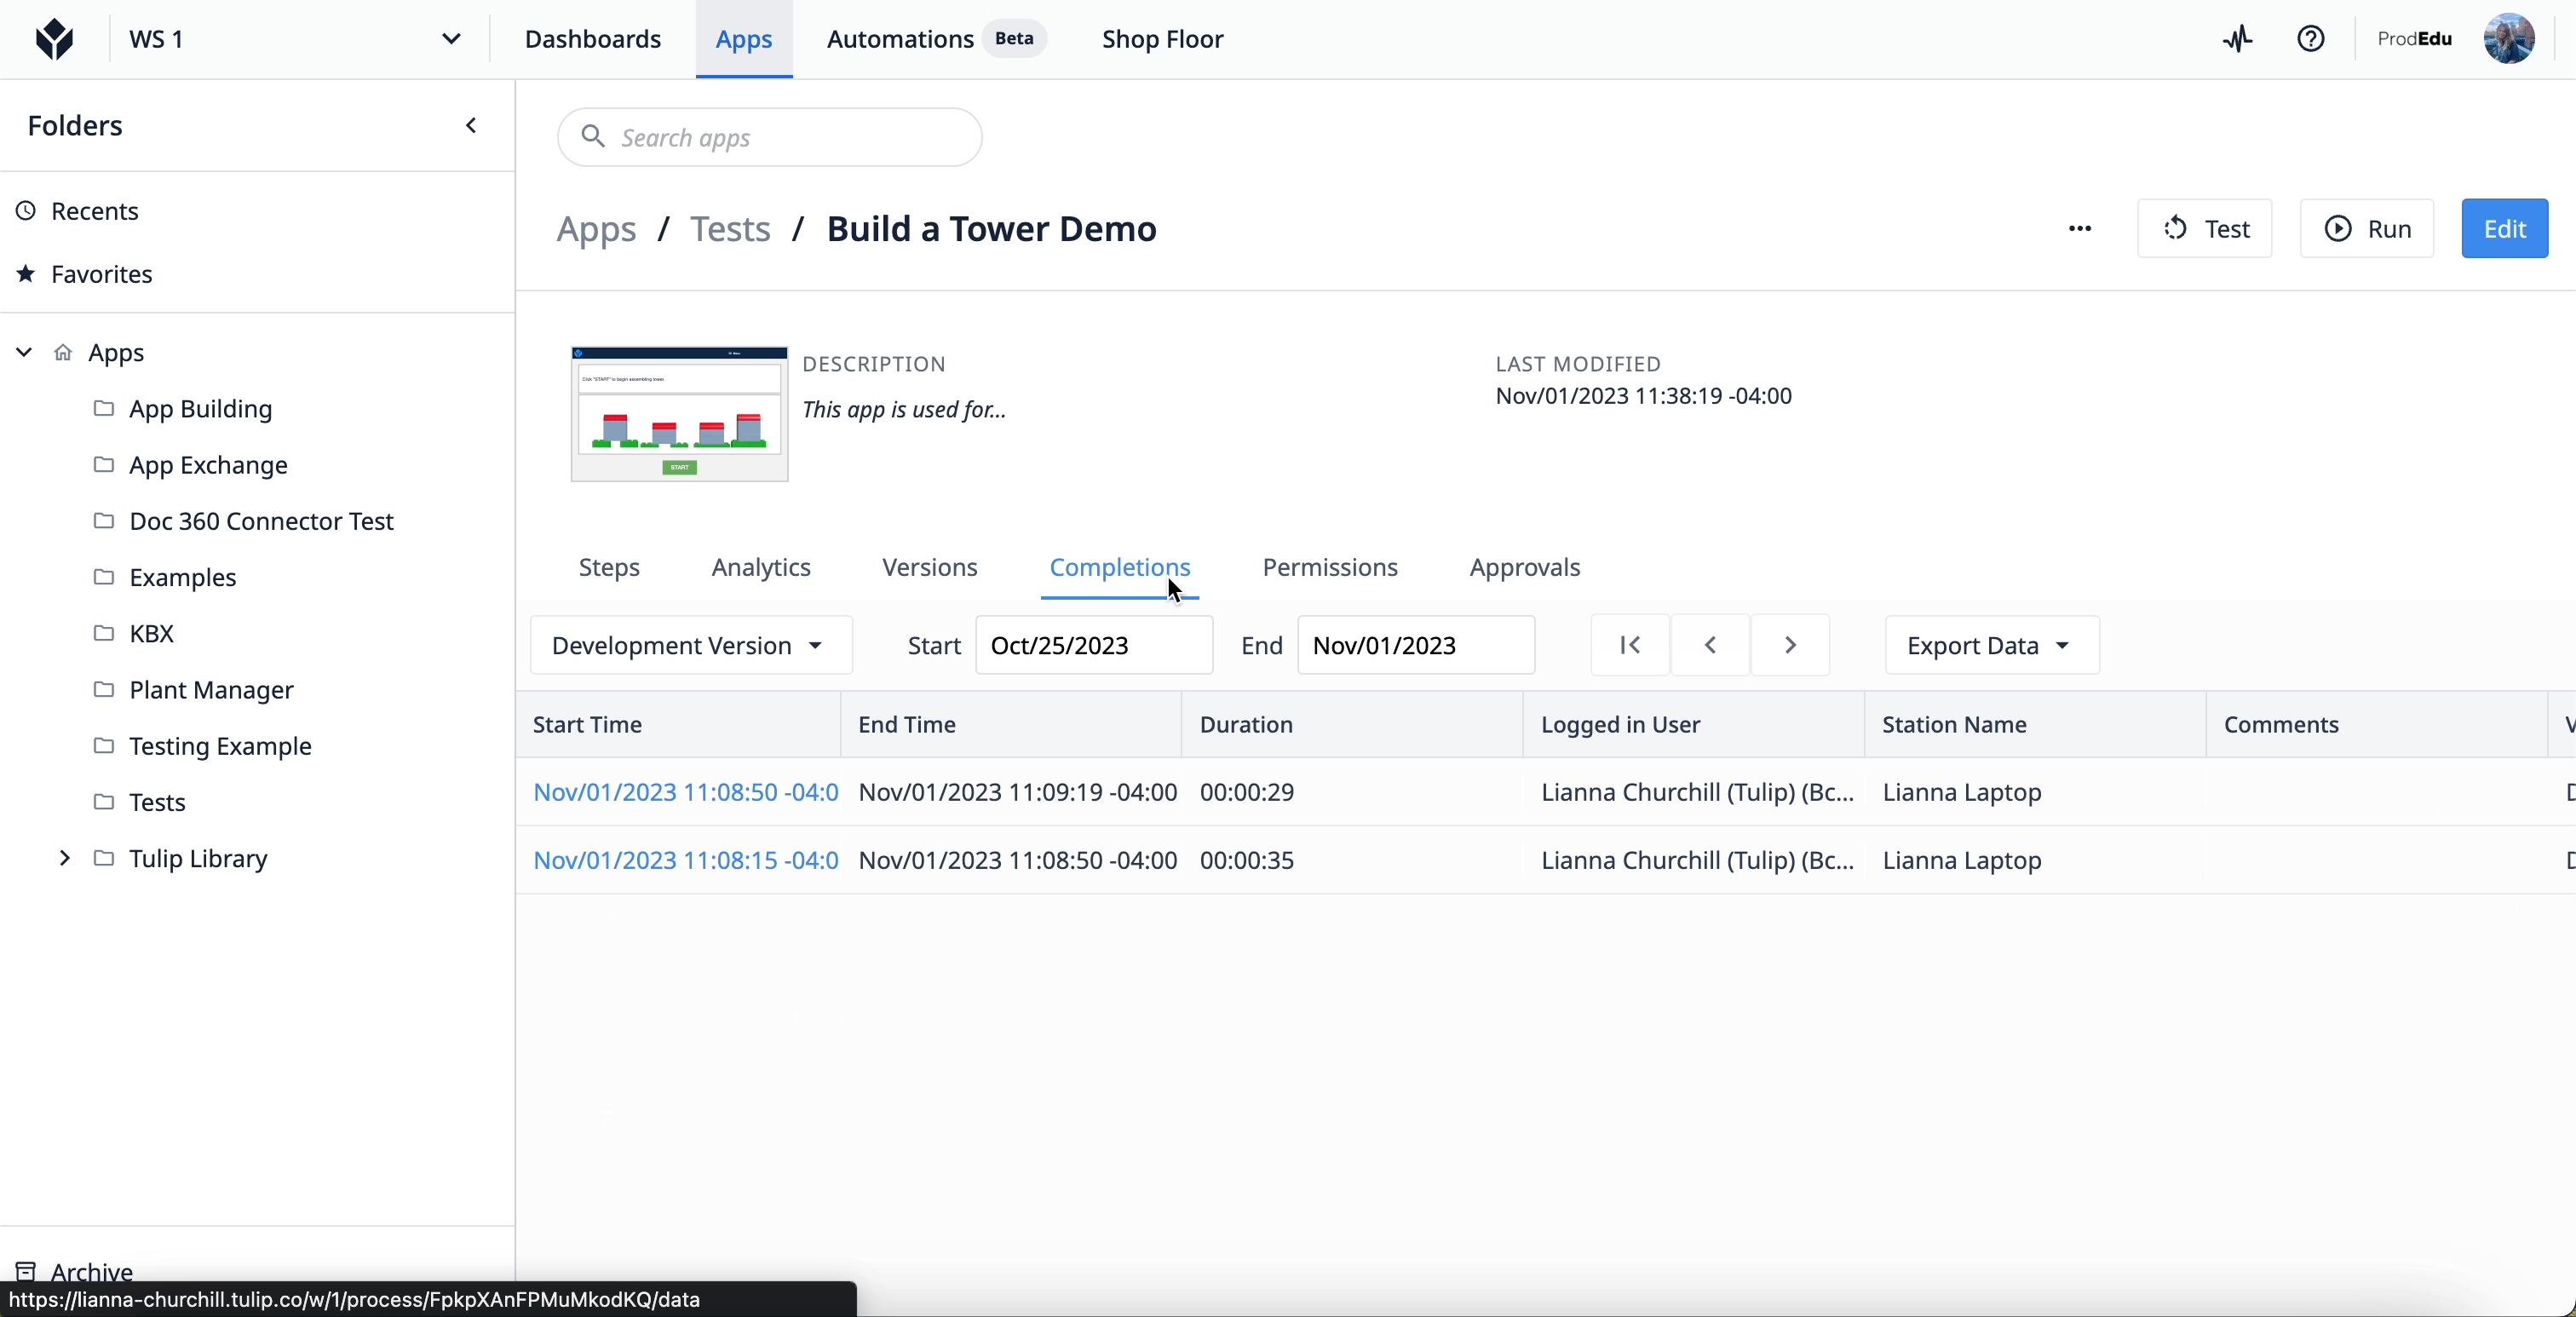
Pour en savoir plus sur les « Completions », cliquez ici.
Tableaux vs « Completions »
Les données de « Completions » étant automatiquement stockées dans les données de l’application, vous vous demandez peut-être dans quels cas il serait préférable de créer un tableau pour stocker ces données.
Les données de finalisation sont immuables, tandis que les champs des tableaux sont créés en fonction de vos besoins. Les données des tableaux sont également enregistrées depuis votre application en fonction des déclencheurs et des variables que vous définissez ; en revanche, les données de « completions » ne sont enregistrées que lorsqu'un utilisateur termine ou annule l'application. Si les données de « completions » offrent une simplicité d'utilisation et une automatisation instantanée, les données des tableaux peuvent être personnalisées pour votre application et offrent la flexibilité nécessaire pour réutiliser ces données dans plusieurs applications.
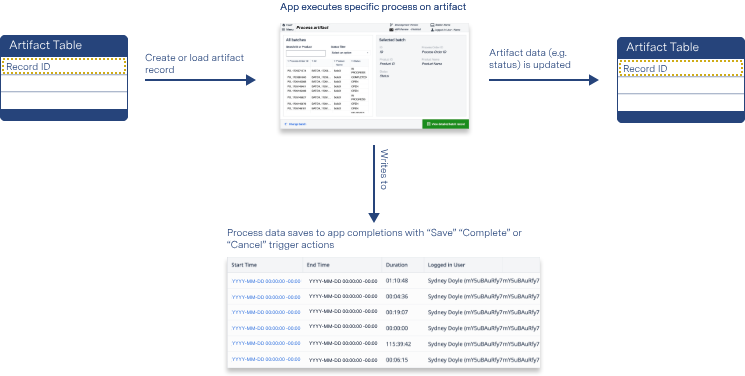
Bonnes pratiques pour le stockage des données
Le stockage des données étant personnalisable en fonction de vos opérations, il existe de nombreuses façons de configurer vos structures de données. Tulip recommande plusieurs bonnes pratiques pour vous assurer de créer des tables et de stocker vos données en tenant compte des objectifs suivants :
- Les données sont facilement accessibles
- Les données sont visibles par les personnes et les systèmes concernés
- Les données sont centralisées et ne sont pas dupliquées ailleurs
Pour en savoir plus sur les bonnes pratiques de Tulip en matière de stockage des données, cliquez ici.
Appliquer un modèle de données
Tulip propose un modèle de données commun prédéfini adapté à de nombreux cas d'utilisation, que vous pouvez adopter et adapter à vos besoins spécifiques :
- Modèle de données commun pour des cas d'utilisation distincts
- Modèle de données commun pour les cas d'utilisation dans le secteur pharmaceutique
Dans Tulip, un modèle de données commun est un ensemble de tables définies suffisamment flexibles pour permettre le partage des données au sein d’une solution d’applications.
Les schémas ci-dessous illustrent comment les tables partagent des données communes entre les applications.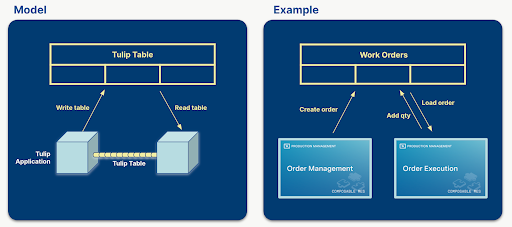
Un modèle de données commun propose des schémas de données standardisés et extensibles, rationalisant le traitement des données entre les systèmes en représentant des concepts largement utilisés (par exemple, les ordres de travail ou les unités). Cela simplifie la création, la compilation et l’analyse des données, et offre une opportunité significative d’améliorer la gestion des données.
Les tables Tulip doivent principalement suivre le modèle du jumeau numérique, ce qui signifie qu’elles doivent refléter l’usine physique ou l’atelier de production aussi fidèlement que possible. Les données historiques des applications doivent être limitées aux enregistrements d’achèvement afin de garantir que les tables ne stockent pas de données de référence ni ne dupliquent les données provenant des enregistrements d’achèvement ou d’enregistrements externes.
Pour en savoir plus sur l’utilisation d’un modèle de données commun, cliquez ici.
Suivez la formation sur le modèle de données commun proposée par Tulip University ici.
Utiliser les données dans les applications
Pour afficher, modifier ou saisir des données de table dans vos applications, vous devez d’abord vous familiariser avec les widgets. Les Input Widgets vous permettent de modifier et de saisir des données qui seront répercutées dans votre table. Les widgets intégrés affichent vos informations et peuvent être configurés pour vous permettre d’interagir avec vos tables. Pour un tutoriel complet sur l’intégration des données de tableau, consultez :
- Utilisation des tableaux dans une application
- Présentation détaillée de la fonctionnalité : les tableaux Tulip
Les données de complétion peuvent être affichées dans vos applications via Analytics. Vous devrez d’abord créer une analyse à partir de vos données de complétion, puis intégrer cette analyse à votre application.
Pour en savoir plus sur l’utilisation des données de complétion pour créer une analyse, cliquez ici.
Comment Tulip stocke vos données
Tulip étant une plateforme en libre-service, vous pouvez déterminer quelles données sont transmises et stockées. Le cloud Tulip stocke vos données sur AWS, à l’aide d’une base de données MongoDB ou PostgreSQL. Tulip télécharge automatiquement toutes les images, vidéos et fichiers PDF vers le service de stockage S3 d’Amazon, ce qui vous évite d’avoir à vous soucier de la gestion du stockage ou du suivi de vos données collectées.
Prochaines étapes
Commencez à travailler avec les données en suivant les conseils des experts de Tulip :* Tutoriel : Créez votre premier tableau* Cours « Travailler avec les données et les tableaux »* Comprendre les « App Completions » et le guide « Table University »* Intégration avec des systèmes externes
Avez-vous trouvé ce que vous cherchiez ?
Vous pouvez également vous rendre sur community.tulip.co pour poser votre question ou voir si d’autres utilisateurs ont rencontré un problème similaire !
