
Chi può utilizzare questa funzionalità
Utenti con piani Enterprise e superiori.
Diagramma di esportazione/importazione
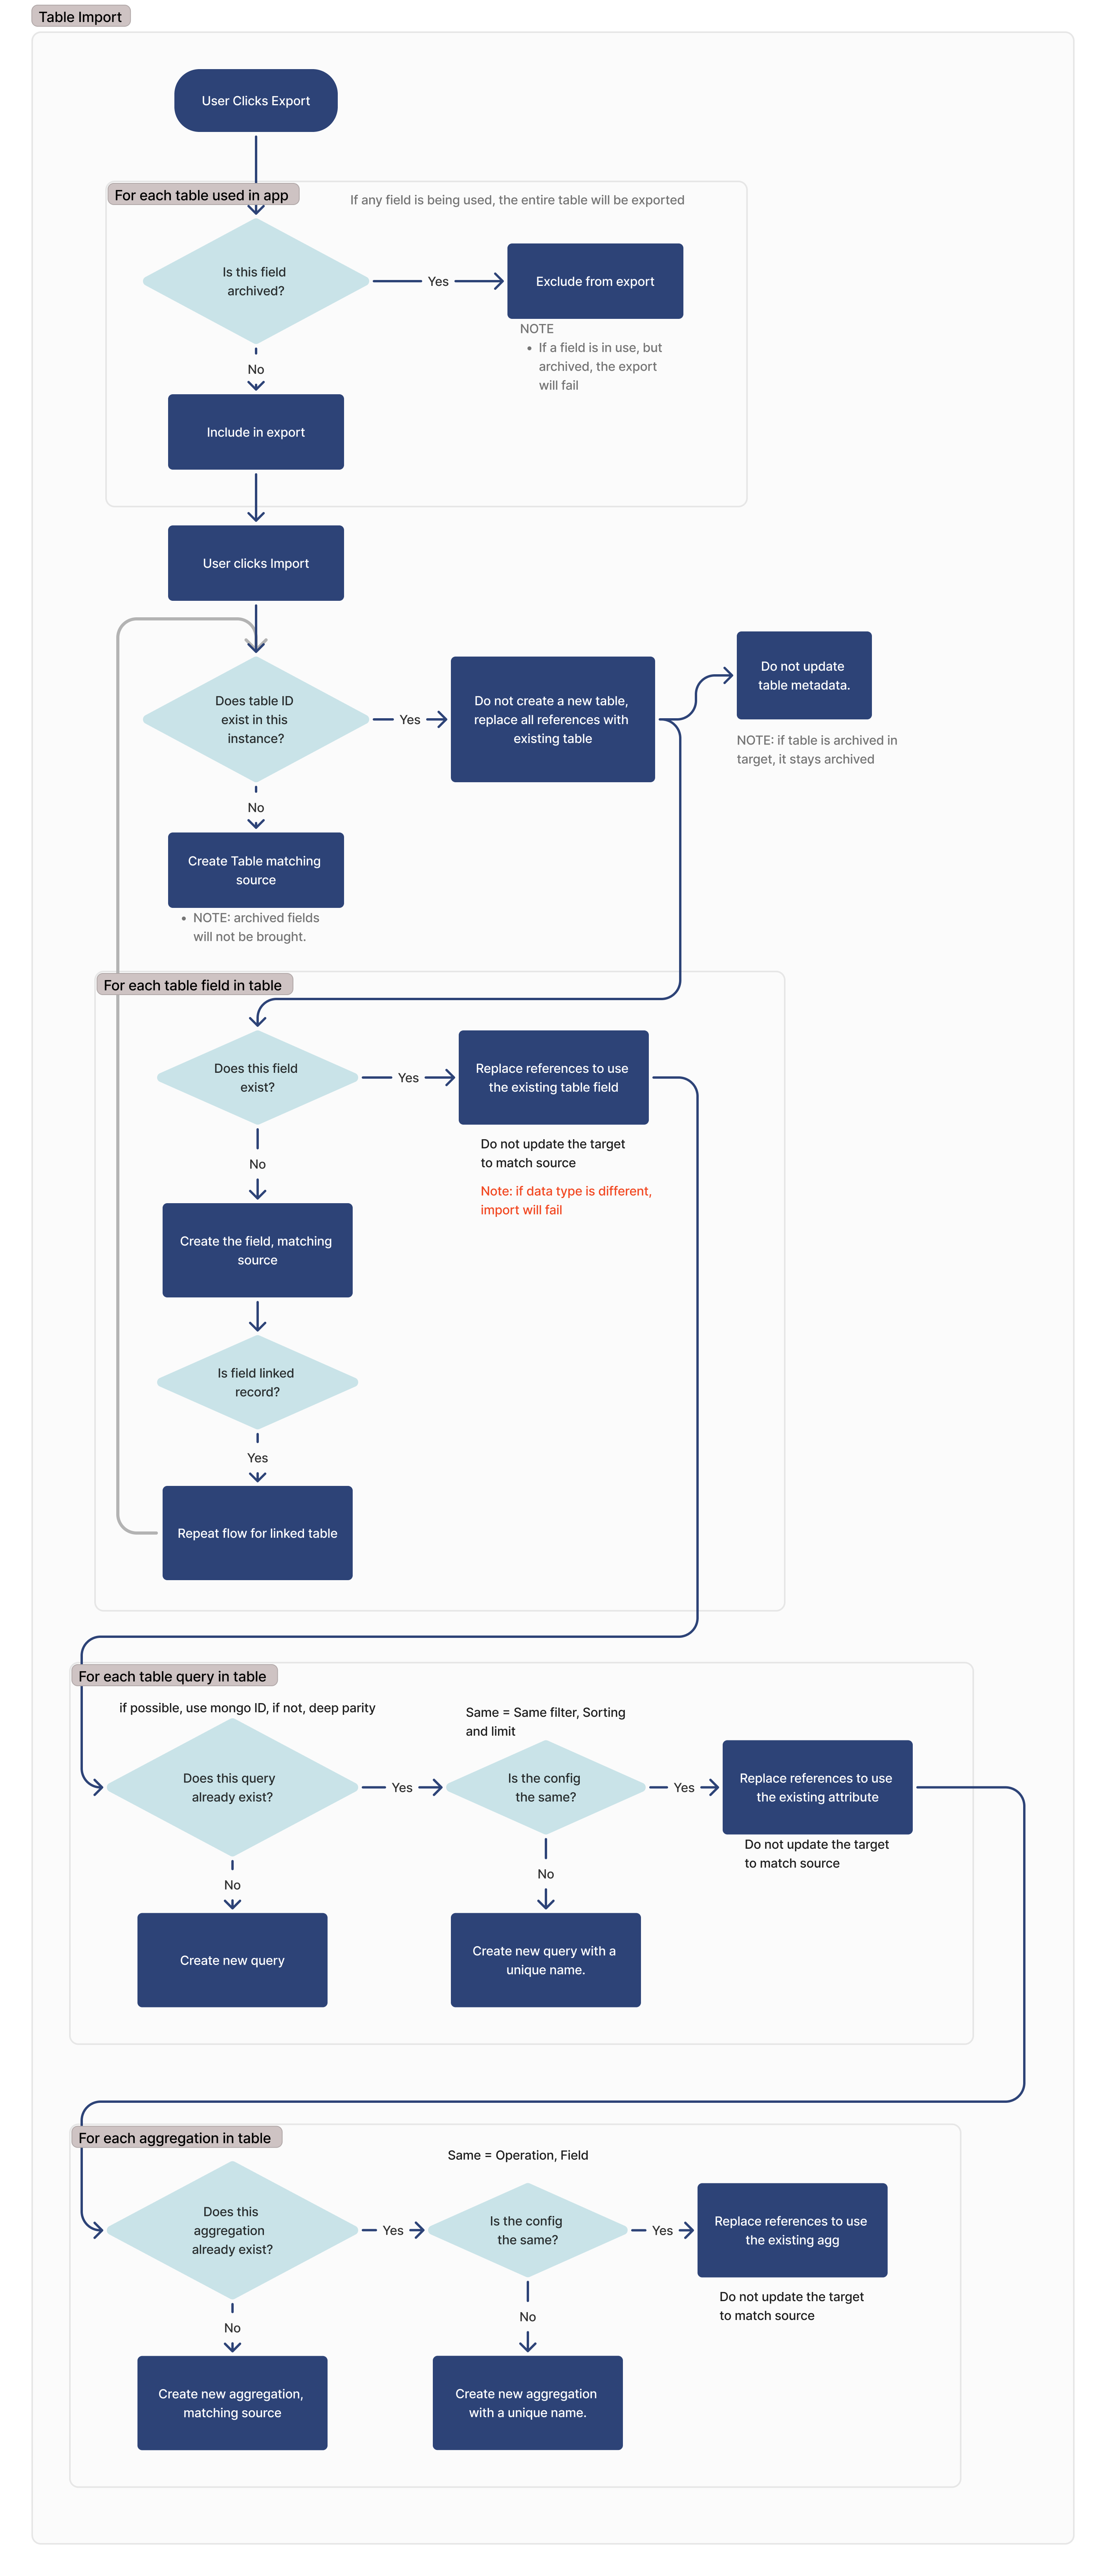
Di seguito è riportato l’intero flusso di trasferimento per tabelle, query e aggregazioni di Tulip. Questo documento fornirà una spiegazione dettagliata di tale flusso.
Campi utente personalizzati e tabelle delle attività dei dispositivi
Il flusso descritto di seguito si applica anche alle modalità di esportazione e importazione delle tabelle dei campi utente personalizzati e delle tabelle dei campi relativi all’attività delle macchine.
Esportazione
Durante il processo di esportazione, l’applicazione o l’automazione esportata includerà tutte le tabelle in uso all’interno di tale applicazione. Una tabella è considerata in uso se è soddisfatta una delle seguenti condizioni:
- È visualizzata in un widget “Record tabella”
- Utilizzata in un widget di input
- Visualizzata in una tabella interattiva
- Utilizzata in un trigger
- Utilizzata in un'azione di automazione
- Utilizzato in un blocco evento di automazione
- Utilizzato in un filtro per una query su una tabella, una tabella interattiva o un widget di analisi
- Utilizzato come input o output per un widget personalizzato
Se un campo è archiviato, non verrà esportato. Se un campo è archiviato ma in uso, l'esportazione fallirà.
Importazione
Trova una tabella corrispondente
Per identificare le tabelle corrispondenti durante l’importazione, cerchiamo gli ID corrispondenti. Se viene trovata una tabella con lo stesso ID, non ne creiamo una nuova e utilizziamo quella esistente.
Se una tabella è archiviata nell’istanza di origine e non esiste in quella di destinazione, la tabella viene creata nell’istanza di destinazione e verrà archiviata.
Se la tabella nell'istanza di origine è archiviata, rimarrà archiviata. Una tabella archiviata rimane archiviata; una tabella non archiviata rimane non archiviata.
Per ogni campo della tabella
Per ogni campo della tabella, cerchiamo un campo corrispondente in base all’ID della colonna di quel rispettivo campo.
Se il tipo di dati del campo corrispondente è diverso, l’importazione fallirà.
Se il campo è un campo di record collegato, la tabella collegata verrà aggiunta all’elenco delle dipendenze per l’importazione e questo flusso verrà ripetuto per quella tabella.
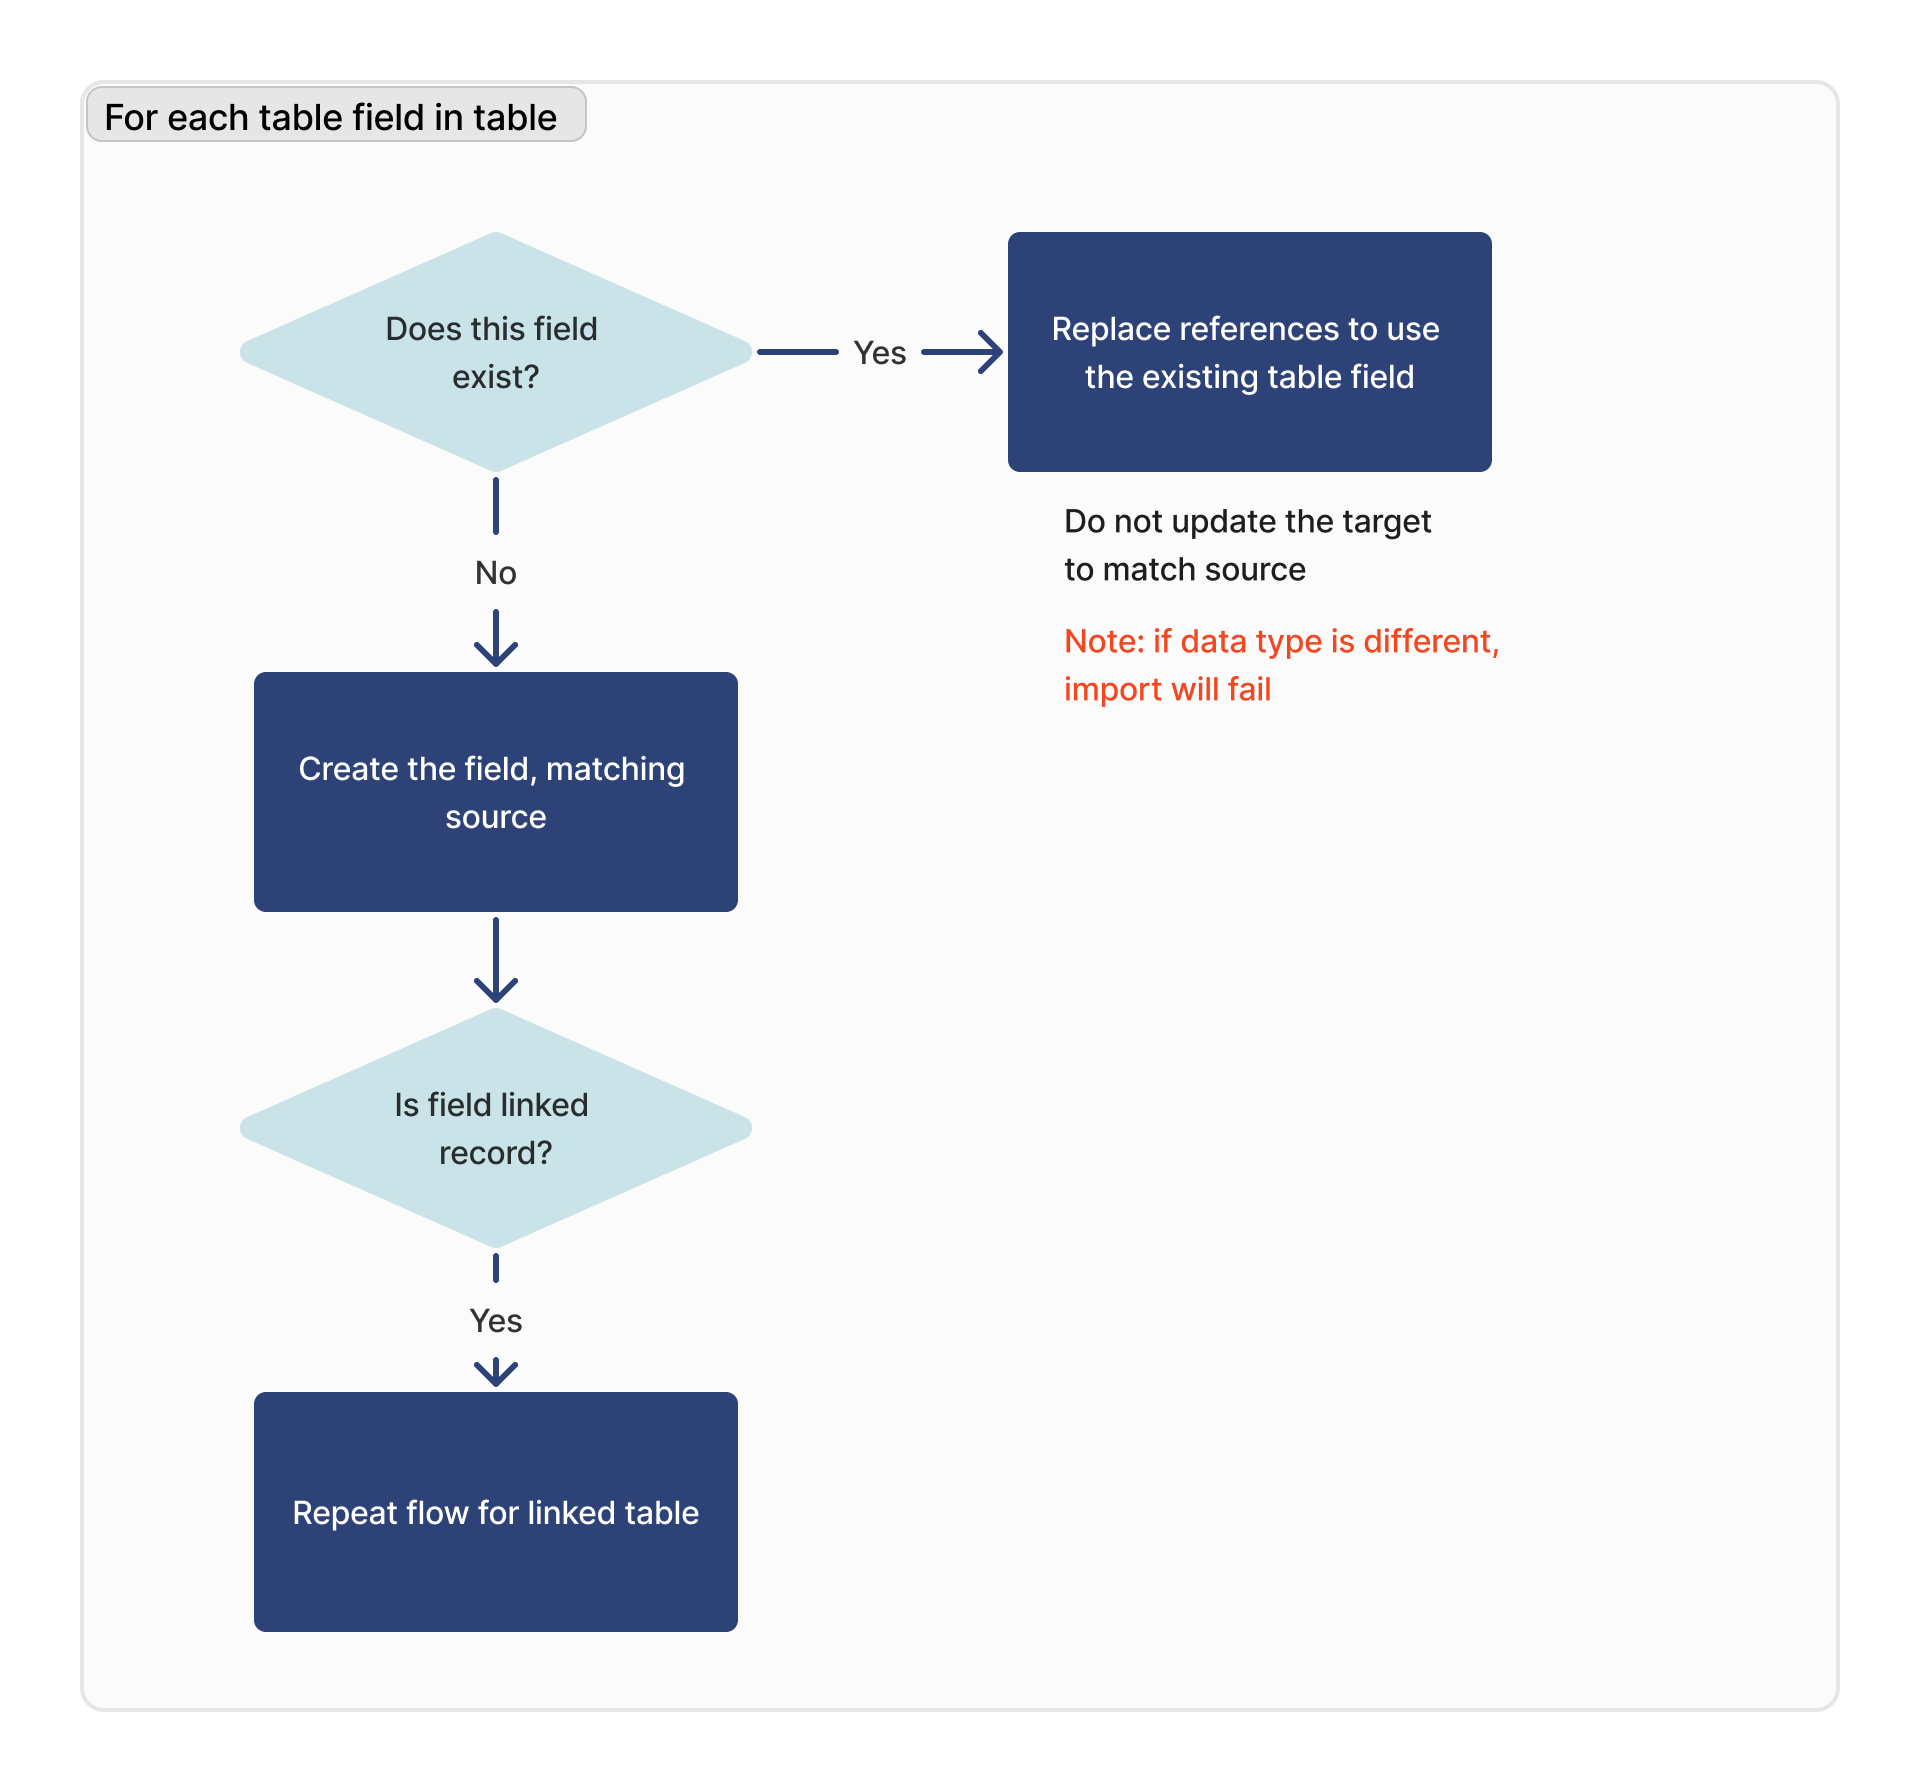
Se un campo è archiviato nella tabella di origine e non esiste in quella di destinazione, verrà creato in quest'ultima come non archiviato (nota: questo comportamento differisce da quello della tabella).
Se un campo esiste già nella destinazione, il suo stato di archiviazione non viene mai aggiornato dall’importazione. Un campo archiviato rimane archiviato; un campo non archiviato rimane non archiviato.
When exporting a table directly, archived fields are not included. However, if an archived field is referenced by an app, it will be included in the export (with the above import rules applying).
Per ogni query
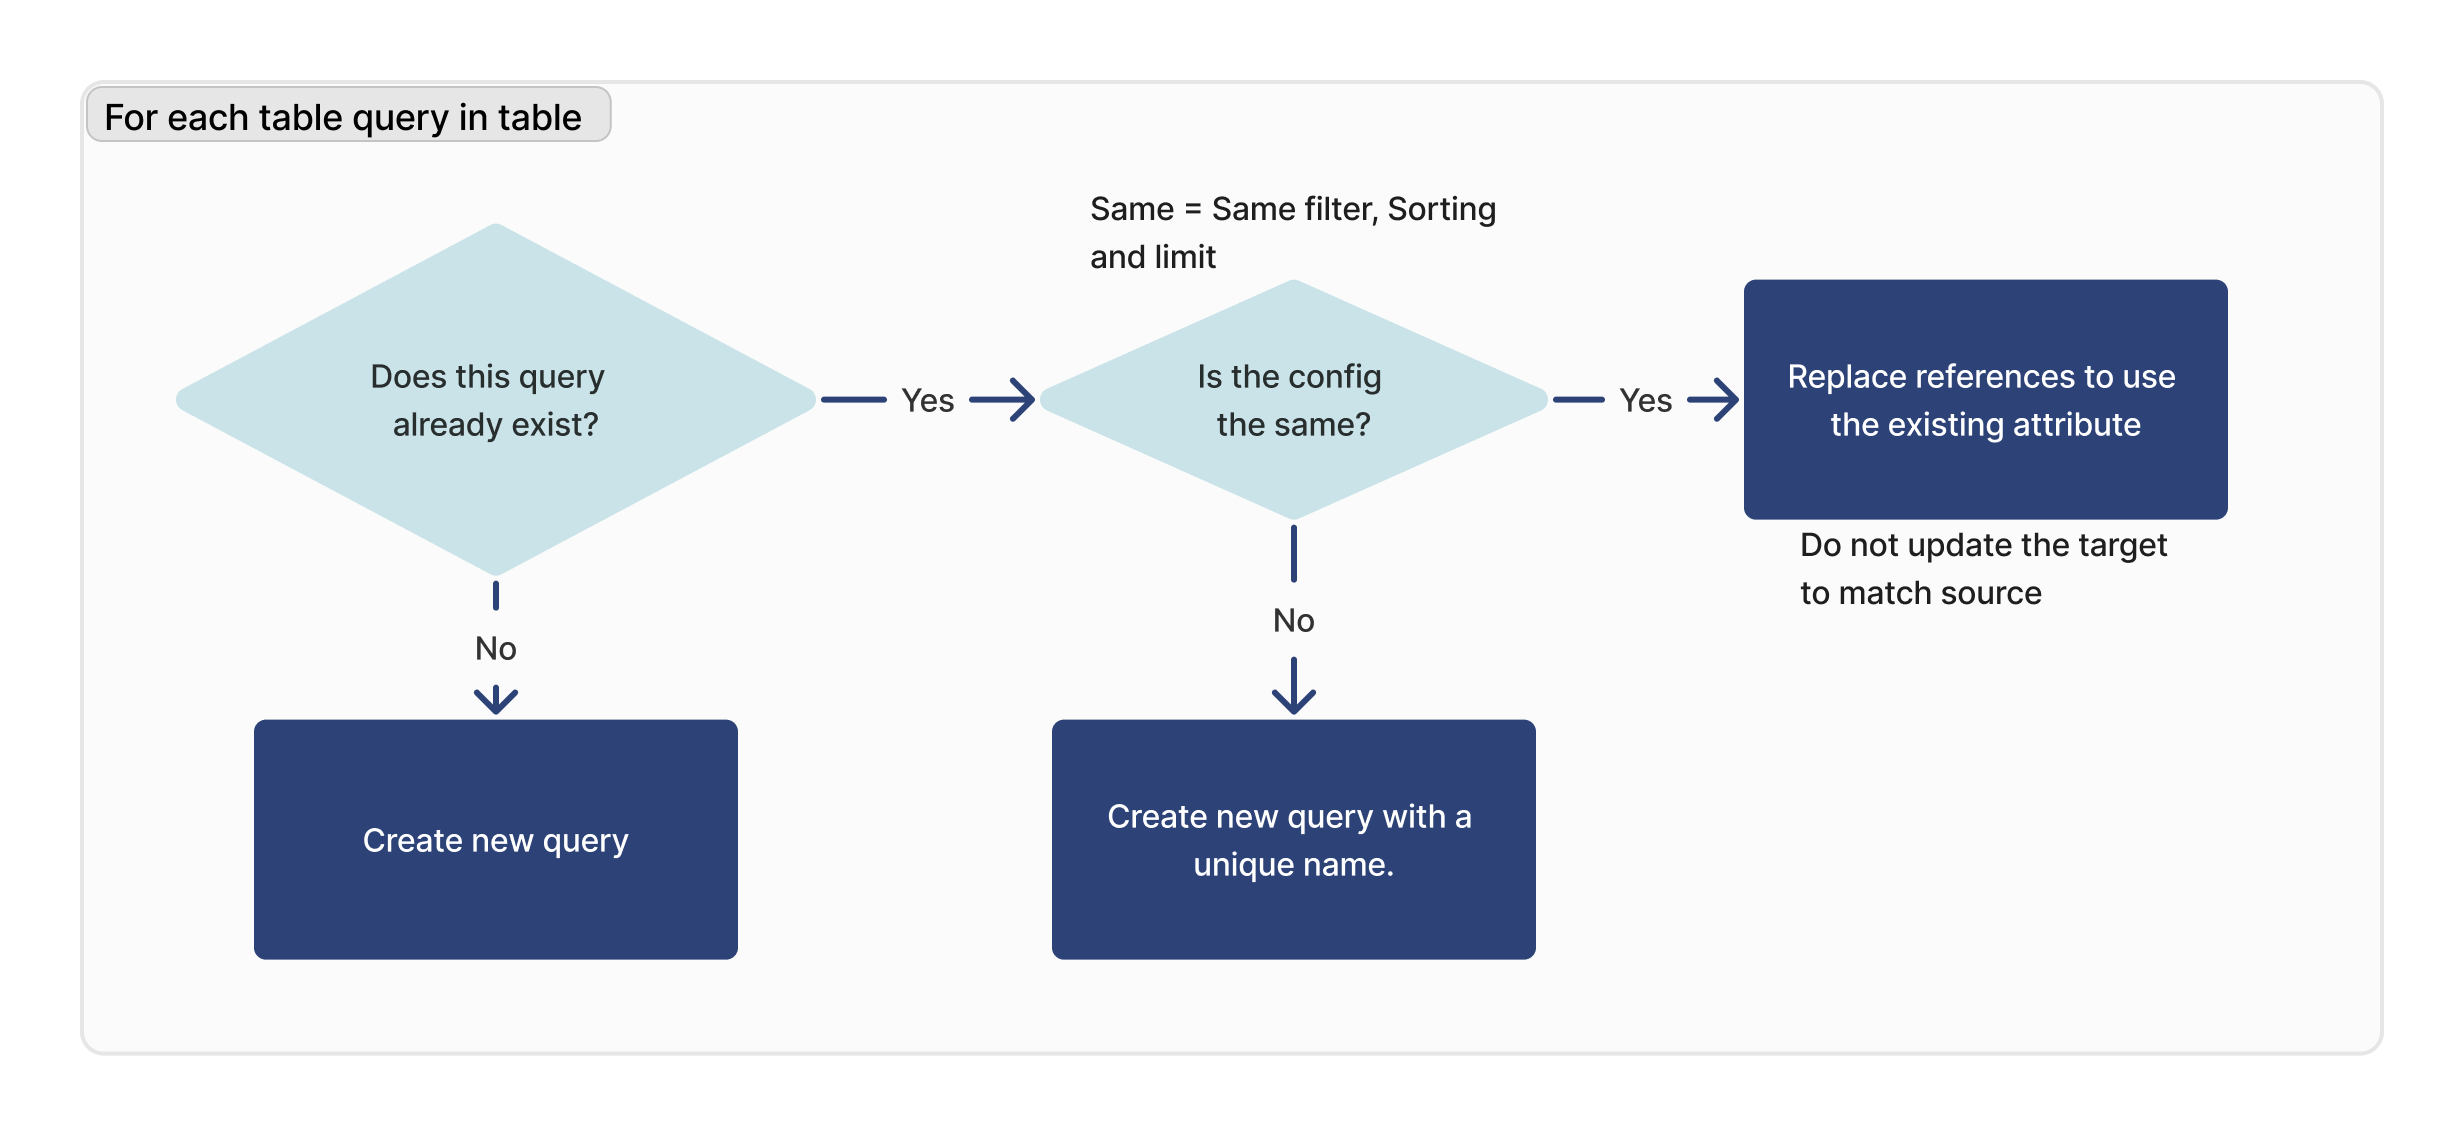
Per ogni query presente nella tabella importata, verifichiamo se tale query esiste. Se viene trovato un ID corrispondente, verifichiamo che la configurazione sia identica (limite, ordinamento e filtro) tra la destinazione e la fonte.
Se non è possibile trovare una query corrispondente, verrà creata una nuova query. Se viene trovata una query corrispondente, ma non è identica all’istanza di destinazione, verrà creata una nuova query con un nuovo nome.
Nota: ciò non si applica ai campi utente personalizzati né alle tabelle delle attività del sistema.
Gli aggiornamenti al comportamento di importazione/esportazione riducono i duplicati. Le query delle tabelle ora vengono importate come development version. La query della tabella verrà importata come snapshot solo se esiste già una query identica con una configurazione diversa.
Il comportamento precedente (ancora presente nelle istanze r329/LTS14 e precedenti) importava gli snapshot come snapshot e gli development versions come development versions.
Per ogni aggregazione
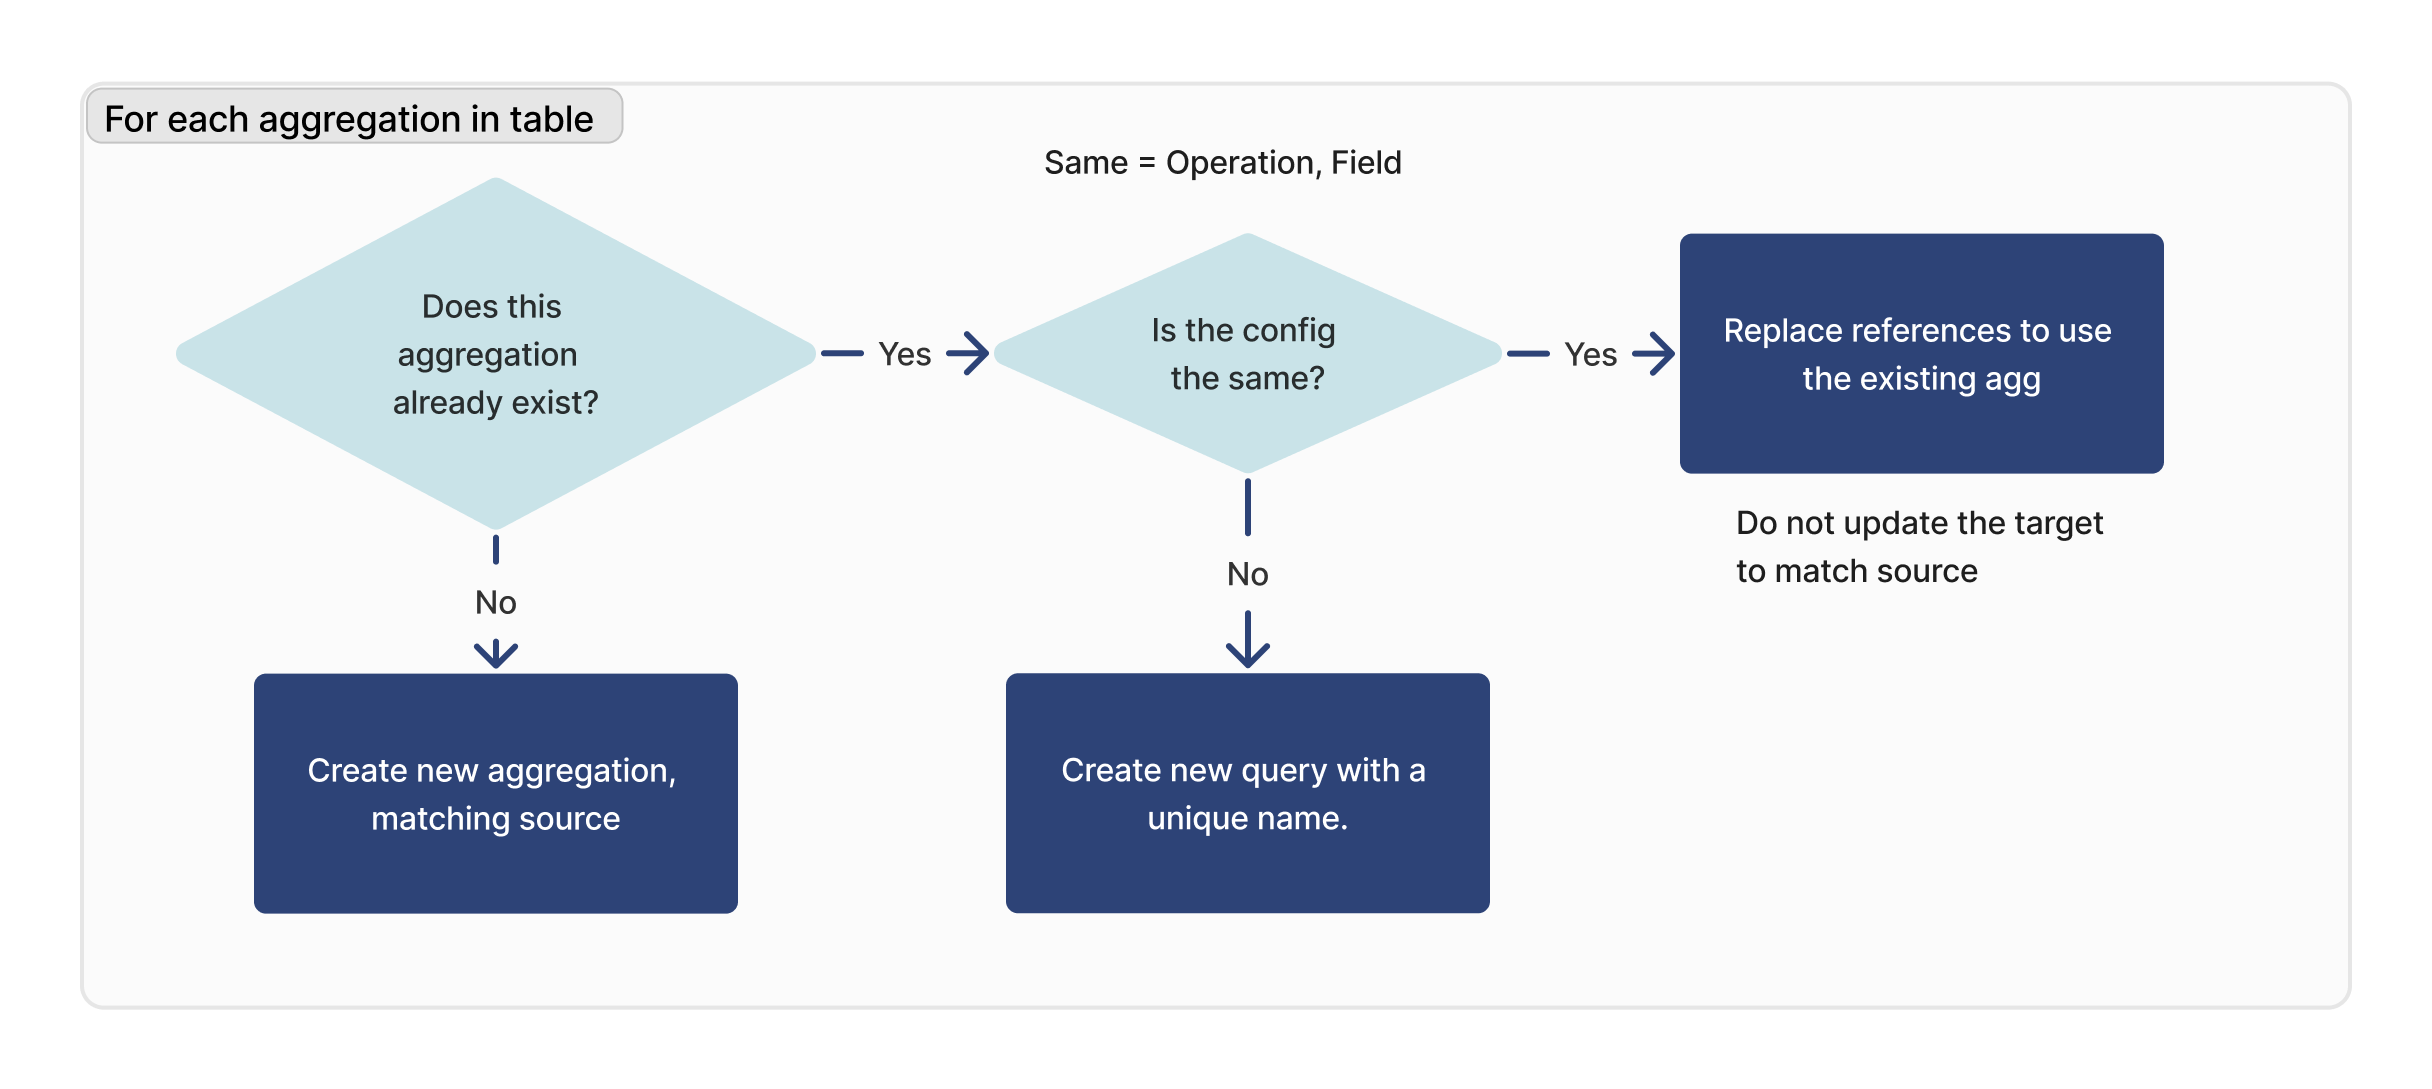
Per ogni aggregazione nella tabella importata, verifichiamo se tale query esiste. Se viene trovato un ID corrispondente, verifichiamo che la configurazione sia identica (operazione, campo) tra la destinazione e l’origine.
Se non è possibile trovare un’aggregazione corrispondente, verrà creata una nuova aggregazione. Se viene trovata un’aggregazione corrispondente, ma non è identica a quella dell’istanza di destinazione, verrà creata una nuova aggregazione con un nuovo nome.
Nota: ciò non si applica ai campi utente personalizzati né alle tabelle delle attività del sistema.
Gli aggiornamenti al comportamento di importazione/esportazione riducono i duplicati. Le aggregazioni delle tabelle ora vengono importate come development version. L’aggregazione della tabella verrà importata come snapshot solo se esiste già la stessa aggregazione con una configurazione diversa.
Il comportamento precedente (ancora presente nelle istanze r329/LTS14 e precedenti) importava gli snapshot come snapshot e le aggregazioni di tabella ( development versions ) come tabelle di attività ( development versions).
{{snippet.Hai trovato quello che cercavi?}}