
Optimiza la obtención de datos de Tulip a AWS S3 para ampliar las oportunidades de análisis e integraciones
Objetivo
Esta guía explica paso a paso cómo recuperar todos los datos de las tablas de Tulip mediante una función Lambda y escribirlos en un bucket de S3.
Esto va más allá de la consulta básica de obtención de datos y recorre todas las tablas de una instancia determinada; puede resultar muy útil para una tarea semanal de ETL (Extracción, Transformación, Carga).
La función Lambda puede activarse a través de diversos recursos, como los temporizadores de Event Bridge o una API Gateway
A continuación se muestra un ejemplo de arquitectura: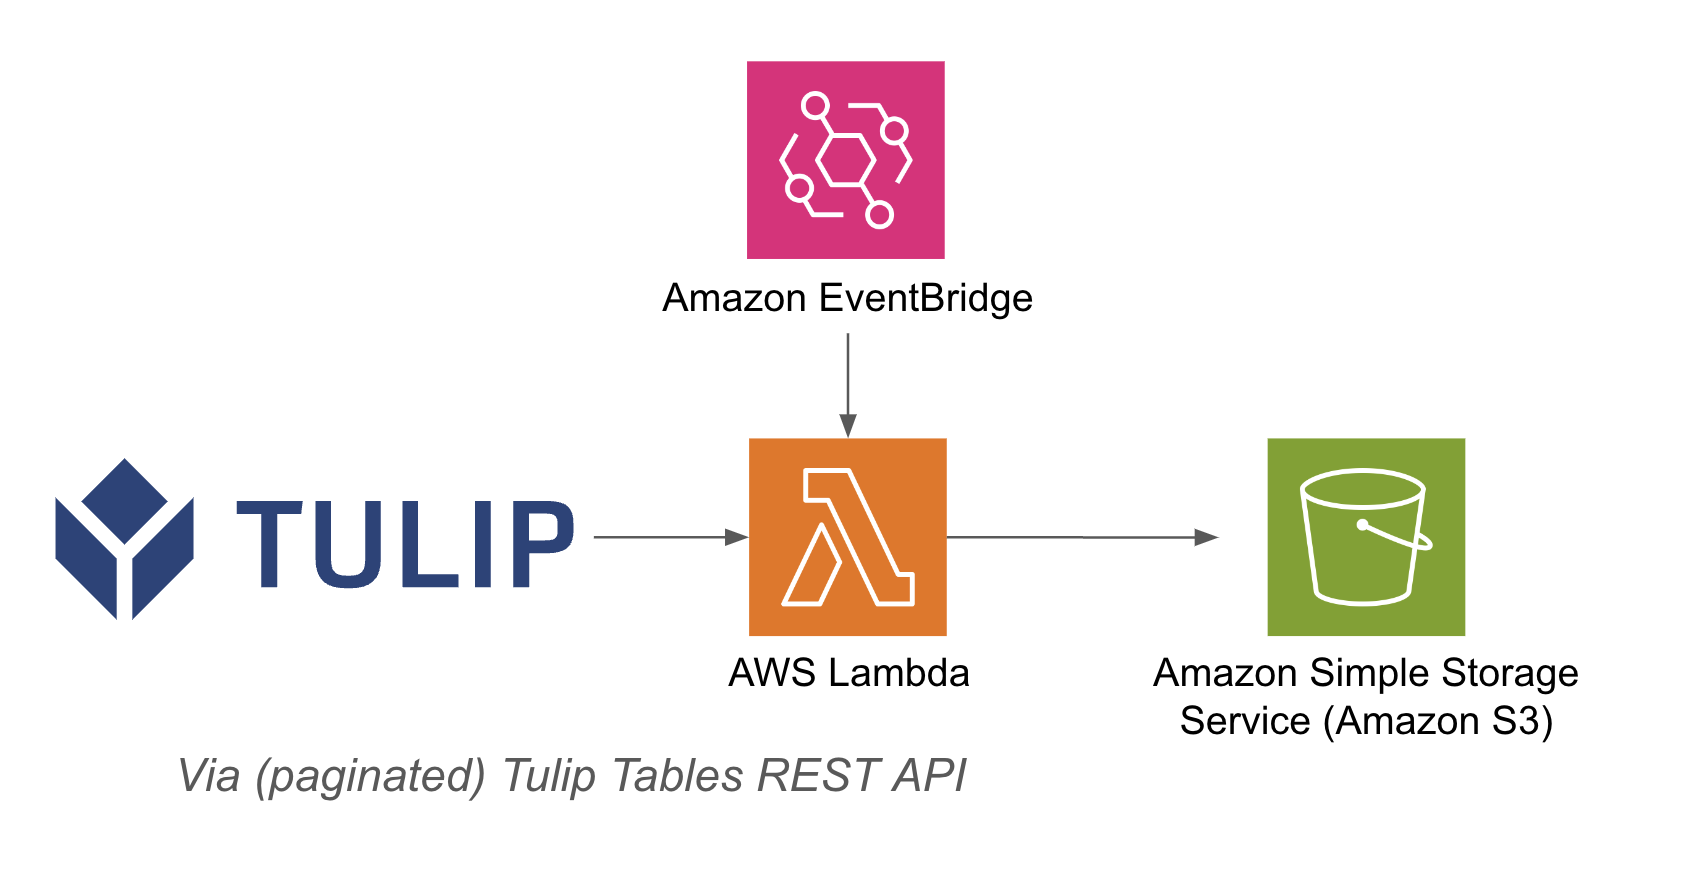
Configuración
Esta integración de ejemplo requiere lo siguiente:
- Uso de la API de Tulip Tables (obtén la clave y el secreto de la API en la configuración de la cuenta)
- Tabla de Tulip (obtenga el ID único de la tabla)
Pasos generales: 1. Crea una función de AWS Lambda con el desencadenador correspondiente (API Gateway, Event Bridge Timer, etc.). 2. Asegúrate de que se utilizan las capas de Lambda adecuadas (por ejemplo, para pandas y awswrangler, etc.) y de que las claves de la API de Tulip Tables tienen los permisos suficientes. 3. Recupere los datos de la tabla de Tulip con el ejemplo siguiente (se puede utilizar en cualquier contexto, ya sea en S3, Glue, Redshift, etc.)```pythonimport jsonimport awswrangler as wrimport boto3from datetime import datetimeimport pandas as pdimport requestsimport os
# Obtener la marca de tiempo actual para nombres de archivo únicos
timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")
bucket = os.getenv('bucket_name')
# Función para convertir diccionarios en cadenas
def dict_to_str(cell): if isinstance(cell, dict): return str(cell) return cell
def query_table(table_id, base_url, api_header): offset = 0 función = f'/tables/{table_id}/records?limit=100&offset={offset}&includeTotalCount=false&filterAggregator=all' r = requests.get(base_url+función, headers=api_header) df = pd.DataFrame(r.json()) length = len(r.json()) while length > 0: offset += 100 función = f'/tables/{table_id}/records?limit=100&offset={offset}&includeTotalCount=false&filterAggregator=all' r = requests.get(base_url + función, headers=api_header) longitud = len(r.json()) df_append = pd.DataFrame(r.json()) df = pd.concat([df, df_append], axis=0) df = df.apply(lambda row: row.apply(dict_to_str), axis=1) return df
# crear función
def write_to_s3(row, base_url, api_header, bucket): table = row['label'] id = row['id'] df = query_table(id, base_url, api_header)
path = f's3://{bucket}/{timestamp}/{table}.csv'# Escribir el DataFrame en S3 como CSV wr.s3.to_csv( df=df, path=path, index=False) print(f"Se ha escrito {table} en {path}") return f"Se ha escrito {table} en {path}"
def lambda_handler(event, context): api_header = {'Authorization' : os.getenv('tulip_api_basic_auth')} instance = os.getenv('tulip_instance') base_url = f'https://{instance}.tulip.co/api/v3' get_tables_function = '/tables' r = requests.get(base_url+get_tables_function, headers=api_header) table_names = pd.DataFrame(r.json())
# función de consulta de la tabla table_names.apply(lambda row: write_to_s3(row, base_url, api_header, bucket), axis=1) return { 'statusCode': 200, 'body': json.dumps('¡Escrito en S3!')}
## Casos de uso y próximos pasos

Una vez finalizada la integración con Lambda, puedes analizar fácilmente los datos con un cuaderno de Sagemaker, QuickSight o una variedad de otras herramientas.

**1. Predicción de defectos:** identifica los defectos de producción antes de que se produzcan y aumenta la tasa de acierto a la primera. Identifica los factores clave de la calidad en la producción para implementar mejoras

**2. Optimización del coste de la calidad:** identifica oportunidades para optimizar el diseño de los productos sin que ello afecte a la satisfacción del cliente.

**3. Optimización del consumo energético en la producción**: identifica los factores clave de la producción que permiten optimizar el consumo de energía.

**4. Predicción y optimización de entregas y planificación**: optimice el calendario de producción en función de la demanda de los clientes y del calendario de pedidos en tiempo real.

**5. Análisis comparativo global de máquinas y líneas**: realizar comparativas de máquinas o equipos similares mediante la normalización.

**6. Gestión digital del rendimiento a nivel global y regional**: datos consolidados para crear paneles de control en tiempo real