
¿Quién puede utilizar esta función?
Los usuarios con planes Enterprise o superiores.
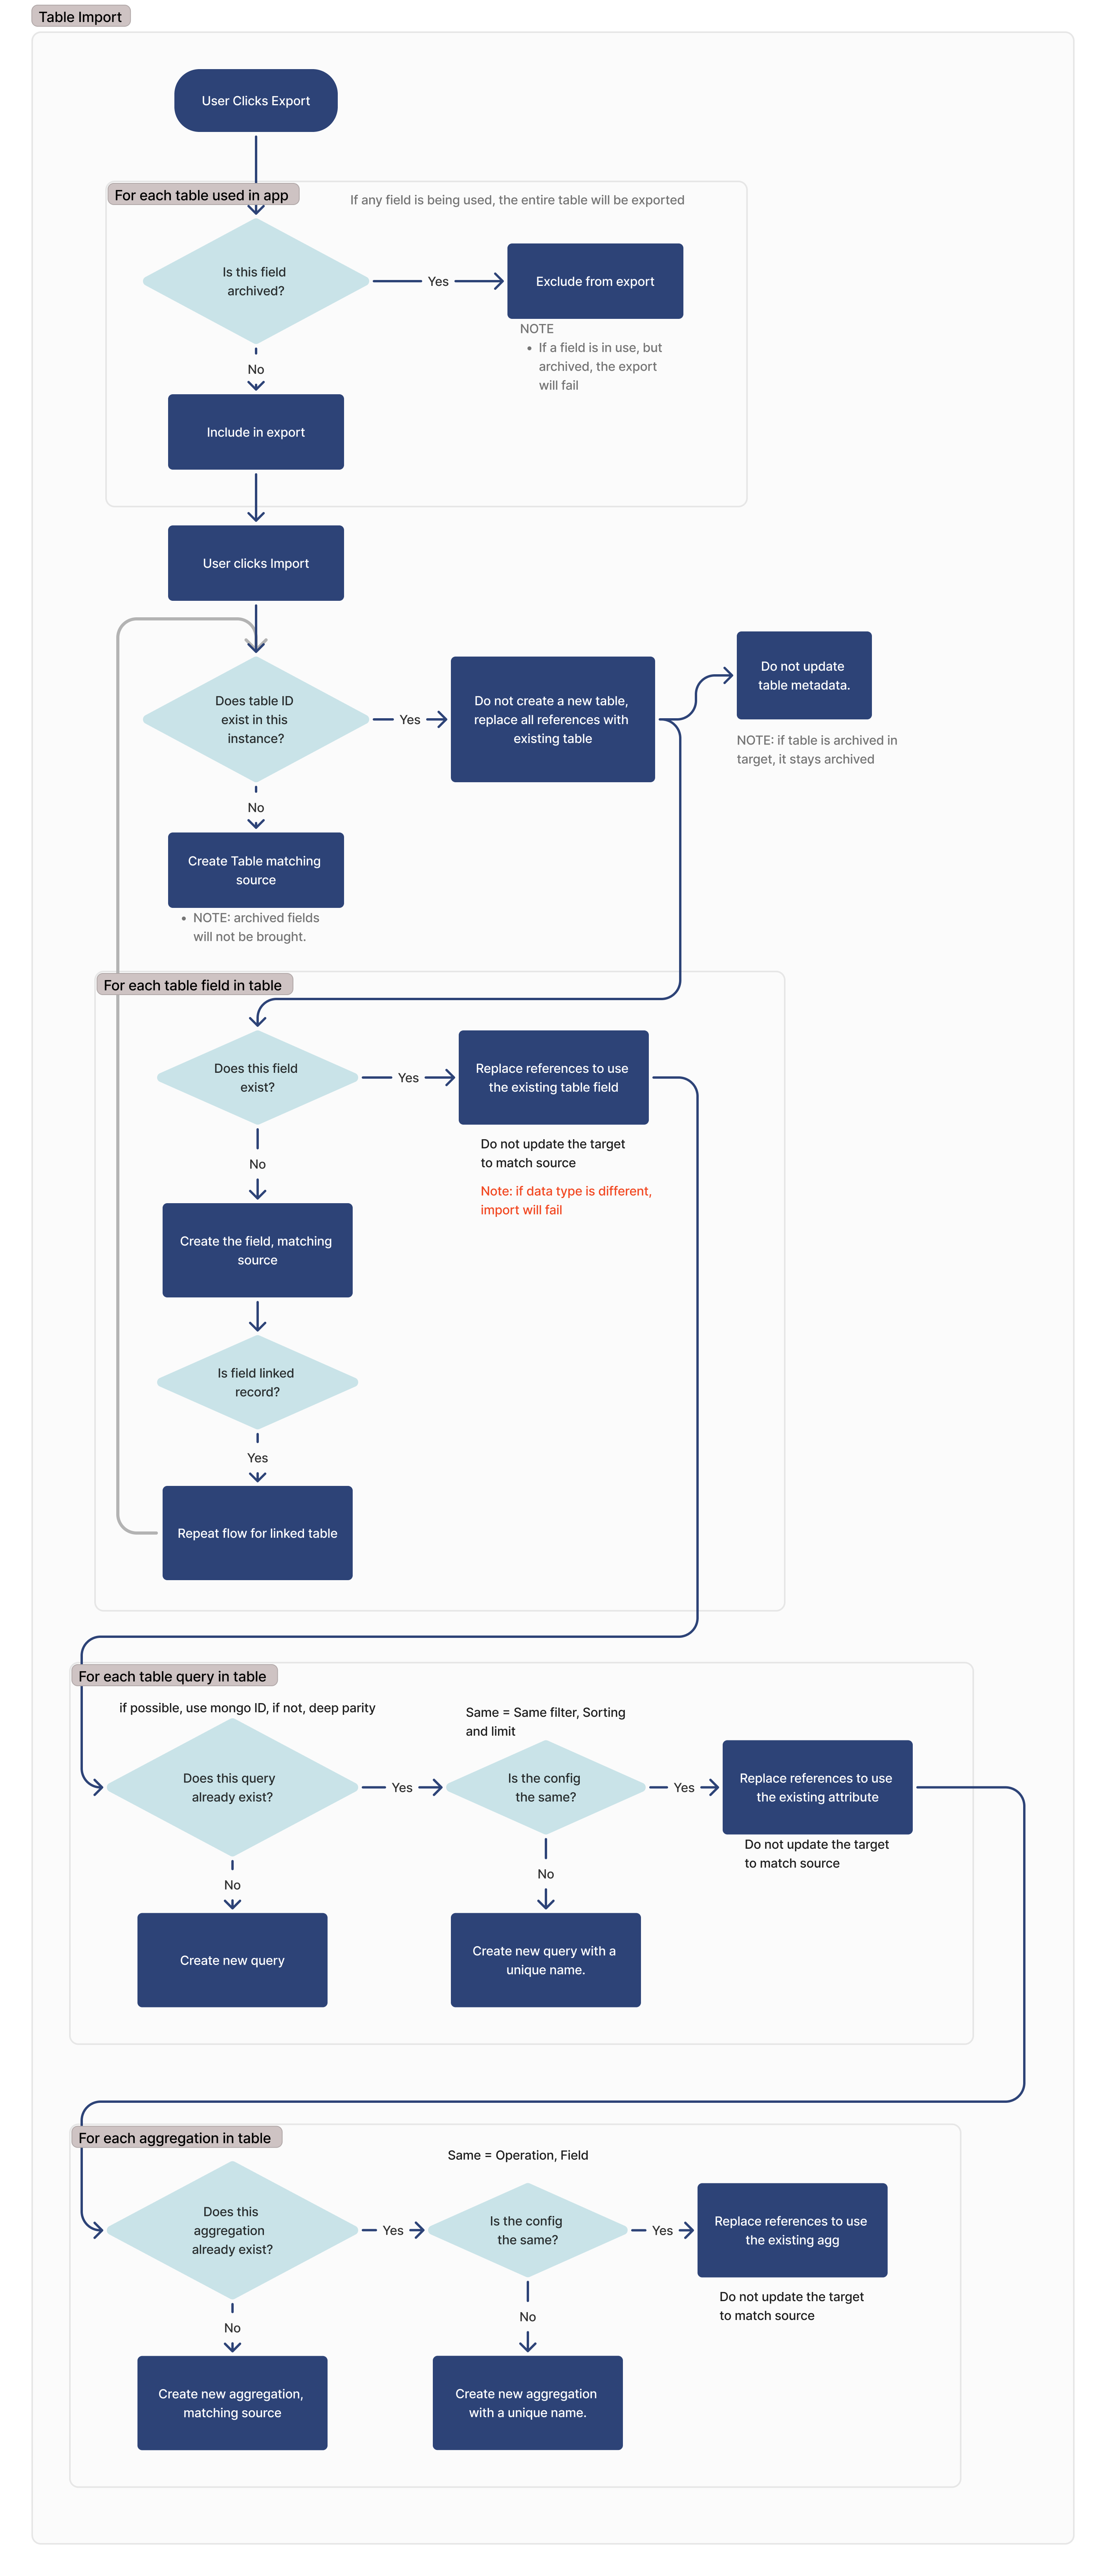
Diagrama de importación y exportación
A continuación se muestra el flujo de transferencia completo para las tablas, consultas y agregaciones de Tulip. Este documento ofrece una explicación detallada de dicho flujo.
Campos de usuario personalizados y tablas de actividad de la máquina
El flujo que se describe a continuación también se aplica a la forma en que se exportan e importan las tablas de campos de usuario personalizados y las tablas de campos de actividad de la máquina.
Exportación
Durante el proceso de exportación, la aplicación o automatización exportada incluirá todas las tablas que se estén utilizando dentro de dicha aplicación. Se considera que una tabla está en uso si se cumple alguna de las siguientes condiciones:
- Aparece en un widget de «Registro de tabla»
- Se utiliza en un widget de entrada
- Aparece en una tabla interactiva
- Se utiliza en un disparador
- Se utiliza en una acción de automatización
- Utilizado en un bloque de eventos de automatización
- Utilizado en un filtro para una consulta de tabla, una tabla interactiva o un widget de análisis
- Utilizado como entrada o salida para un widget personalizado
Si un campo está archivado, no se exportará. Si un campo está archivado pero en uso, la exportación fallará.
Importación
Buscar una tabla idéntica
Para identificar tablas coincidentes durante la importación, buscamos ID coincidentes. Si se encuentra una tabla con el mismo ID, no creamos una nueva tabla y utilizamos la ya existente.
Si una tabla está archivada en el origen y no existe en el destino, se creará en el destino y se archivará.
Si la tabla de la instancia de origen está archivada, permanecerá archivada. Una tabla archivada permanece archivada; una tabla no archivada permanece sin archivar.
Para cada campo de la tabla
Para cada campo de la tabla, buscamos un campo coincidente basándonos en el ID de columna de ese campo respectivo.
Si el tipo de datos del campo coincidente es diferente, la importación fallará.
Si el campo es un campo de registro vinculado, la tabla vinculada se añadirá a la lista de dependencias de la importación, y este proceso se repetirá para esa tabla.
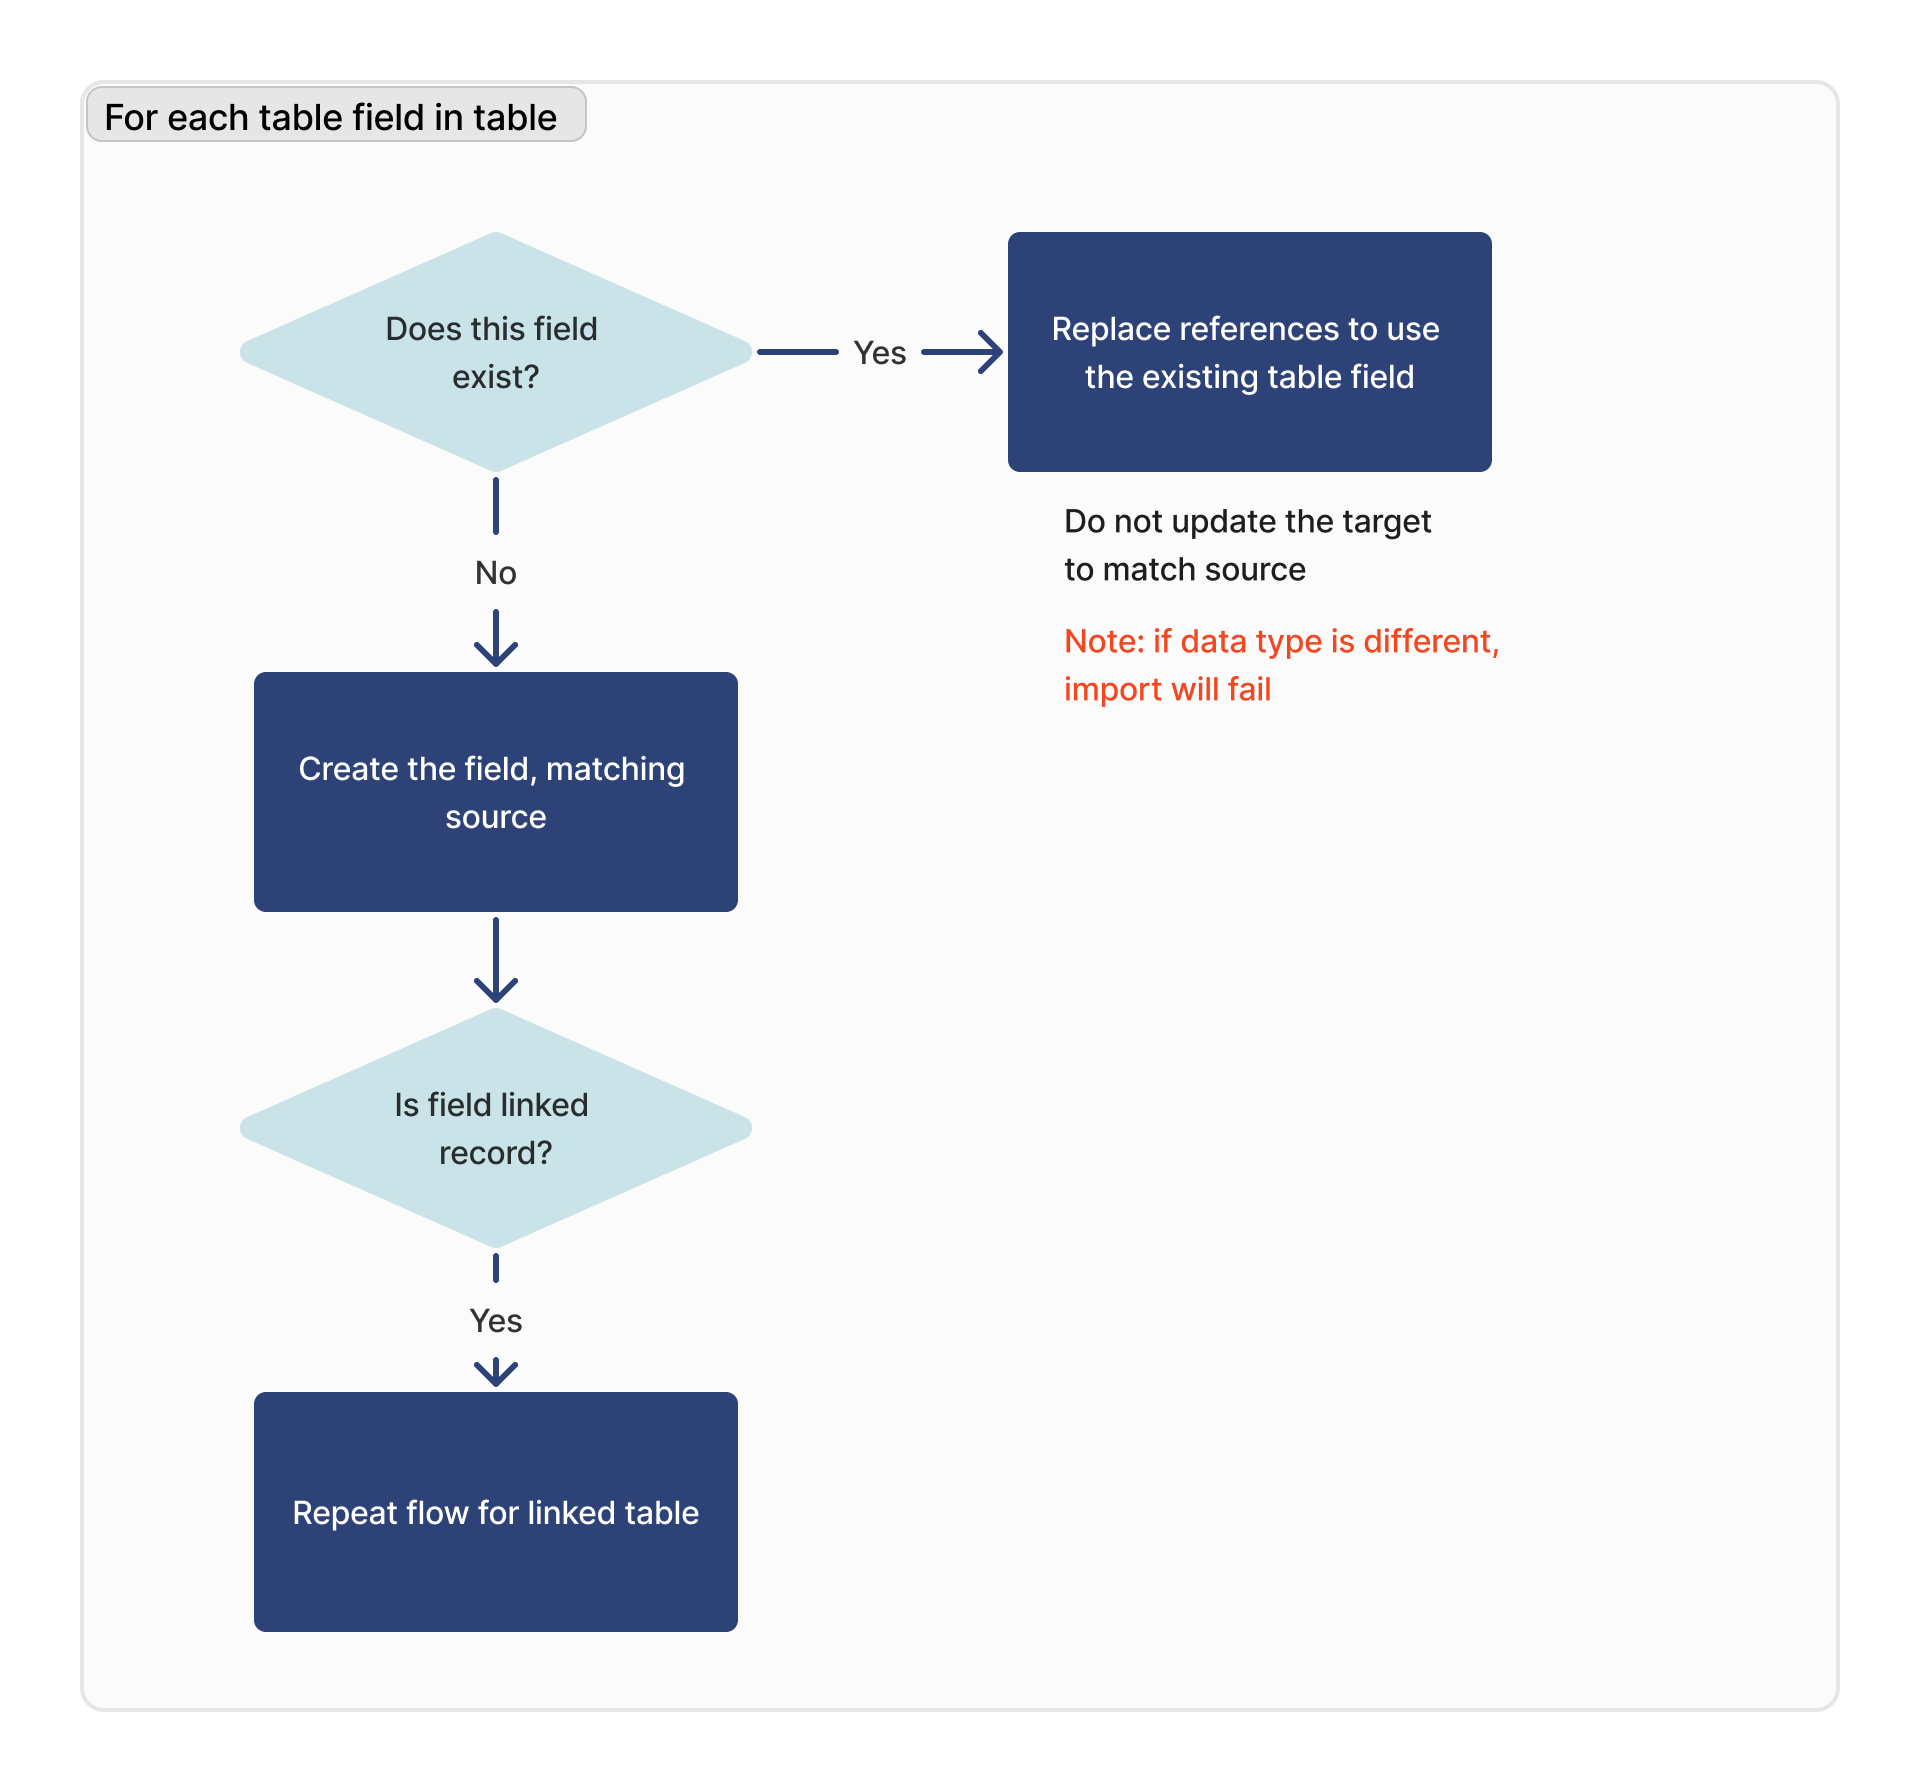
Si un campo está archivado en el origen y no existe en el destino, se crea en el destino como no archivado (nota: esto difiere del comportamiento de las tablas).
Si un campo ya existe en el destino, su estado de archivo nunca se actualiza mediante la importación. Un campo archivado permanece archivado; un campo no archivado permanece sin archivar.
When exporting a table directly, archived fields are not included. However, if an archived field is referenced by an app, it will be included in the export (with the above import rules applying).
Para cada consulta
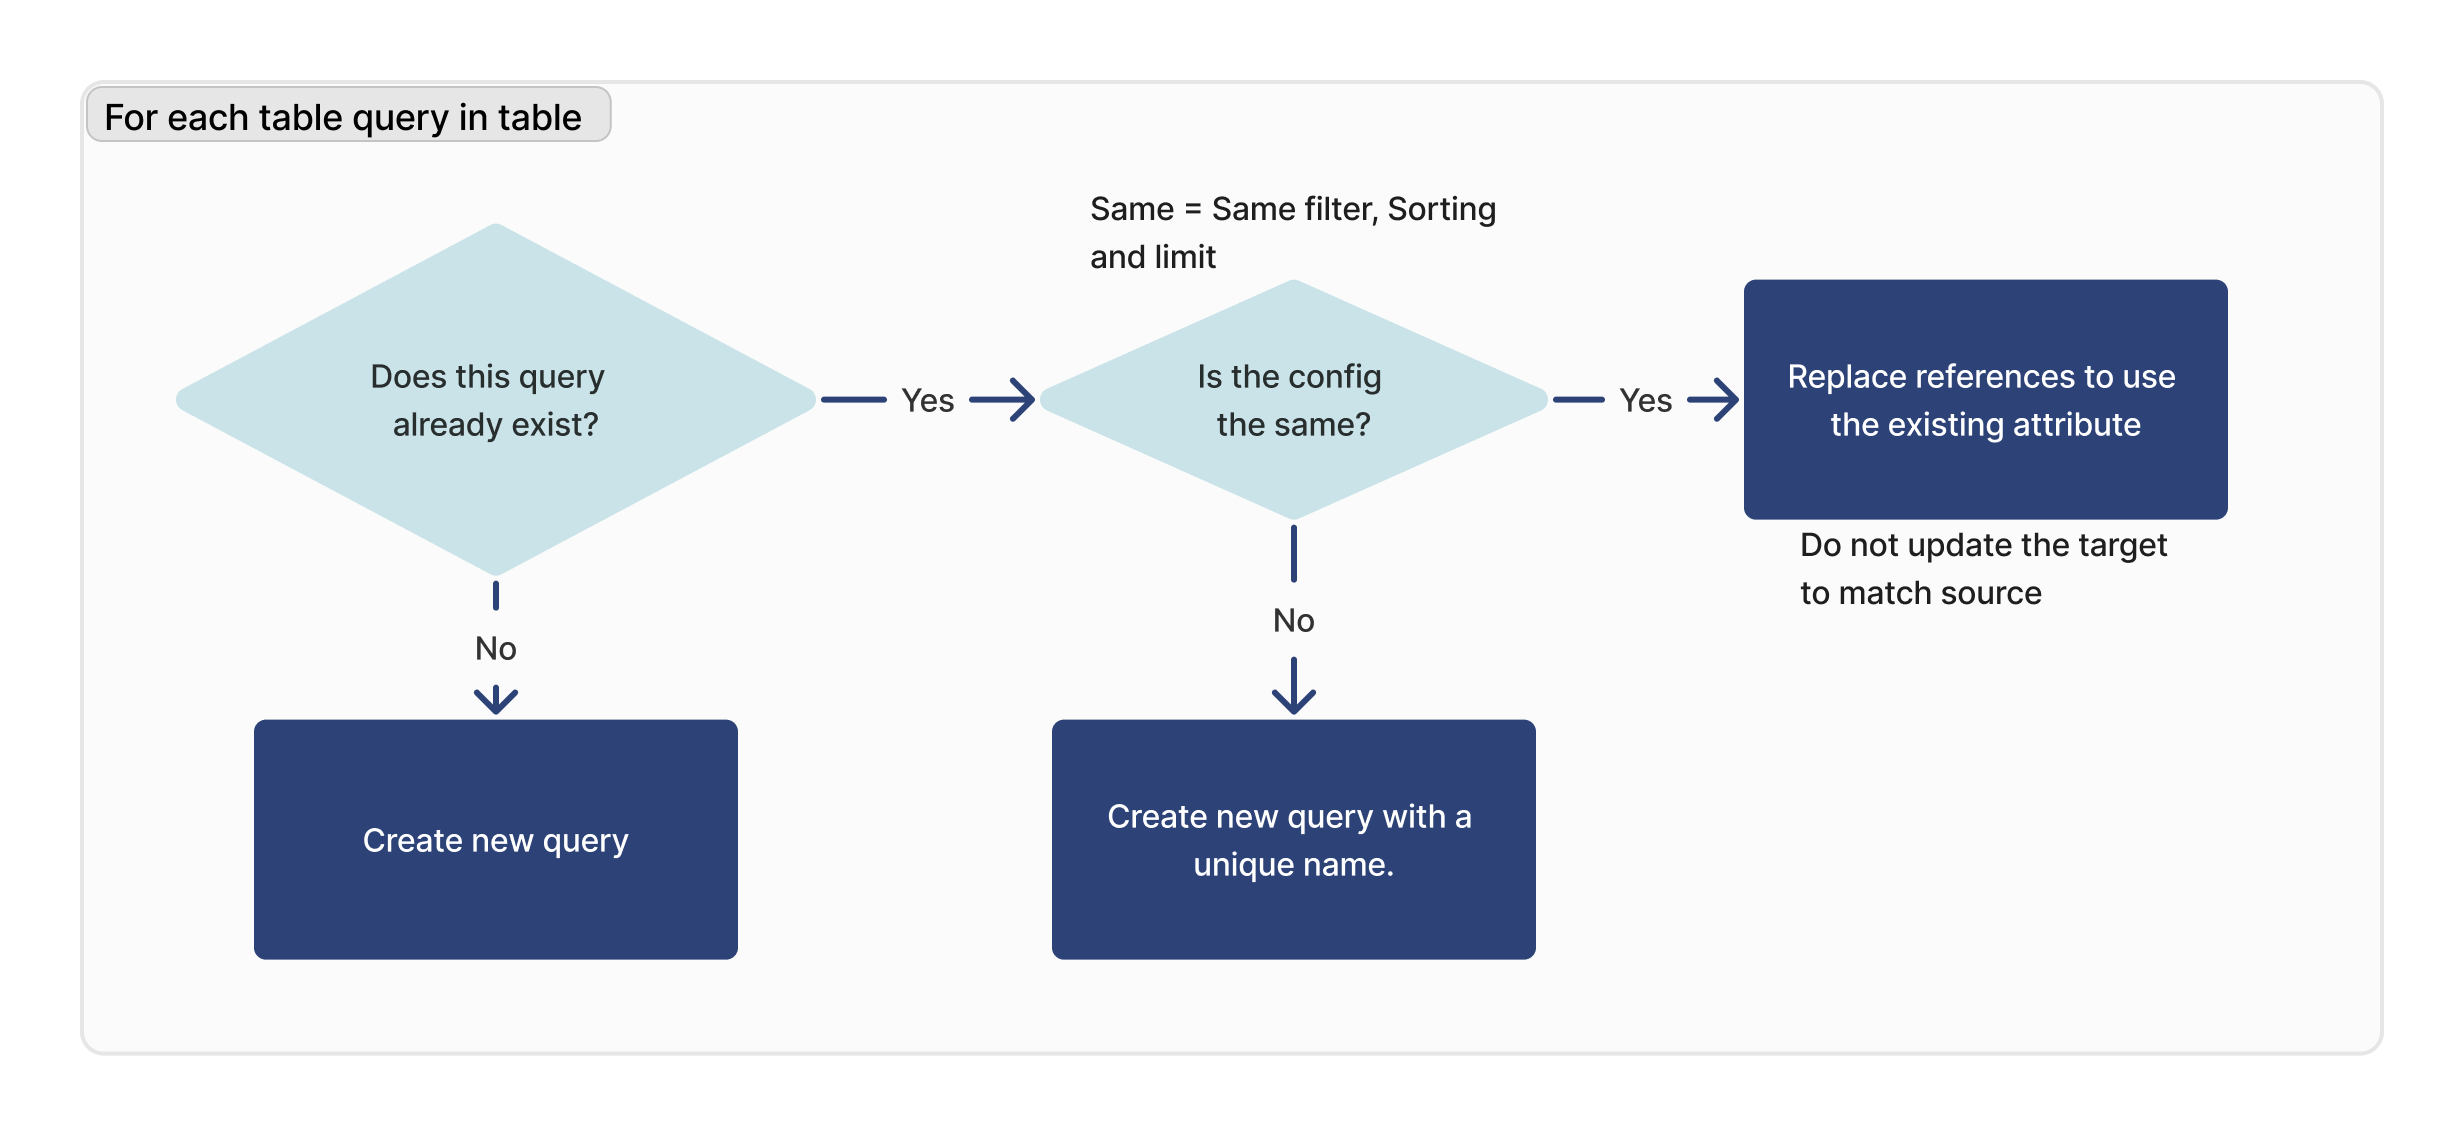
Para cada consulta de la tabla importada, comprobamos si dicha consulta existe. Si se encuentra un ID coincidente, verificamos que la configuración sea idéntica (límite, ordenación y filtrado) entre el destino y la fuente.
Si no se encuentra una consulta coincidente, se creará una nueva consulta. Si se encuentra una consulta coincidente, pero no es idéntica a la de la instancia de destino, se creará una nueva consulta con un nuevo nombre.
Nota: Esto no se aplica a los campos de usuario personalizados ni a las tablas de actividad de la máquina.
:::(Información) (Comportamiento de importación/exportación actualizado a partir de la versión r347/LTS15)
Las actualizaciones en el comportamiento de importación/exportación reducen los duplicados. Las consultas de tabla ahora se importan como « development version ». La consulta de tabla solo se importará como instantánea si ya existe la misma consulta y tiene una configuración diferente.
El comportamiento anterior (que sigue existiendo en las instancias r329/LTS14 y anteriores) importaba las instantáneas como «snapshots» y las « development versions » como « development versions ».
:::
Para cada agregación
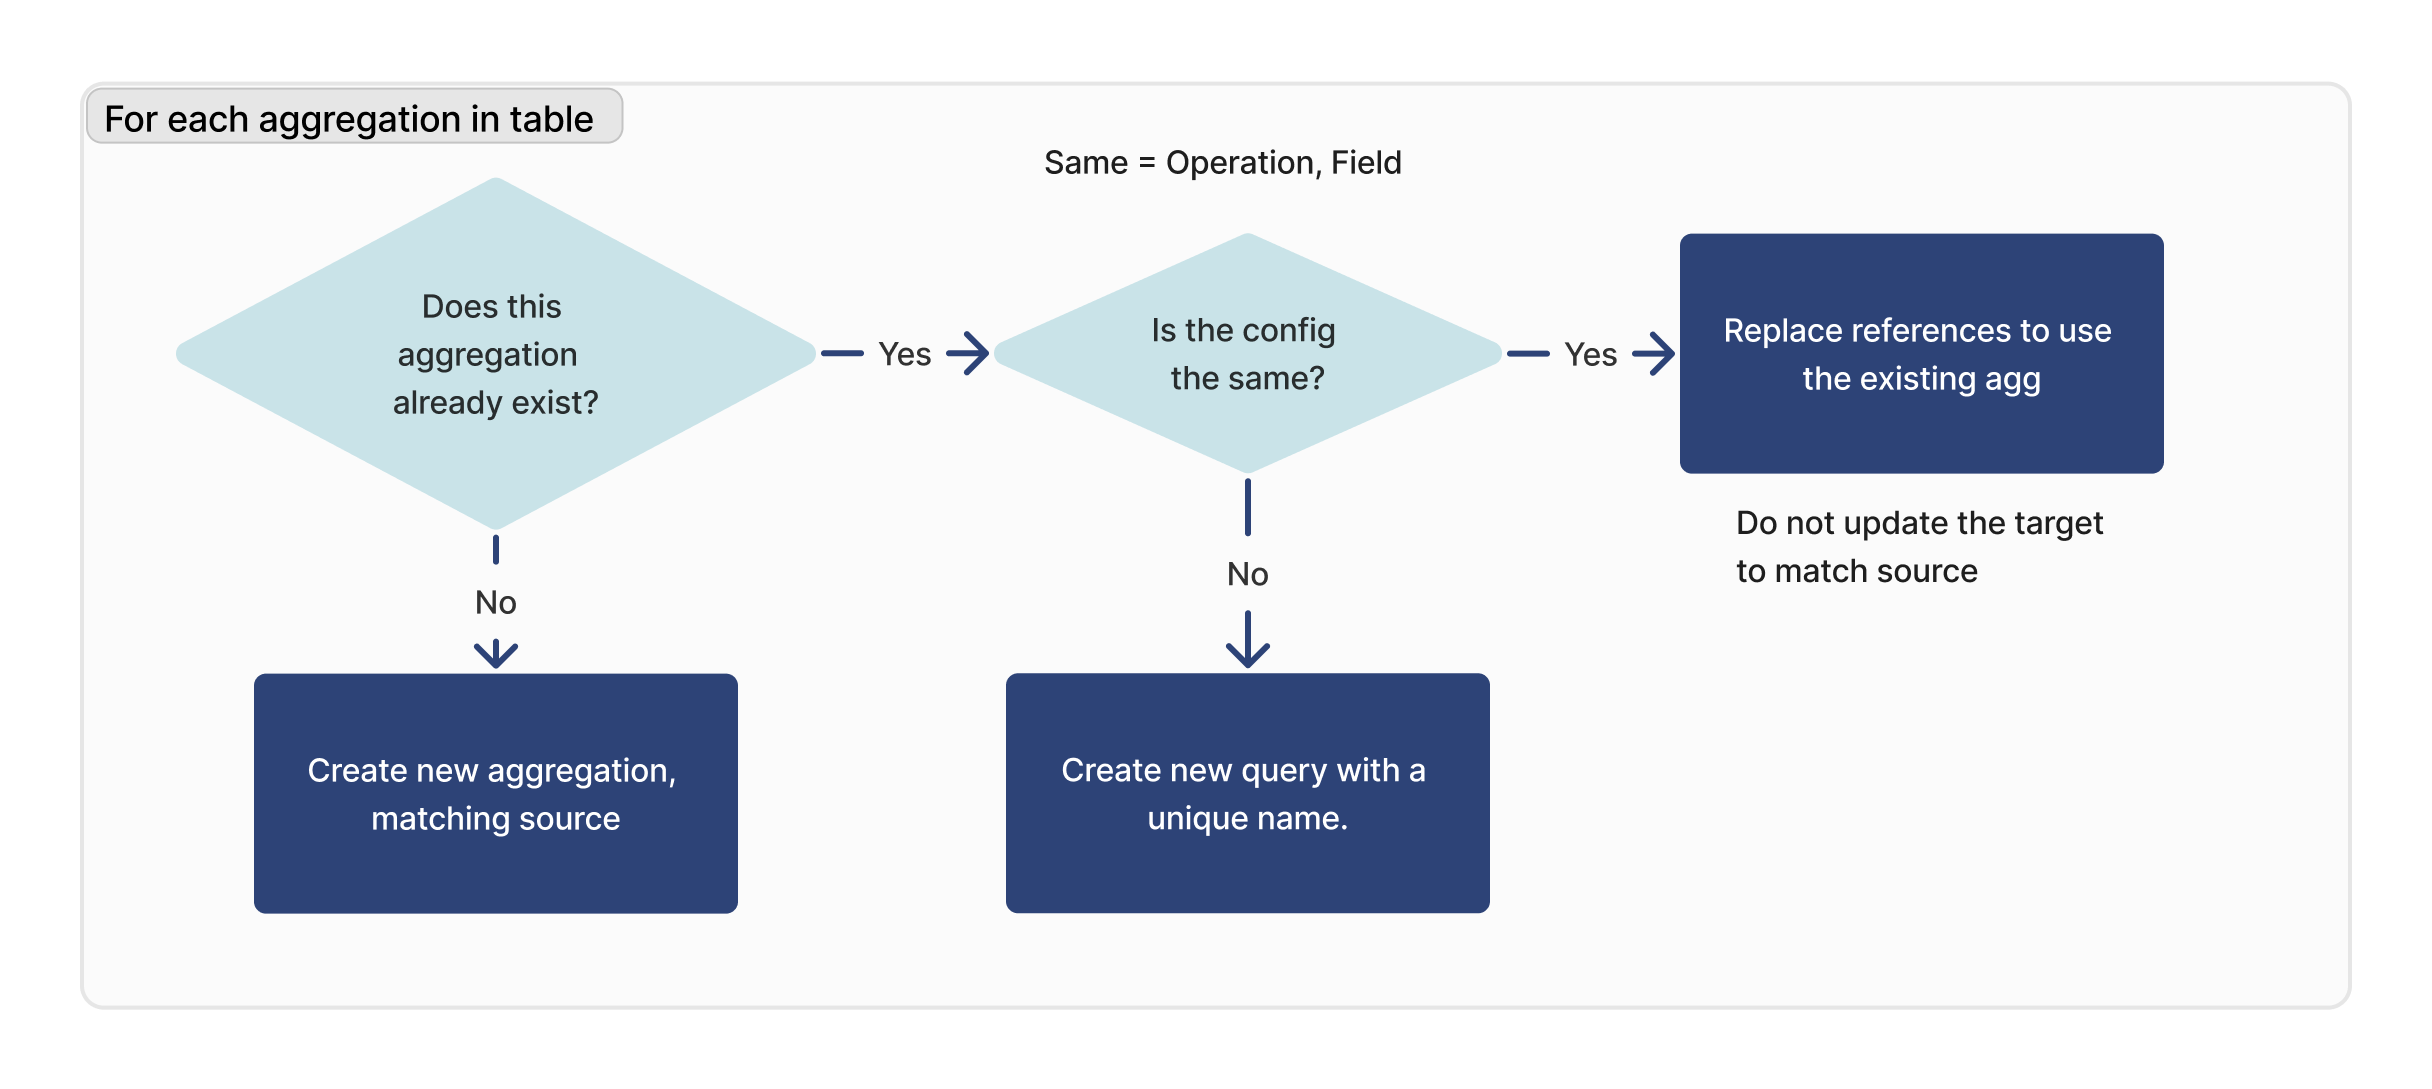
Para cada agregación de la tabla importada, comprobamos si existe esa consulta. Si se encuentra un ID coincidente, verificamos que la configuración sea idéntica (operación, campo) entre el destino y el origen.
Si no se encuentra una agregación coincidente, se creará una nueva agregación. Si se encuentra una agregación coincidente, pero no es idéntica a la de la instancia de destino, se creará una nueva agregación con un nuevo nombre.
Nota: Esto no se aplica a los campos de usuario personalizados ni a las tablas de actividad de la máquina.
:::(Información) (Comportamiento de importación/exportación actualizado a partir de la versión r347/LTS15)
Las actualizaciones en el comportamiento de importación/exportación reducen los duplicados. Las agregaciones de tablas ahora se importan como development version. La agregación de la tabla solo se importará como instantánea si ya existe la misma agregación y tiene una configuración diferente.
El comportamiento anterior (que aún existe en las instancias r329/LTS14 y anteriores) importaba las instantáneas como «snapshots» y las « development versions » como « development versions ».
:::
{{snippet.¿Has encontrado lo que buscabas?}}