
W tym przewodniku dowiesz się:
- Dwa różne sposoby przechowywania danych w Tulip
- Kiedy stosować różne metody przechowywania danych
- Jak ważne jest wdrożenie modelu danych
Podczas pracy z danymi kluczowe znaczenie ma utrzymanie porządku, aby uniknąć bałaganu i scentralizować informacje. Dzięki Tulip przechowywanie danych i zarządzanie nimi jest łatwe dzięki wielu opcjom dostosowanym do Twoich potrzeb.
W jaki sposób Tulip rejestruje Twoje operacje?
W Tulip dane występują na wielu poziomach.
Aplikacje przechowują dane statyczne, takie jak instrukcje tekstowe dotyczące poszczególnych kroków.
Tabele to bazy danych tworzone przez Tulip, przypominające arkusz kalkulacyjny z zleceniami pracy, z których można korzystać w wielu aplikacjach.
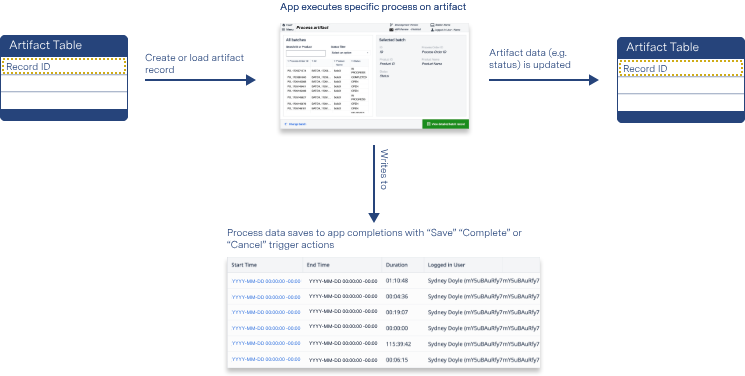
Zakończenia przechowują metadane produkcyjne, takie jak czas trwania aplikacji, nazwa stanowiska oraz wszelkie dane wejściowe do zmiennych.
Poniższy schemat przedstawia przepływ danych w zakładzie produkcyjnym.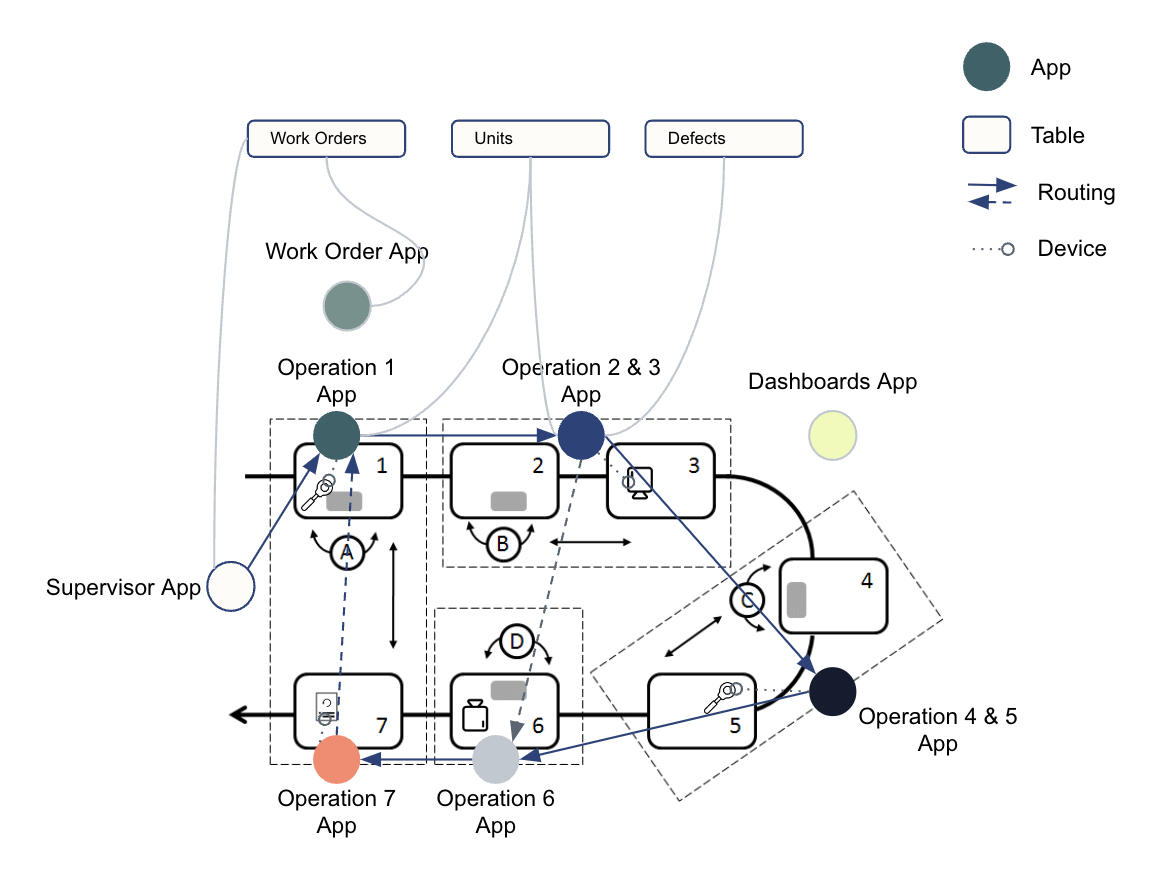
Opcje przechowywania danych
W systemie Tulip dostępne są dwie opcje przechowywania danych: tabele i „Completions”.
Tabele
Tabele stanowią połączenie arkuszy kalkulacyjnych i relacyjnych baz danych, które można dostosować do dowolnego sposobu prezentacji danych. Są to udostępniane źródła danych, z których może korzystać wiele aplikacji.
Tworząc tabelę, definiujesz Field, które przechowują i organizują dane w postaci rekordów. Pola pełnią rolę kolumn, rekordy to wiersze zawierające konkretne dane, a każdy pojedynczy element danych to pole rekordu tabeli.
Tabele można osadzać w aplikacji w celu tworzenia, modyfikowania i wyświetlania rekordów związanych z zadaniami.
Możesz zaimportować istniejące dane do tabel Tulip, zgodnie z opisem tutaj.
Jeśli nie chcesz tworzyć własnej tabeli, ale nie masz też istniejących danych do zaimportowania, możesz skorzystać z jednej z wstępnie skonfigurowanych tabel Tulip, które są wbudowane w Twoją instancję. Dają one wyobrażenie o różnych polach, których można używać w tabelach, oraz o ogólnych typach danych, które można rejestrować. Dostępne opcje typów danych obejmują:
- Tekst
- Liczba całkowita
- Liczba
- Logiczny
- Data i godzina
- Przedział
- Kolor
- Obraz
- Wideo
- Plik
- Urządzenie
- Powiązany rekord
Każde z tych pól będzie odpowiadało danym wejściowym używanym w Twojej aplikacji. Aby wyświetlić rekordy w tabeli, przejdź do ekranu tabeli za pośrednictwem strony swojej instancji Tulip. Najedź kursorem na „Aplikacje” i wybierz „Tabele”.
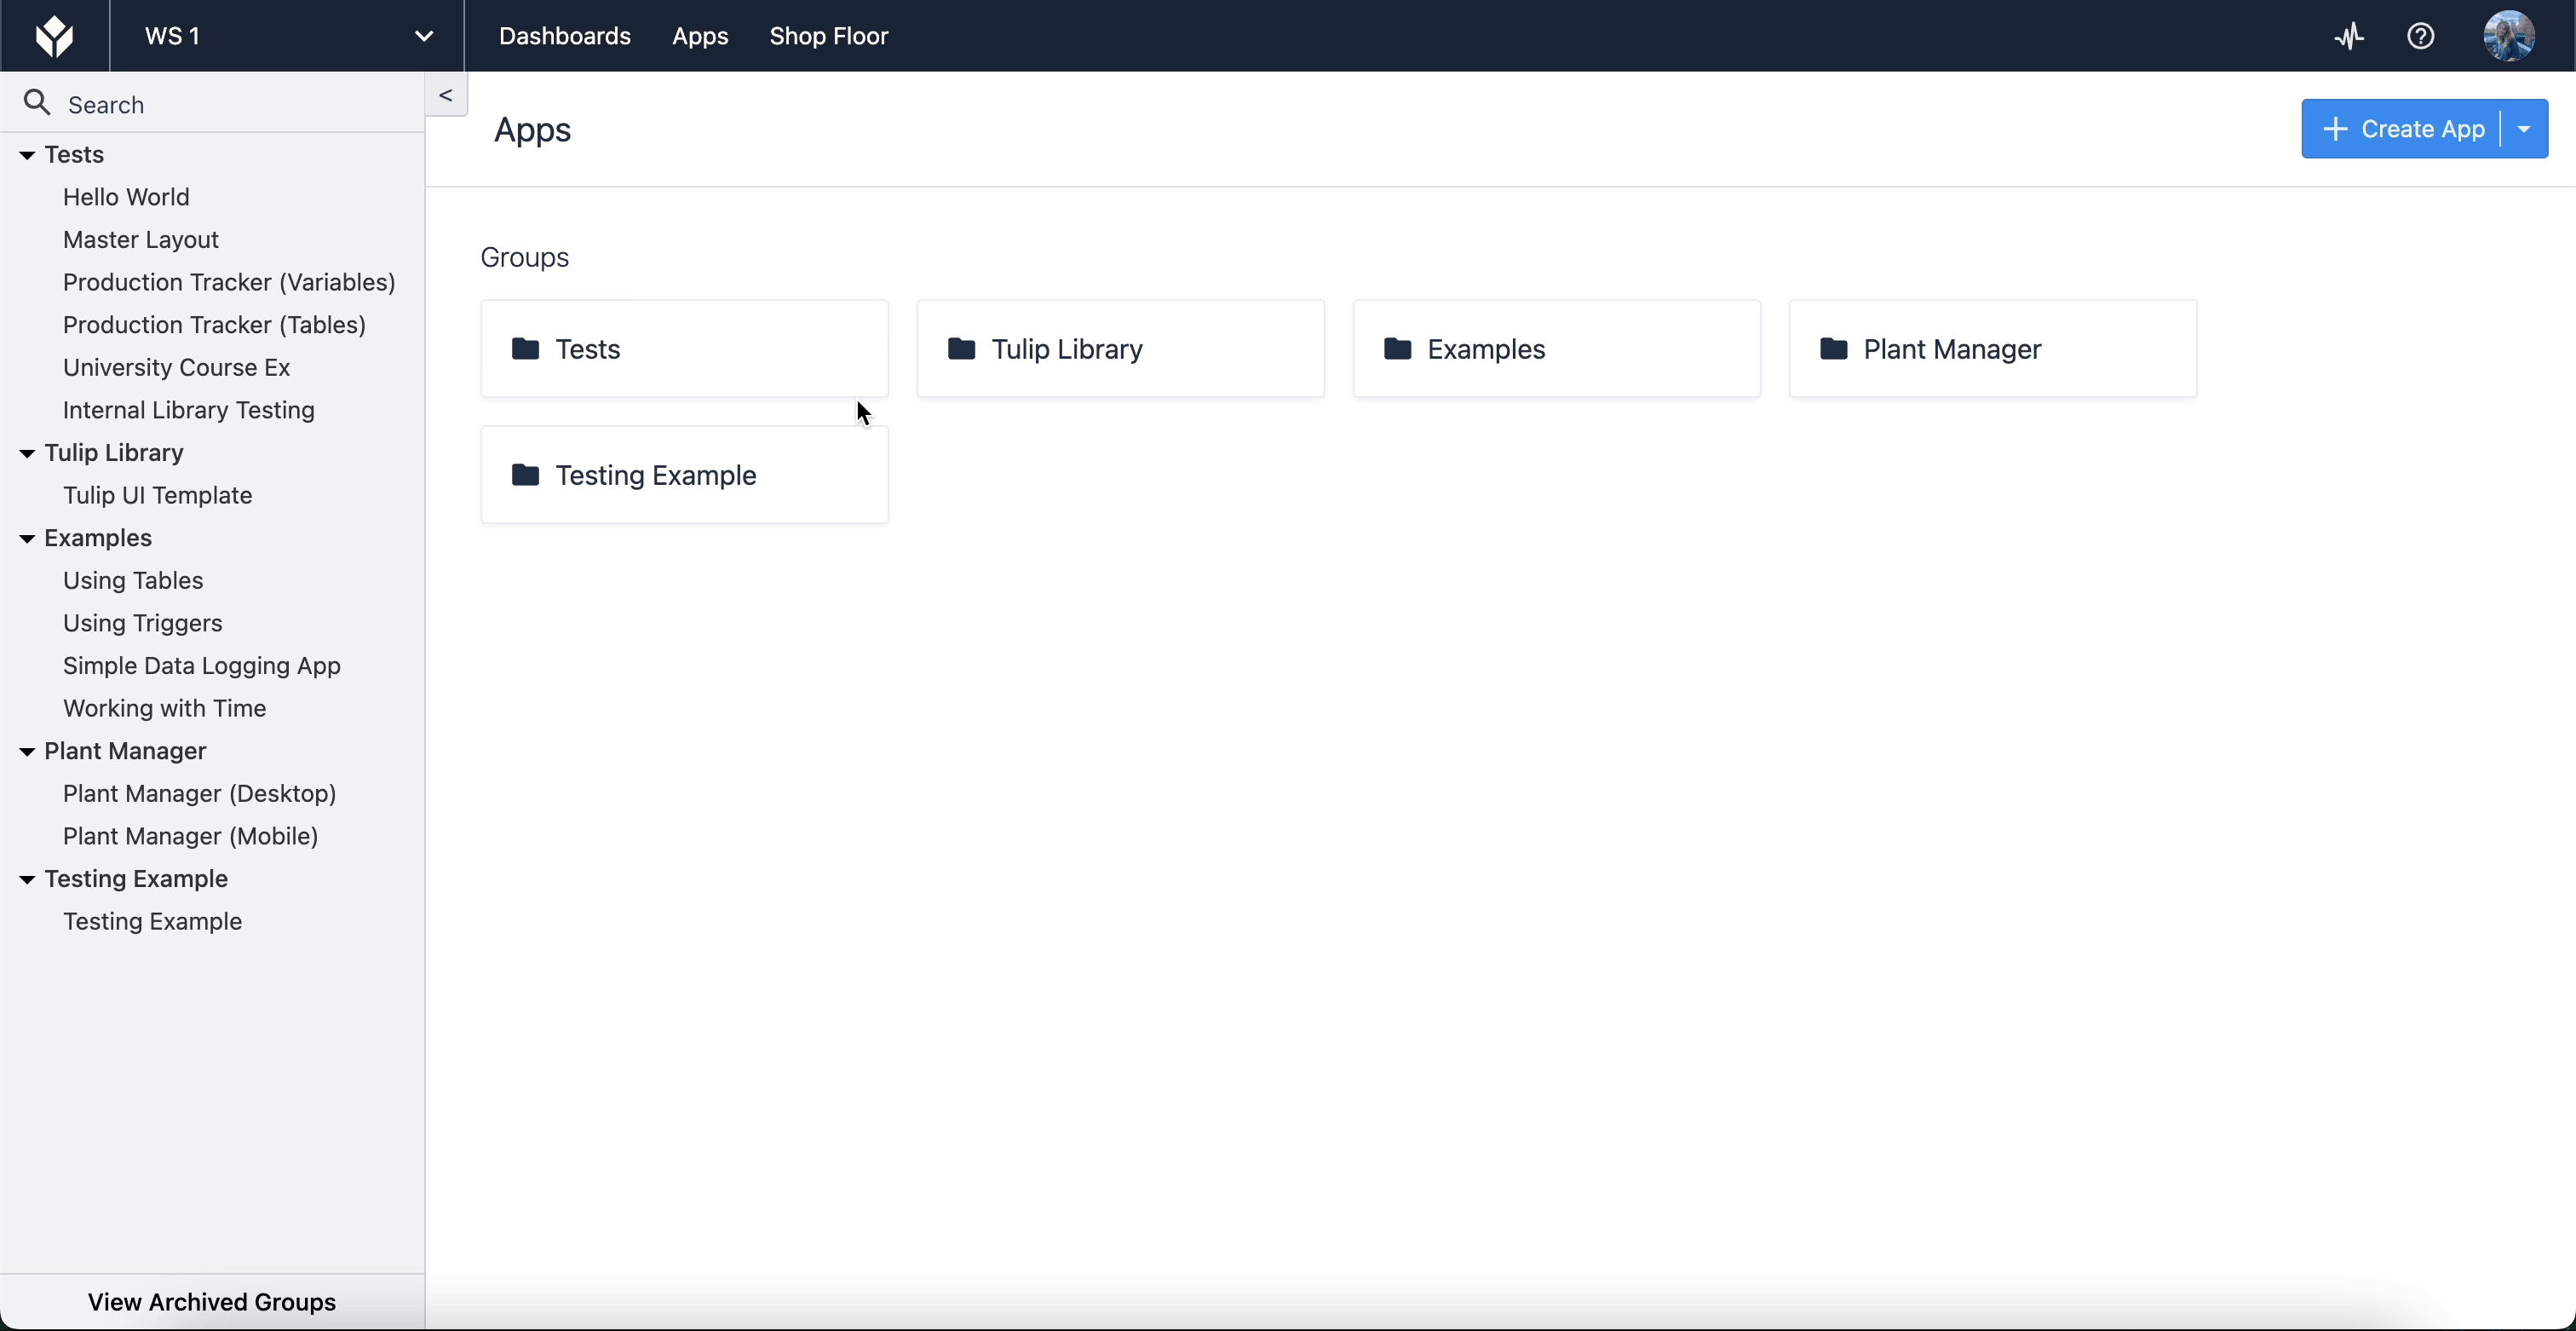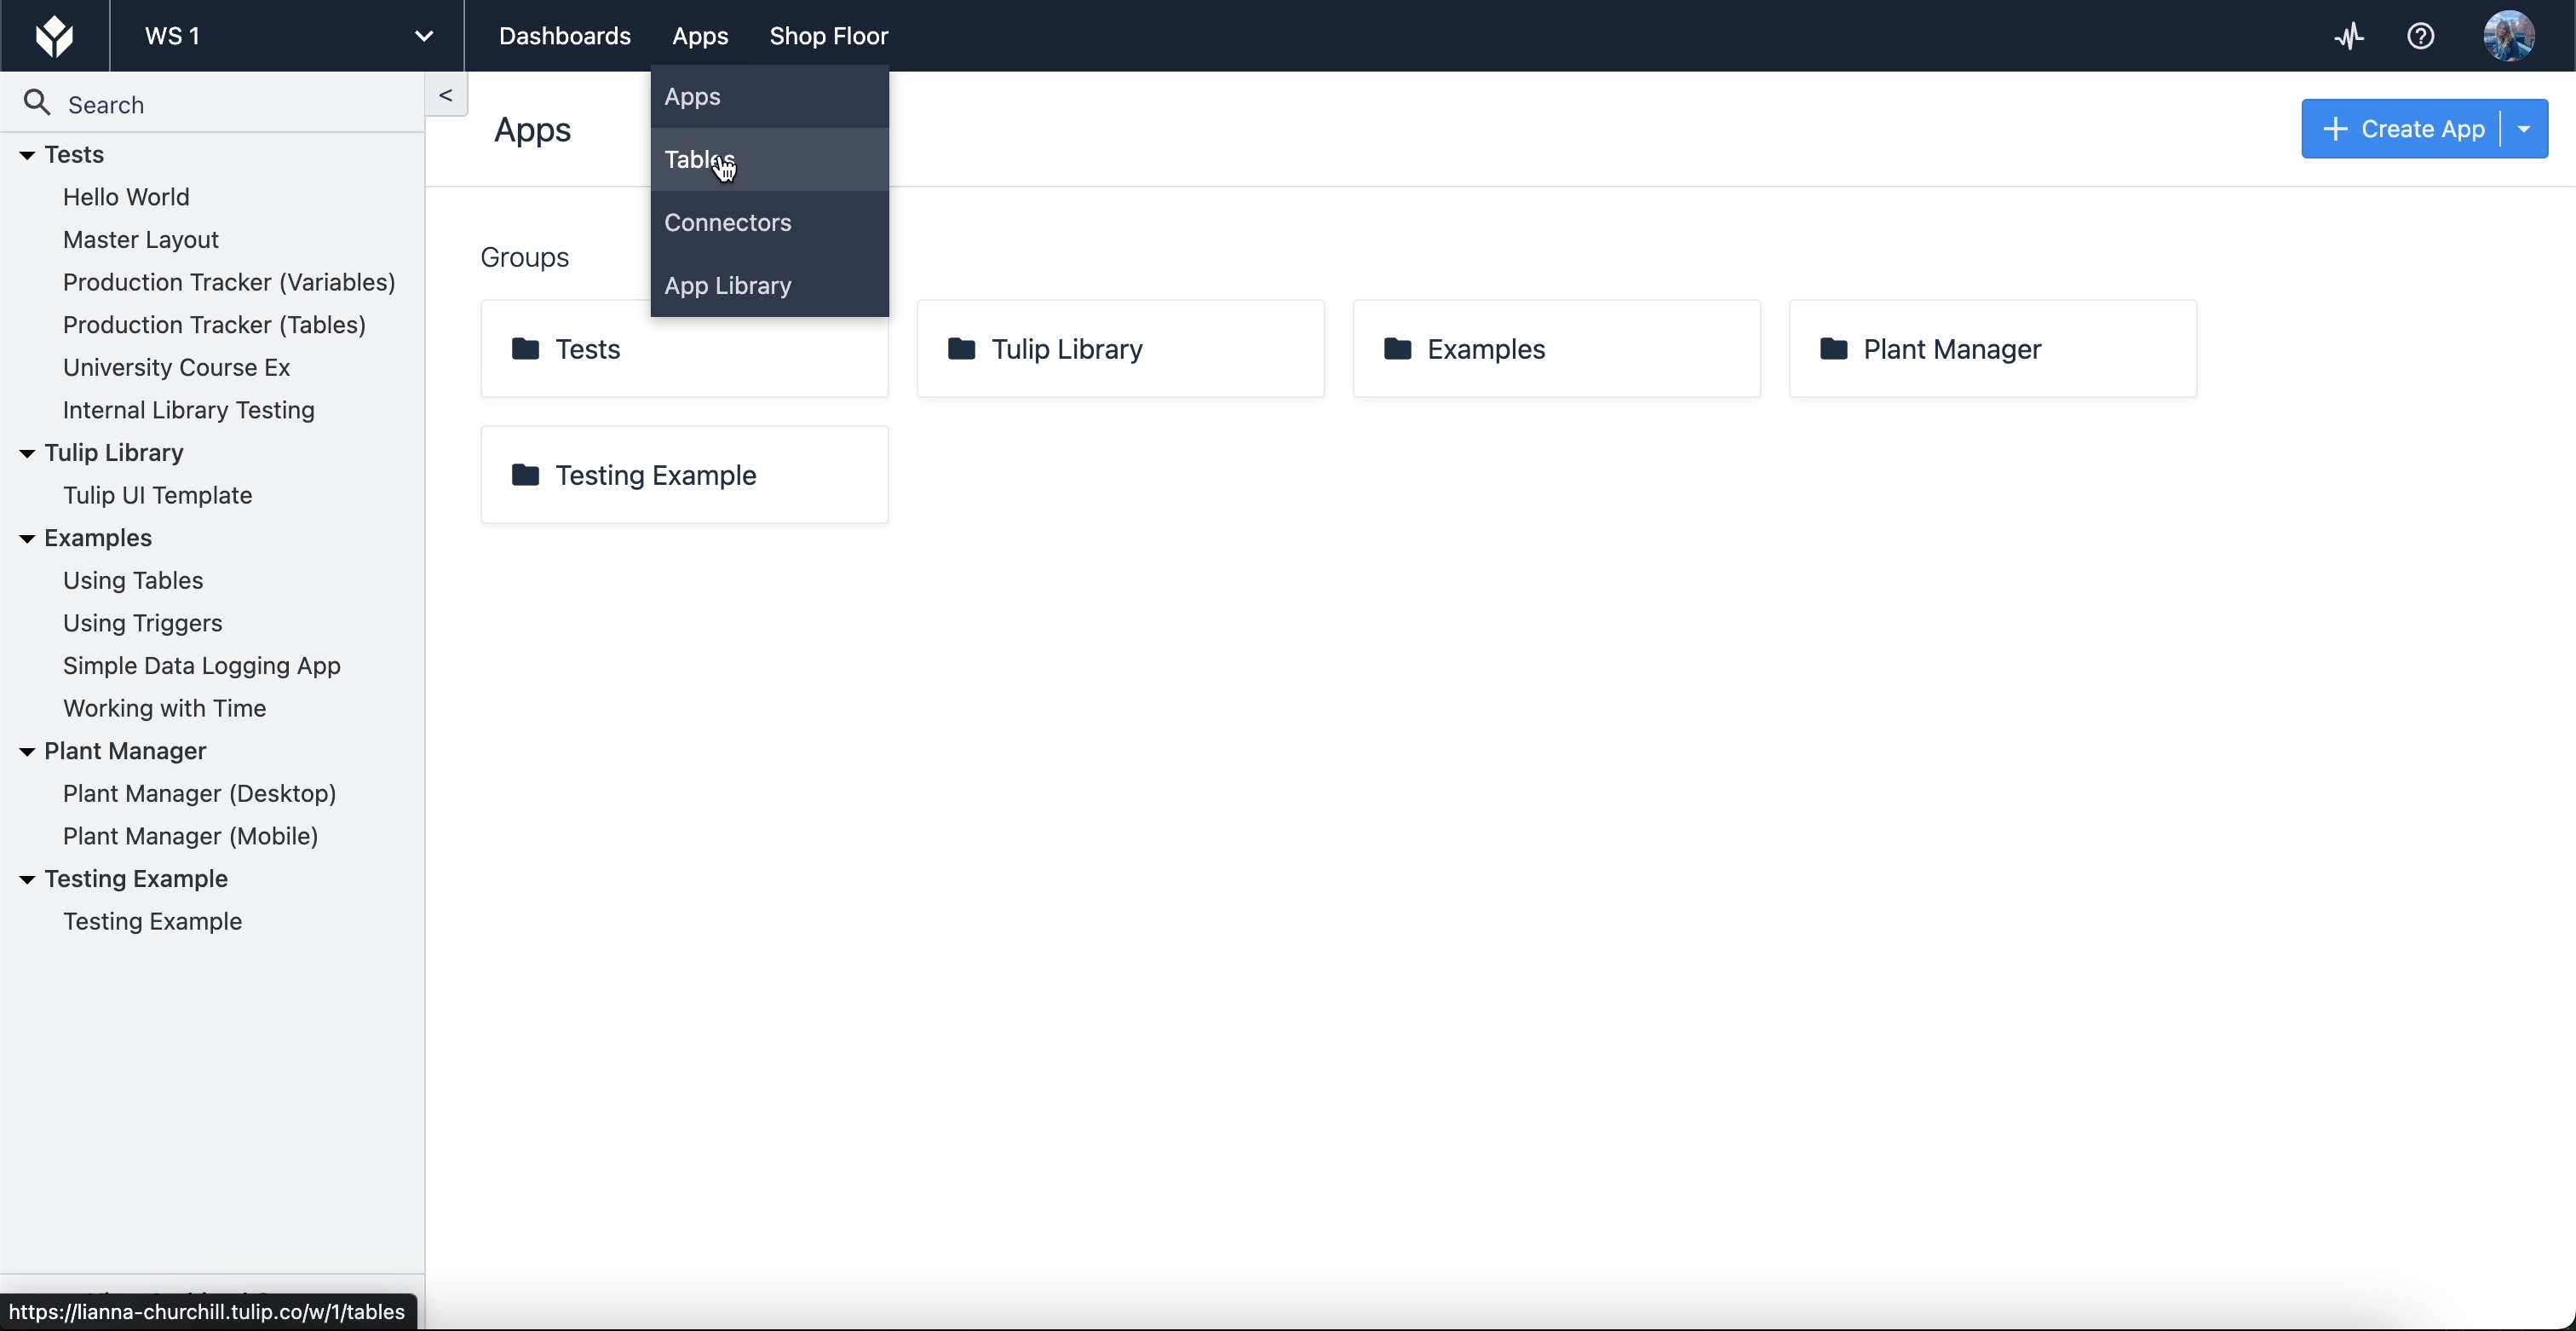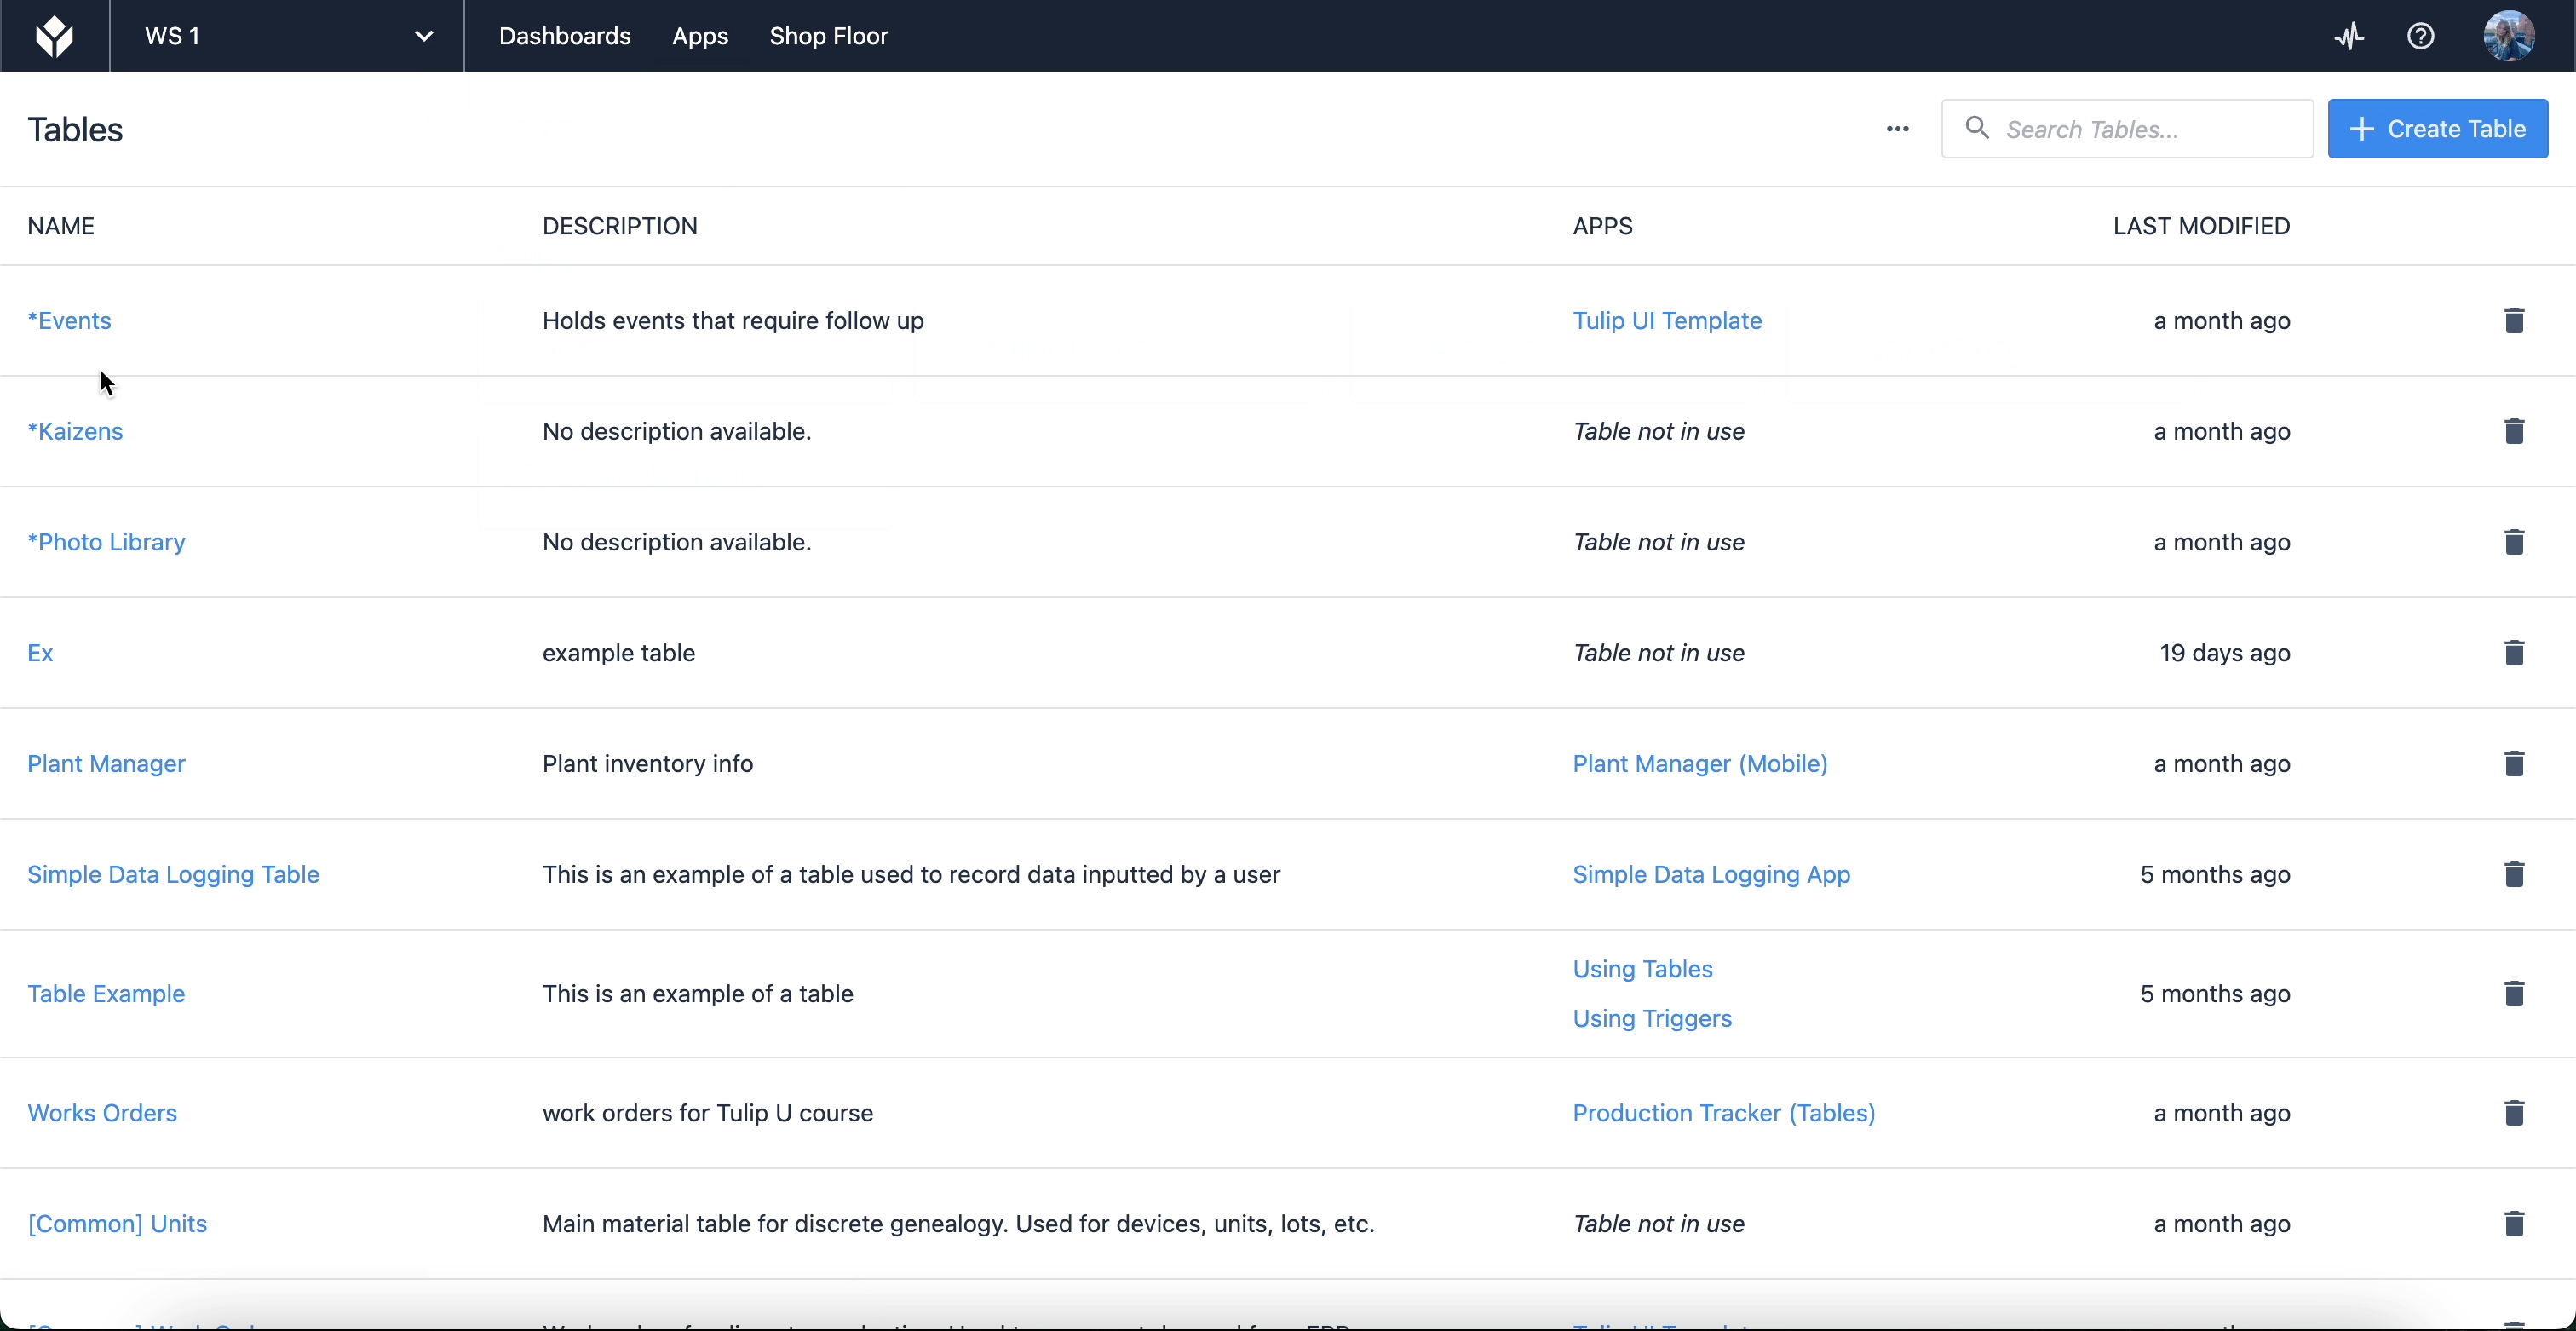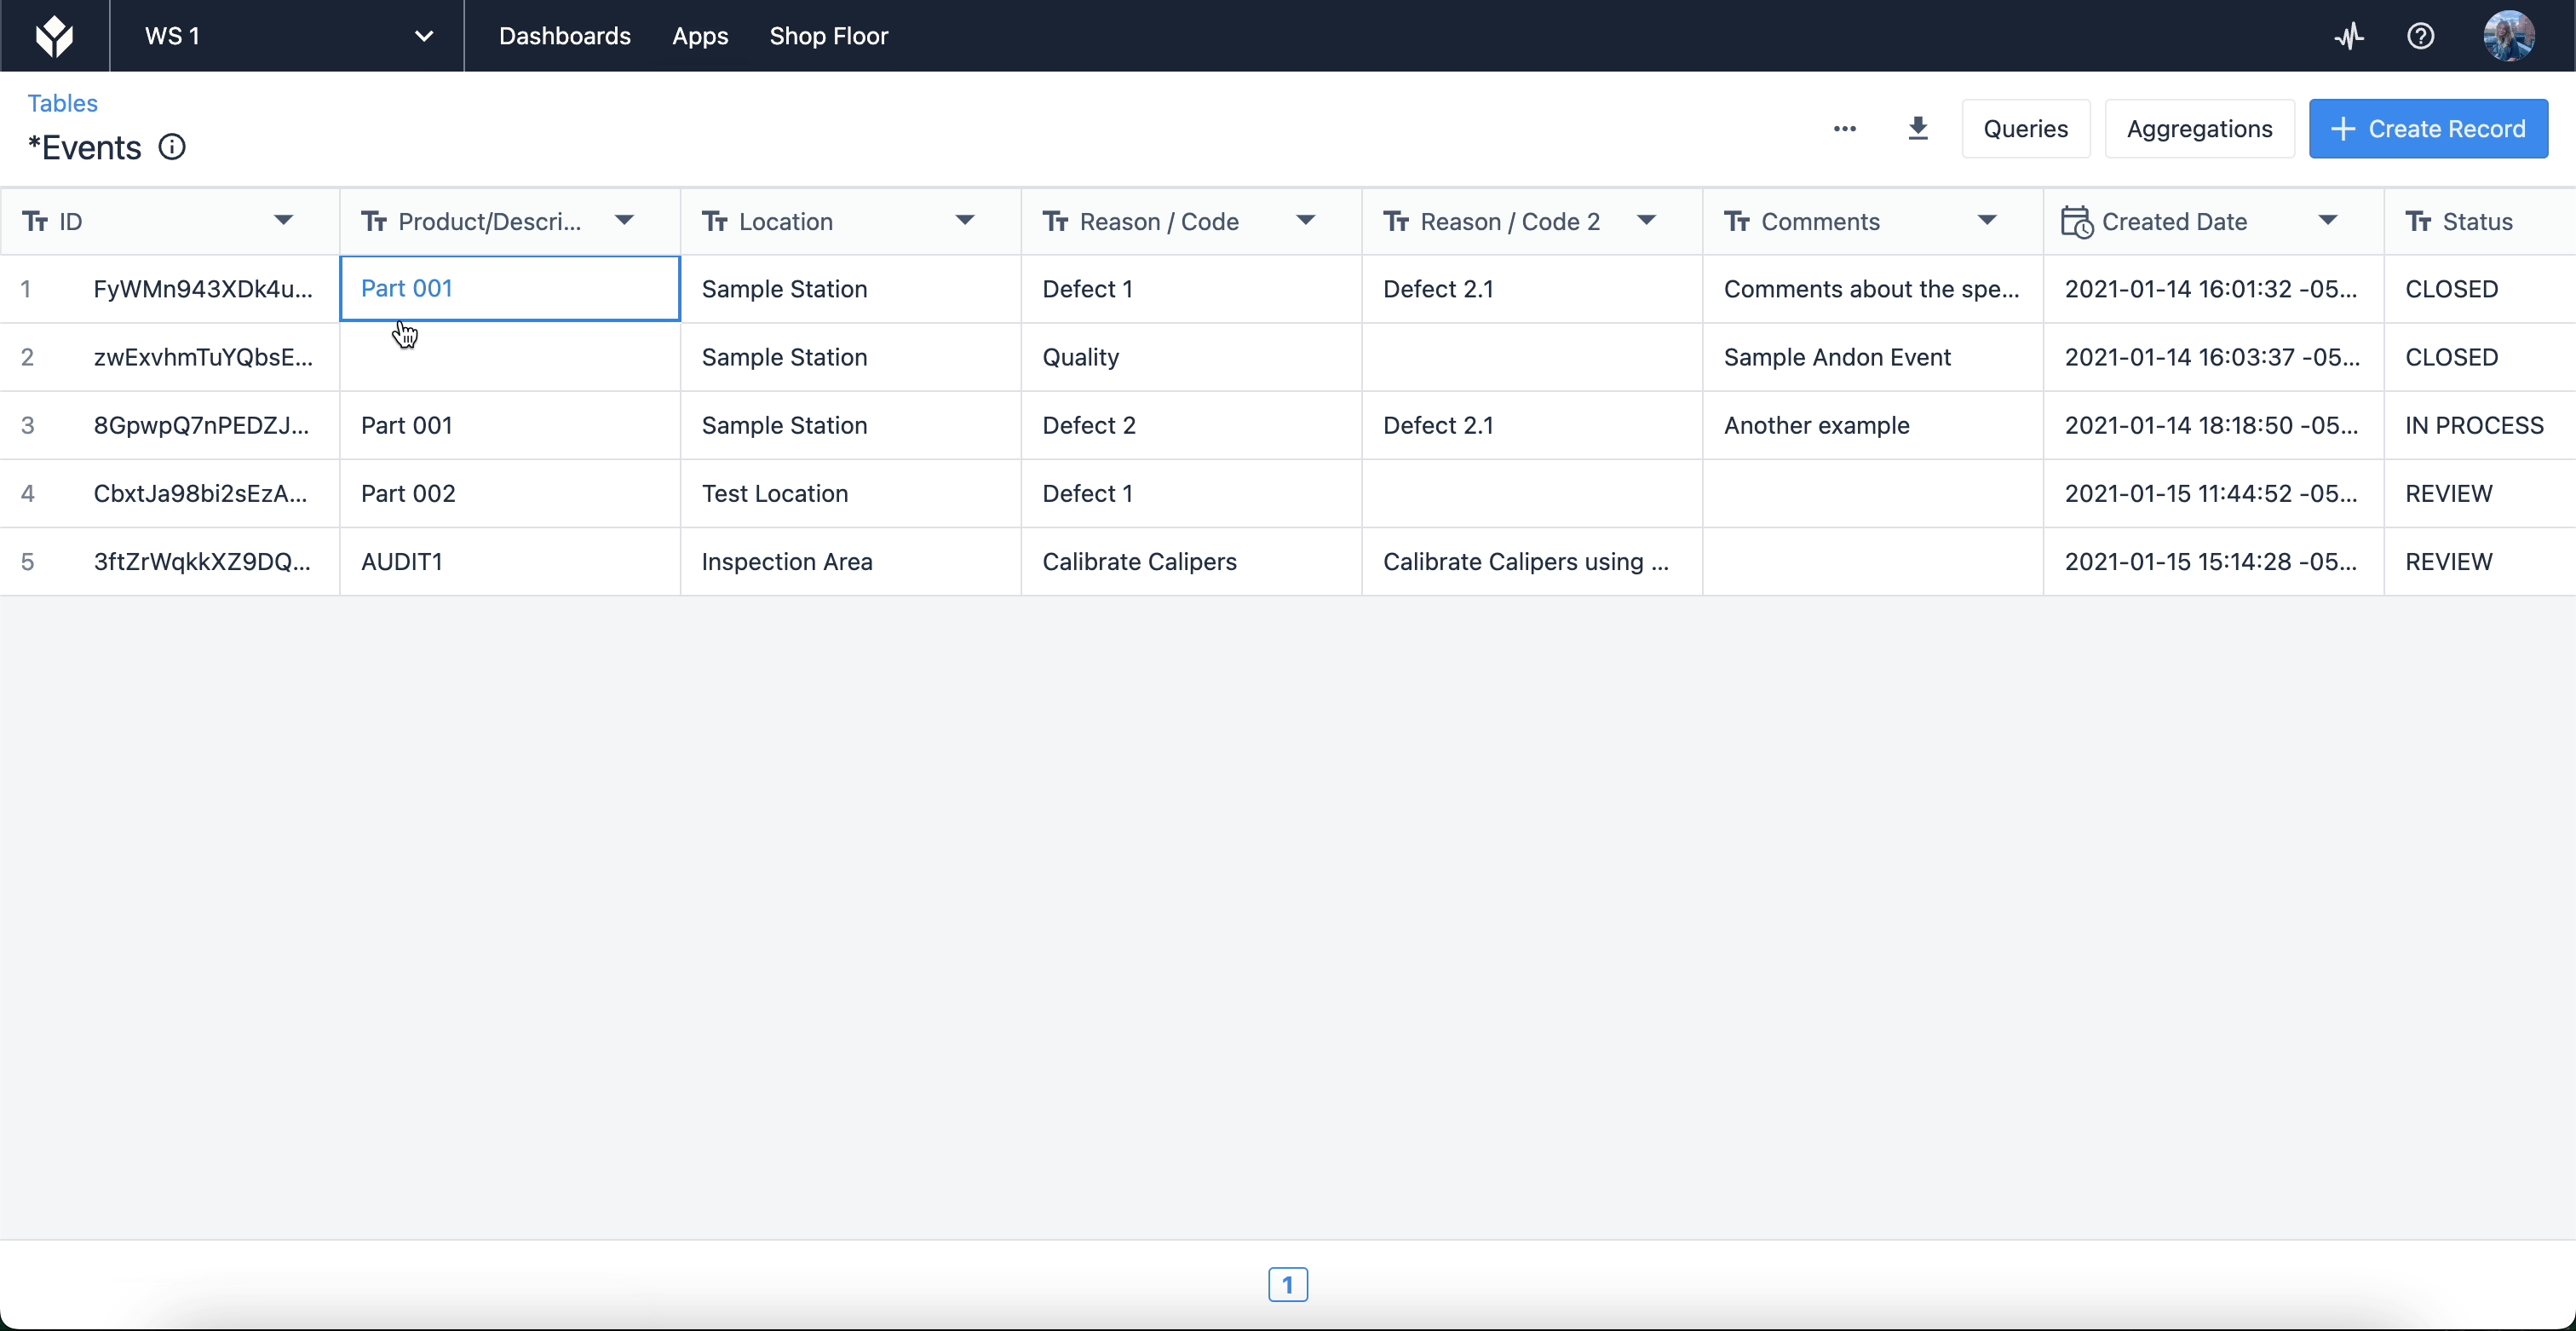
Znajdziesz tu listę tabel, które utworzyłeś lub do których masz dostęp w celu wykorzystania w swoich aplikacjach. Po wybraniu tabeli będziesz mógł edytować pola i same rekordy, a także tworzyć zapytania i agregacje, które pozwolą Ci wykorzystać dane z tabeli w aplikacjach. Tabele można również łączyć ze sobą (np. w przypadku genealogii produktów).
Zalecane zastosowanie tabel w Tulip
Tulip zaleca wykorzystywanie tabel do przechowywania, w ujęciu ogólnym, dwóch różnych rodzajów artefaktów: fizycznych i operacyjnych.
Artefakty fizyczne to namacalne obiekty lub komponenty wykorzystywane lub wytwarzane podczas operacji, takie jak partia/seria lub sprzęt.Artefakty operacyjne to elementy niefizyczne lub komponenty, które umożliwiają lub wspierają operacje, takie jak zdarzenia związane z wadami lub konfiguracja kanban.
Aby dowiedzieć się więcej na temat korzystania z tabel, zobacz:
Zakończenia
Zakończenia w aplikacji idealnie nadają się do przechowywania i porządkowania danych produkcyjnych. Pola metadanych są automatycznie generowane i zapisywane po zakończeniu lub anulowaniu aplikacji przez użytkownika. Pola te obejmują:
- Czas trwania aplikacji
- Czas rozpoczęcia i zakończenia
- Zalogowany użytkownik
- Nazwa stacji
- Komentarze
- Wersja aplikacji
- ID wykonania
- Anulowane (niezależnie od tego, czy aplikacja została anulowana)
W przeciwieństwie do danych przechowywanych w tabelach, dane przechowywane w sekcji „Zakończenia” aplikacji nie mogą być edytowane. Gwarantuje to, że informacje te są niepodważalne: nie można ich manipulować ani zmieniać, a ponadto dokładnie odzwierciedlają wykorzystanie aplikacji.
Dane dotyczące zakończeń mogą być wykorzystywane wyłącznie przez jedną aplikację i są mniej dostępne z poziomu systemów zewnętrznych.
Aby uzyskać dostęp do danych dotyczących zakończeń aplikacji, wybierz aplikację z grupy aplikacji w swojej instancji Tulip. Po przejściu do ekranu głównego aplikacji wybierz zakładkę „Zakończenia”.
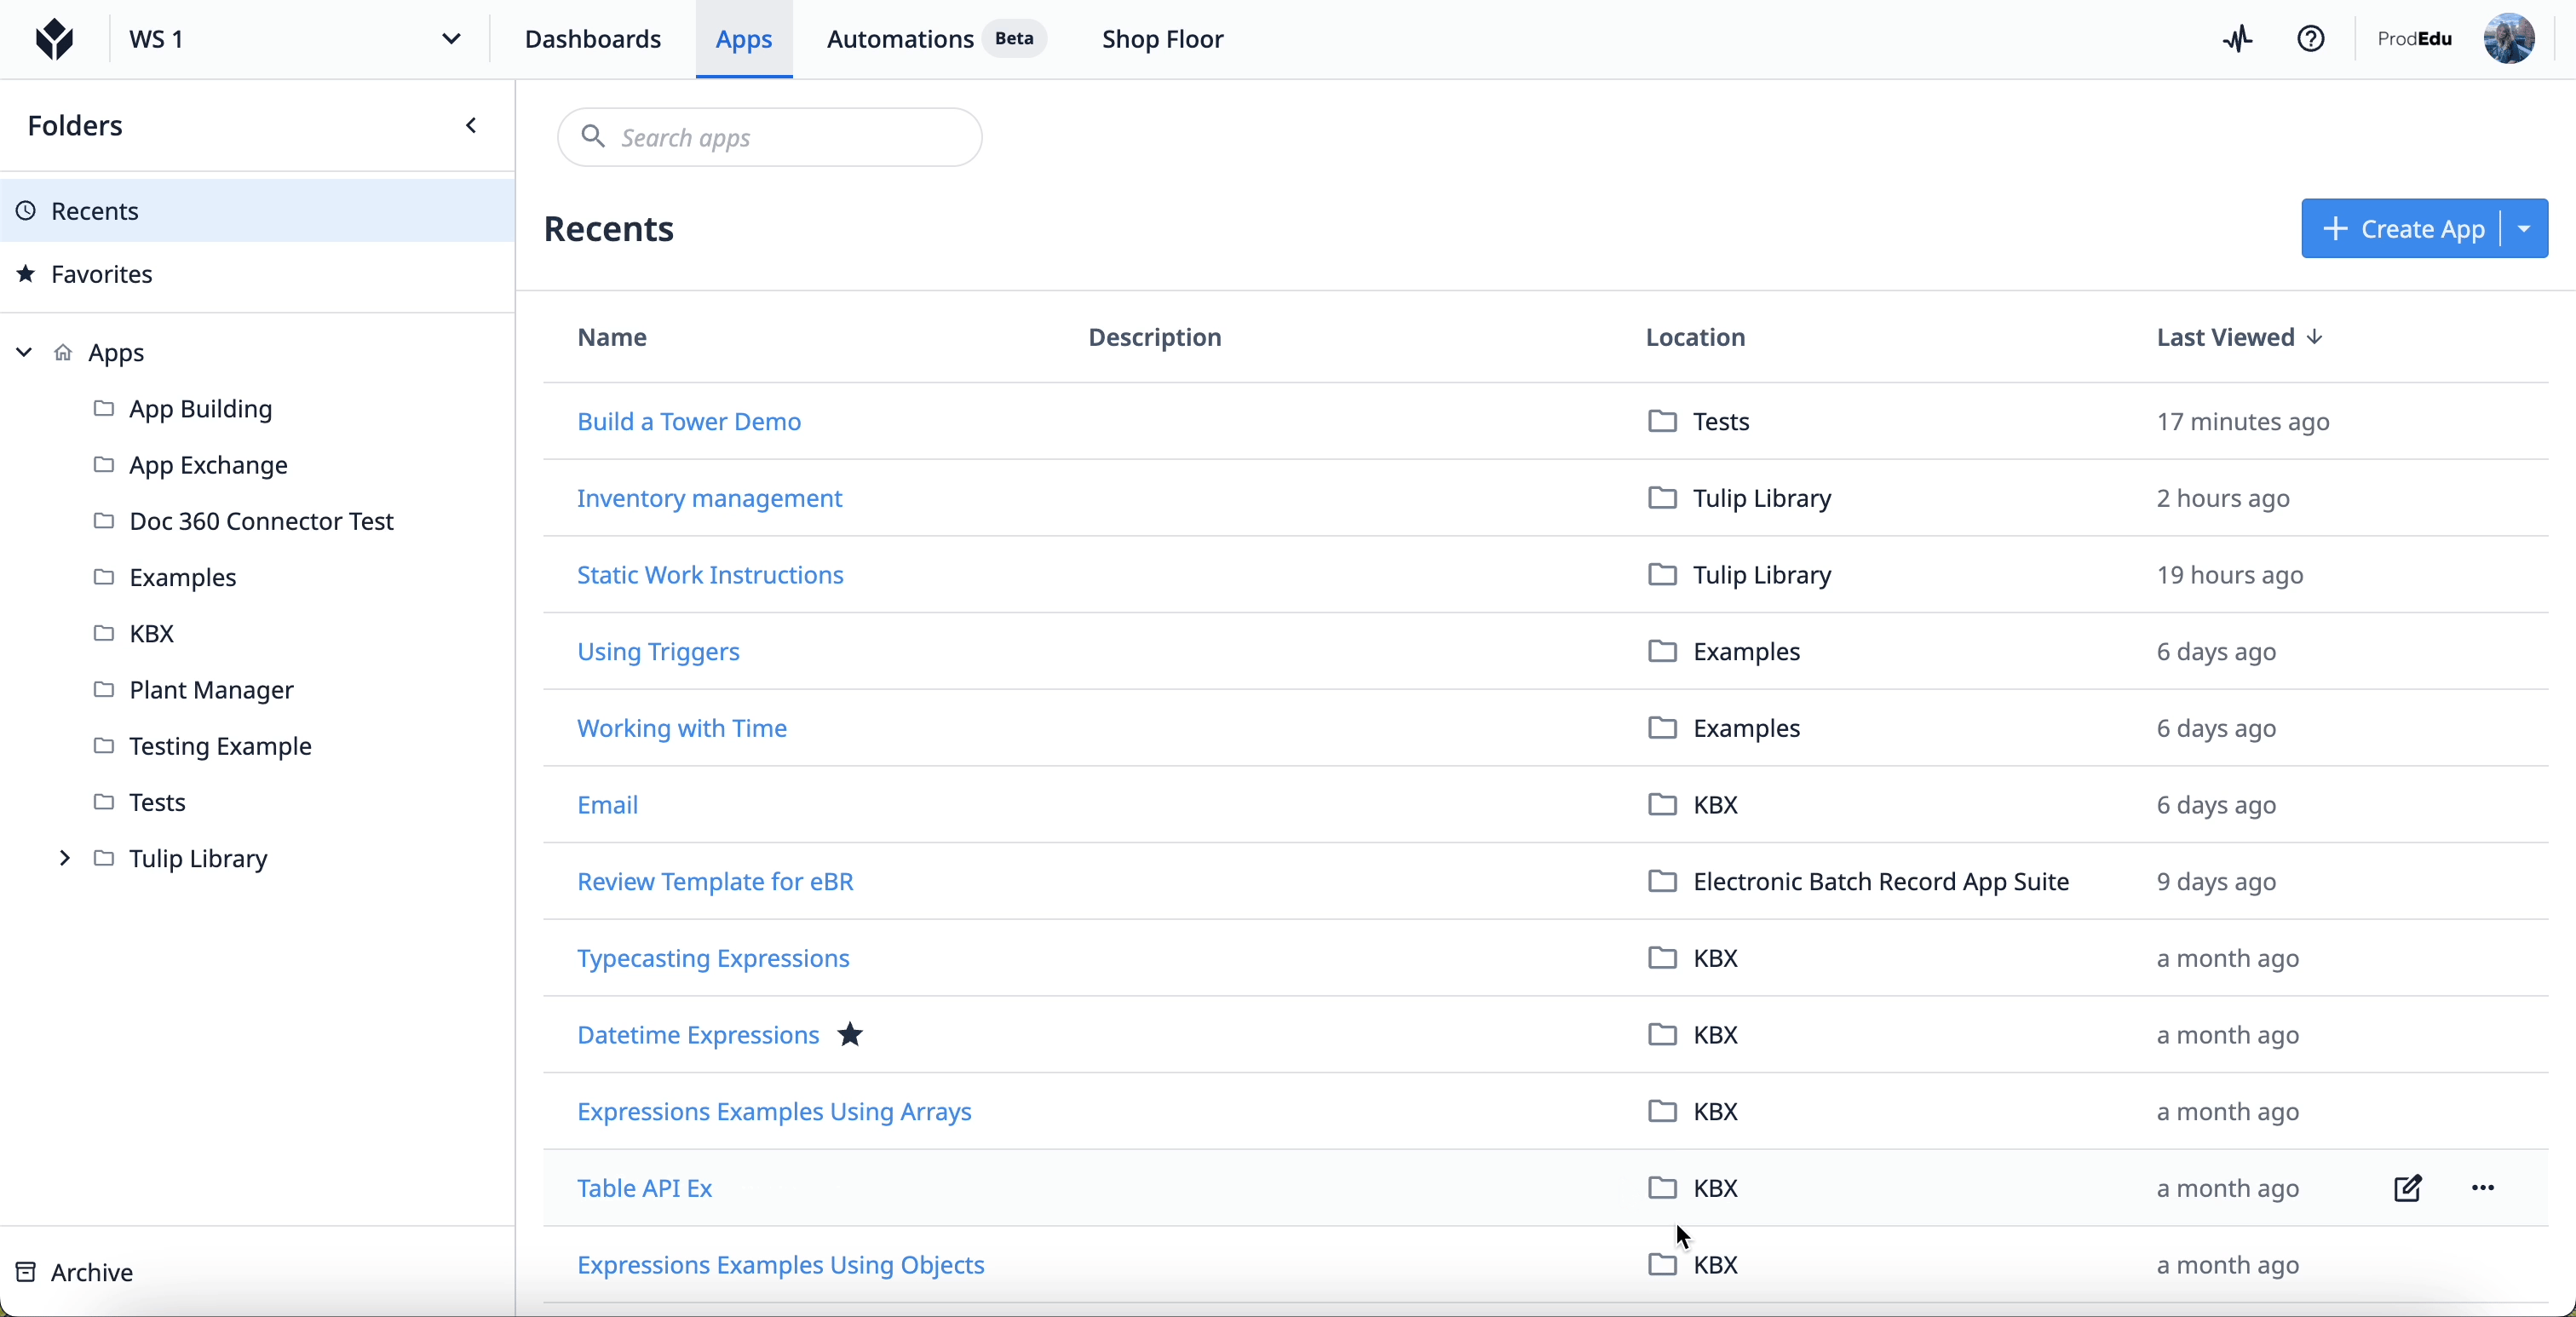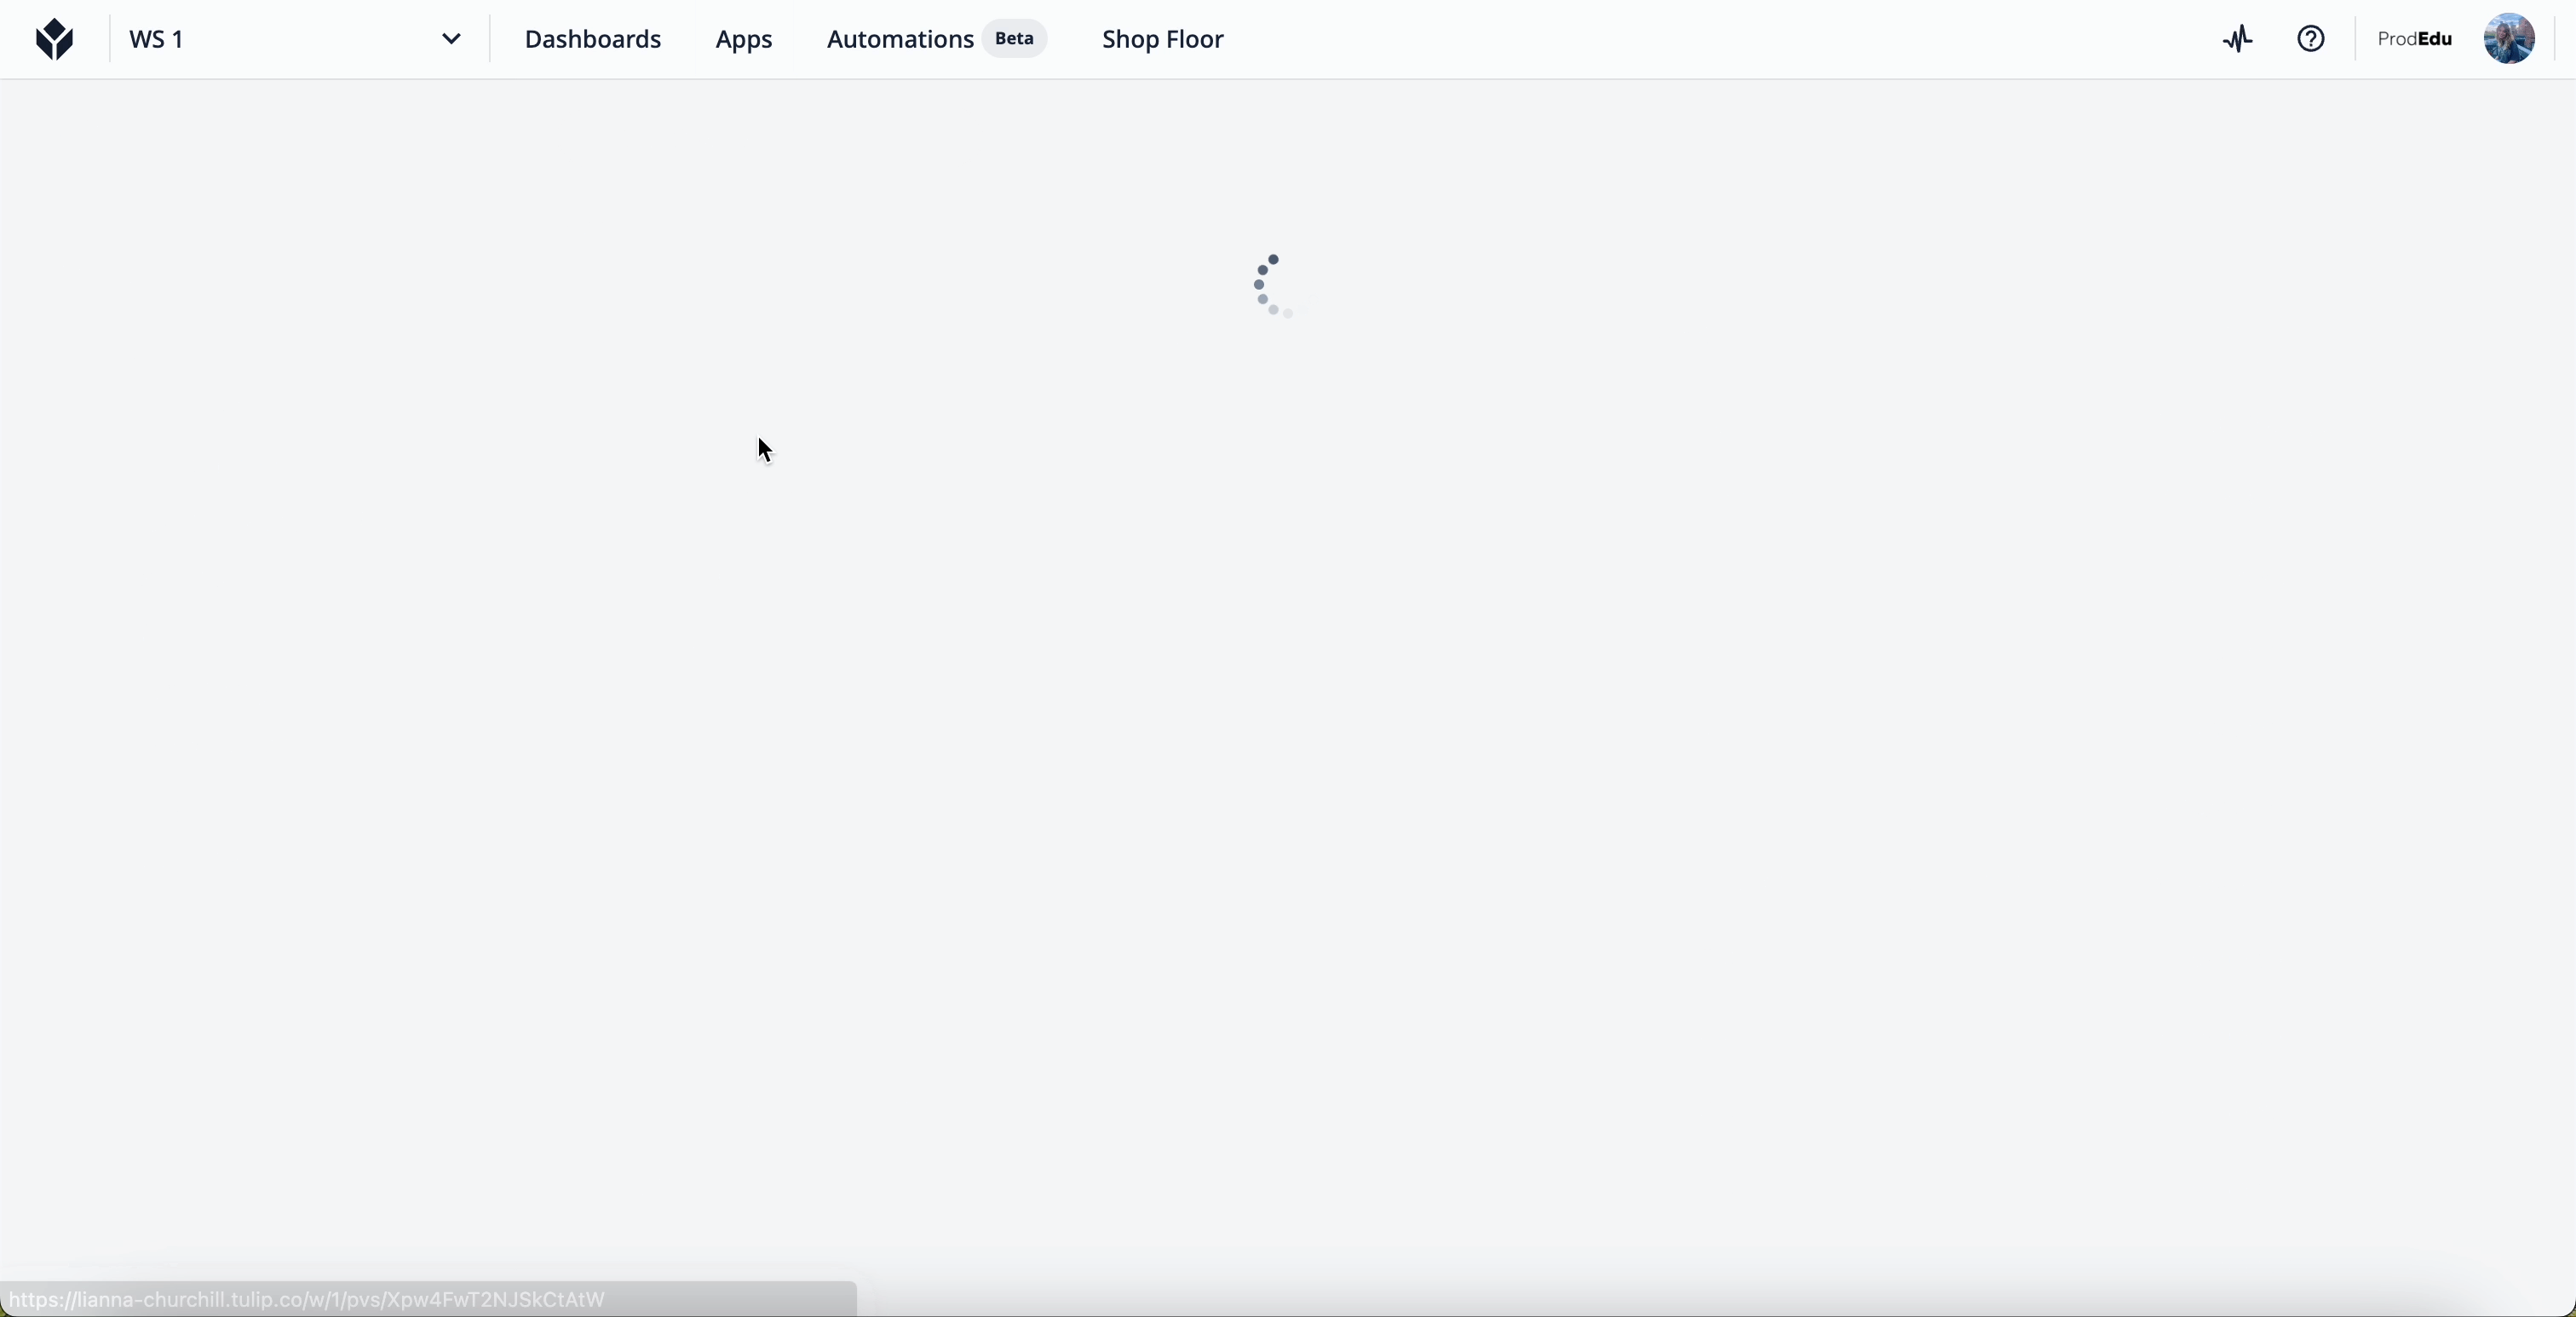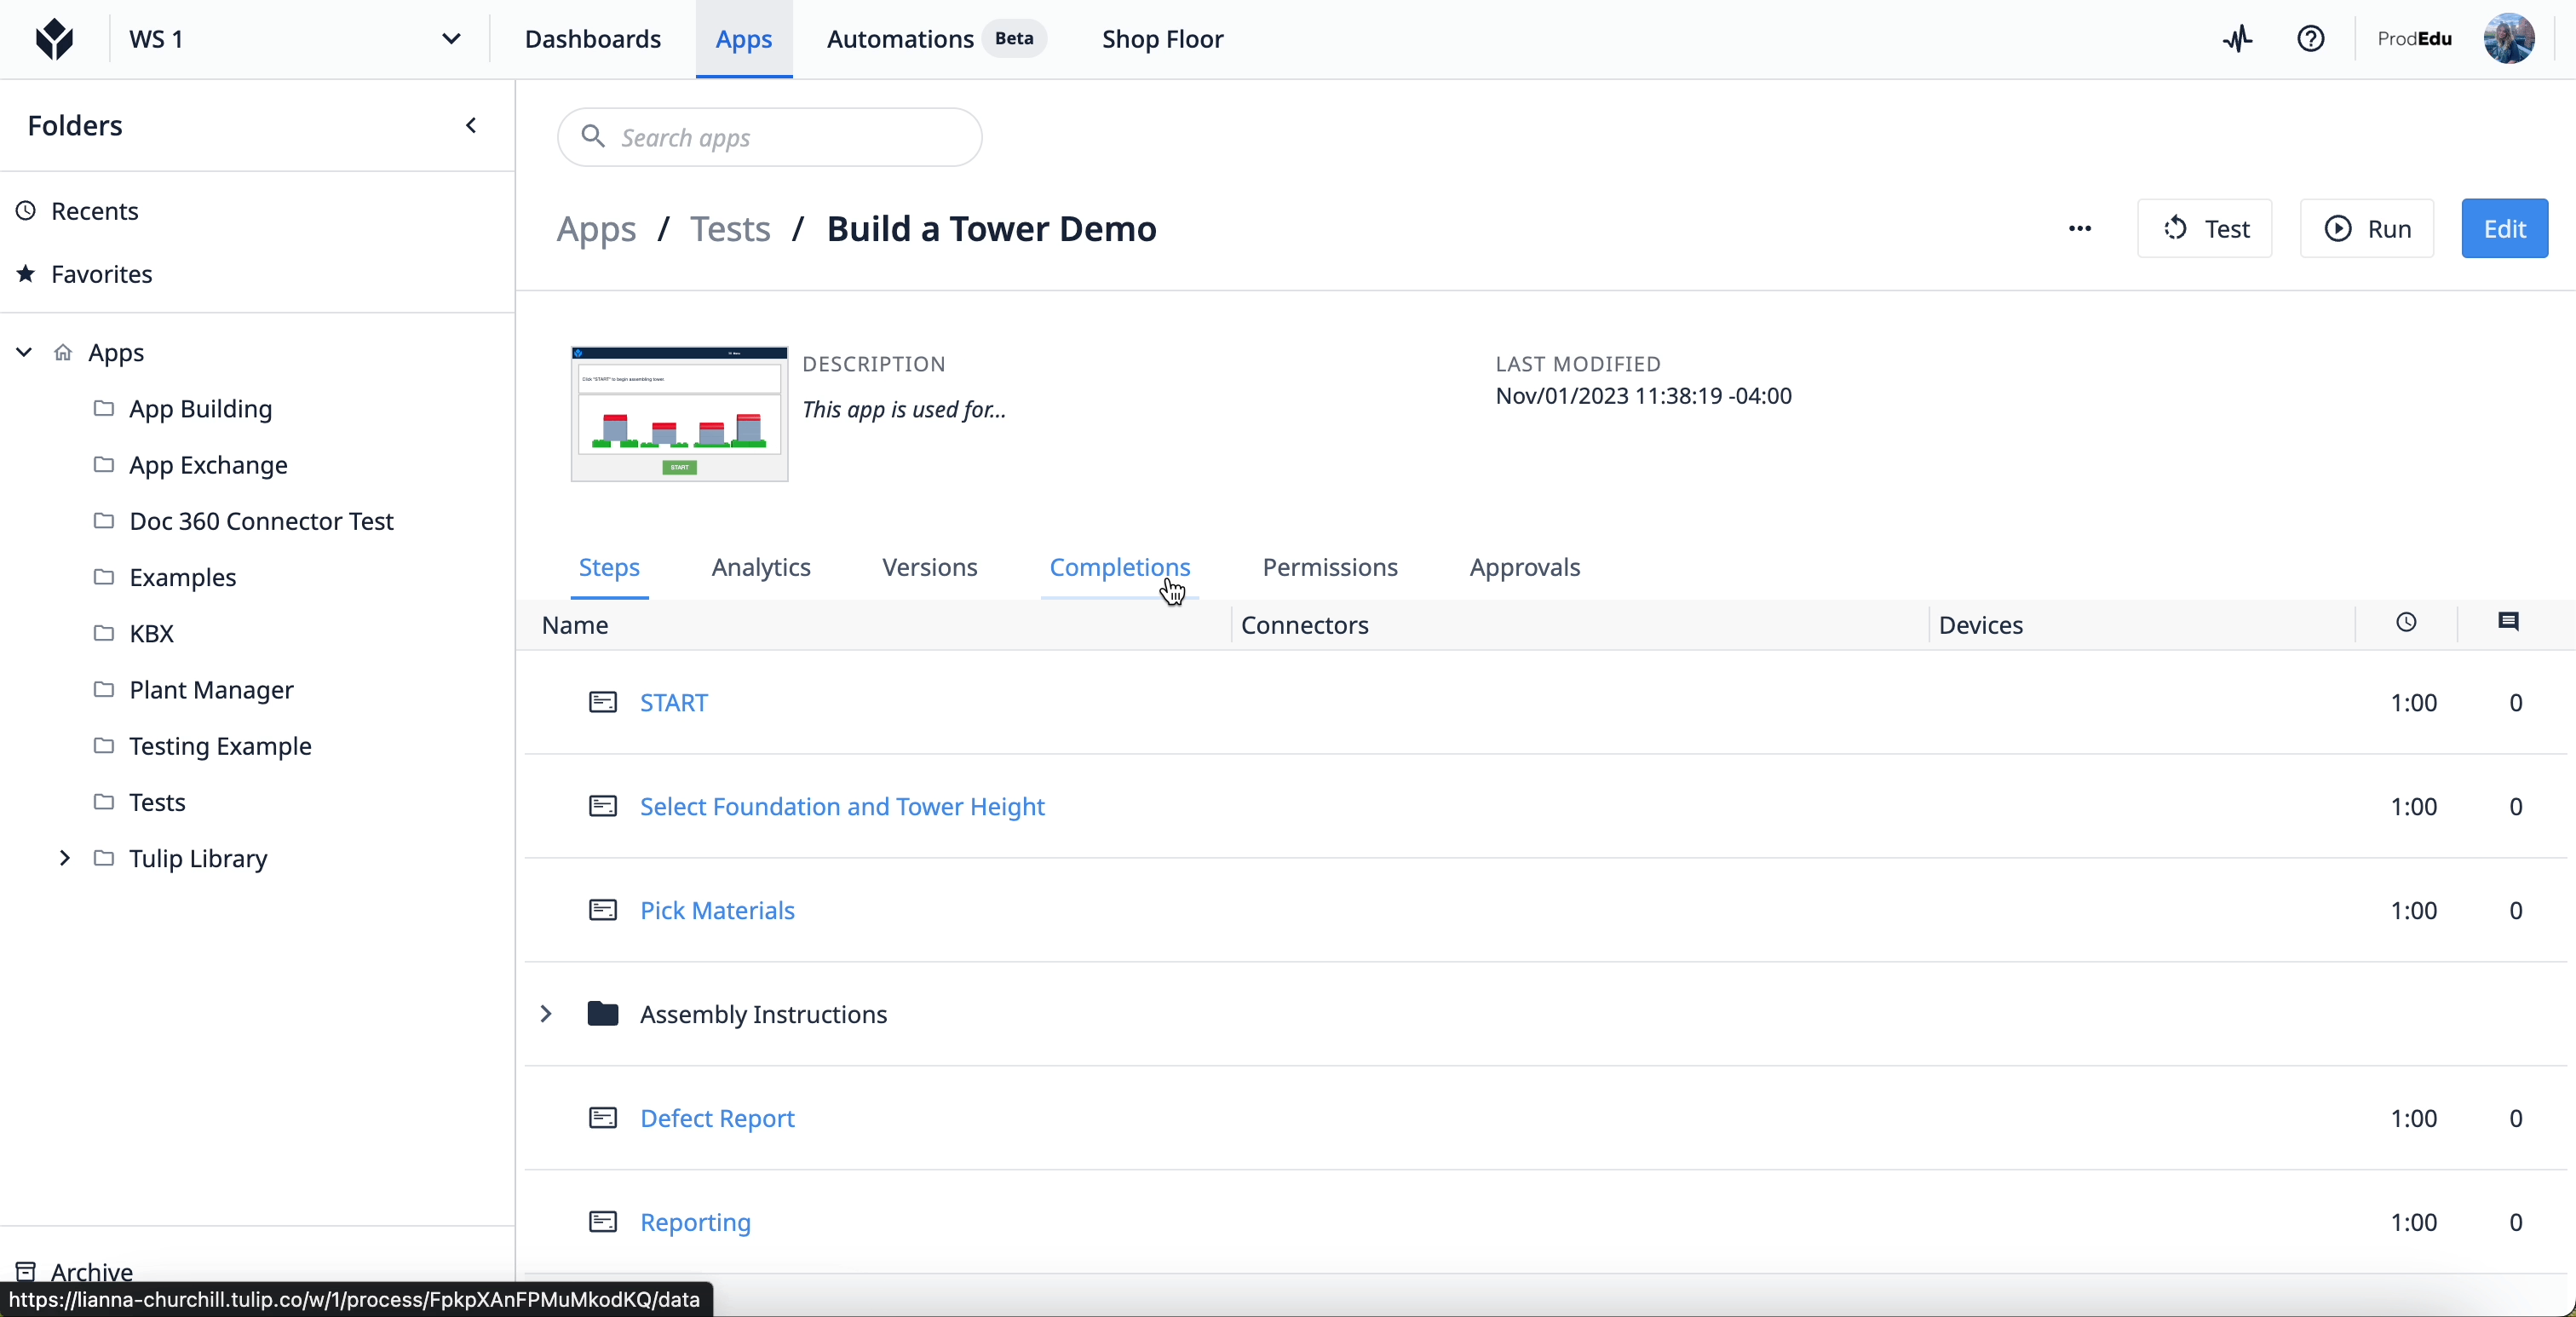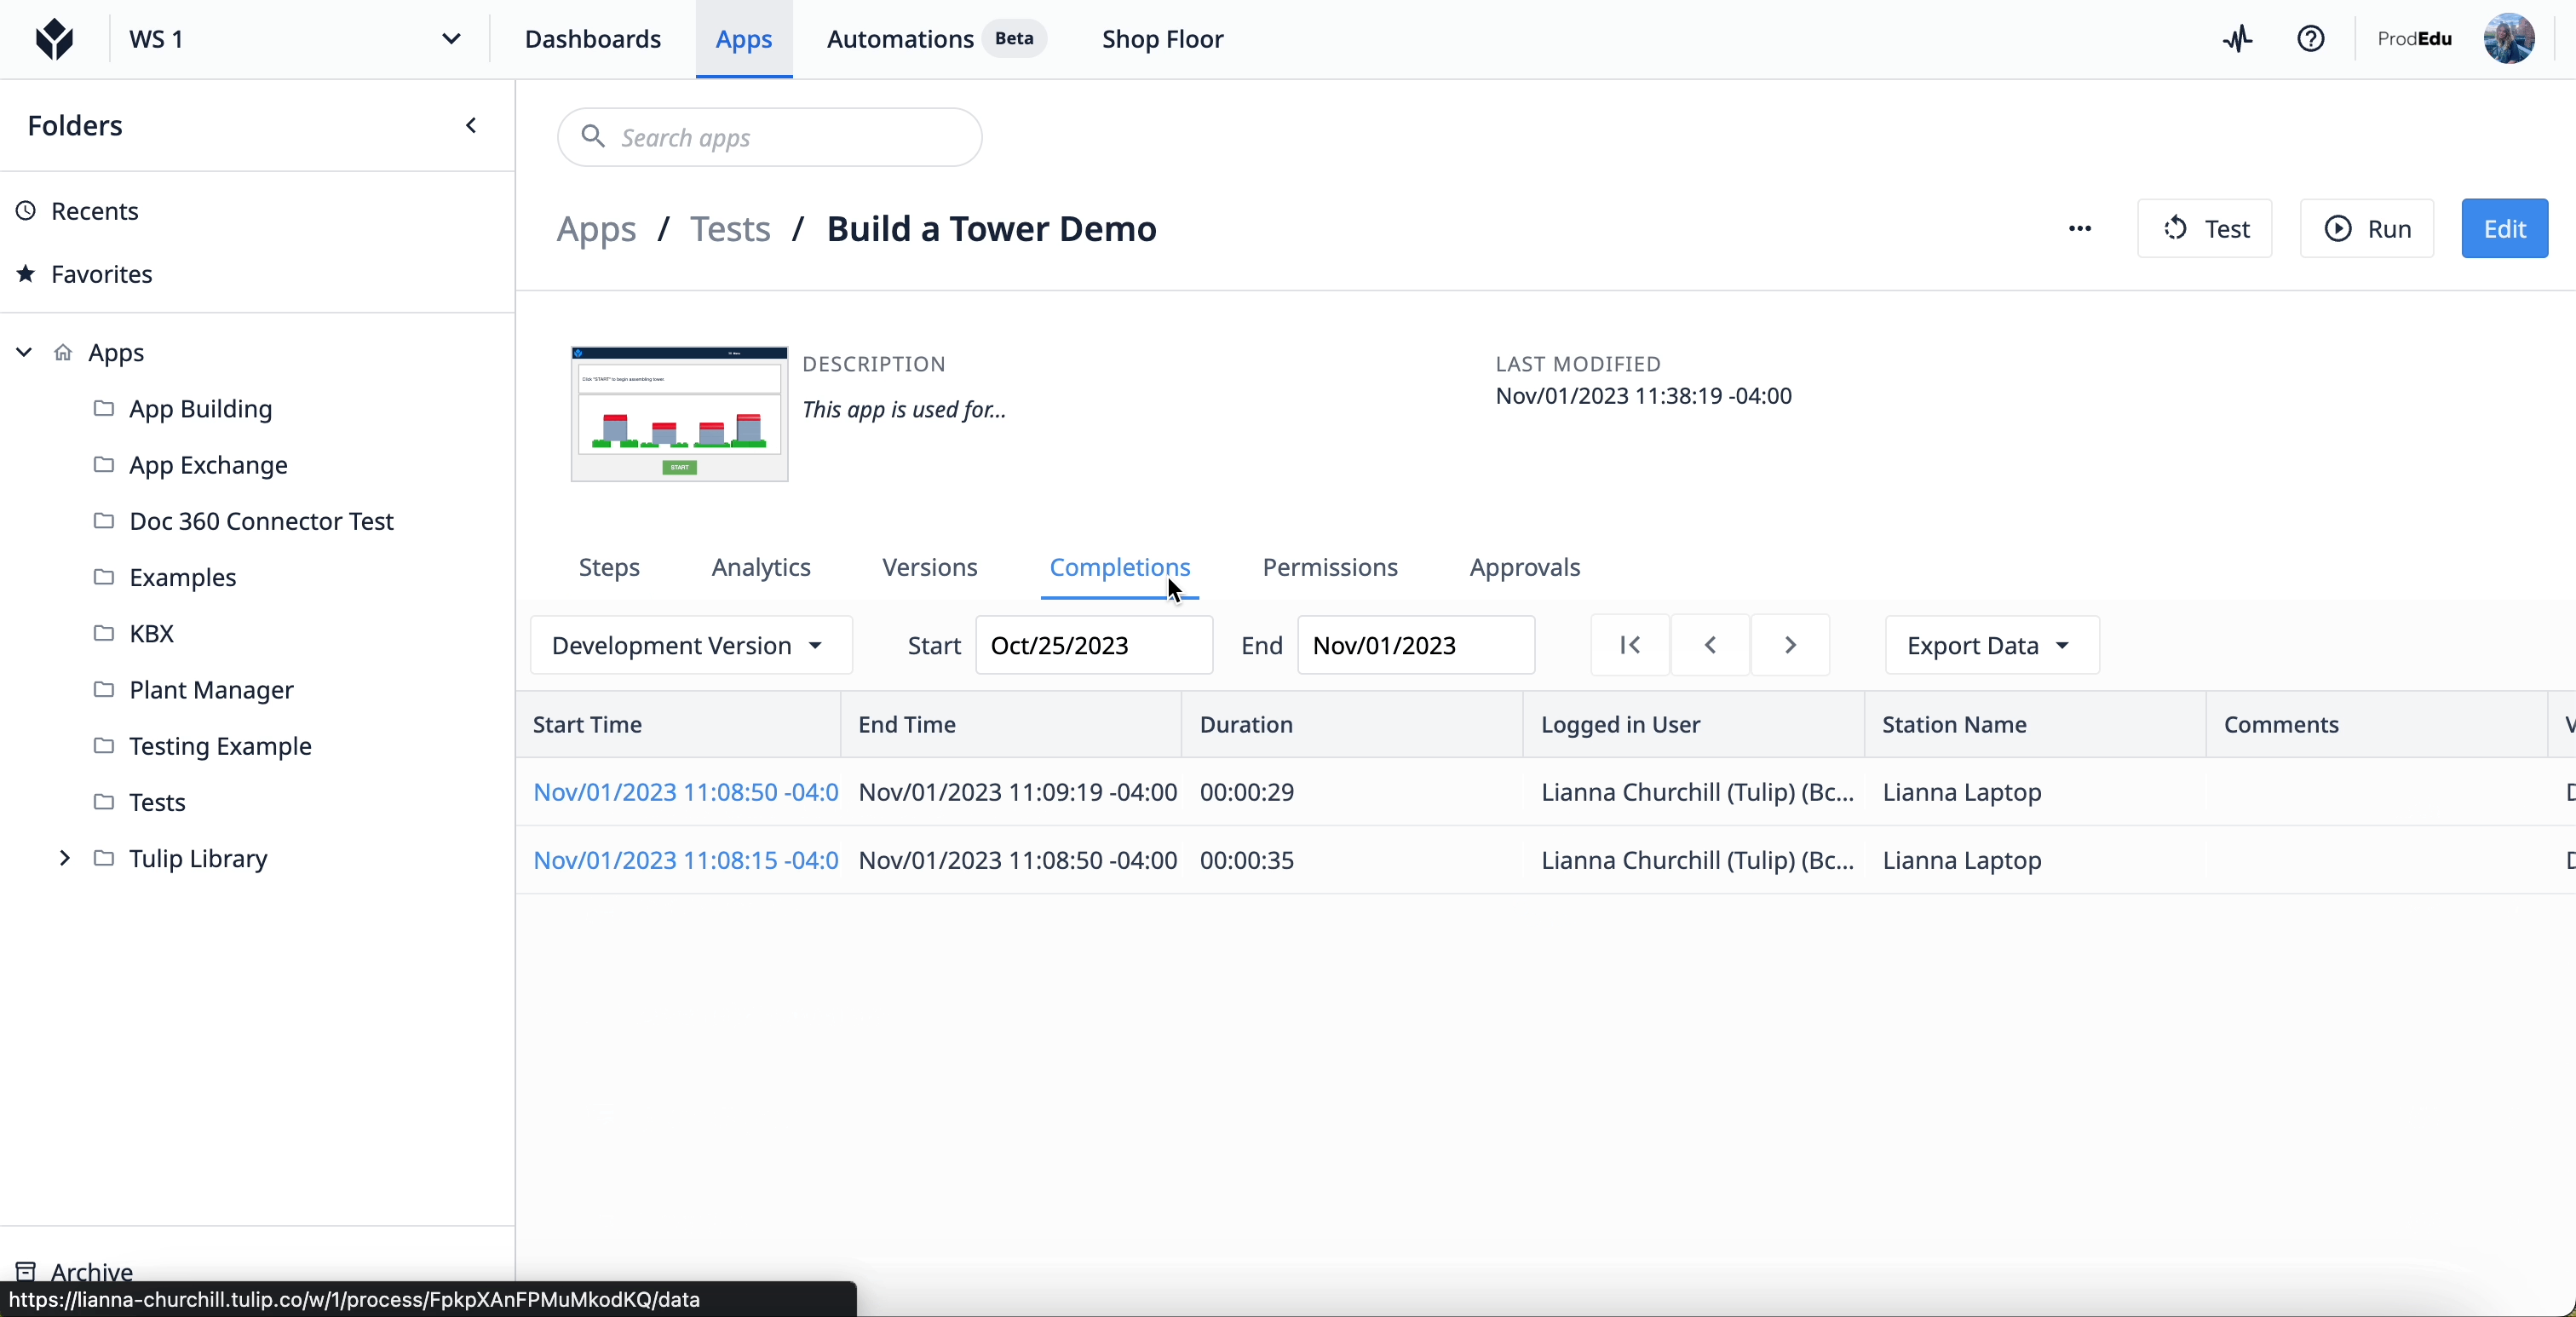
Dowiedz się więcej o „Completions” tutaj.
Tabele a dane o zakończeniach
Ponieważ dane o zakończeniach są automatycznie zapisywane w danych aplikacji, możesz się zastanawiać, kiedy warto zamiast tego skonfigurować tabelę do przechowywania danych.
Dane dotyczące zakończeń są niezmienne, podczas gdy pola w tabelach są tworzone w zależności od Twoich potrzeb. Dane z tabel są również zapisywane z aplikacji na podstawie ustawionych przez Ciebie wyzwalaczy i zmiennych; dane z autouzupełniania są natomiast zapisywane tylko wtedy, gdy użytkownik zakończy korzystanie z aplikacji lub anuluje jej działanie. Chociaż dane z autouzupełniania zapewniają wygodę i natychmiastową automatyzację, dane z tabel można dostosować specjalnie do Twojej aplikacji i elastycznie wykorzystywać je w wielu aplikacjach.
Najlepsze praktyki dotyczące przechowywania danych
Ponieważ przechowywanie danych można dostosować do Twoich potrzeb operacyjnych, istnieje wiele sposobów konfiguracji struktur danych. Tulip zaleca kilka praktyk, które pomogą Ci tworzyć tabele i przechowywać dane zgodnie z następującymi celami:
- Dane są łatwo dostępne
- Dane są widoczne dla odpowiednich osób i systemów
- Dane są scentralizowane i nie są powielane w innych miejscach
Dowiedz się więcej o najlepszych praktykach firmy Tulip dotyczących przechowywania danych tutaj.
Zastosuj model danych
Tulip oferuje gotowy, wspólny model danych dostosowany do wielu scenariuszy użytkowania, dzięki czemu można go wdrożyć i dostosować do konkretnych potrzeb:
- Wspólny model danych dla konkretnych przypadków użycia
- Wspólny model danych dla zastosowań w branży farmaceutycznej
W Tulip wspólny model danych to zbiór zdefiniowanych tabel, które są na tyle elastyczne, że umożliwiają współdzielenie danych w ramach całego rozwiązania składającego się z aplikacji.
Poniższe diagramy ilustrują, w jaki sposób tabele udostępniają wspólne dane w aplikacjach.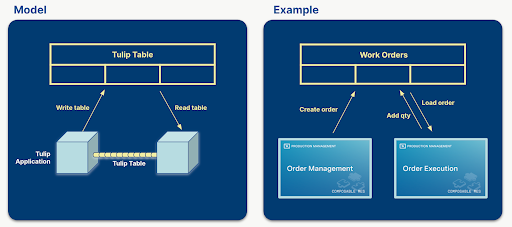
Wspólny model danych oferuje znormalizowane i rozszerzalne schematy danych, usprawniając obsługę danych w różnych systemach poprzez przedstawienie powszechnie stosowanych pojęć (np. zlecenia pracy, jednostki). Ułatwia to tworzenie, kompilację i analizę danych oraz stwarza znaczącą szansę na usprawnienie zarządzania danymi.
Tabele Tulip powinny przede wszystkim być zgodne z modelem cyfrowego bliźniaka, co oznacza, że powinny one jak najdokładniej odzwierciedlać fizyczny zakład lub halę produkcyjną. Historyczne dane z aplikacji powinny być ograniczone do rekordów realizacji, aby zapewnić, że tabele nie przechowują danych podstawowych ani nie powielają danych z rekordów realizacji lub rekordów zewnętrznych.
Dowiedz się więcej o tym, jak korzystać ze wspólnego modelu danych tutaj.
Weź udział w kursie dotyczącym wspólnego modelu danych na Tulip University tutaj.
Wykorzystanie danych w aplikacjach
Aby wyświetlać, edytować lub wprowadzać dane z tabel w swoich aplikacjach, należy najpierw zapoznać się z widżetami. Input Widgety umożliwiają edycję i wprowadzanie danych, które zostaną odzwierciedlone w tabeli. Osadzone widżety wyświetlają informacje i można je skonfigurować tak, aby umożliwić interakcję z tabelami. Pełny samouczek dotyczący włączania danych z tabel znajdziesz tutaj:
Dane dotyczące ukończenia można wyświetlać w aplikacjach za pomocą narzędzia Analytics. Najpierw należy utworzyć analizę na podstawie danych dotyczących ukończenia, a następnie osadzić tę analizę w aplikacji.
Więcej informacji na temat tworzenia analizy z wykorzystaniem danych dotyczących ukończenia znajdziesz tutaj.
Jak Tulip przechowuje Twoje dane
Ponieważ Tulip jest platformą samoobsługową, to Ty decydujesz, które z Twoich danych są przesyłane i przechowywane. Tulip Cloud przechowuje dane w chmurze AWS, korzystając z bazy danych MongoDB lub PostgreSQL. Tulip automatycznie przesyła wszystkie obrazy, filmy i pliki PDF do magazynu Amazon S3, dzięki czemu nie musisz martwić się o zarządzanie przestrzenią dyskową ani śledzenie zebranych danych.
Kolejne kroki
Rozpocznij pracę z danymi, korzystając z porad ekspertów Tulip:* Przewodnik krok po kroku: Utwórz swoją pierwszą tabelę* Kurs „Praca z danymi i tabelami”* Przewodnik „Zrozumienie zakończeń aplikacji i tabel”* Integracja z systemami zewnętrznymi
Czy znalazłeś to, czego szukałeś?
Możesz również przejść na stronę community.tulip.co, aby zadać pytanie lub sprawdzić, czy inni mieli podobny problem!
