
В этом руководстве вы узнаете:
- Два разных способа хранения данных с помощью Tulip
- Когда использовать различные методы хранения данных
- О важности внедрения модели данных
При работе с данными крайне важно поддерживать порядок, чтобы избежать беспорядка и централизовать информацию. С Tulip хранение и управление данными упрощается благодаря множеству вариантов, соответствующих вашим потребностям.
Как Tulip фиксирует ваши операции?
В Tulip данные существуют на нескольких уровнях.
Приложения хранят статические данные, например текстовые инструкции к тому или иному шагу.
Таблицы — это встроенные в Tulip базы данных, например, таблицы с рабочими заданиями, которые можно использовать в нескольких приложениях.
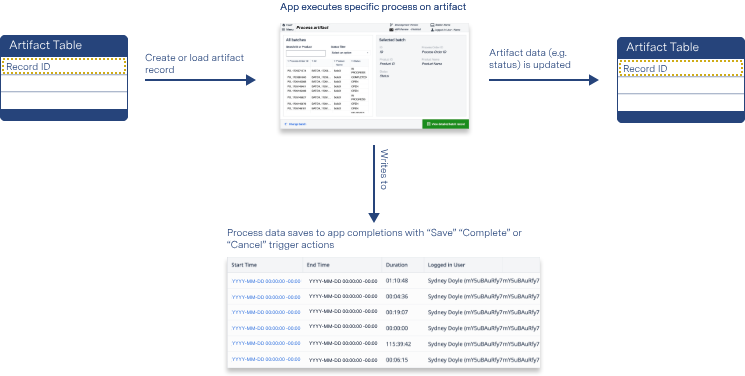
Завершения хранят метаданные производства, такие как продолжительность работы приложения, название станции и любые входные данные для переменных.
На приведенной ниже схеме показан рабочий поток данных на производственном участке.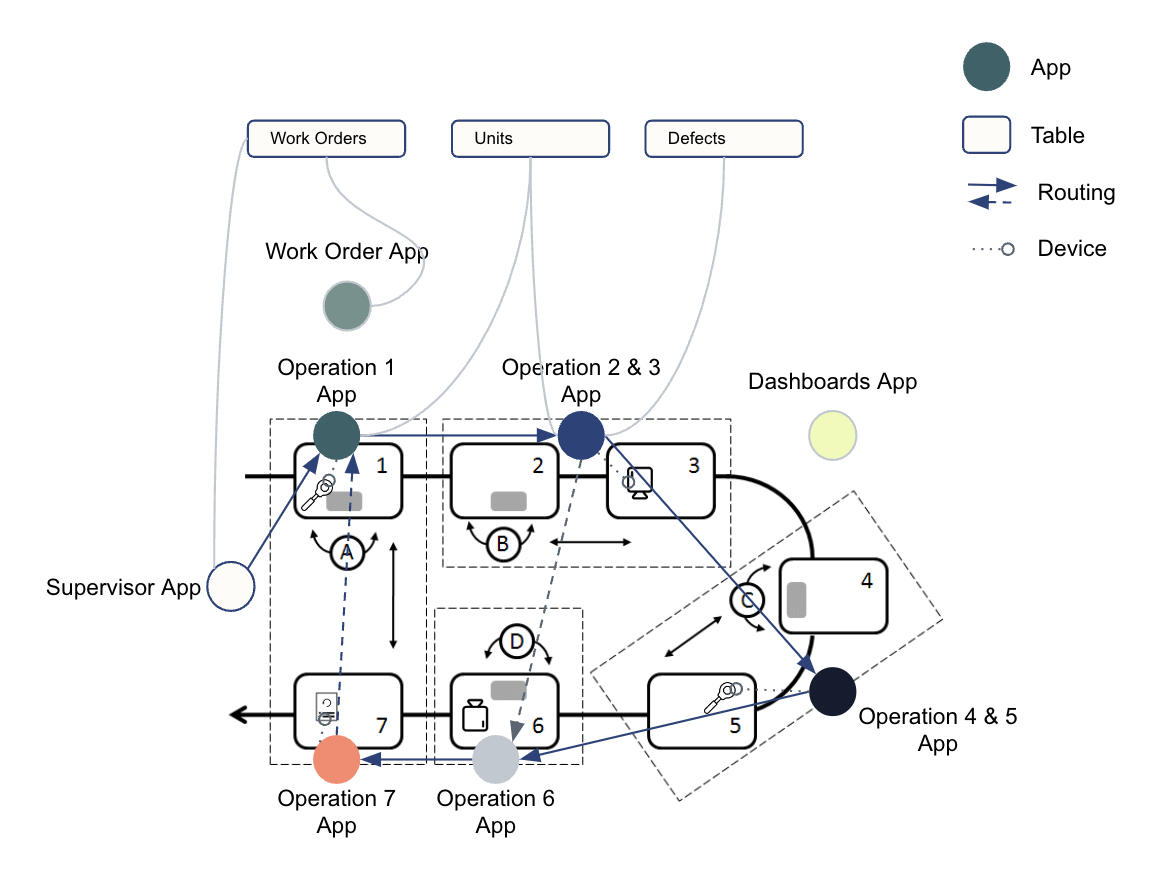
Варианты хранения данных
В Tulip доступно 2 варианта хранения данных: «Таблицы» и «Завершения».
Таблицы
Таблицы представляют собой нечто среднее между электронными таблицами и реляционными базами данных, которые можно настраивать в соответствии с вашими потребностями при представлении данных. Это общие источники данных, которые могут использоваться несколькими приложениями.
При создании таблицы вы создаете Fields, которые хранят и систематизируют данные по записям. Поля выступают в роли столбцов, записи — это строки с конкретными данными, а каждая отдельная единица данных представляет собой поле записи таблицы.
Таблицы можно встраивать в ваше приложение для создания, изменения и отображения записей, относящихся к вашим задачам.
Вы можете импортировать существующие данные в таблицы Tulip, как описано здесь.
Если вы не хотите создавать собственную таблицу, но у вас также нет готовых данных для импорта, вы можете воспользоваться одной из предварительно настроенных таблиц Tulip, которые уже загружены в вашу инстанцию. Они дают представление о различных полях, которые можно использовать в таблицах, и общих типах данных, которые можно регистрировать. Варианты типов данных включают:
- Текст
- Целое число
- Число
- Логическое
- Дата и время
- Интервал
- Цвет
- Изображение
- Видео
- Файл
- Устройство
- Связанная запись
Каждое из этих полей будет соответствовать полям ввода данных, используемым в вашем приложении. Чтобы просмотреть записи в таблице, перейдите на экран таблицы через страницу вашего экземпляра Tulip. Наведите курсор на «Приложения» и выберите «Таблицы».
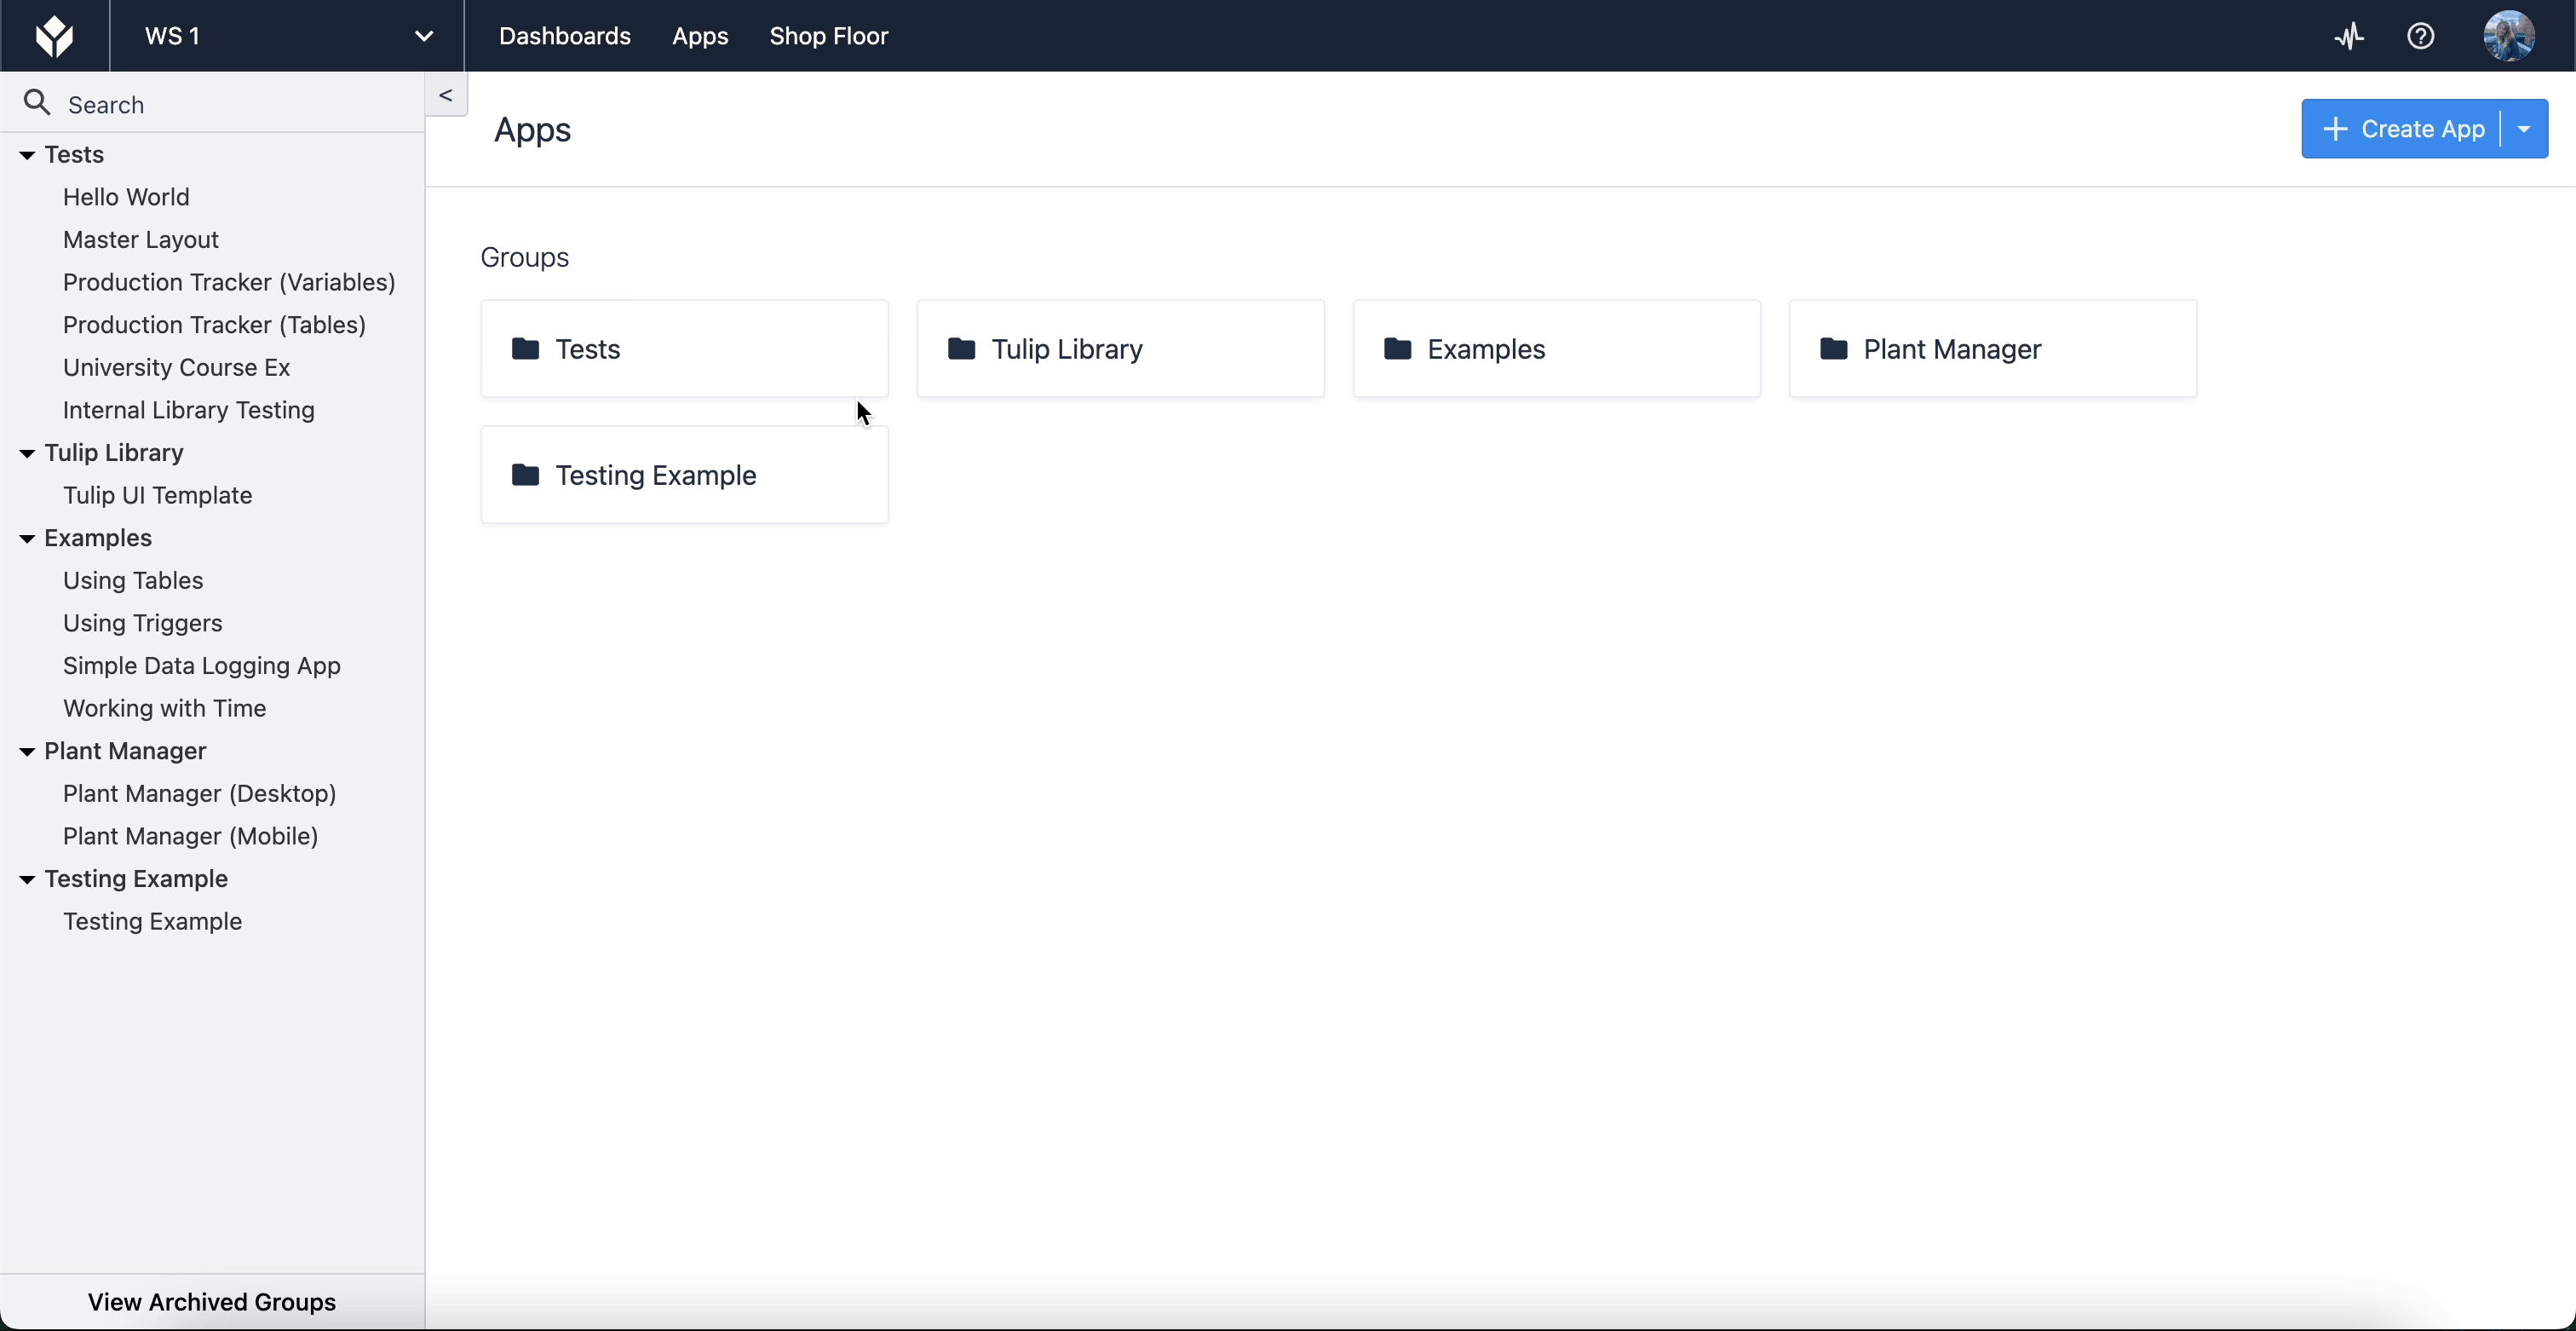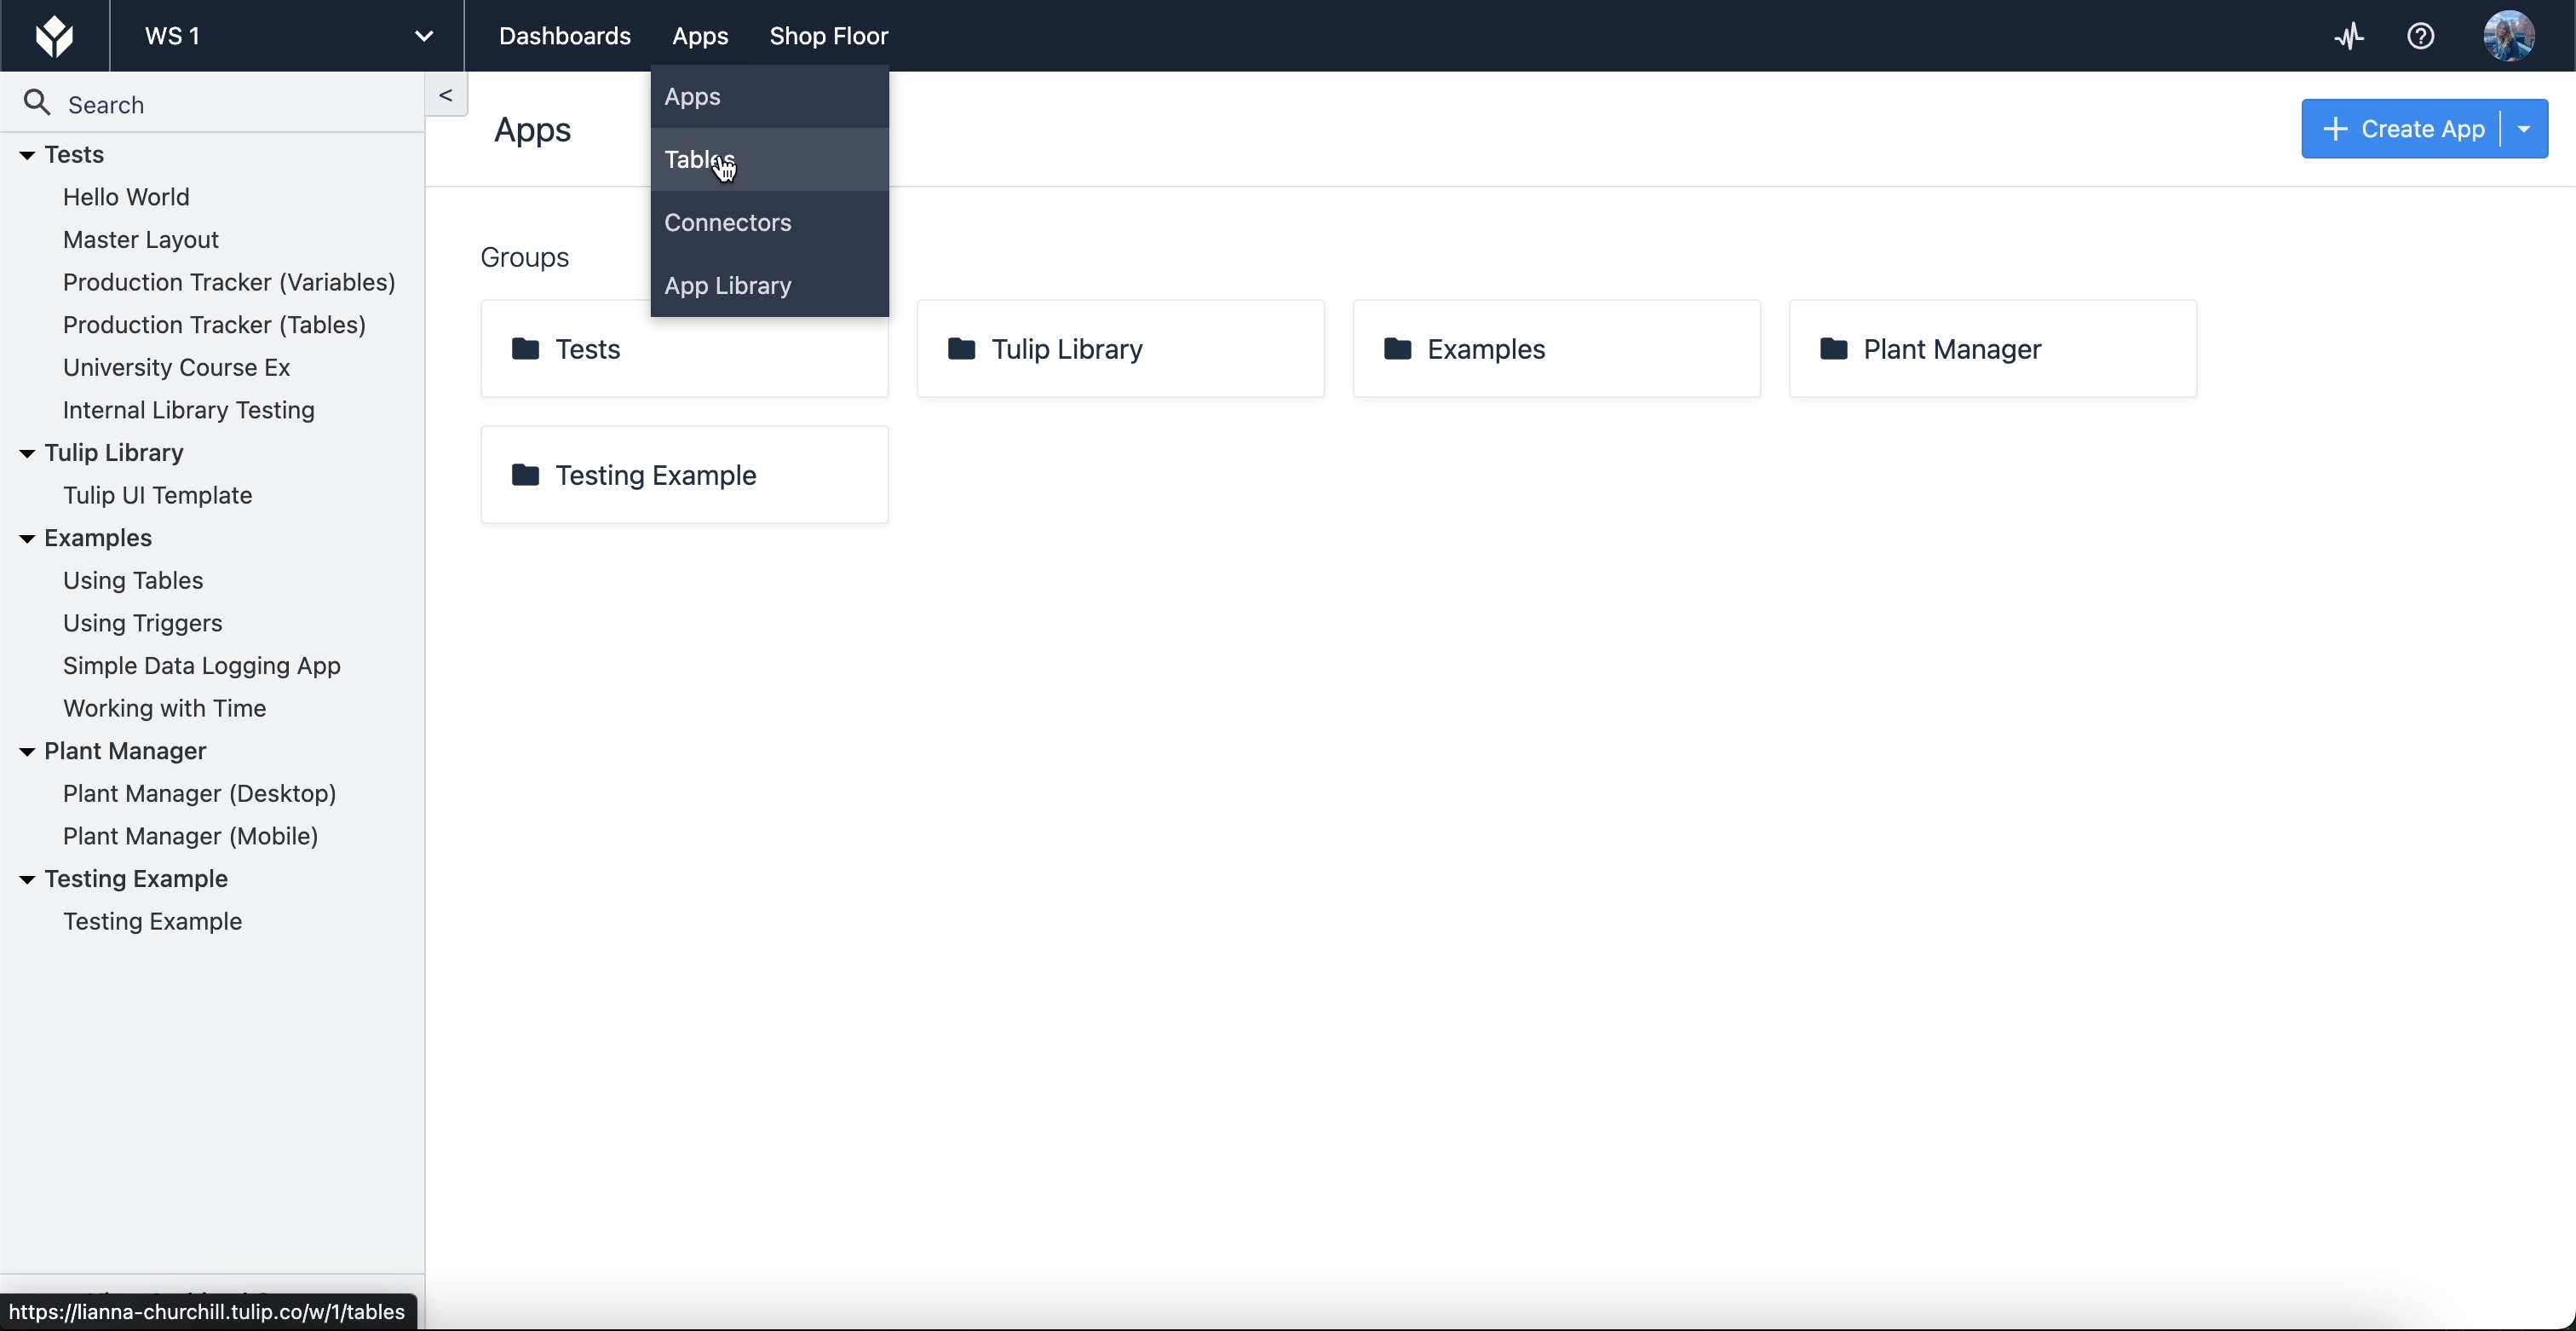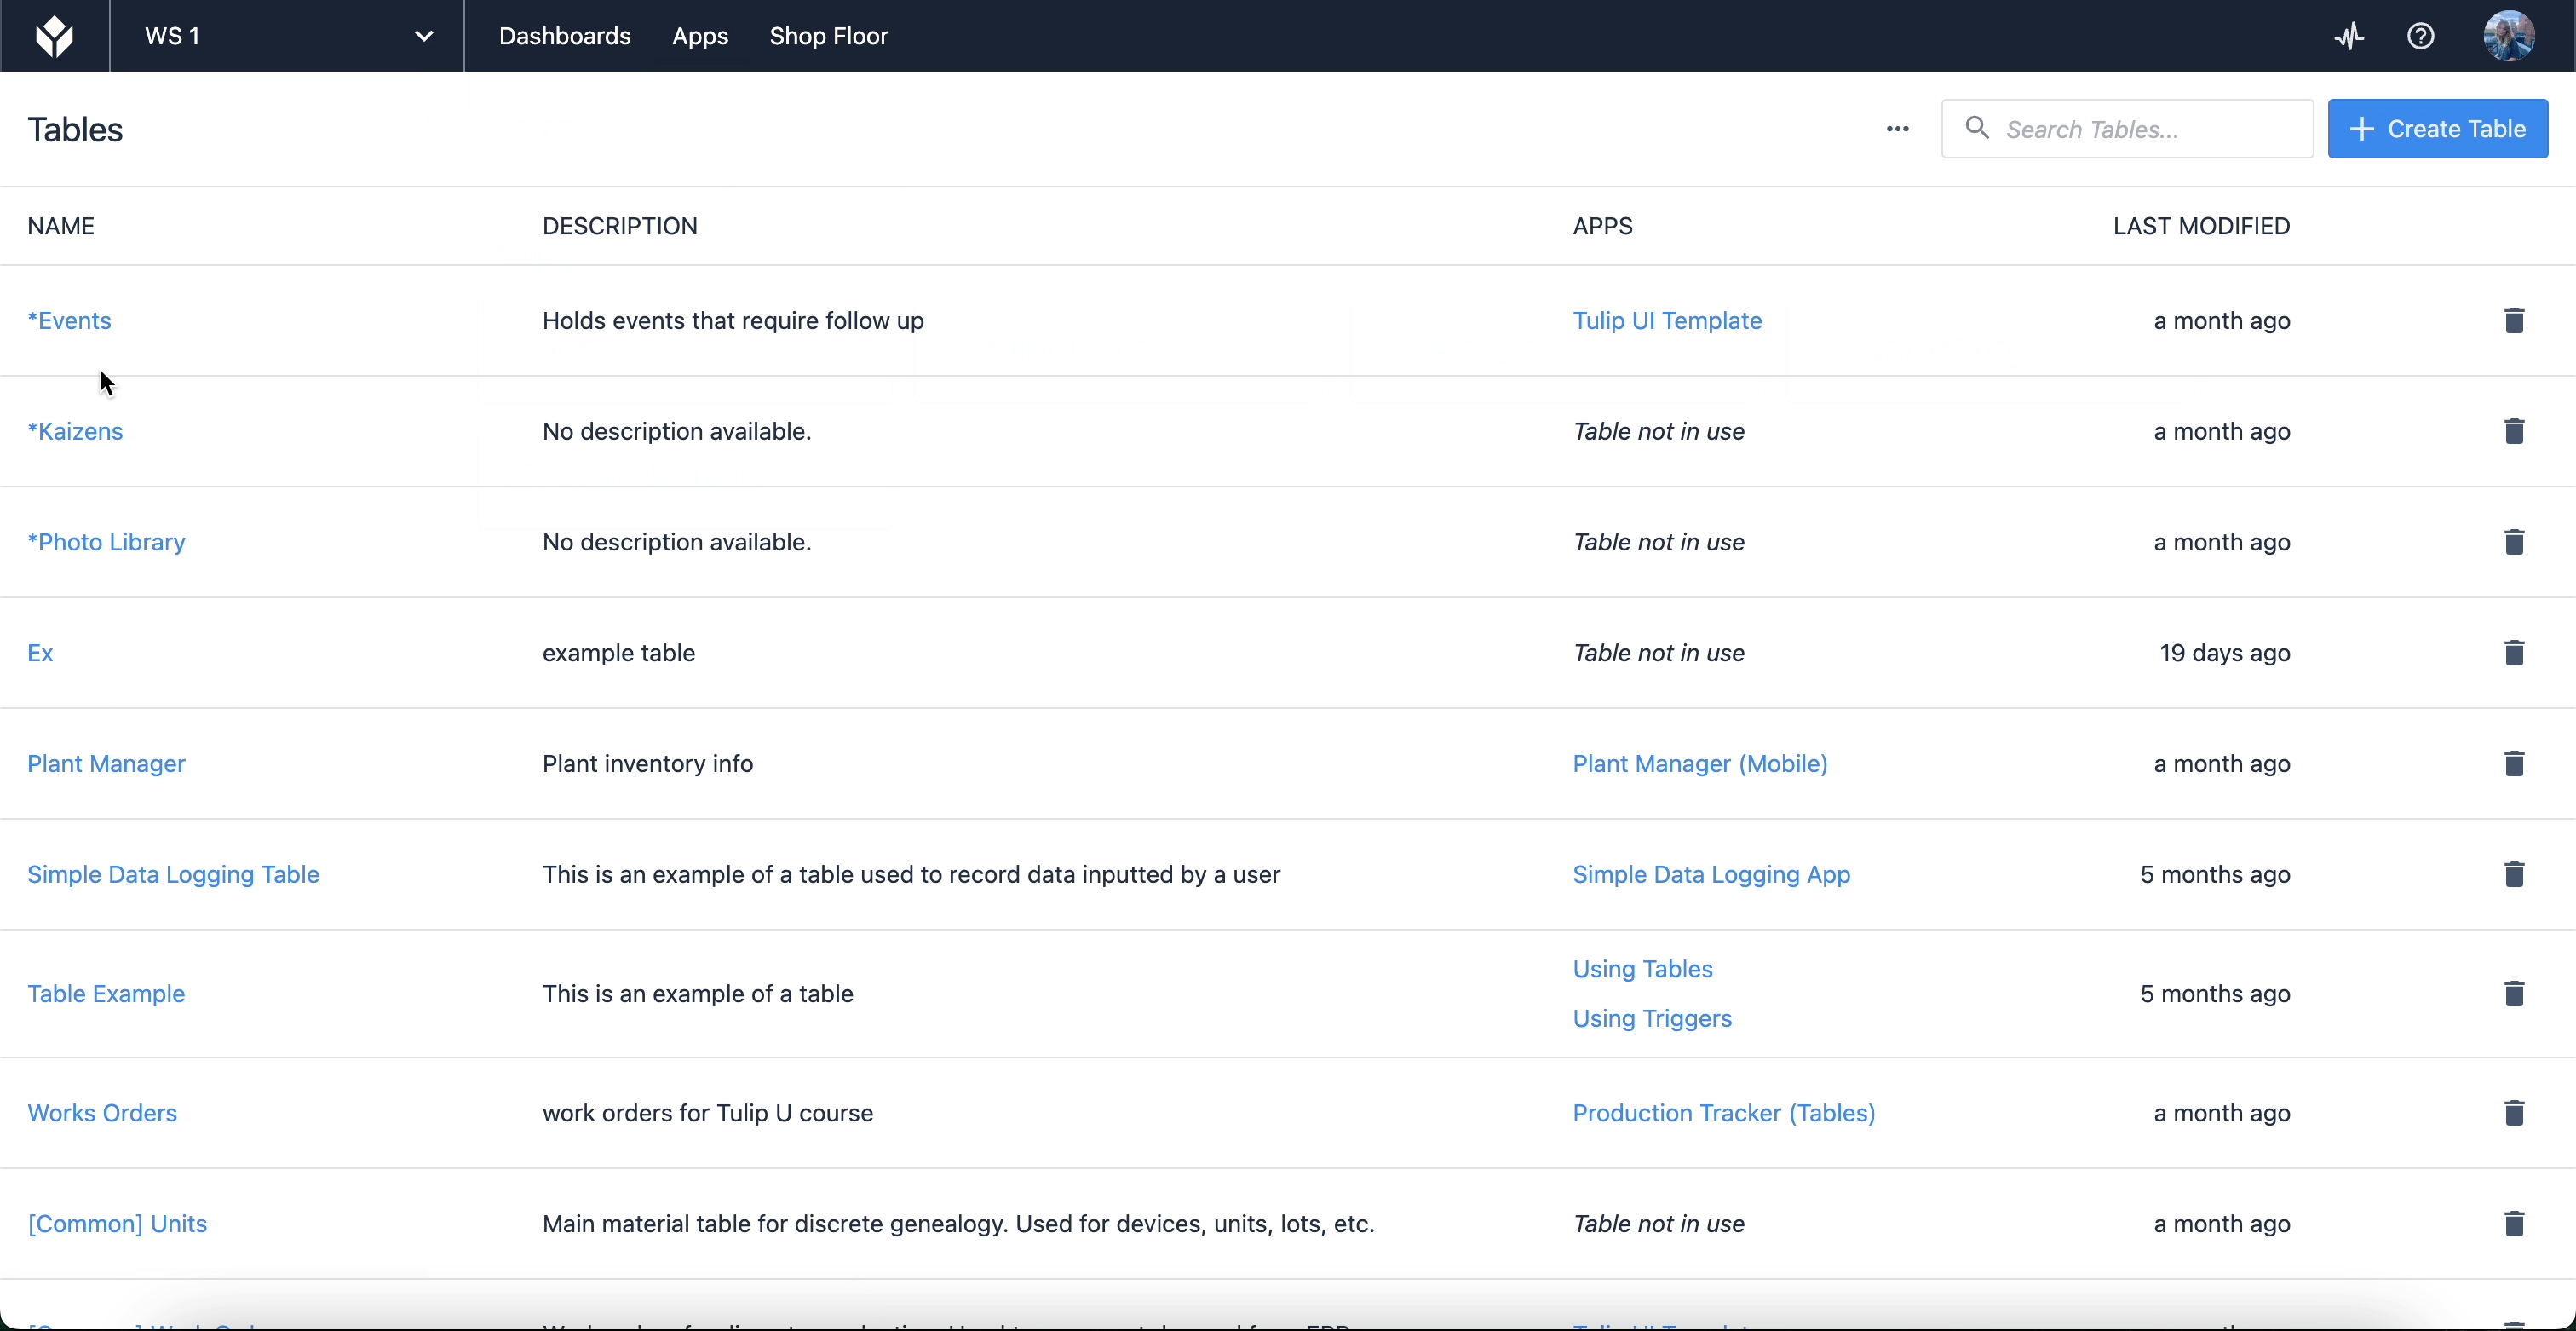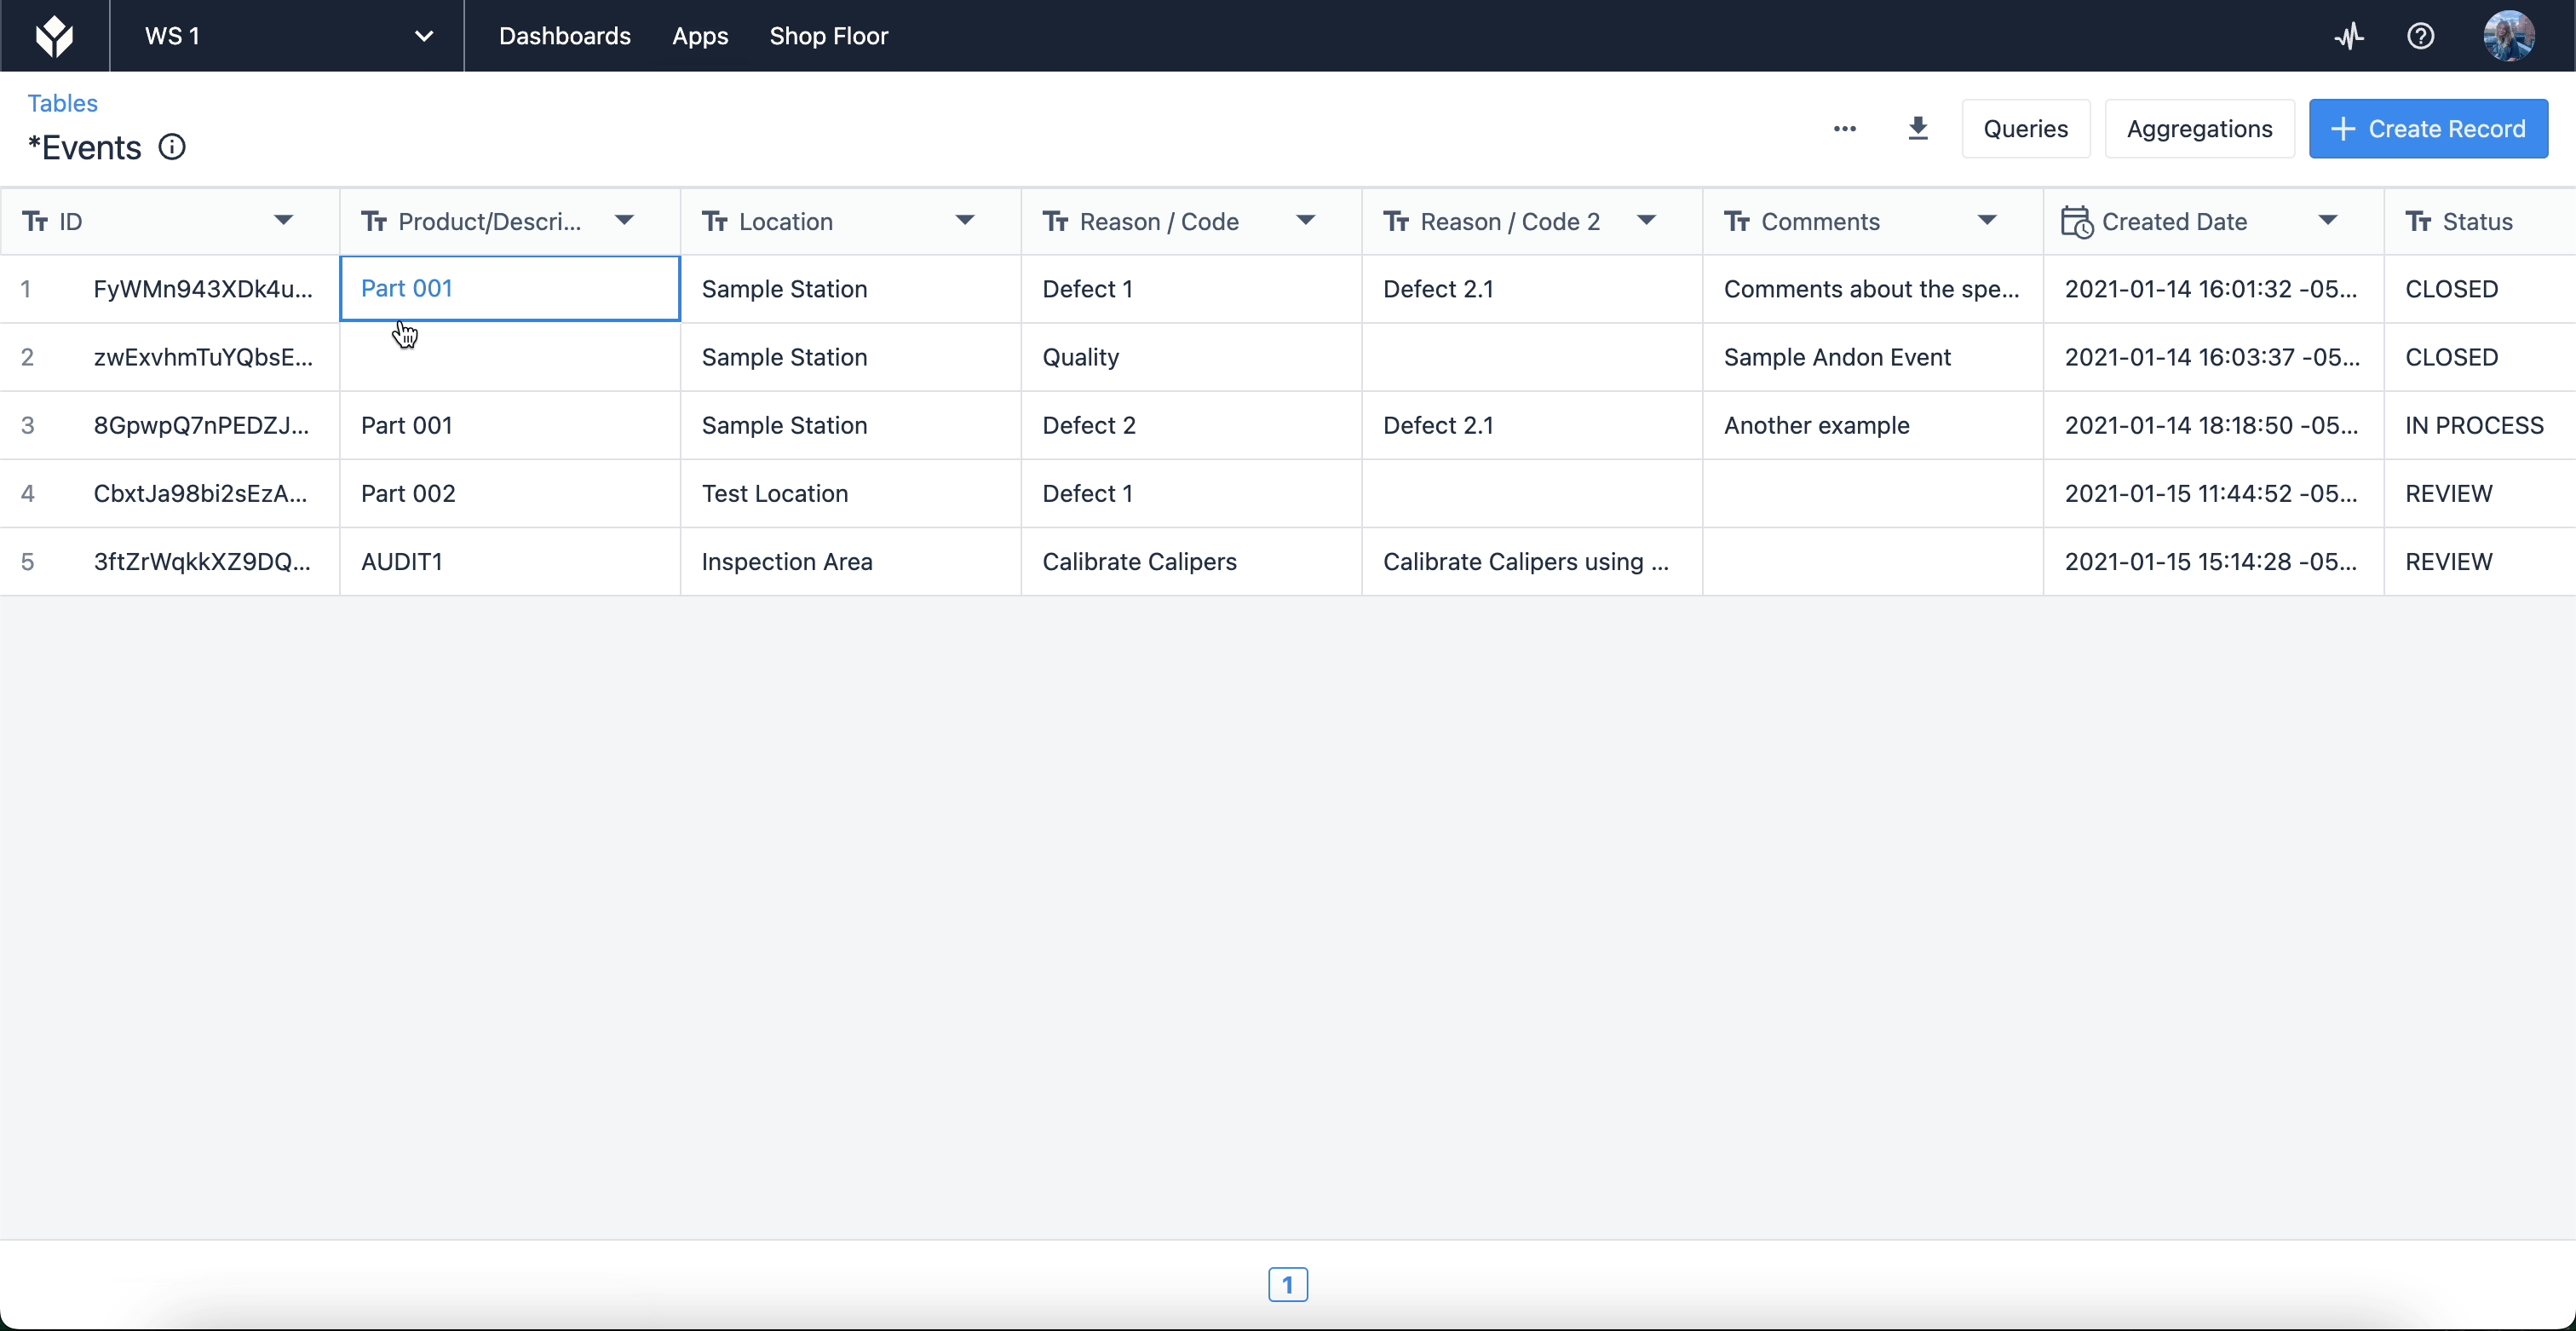
Здесь вы найдете список таблиц, которые вы создали или к которым у вас есть доступ для использования в ваших приложениях. Выбрав таблицу, вы сможете редактировать сами поля и записи, а также создавать запросы и агрегации, которые позволяют использовать данные таблицы в приложениях. Таблицы также можно связывать друг с другом (например, для построения генеалогии продуктов).
Рекомендации по использованию таблиц в Tulip
Tulip рекомендует использовать таблицы для хранения, в общем плане, двух различных типов артефактов: физических и операционных.
Физические артефакты — это материальные объекты или компоненты, которые используются или производятся в ходе операций, например партии или оборудование.Операционные артефакты — это нефизические элементы или компоненты, которые обеспечивают или поддерживают операции, например события дефектов или конфигурация канбана.
Чтобы узнать больше об использовании таблиц, см.:
Завершения
Завершения приложения идеально подходят для хранения и систематизации производственных данных. Поля метаданных автоматически генерируются и сохраняются, как только пользователь завершает работу с приложением или отменяет его. К этим полям относятся:
- Продолжительность работы с приложением
- Время начала и окончания
- Зарегистрированный пользователь
- Название станции
- Комментарии
- Версия приложения
- Идентификатор выполнения
- Отменено (независимо от того, было ли приложение отменено)
В отличие от данных, хранящихся в таблицах, данные, хранящиеся в разделе «Завершения» приложения, не подлежат редактированию. Это гарантирует, что информация является абсолютной: её невозможно подделать или изменить, и она точно отражает использование приложения.
Данные о завершении могут использоваться только одним приложением и менее доступны из внешних систем.
Чтобы получить доступ к данным о завершениях приложения, выберите приложение из группы приложений в вашем экземпляре Tulip. На главном экране приложения перейдите на вкладку «Завершения».
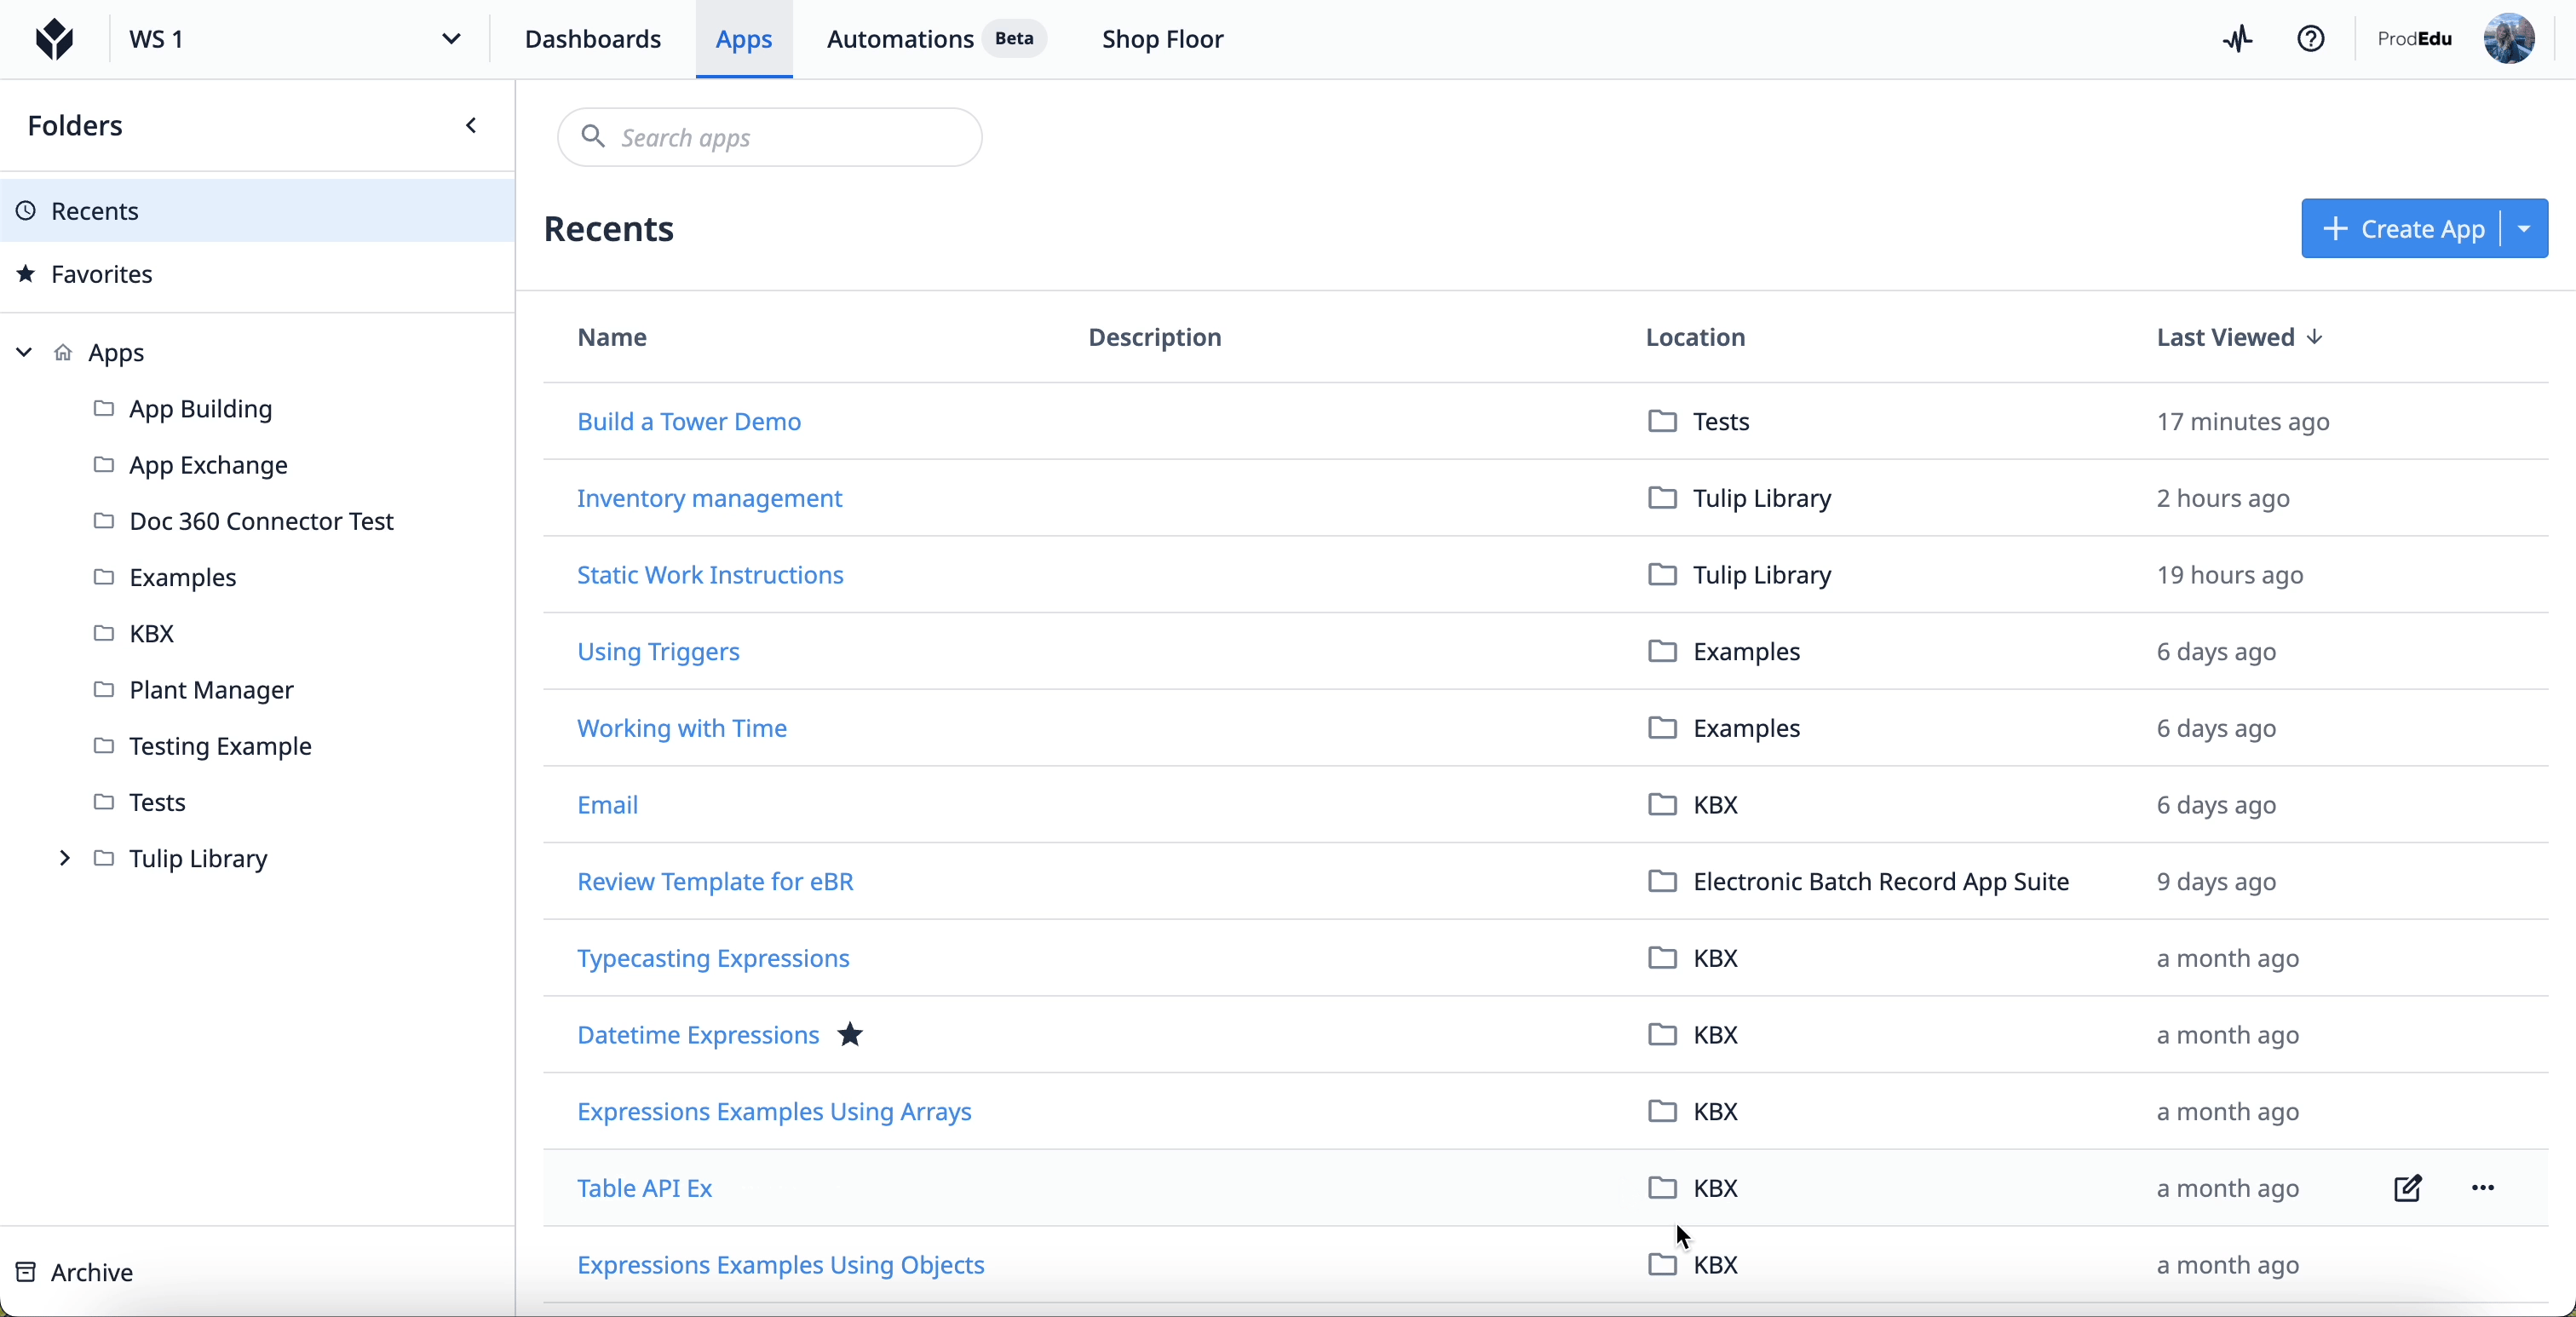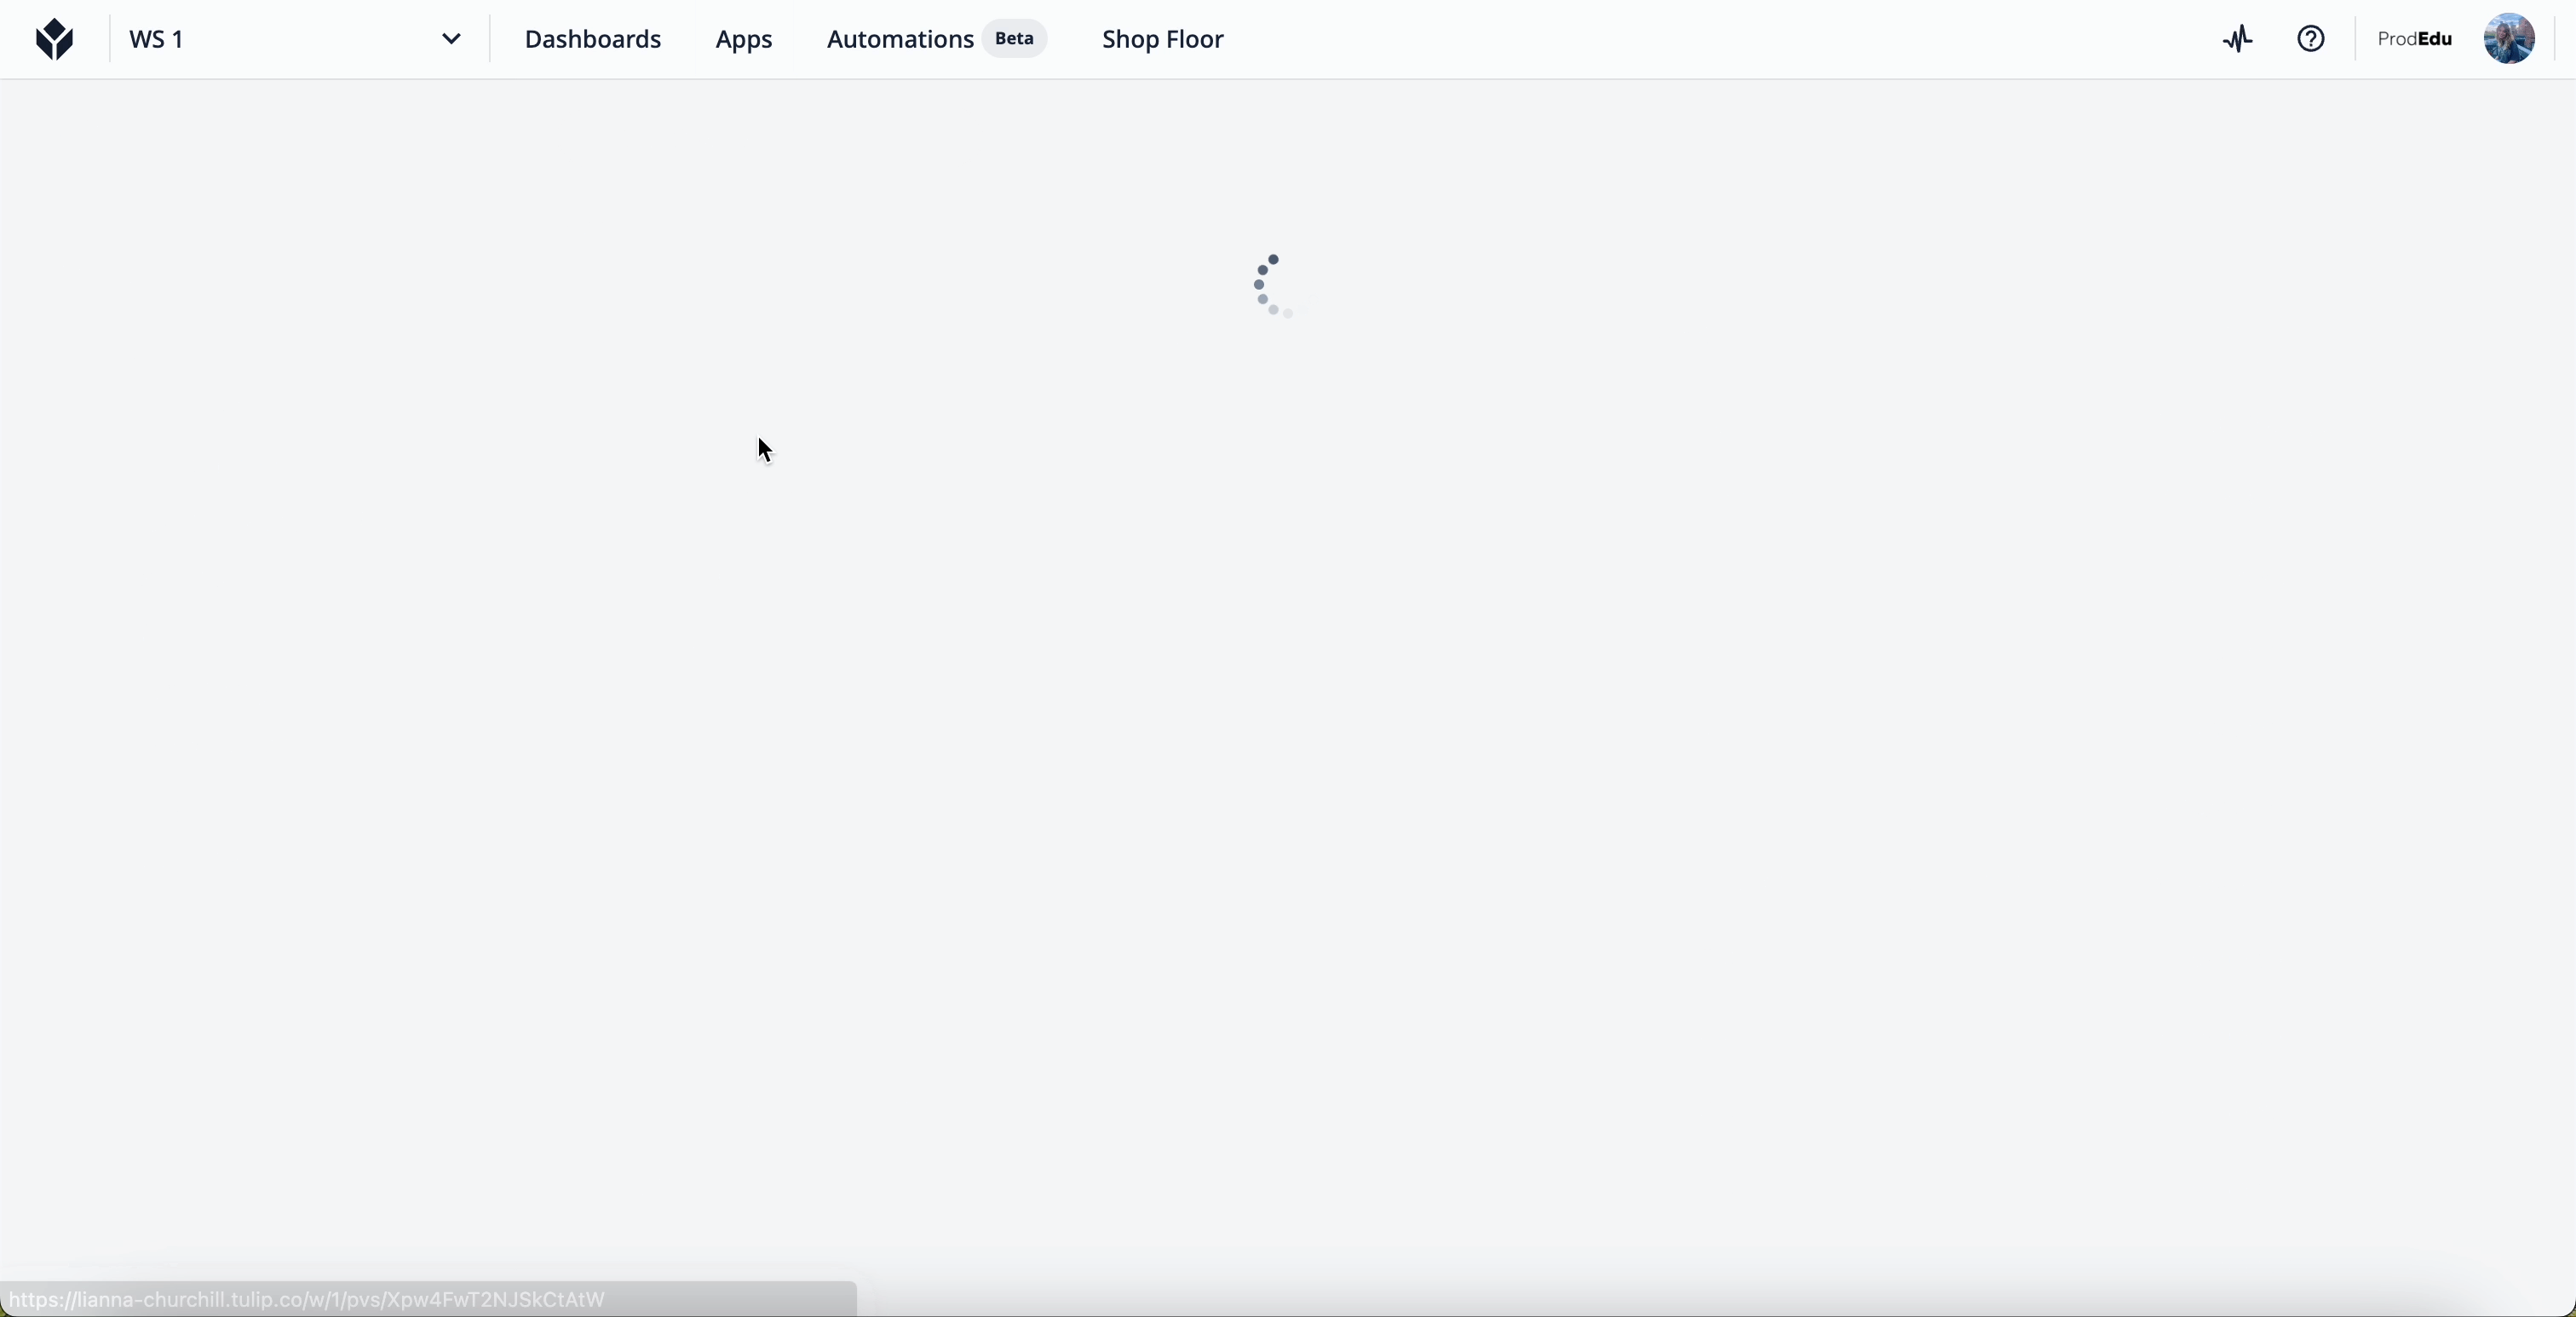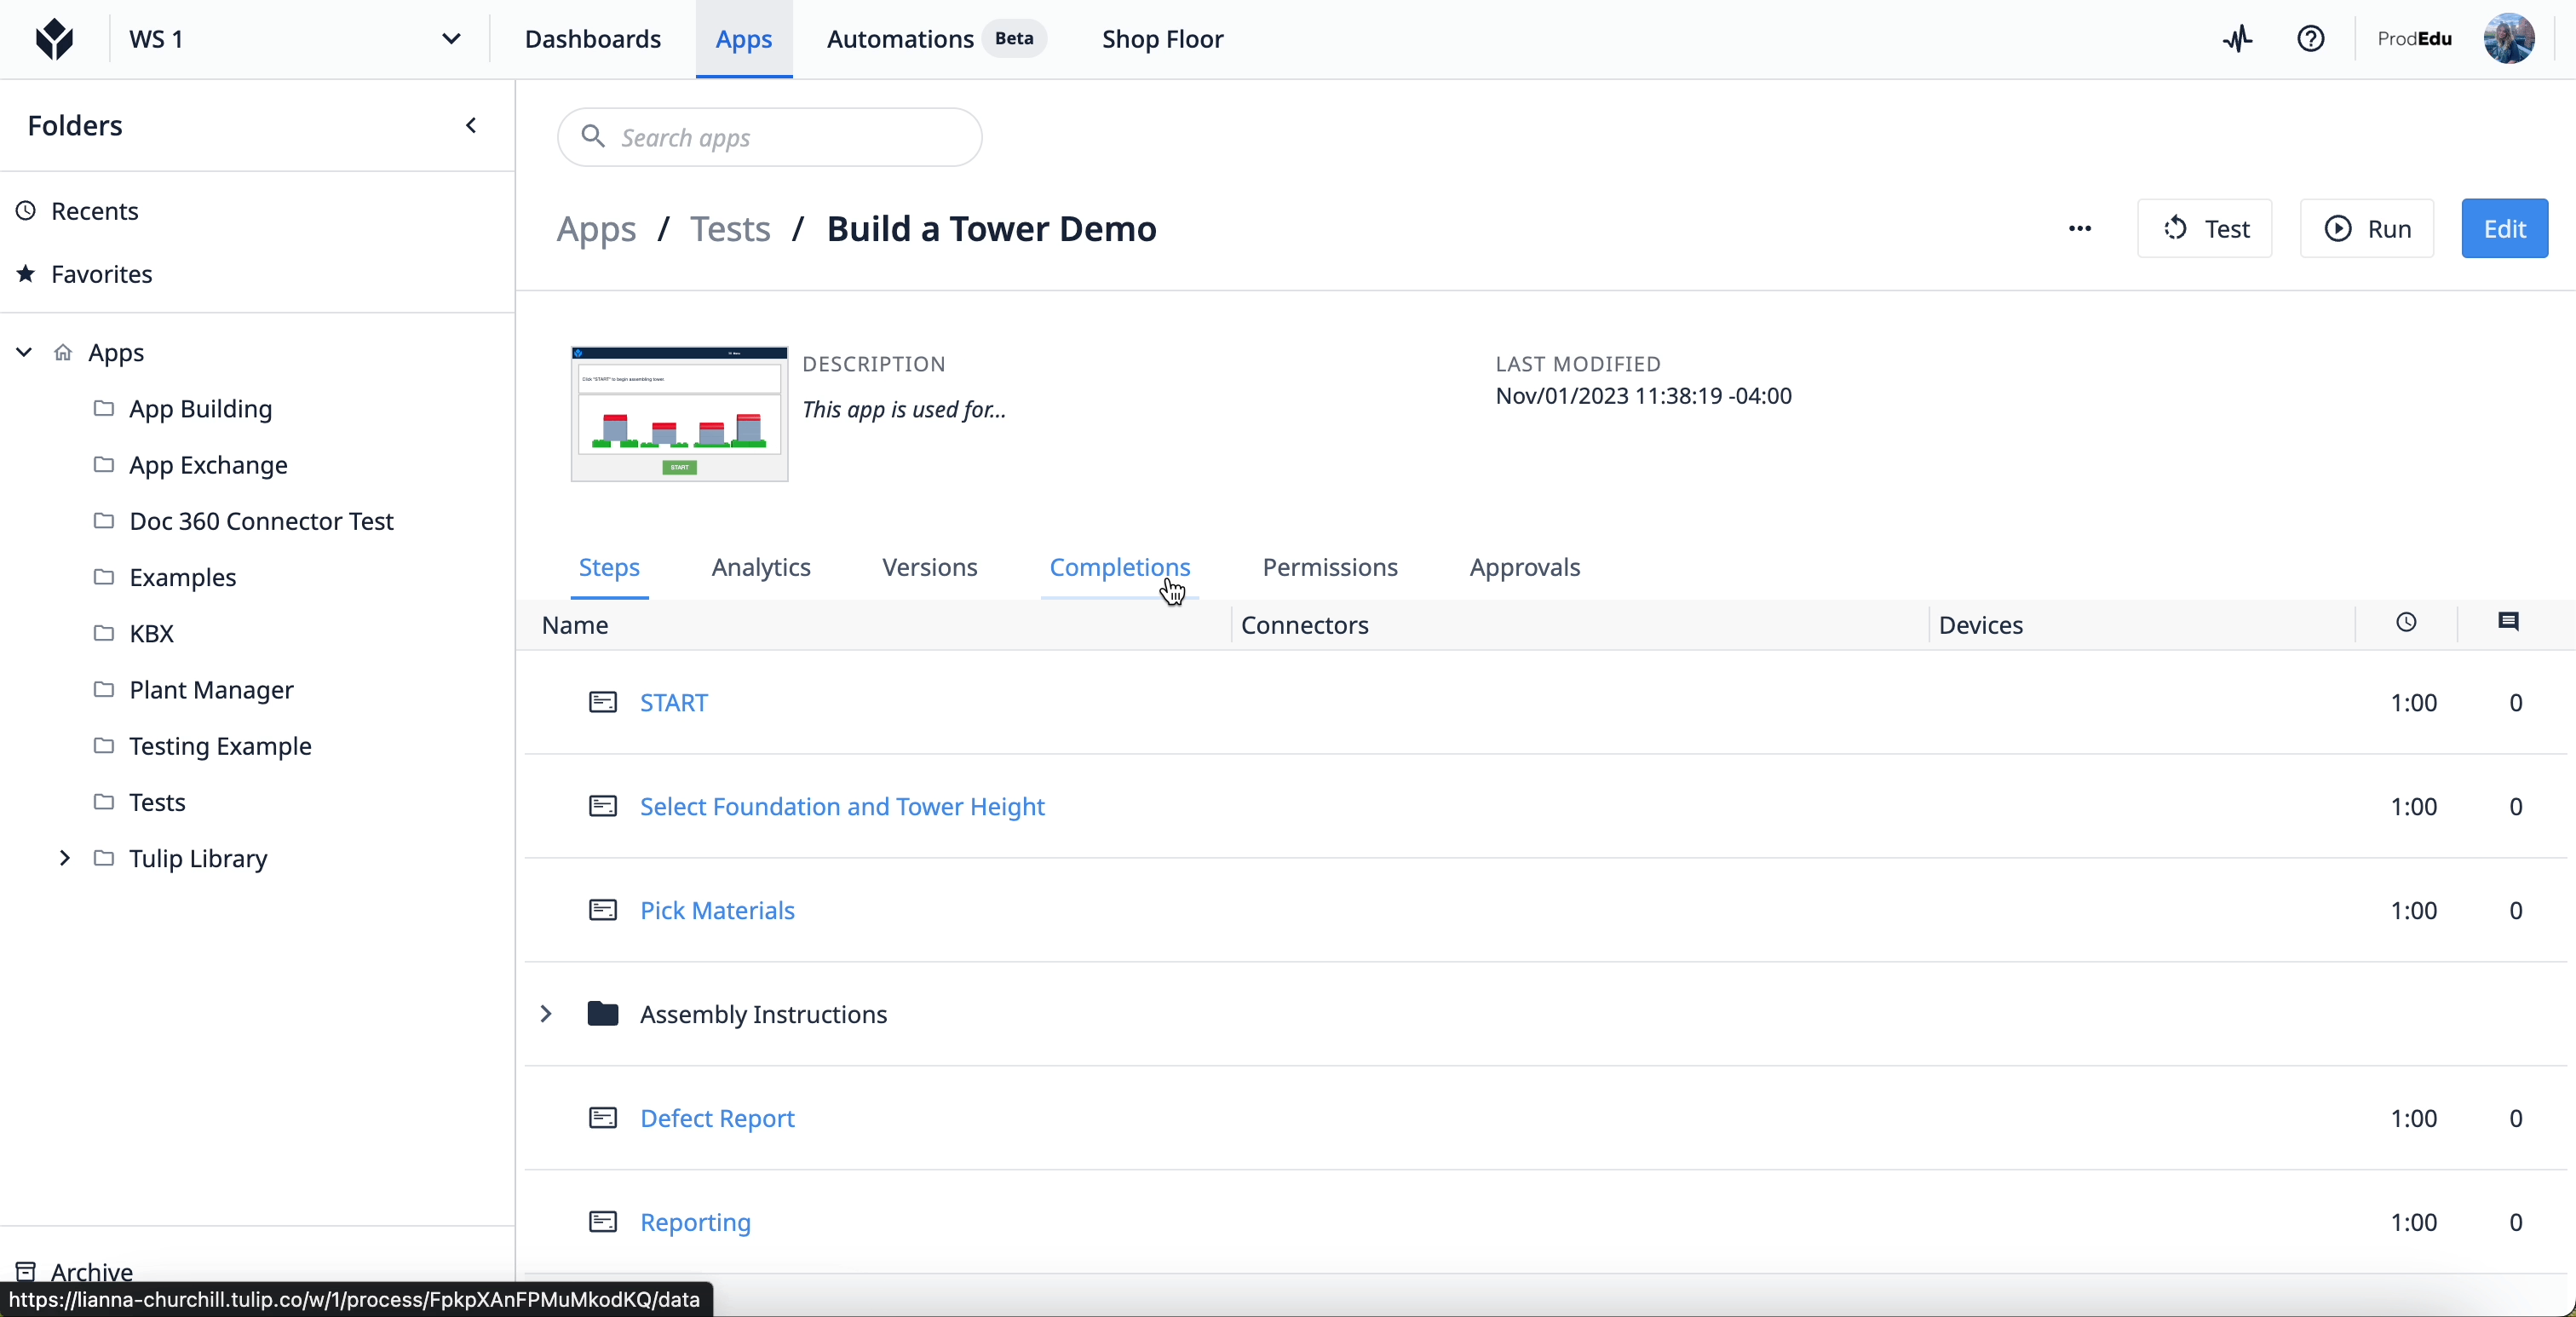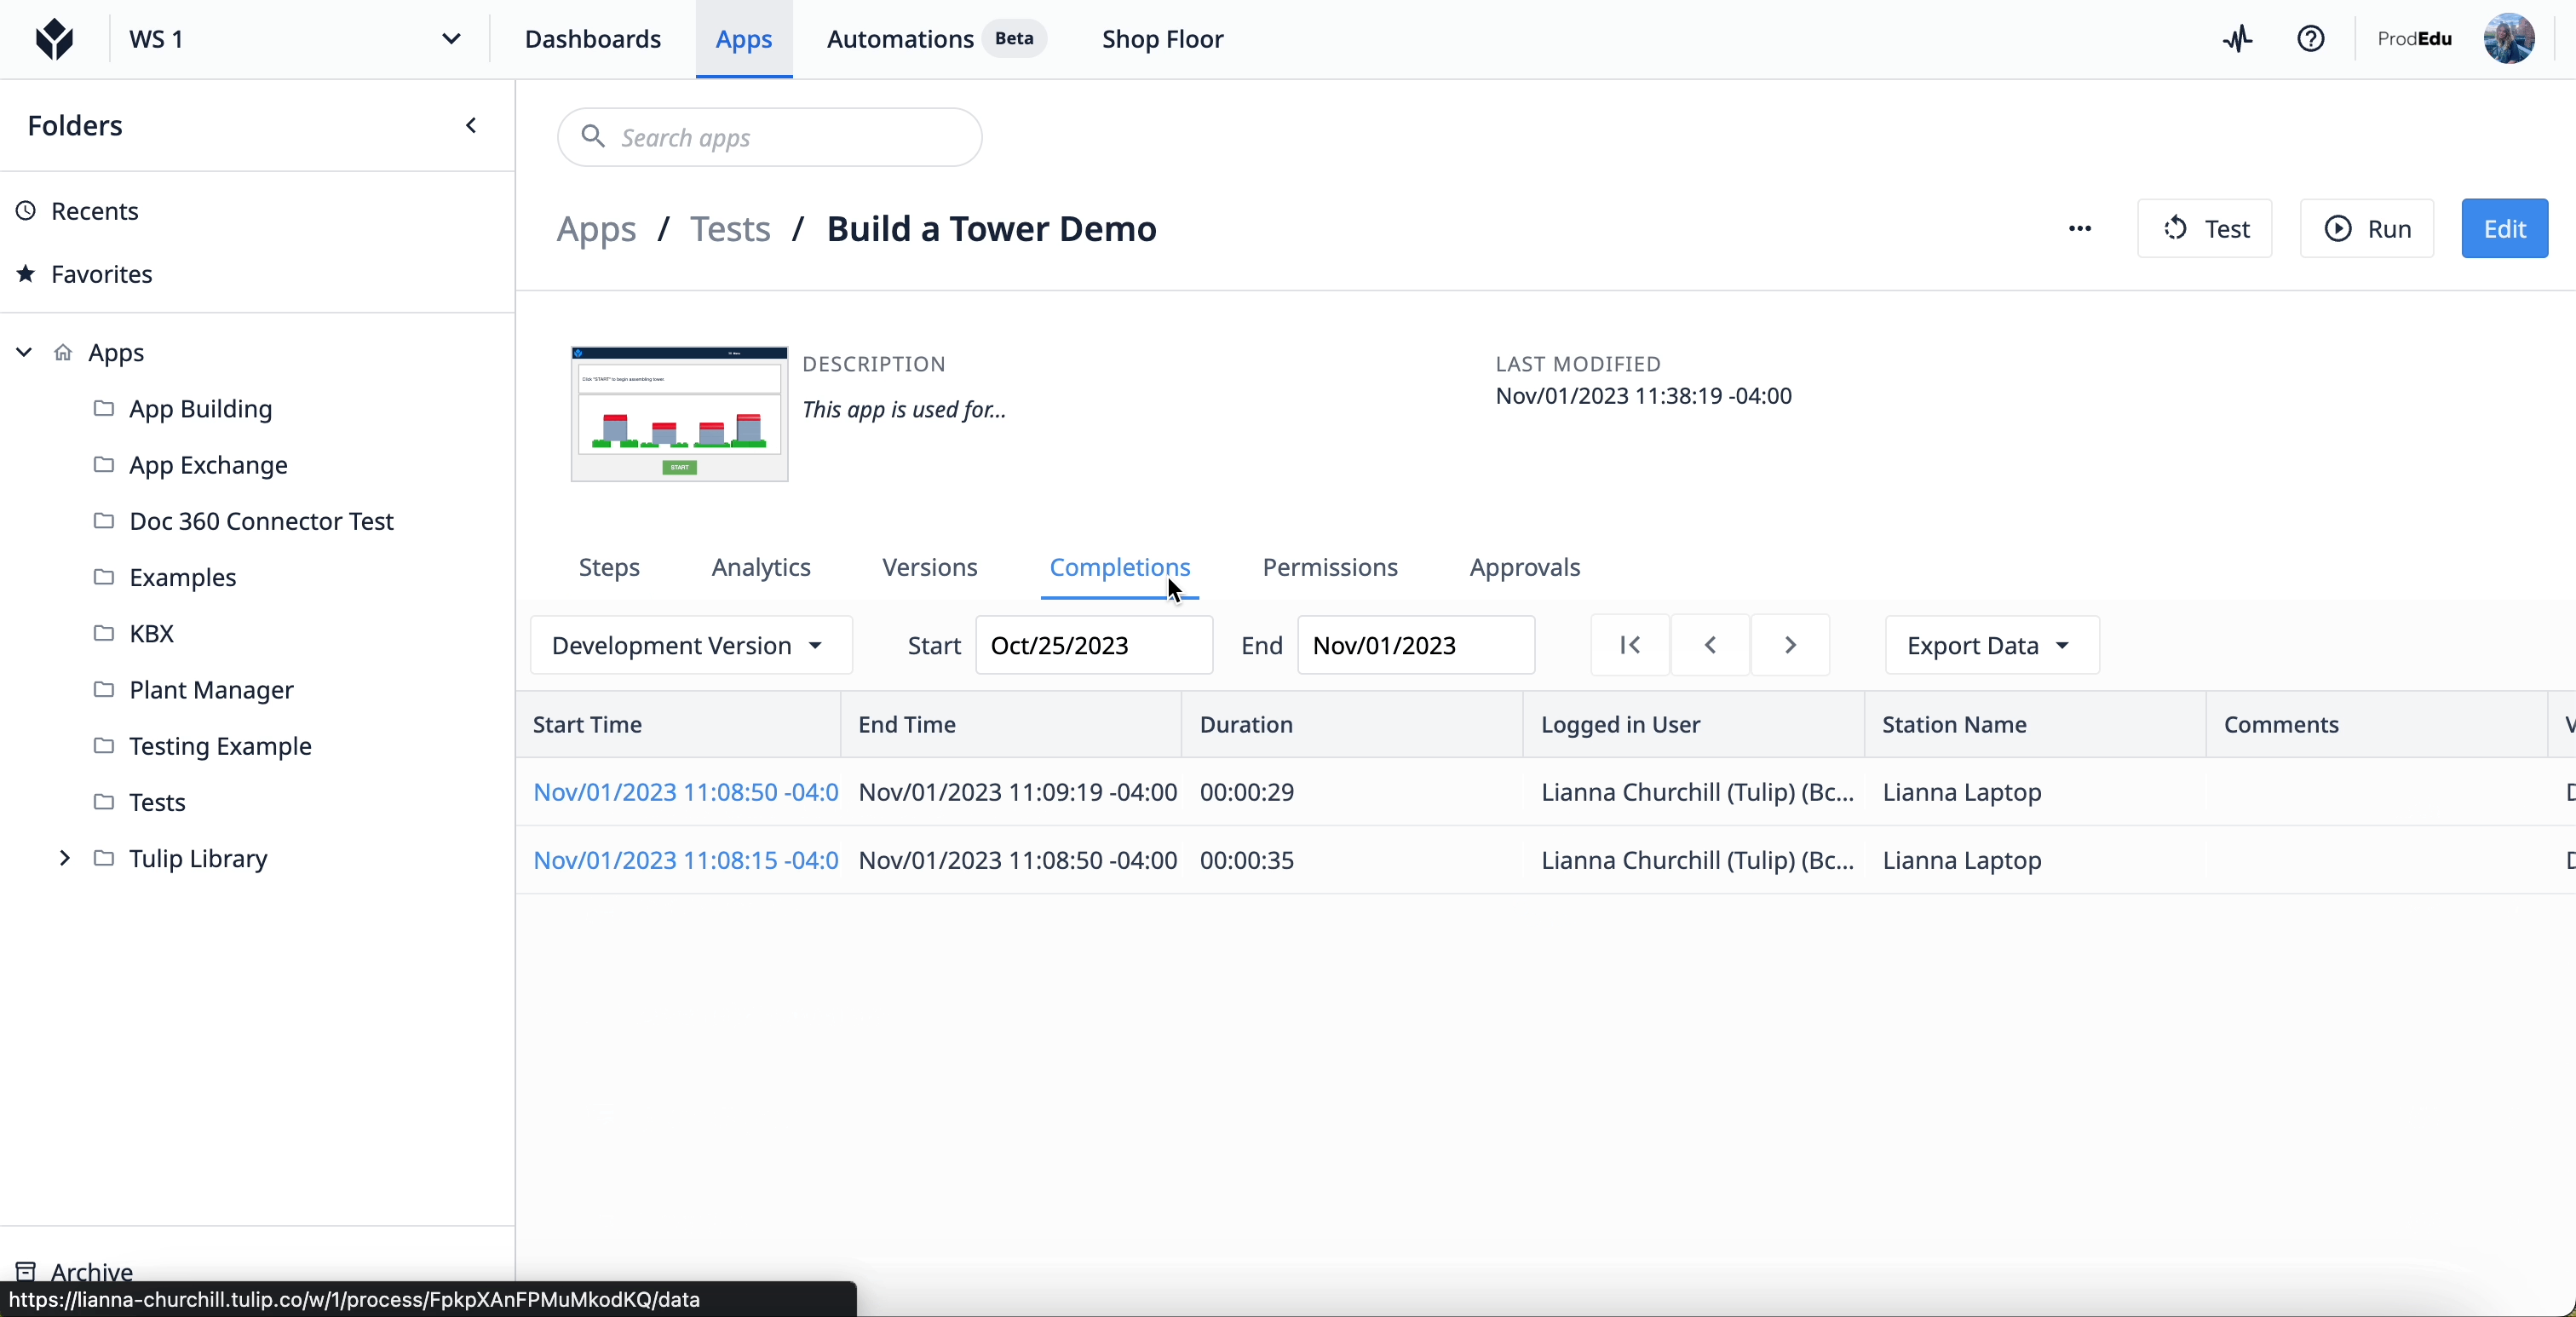
Узнайте больше о завершениях здесь.
Таблицы и завершения
Поскольку данные о завершении автоматически сохраняются в данных приложения, у вас может возникнуть вопрос: когда же лучше создать таблицу для хранения данных?
Данные о завершении являются неизменяемыми, тогда как поля в таблицах создаются в соответствии с вашими потребностями. Данные из таблиц также записываются из вашего приложения в соответствии с установленными вами триггерами и переменными; однако данные автозаполнения записываются только тогда, когда пользователь завершает работу с приложением или отменяет действие. В то время как данные автозаполнения обеспечивают простоту и мгновенную автоматизацию, данные из таблиц можно адаптировать специально для вашего приложения, а также гибко использовать их в нескольких приложениях.
Рекомендации по хранению данных
Поскольку хранение данных настраивается с учётом ваших рабочих процессов, существует множество способов организации структур данных. Tulip рекомендует несколько подходов, которые помогут вам создавать таблицы и хранить данные с учётом следующих целей:
- Данные легко доступны
- Данные доступны необходимым пользователям и системам
- Данные хранятся централизованно и не дублируются в других местах
Узнайте больше о лучших практиках Tulip по хранению данных здесь.
Применение модели данных
Tulip предлагает готовую универсальную модель данных, подходящую для различных сценариев использования, которую вы можете внедрить и адаптировать к своим конкретным потребностям:
- Общая модель данных для отдельных сценариев использования
- Общая модель данных для сценариев использования в фармацевтической отрасли
В Tulip универсальная модель данных представляет собой набор определенных таблиц, которые достаточно гибки для обмена данными между приложениями в рамках одного решения.
На приведенных ниже диаграммах показано, как таблицы обмениваются общими данными между приложениями.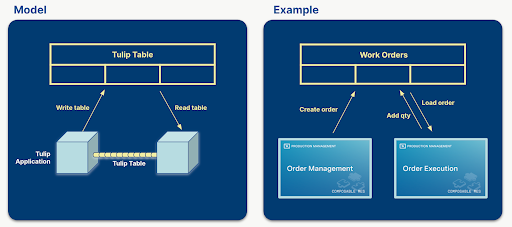
Общая модель данных предлагает стандартизированные и расширяемые схемы данных, оптимизируя обработку данных между системами за счет представления широко используемых концепций (например, «Рабочие заказы», «Единицы»). Это упрощает создание, сбор и анализ данных, а также открывает значительные возможности для улучшения управления данными.
Таблицы Tulip должны в первую очередь следовать модели «цифрового двойника», то есть таблицы должны как можно точнее отражать физический объект или производственный цех. Исторические данные приложений должны ограничиваться записями о завершении работ, чтобы таблицы не хранили основные данные и не дублировали данные из записей о завершении работ или внешних записей.
Узнайте больше о том, как использовать общую модель данных, здесь.
Пройдите курс «Общая модель данных » в Tulip University здесь.
Использование данных в приложениях
Чтобы отображать, редактировать или вводить данные из таблиц в ваших приложениях, вам сначала необходимо ознакомиться с виджетами. Input Widget позволяют редактировать и вводить данные, которые будут отображаться в вашей таблице. Встроенные виджеты отображают вашу информацию и могут быть настроены так, чтобы вы могли взаимодействовать с таблицами. Полное руководство по интеграции данных из таблиц см. здесь:
Данные о завершении задач можно отображать в приложениях с помощью Analytics. Сначала необходимо создать анализ на основе данных о завершении задач, а затем встроить этот анализ в приложение.
Подробнее об использовании данных о завершении для создания анализа см. здесь.
Как Tulip хранит ваши данные
Поскольку Tulip — это платформа самообслуживания, вы сами можете определять, какие из ваших данных передаются и хранятся. Облако Tulip хранит ваши данные в AWS, используя базу данных MongoDB или PostgreSQL. Tulip автоматически загружает все изображения, видео и PDF-файлы в хранилище Amazon S3, избавляя вас от необходимости беспокоиться об управлении хранилищем или отслеживании собранных данных.
Следующие шаги
Начните работать с данными под руководством экспертов Tulip:* Пошаговое руководство: создайте свою первую таблицу* Университетский курс «Работа с данными и таблицами»* Руководство «Понимание завершений приложений и таблиц»* Интеграция с внешними системами
Нашли ли вы то, что искали?
Вы также можете перейти на сайт community.tulip.co, чтобы задать свой вопрос или посмотреть, сталкивались ли другие пользователи с похожей проблемой!
