

本文概述
- 本文旨在探讨如何实施和维护一个兼具高性能、高可靠性、可组合性和可扩展性的 Tulip 表模型。
- 本文旨在提供以下内容:
- 建议将 Tulip Library 表资源作为典型用例的起点
- 设计附加表的最佳实践
- 构建高性能的表查询
- 规划并实施表记录归档策略
**受众:**应用程序开发人员、解决方案架构师、数据架构师、数据平台资源
关键概念
- 表是任何 Tulip 解决方案的基础组件,也是您组织内众多数据源之一。
- 设计良好的表模型能够构建出高性能、可组合且可扩展的解决方案。
- Tulip 库资源通过提供通用数据模型,帮助客户快速入门。
- 表存在某些限制——有些是设计上的(例如速率限制),有些则是实践中的(例如记录数阈值)。
- 设计高性能查询并归档高容量表(例如,超过 1000 万条记录)中的旧表记录,有助于保持解决方案的响应速度,从而直接提升操作员的工作效率和用户体验。
Tulip 在企业数据流中的典型定位
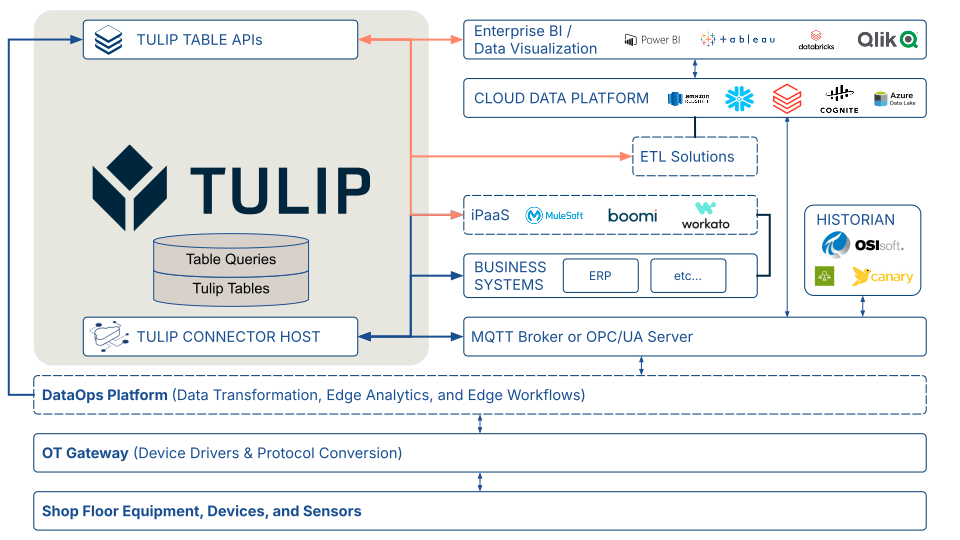
作为旨在提供“单一控制面板”功能的一线运营平台,您的 Tulip 解决方案托管关键制造数据,并与企业内的其他数据源集成。请参阅下图所示的架构图。 您的 Tulip 解决方案可通过连接器函数与企业业务系统交互,并通过配置为 Machine Data Source 的 MQTT 代理或 OPC UA 服务器与车间设备交互。 您的 iPaaS、ETL 解决方案以及企业数据可视化工具可通过表 API 与您的 Tulip 解决方案进行交互。
Tulip 常见数据模型资源
Tulip 提供了多项资源,旨在通过基于 Table 的通用数据模型加速解决方案开发。如需了解更多信息,请参阅:
关于通用数据模型的更多文章
Tulip 资源库中关于通用数据模型的资源
- Tulip 通用数据模型基础套件{
target=_blank} - 表套件
面向可扩展性的表优化
可扩展表设计的最佳实践
Tulip 库通用数据模型中的表是基于下文所述的最佳实践构建的。这些表及其背后的设计原则,为设计能够长期在 Tulip 逻辑中保持可扩展性和可用性的表提供了实用指南。
使表具有水平可扩展性(纵向扩展而非横向扩展)。
以“物料清单(BOM)”表为例。初次接触 Tulip 的应用开发者可能会倾向于创建一个“宽”表,为装配体中的每个组件单独设置一个“编号”列。虽然从短期来看这似乎很简单,但很快就会导致查询复用变得复杂、触发器逻辑负担加重,并限制该表在其他装配体中的适用性。
在下方的物料清单(BOM)表中,各列分别代表装配体的父级和组件。如果一个装配体包含五个组件,则该表包含五条记录。这种结构支持 n 级层次结构,因为一个子装配体可以在一种关系中充当“父级”,而在另一种关系中充当“组件”。
另请注意,此表设计既与产品无关,也与行业无关——它可存储从一顿饭到商用飞机等任何物品的物料清单。
物料清单表的推荐结构| 标签 | 字段类型 | 描述 || --- | --- | --- || ID | 文本 |*必填:*唯一标识符 || 父物料定义 ID | 文本 | 父装配体的唯一标识符材料定义的唯一标识符 || 父级材料描述 | 文本 | 父级材料的描述 || 组件材料定义 ID | 文本 | 组件材料定义的唯一标识符 || 组件材料描述 | 文本 | 待组装或消耗的材料的描述 || 组件数量 | 数字 | 待组装或消耗的材料的数量 || 组件计量单位 | 文本 | 组件 || 使用点 | 文本 | 材料将被组装或消耗的位置、工序或步骤 |
避免使用过宽的表格
虽然 Tulip 平台支持多达 200 列,但如果表格列数超过约 50 列,则可能表明需要重新考虑底层数据模型,以确保长期可扩展性。
避免在单个表中存储过多的不同“事物”
在此语境下,“事物”指特定用例类型的数据实体。例如,“设备与资产”表可能同时存储车间设备和需要校准跟踪的工具的相关信息。虽然将不同类型的实体存储在同一张表中在实际操作中可行,但只有在以下情况下才最为合适:
- 不同实体类型中记录 ID 的使用方式保持一致。
- 在“车间设备”和“已校准工具”的示例中,记录 ID 通常是公司的资产标签。
- 不同类型的实体共享约 50% 或更多的相同列。
- 如果不同类型的实体仅共享极少数相同的字段,则将它们存储在单独的表中可能更为合适。
- 实体类型之间不存在一对多关系。
- 例如,一个批次可能包含许多工作单。即使工作单和批次共享超过 50% 的相同列——且 ID 列既可作为工作单 ID,也可作为批次 ID ——它们之间的一对多关系仍会使查询设计和触发器逻辑变得复杂,从而导致表模型对解决方案构建者和数据使用者而言都难以理解。
- 利益相关者之间的共识。
- 解决方案开发人员和数据用户通常都认为,不同的实体类型在根本上是相似的(例如“车间设备”和“经校准的工具”)。
表的实际限制
速率限制
Tulip 对资产实施速率限制,旨在为用户提供一致且可靠的体验,具体涉及:
- 记录写入
- 记录删除
记录数量限制
Tulip 平台并未对表中的记录数设置硬性限制;但根据表的使用方式,实际上存在一定的限制。随着记录数量的增加,查询和聚合操作的性能通常会下降,这可能会影响应用程序的可靠性、运维人员的体验以及生产现场的生产效率。
已有记录显示,Tulip 客户的生产环境应用在处理超过 1000 万条记录的表时,仅由记录数量导致的性能影响微乎其微。
为可靠性和性能进行的表优化
尽量减少使用关联记录
在 Tulip 平台的早期版本中,包含多个关联记录列且记录数超过 100 万的表会出现显著的性能问题。虽然平台改进已大幅解决了这一问题,但出于以下几个原因,尽量减少或限制关联记录的使用仍是一项最佳实践:
- 大规模性能
- 通过 API 或 CSV 下载提取表记录
- 已知的功能限制(例如,无法根据关联表中的列对嵌入式交互式表格进行筛选)
构建高性能查询
查询性能取决于您使用的筛选类型
| 筛选类型 | 大规模性能 | 备注 |
|---|---|---|
| 等于 | 良好至优秀 | 在文本列上的精确匹配方面表现极佳。在可能的情况下,请优先使用“等于”筛选器,而非其他筛选类型。 |
| 以…开头 | 良好 | |
| 包含 | 一般至良好 | 最适合短列表(< 10 个项目)。随着列表规模增大,性能会下降。 |
| 为空 | 一般到中等 | 如果该列中大多数记录的值为空,则仅依赖此筛选条件的查询可能会很慢。 |
| 不为空 | 一般到中等 | 相反,如果大多数记录为 null,则该查询可以非常快速地返回结果。 |
| 以…结尾 | 一般到中等 | 不区分大小写。当结果限制较大且记录数较多时,性能会下降。 |
| 包含 | 一般到中等 | 不区分大小写。当结果范围较大且记录数较多时,性能会下降。 |
| 不等于 | 较差至一般 | |
| 不在 | 差至一般 | |
| 不以…开头 | 差到一般 | |
| 不以……结尾 | 差到一般 | |
| 不包含 | 差至一般 |
查询性能取决于筛选条件的数量
在设计查询时,应力求取得恰当的平衡:设置足够的筛选条件以返回精确的结果,同时确保查询在类似用例中可复用。通常不需要超过三到四个筛选条件。
If you are building a query with many filters, it may indicate that your table model lacks scalability and would benefit from a partial redesign.
始终设置适当的查询限制
在每个查询中都设置 LIMIT,使用能满足用例需求的最小值:
- **检查是否存在至少一条匹配记录:**1 条记录
- **报表生成:**建议改用 Analytics
- **其他用例:**根据所用的查询过滤条件,考虑实际可能检索或评估的记录最大数量,并将该数值作为 LIMIT 值(如果少于 1,000)。
为何这很重要:
使用默认限制值 1,000 的查询会尝试检索多达 1,000 条匹配记录——即使实际上只需少量记录。在仅需较小结果集即可满足需求的使用场景中,不必要的较大限制会消耗时间和资源。
表记录归档策略基础
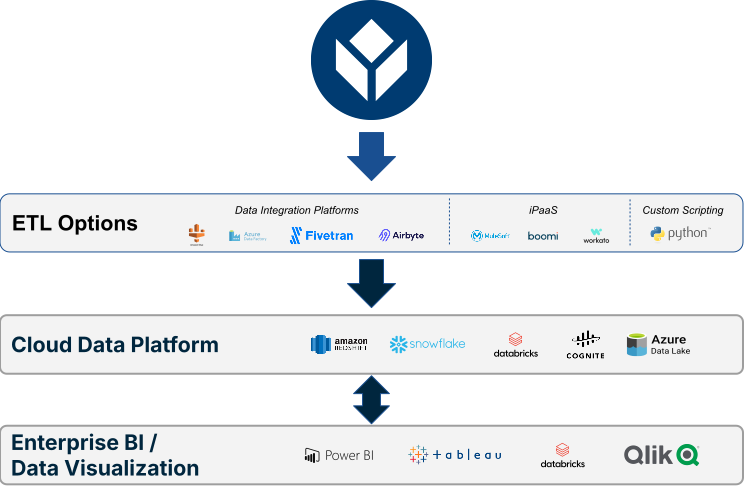
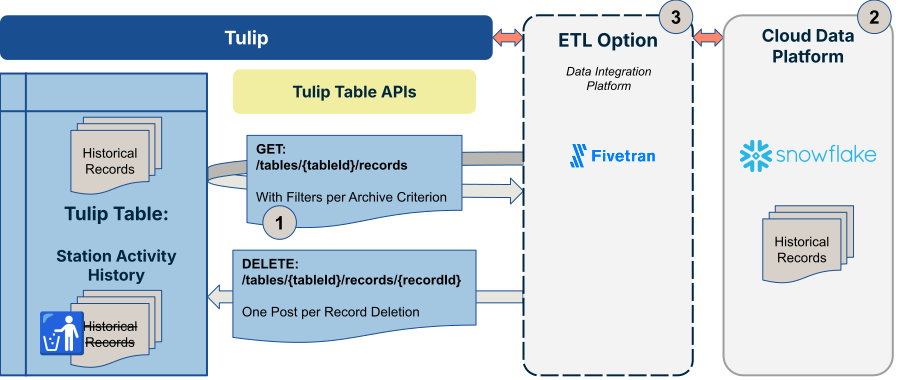
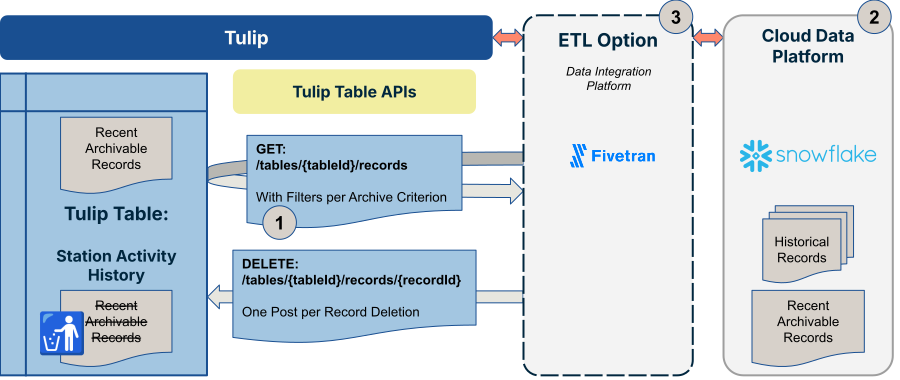
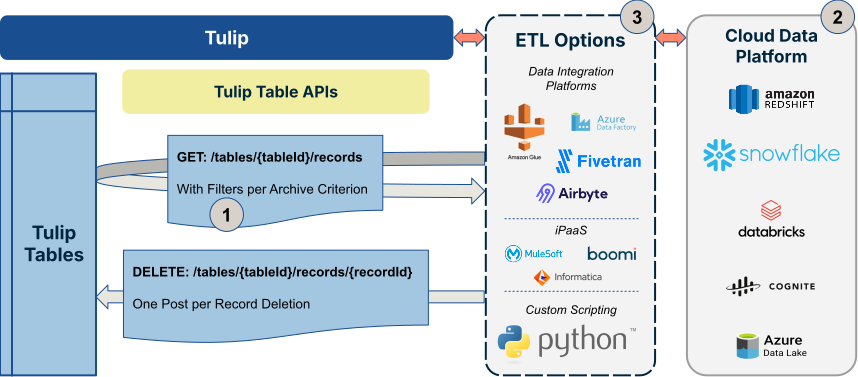
在本讨论中,“归档”是指从表中提取记录,通过 ETL 解决方案(例如 iPaaS 或数据集成平台)将其加载到云数据平台,随后从表中删除这些记录的过程。
背景与建议
- Tulip 并未对表中可存储的记录数设置硬性限制。
- Tulip 建议将单个表的记录数控制在几百万以内,因为随着记录数的增加,查询性能可能会下降。
- 如果使用关联记录或查询设计不当,性能问题会进一步加剧。
建议:
通过定期将较旧的记录迁移至云数据平台,将表中的记录数控制在 1000 万条以下。
规划和实施表记录归档
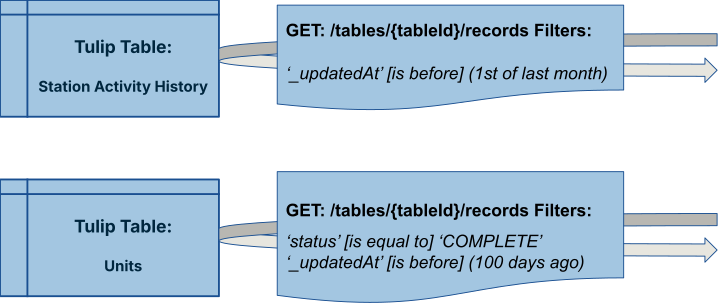
- 定义归档标准——确定用于识别每张表中符合归档条件的记录的查询过滤条件。
- *示例:*对于“车站状态历史”表,您可以归档所有日期早于上个月1日的记录。
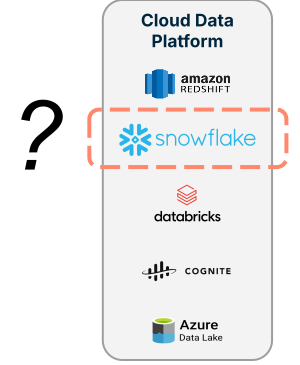
- 确定目标位置——选择目标云数据平台(例如:Redshift、Snowflake、Databricks 等)。
- 选择 ETL 解决方案——选择数据集成平台、第三方 iPaaS 或自定义 Python 脚本来执行记录迁移。
- 执行初始批量迁移——将所有符合步骤 1 中定义条件的数据记录分批迁移至步骤 2 中确定的目标平台。
- 安排定期增量迁移— 设置自动化流程,持续执行类似的记录迁移操作。一种常见的最佳实践是高频执行此类记录迁移,例如对于在典型工作日期间持续更新的表,每 15 分钟执行一次。
有关步骤 4 和 5 的更详细指导,请参阅下文的“表记录归档的最佳实践”。
关于 ETL 选项的补充资源:
- 数据集成平台
- Fivetran
- Microsoft Fabric
- 云数据平台
- Snowflake
- Cognite
归档表记录的最佳实践
将序列号用作游标
在对记录进行分页时,请使用序列号作为游标,而非基于偏移量的分页方式。
偏移量分页为何会失效:如果在同步运行期间插入或更新了记录,基于偏移量的分页可能会跳过或重复记录。基于序列号的游标是稳定的——无论是否存在并发写入,sequenceNumber > last_seen_seq 始终能返回正确的下一页。
表的同步分为两个阶段:首先是一次性批量加载以导入所有历史记录,随后是定期的增量迁移以捕获变更。这两个阶段都应使用序列号作为游标。
初始批量加载,随后进行增量迁移
在运行增量同步之前,请执行一次一次性批量加载——即完整加载所有历史记录。这将为目标端提供完整的基线数据。
操作模式:
- 从
last_seq = 0开始(若恢复中断的大批量加载,则从上次保存的检查点开始) - 按序列号升序检索页面
- 将每个页写入目标系统
- 每约 500 条记录保存一次检查点
- 当某页未返回任何记录时停止
遵守速率限制并使用指数退避
Tulip Tables API 对所有请求都实施速率限制。正确处理此限制分为两个层面:
主动限流 — 从一开始就合理安排请求间隔以保持在限流阈值内,而非等待被拒绝
被动退避 — 若在实施限流后仍收到 429 状态码(例如因其他并发进程共享同一工作区 API 配额所致),请降低 GET 请求频率并重试。
请参阅《Tulip API 速率限制指南》了解当前限制。请勿在 ETL 解决方案中硬编码限制值——应使用命名常量,以便在限制值发生变化时便于更新。
使用字段过滤器排除关联记录字段
表支持关联记录字段(tableLink 类型)——即一个表中引用另一个表中记录的字段。 当记录响应中包含 tableLink 字段时,Tulip API 必须在服务器端解析这些引用,从而产生级联的数据库查询。对于包含大量关联字段或记录数量庞大的表,这会给数据库带来巨大负载,并影响工作区中的所有用户。
解决方法:使用 fields 查询参数明确列出需要返回的字段,并完全排除 tableLink 字段。这需要少量前期准备工作——您需要先获取表结构以确定应包含哪些字段——但这是正确的做法,能带来更快、更轻量的查询。
基于检查点的错误恢复
网络故障、超时和意外错误在所难免。请设计连接器,使其能够优雅地恢复,而无需从头开始重启。
模式:
- 每处理约 500 条记录后,将最后一个成功处理的序列号持久化到持久化存储中
- 重启时,加载检查点并从 seq > checkpoint_seq 处继续处理
- 在目标存储中使用 upsert 逻辑(而非 insert)写入记录,以确保从检查点重新处理记录是安全的
处理记录删除
Tulip 表 API 不提供删除事件流。如果某条记录在 Tulip 中被永久删除,连接器无法检测到此情况——该记录会直接从 API 中消失,且不会发出任何通知。如何处理此情况取决于您希望外部目标执行什么操作。
- 场景 A:保持目标与 Tulip 同步(镜像删除操作)
- 如果您的目标是让目标系统反映 Tulip 的当前状态(包括已删除的记录)**,则请勿在 Tulip 中永久删除记录。**连接器无法传播它从未检测到的删除操作。
- 取而代之,请在表中添加一个布尔列(如“已归档”或“已删除”),并在需要将记录视为非活动状态时将其设为 true。由于这是字段更新,下一次增量同步会自动捕获该变化并写入目标系统,无需连接器进行特殊处理。随后,您可以在目标系统中过滤掉这些记录。
- **在 Tulip 中:**添加一个名为“archived”的布尔列,当需要将记录视为“非活动”时,请通过您的应用、函数或自动化将其更新,而不是直接删除该记录。
- **在目标系统中:**在查询和报表中使用“归档状态 = false”进行筛选,而不是默认所有同步的记录都是活跃的。
- 场景 B:为提升性能清理 Tulip,同时保留目标系统中的记录
- Tulip 表在保持精简时性能更佳。如果表变得非常大,彻底删除旧的或已完成记录是管理其大小的有效方法——例如,在保留期结束后归档已完成的工作单。
- 在此场景下,在 Tulip 中彻底删除记录是可行的。由于连接器永远不会收到删除事件,从 Tulip 中移除的记录在目标端将不再被更新——它们将按原样保留。目标端由此成为长期归档库,而 Tulip 则保持高性能。
- 此模式无需对连接器进行任何更改。只需确保下游消费者了解目标数据源可能包含在 Tulip 中已不存在的记录,并据此设计查询(例如,基于 completed_at 时间戳进行连接,而不是假设该记录在 Tulip 中仍然有效)。
进一步学习
- 有关此主题的更多指导,请参阅 Tulip 社区中的此讨论帖:Tulip 表连接器方法与最佳实践——与 Airbyte、FiveTran 及其他 ETL 工具协作
- Tulip 网络研讨会——干净的表,快速的应用程序:面向应用程序构建者的数据模型优化指南{
target=_blank}