

Présentation de cet article
- Cet article traite des principes fondamentaux de la mise en œuvre et de la maintenance d’un modèle de table Tulip qui soit : performant, fiable, modulable et évolutif.
- L’objectif de cet article est de fournir les éléments suivants :
- Des recommandations pour utiliser les ressources de tables de la bibliothèque Tulip comme point de départ pour des cas d’utilisation courants
- Les meilleures pratiques pour la conception de tables supplémentaires
- Création de requêtes de table performantes
- Planification et mise en œuvre d’une stratégie d’archivage des enregistrements de tables
Public visé : développeurs d’applications, architectes de solutions, architectes de données, responsables de plateformes de données
Concepts clés
- Les tables constituent un élément fondamental de toute solution Tulip et l’une des nombreuses sources de données au sein de votre organisation.
- Un modèle de table bien conçu permet de créer une solution performante, modulable et évolutive.
- Les ressources de la bibliothèque Tulip offrent aux clients un avantage de départ grâce à un modèle de données commun.
- Les tables présentent certaines limites — certaines liées à leur conception (par exemple, la limitation de débit) et d’autres liées à la pratique (par exemple, les seuils de nombre d’enregistrements).
- La conception de requêtes performantes et l’archivage des anciens enregistrements dans les tables à fort volume (par exemple, > 10 millions d’enregistrements) contribuent à maintenir une solution réactive, ce qui favorise directement la productivité des opérateurs et l’expérience utilisateur.
Position type de Tulip dans le flux de données d’entreprise
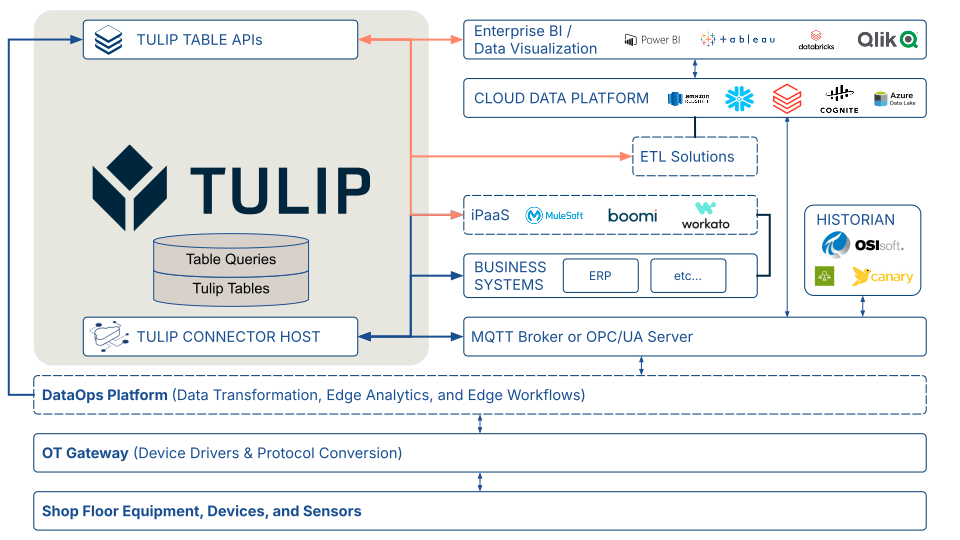
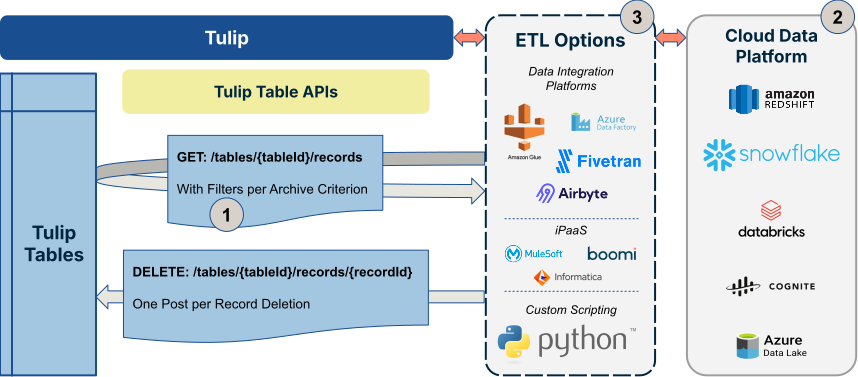
En tant que plateforme opérationnelle de première ligne conçue pour servir de « tableau de bord unique », votre solution Tulip héberge des données de fabrication critiques et s’intègre à d’autres sources de données à l’échelle de l’entreprise. Consultez le schéma d’architecture ci-dessous. Votre solution Tulip peut interagir avec les systèmes métier de l’entreprise via des fonctions de connexion, et avec les équipements de l’atelier via un courtier MQTT ou un serveur OPC UA configuré comme votre . Vos solutions iPaaS et ETL, ainsi que vos outils de visualisation des données d’entreprise, peuvent interagir avec votre solution Tulip via des API de table.
Ressources Tulip pour le modèle de données commun
Tulip fournit plusieurs ressources pour accélérer le développement de solutions à l’aide d’un modèle de données commun articulé autour des tables. Pour plus d’informations, consultez :
Articles supplémentaires sur le modèle de données commun
- Modèle de données commun
- Exemple : utilisation du modèle de données commun pour des cas d'utilisation spécifiques
- Exemple : utilisation du modèle de données commun pour des cas d'utilisation dans le secteur pharmaceutique
Ressources de la bibliothèque Tulip sur le modèle de données commun
- Kit de base du modèle de données commun Tulip{
target=_blank} - Kits de tables
Optimisation des tableaux pour l'évolutivité
Meilleures pratiques pour la conception de tables évolutives
Les tables du modèle de données commun de la bibliothèque Tulip s’appuient sur les bonnes pratiques décrites ci-dessous. Ces tables — ainsi que les principes qui les sous-tendent — constituent un guide pratique pour concevoir des tables qui restent évolutives et utilisables dans la logique Tulip sur le long terme.
Concevez des tables évolutives horizontalement (en hauteur plutôt qu’en largeur).
Prenons l’exemple d’une table de nomenclature. Un développeur débutant sur Tulip pourrait être tenté de créer une table « large » comportant une colonne « Numéro » distincte pour chaque composant d’un assemblage. Bien que cela puisse sembler simple à court terme, cela complique rapidement la réutilisation des requêtes, alourdit la logique des déclencheurs et limite l’applicabilité de la table à d’autres assemblages.
Dans le tableau de nomenclature (BOM) ci-dessous, les colonnes représentent le parent et le composant d’un assemblage. Si un assemblage comporte cinq composants, le tableau contient cinq enregistrements. Cette structure prend en charge une hiérarchie à n niveaux, puisqu’un sous-assemblage peut agir en tant que « parent » dans une relation et en tant que « composant » dans une autre.
Notez également que la conception de cette table est indépendante à la fois du produit et du secteur d’activité : elle pourrait stocker la nomenclature de n’importe quel élément, d’un repas à un avion commercial.
Structure recommandée pour une table de nomenclature| Libellé | Type de champ | Description || --- | --- | --- || ID | Texte | Obligatoire : identifiant unique || ID de définition du matériau parent | Texte | Identifiant unique de la définition du matériau de l’assemblage parent|| Description du matériau parent | Texte | Description du matériau parent || ID de la définition du matériau composant | Texte | Identifiant unique de la définition du matériau composant || Description du matériau composant | Texte | Description du matériau à assembler ou à consommer || Quantité du composant | Nombre | Quantité du matériau à assembler ou à consommer || Unité de mesure du composant | Texte | Unité de mesure du composant || Point d’utilisation | Texte | Emplacement, opération ou étape où le matériau sera assemblé ou consommé |
Évitez les tableaux très larges
Bien que la plateforme Tulip prenne en charge jusqu’à 200 colonnes, un tableau dépassant environ 50 colonnes peut indiquer que le modèle de données sous-jacent doit être repensé pour garantir une évolutivité à long terme.
Évitez de stocker trop d’« entités » distinctes dans un même tableau
Dans ce contexte, une « entité » désigne un type d’entité de données spécifique à un cas d’utilisation. Par exemple, un tableau « Équipements et actifs » peut stocker des informations à la fois sur les équipements d’atelier et sur les outils nécessitant un suivi d’étalonnage. Bien qu’il puisse être pratique de stocker différents types d’entités dans un même tableau, cette approche est particulièrement appropriée lorsque :
- L’utilisation des identifiants d’enregistrement est cohérente entre les différents types d’entités.
- Dans l’exemple des « équipements d’atelier » et des « outils étalonnés », l’identifiant d’enregistrement correspond généralement à l’étiquette d’inventaire de l’entreprise.
- Les différents types d’entités partagent environ 50 % ou plus des mêmes colonnes.
- Si les différents types d’entités ne partagent que très peu de colonnes communes, il est probablement plus judicieux de les stocker dans des tables distinctes.
- Il n’existe pas de relation « un-à-plusieurs » entre les types d’entités.
- Par exemple, un lot peut contenir plusieurs ordres de travail. Même si les ordres de travail et les lots partagent plus de 50 % des mêmes colonnes — et que la colonne « ID » sert soit d’identifiant d’ordre de travail, soit d’identifiant de lot —, la relation « un-à-plusieurs » entre eux peut compliquer la conception des requêtes et la logique des déclencheurs, ce qui se traduit par un modèle de table peu intuitif tant pour les développeurs de solutions que pour les utilisateurs des données.
- Consensus entre les parties prenantes.
- Les développeurs de la solution et les utilisateurs des données s’accordent généralement à dire que les différents types d’entités sont fondamentalement similaires (par exemple, « équipement d’atelier » et « outils étalonnés »).
Limites pratiques des tables
Limites de débit
Tulip applique des limites de débit aux ressources afin d’offrir une expérience cohérente et fiable aux utilisateurs en ce qui concerne :
- Écritures d'enregistrements
- Suppressions d'enregistrements
Pour en savoir plus sur les limites de débit des tables, cliquez ici.
Limites du nombre d'enregistrements
La plateforme Tulip n’impose pas de limite stricte sur le nombre d’enregistrements dans une table ; toutefois, une limite pratique existe en fonction de l’utilisation qui est faite de la table. À mesure que le nombre d’enregistrements augmente, il est fréquent d’observer une dégradation des performances au niveau des requêtes et des agrégations, ce qui peut affecter la fiabilité des applications, l’expérience des opérateurs et la productivité en atelier.
Il existe des cas documentés d’applications de production de clients Tulip fonctionnant sur des tables contenant plus de 10 millions d’enregistrements, avec un impact négligeable sur les performances attribuable au seul nombre d’enregistrements.
Optimisation des tables pour la fiabilité et les performances
Réduire au minimum l’utilisation des enregistrements liés
Dans les versions antérieures de la plateforme Tulip, les tables comportant plusieurs colonnes d’enregistrements liés et plus d’un million d’enregistrements présentaient d’importants problèmes de performances. Les améliorations apportées à la plateforme ont largement résolu ce problème, mais il reste recommandé de limiter ou de réduire l’utilisation des enregistrements liés pour plusieurs raisons :
- Performances à grande échelle
- Extraction d’enregistrements de table via des API ou un téléchargement CSV
- Limitations connues des fonctionnalités (par exemple, impossibilité de filtrer un tableau interactif intégré en fonction d’une colonne d’un tableau lié)
Création de requêtes performantes
Les performances des requêtes dépendent du ou des types de filtres utilisés
| Type de filtre | Performances à grande échelle | Remarques |
|---|---|---|
| égal | De bonne à excellente | Excellent pour la correspondance exacte sur les colonnes de texte. Utilisez les filtres « égal à » autant que possible plutôt que d’autres types de filtres. |
| commence par | Bon | |
| est dans | Passable à Bon | Idéal avec une liste courte (< 10 éléments). Les performances diminuent à mesure que la liste s'allonge. |
| est nul | Passable à modéré | Les requêtes s'appuyant uniquement sur ce filtre peuvent être lentes si la plupart des enregistrements comportent des valeurs nulles dans cette colonne. |
| n'est pas nul | Passable à modéré | À l'inverse, si la plupart des enregistrements sont nuls, cette requête peut renvoyer des résultats très rapidement. |
| se termine par | Passable à modéré | Insensible à la casse. Les performances diminuent lorsque les limites de résultats sont importantes et que le nombre d'enregistrements est élevé. |
| contient | Passable à modérée | Insensible à la casse. Les performances diminuent lorsque les limites de résultats sont élevées et que le nombre d'enregistrements est important. |
| n'est pas égal à | Mauvais à passable | |
| n'est pas dans | Mauvais à correct | |
| ne commence pas par | Mauvais à Passable | |
| ne se termine pas par | Mauvais à Passable | |
| ne contient pas | Mauvais à Passable |
Les performances de la requête dépendent du nombre de filtres
Lorsque vous concevez des requêtes, visez le juste équilibre : suffisamment de filtres pour obtenir des résultats précis tout en conservant la réutilisabilité de la requête dans des cas d’utilisation similaires. Il est rare d’avoir besoin de plus de trois ou quatre filtres.
If you are building a query with many filters, it may indicate that your table model lacks scalability and would benefit from a partial redesign.
Définissez toujours une limite de requête appropriée
Définissez une limite (LIMIT) pour chaque requête, en utilisant la plus petite valeur qui répond à votre cas d'utilisation :
- Vérification de l’existence d’au moins un enregistrement correspondant : 1 enregistrement
- Rapports : envisagez plutôt d'utiliser Analytics
- Autres cas d'utilisation : évaluez le nombre maximal réaliste d'enregistrements qui seraient récupérés ou évalués en fonction des filtres de requête utilisés, et utilisez ce nombre comme valeur LIMIT (s'il est inférieur à 1 000).
Pourquoi est-ce important ?
Une requête utilisant la limite par défaut de 1 000 tentera de récupérer jusqu’à 1 000 enregistrements correspondants, même si seule une poignée d’entre eux est nécessaire. Des limites inutilement élevées consomment du temps et des ressources dans les cas d’utilisation où un ensemble de résultats plus restreint suffirait.
Principes fondamentaux de la stratégie d’archivage des enregistrements de table
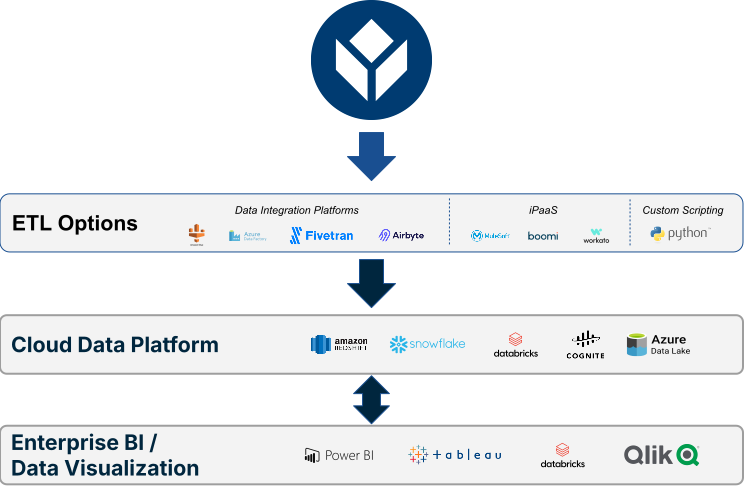
Dans le cadre de cette discussion, le terme « archivage » désigne le processus consistant à extraire des enregistrements d’une ou plusieurs tables, à les charger sur une plateforme de données dans le cloud via une solution ETL (par exemple, une iPaaS ou une plateforme d’intégration de données), puis de supprimer ces enregistrements de la ou des tables.
Contexte et recommandation
- Tulip n’impose pas de limite stricte quant au nombre d’enregistrements pouvant figurer dans les tables.
- Tulip recommande de limiter le nombre d’enregistrements par table à quelques millions, voire moins, car les performances des requêtes peuvent se dégrader à mesure que ce nombre augmente.
- Les problèmes de performances sont aggravés par l’utilisation d’enregistrements liés et de requêtes mal conçues.
Recommandation :
Maintenez le nombre d’enregistrements par table en dessous de 10 millions en transférant périodiquement les enregistrements les plus anciens vers une plateforme de données dans le cloud.
Planification et mise en œuvre de l’archivage des enregistrements des tables
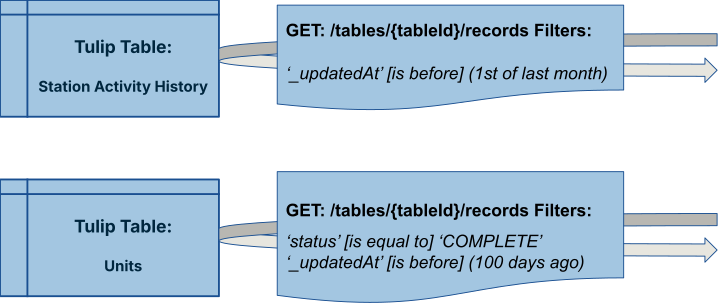
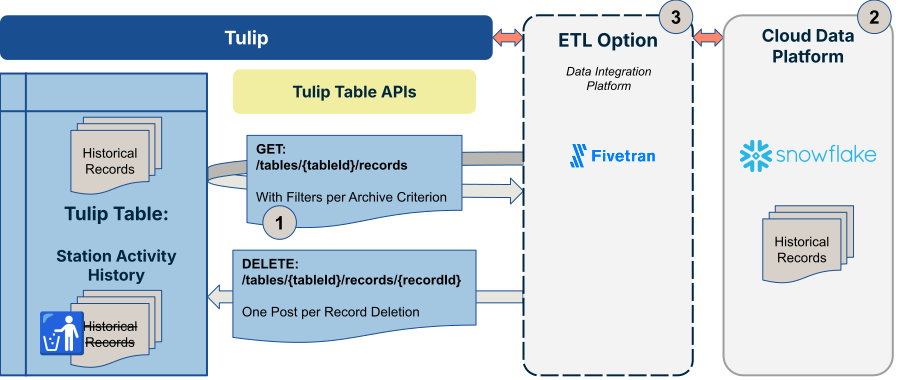
- Définissez les critères d’archivage: déterminez les filtres de requête qui identifient les enregistrements éligibles à l’archivage dans chaque table.
- Exemple : pour une table « Historique de l’état des stations », vous pouvez archiver tous les enregistrements antérieurs au premier du mois précédent.
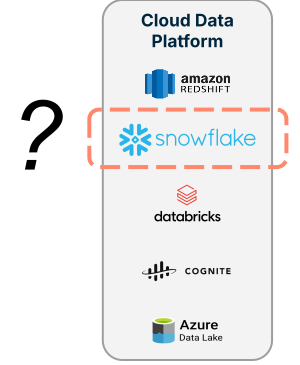
- Identifier la destination — sélectionnez votre plateforme de données cloud cible (par exemple, Redshift, Snowflake, Databricks, etc.).
- Sélectionnez une solution ETL — choisissez une plateforme d’intégration de données, une solution iPaaS tierce ou un script Python personnalisé pour effectuer les transferts d’enregistrements.
- Effectuez une migration initiale en masse — transférez par lots tous les enregistrements répondant aux critères définis à l'étape 1 vers la destination identifiée à l'étape 2.
- Planifiez des migrations incrémentielles récurrentes: mettez en place un processus automatisé pour effectuer régulièrement des transferts de données similaires. Une bonne pratique courante consiste à effectuer ces transferts très fréquemment, par exemple toutes les 15 minutes pour les tables mises à jour tout au long d’une journée de travail type.
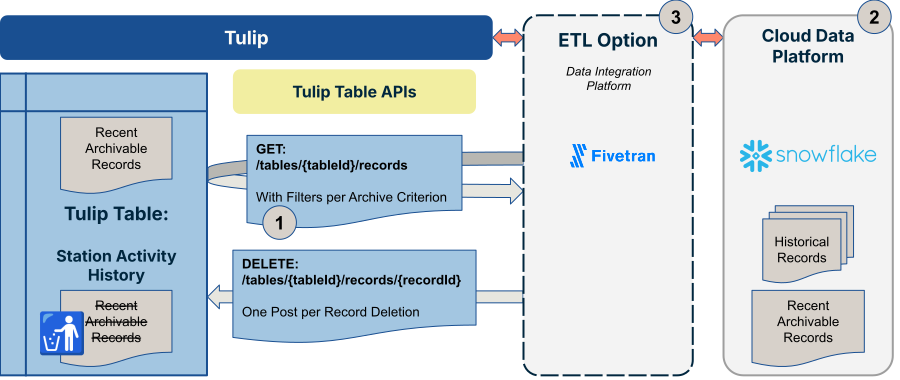
Pour des conseils plus détaillés sur les étapes 4 et 5, consultez la section « Bonnes pratiques en matière d’archivage des enregistrements de tables » ci-dessous.
Ressources supplémentaires sur les options ETL :
- Plateformes d’intégration de données
- Fivetran
- Microsoft Fabric
- Plateformes de données dans le cloud
- Snowflake
- Cognite
Bonnes pratiques en matière d'archivage des enregistrements de table
Utilisez le numéro de séquence comme curseur
Lors de la pagination des enregistrements, utilisez le numéro de séquence comme curseur plutôt qu’une pagination basée sur un décalage.
Pourquoi la pagination par décalage ne fonctionne pas : si des enregistrements sont insérés ou mis à jour pendant que votre synchronisation est en cours, la pagination basée sur un décalage peut sauter ou dupliquer des enregistrements. Les curseurs basés sur le numéro de séquence sont stables : sequenceNumber > last_seen_seq vous donne toujours la page suivante correcte, indépendamment des écritures simultanées.
La synchronisation d’une table s’effectue en deux phases : un chargement en masse unique pour charger tous les enregistrements historiques, suivi de migrations incrémentielles récurrentes pour capturer les modifications. Les deux doivent utiliser le numéro de séquence comme curseur.
Chargement en masse initial puis migrations incrémentielles
Avant d’exécuter des synchronisations incrémentielles, effectuez un chargement en masse unique — un chargement complet de tous les enregistrements historiques. Cela fournit à votre destination une base de référence complète.
Procédure :
- Commencez avec
last_seq = 0(ou le dernier point de contrôle enregistré si vous reprenez un chargement en masse interrompu) - Récupérez les pages triées par numéro de séquence croissant
- Écrivez chaque page dans la destination
- Enregistrez un point de contrôle tous les ~500 enregistrements
- S'arrêter lorsqu'une page ne renvoie aucun enregistrement
Respectez les limites de débit et utilisez le recul exponentiel
L'API Tulip Tables applique des limites de débit à toutes les requêtes. Pour gérer cela correctement, il existe deux approches :
Limitation proactive — espacez vos requêtes pour rester dans les limites dès le départ, plutôt que d’attendre qu’elles soient rejetées
Délai de réessai réactif — lorsqu’un code 429 est reçu malgré la régulation (par exemple en raison d’autres processus simultanés partageant le même quota API de l’espace de travail), réduisez la fréquence de vos requêtes GET et réessayez.
Consultez le guide des limites de débit de l’API Tulip pour connaître les limites actuelles. Ne codez pas en dur les valeurs de limite dans votre solution ETL — utilisez une constante nommée afin de pouvoir les mettre à jour facilement si les limites changent.
Exclure les champs d’enregistrements liés à l’aide du filtre « Fields »
Les tables prennent en charge les champs d’enregistrements liés (de type tableLink) — des champs d’une table qui font référence à des enregistrements d’une autre table. Lorsqu’un champ « tableLink » est inclus dans une réponse d’enregistrements, l’API Tulip doit résoudre ces références côté serveur, ce qui génère des requêtes en cascade sur la base de données. Sur les tables comportant de nombreux champs liés ou un grand nombre d’enregistrements, cela impose une charge importante à la base de données et affecte tous les utilisateurs de l’espace de travail.
La solution : utilisez le paramètre de requête fields pour lister explicitement les champs que vous souhaitez voir renvoyés, et excluez complètement les champs tableLink. Cela nécessite un peu de travail en amont — vous devez d’abord récupérer le schéma de la table pour savoir quels champs inclure — mais c’est la bonne approche et elle permet d’obtenir des requêtes plus rapides et plus légères.
Récupération après erreur basée sur des points de contrôle
Des pannes réseau, des délais d’expiration et des erreurs imprévues sont inévitables. Concevez votre connecteur de manière à ce qu’il puisse se rétablir en douceur sans devoir redémarrer depuis le début.
Modèle :
- Enregistrez le dernier numéro de séquence traité avec succès dans un stockage durable tous les ~500 enregistrements
- Au redémarrage, chargez le point de contrôle et reprenez à partir de seq > checkpoint_seq
- Écrivez les enregistrements à l’aide de la logique « upsert » (et non « insert ») dans la destination afin que le retraitement des enregistrements à partir du point de contrôle soit sécurisé
Gestion de la suppression d’enregistrements
L’API Tulip Tables ne fournit pas de flux d’événements de suppression. Si un enregistrement est définitivement supprimé dans Tulip, le connecteur n’a aucun moyen de le détecter : l’enregistrement disparaît simplement de l’API sans aucune notification. La manière dont vous gérez cela dépend de ce que vous souhaitez que la destination externe fasse.
- Scénario A : maintenir la destination synchronisée avec Tulip (refléter les suppressions)
- Si votre objectif est que la destination reflète l’état actuel de Tulip — y compris les suppressions — , ne supprimez pas définitivement les enregistrements dans Tulip. Le connecteur ne peut pas propager une suppression qu’il n’a jamais détectée.
- Ajoutez plutôt une colonne booléenne à la table — « archivé » ou « supprimé » — et définissez-la sur « true » lorsqu’un enregistrement doit être considéré comme inactif. Comme il s’agit d’une mise à jour de champ, la prochaine synchronisation incrémentielle la détectera et l’écrira automatiquement dans la destination, sans nécessiter de logique particulière de la part du connecteur. Vous pourrez ensuite filtrer ces enregistrements au niveau de la destination.
- Dans Tulip : ajoutez une colonne booléenne « archived » et mettez-la à jour via votre application, une fonction ou une automatisation lorsque l’enregistrement doit être considéré comme « inactif », plutôt que de le supprimer.
- Dans la destination : filtrez sur « archived = false » dans vos requêtes et rapports plutôt que de partir du principe que tous les enregistrements synchronisés sont actifs.
- Scénario B : Nettoyer Tulip pour améliorer les performances, conserver les enregistrements dans la destination
- Les tables Tulip fonctionnent mieux lorsqu’elles sont allégées. Si une table devient très volumineuse, la suppression définitive des enregistrements anciens ou terminés est un moyen valable de gérer sa taille — par exemple, en archivant les bons de travail terminés après une période de conservation.
- Dans ce scénario, la suppression définitive dans Tulip est tout à fait acceptable. Comme le connecteur ne reçoit jamais d’événement de suppression, les enregistrements supprimés de Tulip ne sont tout simplement plus jamais mis à jour dans la destination : ils sont conservés tels quels. La destination devient ainsi une archive à long terme tandis que Tulip conserve ses performances.
- Aucune modification du connecteur n’est nécessaire pour ce modèle. Assurez-vous simplement que les consommateurs en aval comprennent que la destination peut contenir des enregistrements qui n’existent plus dans Tulip, et qu’ils conçoivent leurs requêtes en conséquence (par exemple, en effectuant une jointure sur un horodatage « completed_at » plutôt que de supposer que l’enregistrement est toujours actif dans Tulip).
Pour en savoir plus
- Vous trouverez davantage de conseils sur ce sujet sur la communauté Tulip dans ce fil de discussion : Approches et bonnes pratiques relatives au connecteur de tables Tulip — Utilisation d’Airbyte, FiveTran et d’autres outils ETL
- Webinaire Tulip - Des tables propres, des applications rapides : guide de l’optimisation du modèle de données à l’intention des développeurs d’applications{
target=_blank}
{{snippet.Avez-vous trouvé ce que vous cherchiez ?}}