

Resumen de este artículo
- El alcance de este artículo aborda los fundamentos de la implementación y el mantenimiento de un modelo de tabla de Tulip que sea: eficaz, fiable, combinable y escalable.
- El objetivo de este artículo es ofrecer lo siguiente:
- Recomendaciones para utilizar los recursos de tablas de Tulip Library como punto de partida para casos de uso típicos
- Buenas prácticas para el diseño de tablas adicionales
- Creación de consultas de tablas de alto rendimiento
- Planificación e implementación de una estrategia de archivo de registros de tablas
Destinatarios: desarrolladores de aplicaciones, arquitectos de soluciones, arquitectos de datos y personal de plataformas de datos
Conceptos clave
- Las tablas son un componente fundamental de cualquier solución de Tulip y una de las muchas fuentes de datos de su organización.
- Un modelo de tabla bien diseñado permite crear una solución eficiente, modulable y escalable.
- Los recursos de la biblioteca de Tulip ofrecen a los clientes una ventaja inicial gracias a un modelo de datos común.
- Las tablas tienen ciertas limitaciones: algunas por diseño (por ejemplo, la limitación de tasa) y otras por práctica (por ejemplo, los umbrales de recuento de registros).
- Diseñar consultas de alto rendimiento y archivar los registros más antiguos en tablas de gran volumen (por ejemplo, más de 10 millones de registros) ayuda a mantener una solución ágil, lo que favorece directamente la productividad de los operadores y la experiencia del usuario.
Posición típica de Tulip en el flujo de datos de la empresa
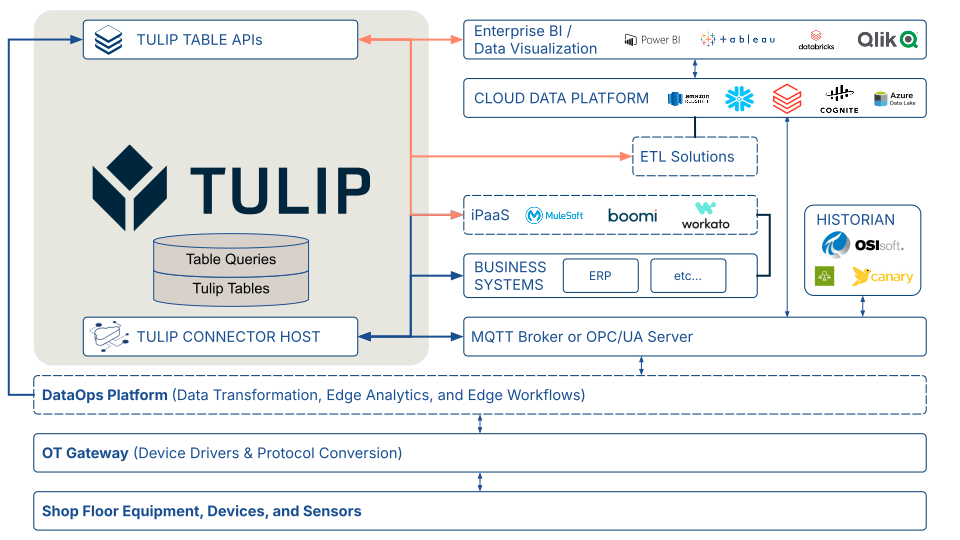
Como plataforma de operaciones de primera línea diseñada para actuar como un único panel de control, tu solución de Tulip aloja datos críticos de fabricación y se integra con otras fuentes de datos de toda la empresa. Observa el diagrama de arquitectura que aparece a continuación. Su solución Tulip puede interactuar con los sistemas empresariales a través de funciones de conector, y con los equipos de la planta de producción mediante un broker MQTT o un servidor OPC UA configurado como su . Sus soluciones iPaaS y ETL, así como las herramientas de visualización de datos de la empresa, pueden interactuar con su solución Tulip a través de las API de tablas.
Recursos de Tulip para el modelo de datos común
Tulip ofrece varios recursos para acelerar el desarrollo de soluciones con un modelo de datos común basado en las tablas. Para obtener más información, consulta:
Artículos adicionales sobre el modelo de datos común
- Modelo de datos común
- Ejemplo: uso del modelo de datos común para casos de uso concretos
- Ejemplo: uso del modelo de datos común para casos de uso del sector farmacéutico
Recursos de la biblioteca de Tulip sobre el modelo de datos común
- Kit básico del modelo de datos común de Tulip{
target=_blank} - Kits de tablas
Optimización de tablas para la escalabilidad
Prácticas recomendadas para el diseño de tablas escalables
Las tablas del modelo de datos común de la biblioteca de Tulip se han creado siguiendo las mejores prácticas que se describen a continuación. Estas tablas —y los principios en los que se basan— sirven de guía práctica para diseñar tablas que sigan siendo escalables y utilizables en la lógica de Tulip a largo plazo.
Diseña las tablas para que sean escalables horizontalmente (altas, no anchas).
Pensemos en una tabla de lista de materiales. Un desarrollador novato de aplicaciones de Tulip podría sentirse tentado a crear una tabla «ancha» con una columna «Número» independiente para cada componente de un conjunto. Aunque esto pueda parecer sencillo a corto plazo, complica rápidamente la reutilización de consultas, sobrecarga la lógica de los desencadenadores y limita la aplicabilidad de la tabla a otros conjuntos.
En la tabla de lista de materiales (BOM) que se muestra a continuación, las columnas representan el elemento principal y los componentes de un conjunto. Si un conjunto tiene cinco componentes, la tabla contiene cinco registros. Esta estructura admite una jerarquía de n niveles, ya que un subconjunto puede actuar como «elemento principal» en una relación y como «componente» en otra.
Obsérvese también que el diseño de esta tabla es independiente tanto del producto como del sector: podría almacenar la lista de materiales de cualquier cosa, desde una comida hasta un avión comercial.
Estructura recomendada para una tabla de lista de materiales| Etiqueta | Tipo de campo | Descripción || --- | --- | --- || ID | Texto | Obligatorio: identificador único || ID de definición del material padre | Texto | Identificador único de la definición del material del ensamblaje padre|| Descripción del material padre | Texto | Descripción del material padre || ID de la definición del material componente | Texto | Identificador único de la definición del material componente || Descripción del material componente | Texto | Descripción del material que se va a montar o consumir || Cantidad del componente | Número | Cantidad del material que se va a montar o consumir || Unidad de medida del componente | Texto | Unidad de medida del componente || Punto de uso | Texto | Ubicación, operación o paso en el que se montará o consumirá el material |
Evita las tablas muy anchas
Aunque la plataforma Tulip admite hasta 200 columnas, una tabla que supere las 50 columnas aproximadamente puede ser una señal de que es necesario replantearse el modelo de datos subyacente para garantizar la escalabilidad a largo plazo.
Evita almacenar demasiadas «cosas» distintas en una sola tabla
En este contexto, una «cosa» se refiere a un tipo de entidad de datos específico de un caso de uso. Por ejemplo, una tabla de «Equipos y activos» podría almacenar información tanto sobre los equipos de la planta de producción como sobre las herramientas que requieren un seguimiento de calibración. Aunque puede resultar práctico almacenar diferentes tipos de entidades en la misma tabla, hacerlo resulta más adecuado cuando:
- El uso del ID de registro es coherente en todos los tipos de entidad.
- En el ejemplo de «equipos de taller» y «herramientas calibradas», el identificador de registro suele ser la etiqueta de activo de la empresa.
- Los diferentes tipos de entidades comparten aproximadamente el 50 % o más de las mismas columnas.
- Si los distintos tipos de entidades solo comparten unas pocas columnas, probablemente sea más adecuado almacenarlas en tablas separadas.
- No existe una relación uno a muchos entre los tipos de entidad.
- Por ejemplo, un lote puede contener muchas órdenes de trabajo. Incluso si las órdenes de trabajo y los lotes comparten más del 50 % de las mismas columnas —y la columna de identificación sirve como identificador de orden de trabajo o de lote— —, la relación uno a muchos entre ellas puede complicar el diseño de consultas y la lógica de los desencadenadores, lo que da lugar a un modelo de tabla poco intuitivo tanto para los creadores de soluciones como para los usuarios de los datos.
- Consenso entre las partes interesadas.
- Los desarrolladores de la solución y los usuarios de los datos suelen coincidir en que los diferentes tipos de entidad son fundamentalmente similares (p. ej., «equipos de taller» y «herramientas calibradas»).
Limitaciones prácticas de las tablas
Límites de frecuencia
Tulip aplica límites de frecuencia a los activos para ofrecer una experiencia coherente y fiable a los usuarios en lo que respecta a:
- Escrituras de registros
- Eliminaciones de registros
Más información sobre los límites de frecuencia de las tablas aquí.
Límites de número de registros
La plataforma Tulip no impone un límite estricto al número de registros de una tabla; sin embargo, existe un límite práctico que depende del uso que se le dé a la tabla. A medida que aumenta el número de registros, es habitual observar una disminución del rendimiento en las consultas y las agregaciones, lo que puede afectar a la fiabilidad de la aplicación, la experiencia del operador y la productividad en la planta de producción.
Existen casos documentados de aplicaciones de producción de clientes de Tulip que operan con tablas que superan los 10 millones de registros, con un impacto insignificante en el rendimiento atribuible únicamente al número de registros.
Optimización de tablas para garantizar la fiabilidad y el rendimiento
Minimizar el uso de registros vinculados
En versiones anteriores de la plataforma Tulip, las tablas con varias columnas de registros vinculados y más de un millón de registros presentaban problemas de rendimiento significativos. Las mejoras de la plataforma han solucionado en gran medida este problema, pero sigue siendo una buena práctica minimizar o mitigar el uso de registros vinculados por varias razones:
- Rendimiento a gran escala
- Extracción de registros de tablas a través de API o descarga en formato CSV
- Limitaciones conocidas de las funciones (por ejemplo, la imposibilidad de filtrar una tabla interactiva incrustada basándose en una columna de una tabla vinculada)
Creación de consultas eficaces
El rendimiento de las consultas depende del tipo o tipos de filtro que utilices
| Tipo de filtro | Rendimiento a gran escala | Notas |
|---|---|---|
| igual a | De bueno a excelente | Excelente para la coincidencia exacta en columnas de texto. Utiliza los filtros «igual a» siempre que sea posible en lugar de otros tipos de filtro. |
| empieza por | Bueno | |
| está en | De aceptable a bueno | Óptimo con una lista corta (< 10 elementos). El rendimiento disminuye a medida que la lista crece. |
| es nulo | De aceptable a moderado | Las consultas que se basan únicamente en este filtro pueden ser lentas si la mayoría de los registros tienen valores nulos en la columna. |
| no es nulo | De aceptable a moderado | Por el contrario, si la mayoría de los registros son nulos, esta consulta puede devolver resultados muy rápidamente. |
| termina en | De aceptable a moderado | No distingue entre mayúsculas y minúsculas. El rendimiento se ve afectado cuando los límites de resultados son grandes y el número de registros es elevado. |
| contiene | De aceptable a moderado | No distingue entre mayúsculas y minúsculas. El rendimiento se ve afectado cuando los límites de resultados son amplios y el número de registros es elevado. |
| no es igual a | De deficiente a aceptable | |
| no está en | De deficiente a aceptable | |
| no empieza por | De malo a regular | |
| no termina en | De malo a regular | |
| no contiene | De malo a regular |
El rendimiento de la consulta depende del número de filtros
Al diseñar consultas, busca el equilibrio adecuado: suficientes filtros para obtener resultados precisos, pero de forma que la consulta se pueda reutilizar en casos de uso similares. No es habitual necesitar más de tres o cuatro filtros.
If you are building a query with many filters, it may indicate that your table model lacks scalability and would benefit from a partial redesign.
Establece siempre un límite adecuado para la consulta
Establece un LIMIT en cada consulta, utilizando el valor más pequeño que satisfaga tu caso de uso:
- Comprobar si existe al menos un registro que coincida: 1 registro
- Informes: plantéate utilizar Analytics en su lugar
- Otros casos de uso: ten en cuenta el número máximo práctico de registros que se recuperarían o evaluarían en función de los filtros de consulta utilizados, y utiliza ese número como LIMIT (si es inferior a 1.000).
Por qué es importante:
Una consulta que utilice el límite predeterminado de 1.000 intentará recuperar hasta 1.000 registros coincidentes, incluso cuando solo se necesiten unos pocos. Los límites innecesariamente grandes consumen tiempo y recursos en casos de uso en los que bastaría con un conjunto de resultados más reducido.
Fundamentos de la estrategia de archivado de registros de tablas
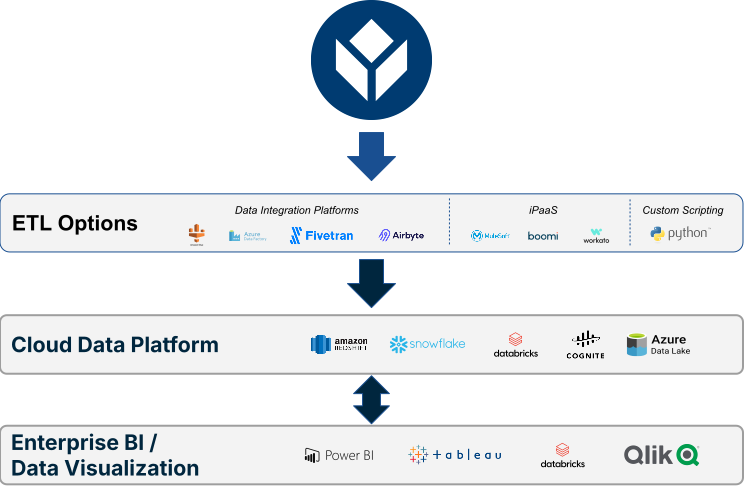
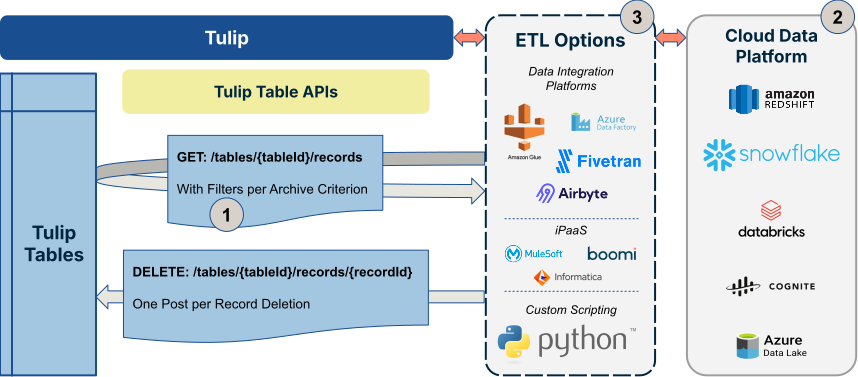
A efectos de este análisis, «archivo» se refiere al proceso de extraer registros de una o varias tablas, cargarlos en una plataforma de datos en la nube a través de una solución ETL (por ejemplo, una iPaaS o una plataforma de integración de datos) y, a continuación, eliminar dichos registros de las tablas.
Antecedentes y recomendación
- Tulip no impone un límite estricto al número de registros que pueden residir en las tablas.
- Tulip recomienda mantener el número de registros de cada tabla en unos pocos millones o menos, ya que el rendimiento de las consultas puede verse afectado a medida que aumenta el número de registros.
- Los problemas de rendimiento se agravan con el uso de registros vinculados y consultas mal diseñadas.
Recomendación:
Mantén el número de registros de las tablas por debajo de los 10 millones trasladando periódicamente los registros más antiguos a una plataforma de datos en la nube.
Planificación e implementación del archivado de registros de las tablas
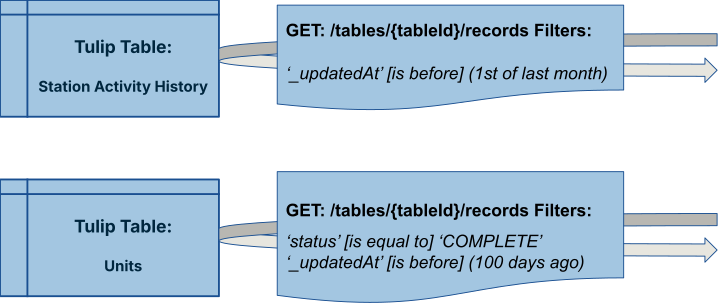
- Defina los criterios de archivado: determine los filtros de consulta que identifiquen los registros aptos para el archivado en cada tabla.
- Ejemplo: en el caso de una tabla denominada «Historial de estado de estaciones», se podrían archivar todos los registros con fecha anterior al primer día del mes anterior.
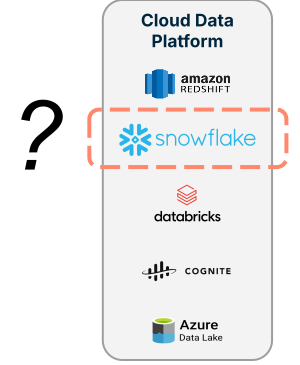
- Identificar el destino: seleccionar la plataforma de datos en la nube de destino (p. ej., Redshift, Snowflake, Databricks, etc.).
- Selecciona una solución ETL: elige una plataforma de integración de datos, una iPaaS de terceros o scripts personalizados en Python para realizar los traslados de registros.
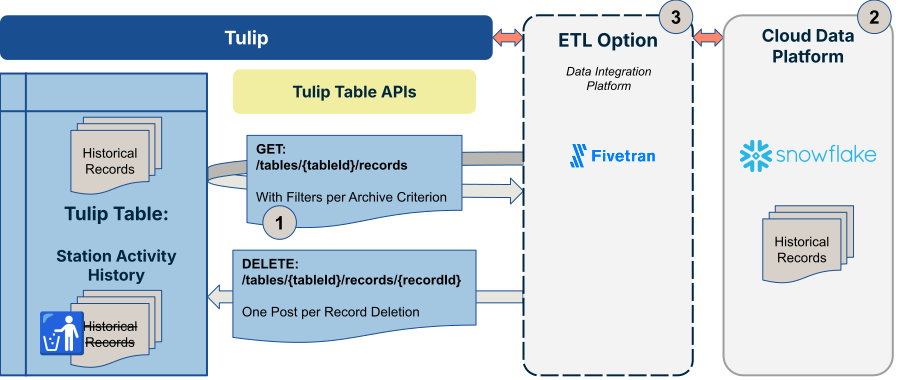
- Realice una migración masiva inicial: traslade por lotes todos los registros que cumplan los criterios definidos en el paso 1 al destino identificado en el paso 2.
- Programa migraciones incrementales periódicas: configura un proceso automatizado para realizar traslados de registros similares de forma continua. Una práctica recomendada habitual es realizar dichos traslados con mucha frecuencia, por ejemplo, cada 15 minutos para las tablas que se actualizan a lo largo de una jornada laboral típica.
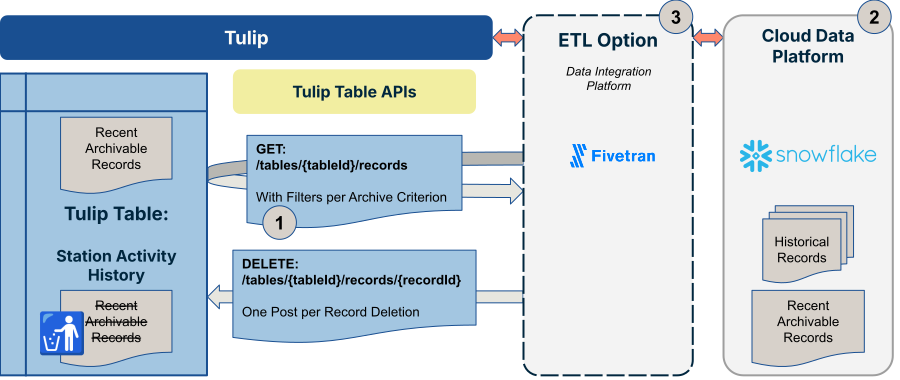
Para obtener orientación más detallada sobre los pasos 4 y 5, consulte «Prácticas recomendadas para el archivado de registros de tablas» más abajo.
Recursos adicionales sobre opciones de ETL:
- Plataformas de integración de datos
- Fivetran
- Microsoft Fabric
- Plataformas de datos en la nube
- Snowflake
- Cognite
Prácticas recomendadas para el archivado de registros de tablas
Utiliza el número de secuencia como cursor
Al paginar los registros, utiliza el número de secuencia como cursor en lugar de la paginación basada en el desplazamiento.
Por qué falla la paginación basada en el desplazamiento: si se insertan o actualizan registros mientras se está ejecutando la sincronización, la paginación basada en el desplazamiento puede omitir o duplicar registros. Los cursores basados en el número de secuencia son estables: sequenceNumber > last_seen_seq siempre te proporciona la página siguiente correcta, independientemente de las escrituras simultáneas.
La sincronización de una tabla se realiza en dos fases: una carga masiva única para cargar todos los registros históricos, seguida de migraciones incrementales periódicas para capturar los cambios. Ambas deben utilizar el número de secuencia como cursor.
Carga masiva inicial y, a continuación, migraciones incrementales
Antes de ejecutar sincronizaciones incrementales, realiza una carga masiva única: una carga completa de todos los registros históricos. Esto proporciona a tu destino una línea de base completa.
Patrón:
- Comienza con
last_seq = 0(o con el último punto de control guardado si se reanuda una carga masiva interrumpida) - Recupera las páginas ordenadas por número de secuencia ascendente
- Escriba cada página en el destino
- Guarda un punto de control cada ~500 registros
- Detente cuando una página no devuelva ningún registro
Respeta los límites de tasa y utiliza el retroceso exponencial
La API de Tulip Tables aplica límites de tasa a todas las solicitudes. Hay dos niveles para gestionar esto correctamente:
Limitación proactiva: espacia tus solicitudes para mantenerte dentro del límite desde el principio, en lugar de esperar a que te las rechacen
Retraso reactivo: cuando se reciba un código 429 a pesar de la limitación (por ejemplo, debido a que otros procesos simultáneos comparten la misma cuota de la API del espacio de trabajo), reduzca la frecuencia de las solicitudes GET y vuelva a intentarlo.
Consulta la guía de límites de tasa de la API de Tulip para conocer los límites actuales. No codifiques los valores de los límites de forma rígida en tu solución ETL: utiliza una constante con nombre para que sean fáciles de actualizar si cambian los límites.
Excluir campos de registros vinculados mediante el filtro de campos
Las tablas admiten campos de registros vinculados (tipo tableLink): campos de una tabla que hacen referencia a registros de otra. Cuando se incluye un campo «tableLink» en una respuesta de registros, la API de Tulip tiene que resolver esas referencias en el lado del servidor, lo que genera consultas en cascada a la base de datos. En tablas con muchos campos vinculados o con un gran número de registros, esto supone una carga significativa para la base de datos y afecta a todos los usuarios del espacio de trabajo.
La solución: utiliza el parámetro de consulta «fields» para enumerar explícitamente los campos que deseas que se devuelvan y excluye por completo los campos «tableLink». Esto requiere un pequeño esfuerzo inicial —primero debes recuperar el esquema de la tabla para saber qué campos incluir—, pero es el enfoque correcto y da como resultado consultas más rápidas y ligeras.
Recuperación de errores basada en puntos de control
Se producirán fallos de red, tiempos de espera agotados y errores inesperados. Diseña tu conector para que se recupere correctamente sin tener que volver a empezar desde cero.
Patrón:
- Almacena de forma persistente el último número de secuencia procesado con éxito en un almacén duradero cada ~500 registros
- Al reiniciar, carga el punto de control y reanuda a partir de seq > checkpoint_seq
- Escriba los registros utilizando la lógica «upsert» (en lugar de «insert») en el destino, de modo que el reprocesamiento de los registros desde el punto de control sea seguro
Gestión de la eliminación de registros
La API de Tulip Tables no proporciona un flujo de eventos de eliminación. Si un registro se elimina de forma definitiva en Tulip, el conector no tiene forma de detectarlo: el registro simplemente desaparece de la API sin notificación alguna. La forma de gestionar esto depende de lo que quieras que haga el destino externo.
- Escenario A: Mantener el destino sincronizado con Tulip (reflejar las eliminaciones)
- Si tu objetivo es que el destino refleje el estado actual de Tulip —incluidas las eliminaciones—, entonces no elimines definitivamente los registros en Tulip. El conector no puede propagar una eliminación que nunca ve.
- En su lugar, añade una columna booleana a la tabla —«archivado» o «eliminado»— y establécela en «verdadero» cuando un registro deba tratarse como inactivo. Al tratarse de una actualización de campo, la siguiente sincronización incremental la detectará y la escribirá en el destino automáticamente, sin que se requiera ninguna lógica especial del conector. A continuación, podrás filtrarlos en el destino.
- En Tulip: añade una columna booleana «archivado» y actualízala a través de tu aplicación, una función o una automatización cuando el registro deba tratarse como «inactivo», en lugar de eliminarlo.
- En el destino: filtra por «archivado = false» en tus consultas e informes, en lugar de dar por sentado que todos los registros sincronizados están activos.
- Escenario B: Limpiar Tulip para mejorar el rendimiento, conservar los registros en el destino
- Las tablas de Tulip funcionan mejor cuando se mantienen ligeras. Si una tabla crece mucho, la eliminación definitiva de registros antiguos o completados es una forma válida de gestionar su tamaño; por ejemplo, archivando las órdenes de trabajo completadas tras un periodo de retención.
- En este escenario, la eliminación definitiva en Tulip es adecuada. Dado que el conector nunca recibe un evento de eliminación, los registros eliminados de Tulip simplemente nunca se vuelven a actualizar en el destino: se conservan tal cual. El destino se convierte en un archivo a largo plazo, mientras que Tulip mantiene su rendimiento.
- No es necesario realizar cambios en el conector para este patrón. Basta con asegurarse de que los consumidores posteriores comprendan que el destino puede contener registros que ya no existen en Tulip y diseñen sus consultas en consecuencia (por ejemplo, realizando una unión con la marca de tiempo «completed_at» en lugar de dar por sentado que el registro sigue activo en Tulip).
Más información
- Se puede encontrar más orientación sobre este tema en la comunidad de Tulip, en este hilo: Enfoques y mejores prácticas del conector de tablas de Tulip: cómo trabajar con Airbyte, FiveTran y otras herramientas ETL
- Seminario web de Tulip: «Tablas limpias, aplicaciones rápidas: guía para desarrolladores de aplicaciones sobre la optimización de modelos de datos»{
target=_blank}
{{snippet.¿Has encontrado lo que buscabas?}}