

Visão geral deste artigo
- O escopo deste artigo aborda os fundamentos da implementação e manutenção de um modelo de tabela do Tulip que seja: eficiente, confiável, composível e escalável.
- O objetivo deste artigo é fornecer o seguinte:
- Recomendações para usar os recursos de tabelas da Biblioteca Tulip como ponto de partida para casos de uso típicos
- Melhores práticas para o projeto de tabelas adicionais
- Criação de consultas de tabela com alto desempenho
- Planejamento e implementação de uma estratégia de arquivamento de registros de tabelas
Público-alvo: desenvolvedores de aplicativos, arquitetos de soluções, arquitetos de dados, profissionais de plataformas de dados
Conceitos-chave
- As tabelas são um componente fundamental de qualquer solução Tulip e uma das muitas fontes de dados dentro da sua organização.
- Um modelo de tabela bem projetado permite uma solução com alto desempenho, composível e escalável.
- Os recursos da Biblioteca Tulip oferecem aos clientes uma vantagem inicial com um modelo de dados comum.
- As tabelas apresentam certas limitações — algumas por design (por exemplo, limitação de taxa) e outras por prática (por exemplo, limites de contagem de registros).
- Projetar consultas de alto desempenho e arquivar registros mais antigos em tabelas de grande volume (por exemplo, > 10 milhões de registros) ajuda a manter uma solução ágil, apoiando diretamente a produtividade dos operadores e a experiência do usuário.
Posição típica da Tulip no fluxo de dados corporativo
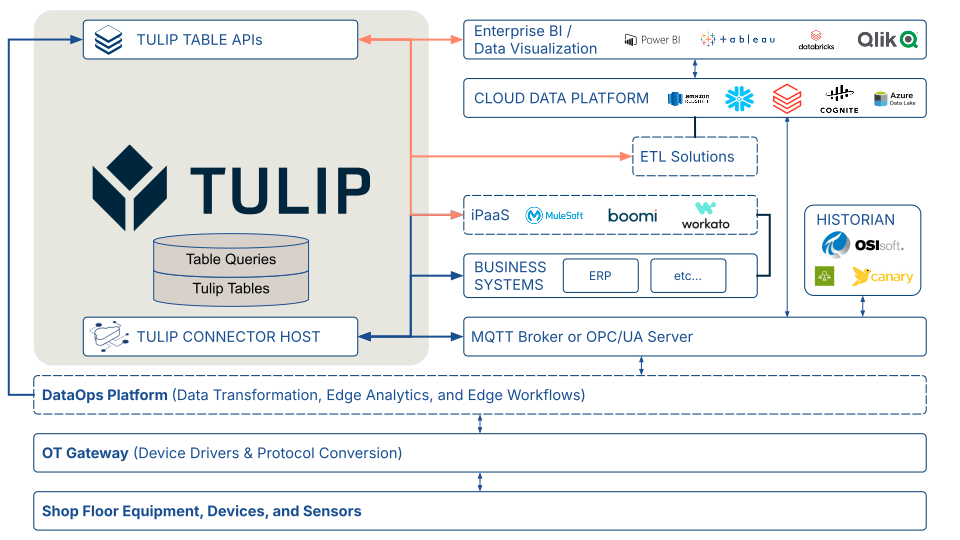
Como uma plataforma de operações de linha de frente projetada para funcionar como um painel único, sua solução Tulip hospeda dados críticos de fabricação e se integra a outras fontes de dados em toda a empresa. Considere o diagrama de arquitetura abaixo. Sua solução Tulip pode interagir com sistemas de negócios corporativos por meio de funções de conector e com equipamentos de chão de fábrica por meio de um broker MQTT ou servidor OPC UA configurado como sua . Suas soluções iPaaS e ETL, bem como as ferramentas de visualização de dados da empresa, podem interagir com sua solução Tulip por meio de APIs de tabela.
Recursos do Tulip para o modelo de dados comum
A Tulip oferece diversos recursos para acelerar o desenvolvimento de soluções com um modelo de dados comum baseado em Tabelas. Para mais informações, consulte:
Artigos adicionais sobre o modelo de dados comum
- Modelo de Dados Comum
- Exemplo: Use o modelo de dados comum para casos de uso específicos
- Exemplo: uso do modelo de dados comum para casos de uso no setor farmacêutico
Recursos da Biblioteca da Tulip sobre o modelo de dados comum
- Kit básico do modelo de dados comum da Tulip{
target=_blank} - Kits de tabelas
Otimização de tabelas para escalabilidade
Melhores práticas para o projeto de tabelas escaláveis
As tabelas do Modelo de Dados Comum da Biblioteca Tulip são construídas com base nas melhores práticas descritas abaixo. Essas tabelas — e os princípios por trás delas — servem como um guia prático para projetar tabelas que permaneçam escaláveis e utilizáveis na lógica do Tulip a longo prazo.
Crie tabelas escaláveis horizontalmente (altas, não largas).
Considere uma tabela de Lista de Materiais (BOM). Um desenvolvedor iniciante de aplicativos Tulip pode se sentir inclinado a criar uma tabela “larga”, com uma coluna “Número” separada para cada componente de um conjunto. Embora isso possa parecer simples no curto prazo, rapidamente complica a reutilização de consultas, sobrecarrega a lógica de gatilhos e limita a aplicabilidade da tabela a outros conjuntos.
Na tabela de Lista de Materiais (BOM) abaixo, as colunas representam o pai e o componente de um conjunto. Se um conjunto tiver cinco componentes, a tabela conterá cinco registros. Essa estrutura suporta uma hierarquia de n níveis, já que um subconjunto pode atuar como “Pai” em uma relação e como “Componente” em outra.
Observe também que esse projeto de tabela é independente tanto do produto quanto do setor — ele poderia armazenar a lista de materiais (BOM) para qualquer coisa, desde uma refeição até uma aeronave comercial.
Estrutura recomendada para uma tabela de Lista de Materiais| Rótulo | Tipo de campo | Descrição || --- | --- | --- || ID | Texto | Obrigatório: Identificador único || ID da definição do material pai | Texto | Identificador único da definição do material pai do conjunto|| Descrição do material pai | Texto | Descrição do material pai || ID da definição do material componente | Texto | Identificador único da definição do material componente || Descrição do material componente | Texto | Descrição do material a ser montado ou consumido || Quantidade do componente | Número | Quantidade do material a ser montado ou consumido || Unidade de medida do componente | Texto | Unidade de medida do componente || Ponto de uso | Texto | Local, operação ou etapa em que o material será montado ou consumido |
Evite tabelas muito largas
Embora a plataforma Tulip suporte até 200 colunas, uma tabela com mais de aproximadamente 50 colunas pode ser um sinal de que o modelo de dados subjacente precisa ser reconsiderado para garantir escalabilidade a longo prazo.
Evite armazenar muitas “coisas” distintas em uma única tabela
Nesse contexto, uma “coisa” refere-se a um tipo de entidade de dados específico para um caso de uso. Por exemplo, uma tabela “Equipamentos e Ativos” pode armazenar informações tanto para equipamentos de chão de fábrica quanto para ferramentas que exigem acompanhamento de calibração. Embora possa ser prático armazenar diferentes tipos de entidades na mesma tabela, isso é mais apropriado quando:
- O uso do ID do registro for consistente entre os tipos de entidade.
- No exemplo de “equipamentos da linha de produção” e “ferramentas calibradas”, o ID do registro é geralmente a etiqueta de ativo da empresa.
- Os diferentes tipos de entidades compartilham aproximadamente 50% ou mais das mesmas colunas.
- Se os diferentes tipos de entidades preenchem pouquíssimas colunas em comum, provavelmente é mais adequado armazená-las em tabelas separadas.
- Não houver relação um-para-muitos entre os tipos de entidade.
- Por exemplo, um Lote pode conter muitas Ordens de Serviço. Mesmo que as Ordens de Serviço e os Lotes compartilhem mais de 50% das mesmas colunas — e a coluna de ID sirva tanto como ID da Ordem de Serviço quanto como ID do Lote —, a relação um-para-muitos entre elas pode complicar o projeto de consultas e a lógica de gatilhos, resultando em um modelo de tabela pouco intuitivo tanto para desenvolvedores de soluções quanto para usuários dos dados.
- Consenso entre as partes interessadas.
- Os desenvolvedores da solução e os usuários dos dados geralmente concordam que os diferentes tipos de entidade são fundamentalmente semelhantes (por exemplo, “equipamentos de chão de fábrica” e “ferramentas calibradas”).
Limitações práticas das tabelas
Limites de taxa
O Tulip aplica limites de taxa aos ativos para proporcionar uma experiência consistente e confiável aos usuários no que diz respeito a:
- Gravações de registros
- Exclusões de registros
Leia mais sobre os limites de taxa das tabelas aqui.
Limites de contagem de registros
A plataforma Tulip não impõe um limite rígido ao número de registros em uma tabela; no entanto, existe um limite prático, dependendo de como a tabela é utilizada. À medida que o número de registros cresce, é comum observar uma queda no desempenho de consultas e agregações, o que pode afetar a confiabilidade do aplicativo, a experiência do operador e a produtividade na linha de produção.
Existem casos documentados de aplicativos de produção de clientes da Tulip operando em tabelas com mais de 10 milhões de registros, com impacto insignificante no desempenho atribuível apenas ao número de registros.
Otimização de tabelas para confiabilidade e desempenho
Minimize o uso de registros vinculados
Em versões anteriores da plataforma Tulip, tabelas com várias colunas de registros vinculados e mais de um milhão de registros apresentavam problemas significativos de desempenho. As melhorias na plataforma resolveram substancialmente essa questão, mas continua sendo uma prática recomendada minimizar ou mitigar o uso de registros vinculados por várias razões:
- Desempenho em escala
- Extração de registros de tabelas por meio de APIs ou download de CSV
- Limitações conhecidas de recursos (por exemplo, impossibilidade de filtrar uma tabela interativa incorporada com base em uma coluna de uma tabela vinculada)
Criação de consultas com bom desempenho
O desempenho da consulta depende do(s) seu(s) tipo(s) de filtro
| Tipo de filtro | Desempenho em escala | Observações |
|---|---|---|
| igual a | Bom a excelente | Excelente para correspondência exata em colunas de texto. Use filtros “igual a” sempre que possível, em vez de outros tipos de filtro. |
| começa com | Bom | |
| está em | Razoável a Bom | Melhor com uma lista curta (< 10 itens). O desempenho diminui à medida que a lista cresce. |
| é nulo | Razoável a moderado | Consultas que dependem exclusivamente desse filtro podem ser lentas se a maioria dos registros tiver valores nulos nessa coluna. |
| não é nulo | Razoável a moderado | Por outro lado, se a maioria dos registros for nula, essa consulta pode retornar resultados muito rapidamente. |
| termina com | Razoável a moderado | Não diferencia maiúsculas de minúsculas. O desempenho diminui com limites de resultados grandes e um número elevado de registros. |
| contém | Razoável a moderado | Não diferencia maiúsculas de minúsculas. O desempenho diminui com limites de resultados grandes e contagens elevadas de registros. |
| não é igual a | Ruim a razoável | |
| não está em | Ruim a razoável | |
| não começa com | Ruim a Regular | |
| não termina com | Ruim a Razoável | |
| não contém | Ruim a Razoável |
O desempenho da consulta depende do número de filtros
Ao projetar consultas, busque o equilíbrio certo: filtros suficientes para retornar resultados precisos, mantendo a consulta reutilizável em casos de uso semelhantes. É raro precisar de mais de três ou quatro filtros.
If you are building a query with many filters, it may indicate that your table model lacks scalability and would benefit from a partial redesign.
Sempre defina um limite adequado para a consulta
Defina um LIMIT em cada consulta, usando o menor valor que atenda ao seu caso de uso:
- Verificar se existe pelo menos um registro correspondente: 1 registro
- Relatórios: considere usar o Analytics em vez disso
- Outros casos de uso: considere o número máximo prático de registros que seriam recuperados ou avaliados com base nos filtros de consulta utilizados e use esse número como o LIMIT (se for menor que 1.000).
Por que isso é importante:
Uma consulta que utilize o limite padrão de 1.000 tentará recuperar até 1.000 registros correspondentes — mesmo quando apenas alguns são necessários. Limites desnecessariamente grandes consomem tempo e recursos em casos de uso em que um conjunto de resultados menor seria suficiente.
Fundamentos da estratégia de arquivamento de registros de tabela
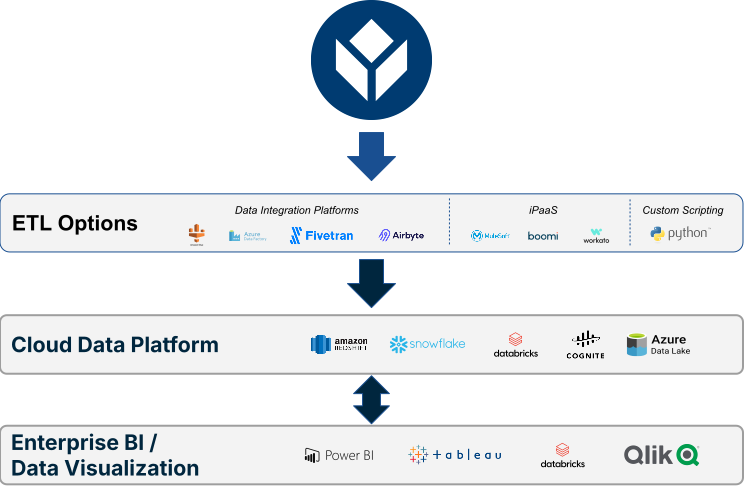
Para os fins desta discussão, “arquivamento” refere-se ao processo de extrair registros de uma ou mais tabelas, carregá-los em uma plataforma de dados na nuvem por meio de uma solução ETL (por exemplo, uma iPaaS ou plataforma de integração de dados) e, em seguida, excluir esses registros das tabelas.
Contexto e recomendação
- O Tulip não impõe um limite rígido ao número de registros que podem residir nas tabelas.
- A Tulip recomenda manter o número de registros em cada tabela em alguns milhões ou menos, pois o desempenho das consultas pode ser prejudicado à medida que o número de registros aumenta.
- Problemas de desempenho são agravados pelo uso de registros vinculados e consultas mal projetadas.
Recomendação:
Mantenha o número de registros nas tabelas abaixo de 10 milhões, transferindo periodicamente os registros mais antigos para uma plataforma de dados na nuvem.
Planejamento e implementação do arquivamento de registros das tabelas
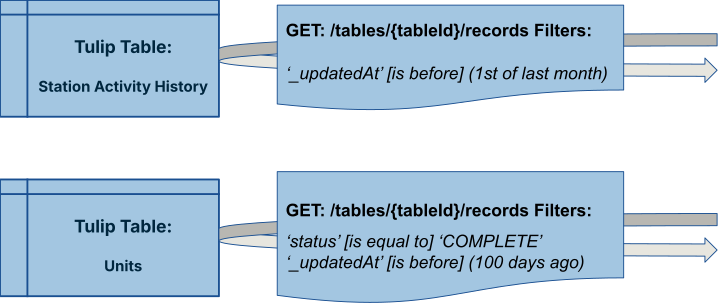
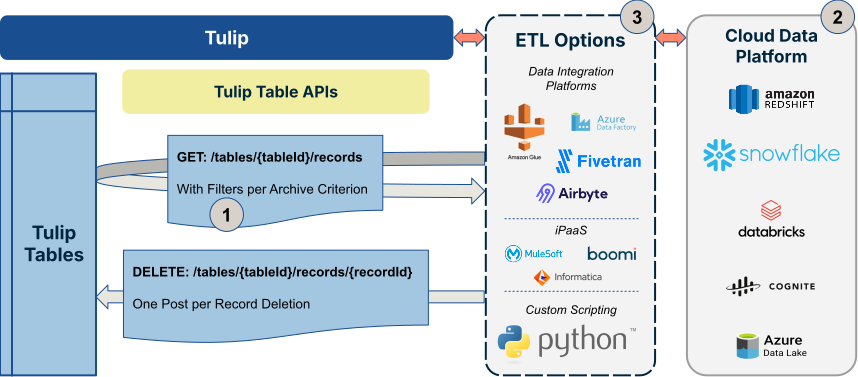
- Defina os critérios de arquivamento — determine os filtros de consulta que identificam os registros elegíveis para arquivamento em cada tabela.
- Exemplo: Para uma tabela “Histórico de status da estação”, você pode arquivar todos os registros com data anterior ao primeiro dia do mês anterior.
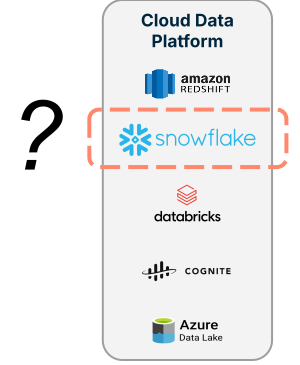
- Identifique o destino — selecione sua plataforma de dados em nuvem de destino (por exemplo, Redshift, Snowflake, Databricks etc.).
- Selecione uma solução ETL — escolha uma plataforma de integração de dados, um iPaaS de terceiros ou scripts Python personalizados para realizar a transferência dos registros.
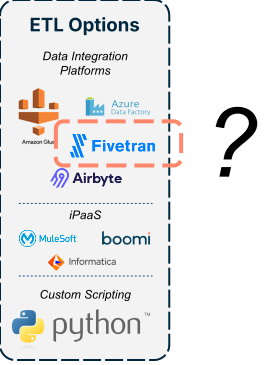
- Realize uma migração em massa inicial — transfira todos os registros que atendam aos critérios definidos na etapa 1 para o destino identificado na etapa 2, em lotes.
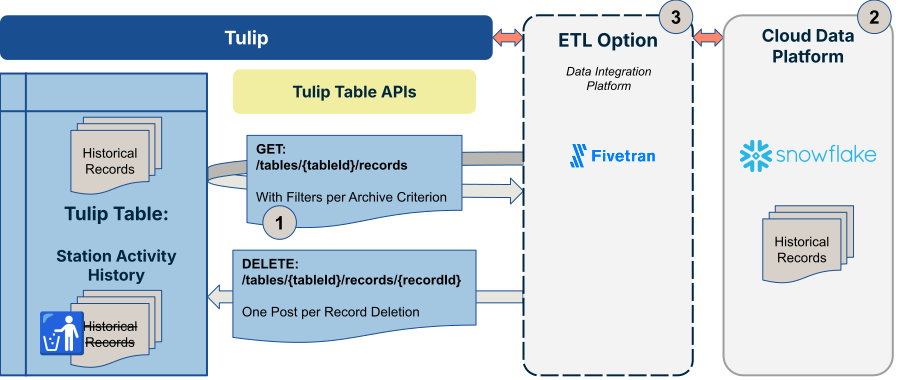
- Programe migrações incrementais recorrentes — configure um processo automatizado para realizar transferências semelhantes de registros de forma contínua. Uma prática recomendada comum é realizar essas transferências com muita frequência, por exemplo, a cada 15 minutos para tabelas atualizadas ao longo de um dia útil típico.
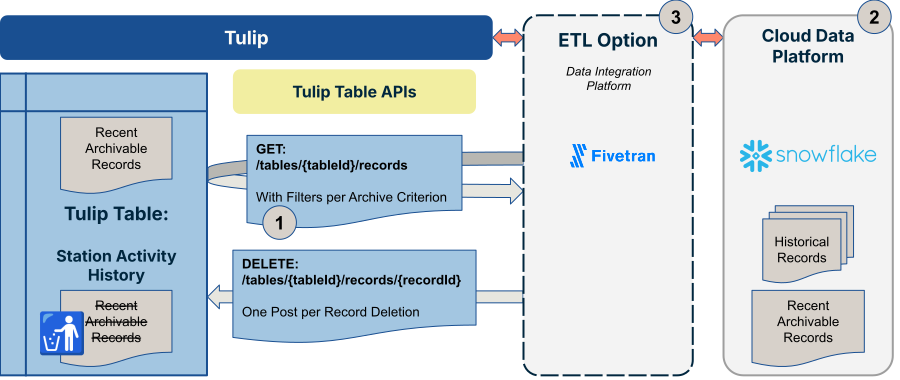
Para orientações mais detalhadas sobre os passos 4 e 5, consulte “Melhores práticas para arquivamento de registros de tabelas” abaixo.
Recursos adicionais sobre opções de ETL:
- Plataformas de integração de dados
- Fivetran
- Microsoft Fabric
- Plataformas de dados na nuvem
- Snowflake
- Cognite
Práticas recomendadas para arquivamento de registros de tabelas
Use o número de sequência como cursor
Ao paginar registros, use o número de sequência como cursor, em vez da paginação baseada em deslocamento.
Por que a paginação baseada em deslocamento falha: se registros forem inseridos ou atualizados enquanto a sincronização estiver em andamento, a paginação baseada em deslocamento pode pular ou duplicar registros. Cursores baseados no número de sequência são estáveis — sequenceNumber > last_seen_seq sempre fornece a próxima página correta, independentemente de gravações simultâneas.
A sincronização de uma tabela ocorre em duas fases: um carregamento em massa único para carregar todos os registros históricos, seguido por migrações incrementais recorrentes para capturar as alterações. Ambas devem usar o número de sequência como cursor.
Carregamento em massa inicial, seguido de migrações incrementais
Antes de executar sincronizações incrementais, realize um carregamento em massa único — um carregamento completo de todos os registros históricos. Isso fornece ao seu destino uma linha de base completa.
Padrão:
- Comece com
`last_seq` = 0(ou o último ponto de verificação salvo, caso esteja retomando um carregamento em massa interrompido) - Busque as páginas classificadas por número de sequência em ordem crescente
- Grave cada página no destino
- Salve um ponto de verificação a cada ~500 registros
- Pare quando uma página não retornar nenhum registro
Respeite os limites de taxa e use o backoff exponencial
A API do Tulip Tables impõe limites de taxa a todas as solicitações. Há duas etapas para lidar com isso corretamente:
Limitação proativa — espace suas solicitações para permanecer dentro do limite desde o início, em vez de esperar para ser rejeitado
Retrocesso reativo — quando um código 429 for recebido apesar da limitação (por exemplo, devido a outros processos simultâneos que compartilham a mesma cota da API do espaço de trabalho), reduza a frequência das chamadas GET e tente novamente.
Consulte o guia de Limites de Taxa da API do Tulip para conhecer os limites atuais. Não codifique valores de limite diretamente em sua solução ETL — use uma constante nomeada para que seja fácil atualizá-los caso os limites sejam alterados.
Exclua campos de registros vinculados usando o filtro de campos
As tabelas suportam campos de registros vinculados (tipo tableLink) — campos em uma tabela que fazem referência a registros em outra. Quando um campo tableLink é incluído em uma resposta de registros, a API do Tulip precisa resolver essas referências no lado do servidor, o que gera consultas em cascata ao banco de dados. Em tabelas com muitos campos vinculados ou grande número de registros, isso impõe uma carga significativa ao banco de dados e afeta todos os usuários do espaço de trabalho.
A solução: use o parâmetro de consulta fields para listar explicitamente os campos que você deseja que sejam retornados e exclua totalmente os campos tableLink. Isso requer um pequeno trabalho inicial — você precisa buscar o esquema da tabela primeiro para saber quais campos incluir —, mas é a abordagem correta e resulta em consultas mais rápidas e leves.
Recuperação de erros baseada em pontos de verificação
Falhas de rede, tempos limite e erros inesperados ocorrerão. Projete seu conector para se recuperar de maneira suave, sem precisar reiniciar do zero.
Padrão:
- Persista o último número de sequência processado com sucesso em um armazenamento durável a cada ~500 registros
- Ao reiniciar, carregue o ponto de verificação e retome a partir de seq > checkpoint_seq
- Grave os registros usando a lógica de upsert (em vez de inserções) no destino, para que o reprocessamento dos registros a partir do ponto de verificação seja seguro
Tratamento da exclusão de registros
A API do Tulip Tables não fornece um fluxo de eventos de exclusão. Se um registro for excluído definitivamente no Tulip, o conector não tem como detectá-lo — o registro simplesmente desaparece da API sem nenhuma notificação. A maneira de lidar com isso depende do que você deseja que o destino externo faça.
- Cenário A: Manter o destino sincronizado com o Tulip (espelhar exclusões)
- Se seu objetivo é que o destino reflita o estado atual do Tulip — incluindo exclusões —, então não exclua registros de forma definitiva no Tulip. O conector não pode propagar uma exclusão que nunca vê.
- Em vez disso, adicione uma coluna booleana à tabela — “arquivado” ou “excluído” — e defina-a como “verdadeiro” quando um registro precisar ser tratado como inativo. Como se trata de uma atualização de campo, a próxima sincronização incremental irá captá-la e gravá-la no destino automaticamente, sem a necessidade de nenhuma lógica especial do conector. Você poderá então filtrá-los no destino.
- No Tulip: adicione uma coluna booleana “arquivado” e atualize-a por meio de seu aplicativo, função ou automação quando o registro precisar ser tratado como “inativo”, em vez de excluí-lo.
- No destino: filtre por “arquivado = false” em suas consultas e relatórios, em vez de presumir que todos os registros sincronizados estejam ativos.
- Cenário B: Limpar o Tulip para melhorar o desempenho, mantendo os registros no destino
- As tabelas do Tulip têm melhor desempenho quando mantidas enxutas. Se uma tabela ficar muito grande, excluir definitivamente registros antigos ou concluídos é uma forma válida de gerenciar seu tamanho — por exemplo, arquivando ordens de serviço concluídas após um período de retenção.
- Nesse cenário, a exclusão definitiva no Tulip é adequada. Como o conector nunca recebe um evento de exclusão, os registros removidos do Tulip simplesmente nunca são atualizados novamente no destino — eles são mantidos como estão. O destino se torna um arquivo de longo prazo, enquanto o Tulip mantém seu desempenho.
- Não são necessárias alterações no conector para esse padrão. Basta garantir que os consumidores a jusante entendam que o destino pode conter registros que não existem mais no Tulip e projetem suas consultas de acordo com isso (por exemplo, fazer uma junção com base no carimbo de data/hora
completed\_at, em vez de presumir que o registro ainda esteja ativo no Tulip).
Mais informações
- Mais orientações sobre esse assunto podem ser encontradas na Comunidade Tulip neste tópico: Abordagens e melhores práticas do conector de tabelas do Tulip — Trabalhando com Airbyte, FiveTran e outras ferramentas de ETL
- Webinar do Tulip – Tabelas limpas, aplicativos rápidos: um guia para desenvolvedores de aplicativos sobre otimização de modelos de dados{
target=_blank}
{{snippet.Você encontrou o que estava procurando?}}