

A cikk áttekintése
- Ez a cikk a Tulip táblamodell olyan megvalósításának és karbantartásának alapjait tárgyalja, amely: teljesítményorientált, megbízható, összetett és skálázható.
- A cikk célja a következőket nyújtani:
- Ajánlás a Tulip Library táblázati elemeinek használatára kiindulási pontként tipikus felhasználási esetekhez
- Bevált gyakorlatok további táblák tervezéséhez
- Teljesítményorientált táblakérdések készítése
- Tábla-rekord-archiválási stratégia tervezése és megvalósítása
Célközönség: Alkalmazásfejlesztők, megoldás-architekták, adatarchitekták, adatplatform-szakemberek
Főbb fogalmak
- A táblák minden Tulip-megoldás alapvető elemei, és a szervezeten belüli számos adatforrás egyike.
- A jól megtervezett táblamodell lehetővé teszi egy teljesítményorientált, összetett és skálázható megoldás létrehozását.
- A Tulip Library eszközei egy közös adatmodellel előnyt biztosítanak az ügyfeleknek.
- A tábláknak vannak bizonyos korlátai – ezek egy része tervezésből adódik (pl. sebességkorlátozás), más része pedig a gyakorlatból (pl. rekordszám-küszöbértékek).
- A nagy adatmennyiségű táblákban (pl. > 10 millió rekord) a nagy teljesítményű lekérdezések tervezése és a régebbi táblarekordok archiválása segít fenntartani a megoldás gyors reagálóképességét, közvetlenül támogatva ezzel az operátorok termelékenységét és a felhasználói élményt.
A Tulip tipikus helye a vállalati adatáramlásban
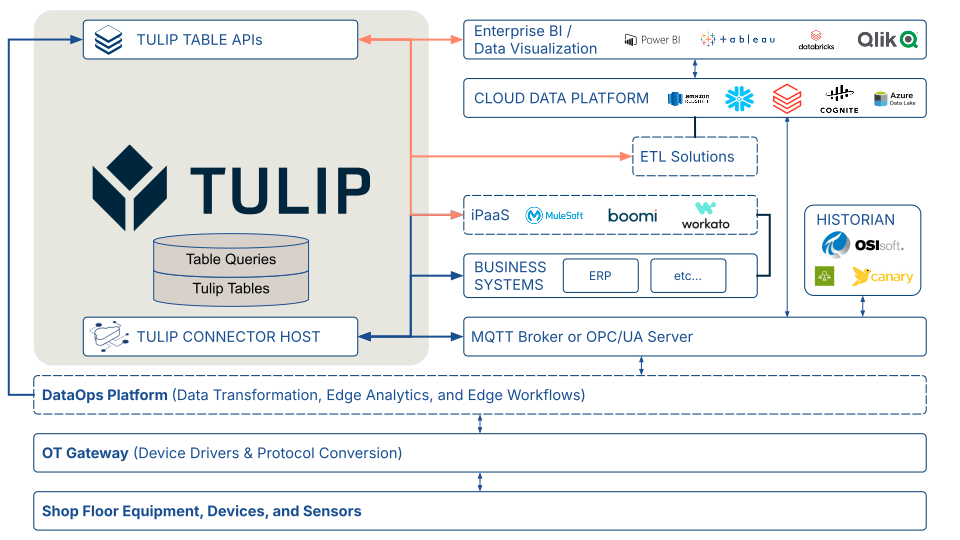
Mint egyetlen felületen működő, első vonalbeli üzemeltetési platform, a Tulip-megoldás tárolja a kritikus gyártási adatokat, és integrálódik a vállalat más adatforrásaival. Tekintse meg az alábbi architektúra-ábrát. A Tulip-megoldás a vállalati üzleti rendszerekkel csatlakozófunkciók (Connector Functions) segítségével, a gyártóterületi berendezésekkel pedig egy MQTT-közvetítőn vagy egy Machine Data Source-ként konfigurált OPC UA-kiszolgálón keresztül léphet kapcsolatba. Az iPaaS és ETL megoldásai, valamint a vállalati adatvizualizációs eszközök a Table API-kon keresztül léphetnek kapcsolatba a Tulip-megoldással.
Tulip-erőforrások a közös adatmodellhez
A Tulip számos forrást biztosít a megoldások fejlesztésének felgyorsításához a táblákra épülő közös adatmodell segítségével. További információkért lásd:
További cikkek a közös adatmodellről
- Közös adatmodell
- Példa: A közös adatmodell használata diszkrét felhasználási esetekhez
- Példa: A közös adatmodell használata gyógyszeripari felhasználási esetekben
A Tulip könyvtár forrásai a közös adatmodellről
- Tulip közös adatmodell alapcsomag{
target=_blank} - Táblakészletek
Táblák optimalizálása a skálázhatóság érdekében
Bevált gyakorlatok a skálázható táblák tervezéséhez
A Tulip könyvtár közös adatmodelljében található táblák az alábbiakban leírt bevált gyakorlatok alapján készültek. Ezek a táblák – és az azok mögött álló elvek – gyakorlati útmutatóként szolgálnak olyan táblák tervezéséhez, amelyek hosszú távon is skálázhatók és használhatók maradnak a Tulip logikájában.
A táblákat vízszintesen skálázhatóvá kell tenni (magasak legyenek, ne szélesek).
Vegyünk példának egy alkatrészlistát (Bill of Materials). Egy kezdő Tulip-alkalmazásfejlesztő hajlamos lehet egy „széles” táblát létrehozni, amelyben az összeszerelés minden egyes alkatrészéhez külön „Szám” oszlop tartozik. Bár ez rövid távon egyszerű megoldásnak tűnhet, gyorsan bonyolítja a lekérdezések újrafelhasználását, megterheli a trigger-logikát, és korlátozza a táblázat más összeszerelésekre való alkalmazhatóságát.
Az alábbi alkatrészlista (BOM) táblában az oszlopok az összeállítás szülőelemét és alkatrészeit jelölik. Ha egy összeállításnak öt alkatrésze van, a táblában öt rekord található. Ez a szerkezet támogatja az n-szintű hierarchiát, mivel egy alösszeállítás egy kapcsolatban „szülőelemként”, egy másikban pedig „alkatrészként” működhet.
Figyeljük meg azt is, hogy ez a táblaterv mind termék-, mind iparág-független – tárolhatja például egy étel vagy akár egy kereskedelmi repülőgép alkatrészlistáját is.
Ajánlott szerkezet az alkatrészlista táblához| Címke | Mezőtípus | Leírás || --- | --- | --- || ID | Szöveg | Kötelező: Egyedi azonosító || Szülő alkatrész definíció azonosítója | Szöveg | A szülő szerelvényanyagdefiníciójának egyedi azonosítója || Szülőanyag leírása | Szöveg | A szülőanyag leírása || Alkatrész-anyagdefiníció azonosítója | Szöveg | Az alkatrész-anyagdefiníció egyedi azonosítója || Alkatrész-anyag leírása | Szöveg | Az összeszerelendő vagy felhasználandó anyag leírása || Alkatrész mennyisége | Szám | Az összeszerelendő vagy felhasználandó anyag mennyisége || Alkatrész mértékegysége | Szöveg | Az || Felhasználási hely | Szöveg | Az a hely, művelet vagy lépés, ahol az anyagot összeállítják vagy felhasználják |
Kerülje a túl széles táblázatokat
Bár a Tulip platform akár 200 oszlopot is támogat, egy körülbelül 50 oszlopot meghaladó táblázat arra utalhat, hogy a hosszú távú skálázhatóság érdekében felül kell vizsgálni az alapul szolgáló adatmodellt.
Kerülje el, hogy túl sok különböző „dolgot” tároljon egyetlen táblázatban
Ebben az összefüggésben a „dolog” egy adott felhasználási esetre jellemző adattípust jelent. Például egy „Berendezések és eszközök” táblázat tárolhatja mind a gyártócsarnoki berendezések, mind a kalibrálás nyomon követését igénylő szerszámok adatait. Bár praktikus lehet különböző típusú entitásokat ugyanabban a táblázatban tárolni, ez leginkább akkor célszerű, ha:
- A rekordazonosító használata az összes entitástípus esetében következetes.
- A „gyártóterületi berendezések” és a „kalibrált szerszámok” példájában a rekordazonosító általában a vállalati eszközcímke.
- A különböző entitástípusok oszlopainak legalább 50%-a megegyezik.
- Ha a különböző típusú entitások csak nagyon kevés közös oszlopot töltenek ki, akkor valószínűleg célszerűbb őket külön táblákban tárolni.
- Nincs egy-több kapcsolat az entitástípusok között.
- Például egy tétel (Batch) számos munkarendelt (Work Order) tartalmazhat. Még akkor is, ha a munkarendelések és a tételek oszlopainak több mint 50%-a megegyezik — és az azonosító oszlop vagy munkarendelés-azonosítóként, vagy tétel-azonosítóként szolgál – a köztük fennálló egy-több kapcsolat bonyolíthatja a lekérdezések tervezését és a triggerek logikáját, ami olyan táblamodellt eredményez, amely sem a megoldás-fejlesztők, sem az adatfelhasználók számára nem intuitív.
- Konszenzus az érdekelt felek között.
- A megoldás fejlesztői és az adatok felhasználói általában egyetértenek abban, hogy a különböző entitástípusok alapvetően hasonlóak (pl. „gyártóterületi berendezések” és „kalibrált szerszámok”).
A táblák gyakorlati korlátai
Sebességkorlátozások
A Tulip sebességkorlátozásokat alkalmaz az eszközökre, hogy a felhasználók számára következetes és megbízható élményt nyújtson a következők tekintetében:
- Rekordírás
- Rekordtörlések
A táblák sebességkorlátozásairól itt olvashat bővebben.
Rekordszám-korlátozások
A Tulip platform nem szab szigorú korlátot a táblák rekordjainak számára; azonban a táblák használatának módjától függően létezik egy gyakorlati korlát. A rekordok számának növekedésével gyakran tapasztalható a lekérdezések és összesítések teljesítményének romlása, ami hatással lehet az alkalmazás megbízhatóságára, a kezelői élményre és a gyártási termelékenységre.
Vannak dokumentált esetek, amikor a Tulip ügyfeleinek termelési alkalmazásai 10 millió rekordot meghaladó táblákon működtek, és a teljesítményre gyakorolt hatás elhanyagolható volt, ami kizárólag a rekordszámnak tulajdonítható.
A táblák optimalizálása a megbízhatóság és a teljesítmény érdekében
A kapcsolt rekordok használatának minimalizálása
A Tulip platform korábbi verzióiban a több összekapcsolt rekord oszlopot tartalmazó és egymillió rekordot meghaladó táblák jelentős teljesítményproblémákat mutattak. A platform fejlesztései jelentősen orvosolták ezt a problémát, de több okból is bevált gyakorlat marad az összekapcsolt rekordok használatának minimalizálása vagy mérséklése:
- Teljesítmény nagy léptékben
- Tábla-rekordok kivonása API-kon keresztül vagy CSV-letöltéssel
- Ismert funkciókorlátozások (pl. beágyazott interaktív táblázat szűrése egy kapcsolt táblázat oszlopai alapján nem lehetséges)
Teljesítményorientált lekérdezések készítése
A lekérdezések teljesítménye a szűrő típusától függ
| Szűrőtípus | Teljesítmény nagy léptékben | Megjegyzések |
|---|---|---|
| egyenlő | Jó – Kiváló | Kiváló a szöveges oszlopok pontos egyezéséhez. Amennyiben lehetséges, a többi szűrőtípus helyett mindig az „egyenlő” szűrőt használja. |
| kezdődik | Jó | |
| ben van | Közepes – Jó | Legjobban rövid listáknál működik (< 10 elem). A lista növekedésével csökken a teljesítmény. |
| nulla | Közepes | A kizárólag erre a szűrőre támaszkodó lekérdezések lassúak lehetnek, ha a legtöbb rekordban null értékek szerepelnek az oszlopban. |
| nem null | Közepes | Ezzel szemben, ha a legtöbb rekord null értékű, ez a lekérdezés nagyon gyorsan adhat eredményt. |
| -val végződik | Közepes | Kis- és nagybetűk közötti különbséget nem vesz figyelembe. A teljesítmény romlik nagy eredménykorlátok és magas rekordszám esetén. |
| tartalmaz | Közepes | Nem különbözteti meg a kis- és nagybetűket. A teljesítmény romlik nagy eredményhatárok és magas rekordszám esetén. |
| nem egyenlő | Gyenge – Közepes | |
| nincs benne | Gyenge – Közepes | |
| nem kezdődik | Gyenge vagy Közepes | |
| nem végződik | Gyenge vagy közepes | |
| nem tartalmazza | Gyenge vagy Közepes |
A lekérdezések teljesítménye a szűrők számától függ
A lekérdezések tervezésekor törekedjen a megfelelő egyensúlyra: elegendő szűrőt használjon a pontos eredmények visszaadásához, miközben a lekérdezést hasonló felhasználási esetekben is újra felhasználhatóvá teszi. Ritkán van szükség háromnál vagy négynél több szűrőre.
If you are building a query with many filters, it may indicate that your table model lacks scalability and would benefit from a partial redesign.
Mindig állítson be megfelelő lekérdezési korlátot
Állítson be LIMIT-et minden lekérdezéshez, a felhasználási esetnek megfelelő legkisebb értéket használva:
- Annak ellenőrzése, hogy létezik-e legalább egy megfelelő rekord: 1 rekord
- Jelentések: Fontolja meg az Analytics használatát helyette
- Egyéb felhasználási esetek: Vegye figyelembe a használt lekérdezési szűrők alapján lekérhető vagy kiértékelhető rekordok gyakorlati maximális számát, és ezt a számot használja LIMIT-ként (ha kevesebb, mint 1000).
Miért fontos ez:
Az alapértelmezett 1 000-es LIMIT-értéket használó lekérdezés akár 1 000 megfelelő rekordot is megpróbál lekérni – még akkor is, ha csak néhányra van szükség. A szükségtelenül nagy LIMIT-értékek időt és erőforrásokat emésztenek fel olyan felhasználási esetekben, ahol egy kisebb eredménykészlet is elegendő lenne.
A táblázati rekordok archiválási stratégiájának alapjai
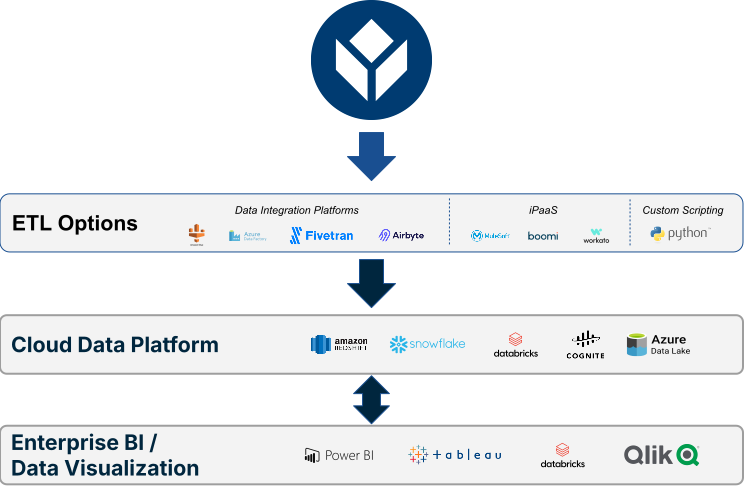
Ebben a tárgyalásban az „archiválás” kifejezés a rekordok táblákból való kivonására, azok egy ETL megoldáson (pl. egy iPaaS vagy adatintegrációs platformon) keresztül egy felhőalapú adatplatformra, majd azok törlését a táblákból.
Háttér és ajánlás
- A Tulip nem szab szigorú korlátot a táblákban tárolható rekordok számára.
- A Tulip azt javasolja, hogy az egyes táblák rekordszámát néhány millióra vagy annál kevesebbre korlátozzák, mivel a rekordszám növekedésével a lekérdezések teljesítménye romolhat.
- A teljesítményproblémákat tovább súlyosbítja a kapcsolt rekordok használata és a rosszul megtervezett lekérdezések.
Ajánlás:
Tartsa a táblák rekordszámát 10 millió alatt úgy, hogy a régebbi rekordokat rendszeresen áthelyezi egy felhőalapú adatplatformra.
A táblák rekordjainak archiválásának tervezése és megvalósítása
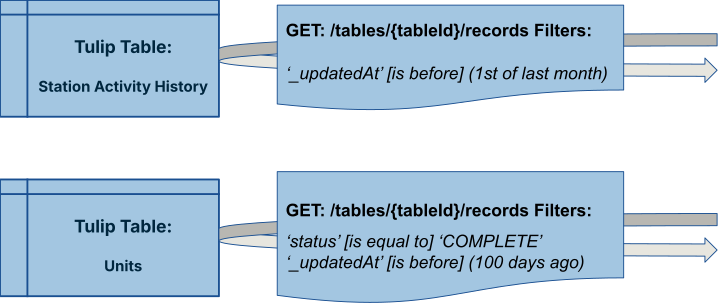
- Határozza meg az archiválási kritériumokat – állapítsa meg azokat a lekérdezési szűrőket, amelyek az egyes táblákban az archiválásra alkalmas rekordokat azonosítják.
- Példa: A „Station Status History” (Állomásállapot-előzmények) táblában például archiválhatja az előző hónap első napját megelőzően keltezett összes rekordot.
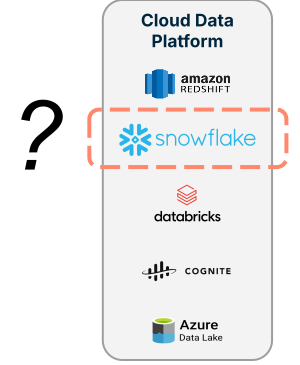
- Határozza meg a célhelyet – válassza ki a cél felhőalapú adatplatformot (pl. Redshift, Snowflake, Databricks stb.).
- Válasszon ETL-megoldást — válasszon egy adatintegrációs platformot, harmadik féltől származó iPaaS-t vagy egyéni Python-parancsfájlt a rekordok áthelyezéséhez.
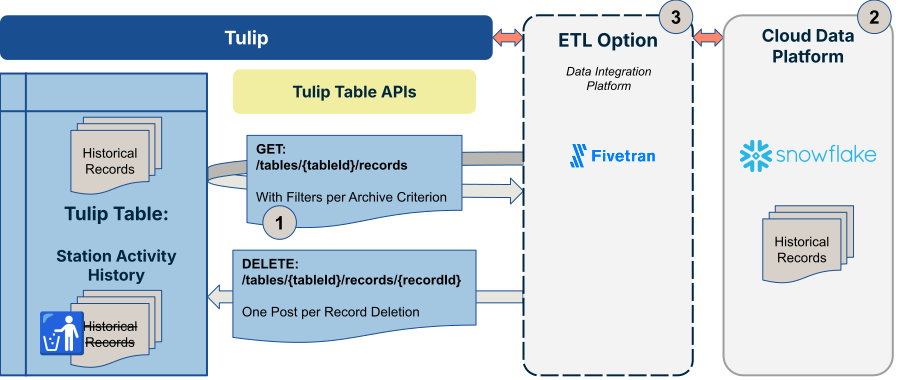
- Végezze el a kezdeti tömeges migrációt — költöztesse át kötegenként az 1. lépésben meghatározott kritériumoknak megfelelő összes rekordot a 2. lépésben azonosított célhelyre.
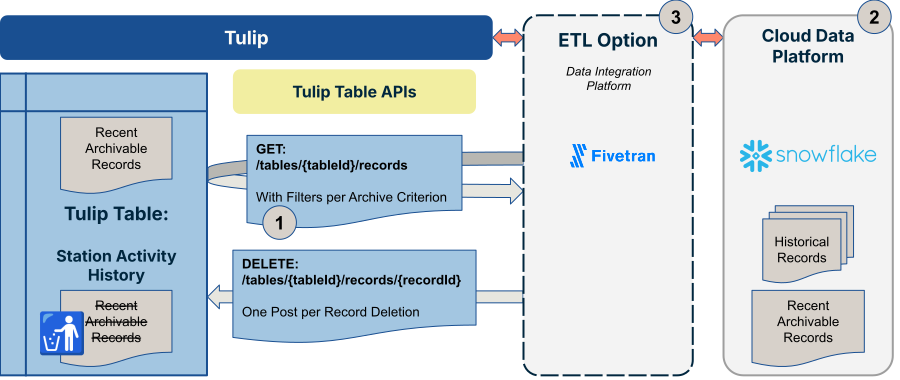
- Ütemezze meg az ismétlődő inkrementális migrációkat — állítson be egy automatizált folyamatot, amely folyamatosan elvégzi a hasonló rekordáthelyezéseket. Általános bevált gyakorlat, hogy az ilyen rekordáthelyezéseket nagyon gyakran hajtsák végre, pl. 15 percenként a tipikus munkanap során frissülő táblák esetében.
A 4. és 5. lépéssel kapcsolatos részletesebb útmutatást lásd az alábbi „A táblarekordok archiválására vonatkozó bevált gyakorlatok” című részben.
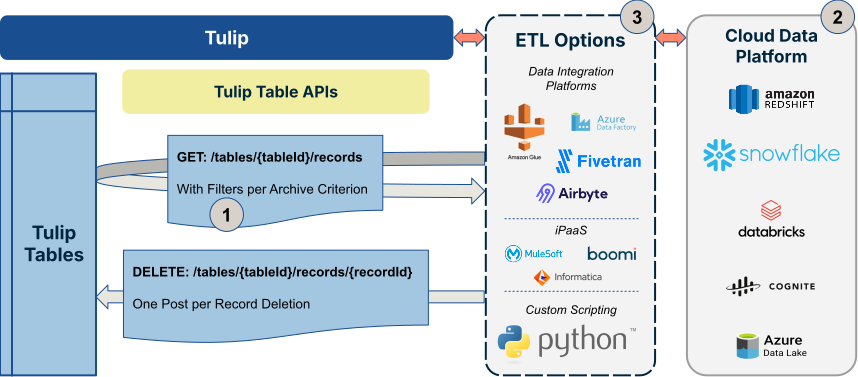
További források az ETL-opciókról:
- Adatintegrációs platformok
- Fivetran
- Microsoft Fabric
- Felhőalapú adatplatformok
- Snowflake
- Cognite
A táblázati rekordok archiválásának bevált gyakorlata
Használja a sorszámot kurzorként
A rekordok lapozásakor a sorozatszámot használja kurzorként az eltolásalapú lapozás helyett.
Miért nem működik az eltolásalapú lapozás: Ha a szinkronizálás futása közben rekordokat illeszt be vagy frissít, az eltolásalapú lapozás kihagyhat vagy duplikálhat rekordokat. A sorszámalapú kurzorok stabilak — a sequenceNumber > last_seen_seq mindig a helyes következő oldalt adja meg, függetlenül a párhuzamos írási műveletektől.
A táblák szinkronizálása két fázisban történik: egyszeri tömeges betöltés az összes korábbi rekord betöltésére, majd ismétlődő inkrementális migrációk a változások rögzítésére. Mindkettőnél a sorszámot kell kurzorként használni.
Kezdeti tömeges betöltés, majd inkrementális migrációk
Az inkrementális szinkronizálások futtatása előtt hajtson végre egy egyszeri tömeges betöltést – az összes korábbi rekord teljes betöltését. Ezzel a célrendszer teljes kiindulási alapot kap.
Mintázat:
- Kezdje a
last_seq = 0értékkel (vagy az utoljára mentett ellenőrzőponttal, ha megszakított tömeges betöltést folytat) - Töltse be az oldalakat sorszám szerint növekvő sorrendben
- Írja be az egyes oldalakat a célrendszerbe
- Minden ~500 rekord után mentse el az ellenőrzőpontot
- Álljunk le, ha egy oldal nem ad vissza rekordokat
Tartsa be a sebességkorlátozásokat, és használjon exponenciális visszalépést
A Tulip Tables API minden kérésre sebességkorlátozásokat alkalmaz. Ennek helyes kezeléséhez két lépés szükséges:
Proaktív korlátozás — a kéréseket úgy időzítse, hogy már az elejétől kezdve a korláton belül maradjanak, ahelyett, hogy megvárná az elutasítást
Reaktív visszavonulás — ha a korlátozás ellenére 429-es hibakódot kap (pl. mert más párhuzamos folyamatok is használják ugyanazt a munkaterületi API-kvótát), csökkentse a GET-kérések gyakoriságát, majd próbálja meg újra.
Az aktuális korlátokról a Tulip API sebességkorlátozások útmutatójában olvashat. Ne kódolja be a korlátértékeket az ETL-megoldásába — használjon névvel ellátott állandót, hogy a korlátok változása esetén könnyen frissíthesse őket.
A kapcsolódó rekordmezők kizárása a Fields Filter segítségével
A táblák támogatják a kapcsolt rekordmezőket (tableLink típus) — az egyik táblában található mezőket, amelyek egy másik táblában lévő rekordokra hivatkoznak. Ha egy tableLink mező szerepel a rekordválaszban, a Tulip API-nak szerveroldalon kell feloldania ezeket a hivatkozásokat, ami láncreakciószerű adatbázis-lekérdezéseket eredményez. Sok összekapcsolt mezővel rendelkező vagy nagy rekordszámú táblák esetében ez jelentős terhelést ró az adatbázisra, és a munkaterület összes felhasználóját érinti.
A megoldás: használja a fields lekérdezési paramétert a visszaadni kívánt mezők kifejezett felsorolásához, és zárja ki teljes mértékben a tableLink mezőket. Ehhez egy kis előkészítő munkára van szükség – először be kell töltenie a táblasémát, hogy megtudja, mely mezőket kell felvenni –, de ez a helyes megközelítés, és gyorsabb, könnyebb lekérdezéseket eredményez.
Ellenőrzőpontokon alapuló hiba-helyreállítás
Hálózati meghibásodások, időtúllépések és váratlan hibák előfordulhatnak. Tervezze meg a csatlakozóját úgy, hogy zökkenőmentesen helyreálljon anélkül, hogy a nulláról kellene újraindulnia.
Minta:
- Minden ~500 rekord után mentse el az utolsó sikeresen feldolgozott sorszámot egy tartós tárolóba
- Újraindításkor töltsd be az ellenőrzőpontot, és folytasd a feldolgozást a seq > checkpoint_seq ponttól
- A rekordokat upsert logikával (nem insert-ekkel) írja a célhelyre, így a checkpointból származó rekordok újrafeldolgozása biztonságos
A rekordok törlésének kezelése
A Tulip Tables API nem biztosít törlési eseményekből álló adatfolyamot. Ha egy rekordot véglegesen törölnek a Tulipból, a csatlakozónak nincs módja ezt észlelni — a rekord egyszerűen eltűnik az API-ból, értesítés nélkül. Hogy ezt hogyan kezeli, attól függ, mit szeretne, hogy a külső célhely tegyen.
- A. forgatókönyv: A célhely szinkronban tartása a Tulip-pal (a törlések tükrözése)
- Ha az a célja, hogy a célhely tükrözze a Tulip aktuális állapotát – beleértve a törléseket is –, akkor ne törölje véglegesen a rekordokat a Tulipban. A csatlakozó nem tudja továbbítani azt a törlést, amelyet soha nem lát.
- Ehelyett adjon hozzá egy logikai oszlopot a táblához – „archivált” vagy „törölve” – és állítsa „true”-ra, amikor egy rekordot inaktívként kell kezelni. Mivel ez egy mezőfrissítés, a következő inkrementális szinkronizálás automatikusan felveszi és átírja a célhelyre, külön csatlakozó-logika nélkül. Ezután kiszűrheti őket a célhelyen.
- A Tulipban: adjon hozzá egy „archived” nevű boolean oszlopot, és frissítse azt az alkalmazásán, egy függvényen vagy egy automatizáláson keresztül, amikor a rekordot „inaktívnak” kell tekinteni, ahelyett, hogy törölné a rekordot.
- A célhelyen: a lekérdezésekben és jelentésekben az „archivált = false” feltételre szűrjön, ahelyett, hogy feltételezné, hogy az összes szinkronizált rekord aktív.
- B. forgatókönyv: A teljesítmény érdekében tisztítsa meg a Tulipot, a rekordokat pedig tartsa meg a célhelyen
- A Tulip-táblák jobban teljesítenek, ha karcsúak maradnak. Ha egy táblázat nagyon nagyra nő, a régi vagy befejezett rekordok végleges törlése érvényes módszer a méret kezelésére — például a befejezett munkamegbízások archiválása egy megőrzési időszak után.
- Ebben a forgatókönyvben a végleges törlés a Tulipban megfelelő megoldás. Mivel a csatlakozó soha nem kap törlési eseményt, a Tulipból eltávolított rekordokat a célhelyen egyszerűen soha többé nem frissítik – azok változatlan formában maradnak meg. A célhely hosszú távú archívummá válik, míg a Tulip továbbra is jól teljesít.
- Ehhez a mintához nincs szükség a csatlakozó módosítására. Csak gondoskodjon arról, hogy a későbbi felhasználók tisztában legyenek azzal, hogy a célrendszer olyan rekordokat is tartalmazhat, amelyek már nem léteznek a Tulipban, és ennek megfelelően tervezzék meg lekérdezéseiket (pl. a completed_at időbélyeg alapján végezzenek csatlakozást, ahelyett, hogy feltételeznék, hogy a rekord még mindig aktív a Tulipban).
További információk
- További útmutatást erről a témáról a Tulip közösségben találhat ebben a szálban: Tulip táblák csatlakozói megközelítések és bevált gyakorlatok – Munka az Airbyte-tal, a FiveTran-nal és más ETL-eszközökkel
- Tulip webinárium – Tiszta táblák, gyors alkalmazások: Útmutató az alkalmazásfejlesztőknek az adatmodell-optimalizáláshoz{
target=_blank}
{{snippet.Megtalálta, amit keresett?}}