

Überblick über diesen Artikel
- Dieser Artikel befasst sich mit den Grundlagen der Implementierung und Wartung eines Tulip-Tabellenmodells, das leistungsfähig, zuverlässig, kombinierbar und skalierbar ist.
- Der Zweck dieses Artikels ist es, Folgendes bereitzustellen:
- Empfehlungen zur Nutzung der Tabellen-Assets der Tulip Library als Ausgangspunkt für typische Anwendungsfälle
- Bewährte Verfahren für den Entwurf zusätzlicher Tabellen
- Erstellung leistungsfähiger Tabellenabfragen
- Planung und Umsetzung einer Strategie zur Archivierung von Tabellendatensätzen
Zielgruppe: App-Entwickler, Lösungsarchitekten, Datenarchitekten, Mitarbeiter von Datenplattformen
Schlüsselkonzepte
- Tabellen sind eine grundlegende Komponente jeder Tulip-Lösung und eine von vielen Datenquellen in Ihrem Unternehmen.
- Ein gut durchdachtes Tabellenmodell ermöglicht eine Lösung, die leistungsstark, kombinierbar und skalierbar ist.
- Die Ressourcen der Tulip-Bibliothek bieten Kunden einen Vorsprung durch ein gemeinsames Datenmodell.
- Tabellen unterliegen bestimmten Einschränkungen – einige sind konstruktionsbedingt (z. B. Ratenbegrenzung), andere ergeben sich aus der Praxis (z. B. Schwellenwerte für die Anzahl der Datensätze).
- Das Entwerfen leistungsfähiger Abfragen und das Archivieren älterer Tabellendatensätze in Tabellen mit hohem Datenaufkommen (z. B. > 10 Millionen Datensätze) trägt dazu bei, eine reaktionsschnelle Lösung aufrechtzuerhalten, was die Produktivität der Bediener und die Benutzererfahrung direkt unterstützt.
Typische Position von Tulip im Datenfluss eines Unternehmens
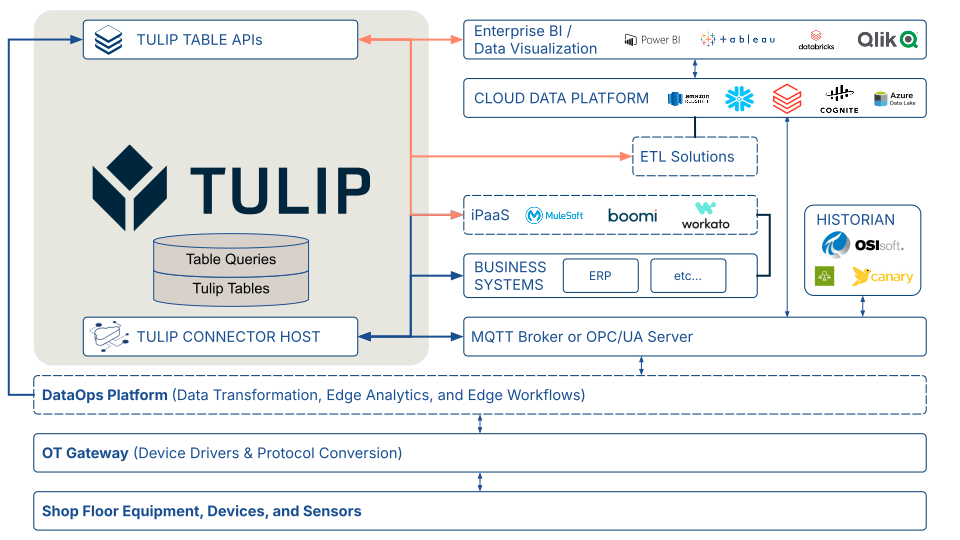
Als Frontline-Betriebsplattform, die als zentrale Übersicht konzipiert ist, hostet Ihre Tulip-Lösung kritische Fertigungsdaten und lässt sich mit anderen Datenquellen im gesamten Unternehmen integrieren. Sehen Sie sich das folgende Architekturdiagramm an. Ihre Tulip-Lösung kann über Connector-Funktionen mit unternehmensweiten Geschäftssystemen und über einen MQTT-Broker oder einen OPC-UA-Server, der als Ihre konfiguriert ist, mit Anlagen in der Fertigung interagieren. Ihre iPaaS- und ETL-Lösungen sowie unternehmensweite Datenvisualisierungstools können über Tabellen-APIs mit Ihrer Tulip-Lösung interagieren.
Tulip-Ressourcen für das gemeinsame Datenmodell
Tulip stellt verschiedene Ressourcen bereit, um die Lösungsentwicklung mit einem gemeinsamen Datenmodell auf Basis von Tabellen zu beschleunigen. Weitere Informationen finden Sie unter:
Weitere Artikel zum gemeinsamen Datenmodell
- Gemeinsames Datenmodell
- Beispiel: Verwendung des gemeinsamen Datenmodells für diskrete Anwendungsfälle
- Beispiel: Verwendung des gemeinsamen Datenmodells für Anwendungsfälle in der Pharmabranche
Ressourcen der Tulip-Bibliothek zum gemeinsamen Datenmodell
- Tulip Common Data Model Base Kit{
target=_blank} - Tabellen-Kits
Tabellenoptimierung für Skalierbarkeit
Bewährte Verfahren für skalierbares Tabellen-Design
Die Tabellen im Common Data Model der Tulip-Bibliothek basieren auf den unten beschriebenen Best Practices. Diese Tabellen – und die ihnen zugrunde liegenden Prinzipien – dienen als praktischer Leitfaden für die Gestaltung von Tabellen, die langfristig skalierbar und in der Tulip-Logik nutzbar bleiben.
Gestalten Sie Tabellen horizontal skalierbar (hoch statt breit).
Betrachten wir eine Stücklistentabelle. Ein neuer Tulip-App-Entwickler könnte versucht sein, eine „breite“ Tabelle mit einer separaten Spalte „Nummer“ für jede Komponente in einer Baugruppe zu erstellen. Auch wenn dies kurzfristig einfach erscheinen mag, erschwert es schnell die Wiederverwendung von Abfragen, belastet die Trigger-Logik und schränkt die Anwendbarkeit der Tabelle auf andere Baugruppen ein.
In der unten stehenden Stücklistentabelle (BOM) stellen die Spalten das übergeordnete Element und die Komponente einer Baugruppe dar. Wenn eine Baugruppe fünf Komponenten hat, enthält die Tabelle fünf Datensätze. Diese Struktur unterstützt eine n-stufige Hierarchie, da eine Unterbaugruppe in einer Beziehung als „übergeordnetes Element“ und in einer anderen als „Komponente“ fungieren kann.
Beachten Sie außerdem, dass dieser Tabellenaufbau sowohl produkt- als auch branchenunabhängig ist – er könnte die Stückliste für alles Mögliche speichern, von einer Mahlzeit bis hin zu einem Verkehrsflugzeug.
Empfohlene Struktur für eine Stücklistentabelle| Bezeichnung | Feldtyp | Beschreibung || --- | --- | --- || ID | Text | Erforderlich: Eindeutige Kennung || ID der übergeordneten Materialdefinition | Text | Eindeutige Kennung der übergeordneten BaugruppeMaterialdefinition || Beschreibung des übergeordneten Materials | Text | Beschreibung des übergeordneten Materials || ID der Materialdefinition der Komponente | Text | Eindeutige Kennung der Materialdefinition der Komponente || Beschreibung des Materials der Komponente | Text | Beschreibung des Materials, das montiert oder verbraucht werden soll || Menge der Komponente | Zahl | Menge des Materials, das montiert oder verbraucht werden soll || Maßeinheit der Komponente | Text | Maßeinheit der Komponente || Verwendungsort | Text | Ort, Vorgang oder Schritt, an dem das Material montiert oder verbraucht wird |
Vermeiden Sie sehr breite Tabellen
Die Tulip-Plattform unterstützt zwar bis zu 200 Spalten, doch eine Tabelle mit mehr als etwa 50 Spalten kann ein Hinweis darauf sein, dass das zugrunde liegende Datenmodell im Hinblick auf langfristige Skalierbarkeit überdacht werden muss.
Vermeiden Sie es, zu viele unterschiedliche „Dinge“ in einer einzigen Tabelle zu speichern
In diesem Zusammenhang bezieht sich ein „Ding“ auf einen anwendungsspezifischen Typ einer Datenentität. Beispielsweise könnte eine Tabelle „Ausrüstung & Anlagen“ Kontextdaten sowohl für Fertigungsanlagen als auch für Werkzeuge speichern, für die eine Kalibrierungsnachverfolgung erforderlich ist. Es kann zwar praktisch sein, verschiedene Arten von Entitäten in derselben Tabelle zu speichern, dies ist jedoch am sinnvollsten, wenn:
- Die Verwendung der Datensatz-ID über alle Entitätstypen hinweg einheitlich ist.
- Im Beispiel „Betriebsausstattung“ und „kalibrierte Werkzeuge“ ist die Datensatz-ID in der Regel die Anlagenkennnummer des Unternehmens.
- Die verschiedenen Entitätstypen teilen sich etwa 50 % oder mehr der Spalten.
- Wenn die verschiedenen Entitätstypen nur sehr wenige gemeinsame Spalten haben, ist es wahrscheinlich besser, sie in separaten Tabellen zu speichern.
- Es besteht keine Eins-zu-Viele-Beziehung zwischen den Entitätstypen.
- Beispielsweise kann ein Los viele Arbeitsaufträge enthalten. Selbst wenn Arbeitsaufträge und Lose mehr als 50 % der Spalten gemeinsam haben – und die ID-Spalte entweder als Arbeitsauftrags-ID oder als Los-ID dient – kann die „Eins-zu-Viele“-Beziehung zwischen ihnen das Abfrage-Design und die Trigger-Logik verkomplizieren, was zu einem Tabellenmodell führt, das sowohl für Lösungsentwickler als auch für Datennutzer unintuitiv ist.
- Konsens unter den Beteiligten.
- Die Lösungsentwickler und die Nutzer der Daten sind sich im Allgemeinen einig, dass die verschiedenen Entitätstypen grundsätzlich ähnlich sind (z. B. „Fertigungsanlagen“ und „kalibrierte Werkzeuge“).
Praktische Einschränkungen von Tabellen
Ratenbeschränkungen
Tulip wendet Ratenbegrenzungen auf Assets an, um den Nutzern eine konsistente und zuverlässige Erfahrung in Bezug auf Folgendes zu bieten:
- Das Schreiben von Datensätzen
- Löschen von Datensätzen
Erfahren Sie hier mehr über die Ratenbegrenzungen für Tabellen.
Beschränkungen der Datensatzanzahl
Die Tulip-Plattform legt keine feste Obergrenze für die Anzahl der Datensätze in einer Tabelle fest; je nach Nutzung der Tabelle besteht jedoch eine praktische Grenze. Mit steigender Datensatzanzahl kommt es häufig zu Leistungseinbußen bei Abfragen und Aggregationen, was sich auf die Zuverlässigkeit der Anwendung, die Benutzererfahrung der Bediener und die Produktivität in der Fertigung auswirken kann.
Es gibt dokumentierte Fälle, in denen Produktionsanwendungen von Tulip-Kunden mit Tabellen arbeiten, die mehr als 10 Millionen Datensätze enthalten, wobei die allein auf die Datensatzanzahl zurückzuführenden Leistungseinbußen vernachlässigbar sind.
Tabellenoptimierung für Zuverlässigkeit und Leistung
Verwendung verknüpfter Datensätze minimieren
In früheren Versionen der Tulip-Plattform wiesen Tabellen mit mehreren Spalten für verknüpfte Datensätze und mehr als einer Million Datensätzen erhebliche Leistungsprobleme auf. Durch Verbesserungen an der Plattform wurde dieses Problem weitgehend behoben, dennoch gilt es aus mehreren Gründen weiterhin als bewährte Vorgehensweise, die Verwendung verknüpfter Datensätze zu minimieren oder einzuschränken:
- Leistung bei großem Datenvolumen
- Extraktion von Tabellendatensätzen über APIs oder CSV-Download
- Bekannte Funktionseinschränkungen (z. B. die Unmöglichkeit, eine eingebettete interaktive Tabelle anhand einer Spalte aus einer verknüpften Tabelle zu filtern)
Erstellung leistungsfähiger Abfragen
Die Abfrageleistung hängt von Ihren Filtertypen ab
| Filtertyp | Leistung bei hoher Auslastung | Hinweise |
|---|---|---|
| gleich | Gut bis ausgezeichnet | Hervorragend für den exakten Abgleich in Textspalten. Verwenden Sie nach Möglichkeit immer „Gleich“-Filter anstelle anderer Filtertypen. |
| beginnt mit | Gut | |
| ist in | Befriedigend bis gut | Am besten bei einer kurzen Liste (< 10 Einträge). Die Leistung nimmt mit zunehmender Listenlänge ab. |
| ist null | Befriedigend bis mäßig | Abfragen, die sich ausschließlich auf diesen Filter stützen, können langsam sein, wenn die meisten Datensätze in dieser Spalte Nullwerte enthalten. |
| ist nicht null | Befriedigend bis mäßig | Umgekehrt kann diese Abfrage sehr schnell Ergebnisse liefern, wenn die meisten Datensätze den Wert „null“ enthalten. |
| endet mit | Befriedigend bis mäßig | Groß-/Kleinschreibung wird nicht berücksichtigt. Die Leistung verschlechtert sich bei großen Ergebnisgrenzen und hohen Datensatzzahlen. |
| enthält | Befriedigend bis mäßig | Groß-/Kleinschreibung wird nicht berücksichtigt. Die Leistung nimmt bei großen Ergebnisgrenzen und hohen Datensatzzahlen ab. |
| ist nicht gleich | Schlecht bis befriedigend | |
| ist nicht in | Schlecht bis befriedigend | |
| beginnt nicht mit | Schlecht bis Befriedigend | |
| endet nicht mit | Schlecht bis Befriedigend | |
| enthält nicht | Schlecht bis Befriedigend |
Die Abfrageleistung hängt von der Anzahl der Filter ab
Achten Sie beim Entwerfen von Abfragen auf das richtige Gleichgewicht: genügend Filter, um präzise Ergebnisse zu liefern, und gleichzeitig die Wiederverwendbarkeit der Abfrage für ähnliche Anwendungsfälle zu gewährleisten. Es ist selten, dass mehr als drei oder vier Filter benötigt werden.
If you are building a query with many filters, it may indicate that your table model lacks scalability and would benefit from a partial redesign.
Legen Sie immer ein angemessenes Abfrage-Limit fest
Legen Sie für jede Abfrage ein LIMIT fest und verwenden Sie dabei den kleinsten Wert, der Ihren Anwendungsfall erfüllt:
- Prüfen, ob mindestens ein passender Datensatz vorhanden ist: 1 Datensatz
- Berichterstellung: Ziehen Sie stattdessen die Verwendung von Analytics in Betracht
- Andere Anwendungsfälle: Berücksichtigen Sie die realistische maximale Anzahl von Datensätzen, die basierend auf den verwendeten Abfragefiltern abgerufen oder ausgewertet würden, und verwenden Sie diese Zahl als LIMIT (sofern sie unter 1.000 liegt).
Warum das wichtig ist:
Eine Abfrage mit dem Standardlimit von 1.000 versucht, bis zu 1.000 passende Datensätze abzurufen – selbst wenn nur eine Handvoll benötigt wird. Unnötig große Limits verbrauchen Zeit und Ressourcen in Anwendungsfällen, in denen eine kleinere Ergebnismenge ausreichen würde.
Grundlagen der Strategie zur Archivierung von Tabellendatensätzen
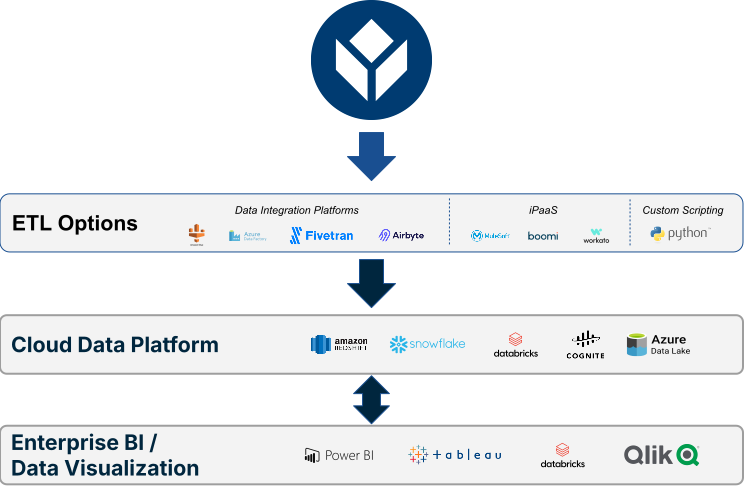
Im Rahmen dieser Erörterung bezieht sich „Archivierung“ auf den Prozess, bei dem Datensätze aus einer oder mehreren Tabellen extrahiert, über eine ETL-Lösung (z. B. eine iPaaS- oder Datenintegrationsplattform) in eine Cloud-Datenplattform zu laden und diese Datensätze anschließend aus den Tabellen zu löschen.
Hintergrund und Empfehlung
- Tulip legt keine feste Obergrenze für die Anzahl der Datensätze fest, die in Tabellen gespeichert werden können.
- Tulip empfiehlt, die Anzahl der Datensätze in einzelnen Tabellen auf einige Millionen oder weniger zu beschränken, da die Abfrageleistung mit steigender Datensatzanzahl nachlassen kann.
- Leistungsprobleme werden durch die Verwendung verknüpfter Datensätze und schlecht konzipierter Abfragen noch verstärkt.
Empfehlung:
Halten Sie die Anzahl der Datensätze in Tabellen unter 10 Millionen, indem Sie ältere Datensätze regelmäßig auf eine Cloud-Datenplattform verschieben.
Planung und Umsetzung der Archivierung von Tabellendatensätzen
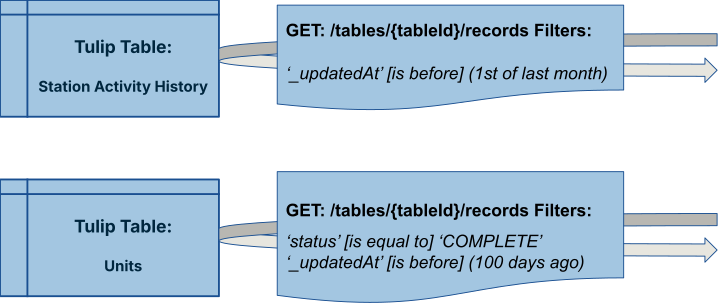
- Definieren Sie die Archivierungskriterien – legen Sie die Abfragefilter fest, mit denen in jeder Tabelle die für die Archivierung in Frage kommenden Datensätze identifiziert werden.
- Beispiel: Für eine Tabelle „Station Status History“ könnten Sie alle Datensätze archivieren, deren Datum vor dem ersten Tag des Vormonats liegt.
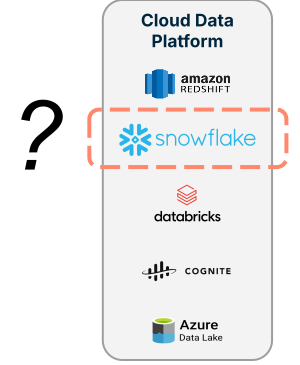
- Legen Sie das Ziel fest – wählen Sie Ihre gewünschte Cloud-Datenplattform aus (z. B. Redshift, Snowflake, Databricks usw.).
- Wählen Sie eine ETL-Lösung aus – entscheiden Sie sich für eine Datenintegrationsplattform, ein iPaaS-Tool eines Drittanbieters oder benutzerdefinierte Python-Skripte, um die Datenübertragung durchzuführen.
- Führen Sie eine erste Massenmigration durch – verschieben Sie alle Datensätze, die die in Schritt 1 definierten Kriterien erfüllen, stapelweise an das in Schritt 2 festgelegte Ziel.
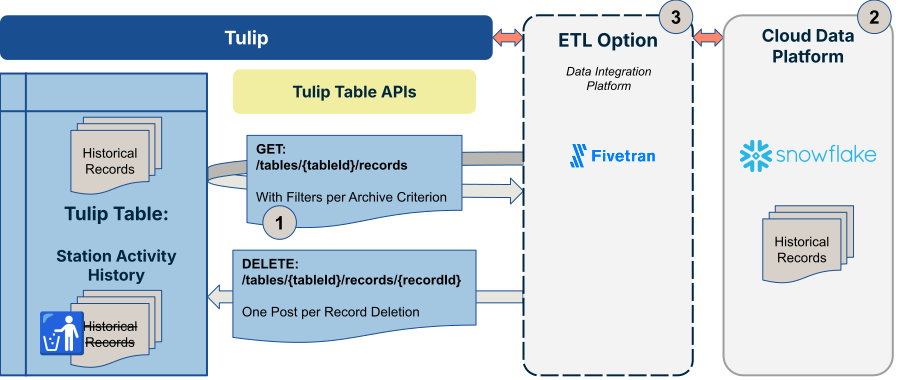
- Planen Sie wiederkehrende inkrementelle Migrationen – richten Sie einen automatisierten Prozess ein, um ähnliche Datensatzverschiebungen fortlaufend durchzuführen. Eine gängige bewährte Vorgehensweise besteht darin, solche Datensatzverschiebungen sehr häufig durchzuführen, z. B. alle 15 Minuten für Tabellen, die im Laufe eines typischen Arbeitstages aktualisiert werden.
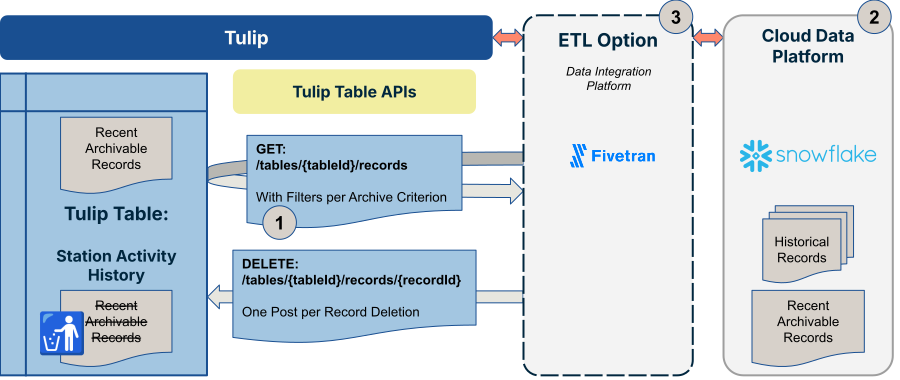
Ausführlichere Anleitungen zu den Punkten 4 und 5 finden Sie weiter unten unter „Bewährte Verfahren zur Archivierung von Tabellendatensätzen“.
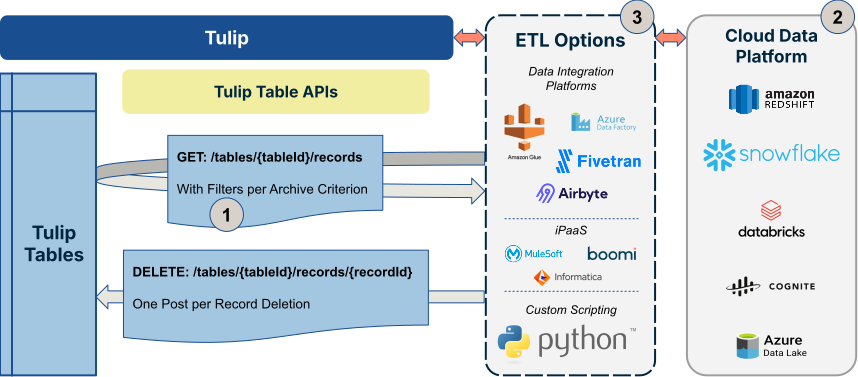
Weitere Ressourcen zu ETL-Optionen:
- Datenintegrationsplattformen
- Fivetran
- Microsoft Fabric
- Cloud-Datenplattformen
- Snowflake
- Cognite
Bewährte Verfahren zur Archivierung von Tabelleneinträgen
Verwenden Sie die Sequenznummer als Cursor
Verwenden Sie beim Blättern durch Datensätze die Sequenznummer als Cursor anstelle einer offsetbasierten Paginierung.
Warum die Offset-basierte Paginierung versagt: Wenn während der Synchronisierung Datensätze eingefügt oder aktualisiert werden, kann die Offset-basierte Paginierung Datensätze überspringen oder doppelt anzeigen. Auf der Sequenznummer basierende Cursor sind stabil – „sequenceNumber > last_seen_seq“ liefert Ihnen immer die richtige nächste Seite, unabhängig von gleichzeitigen Schreibvorgängen.
Die Synchronisierung einer Tabelle erfolgt in zwei Phasen: einem einmaligen Massenladevorgang zum Laden aller historischen Datensätze, gefolgt von wiederkehrenden inkrementellen Migrationen zur Erfassung von Änderungen. Bei beiden sollte die Sequenznummer als Cursor verwendet werden.
Anfänglicher Massenladevorgang, gefolgt von inkrementellen Migrationen
Führen Sie vor der Ausführung inkrementeller Synchronisierungen einen einmaligen Massenladevorgang durch – eine vollständige Ladung aller historischen Datensätze. Dadurch erhält Ihr Ziel eine vollständige Basis.
Vorgehensweise:
- Beginnen Sie mit
last_seq = 0(oder dem zuletzt gespeicherten Checkpoint, wenn Sie einen unterbrochenen Massenladevorgang fortsetzen) - Seiten nach aufsteigender Sequenznummer sortiert abrufen
- Schreiben Sie jede Seite in das Ziel
- Speichern Sie etwa alle 500 Datensätze einen Checkpoint
- Beenden, wenn eine Seite keine Datensätze mehr zurückgibt
Ratenbegrenzungen beachten und exponentielles Backoff anwenden
Die Tulip Tables API wendet bei allen Anfragen Ratenbegrenzungen an. Um dies korrekt zu handhaben, gibt es zwei Ansätze:
Proaktive Drosselung – Verteilen Sie Ihre Anfragen zeitlich so, dass Sie von Anfang an innerhalb des Limits bleiben, anstatt darauf zu warten, dass sie abgelehnt werden
Reaktives Backoff – Wenn trotz Drosselung ein 429-Fehler empfangen wird (z. B. weil andere parallele Prozesse dieselbe API-Quote des Arbeitsbereichs nutzen), reduzieren Sie die GET-Häufigkeit und versuchen Sie es erneut.
Die aktuellen Grenzwerte finden Sie im Leitfaden zu den Ratenbegrenzungen der Tulip-API. Codieren Sie die Grenzwerte nicht fest in Ihre ETL-Lösung ein – verwenden Sie stattdessen eine benannte Konstante, damit sie bei Änderungen der Grenzwerte leicht aktualisiert werden können.
Verknüpfte Datensatzfelder mithilfe des Feldfilters ausschließen
Tabellen unterstützen verknüpfte Datensatzfelder (Typ „tableLink“) – Felder in einer Tabelle, die auf Datensätze in einer anderen Tabelle verweisen. Wenn ein „tableLink“-Feld in einer Datensatzantwort enthalten ist, muss die Tulip-API diese Verweise serverseitig auflösen, was zu kaskadierenden Datenbankabfragen führt. Bei Tabellen mit vielen verknüpften Feldern oder einer großen Anzahl von Datensätzen belastet dies die Datenbank erheblich und wirkt sich auf alle Nutzer des Arbeitsbereichs aus.
Die Lösung: Verwenden Sie den Abfrageparameter „fields“, um die Felder, die zurückgegeben werden sollen, explizit aufzulisten, und schließen Sie „tableLink“-Felder vollständig aus. Dies erfordert einen geringen Vorbereitungsaufwand – Sie müssen zunächst das Tabellenschema abrufen, um zu wissen, welche Felder einbezogen werden sollen –, ist jedoch der richtige Ansatz und führt zu schnelleren, ressourcenschonenderen Abfragen.
Checkpoint-basierte Fehlerbehebung
Netzwerkausfälle, Timeouts und unerwartete Fehler werden auftreten. Entwerfen Sie Ihren Konnektor so, dass er sich reibungslos erholt, ohne von Grund auf neu starten zu müssen.
Muster:
- Speichern Sie nach jeweils etwa 500 Datensätzen die zuletzt erfolgreich verarbeitete Sequenznummer in einem dauerhaften Speicher ab
- Laden Sie beim Neustart den Checkpoint und setzen Sie die Verarbeitung ab seq > checkpoint_seq fort
- Schreiben Sie Datensätze mithilfe der „Upsert“-Logik (nicht mit „Inserts“) in den Zielspeicher, damit die erneute Verarbeitung von Datensätzen ab dem Checkpoint sicher ist
Umgang mit dem Löschen von Datensätzen
Die Tulip-Tables-API stellt keinen Strom von Löschereignissen bereit. Wenn ein Datensatz in Tulip endgültig gelöscht wird, hat der Konnektor keine Möglichkeit, dies zu erkennen – der Datensatz verschwindet einfach ohne Benachrichtigung aus der API. Wie Sie damit umgehen, hängt davon ab, was das externe Ziel tun soll.
- Szenario A: Das Ziel mit Tulip synchron halten (Löschungen spiegeln)
- Wenn Ihr Ziel darin besteht, dass das Ziel den aktuellen Zustand von Tulip widerspiegelt – einschließlich Löschungen –, dann löschen Sie Datensätze in Tulip nicht endgültig. Der Konnektor kann eine Löschung, die er nie sieht, nicht weiterleiten.
- Fügen Sie stattdessen der Tabelle eine boolesche Spalte hinzu – „archiviert“ oder „gelöscht“ – und setzen Sie diese auf „true“, wenn ein Datensatz als inaktiv behandelt werden soll. Da es sich hierbei um eine Feldaktualisierung handelt, wird diese bei der nächsten inkrementellen Synchronisierung erfasst und automatisch an das Ziel geschrieben, ohne dass eine spezielle Konnektorlogik erforderlich ist. Sie können diese Datensätze dann am Ziel herausfiltern.
- In Tulip: Fügen Sie eine boolesche Spalte „archiviert“ hinzu und aktualisieren Sie diese über Ihre App, eine Funktion oder eine Automatisierung, wenn der Datensatz als „inaktiv“ behandelt werden soll, anstatt ihn zu löschen.
- Im Zielsystem: Filtern Sie in Ihren Abfragen und Berichten nach „archiviert = false“, anstatt davon auszugehen, dass alle synchronisierten Datensätze aktiv sind.
- Szenario B: Tulip aus Leistungsgründen bereinigen, Datensätze im Zielsystem behalten
- Tulip-Tabellen bieten eine bessere Leistung, wenn sie schlank gehalten werden. Wenn eine Tabelle sehr groß wird, ist das endgültige Löschen alter oder abgeschlossener Datensätze eine sinnvolle Methode, um ihre Größe zu verwalten – zum Beispiel durch das Archivieren abgeschlossener Arbeitsaufträge nach einer Aufbewahrungsfrist.
- In diesem Szenario ist das endgültige Löschen in Tulip unbedenklich. Da der Konnektor niemals ein Löschereignis erhält, werden aus Tulip entfernte Datensätze im Ziel einfach nie wieder aktualisiert – sie bleiben unverändert erhalten. Das Ziel wird zu einem Langzeitarchiv, während Tulip leistungsfähig bleibt.
- Für dieses Muster sind keine Änderungen am Connector erforderlich. Stellen Sie lediglich sicher, dass nachgelagerte Verbraucher verstehen, dass das Ziel Datensätze enthalten kann, die in Tulip nicht mehr vorhanden sind, und gestalten Sie ihre Abfragen entsprechend (z. B. durch einen Join auf den Zeitstempel „completed_at“, anstatt davon auszugehen, dass der Datensatz in Tulip noch aktiv ist).
Weiterführende Informationen
- Weitere Anleitungen zu diesem Thema finden Sie in der Tulip-Community in diesem Thread: Ansätze und Best Practices für den Tulip-Tabellen-Konnektor – Arbeiten mit Airbyte, FiveTran und anderen ETL-Tools
- Tulip-Webinar – Saubere Tabellen, schnelle Apps: Ein Leitfaden für App-Entwickler zur Optimierung von Datenmodellen{
target=_blank}
{{snippet.Haben Sie gefunden, wonach Sie gesucht haben?}}