

Découvrez comment stocker et gérer de manière optimale les données au sein de Tulip.
Tout comme les applications, les données dans Tulip doivent fonctionner ensemble comme un système. Garder les données facilement accessibles pour informer les personnes et les autres systèmes améliore la visibilité et évite la duplication des données à plusieurs endroits.
Bonnes pratiques
Voici quelques principes à suivre lors de la conception d’une structure de données pour vos applications :
Adoptez une structure de « jumeau numérique » pour les tables
Un jumeau numérique est une représentation ou un modèle virtuel et dynamique d’une pièce, d’un objet, d’une machine, voire d’un processus de production complet. Il se compose de l’élément physique lui-même, de sa représentation virtuelle et de la fonctionnalité de connexion qui permet aux données de circuler entre l’objet physique et l’objet virtuel.
Les tables Tulip doivent refléter le plus fidèlement possible la réalité de votre atelier.
Organisez les tables par type d’information
Il est préférable d’identifier les types de tableaux et de les définir. Comprendre quelles informations doivent figurer dans quels tableaux est particulièrement crucial lors de la conception d’une solution.
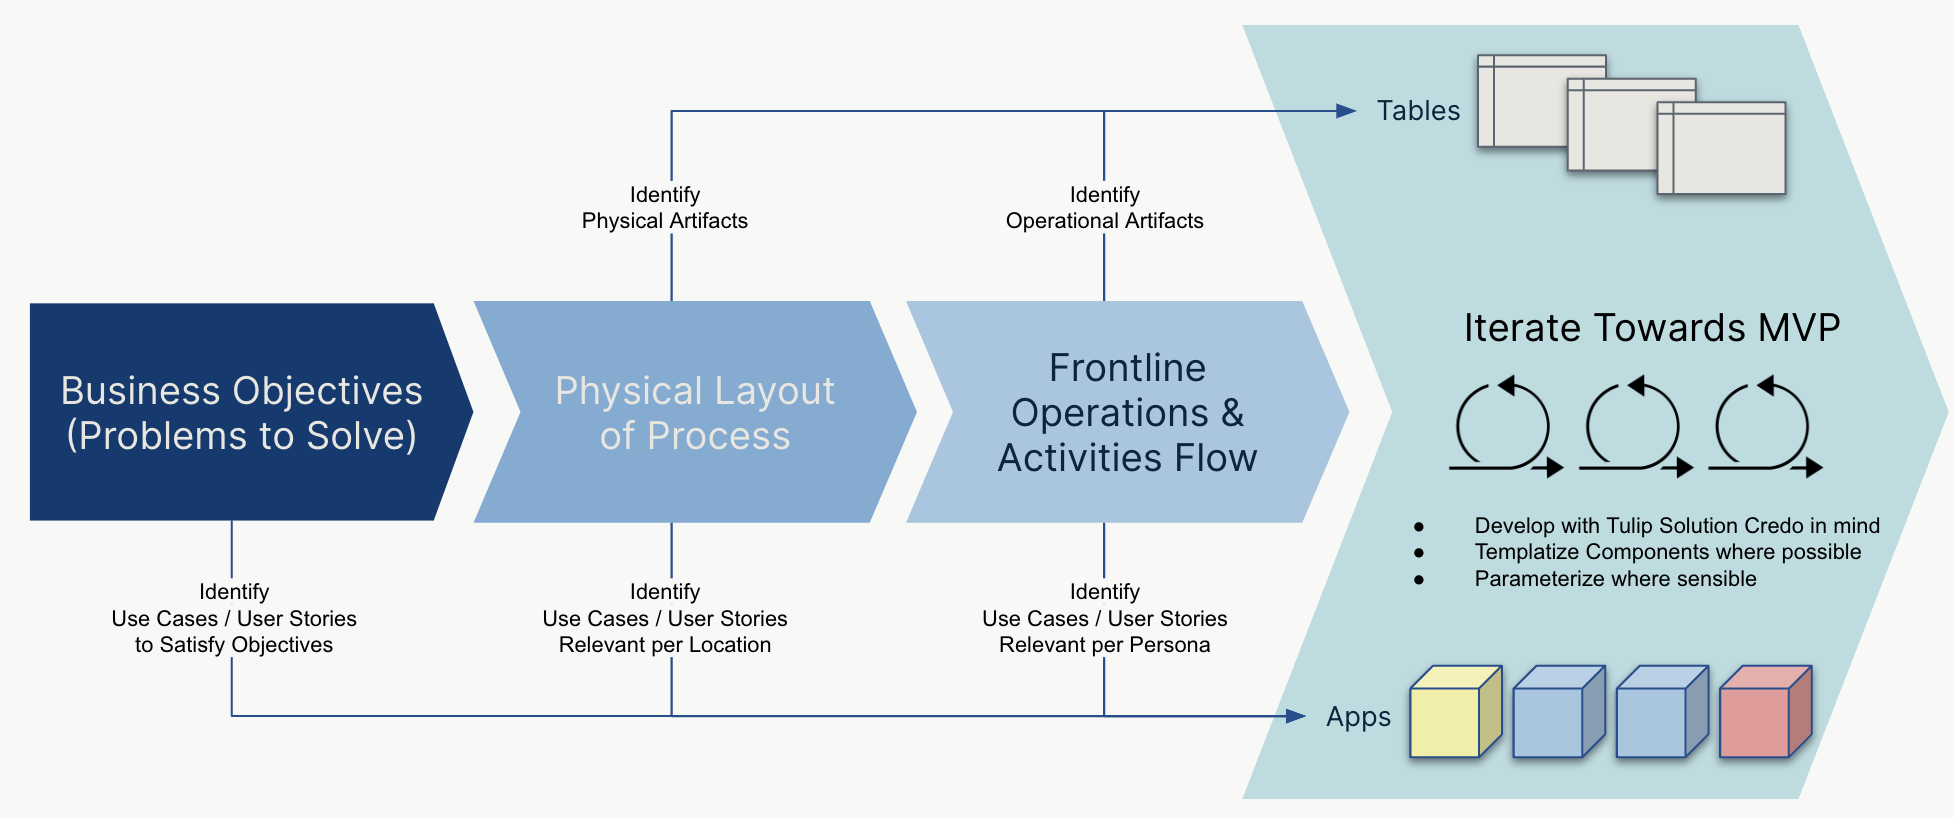
Par exemple, les tables du modèle de données commun présenté par Tulip sont réparties en deux catégories :
| Catégorie | Description | Exemples |
|---|---|---|
| Artefact physique | Il s’agit d’un objet tangible que vous pouvez physiquement toucher dans votre atelier | Articles en stock, équipements et actifs |
| Artéfacts opérationnels | Il s’agit d’un élément immatériel doté d’un identifiant unique, que l’on retrouve couramment dans le cadre des opérations. Ces éléments se présentent souvent sous la forme de fiches de suivi ou de bons imprimés. | Fiche Kanban, ordre de travail |
It’s important to remember that tables should avoid duplicating external data.
Structure et configuration des tables
Les tables et les champs doivent être simples et avoir un objectif clair quant aux informations qu’ils stockent. En utilisant les types de tables évoqués précédemment (artefacts physiques et artefacts opérationnels), vous pouvez définir précisément l’objectif de chaque table.
Les champs de chaque table dépendent des informations pertinentes pour les artefacts. En règle générale, la plupart des tables doivent comporter un champ « statut » (ou similaire). Voici d’autres champs courants que vous pouvez ajouter :
- Matériau
- Emplacement/Compartiment
- Identifiants (ordre de travail, article, client, etc.)
- Mesures
- Dates de début, de demande ou d'achèvement
- Commentaires
- Photo
Pour toutes les données que vous souhaitez utiliser dans des calculs, créez une requête ou une agrégation. Les calculs qui alimentent les objectifs et les indicateurs clés de performance (KPI) vous permettront d’obtenir un aperçu des opérations en cours.
Conventions de nommage
Gardez à l’esprit que les noms de tables et de colonnes que vous utilisez peuvent être vus par d’autres développeurs citoyens et par les opérateurs dans Tulip Analytics ; veillez donc à utiliser des noms intuitifs et centrés sur l’utilisateur pour les tables et les colonnes, plutôt que les conventions de nommage généralement utilisées par les ingénieurs logiciels. Par exemple, donnez à une table un nom tel que « Équipements et outils » plutôt que « eqps_tools », et utilisez des noms de colonnes tels que « Type d’équipement » plutôt que « eqpType ».
En savoir plus sur les bonnes pratiques de nommage des éléments dans Tulip.
Optimisation des tables pour l’évolutivité et les performances
L’article dont le lien figure ci-dessus aborde les principes fondamentaux de la mise en œuvre et de la maintenance d’un modèle d’ Tulip table qui soit : performant, fiable, modulable et évolutif.
Quand utiliser les enregistrements de fin d’application
Un enregistrement de fin d’application est créé soit lors de la fermeture d’une application via une transition telle que « App / Complete App », soit par l’action déclencheuse « Save All App Data ». Les données historiques sont traditionnellement suivies via la fermeture d’application et stockées dans des enregistrements de fin d’application, qui sont propres à chaque application.
Si vous avez uniquement besoin de stocker des données à des fins d’historique des processus et/ou pour effectuer des analyses sur ces données via Analytics, les enregistrements de fin d’application sont probablement suffisants et constituent le moyen le plus simple de sauvegarder ces données.
En savoir plus sur les enregistrements de fin d’application.
Envisagez un modèle de données commun
Un modèle de données commun favorise la composabilité, un facteur clé de la réussite avec Tulip. Lorsque vous développez une suite d’applications, il est important de disposer également d’un modèle de données servant de base pour « relier » les applications à l’aide de données réutilisables.
En savoir plus sur l’utilisation d’un modèle de données commun.
Vous pouvez également commencer par le modèle de données commun de Tulip, que vous pourrez ensuite adapter à vos besoins.