

了解如何在 Tulip 中优化数据的存储与管理。
与应用程序类似,Tulip 中的数据应作为一个系统协同工作。确保数据易于访问,以便为人员和其他系统提供信息,这不仅能提高透明度,还能避免数据在多处重复。
最佳实践
在为应用程序规划数据结构时,您应遵循以下几项原则:
为表采用数字孪生结构
数字孪生是零件、物体、机器甚至整个生产过程的动态虚拟表示或模型。它由实物本身、该实物的虚拟表示,以及允许数据在实物与虚拟对象之间双向传输的连接功能组成。
Tulip 表格应尽可能以 1:1 的比例反映您的车间实际情况。
按信息类型组织表
最好先识别表格类型并对其进行定义。在设计解决方案时,了解哪些信息应放入哪些表格尤为关键。
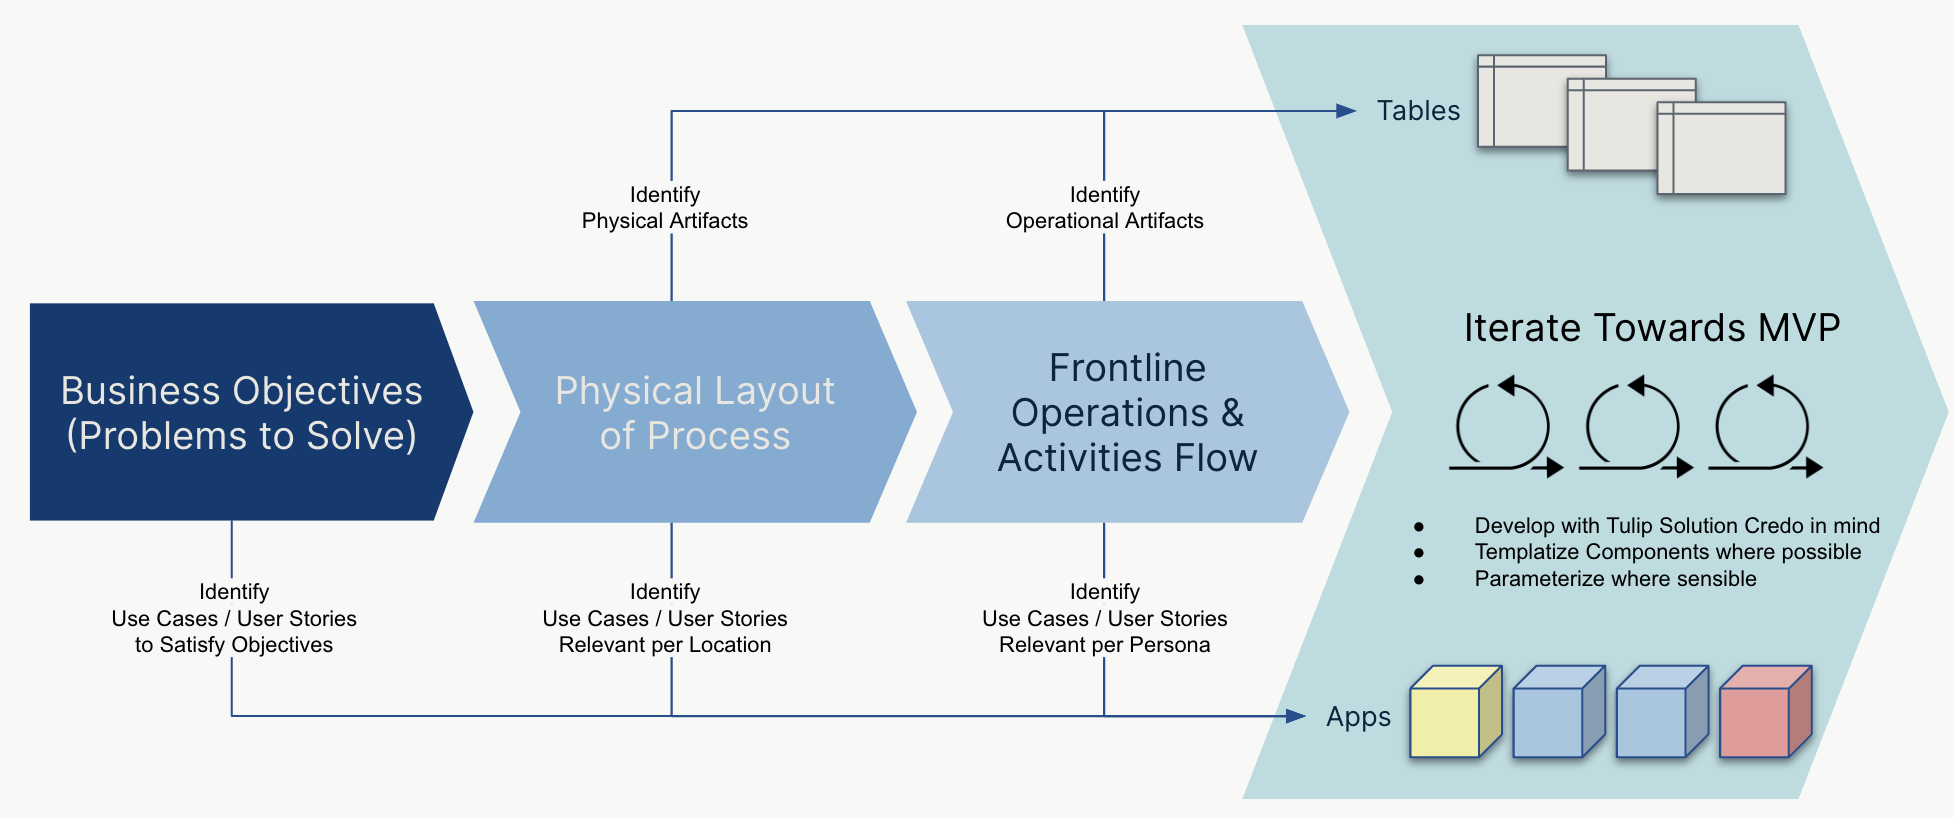
例如,Tulip 示例中的通用数据模型将表分为两类:
| 类别 | 描述 | 示例 |
|---|---|---|
| 物理实体 | 这是生产车间中可以实际触摸到的有形物品 | 库存项目、设备及资产 |
| 运营实物 | 这是具有唯一标识符的无形元素,通常与运营相关。这些通常以打印的流转单或票据的形式出现。 | 看板卡、工作单 |
It’s important to remember that tables should avoid duplicating external data.
表结构与设置
表和字段应设计简洁,并明确其存储信息的用途。通过使用前文讨论过的表类型(物理工件和运营工件),您可以精确定义每个表的用途。
各表的字段取决于与实物相关的信息。一个很好的经验法则是:大多数表都应包含一个“状态”(或类似)字段。您还可以添加其他常见字段,包括:
- 物料
- 位置/货位
- ID(工单、物料、客户等)
- 测量值
- 开始、申请或完成日期
- 备注
- 照片
对于任何您希望用于计算的数据,请创建查询或聚合。那些为目标和关键绩效指标(KPI)提供依据的计算,将使您能够获取当前运营状况的快照。
命名规范
请注意,您使用的表名和列名可能会被其他“公民开发者”以及 Tulip Analytics 中的操作员看到,因此请务必为表和表列使用直观且以人为中心的名称,而不是使用软件工程师通常采用的命名约定。 例如,将表命名为“设备和工具”,而不是“eqps_tools”;将列命名为“设备类型”,而不是“eqpType”。
为可扩展性和性能进行的表优化
上文链接的文章探讨了如何构建和维护一个兼具高性能、高可靠性、可组合性和可扩展性的Tulip table 模型的基础知识。
何时使用完成记录
完成记录可通过**“应用/完成应用**”等转换操作来完成应用,或通过**“保存所有应用数据”**触发操作来创建。历史数据通常通过“应用完成”进行追踪,并存储在各应用本地的完成记录中。
如果您仅需存储数据以供流程历史记录之用,和/或通过 Analytics 对这些数据进行分析,那么“完成记录”通常已足够,且是保存此类数据最简便的方式。
考虑采用通用数据模型
通用数据模型能够实现可组合性,这是在 Tulip 中取得成功的关键因素。在构建应用程序套件时,建立一个数据模型作为基础,通过可重用的数据将应用程序“连接”起来,这一点非常重要。
您也可以从Tulip 通用数据模型入手,随后根据需要进行调整。