

Узнайте, как оптимально хранить данные и управлять ими в Tulip.
Подобно приложениям, данные в Tulip должны работать вместе как единая система. Обеспечение легкого доступа к данным для информирования людей и других систем повышает прозрачность и позволяет избежать дублирования данных в разных местах.
Передовой опыт
Вот несколько принципов, которым следует придерживаться при планировании структуры данных для ваших приложений:
Используйте структуру «цифрового двойника » для таблиц
«Цифровой двойник» — это динамическое виртуальное представление или модель детали, объекта, машины или даже всего производственного процесса. Он состоит из самого физического объекта, его виртуального представления и соединительной функциональности, которая позволяет данным передаваться между физическим и виртуальным объектами.
Таблицы Tulip должны как можно точнее (в масштабе 1:1) отражать то, что происходит на вашем производстве.
Структурируйте таблицы по типу информации
Лучше всего определить типы таблиц и дать им определения. Понимание того, какая информация попадает в какие таблицы, особенно важно при разработке решения.
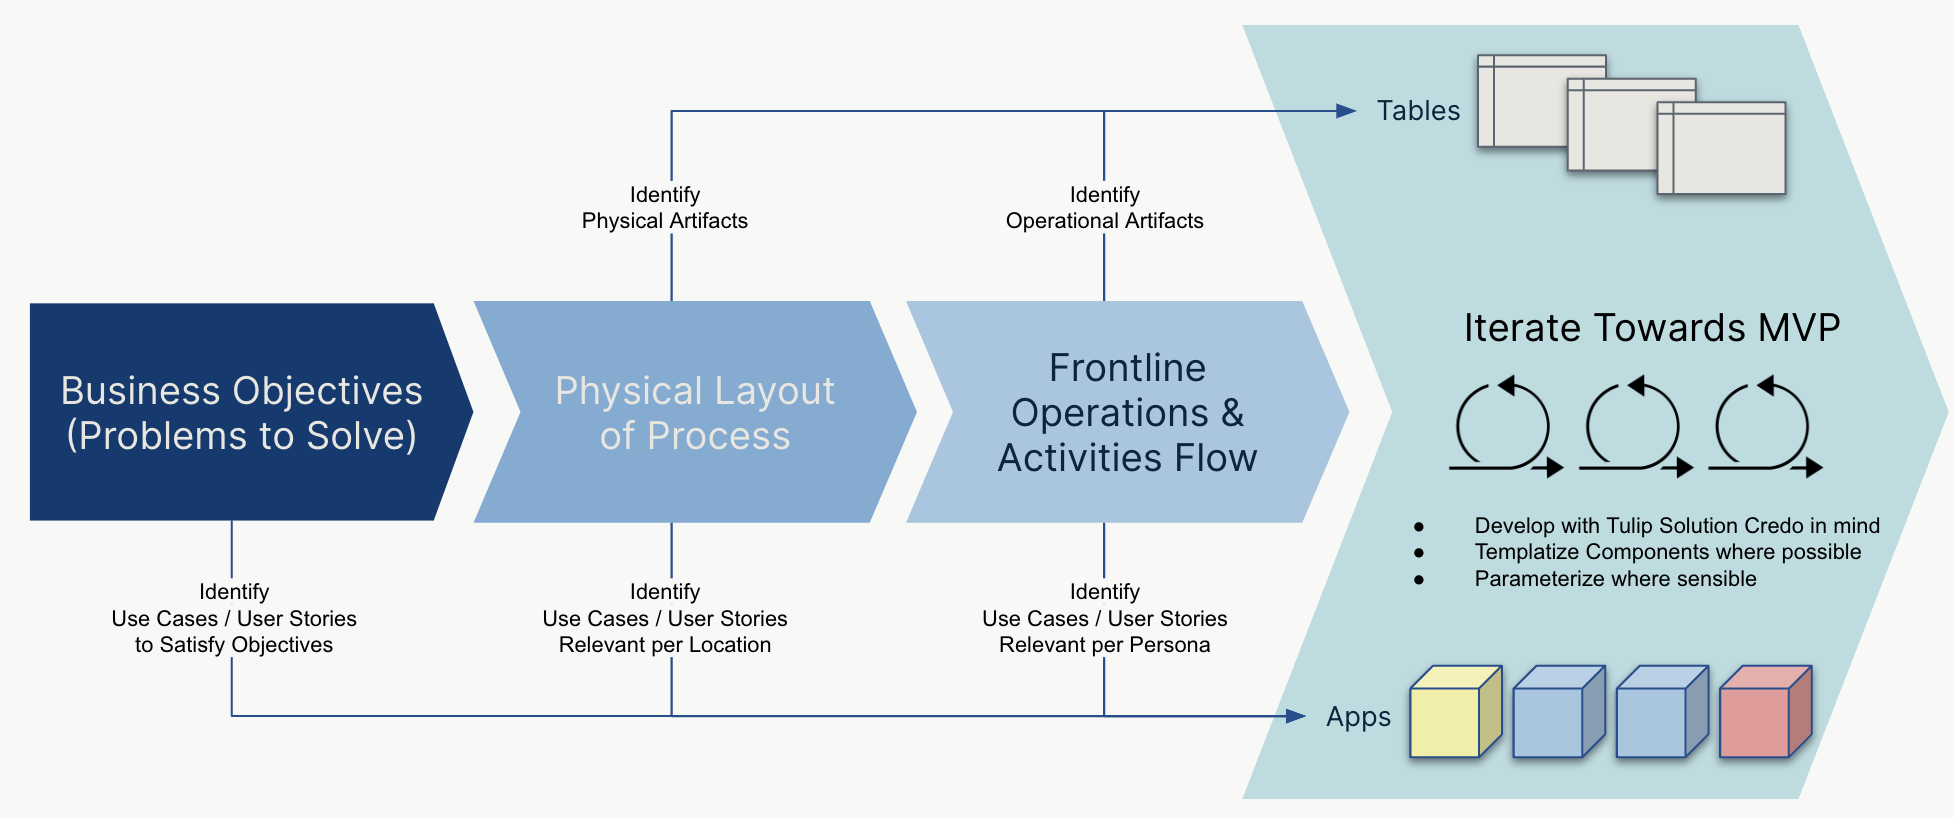
Например, таблицы в примере общей модели данных Tulip разделены на две категории:
| Категория | Описание | Примеры |
|---|---|---|
| Физический объект | Это что-то осязаемое, к чему можно физически прикоснуться на производственном участке | Товары, оборудование и активы |
| Операционные артефакты | Это уникально идентифицируемый нематериальный элемент, который часто встречается в связи с производственными операциями. Часто они представлены в виде распечатанных накладных или билетов. | Карта канбан, производственное задание |
It’s important to remember that tables should avoid duplicating external data.
Структура и настройка таблиц
Таблицы и поля должны быть простыми и иметь четкое назначение в отношении хранящейся в них информации. Используя ранее рассмотренные типы таблиц (физические артефакты и операционные артефакты), вы можете точно определить назначение каждой таблицы.
Поля для каждой таблицы зависят от информации, относящейся к артефактам. Хорошим практическим правилом является то, что большинство таблиц должно содержать поле «статус» (или аналогичное). Другие распространенные поля, которые можно добавить, включают:
- Материал
- Местоположение/ячейка
- Идентификаторы (заказ на работу, материал, заказчик и т. д.)
- Измерения
- Даты начала, запроса или завершения
- Комментарии
- Фото
Для любых данных, которые вы хотите использовать в расчетах, создайте запрос или агрегацию. Расчеты, лежащие в основе целей и ключевых показателей эффективности (KPI), позволят вам получить обзор текущих операций.
Правила именования
Учтите, что имена таблиц и столбцов, которые вы используете, могут быть видны другим «гражданским разработчикам» и операторам в Tulip Analytics, поэтому обязательно используйте интуитивно понятные, ориентированные на человека имена для таблиц и столбцов, а не правила именования, обычно применяемые программистами. Например, назовите таблицу «Оборудование и инструменты» вместо «eqps_tools», а столбцы — «Тип оборудования» вместо «eqpType».
Узнайте больше о рекомендациях по присвоению имен элементам в Tulip.
Оптимизация таблиц для масштабируемости и производительности
В статье, ссылка на которую приведена выше, обсуждаются основы реализации и обслуживания модели « Tulip table », которая должна быть: производительной, надёжной, компонованной и масштабируемой.
Когда использовать записи завершения
Запись завершения создается либо при завершении работы с приложением с помощью перехода, такого как «Приложение» / «Завершить работу с приложением», либо при срабатывании триггера «Сохранить все данные приложения». Исторические данные традиционно отслеживаются с помощью завершения работы с приложением и хранятся в записях завершения, которые являются локальными для каждого приложения.
Если вам нужно хранить данные исключительно для ведения истории процессов и/или проведения анализа этих данных с помощью Analytics, то записи завершения, скорее всего, будут достаточными и станут самым простым способом сохранения этих данных.
Узнайте больше о записях о завершении.
Рассмотрите возможность использования общей модели данных
Общая модель данных обеспечивает компоновку — ключевой фактор успеха в работе с Tulip. При создании набора приложений важно также иметь модель данных в качестве основы для «соединения» приложений с помощью повторно используемых данных.
Узнайте больше об использовании общей модели данных.
Вы также можете начать с общей модели данных Tulip, которую затем можно адаптировать под свои нужды.