
Quem pode usar esse recurso
Usuários com planos Enterprise e superiores.
Diagrama de exportação e importação
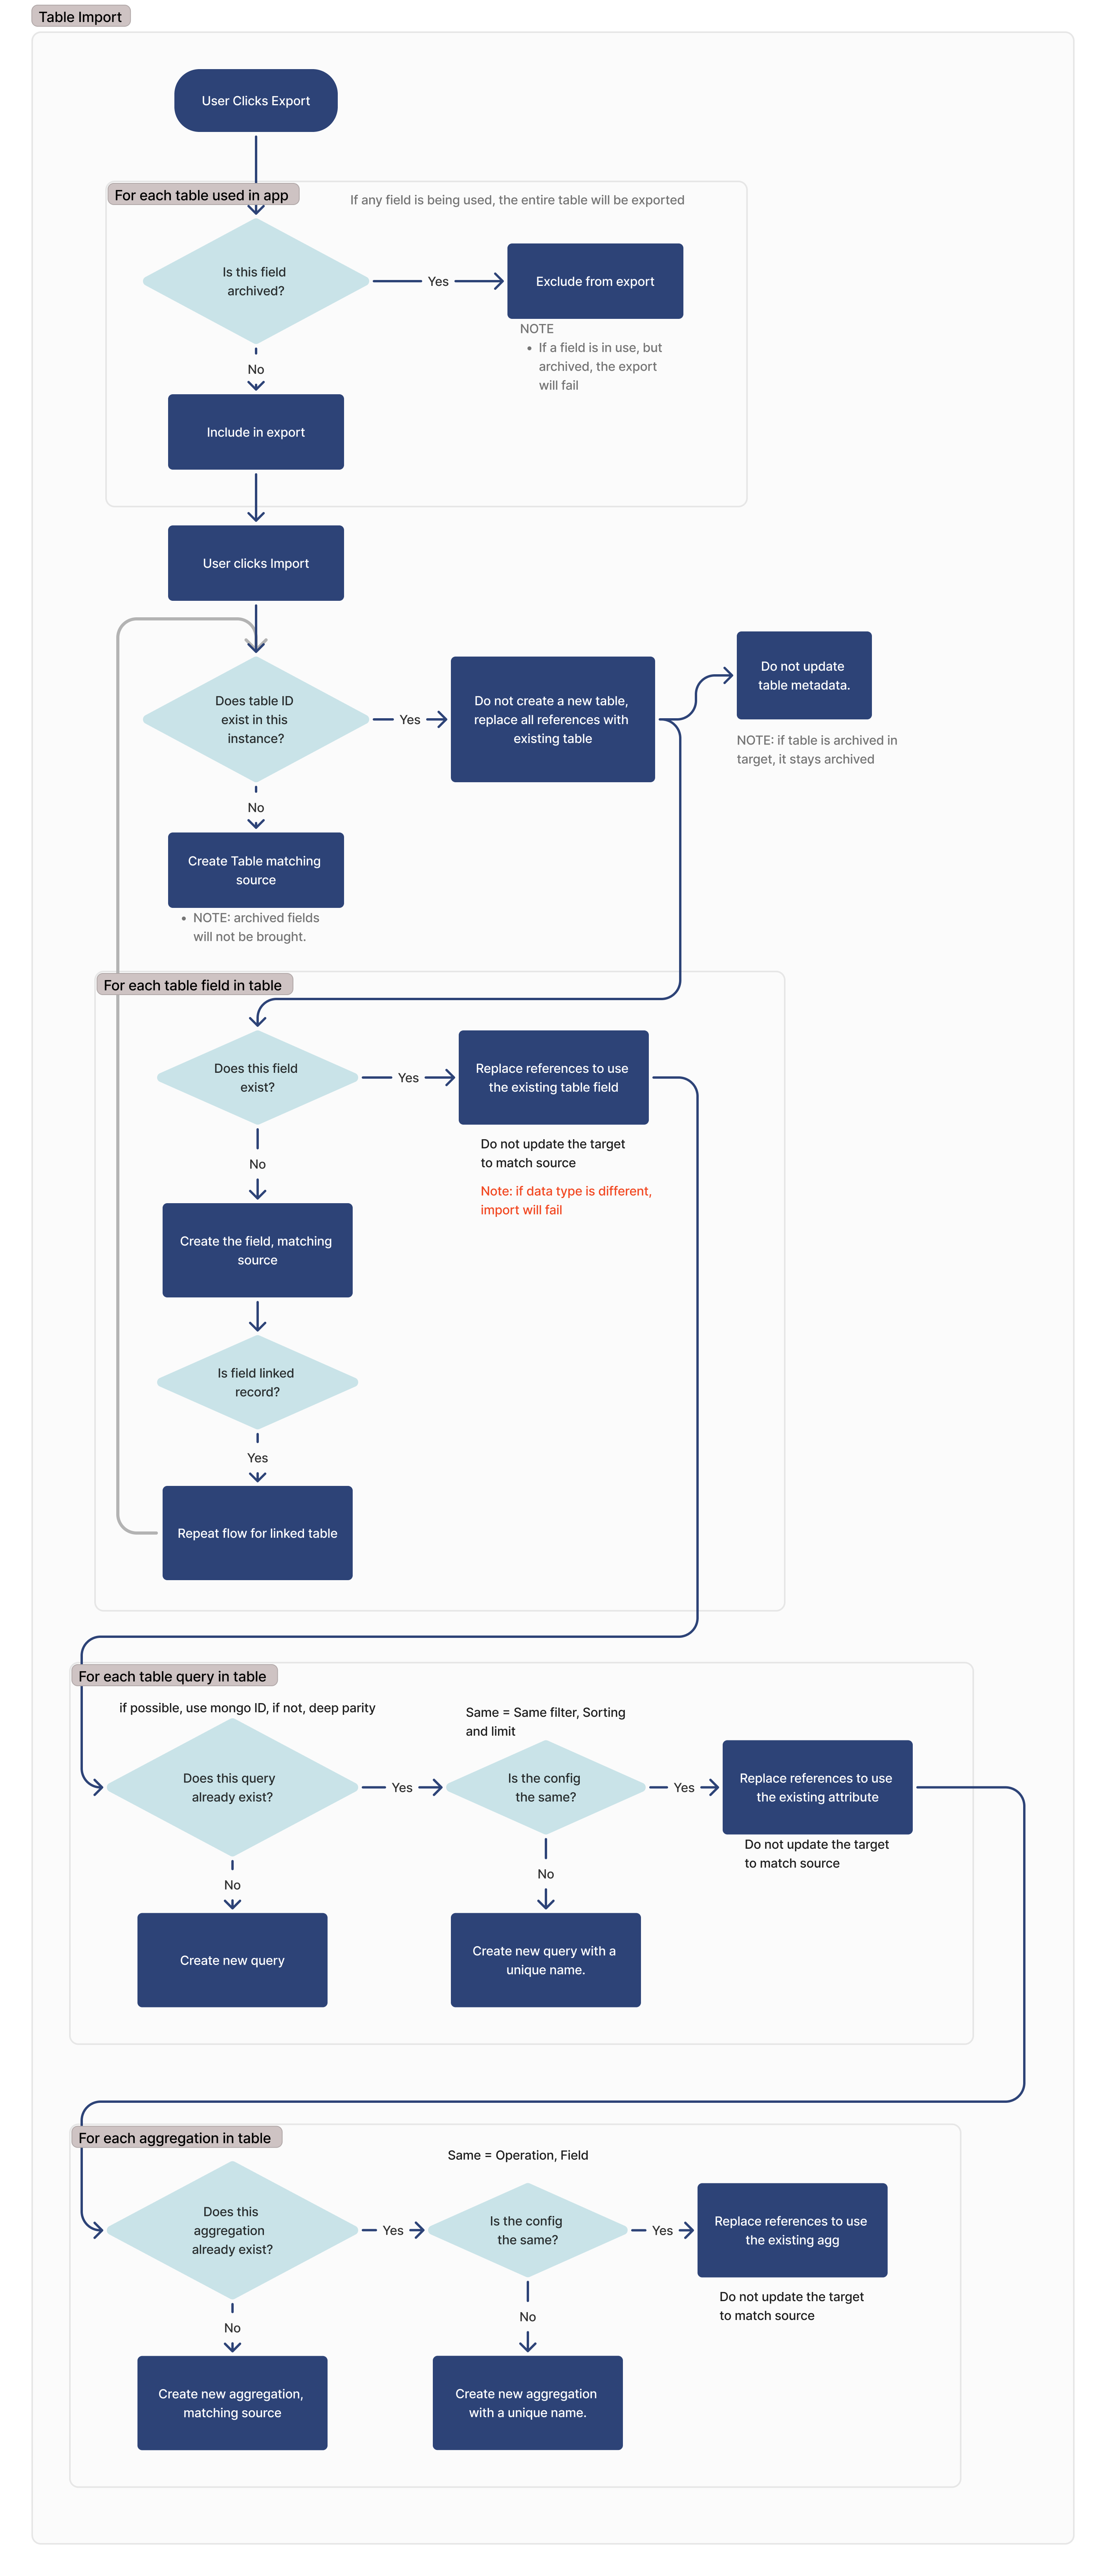
Abaixo está todo o fluxo de transferência para Tabelas, Consultas e Agregações do Tulip. Este documento fornecerá uma explicação detalhada desse fluxo.
Campos personalizados do usuário e tabelas de atividade da máquina
O fluxo descrito abaixo também se aplica à forma como as tabelas de campos personalizados do usuário e as tabelas de campos de atividade da máquina são exportadas e importadas.
Exportação
Durante o processo de exportação, o aplicativo ou automação exportado incluirá todas as tabelas em uso nesse aplicativo. Uma tabela é considerada em uso se qualquer uma das seguintes condições for atendida:
- Exibida em um widget “Registro da tabela”
- Usada em um widget de entrada
- Exibida em uma tabela interativa
- Usada em um gatilho
- Usada em uma ação de automação
- Usado em um bloco de evento de automação
- Usado em um filtro para uma consulta de tabela, tabela interativa ou widget de análise
- Usado como entrada ou saída para um widget personalizado
Se um campo estiver arquivado, ele não será exportado. Se um campo estiver arquivado, mas em uso, a exportação falhará.
Importação
Encontrar uma tabela idêntica
Para identificar tabelas correspondentes na importação, procuramos IDs correspondentes. Se for encontrada uma tabela com o mesmo ID, não criamos uma nova tabela e utilizamos a já existente.
Se uma tabela estiver arquivada na instância de origem e não existir na instância de destino, ela será criada na instância de destino e será arquivada.
Se a tabela na instância de origem estiver arquivada, ela permanecerá arquivada. Uma tabela arquivada permanece arquivada; uma tabela não arquivada permanece não arquivada.
Para cada campo da tabela
Para cada campo da tabela, procuramos um campo correspondente com base no ID da coluna desse respectivo campo.
Se o tipo de dados do campo correspondente for diferente, a importação falhará.
Se o campo for um campo de registro vinculado, a tabela vinculada será adicionada à lista de dependências para a importação, e esse fluxo será repetido para essa tabela.
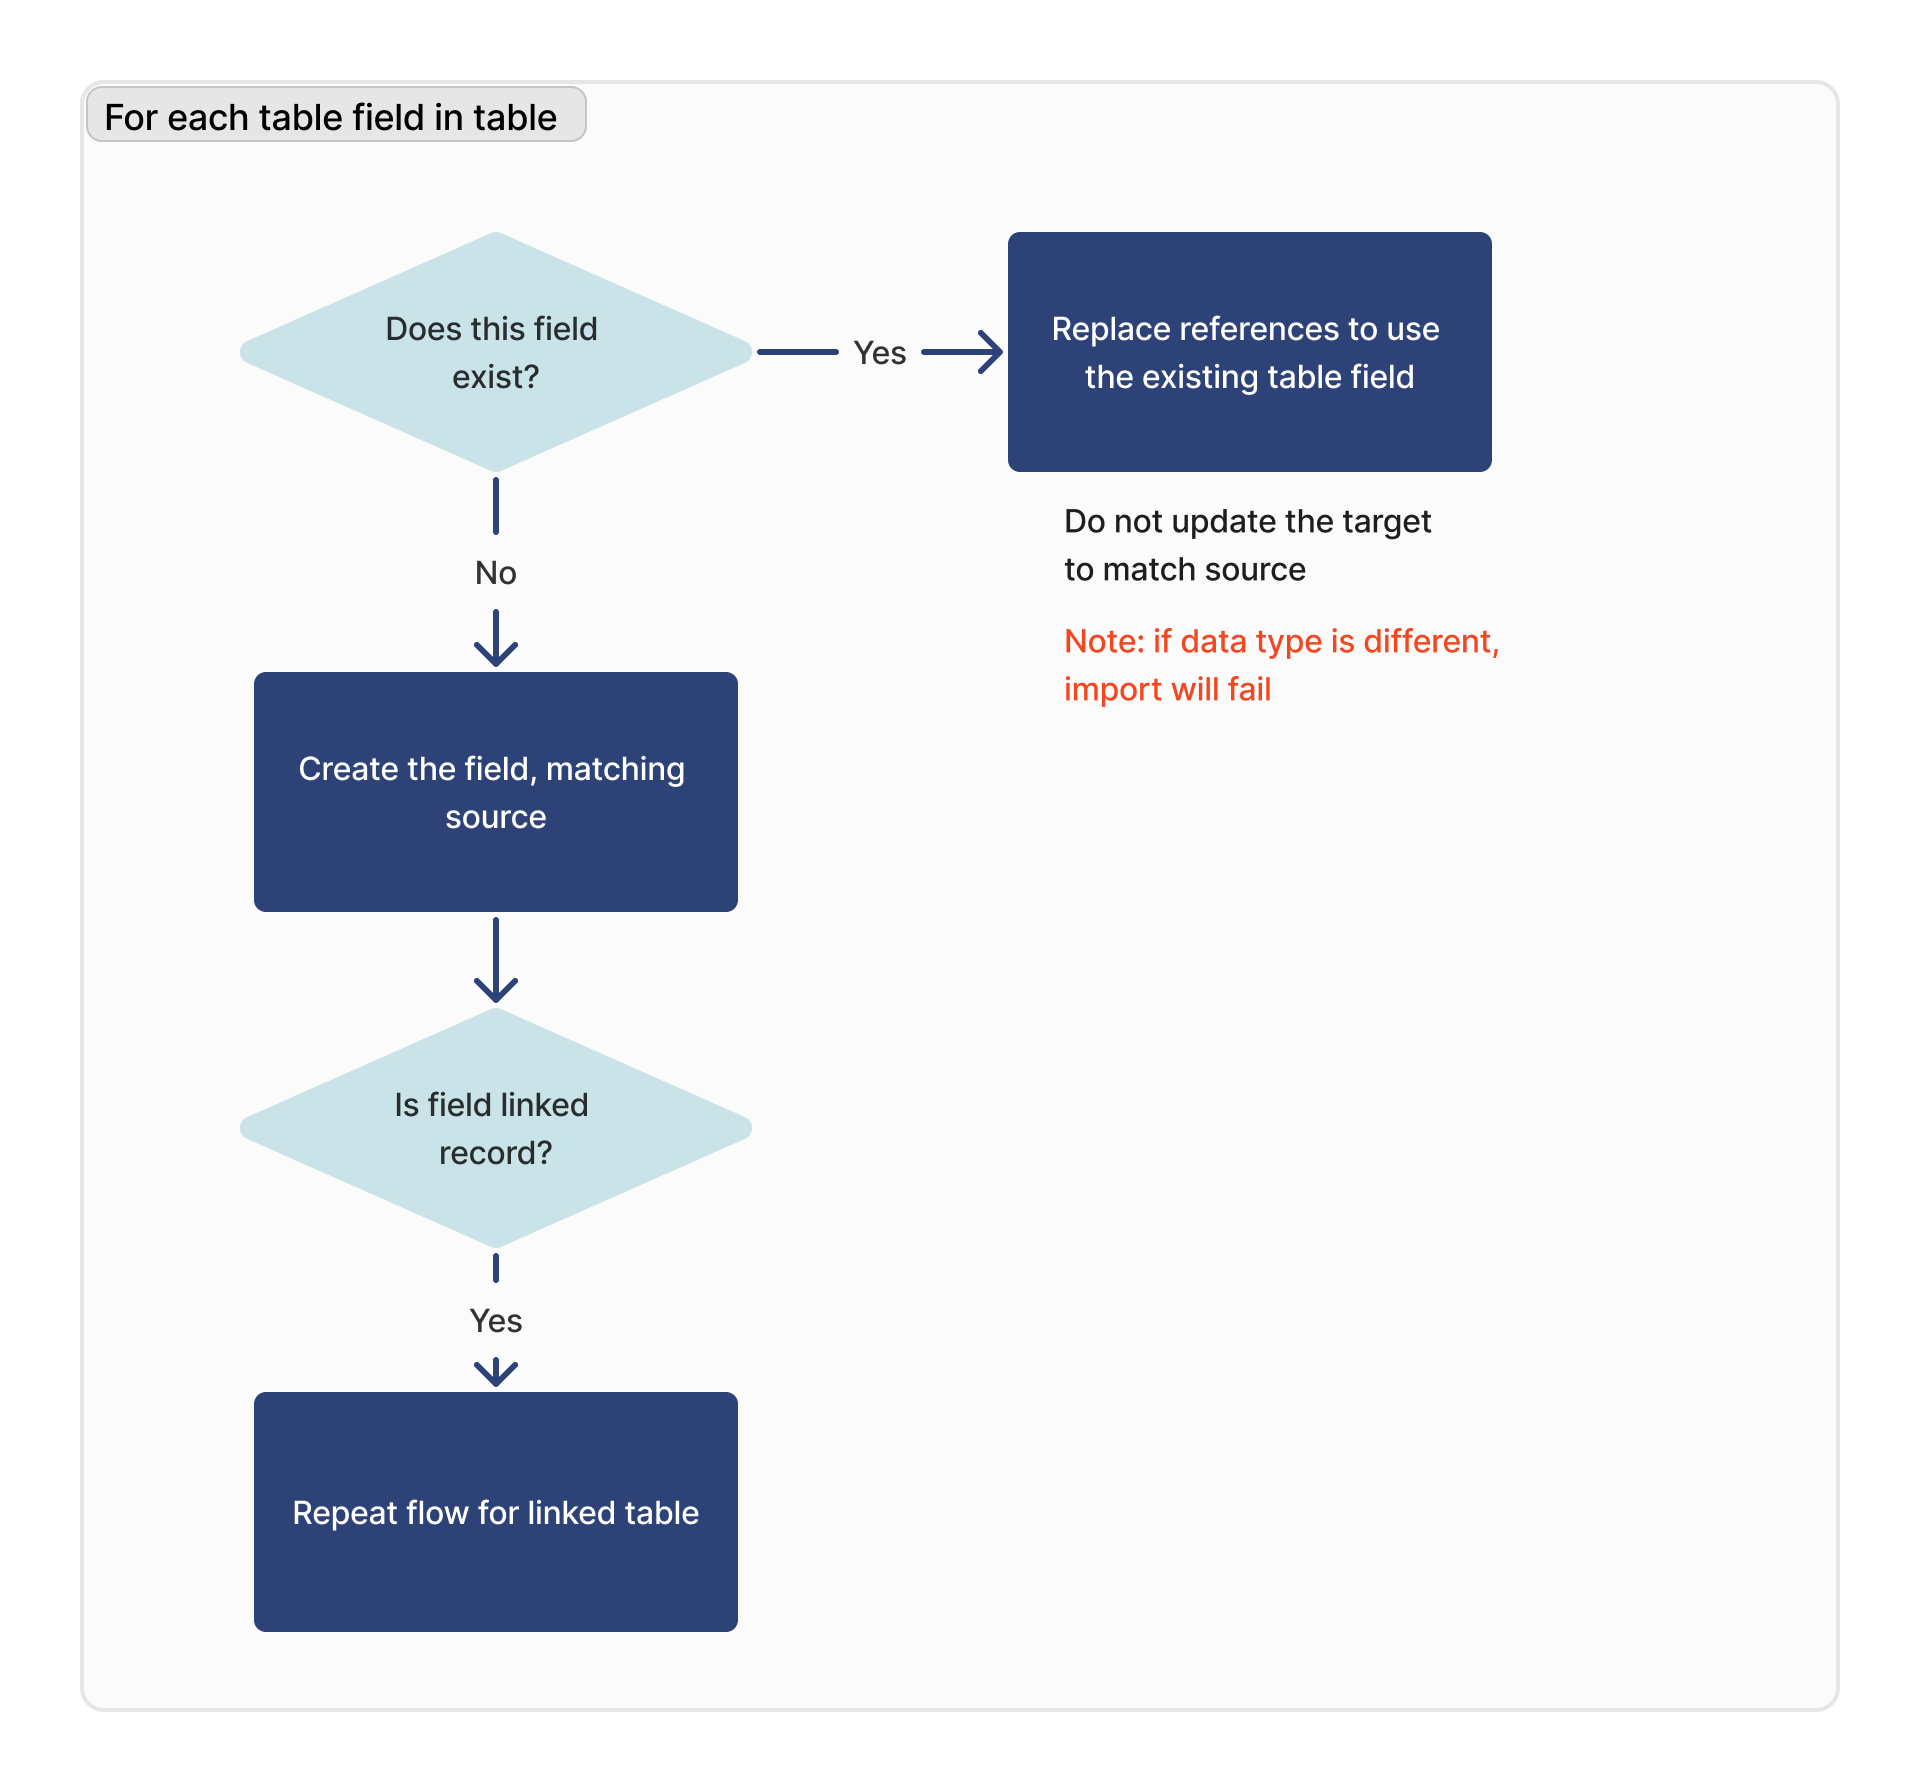
Se um campo estiver arquivado na origem e não existir no destino, ele será criado no destino como não arquivado (observação: isso difere do comportamento da tabela).
Se um campo já existir no destino, seu status de arquivamento nunca será atualizado pela importação. Um campo arquivado permanece arquivado; um campo não arquivado permanece não arquivado.
When exporting a table directly, archived fields are not included. However, if an archived field is referenced by an app, it will be included in the export (with the above import rules applying).
Para cada consulta
Para cada consulta na tabela importada, verificamos se essa consulta existe. Se um ID correspondente for encontrado, verificamos se a configuração é idêntica (limite, ordenação e filtragem) entre o destino e a origem.
Se uma consulta correspondente não puder ser encontrada, uma nova consulta será criada. Se uma consulta correspondente for encontrada, mas não for idêntica à instância de destino, uma nova consulta será criada com um novo nome.
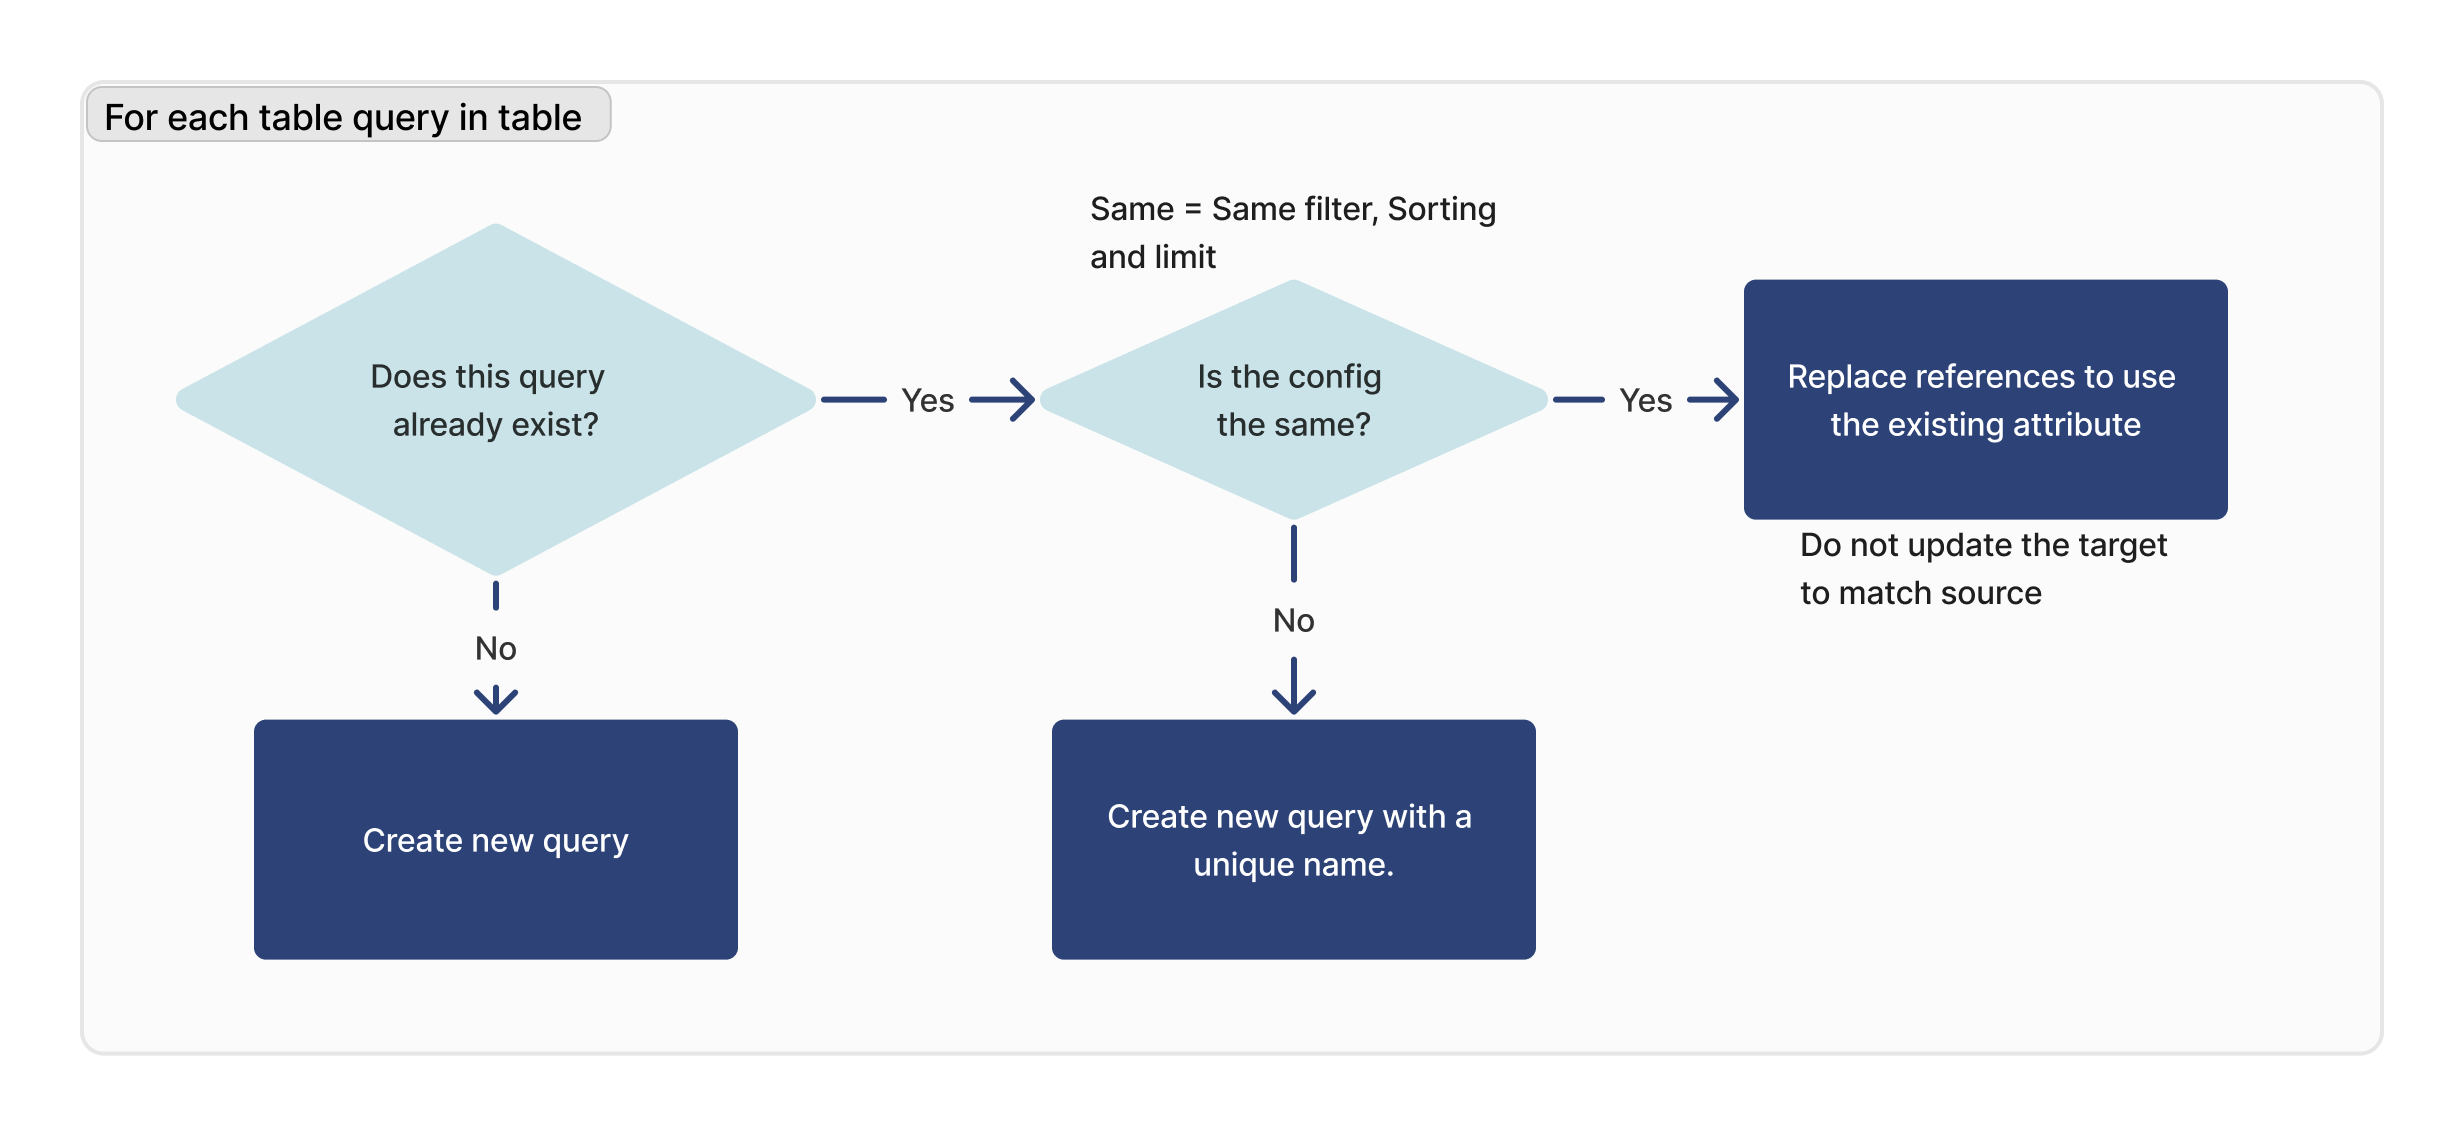
Observação: Isso não se aplica a campos personalizados do usuário ou tabelas de atividade da máquina.
:::(Informação) (Comportamento de importação/exportação atualizado a partir da versão r347/LTS15)
As atualizações no comportamento de importação/exportação reduzem as duplicatas. As consultas de tabela agora são importadas como um “ development version ”. A consulta de tabela só será importada como um snapshot se a mesma consulta já existir e tiver uma configuração diferente.
O comportamento anterior (que ainda existe nas instâncias r329/LTS14 e anteriores) importava instantâneos como “snapshots” e “ development versions ” como “ development versions ”.
:::
Para cada agregação
Para cada agregação na tabela importada, verificamos se essa consulta existe. Se um ID correspondente for encontrado, verificamos se a configuração é idêntica (operação, campo) entre o destino e a origem.
Se não for encontrada uma agregação correspondente, uma nova agregação será criada. Se for encontrada uma agregação correspondente, mas ela não for idêntica à instância de destino, uma nova agregação será criada com um novo nome.
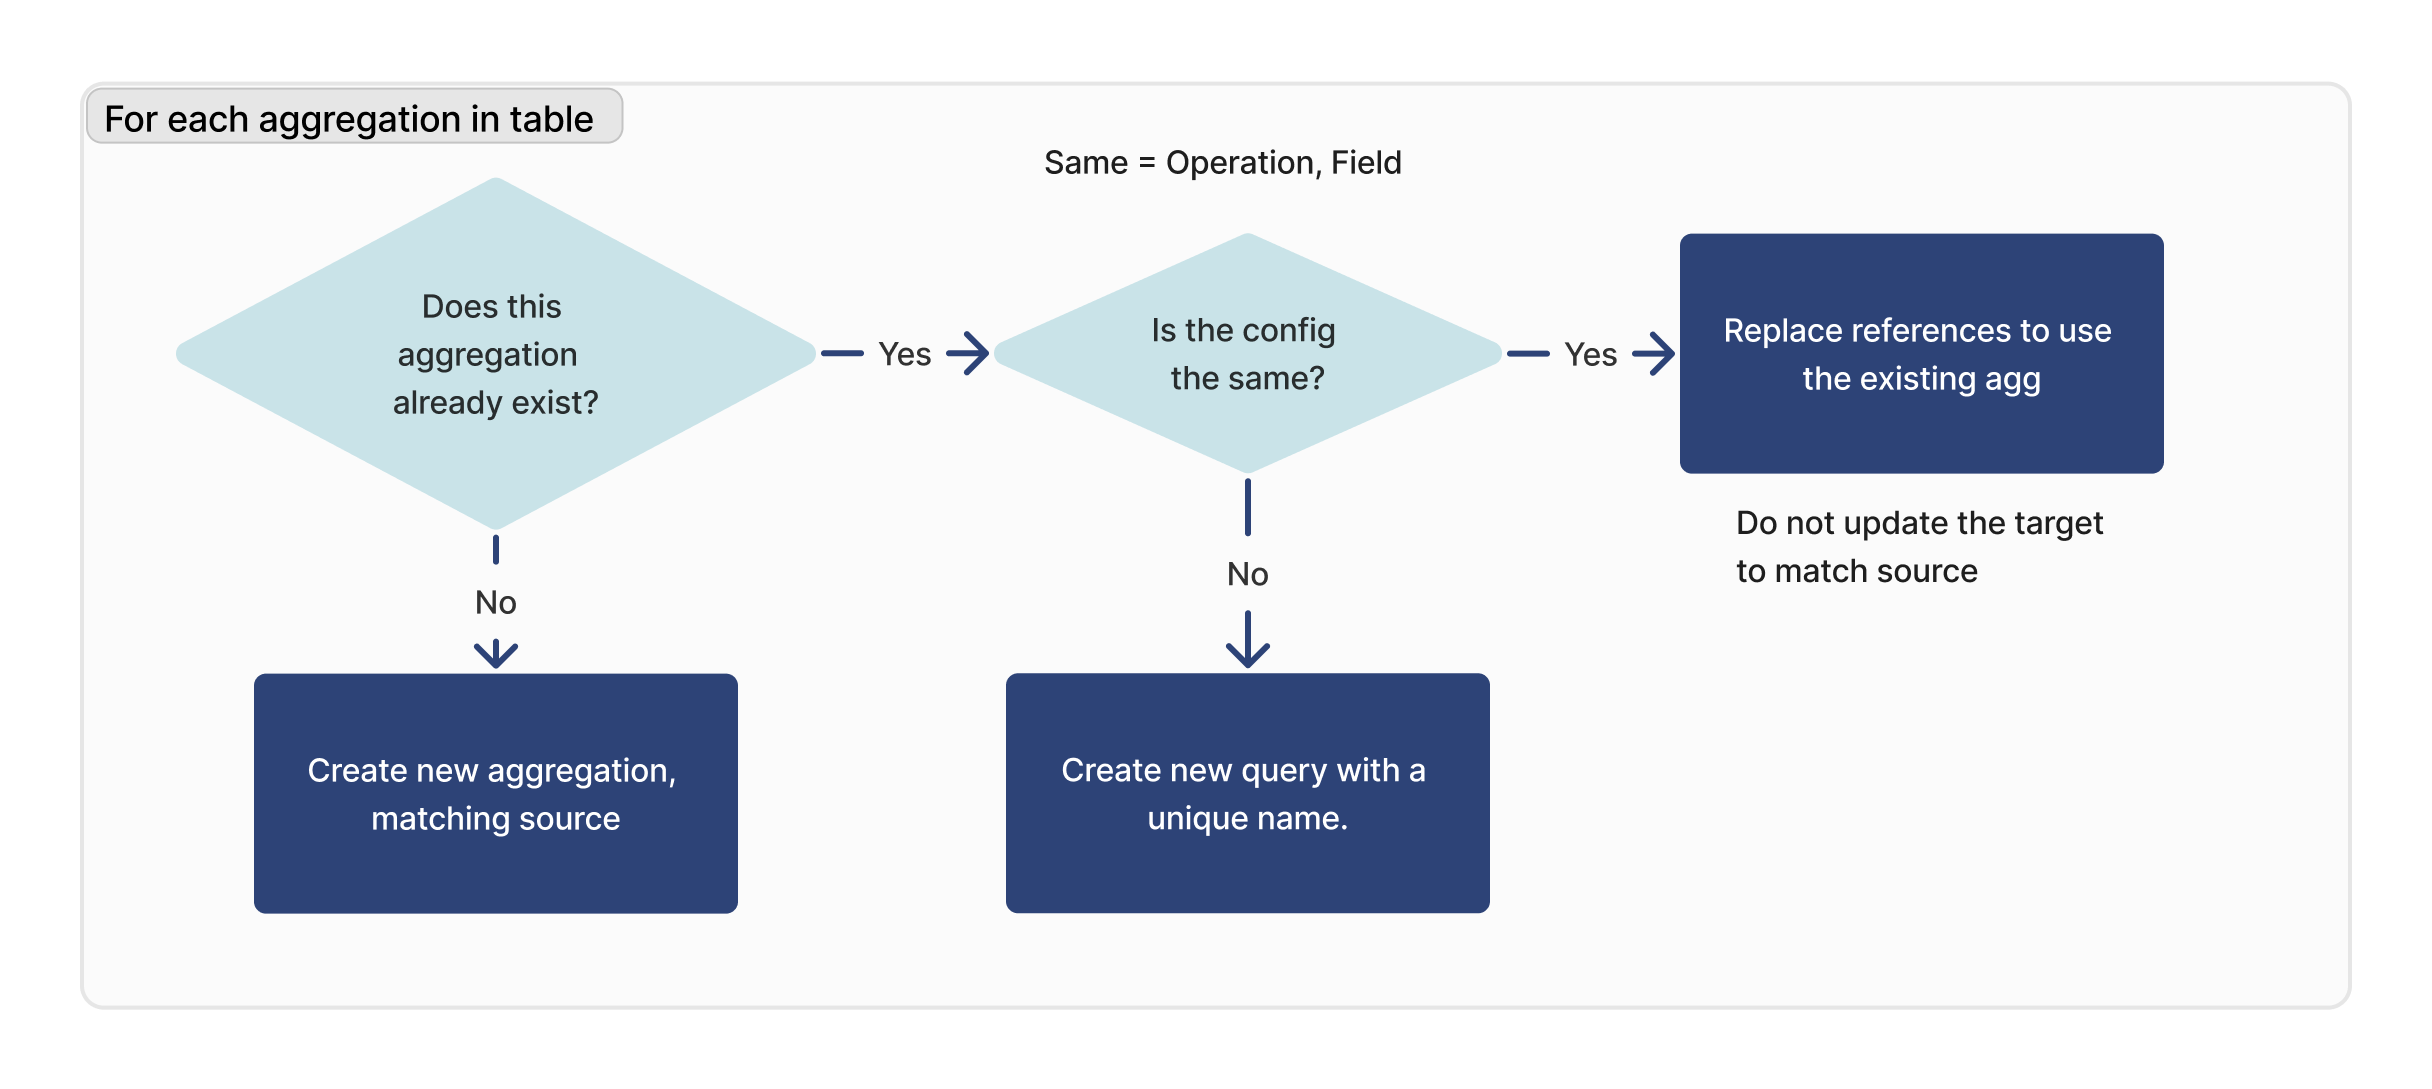
Observação: Isso não se aplica a campos personalizados do usuário ou tabelas de atividade da máquina.
:::(Informação) (Comportamento de importação/exportação atualizado a partir da versão r347/LTS15)
As atualizações no comportamento de importação/exportação reduzem as duplicatas. As agregações de tabela agora são importadas como um development version. A agregação de tabela só será importada como um snapshot se a mesma agregação já existir e tiver uma configuração diferente.
O comportamento anterior (que ainda existe nas instâncias r329/LTS14 e anteriores) importava instantâneos como “snapshots” e “ development versions ” como “ development versions ”.
:::
{{snippet.Você encontrou o que estava procurando?}}