
Tulip에서 AWS S3로 데이터를 효율적으로 전송하여 더 광범위한 분석 및 통합 기회를 확보하세요
목적
이 가이드에서는 Lambda 함수를 통해 모든 Tulip 테이블 데이터를 가져와 S3 버킷에 기록하는 방법을 단계별로 설명합니다.
이는 기본적인 가져오기 쿼리를 넘어 주어진 인스턴스의 모든 테이블을 순차적으로 처리하며, 주간 ETL(추출, 변환, 로드) 작업에 매우 유용합니다.
이 람다 함수는 Event Bridge 타이머나 API Gateway와 같은 다양한 리소스를 통해 트리거될 수 있습니다.
다음은 아키텍처의 예시입니다: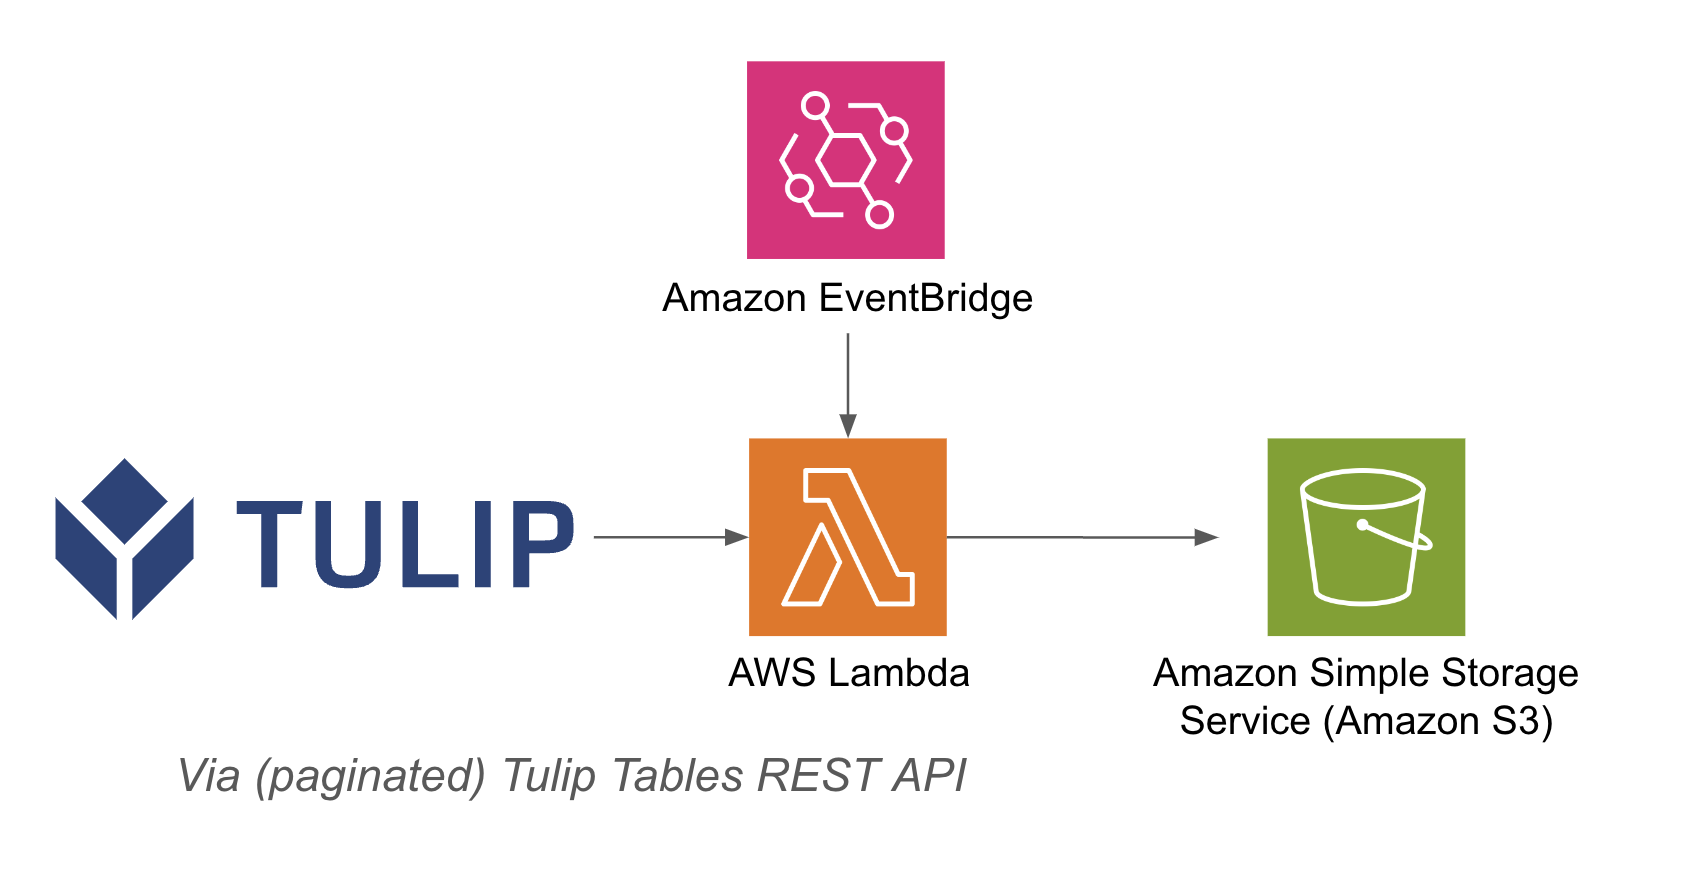
설정
이 통합 예제를 사용하려면 다음이 필요합니다:
- Tulip Tables API 사용 (계정 설정에서 API 키 및 시크릿 확인)
- Tulip 테이블 (테이블 고유 ID 확인)
전체적인 단계: 1. 관련 트리거(API Gateway, Event Bridge Timer 등)를 사용하여 AWS Lambda 함수를 생성합니다. 2. 적절한 Lambda 레이어(예: pandas 및 awswrangler 등)가 사용되고 있는지, 그리고 Tulip Tables API 키에 충분한 권한이 포함되어 있는지 확인합니다. 3. 아래 예제를 사용하여 Tulip 테이블 데이터를 가져옵니다(S3, Glue, Redshift 등 모든 컨텍스트에서 사용 가능).```pythonimport jsonimport awswrangler as wrimport boto3from datetime import datetimeimport pandas as pdimport requestsimport os
# 고유한 파일 이름을 위한 현재 타임스탬프 가져오기
timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")
bucket = os.getenv('bucket_name')
# 사전을 문자열로 변환하는 함수
def dict_to_str(cell): if isinstance(cell, dict): return str(cell) return cell
def query_table(table_id, base_url, api_header): offset = 0 function = f'/tables/{table_id}/records?limit=100&offset={offset}&includeTotalCount=false&filterAggregator=all' r = requests.get(base_url+function, headers=api_header) df = pd.DataFrame(r.json()) length = len(r.json()) while length > 0: offset += 100 function = f'/tables/{table_id}/records?limit=100&offset={offset}&includeTotalCount=false&filterAggregator=all' r = requests.get(base_url+function, headers=api_header) length = len(r.json()) df_append = pd.DataFrame(r.json()) df = pd.concat([df, df_append], axis=0) df = df.apply(lambda row: row.apply(dict_to_str), axis=1) return df
# 함수 생성
def write_to_s3(row, base_url, api_header, bucket): table = row['label'] id = row['id'] df = query_table(id, base_url, api_header)
path = f's3://{bucket}/{timestamp}/{table}.csv'# DataFrame을 CSV 형식으로 S3에 쓰기 wr.s3.to_csv( df=df, path=path, index=False) print(f"{table}을 {path}에 썼습니다") return f"{table}을 {path}에 썼습니다"
def lambda_handler(event, context): api_header = {'Authorization' : os.getenv('tulip_api_basic_auth')} instance = os.getenv('tulip_instance') base_url = f'https://{instance}.tulip.co/api/v3' get_tables_function = '/tables' r = requests.get(base_url+get_tables_function, headers=api_header) table_names = pd.DataFrame(r.json())
# 테이블 쿼리 함수table_names.apply(lambda row: write_to_s3(row, base_url, api_header, bucket), axis=1)return { 'statusCode': 200, 'body': json.dumps('wrote to s3!')}
## 사용 사례 및 다음 단계

Lambda와의 통합을 완료하면 Sagemaker 노트북, QuickSight 또는 다양한 다른 도구를 사용하여 데이터를 쉽게 분석할 수 있습니다.

**1. 결함 예측**- 생산 결함이 발생하기 전에 이를 파악하고 ‘첫 번째 시도에서 바로 올바르게(Right First Time)’를 실현합니다. - 품질 향상을 위해 생산의 핵심 품질 동인을 파악합니다.

**2. 품질 비용 최적화 -** 고객 만족도에 영향을 주지 않으면서 제품 설계를 최적화할 수 있는 기회를 파악합니다.

**3. 생산 에너지 최적화 -** 에너지 소비를 최적화할 수 있는 생산 요인을 파악합니다.

**4. 납기 및 계획 예측 및 최적화**- 고객 수요와 실시간 주문 일정을 기반으로 생산 일정을 최적화합니다.

**5. 글로벌 기계/라인 벤치마킹**- 정규화를 통해 유사한 기계 또는 설비를 벤치마킹합니다.

**6. 글로벌/지역별 디지털 성과 관리 -** 통합된 데이터를 바탕으로 실시간 대시보드를 생성합니다.