

Tulip内でのデータの最適な保存および管理方法について学びましょう。
アプリと同様に、Tulip内のデータもシステムとして連携して機能する必要があります。人や他のシステムに情報を提供するためにデータへのアクセスを容易に保つことで、可視性が向上し、複数の場所でのデータの重複を回避できます。
ベストプラクティス
アプリケーションのデータ構造を計画する際に従うべき原則をいくつか紹介します:
テーブルにはデジタルツイン構造を採用する
デジタルツインとは、部品、オブジェクト、機械、さらには生産プロセス全体を動的に仮想的に表現したモデルです。これは、物理的な対象物自体、その仮想的な表現、そして物理的対象と仮想的対象の間でデータをやり取りするための接続機能で構成されています。
Tulipのテーブルは、現場の状況を可能な限り1:1で反映させる必要があります。
情報に基づいてテーブルを整理する
テーブルの種類を特定し、定義しておくことが最善です。どのテーブルにどのような情報が入るかを理解することは、ソリューションを設計する際に特に重要です。
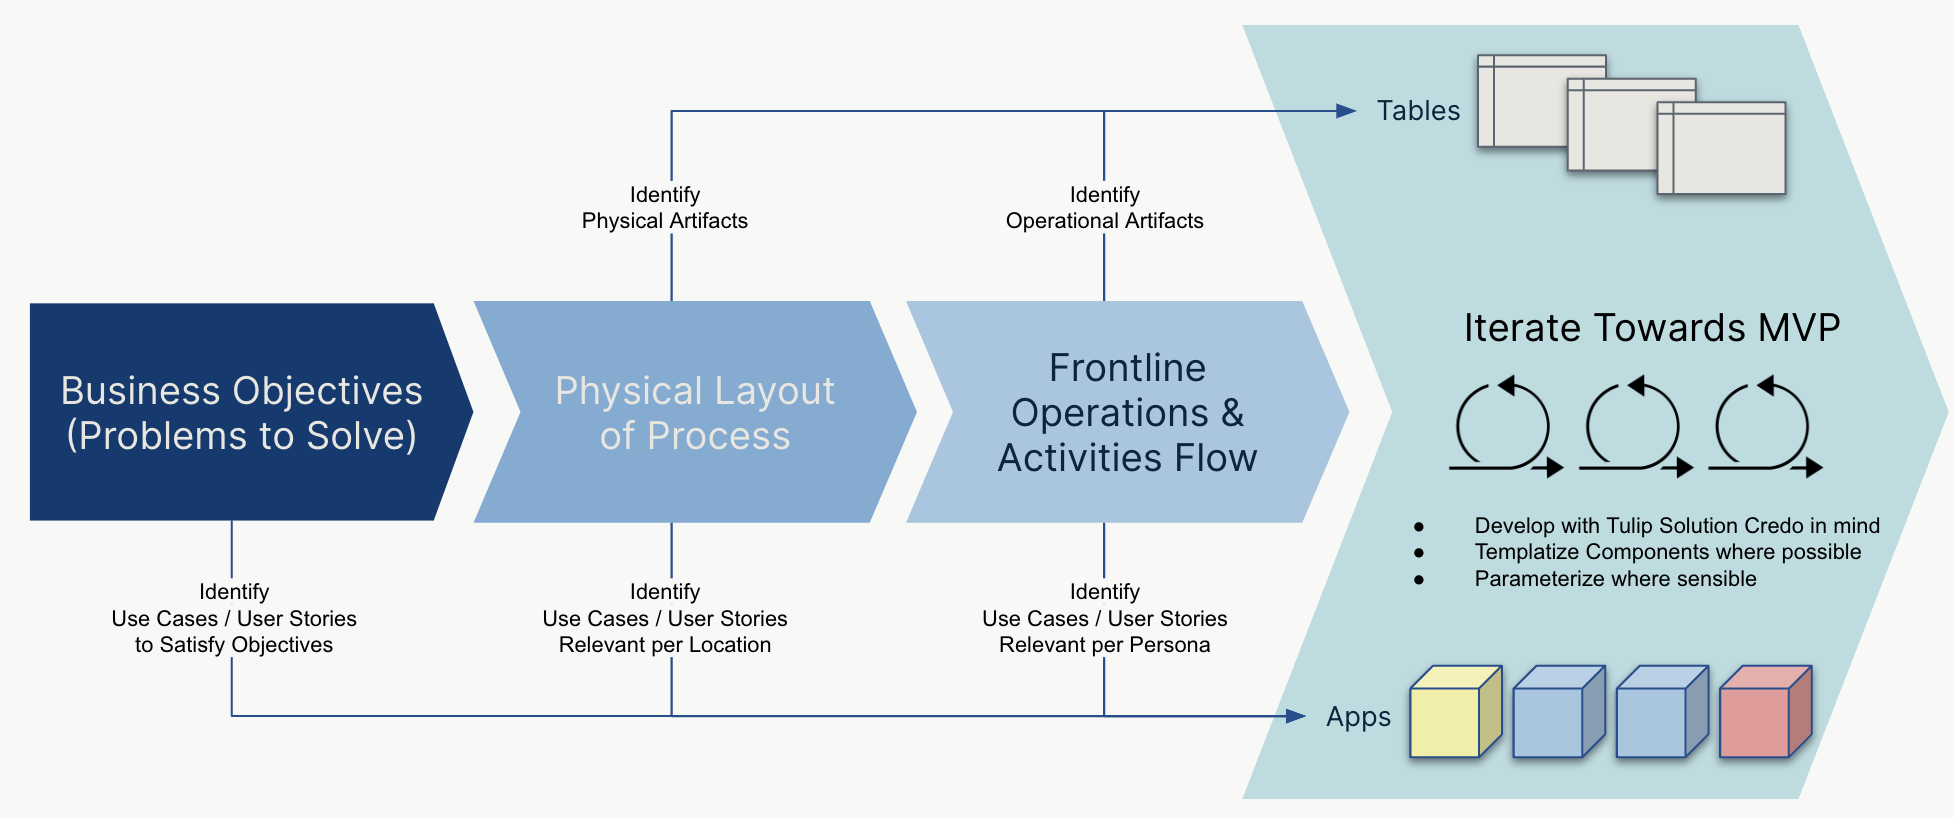
たとえば、Tulipの共通データモデルの例にあるテーブルは、次の2つのカテゴリに分類されています:
| カテゴリ | 説明 | 例 |
|---|---|---|
| 物理的な実体 | これは、製造現場で実際に手に取ることができる有形のものです | 在庫品、設備、資産 |
| 業務上の記録 | これらは、一意に識別される無形の要素であり、業務に関連して一般的に見られるものです。これらは、多くの場合、印刷された伝票やチケットとして見られます。 | かんばんカード、作業指示書 |
It’s important to remember that tables should avoid duplicating external data.
テーブルの構造と設定
テーブルとフィールドはシンプルであり、どのような情報を格納するかの目的が明確であるべきです。前述のテーブルの種類(物理的アーティファクトおよび運用上のアーティファクト)を活用することで、各テーブルの目的を明確に定義できます。
各テーブルのフィールドは、アーティファクトに関連する情報によって異なります。大まかな目安として、ほとんどのテーブルにはステータス(またはそれに類する)フィールドを含めるべきです。その他、追加できる一般的なフィールドには次のようなものがあります:
- 資材
- 保管場所/ビン
- ID(作業指示書、資材、顧客など)
- 測定値
- 開始日、依頼日、または完了日
- 備考
- 写真
計算に使用したいデータについては、クエリまたは集計を作成してください。目標や KPI の策定に役立つ計算を行うことで、現在の業務状況の概要を把握することができます。
命名規則
使用するテーブル名や列名は、他の市民開発者やTulip Analyticsのオペレーターにも表示される可能性があるため、ソフトウェアエンジニアが通常使用する命名規則ではなく、直感的で人間中心の名称をテーブルや列に付けるようにしてください。 つまり、テーブル名には「eqps_tools」ではなく「設備と工具」のような名前を付け、列名には「eqpType」ではなく「設備の種類」のような名前を使用してください。
Tulipにおける要素の命名に関するベストプラクティスの詳細については、こちらをご覧ください。
スケーラビリティとパフォーマンスのためのテーブルの最適化
上記の記事では、高性能、信頼性、構成可能性、スケーラビリティを兼ね備えたTulip table モデルの実装と保守に関する基本事項について解説しています。
完了レコードの使用タイミング
完了レコードは、「App / Complete App」のような遷移を介してアプリを完了させるか、トリガーアクション「Save All App Data」によって作成されます。履歴データは従来、アプリの完了を通じて追跡され、各アプリにローカルに存在する完了レコードに保存されます。
プロセスの履歴を記録したり、Analytics を通じてそのデータを分析したりする目的だけでデータを保存する必要がある場合は、Completion Records で十分であり、このデータを保存する最も簡単な方法となります。
共通データモデルの検討
共通データモデルは、Tulipを成功させるための重要な要素である「構成可能性(composability)」を実現します。アプリスイートを構築する際には、再利用可能なデータを用いてアプリを「連携」させるための基盤として、データモデルを用意することも重要です。
また、Tulip共通データモデルから始めて、必要に応じて調整することも可能です。