

Dans ce guide, vous apprendrez : - Quand stocker les données dans Tulip plutôt que dans un système externe - Comment extraire des données d’autres systèmes - Ce dont vous avez besoin pour intégrer un système à Tulip
Les équipes opérationnelles extraient souvent des données provenant de plusieurs sources, tant au sein de Tulip qu’à l’extérieur. Pour les sources de données externes, vous devrez vous connecter via Tulip.
Establishing secure data connections may require IT personnel.
Quand stocker les données dans Tulip ou dans un système externe
Dans Tulip, vous pouvez stocker les données à deux endroits :
- Tableaux
- Complétions
Les données Tulip (par exemple, les données de processus, les instructions de travail, les équipements) sont directement mises à jour à partir de vos opérations numériques.
Mais qu'en est-il des données auxquelles vous faites référence en production et qui sont stockées ailleurs ? Il peut s'agir notamment :
- Systèmes ERP/WMS
- MES hérités
- Bases de données
- PLM (par exemple pour les nomenclatures)
- Système de gestion de la qualité (SGQ)
Vous pouvez interagir avec des données externes de différentes manières, en fonction de l’usage que vous en faites (par exemple, lire et écrire des données dans une API ou une base de données SQL, ou consulter des données de gestion à des fins de référence pour la production).
Une source unique de vérité est un élément essentiel pour garantir l’exactitude des données en temps réel. Une source de vérité garantit que les données ne sont pas dupliquées ni représentées à plusieurs endroits.
Les données Tulip et les données externes constituent chacune une source de vérité, et aucune ne doit être remplacée ni dupliquée : - Un système externe fournit des exigences claires, des indicateurs métier ou des données clients pour le contexte du flux de travail numérique ; - Les données Tulip contiennent des données opérationnelles et de processus pour le reporting en temps réel
Ce diagramme illustre la séparation entre les données de Tulip et celles d’un ERP :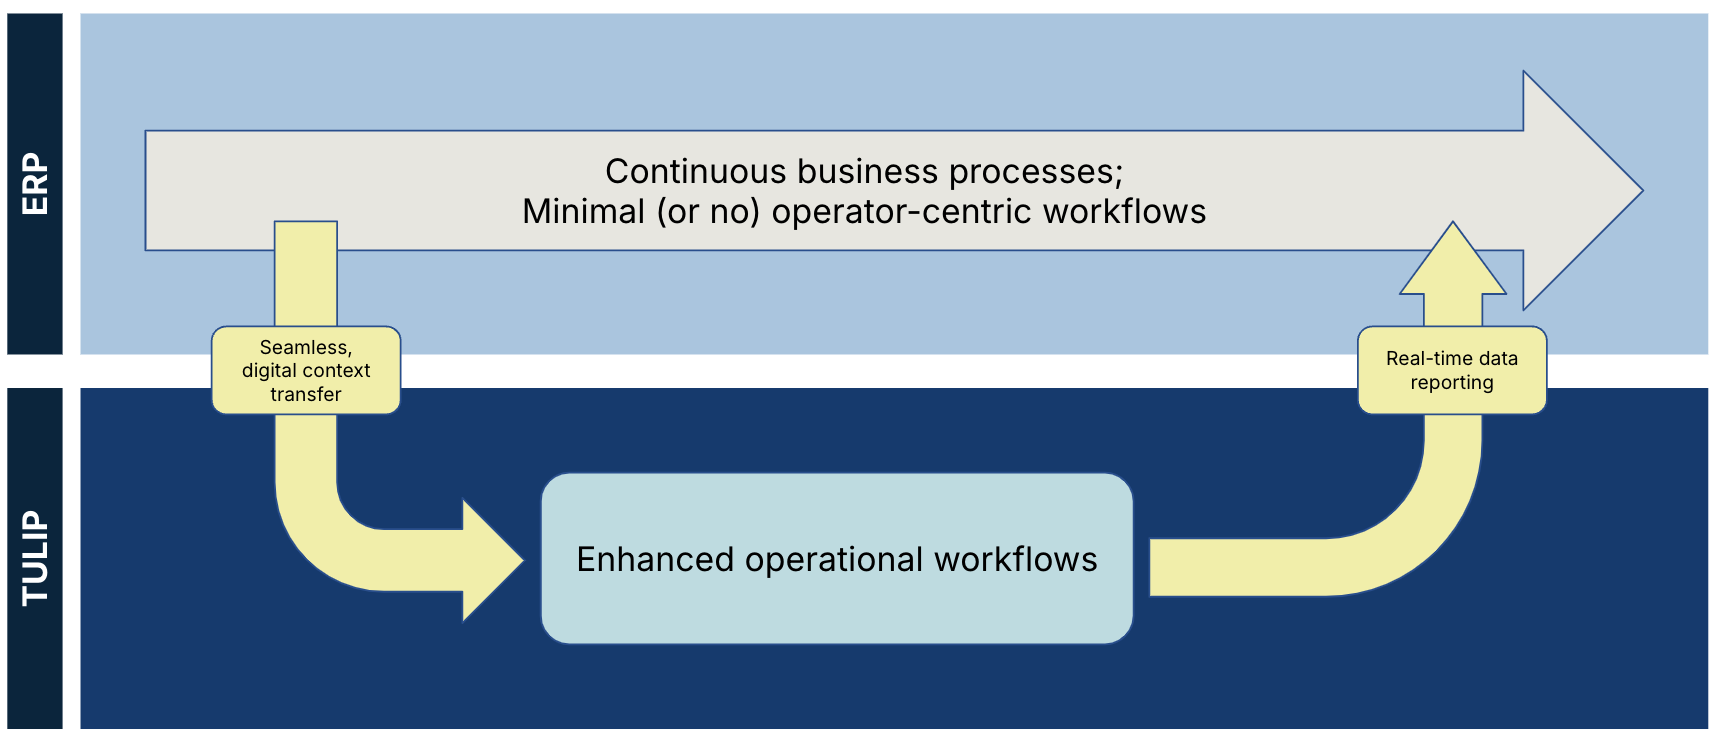
Vous ne devez utiliser les données provenant de sources externes qu’en fonction de vos besoins. Cette pratique signifie qu’un autre système peut fournir des informations contextuelles pour la production, tandis que les données Tulip enrichissent les informations provenant d’une source externe.
Comment savoir si vous devez utiliser des données externes ? – Tirez-vous le minimum de valeur de la solution sans intégration ? – Êtes-vous en mesure de réaliser l’intégration rapidement (en moins d’un mois) ?
Les intégrations doivent permettre de dégager une certaine valeur ajoutée, mais elles ne sont généralement pas indispensables pour exploiter le potentiel de la solution.
Exemple : ordres de travail provenant d’un ERP
- Les ordres de travail sont stockés dans un ERP
- Une application de gestion Tulip récupère les ordres de travail depuis l’ERP
- L’application de gestion crée un enregistrement de l’ordre de travail dans une table Tulip afin de stocker les données de production
- Les applications d’instructions de travail et d’assemblage enregistrent les données de production dans la table des ordres de travail ainsi que les données de processus conformes dans les enregistrements de fin de tâche
Écosystème ouvert
Un écosystème ouvert s'appuie sur plusieurs solutions connectées pour répondre aux besoins spécifiques d'une organisation. Plutôt que d'utiliser un seul système pour tout, l'approche d'écosystème ouvert de Tulip privilégie la au contrôle descendant.
Le schéma ci-dessous montre comment les capacités numériques de Tulip s’intègrent à d’autres systèmes.
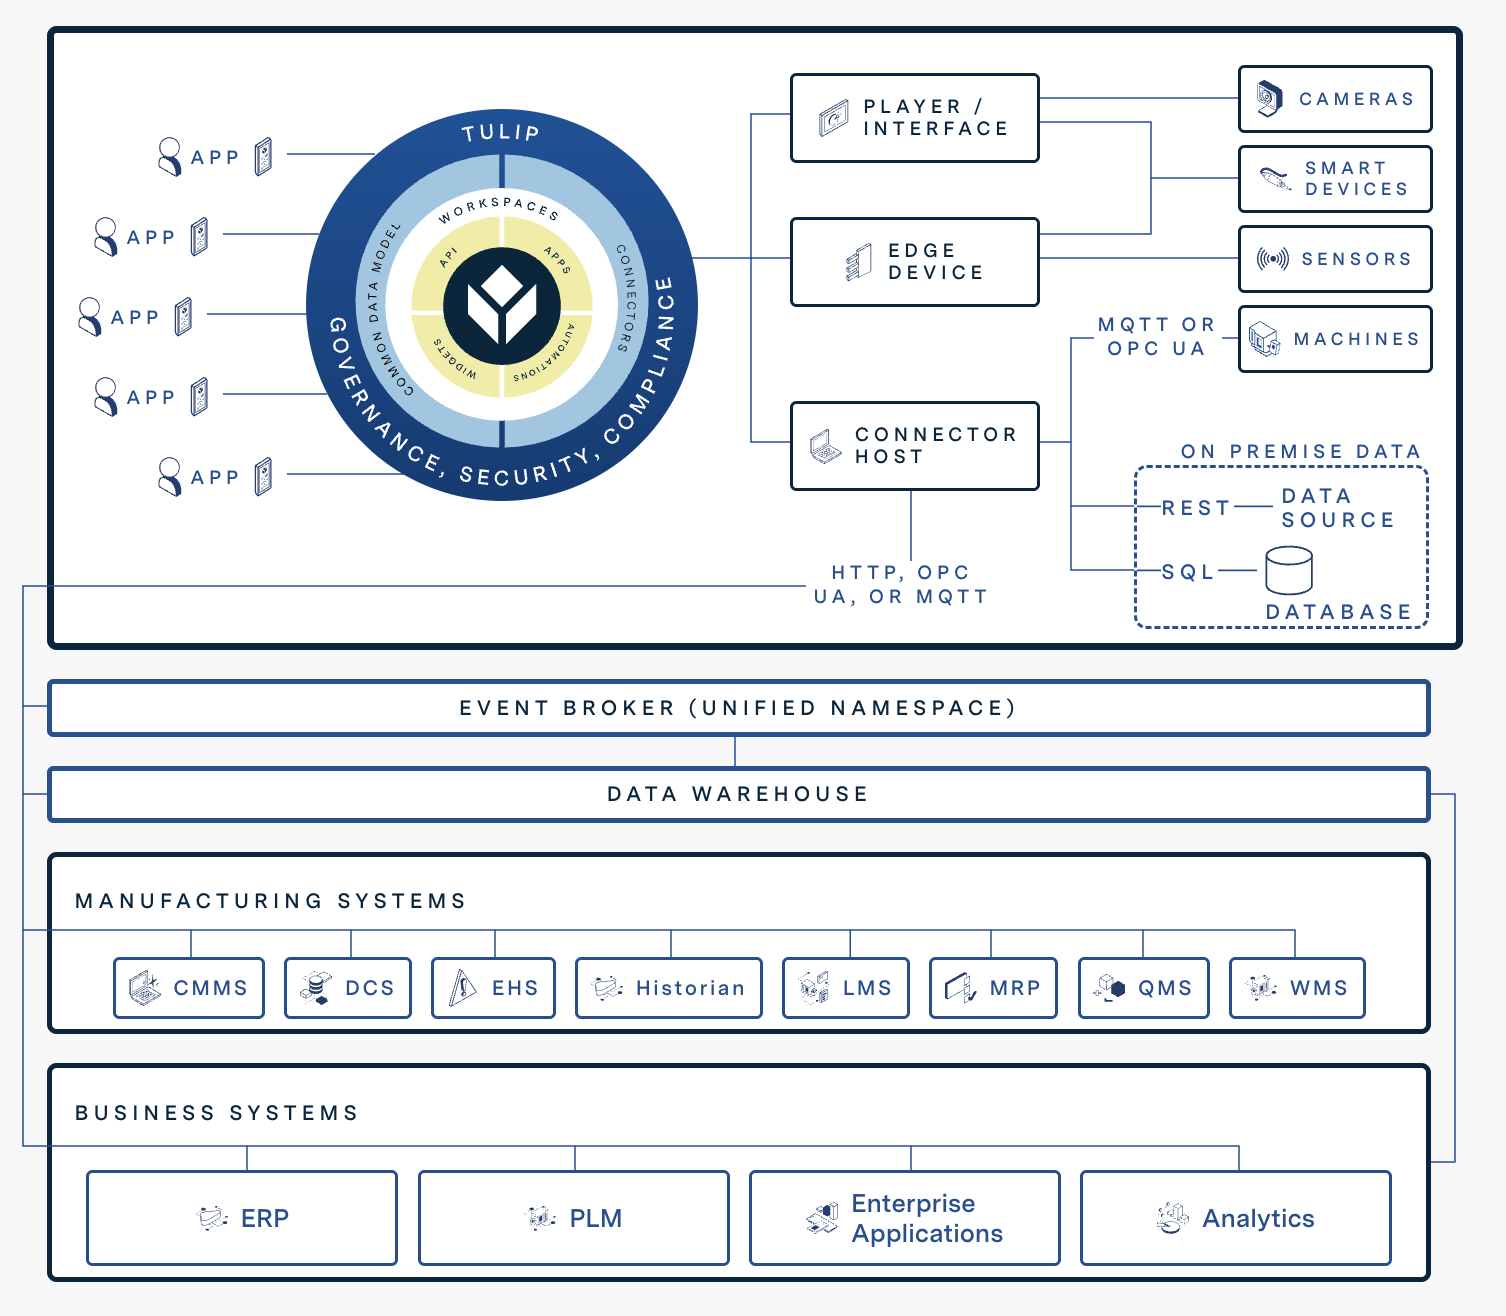
Intégration des systèmes
En règle générale, les intégrations système ne doivent pas nécessairement constituer la première étape du déploiement. Tulip vous recommande de commencer par développer votre produit minimum viable (MVP) sans intégration système, puis d’apporter les ajustements nécessaires. En effet, la mise en place des intégrations système peut prendre plusieurs mois.
Une intégration système avec Tulip implique généralement trois facteurs : - Les capacités et les paramètres du système lui-même - La complexité de l’environnement informatique de votre entreprise - Les compétences de votre équipe informatique pour travailler avec le système
Les intégrations ne sont pas une question de « tout ou rien » : vous devez vous concentrer sur la définition des données minimales nécessaires pour fournir un contexte opérationnel dans une application.
Le schéma ci-dessous illustre une intégration ERP typique avec Tulip :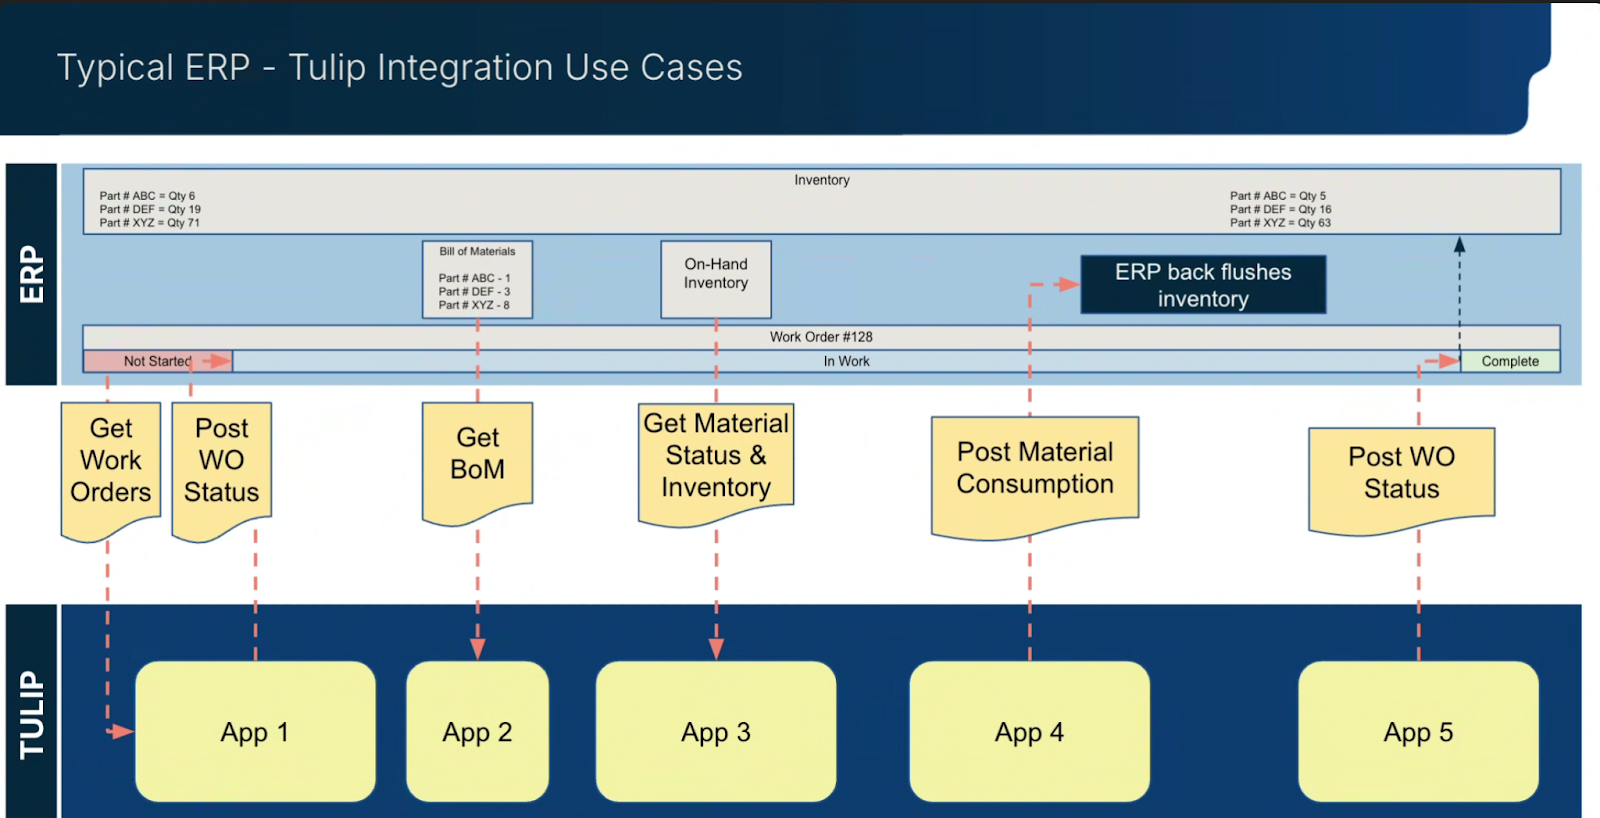
Pour en savoir plus sur la manière de planifier une intégration, cliquez ici.
Flux de données d’intégration
Tulip « communique » avec un système externe selon la configuration suivante :* Un connecteur utilise des paramètres sécurisés pour « accéder » au système* Une fonction de connecteur gère les informations vers/depuis le système* Une action de déclenchement (créée dans l’éditeur d’application) exécute la fonction de connecteur (par exemple, lorsque l’on appuie sur un bouton)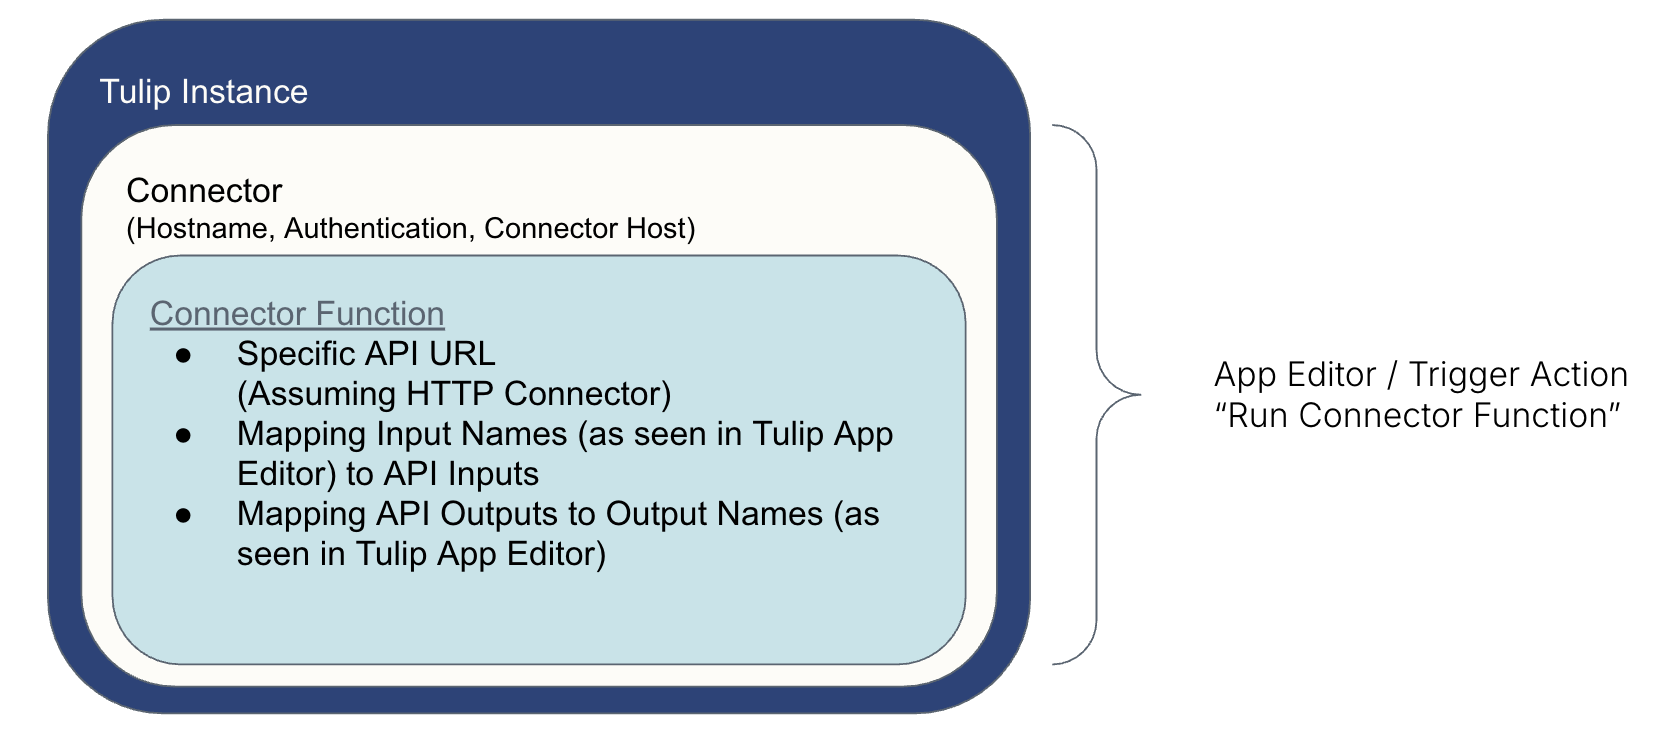
Comment se connecter à un système ?
Explorons et analysons les fonctionnalités qui rendent ces connexions possibles.
Les connecteurs
Les connecteurs constituent le framework de Tulip permettant de créer des connexions entre Tulip et des systèmes tiers. Il s’agit d’intégrations puissantes permettant de visualiser, de gérer et d’interagir avec les données provenant de systèmes externes au sein des applications.
À quoi servent les connecteurs ?
Les connecteurs permettent à Tulip de communiquer avec des systèmes externes. Les outils de votre pile technologique et le niveau d’intégration requis dans vos applications déterminent la manière dont vous utilisez les connecteurs.
Voici quelques cas d’utilisation des connecteurs :* Récupération d’informations à partir d’une source de vérité (par exemple, les ordres de travail de votre ERP)* Enregistrement de la consommation de matières (par exemple, dans votre ERP)* Envoi d’un message Slack
Fonctionnement des connecteurs
Les connecteurs établissent une connexion entre Tulip et un système tiers. Ils gèrent le sens de la communication et l’authentification, ce qui permet l’échange de données.
Le transfert de données est rendu possible grâce à un hôte de connecteur. Les hôtes de connecteur permettent à Tulip de se connecter à des systèmes externes, en servant de lien direct entre les deux. Tulip met à disposition un hôte de connecteur dans le cloud, mais vous pouvez également utiliser un hôte de connecteur sur site.
Pour en savoir plus sur les hôtes de connecteurs, cliquez ici.
Alors que l’hôte de connecteur établit la connexion, les fonctions de connecteur permettent à vos connecteurs d’effectuer diverses opérations, notamment extraire des informations, écrire dans des tables et modifier des données existantes. Les fonctions de connecteur envoient des requêtes au système tiers via l’hôte de connecteur.
Vous pouvez également définir des paramètres pour votre fonction, tels que des paramètres de requête et des réponses, qui déterminent les données renvoyées. Bien qu’aucune connaissance préalable de JSON ne soit requise, une bonne maîtrise de concepts tels que la et des structures de données générales est utile pour mieux comprendre vos fonctions de connecteur.
Types de connecteurs
Afin de comprendre les différents systèmes auxquels vous pouvez vous connecter, il est important de noter qu’il existe trois types de connecteurs qui extraient des informations de différentes sources :
HTTP
Les connecteurs HTTP accèdent aux données à partir d’API externes. Ce sont les connecteurs les plus couramment utilisés. Les connecteurs HTTP peuvent s’interfacer avec la plupart des types d’API HTTP, y compris REST et SOAP.
Les fonctions des connecteurs HTTP peuvent effectuer les types suivants d’API Call :
- GET
- HEAD
- POST
- PUT
- BATCH
- SUPPRIMER
SQL
Les connecteurs SQL permettent d'accéder aux données provenant de bases de données externes. Grâce à un connecteur SQL, vous pouvez modifier des données tabulaires, récupérer des données et manipuler un ensemble de données existant.
Tulip prend en charge les connecteurs SQL suivants :
- Microsoft SQL Server
- PostgreSQL
- MySQL
- Oracle
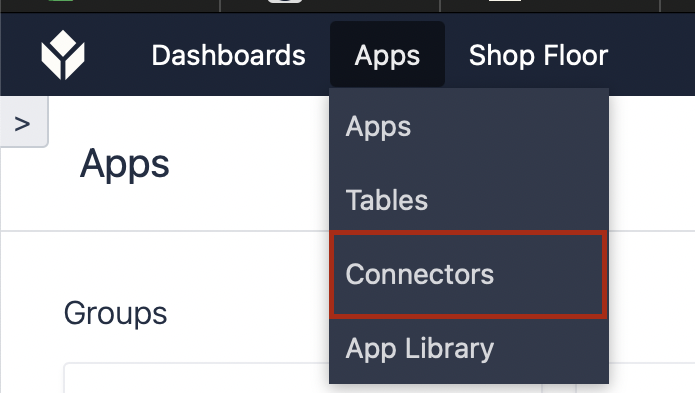
Accédez aux connecteurs HTTP et SQL via la page « Connecteurs » de votre instance.
MQTT
Connectez-vous à des brokers MQTT pour la surveillance des machines. Tulip peut publier nativement les données de son produit vers votre broker MQTT, s'intégrant ainsi de manière transparente dans un espace de noms unifié ou un bus d'événements d'entreprise.
Les champs suivants peuvent être définis pour une fonction de connecteur MQTT : - Qualité de service - Sujet - Conservation des messages - Charge utile - Entrées définies par l’utilisateur
Connectivité en périphérie
Certaines de ces machines comprennent des appareils en périphérie, sur lesquels vous pouvez en savoir plus ici :
API de table
À l’aide de connecteurs, une application Tulip peut lancer une requête HTTP ou SQL. Grâce à l’API Tulip, vous pouvez communiquer avec Tulip et l’intégrer à partir de systèmes externes. Cette API permet d’importer des données dans Tulip depuis un autre système et d’écrire dans ces autres systèmes. L’API Table offre diverses fonctionnalités, notamment :* Mettre à jour un enregistrement de table* Créer une table* Obtenir le nombre d’enregistrements d’une table
L'API Tulip ne fonctionne actuellement qu'avec les tables Tulip. Pour utiliser l'API Table, vous devez disposer de connaissances de base sur le fonctionnement des API.
Accédez à la documentation de l’API Tulip ici.
Pour vous exercer à l’utilisation de l’API Table, suivez le cours de Tulip University : « Feature Deep Dive : Table API ».
Prochaines étapes
En savoir plus sur les intégrations et commencer à établir des connexions :* Comment créer un connecteur* Comment configurer des connecteurs rapides
Avez-vous trouvé ce que vous cherchiez ?
Rendez-vous sur community.tulip.co pour poser votre question ou voir si d'autres utilisateurs ont rencontré un problème similaire !