

In diesem Leitfaden erfahren Sie:– Wann Daten in Tulip und wann in einem externen System gespeichert werden sollten– Wie Sie Daten aus anderen Systemen abrufen– Was Sie benötigen, um ein System in Tulip zu integrieren
Der Betrieb bezieht Daten häufig aus mehreren Quellen, sowohl aus Tulip als auch aus externen Systemen. Bei externen Datenquellen müssen Sie eine Verbindung über Tulip herstellen.
Establishing secure data connections may require IT personnel.
Wann sollten Daten in Tulip und wann in einem externen System gespeichert werden?
In Tulip können Sie Daten an zwei Orten speichern:
- Tabellen
- Abschlüsse
Tulip-Daten (z. B. Prozessdaten, Arbeitsanweisungen, Anlagen) werden direkt aus Ihren digitalen Betriebsabläufen aktualisiert.
Aber was ist mit Daten, auf die Sie in der Produktion verweisen, die jedoch an anderer Stelle gespeichert sind? Dazu können gehören:
- ERP-/WMS-Systeme
- Alte MES-Systeme
- Datenbanken
- PLM (z. B. für Stücklisten)
- Qualitätsmanagementsystem (QMS)
Sie können auf verschiedene Weise mit externen Daten interagieren, je nachdem, wofür Sie die Daten nutzen (z. B. zum Lesen und Schreiben von Daten in eine API-/SQL-Datenbank oder zum Anzeigen von Verwaltungsdaten als Referenz für die Produktion).
Eine einzige „Source of Truth“ ist eine wesentliche Komponente für genaue Echtzeitdaten. Eine „Source of Truth“ stellt sicher, dass Daten nicht dupliziert oder an mehreren Stellen dargestellt werden.
Sowohl Tulip-Daten als auch externe Daten sind jeweils eigene „Single Source of Truth“, und keine der beiden sollte durch die andere ersetzt oder dupliziert werden: – Ein externes System liefert klare Anforderungen, Geschäftskennzahlen oder Kundendaten für den Kontext digitaler Arbeitsabläufe – Tulip-Daten enthalten Betriebs- und Prozessdaten für die Echtzeit-Berichterstattung
Dieses Diagramm veranschaulicht die Trennung der Daten aus Tulip und einem ERP-System: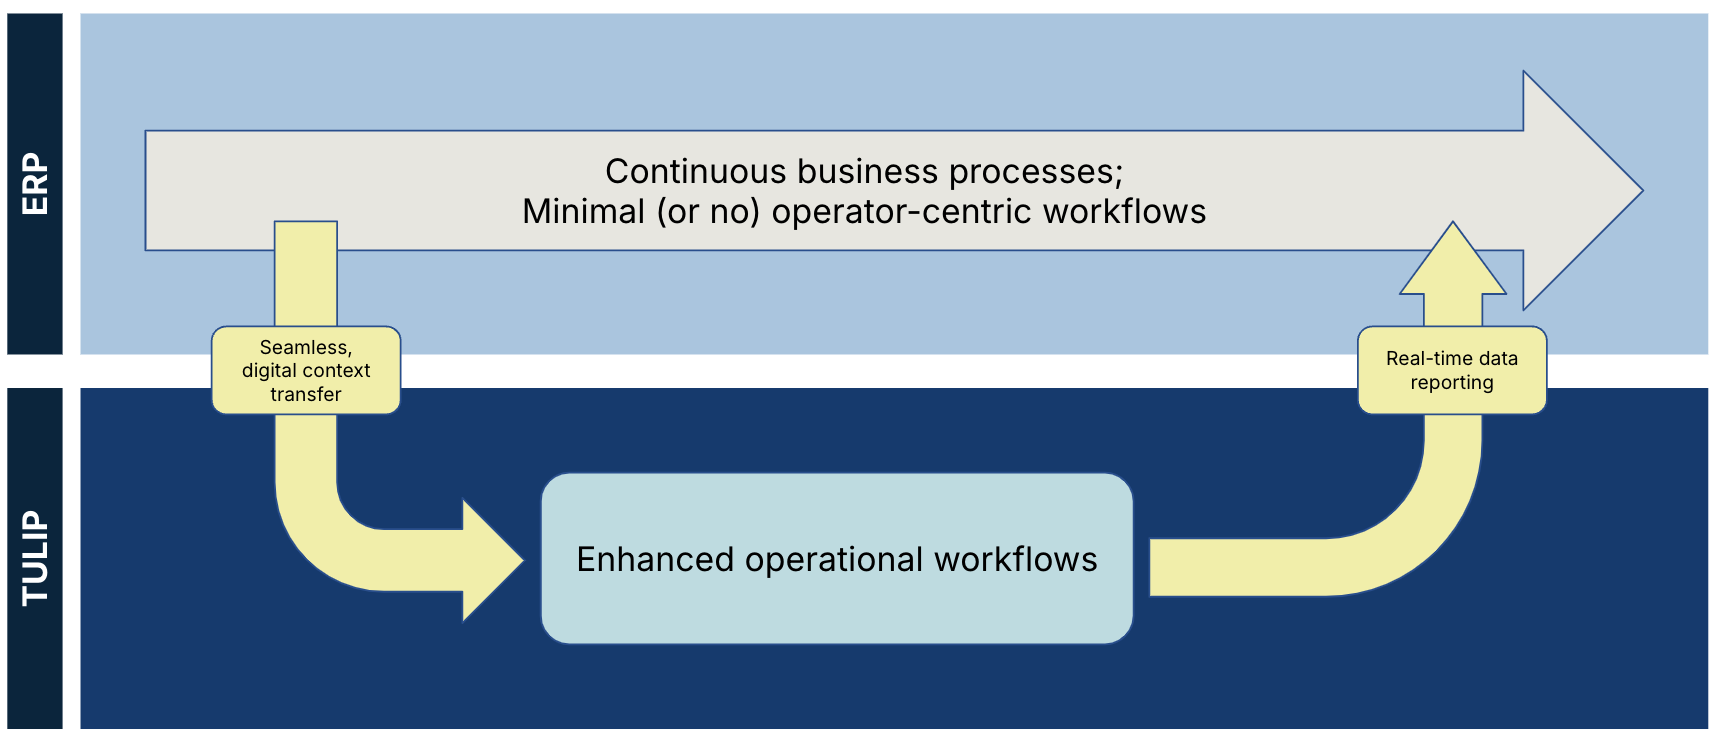
Sie sollten Daten aus externen Quellen nur bei Bedarf verwenden. Diese Vorgehensweise bedeutet, dass ein anderes System Kontextinformationen für die Produktion bereitstellen kann, während Tulip-Daten die Informationen aus einer externen Quelle ergänzen.
Woran erkennen Sie, ob Sie externe Daten nutzen sollten? – Erzielen Sie ohne Integration nur einen minimalen Nutzen aus der Lösung? – Ist eine schnelle Integration möglich (in weniger als einem Monat)?
Integrationen sollten einen zusätzlichen Mehrwert erschließen, sind jedoch in der Regel nicht unerlässlich für den potenziellen Nutzen.
Beispiel: Arbeitsaufträge aus einem ERP-System
- Arbeitsaufträge werden in einem ERP-System gespeichert
- Eine Tulip-Management-App ruft den Arbeitsauftrag aus dem ERP ab
- Die Management-App erstellt einen Datensatz des Arbeitsauftrags in einer Tulip-Tabelle, um Produktionsdaten zu speichern
- Arbeitsanweisungen und Montage-Apps erfassen Produktionsdaten in der Arbeitsauftragstabelle und konforme Prozessdaten in den Fertigstellungsdaten
Offenes Ökosystem
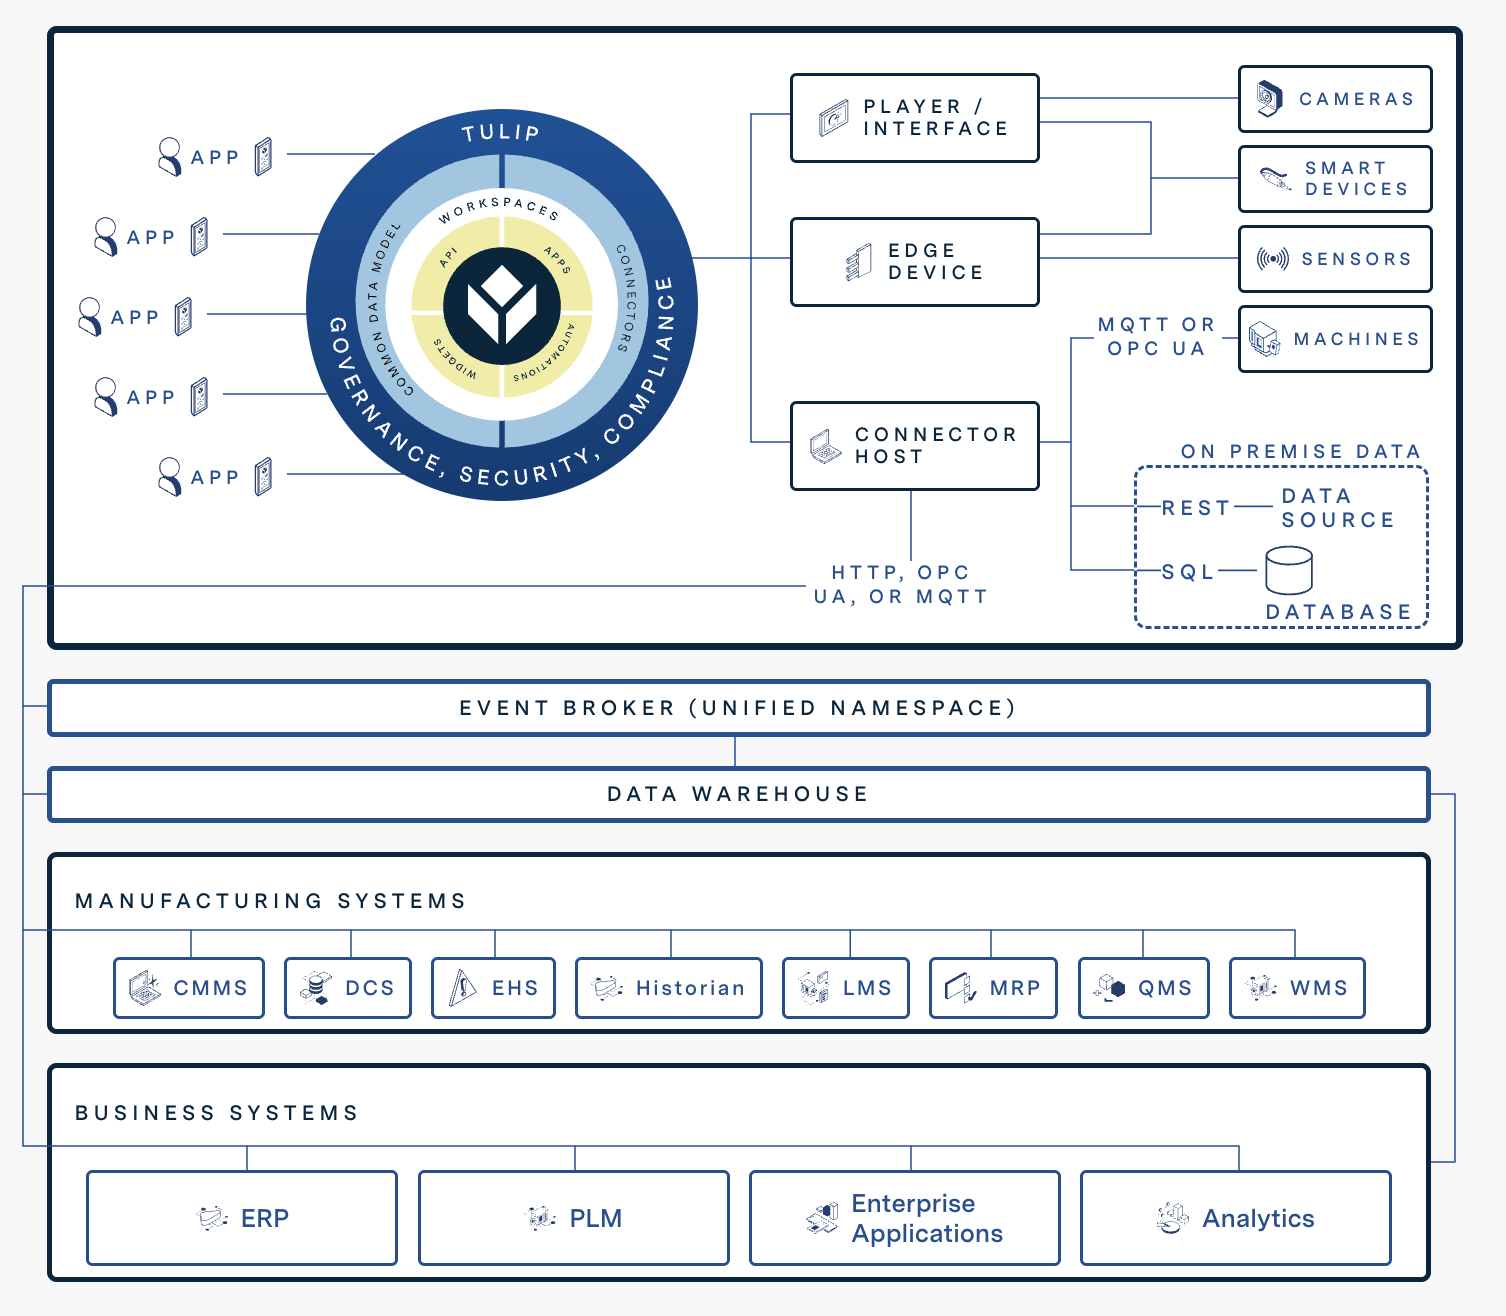
Ein offenes Ökosystem nutzt mehrere miteinander verbundene Lösungen, um die individuellen Anforderungen eines Unternehmens zu erfüllen. Anstatt ein einziges System für alles zu verwenden, legt der offene Ökosystem-Ansatz von Tulip den Schwerpunkt auf Composability statt auf Top-Down-Kontrolle.
Das folgende Diagramm zeigt, wie sich die digitalen Funktionen von Tulip in andere Systeme integrieren lassen.
Systemintegration
Systemintegrationen müssen in der Regel nicht bereits im ersten Schritt der Einführung erfolgen. Tulip empfiehlt, zunächst Ihr Minimum Viable Product (MVP) ohne Systemintegration zu entwickeln und anschließend bei Bedarf Anpassungen vorzunehmen. Der Grund dafür ist, dass die Einrichtung von Systemintegrationen bis zu mehreren Monaten dauern kann.
Eine Systemintegration mit Tulip hängt in der Regel von drei Faktoren ab: – den Fähigkeiten und Parametern des Systems selbst, – der Komplexität der IT-Umgebung Ihres Unternehmens und – den Fähigkeiten Ihres IT-Teams im Umgang mit dem System.
Bei Integrationen geht es nicht um „alles oder nichts“ – Sie sollten sich darauf konzentrieren, die Mindestdatenmenge zu definieren, die erforderlich ist, um in einer App einen betrieblichen Kontext zu schaffen.
Das folgende Diagramm zeigt eine typische ERP-Integration mit Tulip: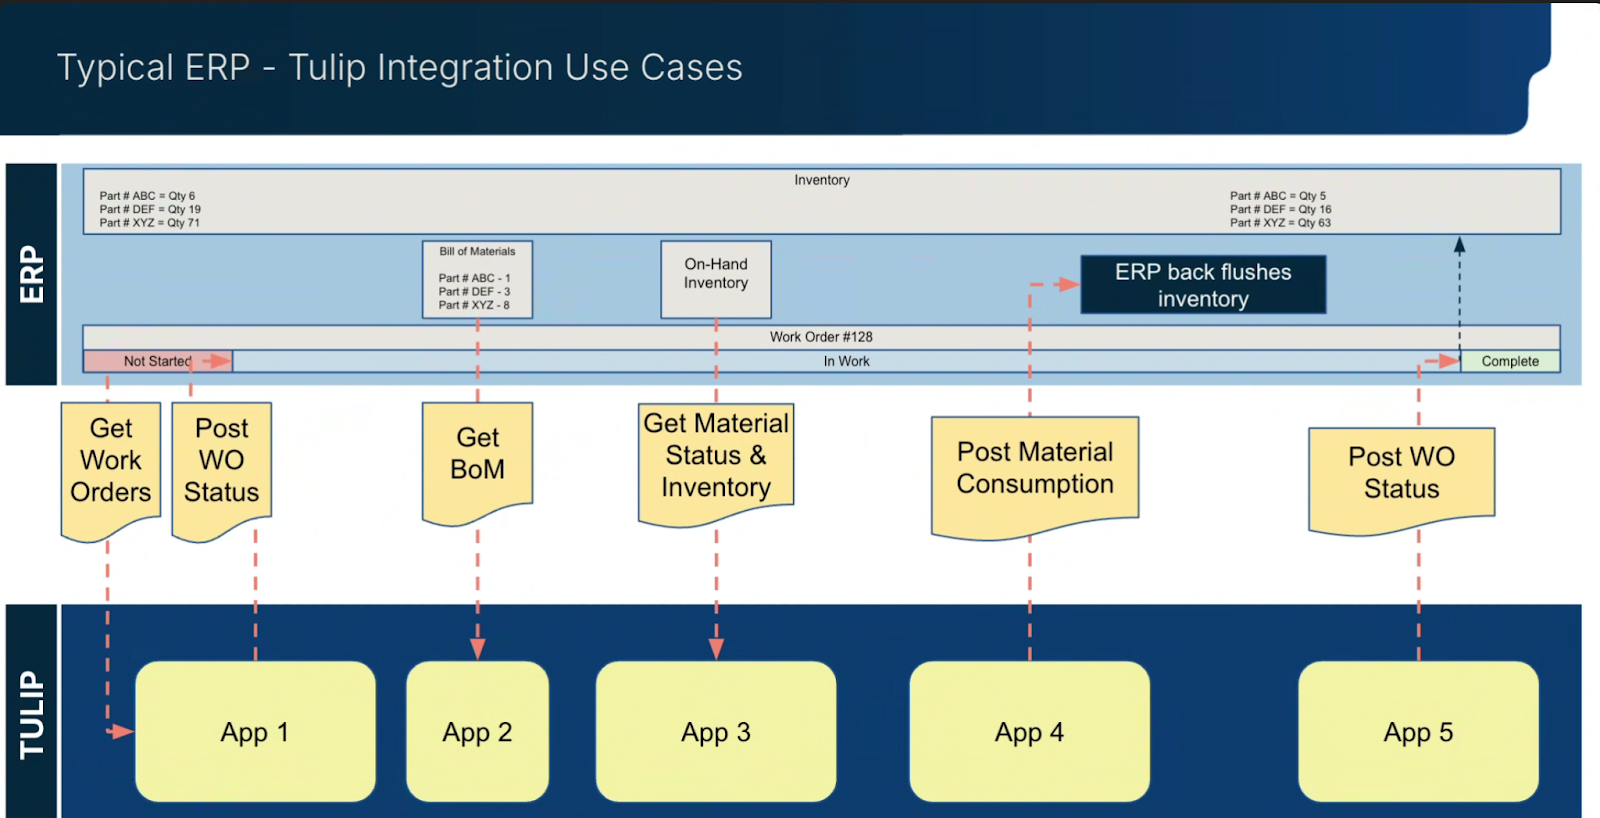
Erfahren Sie hier mehr darüber, wie Sie eine Integration planen.
Datenfluss bei der Integration
Tulip „kommuniziert“ mit einem externen System über folgende Konfiguration:* Ein Connector nutzt sichere Parameter, um „Zugriff“ auf das System zu erhalten* Eine Connector-Funktion steuert den Informationsfluss zum/vom System* Eine Trigger-Aktion (im App-Editor erstellt) führt die Connector-Funktion aus (z. B. beim Drücken einer Schaltfläche)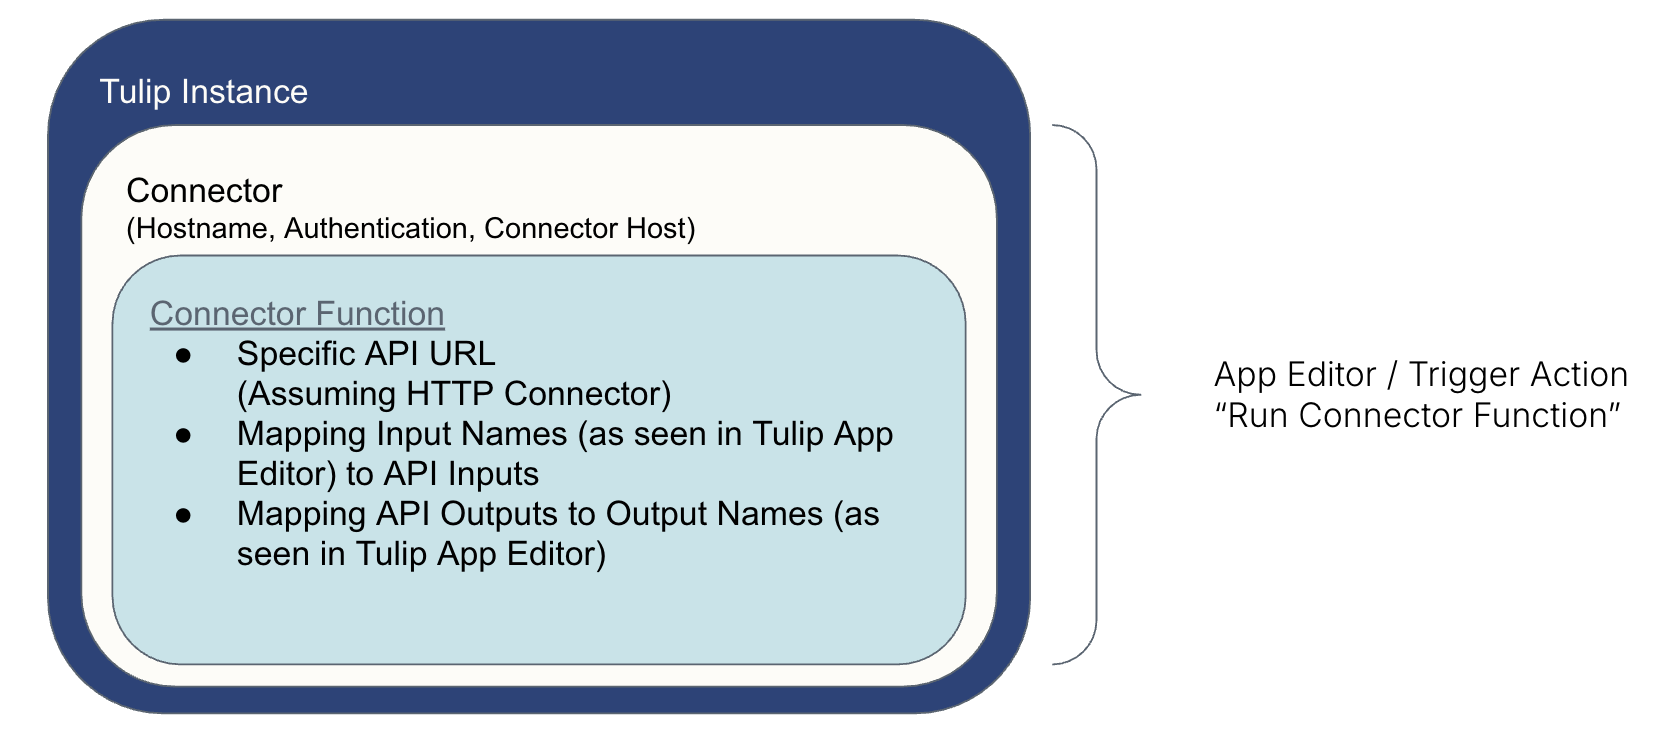
Wie stellt man eine Verbindung zu einem System her?
Lassen Sie uns die Funktionen erkunden und genauer betrachten, die diese Verbindungen ermöglichen.
Konnektoren
Konnektoren sind das Framework von Tulip zum Herstellen von Verbindungen zwischen Tulip und Systemen von Drittanbietern. Sie sind leistungsstarke Integrationen zum Anzeigen, Verwalten und Interagieren mit Daten aus externen Systemen in Anwendungen.
Wofür verwendet man Konnektoren?
Konnektoren sind die Schnittstelle, über die Tulip mit externen Systemen kommuniziert. Die in Ihrem Stack verwendeten Tools und der Grad der erforderlichen Integration in Ihren Anwendungen bestimmen, wie Sie Konnektoren einsetzen.
Zu den Anwendungsfällen für Konnektoren gehören unter anderem:* Abrufen von Informationen aus einer „Source of Truth“ (z. B. Arbeitsaufträge aus Ihrem ERP)* Verbuchen des Materialverbrauchs (z. B. in Ihrem ERP)* Senden einer Slack-Nachricht
So funktionieren Konnektoren
Konnektoren stellen eine Verbindung zwischen Tulip und einem Drittanbietersystem her. Sie regeln die Datenrichtung und die Authentifizierung, wodurch der Datenaustausch ermöglicht wird.
Der Datenaustausch wird durch einen Connector-Host ermöglicht. Connector-Hosts ermöglichen Tulip die Verbindung mit externen Systemen und fungieren dabei als direkte Verbindung zwischen beiden. Tulip stellt einen Cloud-Connector-Host zur Verfügung, Sie können jedoch auch einen lokalen Connector-Host verwenden.
Erfahren Sie hier mehr über Connector-Hosts.
Während der Connector-Host die Verbindung herstellt, sorgen Connector-Funktionen dafür, dass Ihre Connectoren bestimmte Aufgaben ausführen, darunter das Abrufen von Informationen, das Schreiben in Tabellen und das Bearbeiten vorhandener Daten. Connector-Funktionen fordern Aktionen beim Drittanbietersystem an, die über den Connector-Host abgewickelt werden.
Sie können außerdem Anpassungen an Ihrer Funktion vornehmen, wie z. B. Abfrageparameter und Antworten, die festlegen, welche Daten zurückgegeben werden. Vorkenntnisse in JSON sind zwar nicht erforderlich, doch sind Kenntnisse in Bereichen wie und allgemeine Datenstrukturen hilfreich, um Ihre Connector-Funktionen besser zu verstehen.
Arten von Konnektoren
Um die verschiedenen Systeme zu verstehen, mit denen Sie eine Verbindung herstellen können, ist es wichtig zu wissen, dass es drei verschiedene Arten von Konnektoren gibt, die Informationen aus unterschiedlichen Quellen extrahieren:
HTTP
HTTP-Konnektoren greifen auf Daten aus externen APIs zu. Sie sind die am häufigsten verwendeten Konnektoren. HTTP-Konnektoren können mit den meisten Arten von HTTP-APIs kommunizieren, einschließlich REST und SOAP.
HTTP-Konnektorfunktionen können die folgenden Arten von ausführen:
- GET
- HEAD
- POST
- PUT
- BATCH
- LÖSCHEN
SQL
SQL-Konnektoren greifen auf Daten aus externen Datenbanken zu. Mit einem SQL-Konnektor können Sie tabellarische Daten ändern, Daten abrufen und einen bestehenden Datensatz bearbeiten.
Tulip unterstützt die folgenden SQL-Konnektoren:
- Microsoft SQL Server
- PostgreSQL
- MySQL
- Oracle
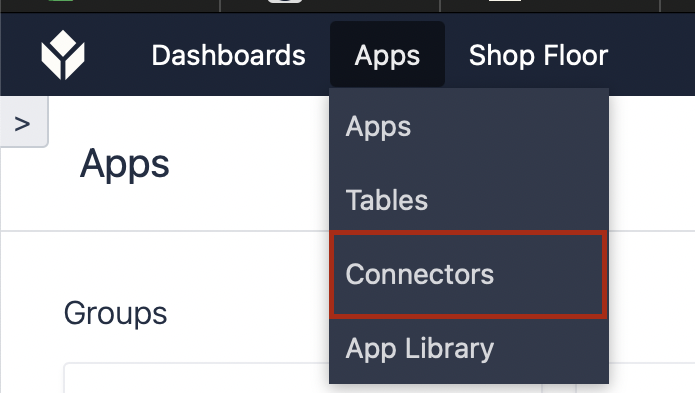
Greifen Sie über die Seite „Konnektoren“ in Ihrer Instanz auf HTTP- und SQL-Konnektoren zu.
MQTT
Stellen Sie eine Verbindung zu MQTT-Brokern für die Maschinenüberwachung her. Tulip kann Daten aus seinem Produkt nativ an Ihren MQTT-Broker veröffentlichen und sich nahtlos in einen Unified Namespace oder einen Enterprise Event Bus integrieren.
Für eine MQTT-Konnektorfunktion können folgende Felder definiert werden:- Dienstgüte (Quality of Service)- Thema (Topic)- Nachrichtenaufbewahrung (Retain Message)- Nutzdaten (Payload)- Benutzerdefinierte Eingaben
Edge-Konnektivität
Zu diesen Maschinen gehören unter anderem Edge-Geräte, über die Sie hier mehr erfahren können:
Tabellen-API
Mithilfe von Konnektoren kann eine Tulip-App eine HTTP- oder SQL-Abfrage initiieren. Über die Tulip-API können Sie mit Tulip kommunizieren und Tulip in externe Systeme integrieren. Diese API dient dazu, Daten aus einem anderen System in Tulip zu importieren und Ihnen das Schreiben in diese anderen Systeme zu ermöglichen. Die Tabellen-API bietet verschiedene Funktionen, darunter:* Einen Tabelleneintrag aktualisieren* Eine Tabelle erstellen* Die Anzahl der Tabelleneinträge ermitteln
Die Tulip-API funktioniert derzeit nur mit Tulip-Tabellen. Um die Tabellen-API nutzen zu können, benötigen Sie grundlegende Kenntnisse über die Funktionsweise von APIs.
Die Dokumentation zur Tulip-API finden Sie hier.
Um den Umgang mit der Tabellen-API zu üben, belegen Sie den Kurs der Tulip University: „Feature Deep Dive: Table API“.
Nächste Schritte
Erfahren Sie mehr über Integrationen und beginnen Sie mit der Anbindung:* So erstellen Sie einen Connector* So richten Sie Quick-Connectoren ein
Haben Sie gefunden, wonach Sie gesucht haben?
Besuchen Sie community.tulip.co, um Ihre Frage zu stellen oder zu sehen, ob andere bereits ein ähnliches Problem hatten!